本篇目标:
1.并查集的基本原理;
2.并查集的存储方式;
3.并查集各个接口的实现与作用;
4.并查集的合并与查找优化;
5.使用并查集省份数量问题。
一. 并查集原理
1.概念理解
在一些实际问题中,需要将 n个不同的元素划分成若干个互不相交的集合。
开始时,每个元素各自属于一个独立的集合。随着元素之间建立联系,需要不断将两个集合合并 。在这个过程中,还需要反复查询某个元素属于哪个集合 ,或者判断两个元素是否属于同一个集合。
适合描述这类问题的数据结构,称为并查集:
英文名称为 Disjoint Set Union,简称 DSU,也经常称为 Union-Find Set。
"并查集"这个名称对应了它最核心的两类操作:
-
并:将两个集合合并;
-
查:查找某个元素所属集合的根节点。
2.理解并查集
然后我们通过一个实例来了解并查集,
假设某公司今年在全国校招了10名学生:
-
西安招聘4人;
-
成都招聘3人;
-
武汉招聘3人。
这10名学生来自不同的学校,开始时互不相识。现在按照下面的方式给他们编号:
cpp
{0, 1, 2, 3, 4, 5, 6, 7, 8, 9}一开始,每名学生都是一个独立的小团体:
cpp
{0} {1} {2} {3} {4} {5} {6} {7} {8} {9}此时一共有10个集合。
可以使用一个数组保存这些集合:
cpp
下标: 0  1  2  3  4  5  6  7  8  9
数据:-1 -1 -1 -1 -1 -1 -1 -1 -1 -1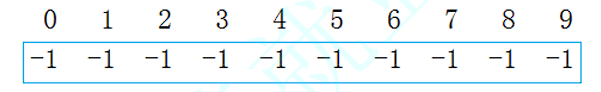
数组中的每个位置对应一名学生。数组中的**-1表示**:
-
当前元素是所在集合的根节点;
-
当前集合一共有1个元素。
毕业后,同一个城市的学生决定结伴前往公司,于是形成了三个小分队:
cpp
西安小分队:s1 = {0, 6, 7, 8}
成都小分队:s2 = {1, 4, 9}
武汉小分队:s3 = {2, 3, 5}假设编号为0、1、2的学生分别担任三个小分队的队长,那么三个集合 可以表示为:
cpp
0
├── 6
├── 7
└── 8

1
├── 4
└── 9

2
├── 3
└── 5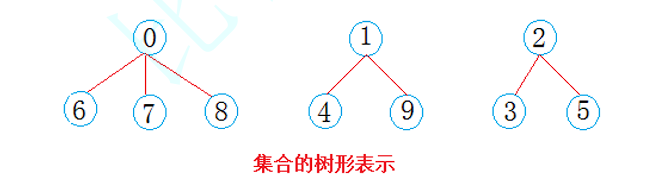
对应的数组可以表示为:
cpp
下标: 0  1  2  3  4  5  6  7  8  9
数据:-4 -3 -3  2  1  2  0  0  0  1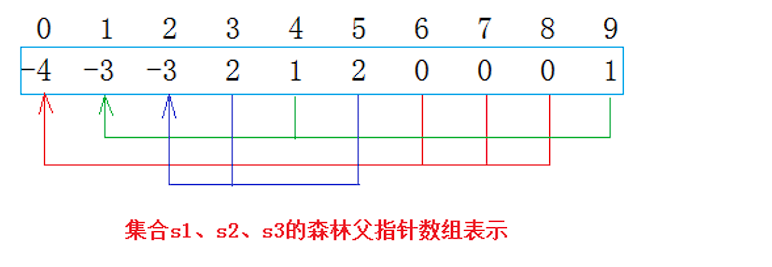
其中:
-
_ufs[0] == -4,说明0是根节点,以0为根的集合有4个元素; -
_ufs[1] == -3,说明1是根节点,以1为根的集合有3个元素; -
_ufs[2] == -3,说明2是根节点,以2为根的集合有3个元素; -
_ufs[6] == 0,说明6的父节点是0; -
_ufs[4] == 1,说明4的父节点是1; -
_ufs[3] == 2,说明3的父节点是2。
由此可以总结出并查集数组的存储规则。
并查集数组的含义:
cpp
数组下标表示集合中的元素编号;

如果数组中的值为负数,说明该元素是根节点;

根节点位置的绝对值表示集合中的元素数量;

如果数组中的值为非负数,表示该元素父节点的下标。
例如:
cpp
_ufs[0] == -4表示0是根节点,并且0所在的集合中有4个元素。
cpp
_ufs[6] == 0表示6不是根节点,6的父节点是0。
3 集合的合并
在公司工作一段时间后,西安小分队中的8号同学和成都小分队中的1号同学相互认识。
通过他们之间的联系,西安小分队和成都小分队也互相认识了,因此两个朋友圈可以合并成一个更大的朋友圈:
cpp
{0, 6, 7, 8} + {1, 4, 9}合并后的集合为:
cpp
{0, 1, 4, 6, 7, 8, 9}假设将以1为根的集合合并到以0为根的集合中,树形关系可以表示为:
cpp
0
├── 6
├── 7
├── 8
└── 1
    ├── 4
    └── 9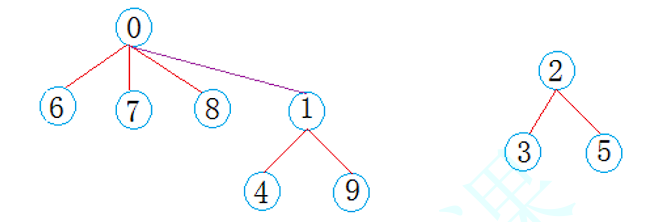
对应数组变为:
cpp
下标: 0  1  2  3  4  5  6  7  8  9
数据:-7  0 -3  2  1  2  0  0  0  1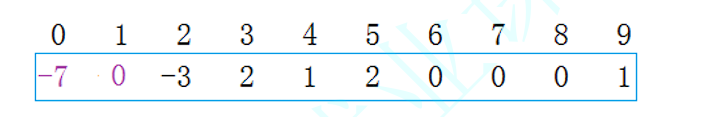
此时:
-
_ufs[0] == -7,表示以0为根的集合有7个元素; -
_ufs[1] == 0,表示1的父节点变成了0; -
_ufs[2] == -3,表示以2为根的集合有3个元素。
10名学生现在形成了两个朋友圈:
cpp
朋友圈一:{0, 1, 4, 6, 7, 8, 9}
朋友圈二:{2, 3, 5}
4. 并查集的用处
通过上面的例子,可以看出并查集主要支持以下操作。
<1>. 查找某个元素属于哪个集合
沿着父节点不断向上查找,直到找到数组值为负数的位置。
这个位置就是集合的根节点,也可以看作集合的名称。
例如查找9属于哪个集合:
9 → 1 → 0由于 _ufs[0] 为负数,所以0是9所在集合的根节点。
<2>. 判断两个元素是否属于同一个集合
分别查找两个元素的根节点:
-
如果根节点相同,说明两个元素属于同一个集合;
-
如果根节点不同,说明两个元素属于不同集合。
例如:
cpp
FindRoot(4) == 0
FindRoot(8) == 0
所以4和8属于同一个集合。
而:
cpp
FindRoot(4) == 0
FindRoot(3) == 2
所以4和3不属于同一个集合。
<3>. 合并两个集合
先找到两个元素各自的根节点。
如果根节点不同,就把一个集合的根节点连接到另一个集合的根节点上,同时更新合并后集合的元素数量。
<4>. 统计集合数量
并查集中,每个集合有且只有一个根节点。
根节点在数组中的值为负数,因此只需要统计数组中负数的数量,就可以得到集合数量。
2. 并查集实现
下面使用 vector<int> 实现一个基本的并查集。
下面分别实现每个接口。
2.1 构造函数
cpp
UnionFindSet(size_t n)
    : _ufs(n, -1)
{
}
构造函数负责创建一个包含 n个元素的并查集。
刚开始时,每个元素都是一个独立的集合,因此数组中的所有元素都初始化为-1。
例如:
cpp
UnionFindSet ufs(5);内部数组初始化为:
cpp
下标: 0  1  2  3  4
数据:-1 -1 -1 -1 -1
这表示当前存在5个集合:
cpp
{0} {1} {2} {3} {4}每个位置都是根节点,每个集合都只有一个元素。
为什么初始化为负数?
并查集使用正负号区分两种情况:
-
负数:当前元素是根节点;
-
非负数:当前数值是父节点下标。
-1的绝对值是1,表示当前集合中只有一个元素。
2.2 查找根节点
cpp
int FindRoot(size_t x)
{
	size_t root = x;
	while (_ufs[root] >= 0)
	{
		root = _ufs[root];
	}

	return root;
}
接口作用:
FindRoot用于查找某个元素所在集合的根节点。
参数 index 是元素编号,返回值是该元素所在集合的根节点编号。
查找过程:
假设数组中存在下面的父子关系:
cpp
    0
   /
  1
 /
9
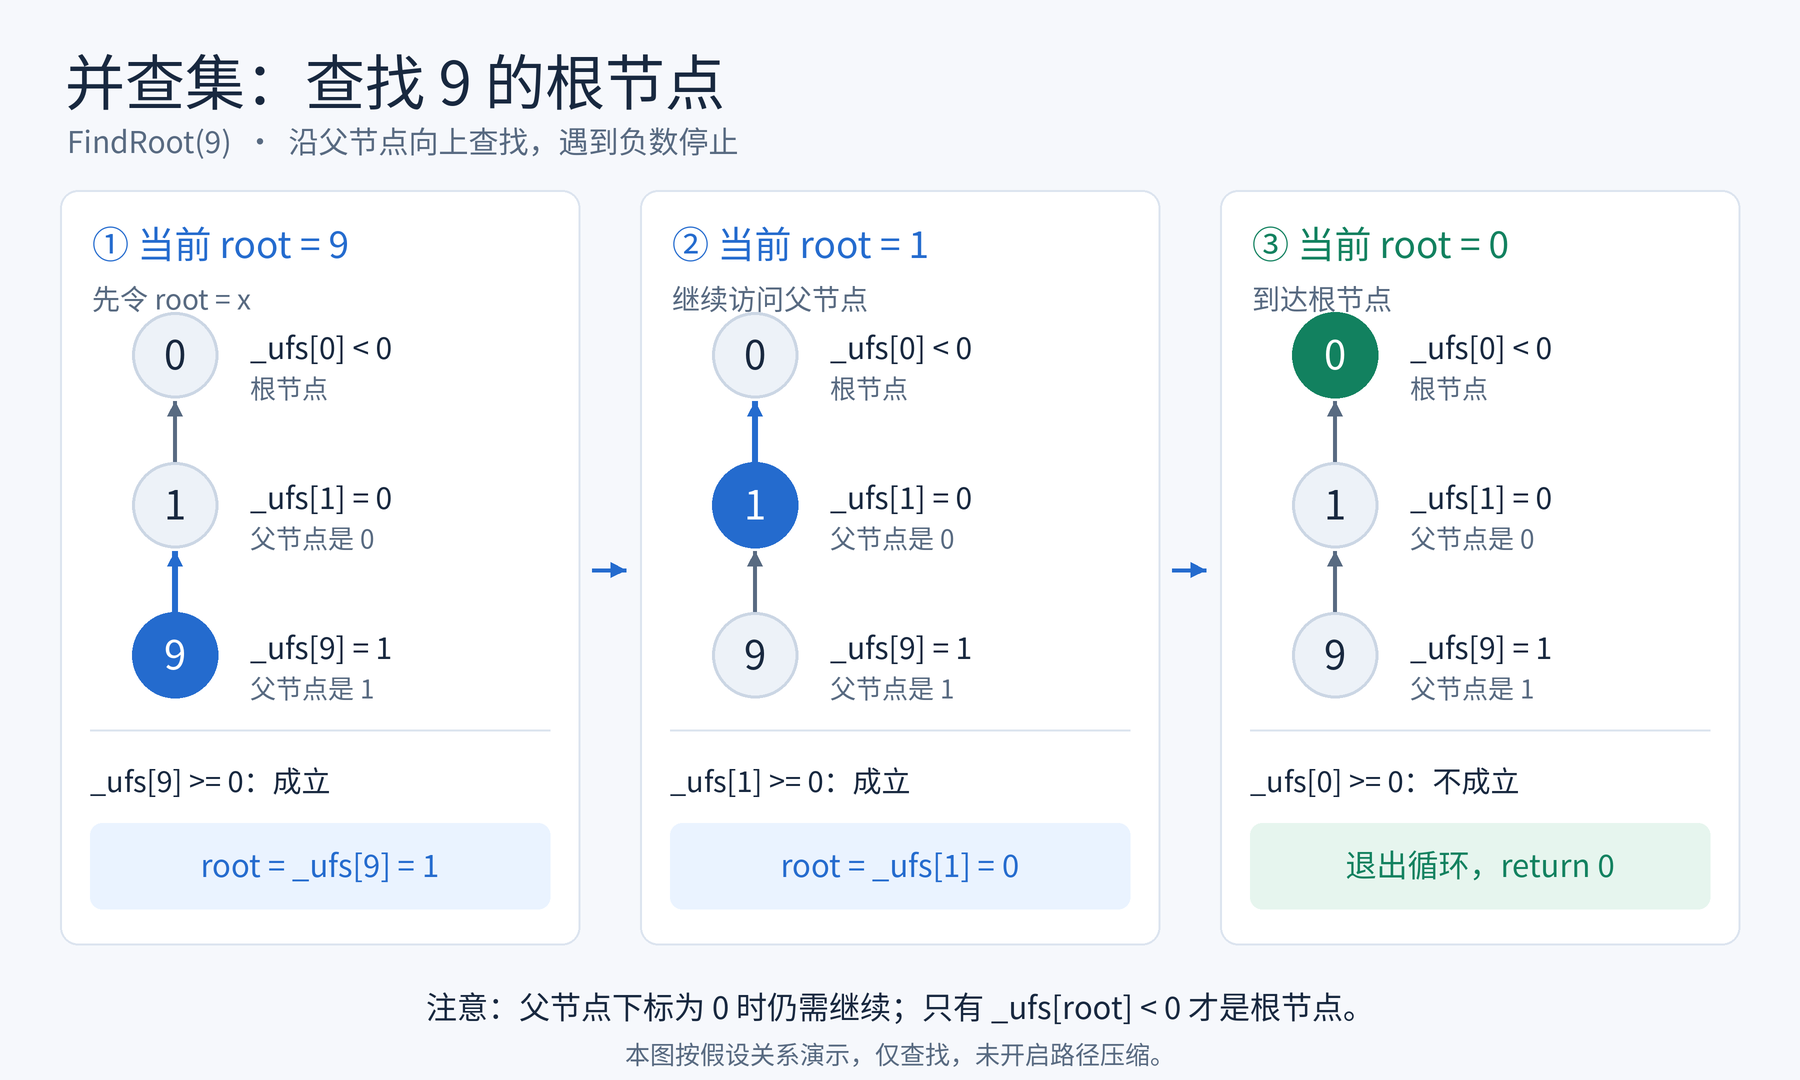
查找9的根节点时:
-
_ufs[9] == 1,说明9的父节点是1; -
_ufs[1] == 0,说明1的父节点是0; -
_ufs[0] < 0,说明0是根节点; -
返回0。
过程如图:
为什么以负数作为结束条件?
cpp
只有根节点位置保存的是负数,其他节点位置保存的是父节点下标,而数组下标不可能是负数,因此,只要找到负数,
就说明已经找到了集合的根。
时间复杂度:
cpp
查找所需时间与树的高度有关,如果树比较矮,查找速度就很快;如果树退化成一条长链,查找速度就会下降。2.3 合并两个集合
cpp
void Union(int x1, int x2)
{
    int root1 = FindRoot(x1);
    int root2 = FindRoot(x2);

    if (root1 == root2)
    {
        return;
    }

    _ufs[root1] += _ufs[root2];
    _ufs[root2] = root1;
}
接口作用:
Union用于合并 x1 和 x2 所在的集合。
<1>.分别查找根节点
cpp
int root1 = FindRoot(x1);
int root2 = FindRoot(x2);
并查集不能简单地把 x2 的父节点设置为 x1,因为 x1 和 x2 不一定是根节点。
正确做法是先找到两个集合的根节点,再合并两棵树。
<2>.判断是否已经在同一个集合
cpp
if (root1 == root2)
{
    return;
}
如果两个元素的根节点相同,说明它们已经属于同一个集合。
此时如果继续合并,可能破坏集合大小等信息,所以直接返回false。
<3>.更新集合大小
cpp
_ufs[root1] += _ufs[root2];两个根节点位置保存的都是负数。
假设:
cpp
_ufs[root1] == -4
_ufs[root2] == -3
合并后:
cpp
_ufs[root1] = -4 + -3 = -7表示合并后的集合一共有7个元素。
<4>.修改根节点关系
cpp
_ufs[root2] = root1;这一步表示将 root2 所在的集合合并到 root1 所在的集合中。
执行后,root2不再是根节点,它的父节点变成了 root1。
2.4 统计集合数量
cpp
std::size_t Count() const
{
    std::size_t count = 0;

    for (int value : _ufs)
    {
        if (value < 0)
        {
            ++count;
        }
    }

    return count;
}
接口作用:
Count用于统计并查集中当前存在多少个互不相交的集合。
统计原理:
每个集合有且只有一个根节点,而根节点对应的数组值一定是负数。
因此,只需要遍历数组,统计负数的数量即可。
例如:
cpp
下标: 0  1  2  3  4  5  6  7  8  9
数据:-7  0 -3  2  1  2  0  0  0  1
数组中只有两个负数:
cpp
-7和-3所以当前共有两个集合。
3. 并查集的优化
基本并查集已经可以正确完成查找和合并操作,但如果合并方式不合理,树可能变得很高。
例如:
cpp
0 → 1 → 2 → 3 → 4 → 5查找0的根节点需要经过多个节点。
常见的优化方式包括:
-
按集合大小合并;
-
路径压缩。
3.1 按集合大小合并
合并两个集合时,将元素数量较少的集合连接到元素数量较多的集合上。
这样可以尽量避免树的高度快速增加。
因为根节点保存的是集合大小的相反数,所以:
-
数值越小,绝对值越大,集合越大;
-
数值越大,绝对值越小,集合越小。
例如:
cpp
-7 < -3说明保存-7的集合更大。
合并时可以增加下面的判断:
cpp
if (_ufs[root1] > _ufs[root2])
{
    swap(root1, root2);
}
这样可以保证 root1 表示较大的集合,然后把 root2 合并到 root1 中。
3.2 路径压缩
查找根节点后,可以将查找路径上的所有节点直接连接到根节点。
例如,原来的关系为:
cpp
9 → 4 → 1 → 0完成路径压缩后变成:
cpp
9 → 0
4 → 0
1 → 0
下一次查找这些元素时,就可以更快地找到根节点。
路径压缩版 FindRoot 可以写成:
cpp
int FindRoot(int index)
{
    int root = index;

    // 先找到根节点
    while (_ufs[root] >= 0)
    {
        root = _ufs[root];
    }

    // 将查找路径上的节点直接连接到根节点
    while (index != root)
    {
        int parent = _ufs[index];
        _ufs[index] = root;
        index = parent;
    }

    return root;
}
同时采用按集合大小合并和路径压缩后,并查集单次操作的均摊时间复杂度非常接近 (O(1))。
4. 并查集应用
题目网址 :547. 省份数量 - 力扣(LeetCode) https://leetcode.cn/problems/number-of-provinces/description/
4.1.省份问题
<1>.题目描述
给定一个 n*n 的矩阵 isConnected。
如果:
cpp
isConnected[i][j] == 1表示第 i 个城市和第 j 个城市直接相连。
如果两个城市直接或间接相连,那么它们属于同一个省份。
要求计算省份总数。
例如:
cpp
城市0和城市1相连
城市1和城市2相连
即使城市0和城市2没有直接连接,它们仍然可以通过城市1间接连接,因此三个城市属于同一个省份。
<2>. 解题思路
可以将每个城市看作并查集中的一个元素。
开始时,每个城市都是一个独立集合,所以一共有 n 个省份。
然后遍历连接矩阵:
-
如果
isConnected[i][j] == 1,说明城市i和城市j相连; -
查找两个城市的根节点;
-
如果根节点不同,就合并两个集合;
-
遍历结束后,并查集中剩余的集合数量就是省份数量。
为什么可以使用并查集?
因为题目中的"省份"本质上就是一个连通集合。同一个连通集合中的所有城市,不管是直接相连还是间接相连,最后都会被合并到同一个并查集集合中。
<3> 代码实现
cpp
class UnionFindSet
{
public:
	UnionFindSet(size_t n)
		:_ufs(n,-1)
	{ }
	void Union(int x1, int x2)
	{
		int root1 = Findroot(x1);
		int root2 = Findroot(x2);
		if (root1 == root2)
		{
			return;
		}

		_ufs[root1] += _ufs[root2];
		_ufs[root2] = root1;
	}
	int Findroot(int x)
	{
		int child = x;
		while (_ufs[child] > 0)
		{
			child = _ufs[child];
		}

		return child;
	}
	int SetSize()
	{
		int size = 0;
		for (size_t i = 0; i < _ufs.size(); i++)
		{
			if (_ufs[i] < 0)
			{
				size++;
			}
		}

		return size;
	}
private:
	std::vector<int> _ufs;
};

class Solution
{
public:
    int findCircleNum(vector<vector<int>>& isConnected)
    {
        int n=isConnected.size();
        UnionFindSet _ufs(n);
        for(int i=0;i<n;i++)
        {
            for(int j=i+1;j<n;j++)
            {
                if(isConnected[i][j]==1)
                {
                    _ufs.Union(i,j);
                }
            }
        }

        return _ufs.SetSize();
    }
};
<4> 为什么从 j = i + 1 开始遍历
连接矩阵通常是对称矩阵:
cpp
isConnected[i][j] == isConnected[j][i]如果城市0和城市1相连,那么:
cpp
isConnected[0][1] == 1
isConnected[1][0] == 1
只需要处理其中一个位置即可。
另外,矩阵主对角线上的元素通常都是1:
cpp
isConnected[i][i] == 1它表示城市和自己相连,不需要进行合并。
因此,可以只遍历矩阵的上三角部分:
cpp
for (std::size_t j = i + 1; ...)这样能够避免重复处理。
4.2. 等式方程的可满足性
<1>. 题目描述
给定一个字符串数组 equations,每个字符串表示两个小写字母之间的关系。
表达式只有两种:
cpp
a==b
a!=b
其中:
-
a==b表示变量a和变量b相等; -
a!=b表示变量a和变量b不相等。
要求判断是否可以为这些变量赋值,使所有表达式同时成立。
例如:
cpp
["a==b", "b==c", "a==c"]可以满足,因为 a、b、c 可以取相同的值。
而:
cpp
["a==b", "b==c", "a!=c"]无法满足。
前两个表达式可以推出:
cpp
a == b == c但第三个表达式要求:
cpp
a != c两者发生矛盾。
<2> 解题思路
题目中的变量只有26个小写字母,因此可以建立一个包含26个元素的并查集:
cpp
a → 0
b → 1
c → 2
...
z → 25
整体处理分为两步。
第一步:处理所有相等关系
遍历所有表达式,将 == 两端的变量合并到同一个集合中。
例如:
cpp
a==b
b==c
处理后:
cpp
{a, b, c}它们拥有相同的根节点。
第二步:处理所有不等关系
再次遍历所有表达式,检查 != 两端的变量。
如果两个变量的根节点相同,说明前面的相等关系已经确定它们必须相等,但当前表达式又要求它们不相等,产生矛盾,返回false。
如果所有不等关系都没有发生冲突,就返回true。
<3> 为什么必须遍历两遍
不能按照表达式出现的顺序,一边处理相等关系,一边立即判断不等关系。
例如:
cpp
["a!=c", "a==b", "b==c"]如果第一次看到 a!=c 时立即判断,此时 a 和 c 还不在同一个集合中,看起来没有矛盾。
但是处理完:
cpp
a==b
b==c
之后,可以推出:
cpp
a==c此时就与 a!=c 冲突了。
因此必须:
-
先处理所有
==,建立完整的相等关系; -
再处理所有
!=,检查是否存在矛盾。
<4> 代码实现
cpp
class Solution
{
public:
    bool equationsPossible(vector<string>& equations)
    {
        vector<int> ufs(26,-1);
        auto findroot=[&ufs](int x){
            while(ufs[x]>=0)
            {
                x=ufs[x];
            }
            return x;
        };
        //将相等的放在一块
        for(auto&str:equations)
        {
            if(str[1]=='=')
            {
                int root1=findroot(str[0]-'a');
                int root2=findroot(str[3]-'a');
                if(root1!=root2)
                {
                    ufs[root1]+=ufs[root2];
                    ufs[root1]=root2;
                }
            }
        }
        //本次看看不相等的,如果不相等的root1和root2是同一个父节点
        //就说明之前在相等里面是相等的,说明发起了冲突
        for(auto&str:equations)
        {
            if(str[1]=='!')
            {
                int root1=findroot(str[0]-'a');
                int root2=findroot(str[3]-'a');
                if(root1==root2)
                {
                    return false;
                }
            }
        }

        return true;
    }
};
<5> 示例分析
给定:
cpp
["a==b", "b!=c", "c==a"]第一遍处理相等关系。
处理:
a==b得到:
{a, b}处理:
c==a得到:
{a, b, c}第二遍检查:
b!=c此时 b 和 c 的根节点相同,说明它们必须相等,但表达式要求它们不相等,所以返回:
false总结:
<1>.并查集是一种专门处理集合合并与查询问题的数据结构。
它使用数组表示森林结构:
-
数组下标表示元素编号;
-
根节点位置保存负数;
-
负数的绝对值表示集合大小;
-
非根节点位置保存父节点下标。
<2>.并查集的核心接口包括:
构造函数:初始化并查集,使每个元素分别属于一个独立集合。
FindRoot:沿着父节点向上查找,获得元素所在集合的根节点。
Union:查找两个元素的根节点。如果根节点不同,就将两个集合合并。
Count:统计数组中负数的数量,从而得到集合数量。
<3>.并查集主要用于解决以下类型的问题:
-
判断两个元素是否属于同一个集合;
-
合并两个集合;
-
统计互不相交的集合数量;
-
判断无向图中的连通关系;
-
统计连通分量;
-
处理具有传递性的等价关系。
<4>.在"省份数量"问题中,一个省份就是一个城市连通集合。将所有直接相连的城市合并后,并查集中的集合数量就是省份数量。
在"等式方程的可满足性"问题中,所有相等的变量应该属于同一个集合。先合并全部相等关系,再检查不等关系两端是否落在同一个集合中,就可以判断方程之间是否存在矛盾。
如果再结合按集合大小合并和路径压缩,并查集的操作效率会非常高,是解决连通性和集合合并问题时非常重要的数据结构。