论文题目: Reviving ConvNeXt for Efficient Convolutional Diffusion Models
中文翻译: 重振 ConvNeXt:面向高效卷积扩散模型的架构设计
会议: CVPR 2026
摘要: 近年来扩散模型越来越偏向 Transformer 主干,因为全注意力架构表现出很强的可扩展性。但卷积网络具备的局部归纳偏置、参数效率和硬件友好性,在现代生成模型中反而没有被充分研究。论文提出 Fully Convolutional Diffusion Model(FCDM),以 ConvNeXt 为核心重新设计条件扩散模型。FCDM-XL 在参数规模接近 DiT-XL/2 的情况下,只需要约一半 FLOPs,并在 ImageNet 256×256 和 512×512 上以显著更少的训练步数达到更优或有竞争力的生成质量。更重要的是,最大模型可以在 4 张消费级 GPU 上训练,说明现代 ConvNet 仍然是高效扩散建模的重要路线。
一、为什么扩散模型又要重新看卷积?
DiT 之后,扩散模型主干快速向 Transformer 靠拢。原因很直接:Transformer 结构统一、扩展方便,而且模型规模增大后性能通常持续提升。FLUX、MM-DiT 等模型进一步强化了这种趋势。
但代价同样明显:注意力计算随 Token 数增加而变重,高分辨率下显存、计算量和训练成本迅速上升。论文因此提出一个问题:
"可扩展性真的是 Transformer 独有的吗?"
作者重新审视 ConvNeXt。相比传统卷积网络,ConvNeXt 已经吸收了不少现代 Transformer 的设计思想,同时保留卷积的局部性和硬件效率。如果把它从分类网络重新改造成条件扩散模型,也许能够获得更好的性能---效率平衡。
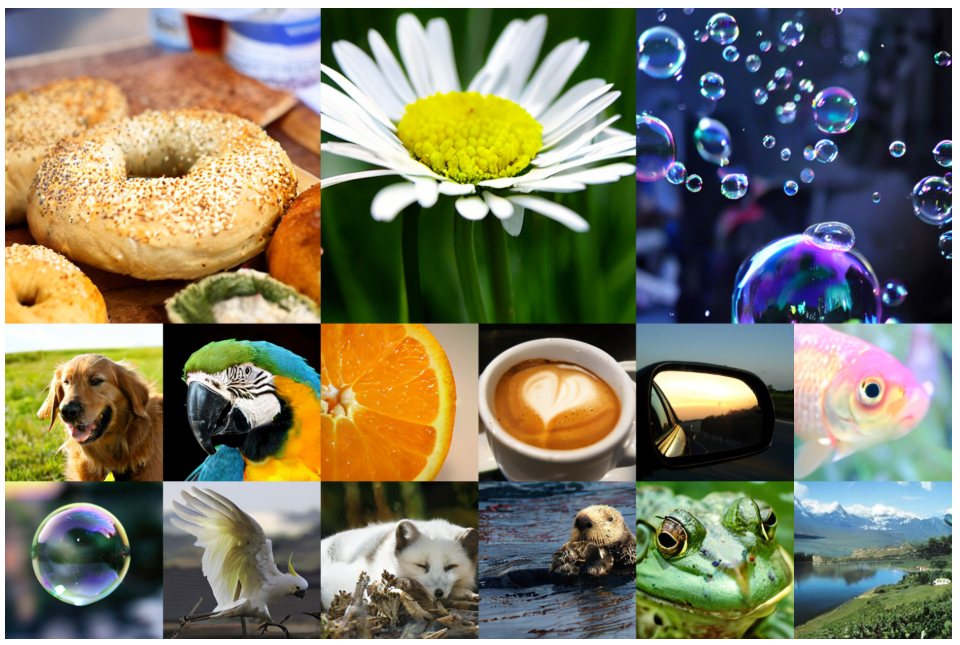
论文 Figure 1:FCDM-XL 在 ImageNet 256×256 和 512×512 上的生成样例
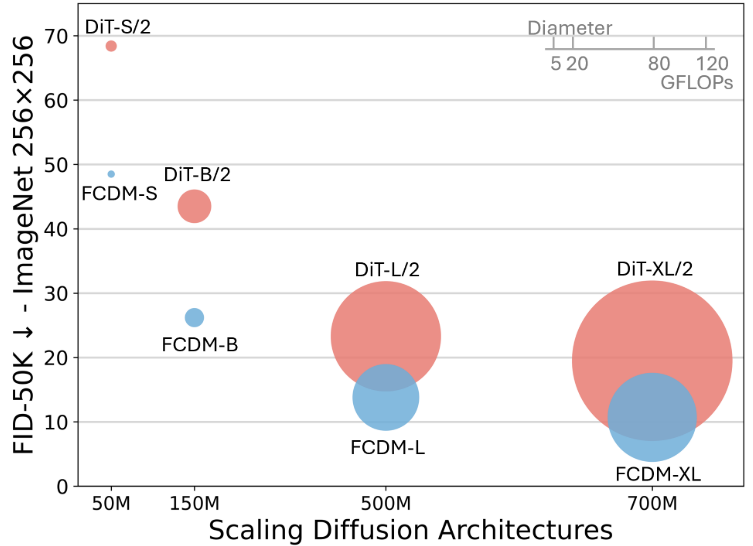
论文 Figure 2:不同模型规模下 FCDM 与 DiT 的 FLOPs、FID 和可扩展性对比
Figure 2 给出的结论很直观:从 Small 到 XL,FCDM 随模型规模增大持续降低 FID,而且在相近参数量下始终比 DiT 使用更少 FLOPs、收敛更快。
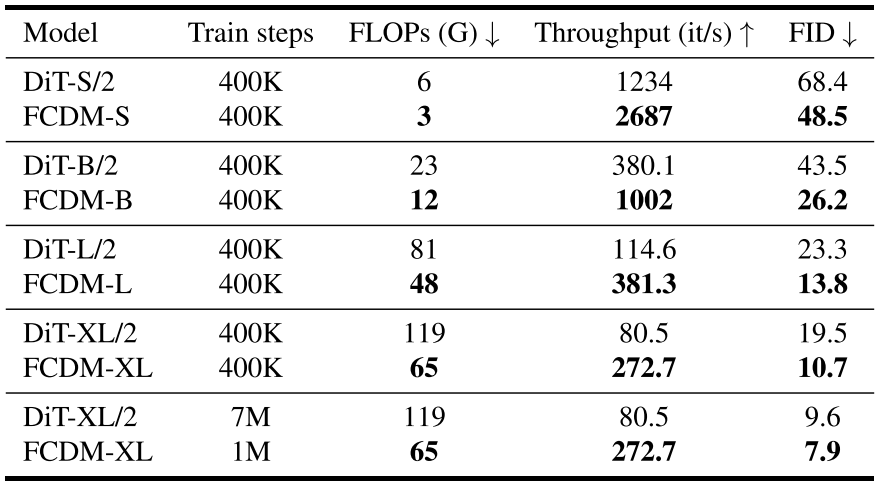
论文 Table 1:相同训练步数与不同模型规模下 FCDM 和 DiT 的效率、吞吐量与 FID 对比
例如 400K iterations 时,FCDM-XL 的计算量约为 65 GFLOPs 、吞吐量 272.7 it/s 、FID 10.7 ;DiT-XL/2 则约为 119 GFLOPs 、80.5 it/s 、FID 19.5 。继续训练到 1M steps 后,FCDM-XL 的 FID 达到 7.9,甚至优于训练 7M steps 的 DiT-XL/2(FID 9.6)。
二、FCDM:怎么把 ConvNeXt 改造成扩散模型?
FCDM 并不是简单把 DiT 的 Transformer Block 换成卷积,而是针对扩散模型重新组织 ConvNeXt。
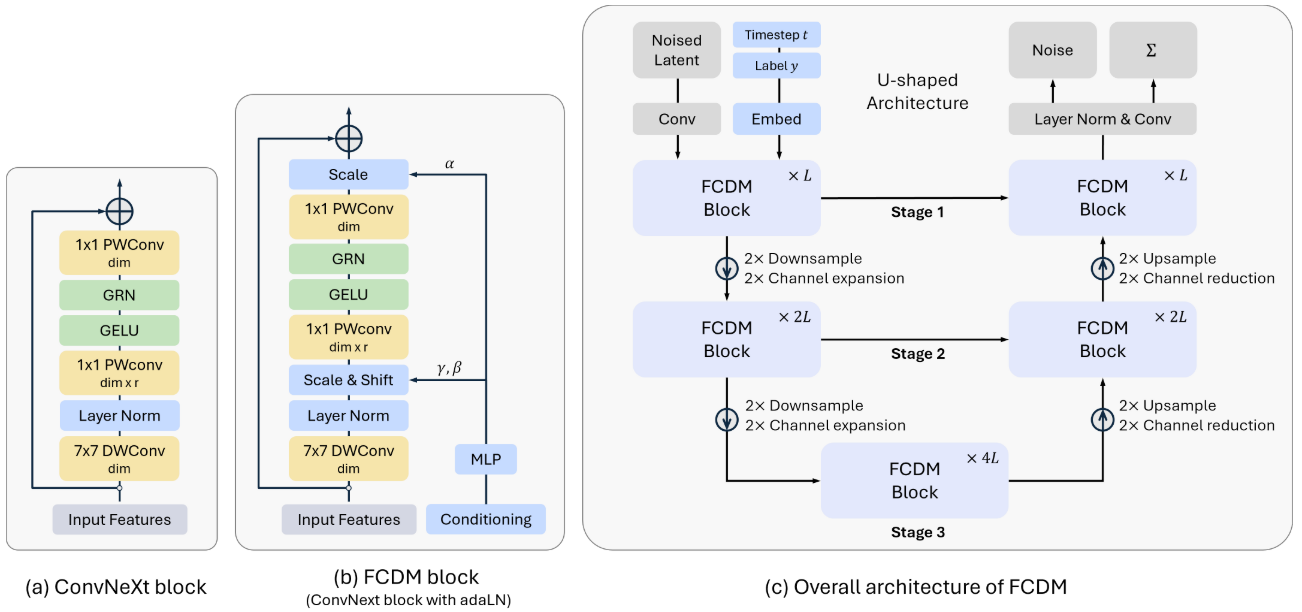
论文 Figure 3:ConvNeXt Block、FCDM Block 与完整 U-shaped FCDM 架构
2.1 保留 ConvNeXt 的核心 Block
原始 ConvNeXt Block 包含:
-
7×7 Depthwise Convolution;
-
LayerNorm;
-
两个 1×1 Pointwise Convolution;
-
Inverted Bottleneck 式通道扩张与压缩;
-
Global Response Normalization(GRN)。
其中大卷积核负责扩大有效感受野,Depthwise Conv 控制计算量,而倒置瓶颈让高维通道空间承担更多特征变换。
2.2 用 AdaLN 注入时间和类别条件
分类版 ConvNeXt 没有扩散模型需要的时间步和类别条件,因此 FCDM 将 LayerNorm 替换为 Adaptive LayerNorm(AdaLN)。
类别 Embedding 和 Timestep Embedding 先组合成条件向量,再通过轻量 MLP 产生 γ、β、α,用于调制归一化后的特征。与 DiT 类似,最终调制尺度 α 采用零初始化,从而提高深层网络训练稳定性。
所以 FCDM 保留的是 ConvNeXt 的局部卷积结构,但条件注入方式借鉴了现代扩散 Transformer。
2.3 U-shaped 架构,但只用两个超参数扩展
卷积网络天然适合 U-Net 式层级结构。FCDM 将 ConvNeXt Block 放入 Encoder---Decoder 结构,并通过 Skip Connection 将浅层高分辨率细节送到解码阶段。
它刻意避免复杂的"每一层分别配置多少 Block、多少 Channel"的手工设计,只保留两个主要缩放参数:Block 数量和隐藏通道数
每经过一次 2× Downsampling,L 和 C 都按规则扩展。因此从 FCDM-S、B、L 到 XL,只需要调整少数参数即可完成规模放大。
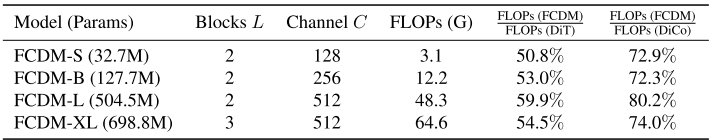
论文 Table 2:FCDM-S/B/L/XL 的参数量、Block、Channel 与 FLOPs
在参数量与 DiT 对齐后,FCDM 整体只使用大约 50% 的 DiT FLOPs ,同时约为 DiCo FLOPs 的 75%。例如 FCDM-XL 为 698.8M 参数,但只需 64.6 GFLOPs。
三、为什么比已有卷积扩散模型 DiCo 更高效?
作者还专门比较了当前卷积扩散模型 DiCo。
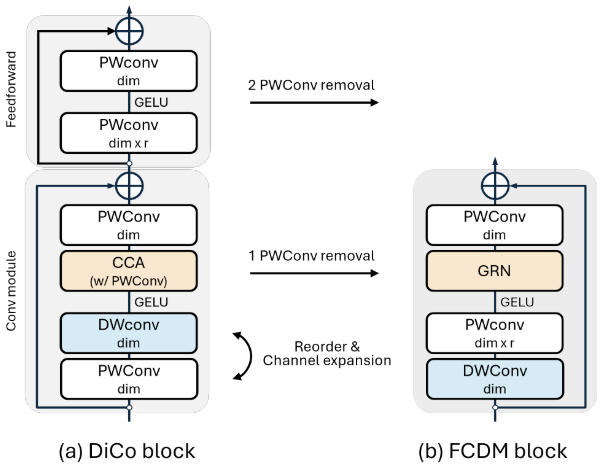
论文 Figure 4:DiCo Block 与 FCDM Block 的结构差异
两者都有 Depthwise/Separable Convolution,但 FCDM 有三个关键差异。
第一,先 Depthwise Conv,再做通道扩张。这样 7×7 Depthwise Conv 始终在较低通道维度上执行,扩张后的高维空间主要交给 1×1 Conv 处理,因此既保留较大感受野,又不会因为通道膨胀显著增加大卷积核成本。
第二,FCDM 使用 GRN 代替 DiCo 的 Compact Channel Attention(CCA)。二者都希望减少通道冗余、增强不同通道响应,但 CCA 需要额外 1×1 Conv,而 GRN 主要由 L2 Normalization 和 Response Normalization 构成,更轻量。
第三,FCDM 不再额外增加 Feedforward Module。因为 Inverted Bottleneck 本身已经完成通道扩张和非线性变换,再堆 FFN 反而会带来冗余。
因此这篇论文的核心并不是"卷积一定比 Transformer 强",而是说明:如果重新设计卷积 Block,ConvNeXt 的局部计算和层级结构可以非常适合扩散模型。
四、实验设置:尽量只比较"架构本身"
论文在 ImageNet-1K 上进行 Class-Conditional Latent Diffusion 实验,分辨率包括 256×256 和 512×512。
训练基本沿用 DiT 的标准设置:
-
AdamW;
-
Learning Rate:1×10^-4;
-
Batch Size:256;
-
无 Weight Decay;
-
仅使用 Horizontal Flip;
-
EMA Decay:0.9999;
-
Diffusion Timestep:1000。
评测时生成 50K 张图像,使用 250 个 DDPM Sampling Steps。主要指标是 FID,同时报告 IS、Precision 和 Recall。
计算资源上,FCDM-XL 在 256×256 下可以用 4 张 RTX 4090 24GB、Global Batch Size 256 训练,速度约 0.9 it/s;论文还验证了 Batch Size 256 可以放入单张 A100 40GB。
这部分很重要,因为文章重点不是刷新绝对最强 FID,而是验证:在相对常规的 DiT 训练框架下,架构本身能不能显著降低生成成本。
五、主实验:更少 FLOPs、更高吞吐、更快收敛
5.1 从 Small 到 XL,卷积同样能 Scaling
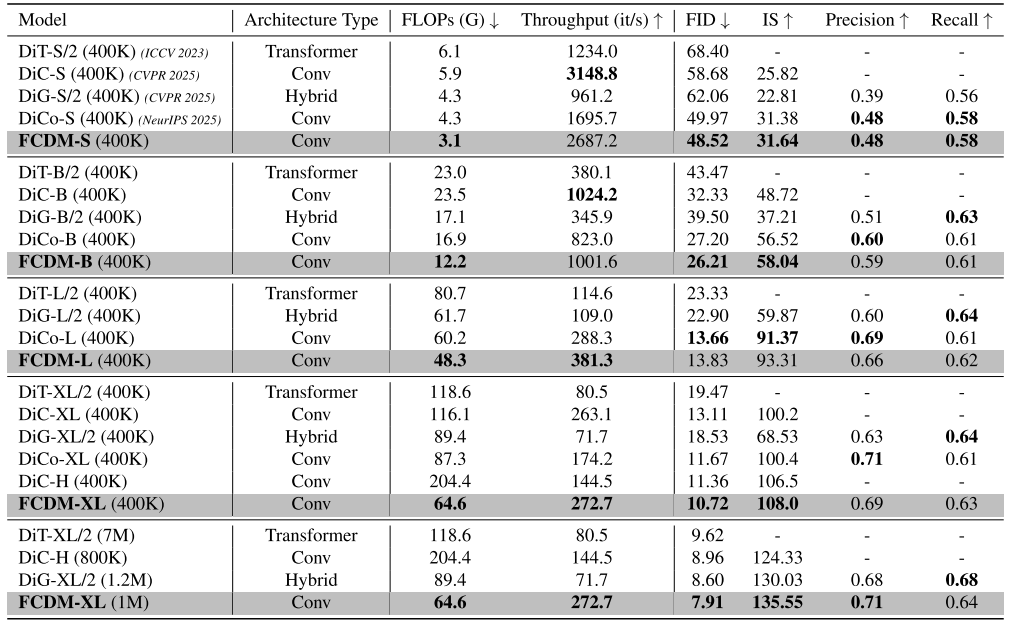
论文 Table 3:ImageNet 256×256 上不同尺度模型的生成质量与效率比较
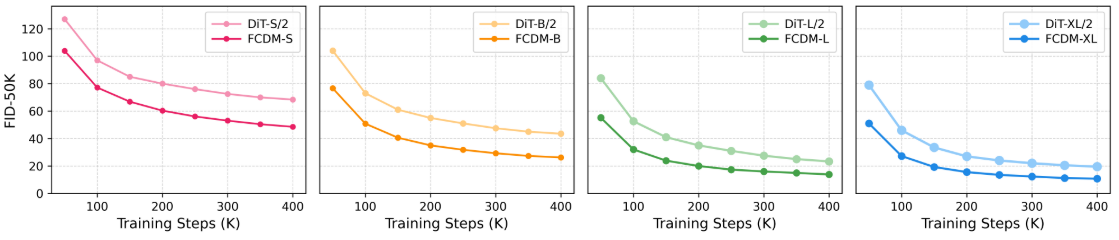
论文 Figure 5:FCDM 与 DiT 在不同模型规模下的 FID 收敛曲线
400K steps 下:
-
FCDM-S:FID 48.52
-
FCDM-B:FID 26.21
-
FCDM-L:FID 13.83
-
FCDM-XL:FID 10.72
模型越大,FID 持续下降,没有出现"卷积网络扩不动"的现象。
更关键的是 FCDM-XL 在 1M steps 时达到 FID 7.91 ,计算量只有 64.6 GFLOPs ,吞吐量 272.7 it/s。同表中的 DiT-XL/2 即使训练 7M steps,FID 仍为 9.62,而且单次计算为 118.6 GFLOPs、吞吐只有 80.5 it/s。
这说明 FCDM 的优势同时来自两层:
单步训练更便宜 + 达到目标质量需要的训练步数更少。
5.2 256×256:性能和效率一起看
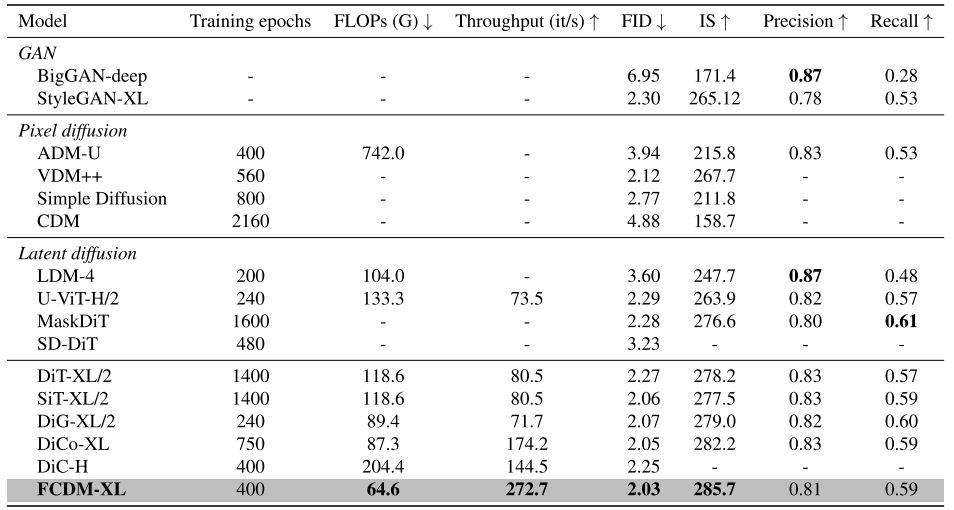
论文 Table 4:ImageNet 256×256 Class-Conditional Generation Benchmark
加入 Classifier-Free Guidance 后,训练 400 epochs 的 FCDM-XL 达到:
-
FID:2.03
-
IS:285.7
-
FLOPs:64.6G
-
Throughput:272.7 it/s
其 FID 与 SiT、DiCo 等强基线处于同一水平甚至略优,但单次 FLOPs 和吞吐明显更有优势。
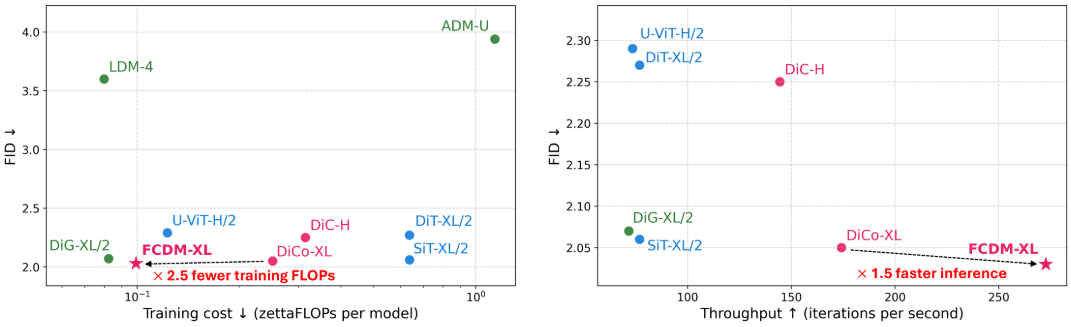
论文 Figure 6:FID 与总训练成本、FID 与吞吐量的联合比较
Figure 6 更能体现作者想强调的点:FCDM 位于"较低训练成本 + 较高吞吐 + 较低 FID"的优势区域。与 DiCo 相比,论文指出 FCDM 可以用约 2.5× 更少的总训练 FLOPs 取得有竞争力的生成性能,并获得约 1.5× 更高的推理吞吐。
不过作者也明确说明:FCDM 目前并没有超过 EDM-2、Simpler Diffusion 等最新绝对 SOTA。因此它的卖点应理解为性能---效率权衡,而不是单纯追求最低 FID。
5.3 512×512:分辨率越高,卷积优势越明显
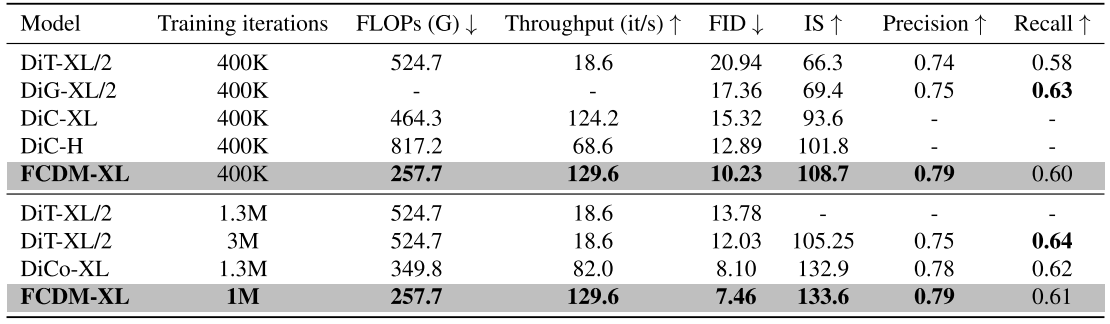
论文 Table 5:ImageNet 512×512 上的生成质量与效率对比
在 512×512 下,FCDM-XL 400K steps 已达到 FID 10.23 ;训练到 1M steps 后,FID 进一步达到 7.46 ,FLOPs 为 257.7G ,吞吐量 129.6 it/s。
相比之下,DiT-XL/2 的计算量为 524.7G,吞吐仅 18.6 it/s;即使训练到 3M steps,表中 FID 仍为 12.03。
论文还指出,当分辨率从 256 翻倍到 512 时,DiT 吞吐下降约 4× ,而 FCDM 只下降约 2×。这正体现了 Attention 与局部卷积在高分辨率下计算复杂度的差异。
六、消融实验:ConvNeXt 的哪些设计真的重要?
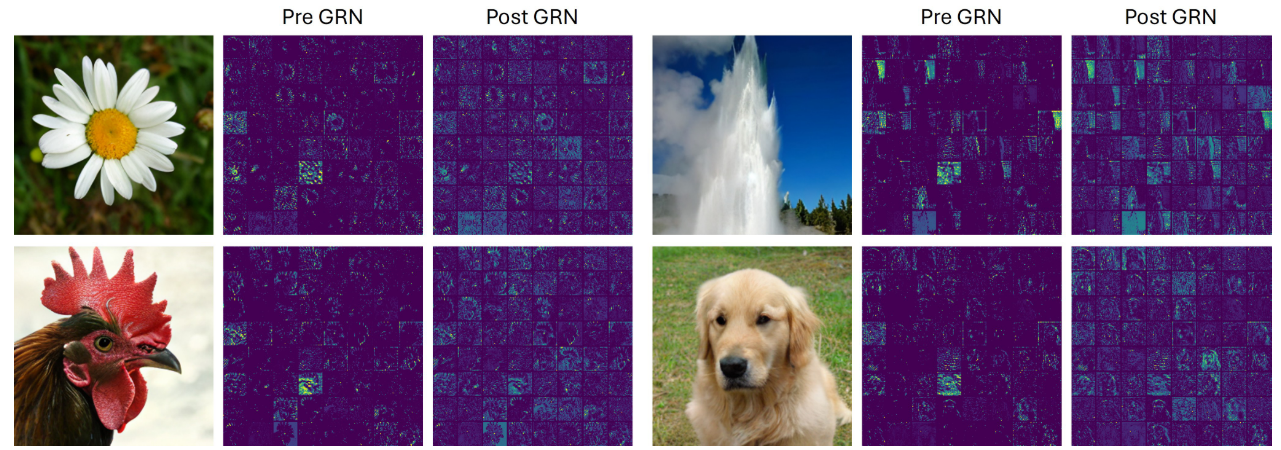
论文 Figure 7:GRN 前后 Feature Activation 可视化
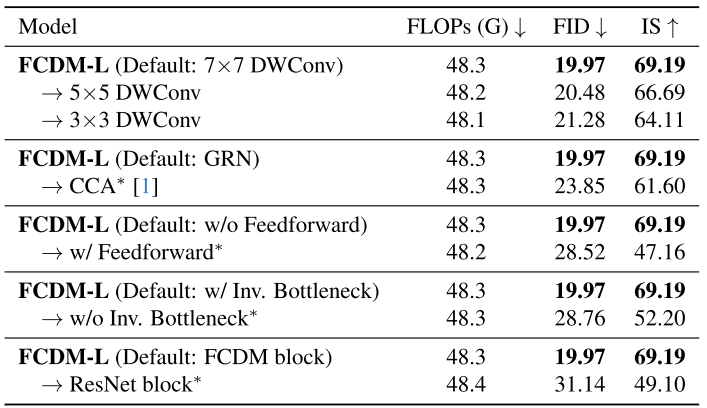
论文 Table 6:卷积核大小、GRN、Feedforward、Inverted Bottleneck 与 Block 设计消融
默认 FCDM-L 使用 7×7 DWConv,在 200K steps 下 FID 为 19.97。改成 5×5 后变为 20.48,3×3 后进一步变为 21.28,说明大卷积核带来的更大有效感受野确实重要。
将 GRN 替换成 DiCo 的 CCA 后,FID 恶化到 23.85。Figure 7 也显示,GRN 能明显降低不同 Feature Channel 之间的冗余。
几个更激进的消融下降得更明显:
-
加入额外 Feedforward:FID 28.52
-
去掉 Inverted Bottleneck:FID 28.76
-
将 FCDM Block 换成 ResNet Block:FID 31.14
这些结果说明,FCDM 的性能不是"只要用卷积就行",而是依赖 ConvNeXt 的一整套现代化设计:大核 Depthwise Conv + Inverted Bottleneck + GRN + 简洁 Block 结构。
七、总结与思考
FCDM 最值得记住的观点是:
扩散模型的 Scaling 并不专属于 Transformer。
作者把 ConvNeXt 重新设计为条件扩散 Backbone,通过 AdaLN 注入条件、U-shaped 层级结构保持多尺度信息,再利用大核 Depthwise Conv、Inverted Bottleneck 和 GRN 构建高效 Block。结果表明,在与 DiT 对齐参数量的情况下,FCDM 大约只需要一半 FLOPs,同时拥有更高吞吐和更快 FID 收敛。
这篇论文真正挑战的是一个近年来越来越默认的前提:生成模型要继续 Scaling,就必须依赖越来越大的 Transformer。
FCDM 给出的答案更克制:Transformer 当然很强,但现代 ConvNet 的局部归纳偏置和硬件效率并没有失效。尤其在高分辨率和有限 GPU 资源下,卷积架构仍可能提供非常有竞争力的路径。
从工程角度看,这一点尤其值得关注。FCDM-XL 能在 4 张 RTX 4090 上训练,在 512×512 下仍保持明显吞吐优势;与此同时,它并没有依赖复杂的新训练目标,而主要通过 Backbone 设计获得收益。
所以这篇工作的价值并不只是"ConvNeXt 又赢了一次",而是在提醒我们:
当一个领域的主流架构逐渐收敛到 Transformer 时,重新检查被忽略的归纳偏置和硬件特性,有时比继续堆计算量更值得。