目录
- 前言
- 一、问题定义:为什么"五关全过"不等于"金融级过"
- 二、核心方案:五关之上,再叠一层"决策级举证"
-
- [2.1 四可核对表(本篇的骨架)](#2.1 四可核对表(本篇的骨架))
- [2.2 四可逐个说清"它会怎么卡你 + 你该拿什么去核"](#2.2 四可逐个说清“它会怎么卡你 + 你该拿什么去核”)
- [2.3 判据复用表:三可的判据前篇全立过,第四可(不可抵赖)是金融级新增、心智接第 12 篇](#2.3 判据复用表:三可的判据前篇全立过,第四可(不可抵赖)是金融级新增、心智接第 12 篇)
- [2.4 外层监管层:只给边界,不重建立五关](#2.4 外层监管层:只给边界,不重建立五关)
- [2.5 三个取舍点(每个都有代价)](#2.5 三个取舍点(每个都有代价))
- [2.6 边界:这篇不是什么](#2.6 边界:这篇不是什么)
- 三、代码实战:一个纯标准库的金融级决策审计链核对器
-
- [3.1 数据结构:决策是数据,不是一行日志](#3.1 数据结构:决策是数据,不是一行日志)
- [3.2 哈希链那一刀:一改就断链、一断全废](#3.2 哈希链那一刀:一改就断链、一断全废)
- [3.3 可复现是"版本对得上",不是"逐字一致"](#3.3 可复现是“版本对得上”,不是“逐字一致”)
- [3.4 主核对:先验链、再逐笔核四可](#3.4 主核对:先验链、再逐笔核四可)
- [3.5 9 个断言怎么把这些结论钉死](#3.5 9 个断言怎么把这些结论钉死)
- 四、踩坑记录:这三个坑,每个都真付过费
-
- [4.1 我以为"记了日志"就=可审计,结果审计员一句"这日志能改吗"把我问住](#4.1 我以为“记了日志”就=可审计,结果审计员一句“这日志能改吗”把我问住)
- [4.2 客户投诉要我复现三个月前那笔拒绝决策,我复现不出来](#4.2 客户投诉要我复现三个月前那笔拒绝决策,我复现不出来)
- [4.3 出了事要追责,我发现"申请人"和"审批人"是同一个人](#4.3 出了事要追责,我发现“申请人”和“审批人”是同一个人)
- 五、选型对比:三种做法,你该抄哪一种
-
- [5.1 大表:金融级"决策可举证"这条路的三种做法](#5.1 大表:金融级“决策可举证”这条路的三种做法)
- [5.2 副表:金融级决策可举证的监管口径现状(2026,口径与期限待核实)](#5.2 副表:金融级决策可举证的监管口径现状(2026,口径与期限待核实))
- [5.3 可复用 checklist:金融级 AI 决策可举证 8 问](#5.3 可复用 checklist:金融级 AI 决策可举证 8 问)
- [六、总结 + 下一篇预告](#六、总结 + 下一篇预告)
- [附录 A:四可 → 判据 → 依据出处 → 对应前篇](#附录 A:四可 → 判据 → 依据出处 → 对应前篇)
- [附录 B:金融级决策可举证的监管口径现状表(2026,全标"待核实")](#附录 B:金融级决策可举证的监管口径现状表(2026,全标“待核实”))
- [附录 C:可引用公开口径清单(口径与条文以官方原文为准)](#附录 C:可引用公开口径清单(口径与条文以官方原文为准))
- [附录 D:审计链算法说明](#附录 D:审计链算法说明)
前言
上一篇《政企国产化避坑》结尾我留了一句话:"政企国产化讲的是'东西能不能进来、谁来扛';金融级讲的是'每个决策能不能被审计、能不能被追责'------同一套工程纪律,在金融行业要被逼到什么程度。"今天来还这笔账。
先说个让我脸上挂不住的事。我交付过一个金融客户的 AI 审批项目,政企那五关我全按第 16 篇的核对器过了一遍------合规过了、信创逐家核了、运维排了人、原厂维保也签了,我自认为交得漂亮。结果有一天,客户一笔 AI"拒绝放款"的决策被投诉到了监管,监管来函,要我把那笔决策复现一遍:当时是谁调的、命中了哪条规则、模型是哪一版、谁批的、这条记录有没有被改过。
我打开日志,只有一行"审核未通过"。 那一刻我才知道:政企那五关,问的是"这套系统能不能上线";金融 AI 落地问的是另一件事------"这套系统做的每一笔决策,能不能拿出来举证" 。这一篇就把这一层补上。
一、问题定义:为什么"五关全过"不等于"金融级过"
第 16 篇那五道关,我核得很认真。可它核的全是"系统级"的东西:这套系统能不能进来、谁来扛它------上线前和交付时的事。金融级问的是"决策级":这套系统上线之后,它做的每一笔放行、每一笔拒绝,事后能不能自证。 这两个问题之间隔着一整层,我原来把它们混成了一件。三个误区,一个比一个贵。
误区一:把审计当成"日志"。 我当时的想法很朴素:每次决策我都记了日志------谁调的、什么时候、结果是什么,一应俱全,这不就是可审计吗?后来内部审计的人只问了我一句:你这日志存在哪、谁能改、你怎么证明现在给我看的这条就是当时那条?我一下哑了。日志就在业务库里,运维能改、开发能删,我拿不出任何"这条记录没被动过"的证明。能被改的日志,不叫证据。
误区二:把合规当成"系统过等保就行"。 我一开始觉得系统过了等保、过了密评,合规这块就齐了。错。系统级合规 ≠ 决策级举证------系统过了等保,不代表它做的某一笔决策说得清"是谁、凭什么"。等保管的是这台机器安不安全,管不了"这一笔放款为什么批"。
误区三:把可复现当成"重跑一遍"。 我一度以为复现就是拿今天的数据再跑一遍。真去复现才发现:模型升级过、Prompt 改过好几轮,我用今天的版本怎么跑都对不上当时那笔;就算版本没换,LLM 本身也有随机性。重跑 ≠ 复现------复现的标准要提前定义,金融里通常是"关键依据一致",不是"逐字一致"。
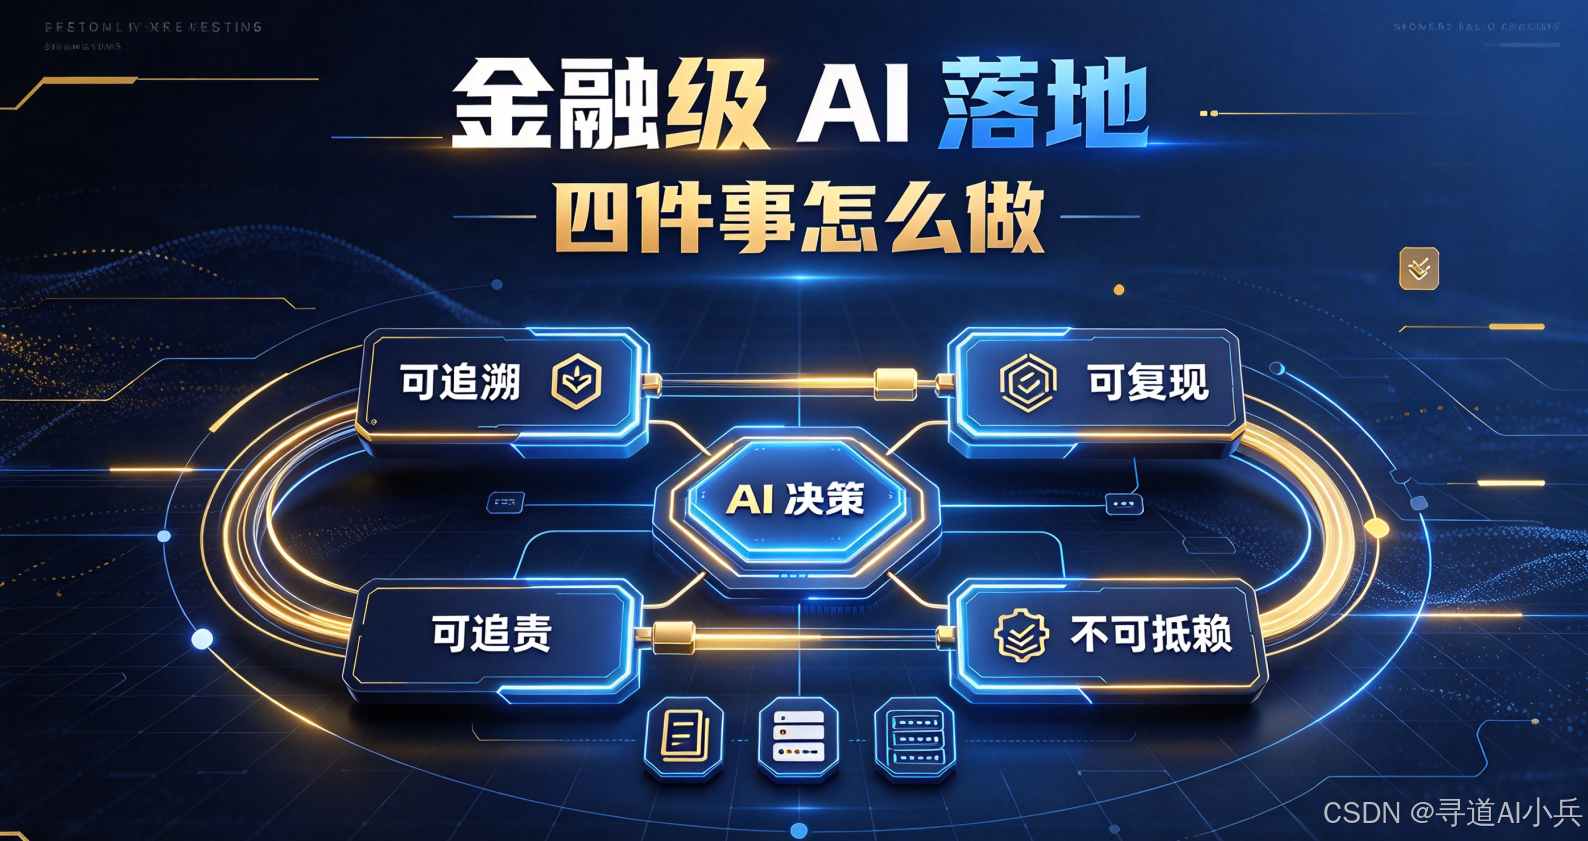
先把结论撂这儿:金融级 AI 落地 = 政企五关(系统级)之上,再叠一层"决策级举证"的四可------① 可追溯(谁调的/谁批的/走了哪条路)→ ② 可复现(用当时那一版三元组,能证明当时凭什么这么判)→ ③ 可追责(追到具体责任人,且申请人 ≠ 审批人)→ ④ 不可抵赖(记录防篡改,一改就断链、一断全废)。四可缺一件,你那堆日志就只是一堆能被改的字符串,举不了证。 落点是一个纯标准库、离线可跑、可断言的"金融级决策审计链核对器"。
举个最具体的例子,把"系统级"和"决策级"这一刀切干净。 我这套信贷审批系统,等保过了、密评过了、日志也打了------从"系统"这一层看,它是一套合规的系统,第 16 篇那五关我核得挑不出毛病。可监管来函要的是那一笔 拒绝的答案:命中了哪条规则、模型是哪一版、谁批的、这条记录有没有被动过。这两件事隔着整整一层:系统级通过,回答的是"这台机器安不安全、能不能上线";决策级通过,回答的是"它做的这一笔 决定站不站得住"。我原来拿前者的答案去回后者的问,所以才在监管来函面前一句话都答不上来------这也是本篇跟第 16 篇最大的不同:那五关是上线前和交付时的系统级准入,这四可是上线后每一笔决策的决策级举证。
二、核心方案:五关之上,再叠一层"决策级举证"
整篇的主线就一句:第 16 篇给了我一套政企五关、一个能核的核对器------可那五关全是"系统级"的,管的是这套系统能不能上线、谁来养它。金融级管的是另一层:"决策级"------这套系统做的每一笔决策,事后能不能自证。这一篇在五关之上叠一层"四可",每一可的判据全是前几篇在真实场景里立过的,我一个不新造。
第 16 篇政企五关(系统级:这套系统能不能进来、谁来扛)
  ① 合规关 ② 信创关 ③ 运维关 ④ 适配关 ⑤ 支持关 ------ 管的是"上线前 + 交付时"
   │
   ▼  金融级在它之上再加一层(本篇):这套系统做的每一笔决策,能不能自证
   │
金融级增量 = "决策级举证"的四可(每一笔放行/拒绝,都要过这四关)
  ① 可追溯 ------ 谁调的、谁批的、走了哪条路           ← 接第 8 篇 Trace(可观测 → 可举证)
  ② 可复现 ------ 用当时那一版三元组,能证明当时凭什么 ← 接第 12 篇版本不可变 + 第 13 篇模型是耗材的正面冲突
  ③ 可追责 ------ 追到具体责任人,且申请人 ≠ 审批人      ← 接第 10 篇"放行/拒绝都可追到是谁"
  ④ 不可抵赖 ------ 记录防篡改,一改就断链、一断全废     ← 金融级增量核心(接第 12 篇指纹心智)
   │
   ▼  每一可的判据,全部复用前几篇立过的(不新造)
   │
落点:一个能核对的东西(这是本篇区别于"金融 AI 软文"的关键)
  决策记录数据(DecisionRecord:决策 id + 输入指纹 + 三元组版本 + 依据 + 操作人/审批人/责任人 + 前序链哈希)
        ├──► render_audit_table():把决策链渲染成人看的「决策审计表」(表给人看)
        └──► audit_all(records):逐笔核对 → PASS/FAIL/PENDING/NEEDS_HUMAN + 断链点
                               → 确定性吐出「这一笔能不能上法庭 + 断链在哪 + 待人工确认清单」
  一句话:表给人看,程序给人核;两者共用同一份数据,所以不会打架。
先点破这一刀:系统级通过 ≠ 决策级通过。 我把政企五关全过了一遍,不等于金融级过了------它们问的是两个问题。五关问"这东西能不能进我的网、谁来养",四可问"它做的那一笔决定,出了事我能不能自证清白"。顺序也不能反:先过五关、再叠四可 ------系统都进不来,谈决策级举证是空的。这是第 16 篇"先过边界、再谈性能"在金融语境里的续写:先能举证、再谈性能。
2.1 四可核对表(本篇的骨架)
整篇里这张表最实用,你可以直接抄走。每一可的判据都标了出处,坐实"判据复用、不新造"。
| 四可(金融问的第一个问题) | 它会怎么卡你 | 你该拿什么去核 | 判据来源(前篇立过的) |
|---|---|---|---|
| ① 可追溯 | 只有结果没过程 → 说不清"谁做的、凭什么做的" | 决策留痕:接入链路 + 操作人 + 审批人 + 命中规则 | 第 8 篇《OTel + LangFuse 全链路 Trace》"Trace = 谁调的、谁批的、走了哪条路可回溯"+ 第 2 篇《Golden Set 评测》评测记录 |
| ② 可复现 | 模型/Prompt/数据版本漂了 → 用当时的版也证明不了 | 三元组版本指纹 + 依据快照(冻结、可归档,不要求逐字一致) | 第 12 篇《数据工程底座》"版本不可变"+ 第 13 篇《LLMOps 不完全指南》"模型是耗材 / 指针级回滚的正面冲突" |
| ③ 可追责 | 申请人=审批人 / 责任人字段缺失 → 追不到具体的人 | 责任人字段 + 职责分离(申请人≠审批人)+ 审批留痕 | 第 10 篇《Human-in-the-Loop 反馈闭环》"放行/拒绝都能追到是谁、凭什么" |
| ④ 不可抵赖 | 日志能被改/删/补 → 拿出去举不了证 | 哈希链:记录防篡改------改一处,后面整段对不上(防篡改 + 可验证) | 金融级新增(增量核心;指纹心智接第 12 篇《数据工程底座》"版本不可变") |
2.2 四可逐个说清"它会怎么卡你 + 你该拿什么去核"
① 可追溯:不是"有没有记",是"记下来能不能说清是谁、凭什么"。 这一可的判据最直接------第 8 篇立过的全链路 Trace:"谁调的、谁批的、走了哪条路可回溯"。金融级只是把它从"可观测"推成"可举证":Trace 过去是给你自己排查问题看的,现在要能原样交出去当证据。所以一条决策记录里,必须有操作人、有命中的规则/引用的条款(我叫它 grounds)、有输入指纹。少了"凭什么",审计员问一句你就哑。这一可有强监管锚 :信贷场景的《商业银行互联网贷款管理暂行办法》要求风险模型全过程文档化归档、供本行和监管随时查阅;2025 年底的《银行业保险业数字金融高质量发展实施方案》又把"提升算法透明度和可解释性"统一提了一遍。但要说清楚------它是"原则性表述 + 分场景强制留痕",没有一条专门叫"AI 决策可追溯"的技术标准。
② 可复现:弱锚,只有框架的原则性要求------所以我把标准定成"关键依据一致"。 这一可跟第 13 篇"模型是耗材、随时换"天生打架,我在取舍点③展开。这里先说判据:第 12 篇的"版本不可变"给了它心智------用当时那一版三元组(模型/Prompt/数据),能证明当时凭什么这么判。注意"证明"两个字:可复现不是要你把老模型养一辈子真跑,是要你留一条"能证明当时凭什么这么判"的最小链。 监管侧这一可最弱------只有模型风险管理框架的原则性要求(验证、监控、文档化),没有"必须逐字复现 AI 决策"的强制条款。所以我照取舍点③写:分层、关键依据一致,不苛求逐字。
③ 可追责:有强监管锚,而且"申请人 ≠ 审批人"这条能直接挂上去。 第 10 篇立过"每一次放行/拒绝都能追到是谁、凭什么";金融把它推成硬约束:不仅"能追到",还要"追到的是被分开的两个角色"。《商业银行内部控制指引》要求不相容岗位分离、重要岗位轮岗------"申请人 ≠ 审批人"这条,直接挂"不相容岗位分离"(条文编号进附录)。再加金融监管总局"谁使用谁负责"的原则:AI 不背锅,人和机构是最终责任主体。所以可追责就是三件事:责任人字段必填、有独立的人工审批留痕、申请人 ≠ 审批人。这三件缺一件,出了事你就追不到具体的人。
④ 不可抵赖:这条得正面说清楚------它是"工程自保",不是"监管强制"。 这是全篇最容易得罪人、也最容易被审稿盯的一刀,我不绕:目前没有"金融 AI 决策日志必须防篡改/哈希链"的强制技术标准。 我翻了一圈公开口径,能挂上的只有"密码学手段"的技术参照------区块链存证、可信时间戳、金融分布式账本安全这一类国标/行标,它们定义的是"怎么用哈希/时间戳做存证、防篡改、可核验",但都不是"金融 AI 决策日志"的强制要求 。所以这一可的定位是:我做哈希链,是为了让记录"改了你验得出来",是工程上的自保,不是满足某个必须过的监管条款。 你被审计员问"这日志能改吗"的时候,能当场自己验一遍------这就够了。别把工程自保吹成监管强制,这是这一篇最要紧的诚实。
2.3 判据复用表:三可的判据前篇全立过,第四可(不可抵赖)是金融级新增、心智接第 12 篇
这张表的信任来源就在这儿:上面每一可的判据,都是前面某一篇在真实场景里立过的,我不是临时编一套标准来评金融。
| 可 | 判据来源(前篇立过的) | 一句话 |
|---|---|---|
| 可追溯 | 第 8 篇《OTel + LangFuse 全链路 Trace》 | Trace = 谁调的、谁批的、走了哪条路可回溯(可观测 → 可举证) |
| 可追溯 | 第 2 篇《Golden Set 评测》 | "当时那版凭什么被评过",评测记录也是决策链的一部分 |
| 可复现 | 第 12 篇《数据工程底座》 | 版本不可变:用当时那一版能证明当时凭什么这么判 |
| 可复现 | 第 13 篇《LLMOps 不完全指南》 | 模型是耗材 → 与"能复现"正面冲突,解法是分层留最小举证集 |
| 可追责 | 第 10 篇《Human-in-the-Loop 反馈闭环》 | 放行/拒绝都能追到是谁、凭什么 → 推成"责任人 + 职责分离" |
| 不可抵赖 | 第 12 篇《数据工程底座》 | 内容指纹当身份:能被验证的才是真的 → 哈希链 |
| 增量边界 | 第 16 篇《政企国产化避坑》 | 五关是系统级、四可是决策级;系统级通过 ≠ 决策级通过 |
| 全局映射 | 开篇《四大支柱》 | 金融级不是新框架,是四大支柱被监管逼到举证级 |
2.4 外层监管层:只给边界,不重建立五关
四可外面还压着一层监管约束:留痕期限、双录、报送、等保密评更严、数据分级、容灾高可用、职责分离。这些我一个都不展开------它们是第 16 篇和附录的活,本篇只点边界,且口径全标待核实:
- 留痕期限 :没有统一数字,取决于留的是什么------双录、反洗钱交易记录、生成式 AI 日志各是一档,"AI 决策留痕"本身没有专属统一期限。
- 双录:强制要求锚在"销售行为"上,"AI 决策要不要双录"核不到统一强制口径,目前是团体标准和厂商方案。
- 报送:对外/有舆论属性的 AI 可能触发算法备案、仅内部使用一般豁免,"金融 AI 是否必然触发"口径未统一(待核实)。
- 等保/密评:金融系统等保、密评要求更严,具体等级按机构与系统定(口径统一、等级按系统,待核实)。
- 数据分级:有明确标准(标准侧五级、监管侧三级四类两套颗粒度),敏感级数据进测试环境要脱敏、到期限要删到不可恢复。
- 容灾:金融核心系统有公开的灾难恢复等级口径,两地三中心是优选架构(厂商口径,待核实);AI 决策审计链是信息系统的一部分,套同一套口径,不因是大模型单独给个标准。RTO/RPO 具体数值只给量级、一律待核实。
- 职责分离:有明文依据(不相容岗位分离),已落到四可③里。
这张清单的生产化,就一句话:一张"监管维度 × 依据 × 口径 × 核实日期"的数据表 + 一个核对器。 本篇 demo 的两张数据表(决策记录 DecisionRecord + 审计要求 Policy)就是它的最小 schema------换成你们机构真实的口径数据,加个前端,它就是你们机构的"决策审计平台"。
还有一件事得单独说:判定是四态 ,不是两态。金融的现实是"很多事你核不到确定答案"------留痕期限到底留几年、AI 决策要不要双录,这些都没有统一口径。只给 PASS/FAIL 的核对器会逼你替监管编一个答案;四态让"我不知道"成为合法结论,并把这些"我不知道"单独收进一张待人工确认清单 ,交接给合规口和法务去补。一个诚实的审计链,不只告诉你哪些笔能自证,还要把"我不确定的那部分"原样交出来------少了这一条,"金融级"三个字就站不住。
再说清"四可"这个词:它是我为了"能对着核"做的工程化归纳,不是某个监管文件的官方分类。 但它不悬空------可追溯/可复现能挂到算法金融应用评价规范的评价判据上,可追责挂不相容岗位分离,不可抵赖挂区块链存证/可信时间戳的国标参照,整体还能对到模型风险管理的"验证---监控---文档化"框架。我不发明官方口径,我只是把"金融落地时你每一笔决策都得挨个核的那四件事"编成一张能核的表。
2.5 三个取舍点(每个都有代价)
取舍一:"能举证 > 跑得动"------金融级的第一性是"事后能自证",不是"事前跑得快"。 互联网/政企通用场景,第一性是"能不能用、快不快、谁来扛";金融级要把它翻过来------一笔决策哪怕被判"拒绝",也必须是可举证的拒绝 (凭什么拒、依据哪条规则、谁批的)。所以系统要在正常业务链路上额外挂一条"举证链"(决策留痕 + 防篡改 + 可复现),这条链会在延迟、吞吐、成本上收税。代价我认三条 :① 每条决策都要落审计记录 + 算链哈希,写放大、延迟增加(量级随实现浮动,本行只定性、不编数字);② 为了可复现,三元组版本得冻结、不能随便热更,发布自由度下降(跟第 13 篇"模型是耗材"直接顶牛);③ 职责分离强制多加一道人工审批,业务流程变长、人效下降。我认,因为在金融,一笔"说不清凭什么"的放行,比一笔慢 200ms 的放行危险不在一个量级------前者出事你举不了证,责任就落你自己头上。
取舍二:"不可抵赖"要靠密码学,不是靠"我日志里写了"------但它是工程自保、不是监管强制。 很多团队以为"我记了日志 = 可审计",可日志能被改、能被删、能对不上。金融级要的是不可抵赖 :决策记录必须防篡改(哈希链/签名),一改就断链、一断就全废,还得能证明"这条记录就是当时那条"。第 12 篇那句"能被验证的才是真的",搬到日志上就是哈希链:记录不是写下来就算数,是能被验证才算数。 但必须说清------金融对"AI 决策日志必须防篡改"没有统一强制技术标准,只有密码学手段的国标/行标当技术参照,所以这条是工程自保。你的哈希链做的是让记录"改了你验得出来",不是满足某个必须过的监管条款。代价: ① 哈希链/签名带来额外计算和存储(每次决策一次哈希、密钥得管);② 密钥管理本身是个大活(丢了/轮换了,历史链怎么验,得提前设计);③ 链一旦定死就难回改------记录顺序、字段口径得一次定对,事后补一条或改一个字段,从断点往后全链重算。我认,因为谁都能改的日志是自说自话------对方一句"这日志是不是事后补的"就把你问住。**
取舍三:"可复现"跟"模型是耗材"天然打架------你得在"换模型"和"能举证"之间做取舍。 第 13 篇我立过"模型是耗材、可迁移性第一天设计",鼓励你随时换模型;可金融级又要求"用当时的版本能证明当时的决策"。这两件事是矛盾的:模型换得越勤,历史决策的复现成本越高。所以金融级的做法是分层 :不是要你留着所有老模型能真跑,而是留"可举证的最小集"------决策当时的三元组版本指纹 + 依据快照 + 输出摘要;能不能真重放出逐字一致反而次要(LLM 有随机性、有温度、甚至供应商静默更新),关键是"当时的依据链没断"。代价: ① "复现"的"一致标准"要提前定义(逐字一致 vs 关键依据一致------金融里通常是后者);② 老版本组件要归档、不能删,存储和维护成本上升;③ LLM 的固有随机性让"逐字复现"在很多情况下根本做不到,只能退到"依据可复现"。我认,因为可复现不是要你把老模型养一辈子,是要你留一条"能证明当时凭什么这么判"的链------链在,就举得了证。
2.6 边界:这篇不是什么
三层边界,缺一层就滑向软文或政策文:不是"金融 AI 落地案例秀"的软文 (不吹任何一家机构/厂商、不写"某银行上线后效率提升 X%"------本篇给的是"每一笔决策怎么变成可举证的记录 + 一个能核的落点");不是金融监管政策解读/条文复述 (不复述政策原文、不假装我有一份权威的"金融 AI 合规清单"------恰恰相反,本篇点破"监管口径又多又碎、很多没有统一技术标准,别把一篇营销号的'金融 AI 合规要点'当依据");不是风控模型测评 (一句不比"哪个风控模型准"------准确率是模型评测的事,可举证是工程纪律的事,两件事)。另外两条:不重讲前十六篇的细节 (四可判据只引用、各一句);不抢下一篇的活(把全专栏拼成一张总图那件事,推给收官篇)。
三、代码实战:一个纯标准库的金融级决策审计链核对器
"每一笔决策能自证"正是本篇区别于"金融 AI 软文"的唯一硬落点。所以这一篇的落点是一个离线可跑、纯标准库、无 API key、无第三方依赖的核对器:把每一笔决策编码成一条带链哈希的可举证记录,跑通"先验哈希链完整性 → 逐笔核四可 → 汇总结论 + 断链点 + 待人工确认清单 → 渲染成人看的决策审计表"。一篇案例秀不用跑也能看,一条能验的审计链不跑就不知道断在哪。
文件结构跟前几篇的 govcheck/、toolmap/、release/ 同级:
auditchain/
├── mini_auditchain.py        # 主代码:Triplet / DecisionRecord / Policy / VerdictItem / ChainReport
│                             #         + chain_hash / verify_chain / build_chain / replay
│                             #         + audit_decision / audit_all / explain / render_audit_table
│                             #         + load_policies / load_registry / build_demo(纯标准库 hashlib,离线可跑)
└── test_mini_auditchain.py   # 9 个断言,锁"链一断全废 / 四可缺一不予放行 / 申请人≠审批人 /
                              #   版本对不上不可复现 / 放行拒绝对称留痕 / 核不到标 pending /
# 结论可对账 / 待人工确认清单完整 / 审计要求一改结论就改"正文只贴关键节选、为便于阅读对 docstring 做了略精简、对函数体用了 ... 占位 (不是逐字原样)。没露面的辅助函数 ------load_registry(在册版本集数据源)、_judge(按规则名分派判定)、_overall_of(逐笔整体判定)、_verify_mark(核实标记)、_action_cn(动作中文名)、_demo_records(构造示意决策链)、_print_chain(打印链核对),以及各条判定规则(rule_accountable 等 rule_*)与规则表 RULES / DIM_CN------都在 auditchain/mini_auditchain.py 里。别照抄正文片段去拼,直接跑整个文件 (python auditchain/mini_auditchain.py)。
3.1 数据结构:决策是数据,不是一行日志
这是整份代码存在的前提------把"举证要哪些字段"焊进 schema。每个字段的"为什么"都写在 docstring 里:
python
@dataclass
class DecisionRecord:
    """一条决策记录 = 一份可举证的证据(不是一行日志)。

    为什么决策要做成「数据」而不是「一行日志」:
    "谁、凭什么、依据哪版"这三件事,一条记录里没有,后面再补就补不回来------把「举证要哪些字段」
    焊进 schema,比事后补日志靠谱得多。
      action       动作:放行 / 拒绝 ------ 一视同仁,都要留痕
      triplet      三元组版本(模型/Prompt/数据指纹)------ 可复现的锚
      grounds      依据(命中规则 / 引用条款)------ 可追溯的锚
      operator     操作人(谁调的)    approver 审批人(谁批的,必须 ≠ operator)    owner 责任人(出事追到谁)
      prev_hash    前序链哈希          chain_hash 本条链哈希 ------ 不可抵赖的锚
    """
    decision_id: str
    ts: str
    scenario: str
    action: str
    input_fp: str
    triplet: Triplet
    grounds: list[str] = field(default_factory=list)
    operator: str = ""
    approver: str = ""
    owner: str = ""
    prev_hash: str = ""
    chain_hash: str = ""
审计要求也做成数据------这是"口径会烂、审计链得跟着变"的落点:
python
@dataclass
class Policy:
    """一条审计要求 = 一行数据(不是一段写死的 if-else)。

    为什么审计要求要做成数据:
    "监管口径是一张会烂的活"------口径会更新、会新增、会有冲突。做成数据,要求变了你改数据就行;
    写成 if-else,明天多一条口径你就得重构。
      dimension   维度(四可之一,或外层监管维度如留痕期限/数据分级/双录)
      clause      依据(这条要求管什么)------"凭什么这么判"
      rule        判定规则名(RULES 里的键)------判定逻辑本身也是数据引用,不是散落的 if
      verified_at 核实日期;None 表示没核过(输出里显式标 pending)
    """
    item_id: str
    dimension: str
    clause: str
    applies_when: object          # callable(DecisionRecord) -> bool
    rule: str
    source: str
verified_at: str | None = None判定是四态不是两态------金融监管口径又多又碎,四态是为了让"我不知道"成为合法结论:
python
PASS = "PASS"                # 过(且在核实的口径内)
FAIL = "FAIL"                # 卡住(四可里任一 FAIL,这一笔就举不了证)
PENDING = "PENDING"          # 核不到权威口径(如留痕期限没统一标准),只能标待核实
NEEDS_HUMAN = "NEEDS_HUMAN"  # 口径冲突/边界模糊,需人工判断
VERDICTS = (PASS, FAIL, PENDING, NEEDS_HUMAN)
3.2 哈希链那一刀:一改就断链、一断全废
这是本篇最硬的一条纪律,也是最容易被审稿盯的一条。核心就两句:算哈希、从头重算:
python
def chain_hash(record: DecisionRecord) -> str:
    """算一条记录的链哈希 = H(prev_hash + 本条规范化内容),标准库 hashlib.sha256。

    为什么用哈希链而不是「存条日志 + 加个 id」:
    日志能被改、能被删、能对不上------哈希链让「改一条」必然导致「它的链哈希对不上」,
    而它的链哈希又是下一条 prev_hash 的一部分,于是一改就断链、一断全废。
    字段之间用 \x1f(不可见分隔符)拼,避免「ab|c」和「a|bc」拼出同一个字符串这种拼接歧义。
    """
    t = record.triplet
    parts = [
        record.prev_hash or GENESIS, record.decision_id, record.ts, record.scenario,
        record.action, record.input_fp, t.model_fp, t.prompt_fp, t.data_fp,
        "\x1e".join(record.grounds or []), record.operator, record.approver, record.owner,
    ]
    payload = "\x1f".join(parts)
    return hashlib.sha256(payload.encode("utf-8")).hexdigest()
python
def verify_chain(records: list[DecisionRecord]) -> tuple[bool, int | None]:
    """链完整性核对:返回(是否完整,第一个断点的下标)。这是「不可抵赖」的落点。

    为什么要「从头发到尾重算」而不是「比对一下存的值」:存的值本身可能就是被改过的------
    只有重算才能发现「内容被动过」;而一旦动过,它之后的每一条都建在一条假链上,所以断点及其之后全废。
    """
    prev = GENESIS
    for i, r in enumerate(records):
        if r.prev_hash != prev:
            return False, i
        if r.chain_hash != chain_hash(r):
            return False, i
        prev = r.chain_hash
    return True, None
3.3 可复现是"版本对得上",不是"逐字一致"
这一条是取舍点③的代码落点,也是跟第 13 篇"模型是耗材"顶牛的地方。核对器不假装能重放 LLM 的逐字输出------它核的是"当时那一版还在不在、依据链还在不在":
python
def replay(record: DecisionRecord, registry: set[str]) -> tuple[bool, str]:
    """可复现核对:record.triplet 的三版在不在册(registry = 在册版本集)。

    为什么核的是版本在不在、不是逐字一致:
    LLM 有随机性、供应商会静默更新(换权重不换名)、数值舍入和专家路由都会让输出飘------
    「逐字复现」在很多场景根本做不到。金融级要的是「关键依据可复现」:当时那一版还在册、
    依据链没断,就足以证明「当时凭什么这么判」。
    """
    t = record.triplet
    missing = [name for name, fp in
               (("模型", t.model_fp), ("Prompt", t.prompt_fp), ("数据", t.data_fp))
               if fp not in registry]
    if missing:
        return False, (f"三元组版本不在册:{'、'.join(missing)}------版本漂了、组件下架了,"
                       f"用今天的版重放不出当时那笔(核的是版本在不在,不是逐字一致)")
    return True, (f"三元组三版均在册[{t.model_fp} / {t.prompt_fp} / {t.data_fp}]:依据链未断"
                  f"(只核版本对得上,不假装重放 LLM 逐字输出)")
3.4 主核对:先验链、再逐笔核四可
python
def audit_all(records, policies=None, registry=None) -> ChainReport:
    """主核对:先验链完整性(断链则断点及其之后全标记链不可信)→ 逐笔核四可 → 汇总。

    为什么先验链、再逐笔核:链一断,断点之后的记录全建在假链上,先给它们盖个「链不可信」的戳,
    再逐笔核才有意义------否则你会对着一条被改过的记录认真核「依据全不全」。
    为什么放行和拒绝走完全一样的核对:audit_all() 对 action 不做任何区分------
    一笔「说得清凭什么」的拒绝,和一笔「说得清凭什么」的放行,价值一样高。
    manual_review = 所有 PENDING/NEEDS_HUMAN 的条目(一个诚实的审计链要把「我不确定的那部分」
    单独交出来,而不是混在结论里蒙混过去)。
    """
    policies = list(load_policies() if policies is None else policies)
    registry = set(load_registry() if registry is None else registry)
    ok, broken_at = verify_chain(records)

    verdicts: list[VerdictItem] = []
    for i, r in enumerate(records):
        # 断点之前的笔不受影响;断点及其之后的所有笔一律标记「链不可信」(一断全废)。
        chain_ok = (broken_at is None) or (i < broken_at)
        verdicts.extend(audit_decision(r, policies, registry, chain_ok))
    ...
跑 python auditchain/mini_auditchain.py(build_demo())会打印 7 个确定性场景(并给出 9 条确定性结论)。注意:这里的数据全是【示意,待核实】,下面贴的是跑出来的输出,它是对示意数据的确定性结论,不是对真实监管/机构的评价:
==============================================================================
金融级决策审计链核对器 demo(数据全部为【示意,待核实】)
==============================================================================
四可(每一笔放行/拒绝都要过的四关):① 可追溯  ② 可复现  ③ 可追责  ④ 不可抵赖
外层监管维度(只给边界、只标待核实):留痕期限 · 数据分级 · 双录
一句话:政企五关管的是「这套系统能不能进来」(系统级);
        这四可管的是「它做的每一笔决策能不能上法庭」(决策级)------系统级通过 ≠ 决策级通过。

==============================================================================
[表给人看] render_audit_table()(表与 audit_all 共用同一份决策数据):
| 决策 id | 场景 | 动作 | 操作人 | 审批人 | 三元组版本 | 判定 |
|---|---|---|---|---|---|---|
| D-001 | 信贷审批 | 放行 | op-01 | ap-01 | model:v3.2/prompt:p17/data:ds-2026q1 | 可举证 |
| D-002 | 风控辅助 | 拒绝 | op-02 | ap-01 | model:v3.2/prompt:p17/data:ds-2026q1 | 可举证 |
| D-003 | 信贷审批 | 放行 | op-03 | ap-02 | model:v3.1/prompt:p16/data:ds-2026q1 | 可举证 |
| D-004 | 信贷审批 | 拒绝 | op-04 | ap-02 | model:v3.2/prompt:p17/data:ds-2026q1 | 可举证 |
| D-005 | 风控辅助 | 放行 | op-05 | ap-03 | model:v3.2/prompt:p17/data:ds-2025q4 | 可举证 |

==============================================================================
[场景 1] 干净链:逐笔核四可(放行和拒绝走完全一样的核对)
  D-001 [放行] -> 可举证   FAIL[无]   非决定性[留痕期限、数据分级、双录]
  D-002 [拒绝] -> 可举证   FAIL[无]   非决定性[留痕期限、数据分级、双录]
  D-003 [放行] -> 可举证   FAIL[无]   非决定性[留痕期限、数据分级、双录]
  D-004 [拒绝] -> 可举证   FAIL[无]   非决定性[留痕期限、数据分级、双录]
  D-005 [放行] -> 可举证   FAIL[无]   非决定性[留痕期限、数据分级、双录]
  -> 决策审计链:5 笔决策;链完整性[完整];可举证 5 笔 / 不可举证 0 笔 / 待人工 0 笔;待人工确认 15 项(对示意数据的确定性结论,非对真实监管/机构的评价)

==============================================================================
[场景 2] 篡改第 3 笔(D-003)的 grounds------不可抵赖:一改就断链、一断全废
  verify_chain() -> 链完整[False];第一个断点下标[2](= D-003)
  断链后重核:断点(含)之后全标记「链不可信」,断点之前不受影响
  D-001 [放行] -> 可举证   FAIL[无]   非决定性[留痕期限、数据分级、双录]
  D-002 [拒绝] -> 可举证   FAIL[无]   非决定性[留痕期限、数据分级、双录]
  D-003 [放行] -> 不可举证   FAIL[不可抵赖]   非决定性[留痕期限、数据分级、双录]
  D-004 [拒绝] -> 不可举证   FAIL[不可抵赖]   非决定性[留痕期限、数据分级、双录]
  D-005 [放行] -> 不可举证   FAIL[不可抵赖]   非决定性[留痕期限、数据分级、双录]
  -> 决策审计链:5 笔决策;链完整性[断链@D-003(下标 2)];可举证 2 笔 / 不可举证 3 笔 / 待人工 0 笔;待人工确认 15 项(对示意数据的确定性结论,非对真实监管/机构的评价)

==============================================================================
[场景 3] 申请人 = 审批人(职责分离违规)------可追责 FAIL
  D-002 可追责 -> FAIL
  理由:职责分离违规:申请人=审批人(operator==approver)------出事追不到具体责任人(银监发〔2014〕40 号第 18 条不相容岗位分离)

==============================================================================
[场景 4] 三元组版本不在册------可复现 FAIL(核的是版本在不在,不是逐字一致)
  D-004 可复现 -> FAIL
  理由:三元组版本不在册:模型------版本漂了、组件下架了,用今天的版重放不出当时那笔(核的是版本在不在,不是逐字一致)

==============================================================================
[场景 5] 每条结论可对账:explain() 逐条给维度/依据/出处/核实日期
  维度[不可抵赖] 判定[PASS] 决策[D-001]
  依据[不可抵赖:记录防篡改(哈希链),一改就断链、一断全废------工程自保,非监管强制]
  出处[第 12 篇内容指纹心智;密码学手段技术参照 GB/T 43580-2023 区块链存证 / GB/T 20520 时间戳 / JR/T 0184-2020 金融分布式账本]
  核实[2026-09(技术参照,非强制)]
  理由:链哈希匹配且本笔在链完整段内:这条记录改了你验得出来(一改就断链)
  维度[留痕期限] 判定[PENDING] 决策[D-001]
  依据[留痕期限:AI 决策留痕本身无专属统一期限,落到具体数据类型上]
  出处[双录/反洗钱/生成式日志多档并存,口径未统一(待核实)]
  核实[pending]
  理由:留痕期限口径未统一(双录 / 反洗钱 / 生成式日志各是一档),「AI 决策留痕」无专属统一期限------需人工确认,不硬给数字

==============================================================================
[场景 6] 审计要求是数据:加一条「双人复核」要求 → 结论随之变化,audit_all 一行不改
  加之前:待人工确认 15 项
  加之后:待人工确认 20 项(多出的就是新增维度「双人复核」)
  -> 数据改了结论就改,不用动 audit_all() / _judge() 一行代码。

==============================================================================
[场景 7] 待人工确认清单 = 所有非决定性判定的集合(不多不少)
  · D-001 [留痕期限] PENDING:留痕期限口径未统一(双录 / 反洗钱 / 生成式日志各是一档),「AI 决策留痕」无专属统一期限------需人工确认,不硬给数字
  · D-001 [数据分级] PENDING:数据分级口径未统一(标准侧五级 vs 监管侧三级四类),涉敏感级决策的脱敏/加密到什么程度无统一强制------需人工确认,按机构数据分级细则落地
  · D-001 [双录] NEEDS_HUMAN:「AI 决策要不要双录」无统一强制口径(现有双录锚在销售行为上,AI 双录是团体标准/厂商方案)------口径冲突,需人工判断(不硬给 PASS,也不硬给 FAIL)
  · ...共 15 项(= 所有 PENDING / NEEDS_HUMAN 的条目)

==============================================================================
九条确定性结论(对示意数据的确定性结论,不是对真实监管/机构的评价):
  1. 链一断,整条链全废------改第 3 笔,断点(含)之后全标记链不可信,断点之前不受影响。
  2. 四可缺一,这一笔就不予放行------可追溯/可复现/可追责/不可抵赖,任一 FAIL 即不可举证。
  3. 申请人 = 审批人 → 可追责 FAIL------职责分离是金融内控硬要求(不相容岗位分离)。
  4. 可复现 = 三元组版本对得上,不是逐字一致------版本不在册就判不可复现。
  5. 放行和拒绝一视同仁------action 不改变要核什么,拒绝笔走和放行笔一样的核对。
  6. 核不到口径的老实标 PENDING(如留痕期限),不编一个数字。
  7. 每条结论能对账到依据------explain() 给维度/依据/出处/核实日期。
  8. 待人工确认清单 = 所有 PENDING/NEEDS_HUMAN 的集合,不多不少。
9. 审计要求是可增删的数据------加一条 Policy,结论随之变,核对逻辑一行不改。读一遍这个输出,主线就出来了:同一批决策 ,一改第 3 笔,断链点之后三笔全废、断链之前两笔不受影响------"一改就断链、一断全废"不是口号,是跑出来的;把某个业务员的"申请人"和"审批人"设成同一个账号,可追责当场 FAIL;把模型版本换成一个不在册的,可复现当场 FAIL;放行笔和拒绝笔走的是完全一样的核对(你看场景 1 里两列维度一模一样);核不到的口径(留痕期限)老实标 PENDING,单列一张"待人工确认清单",不混进结论里蒙混过去。
3.5 9 个断言怎么把这些结论钉死
test_mini_auditchain.py 用纯标准库 unittest,两种跑法都行:
bash
python auditchain/test_mini_auditchain.py     # 在仓库根目录下
python -m unittest test_mini_auditchain        # 在 auditchain/ 目录下
九个断言,对应本篇的九个命题句。挑三条说透:
断言①"链一断,整条链全废"是本篇的命题句。 它构造一条 5 笔的链,改中间第 3 笔的 grounds,断言 verify_chain() 返回 (False, 2),且断点及其之后的每一笔"不可抵赖"都 FAIL、断点之前不受影响:
python
def test_01_break_chain_discards_all_after(self):
    recs = build_chain([_valid_record(i) for i in range(1, 6)])   # 5 笔
    ok, idx = verify_chain(recs)
    self.assertTrue(ok)
    self.assertIsNone(idx)

    recs[2].grounds = ["被改过的依据(事后补的)"]                 # 篡改第 3 笔(下标 2)
    ok, idx = verify_chain(recs)
    self.assertFalse(ok)
    self.assertEqual(idx, 2)                                     # 断点就是第 3 笔

    rep = audit_all(recs)
    # 断点(含)及其之后的所有笔:不可抵赖 FAIL(链不可信)
    for r in recs[2:]:
        v = _find(rep, r.decision_id, NON_REPUDIABLE)
        self.assertEqual(v.verdict, FAIL)
        self.assertIn("链不可信", " ".join(v.reasons))
    # 断点之前的笔不受影响
    for r in recs[:2]:
        self.assertEqual(_find(rep, r.decision_id, NON_REPUDIABLE).verdict, PASS)
断言③"申请人 ≠ 审批人"是金融级最硬的一条。 它不只断判定是 FAIL,还断理由里点名"职责分离"和"申请人=审批人"------把这条纪律的措辞也钉进测试。想亲手验证这刀很容易:把 rule_accountable 里那句 operator == approver 的判断删掉再跑,断言③当场就红。
断言⑧"待人工确认清单不多不少"是核对器诚实度的落点。 它断言 manual_review 的条目集合恰好等于所有 PENDING/NEEDS_HUMAN 的集合------一个诚实的审计链不只告诉你"哪些笔能自证、哪些不能",还要把"我不确定的那部分"单独交出来,交接给合规口/法务去补口径。其余六条------②四可缺一不予放行、④可复现=版本对得上、⑤放行拒绝对称留痕、⑥核不到标 pending、⑦每条结论可对账、⑨审计要求一改结论就改------都在 test_mini_auditchain.py 里,命名和命题句一一对应,就不逐个展开了。
四、踩坑记录:这三个坑,每个都真付过费
4.1 我以为"记了日志"就=可审计,结果审计员一句"这日志能改吗"把我问住
症状:可追溯这块我以为最简单------每次决策我都记了日志,谁调的、什么时候、结果是什么,一应俱全,我自认为可审计。结果有一次内部审计,审计员问了一句:你这日志存在哪、谁能改、怎么证明你现在给我看的这条就是当时那条?我一下哑了------日志就在业务库里,运维能改、开发能删,我拿不出任何"这条记录没被动过"的证明。
排查:根因是我把"可审计"简化成了"有没有记",其实金融级要的是不可抵赖 ------记下来只是一半,能不能证明它没被改过是另一半。
修复:给决策记录加哈希链(每条记录的链哈希 = 上一条链哈希 + 本条内容的哈希),一改就断链、一断全废;审计员随时能自己验一遍。教训:能被改的日志,不叫证据------你要证明的不是"我记了",是"这条记录没被动过"。 但也别把这一刀说歪:金融对"日志必须防篡改"没有统一强制技术标准,这是工程自保,不是监管强制------我事后专门跟客户合规口对齐过这件事,免得被当成"我们满足某条强制要求"去汇报。
4.2 客户投诉要我复现三个月前那笔拒绝决策,我复现不出来
症状:客户对一笔三个月前的 AI 拒绝不满、投诉到监管,监管要我把那笔决策复现一遍。我去复现,才发现那笔决策只留了结果("审核未通过"),没留当时的依据(命中了哪条规则、引用了哪份知识)、没留当时的版本(模型是哪一版、Prompt 是哪一版)------而这三个月里模型升级过、Prompt 改过好几轮,我用今天的版本怎么跑都对不上当时那笔。
排查:根因是我把"可复现"理解成了"系统能重跑",可重跑 ≠ 复现------复现要的是"用当时那一版、当时那份依据,能证明当时为什么这么判",我什么都没留。
修复:决策时就把三元组版本指纹(模型/Prompt/数据)+ 依据快照 + 输出摘要冻结留存,能归档、能对账;复现的标准定成"关键依据一致",不苛求逐字一致(LLM 有随机性,逐字一致在很多场景做不到)。教训:可复现不是要你把老模型养一辈子,是要你留一条"能证明当时凭什么这么判"的链------留痕留到能举证为止,不是留到"记过"为止。(这一坑跟第 13 篇"模型是耗材"正面顶牛,我上面取舍点③如实写了这对矛盾。)
4.3 出了事要追责,我发现"申请人"和"审批人"是同一个人
症状:一笔由 AI 建议、人工确认的信贷放款后来成了坏账,要追责。我调记录一看------系统里"提交申请"和"审批确认"两步是同一个账号操作的(因为图省事,让业务员一个人点到底),AI 给了建议、同一个业务员点了"同意",流程就过了。真要追责时,追谁?追业务员"你不该信 AI"?追开发者"你不该让 AI 这么判"?追不到一个清晰的责任人。
排查:根因是我从没把职责分离当成硬约束------金融内控里"不相容岗位要分离"是基本要求,而我的系统把申请人、审批人合成了一个角色。
修复:审计链强制核"申请人 ≠ 审批人",相等就判 FAIL;责任人字段必填,缺了不许放行;AI 建议和人工确认各自留独立的操作人。教训:可追责的前提是"责任被分清了"------申请人=审批人的系统,出了事谁都追不到,等于没有责任人。
五、选型对比:三种做法,你该抄哪一种
5.1 大表:金融级"决策可举证"这条路的三种做法
| 做法 | 组织的维度 | 覆盖几可 | 结论能不能对账到依据 | 核不到的口径怎么处理 | 时效性怎么管 | 推荐指数 |
|---|---|---|---|---|---|---|
| ① 只记业务日志 | 按业务动作 | 看着有痕,实际不可举证 | 不能------日志没带依据链 | 没有"核不到"的概念,一律当"记过了" | 无 | ⭐⭐ |
| ② 上商业审计/合规平台 | 按平台定的口径 | 平台覆盖到哪算哪,LLM 决策链常不在范围 | 答案随平台口径走,带不走 | 平台怎么说就怎么说 | 平台升级才更新 | ⭐⭐⭐ |
| ③ 按"四可"建自己的决策审计链(本篇 demo 就是最小实现) | 按你的监管场景 | 四可 + 外层维度可逐项加 | 能------每条结论带维度/依据/出处/核实日期 | 核不到的条目老实进"待人工确认清单" | 每条标核实日期 | ⭐⭐⭐⭐⭐ |
结论:做法①是"记了但举不了证"(能被改、没依据链);做法②是"买了个别人的答案"(上手快,但口径未必适配你的监管场景、LLM 决策链常常不在它覆盖范围、数据还可能出域);做法③是"可复用、可对账、能自证",输入你的决策流水就给结论 + 依据 + 断链点,核不到的条目老实进"待人工确认清单"。 小团队不用一上来就把四可全填满,先把你自己监管场景真实要核的那几件填上(每可给判据 + 依据出处),审计链就比任何"合规平台"都实在;后面按需加项。
5.2 副表:金融级决策可举证的监管口径现状(2026,口径与期限待核实)
正文只给结论(完整版维度逐行、全标"待核实"的表格在附录 B):"不可抵赖"这一格,监管口径栏写的是"无统一强制技术标准,只有密码学手段的国标/行标技术参照"------它是工程自保。
5.3 可复用 checklist:金融级 AI 决策可举证 8 问
这八问是你落地时要挨个核的清单;本篇 demo 覆盖了其中可判定的几项(可追溯/可复现/可追责/职责分离/不可抵赖/留痕期限/数据分级),容灾这类只给边界的维度不在 demo 内、按机构口径自核------也是你能直接抄走的落地清单:
- 这一笔决策,谁调的、谁批的、走了哪条路,留全了吗(可追溯)?
- 当时那一版的模型/Prompt/数据,指纹留了吗,能对得上吗(可复现)?
- 出了事追到哪个具体的人,责任人字段填了吗(可追责)?
- 申请人 ≠ 审批人吗(职责分离)?
- 这条记录能被改吗,改了你验得出来吗(不可抵赖)?
- 你们的留痕要留多久、口径是哪来的(监管留痕)?
- 这套审计链自己扛不扛得住故障,灾备下审计不断吗(容灾)?
- 涉及敏感/涉密数据的决策,分级和脱敏做了吗(数据分级)?
六、总结 + 下一篇预告
回到开篇那个场景------监管来函要我把那笔拒绝决策复现一遍,我拿不出来。问题不在"系统跑不跑得动",在"每一笔决策能不能自证"。
一句话收口:金融级 AI 的第一性不是"跑得动",是"能举证"------政企五关问的是"这套系统能不能进来、谁来扛"(系统级),金融级问的是"它做的每一笔决策能不能上法庭"(决策级);可追溯、可复现、可追责、不可抵赖,四可缺一,日志就只是能被改的字符串。 顺序还是不能反:先过政企五关,再叠决策四可。
再说句大实话,也是本篇的信任来源:金融项目我只写实打实跑过的------我跑过信贷审批和一条风控辅助的 AI 落地;投顾、反洗钱这些我没真做过的,一律只给公开口径,不假装我懂每一类金融业务的风控模型。 一个把信贷/风控/投顾都说得像亲历过的人,你反而不敢信。
话说回来,行业纵深的两站------政企、金融------都讲完了;可这十七篇里立过的判据散在各处(评测门、Trace、版本不可变、五道关、四可......),你手里拿着一堆零件,还缺一张"我处在这个处境,该先上哪套纪律、该看哪个落点"的总图。下一篇(专栏收官)《全息地图》:把全专栏的四大支柱、三底座、行业落地,拼成一张"你的处境 → 该用哪套纪律 + 该落哪个核对器"的全息图------前面十七篇的判据在这张图上各就各位,你拿自己的处境一查,就知道从哪一篇开始读、该落哪个 demo。
附录 A:四可 → 判据 → 依据出处 → 对应前篇
| 可 | 判据(要核什么) | 依据出处(口径/标准) | 锚强度 | 对应前篇 |
|---|---|---|---|---|
| ① 可追溯 | 操作人 + 命中规则/引用条款 + 输入指纹 + 三元组字段齐 | 《商业银行互联网贷款管理暂行办法》(银保监会令 2020 年第 9 号)第 42 条风险模型全过程文档化归档;《银行业保险业数字金融高质量发展实施方案》(金办发〔2025〕95 号)"提升算法透明度和可解释性";JR/T 0221-2021 算法可追溯性 | 强(原则性表述 + 分场景强制留痕;无单一"AI 决策可追溯"技术标准) | 第 8 篇、第 2 篇 |
| ② 可复现 | 三元组版本指纹在册 + 依据快照(关键依据一致,不苛求逐字) | 模型风险管理框架的原则性要求(验证/监控/文档化);SR 11-7 三支柱;无"必须逐字复现 AI 决策"的强制条款 | 弱(框架参照 + 行业惯例) | 第 12 篇、第 13 篇 |
| ③ 可追责 | 责任人字段 + 申请人 ≠ 审批人 + 人工审批留痕 | 《商业银行内部控制指引》(银监发〔2014〕40 号)第 18 条不相容岗位分离;金融监管总局"谁使用谁负责" | 强(明文内控要求 + 原则性责任归属) | 第 10 篇 |
| ④ 不可抵赖 | 哈希链:一改就断链、一断全废 | 无强制技术标准;技术参照:GB/T 43580-2023(区块链存证)、GB/T 20520(时间戳)、JR/T 0184-2020(金融分布式账本安全) | 无监管强制锚------工程自保 | 第 12 篇 |
附录 B:金融级决策可举证的监管口径现状表(2026,全标"待核实")
正文一个口径都不编死,这张表才是"会烂的那部分"。每一行的"依据出处 / 口径 / 是否统一 / 核实日期"都标"待核实"------真实能不能过,取决于你机构适用的具体口径和你自己的落地。
| 监管维度 | 依据出处(待核实) | 口径(待核实) | 是否统一 | 核实日期 |
|---|---|---|---|---|
| AI 决策可追溯/可解释 | 互联网贷款办法 + 金办发〔2025〕95 号 + JR/T 0221-2021 | 原则性表述 + 分场景强制留痕 + 评价规范;无"AI 决策可追溯"技术标准 | 不统一 | 2026-09(待核实) |
| 可复现 / 模型可审计 | 模型风险管理框架(SR 11-7 参照 + 国内风险模型全流程) | 原则性要求(验证/监控/文档化);无"逐字复现"强制条款 | 不统一 | 2026-09(待核实) |
| 留痕期限 | 双录规定 / 反洗钱法 / 生成式 AI 日志口径 / 《人工智能示范法 3.0》草案(模型研发记录 ≥5 年,草案非现行法) | 6 个月 / 3 年 / 5 年 / 10 年多档并存,取决于数据类型;"AI 决策留痕"无专属统一期限 | 不统一 | 2026-09(待核实) |
| 双录是否延伸 AI 决策 | 银监办发〔2017〕110 号(销售行为双录) | 现有双录锚在销售行为;"AI 决策要不要双录"核不到统一强制口径(AI 双录是团体标准/厂商方案) | 核不到 | 2026-09(核不到) |
| 报送要求 | 算法备案/生成式 AI 备案相关法规 | 对外/有舆论属性可能触发备案;仅内部使用一般豁免;"金融 AI 是否必然触发"口径未统一 | 口径未统一 | 2026-09(待核实) |
| 数据分级 | JR/T 0197-2020(分级指南)+ 金规〔2024〕24 号 | 标准侧五级 vs 监管侧"三级四类"两套颗粒度;敏感级进测试环境须脱敏 | 统一(但两套口径) | 2026-09(待核实) |
| 等保/密评 | 等保 2.0 + 密码应用基本要求(金融口径更严) | 金融系统等保/密评要求更严;具体等级按机构与系统定 | 统一(等级按系统定) | 2026-09(待核实) |
| 容灾 | 银行业信息系统灾难恢复管理规范 | 公开灾难恢复等级口径,核心系统要求较高;两地三中心为优选;RTO/RPO 具体数值只给量级 | 统一 | 2026-09(待核实) |
| 职责分离 | 银监发〔2014〕40 号第 18 条 | 不相容岗位分离、重要岗位轮岗,明文要求 | 统一 | 2026-09(待核实) |
| 不可抵赖/防篡改 | 无强制标准;技术参照 GB/T 43580-2023 / GB/T 20520 / JR/T 0184-2020 | 无"金融 AI 决策日志必须防篡改"的强制技术标准;只有密码学手段的国标/行标可参照 | 无统一强制口径------工程自保,非监管强制 | 2026-09(技术参照,非强制) |
附录 C:可引用公开口径清单(口径与条文以官方原文为准)
- 《商业银行互联网贷款管理暂行办法》(银保监会令 2020 年第 9 号)第 42 条------风险模型全过程文档化归档、供本行和监管随时查阅(可追溯的强锚,信贷场景)
- 《银行业保险业数字金融高质量发展实施方案》(金融监管总局办公厅,金办发〔2025〕95 号,2025-12)------算法模型全周期管理、提升算法透明度和可解释性、关键节点人工干预、防止模型漂移
- 《商业银行内部控制指引》(银监发〔2014〕40 号)第 18 条------不相容岗位分离("申请人≠审批人"的直接依据)
- 金融监管总局《关于银行业保险业人工智能安全开发应用的指导意见》------"谁使用谁负责"、压实金融机构主体责任、关键环节人工监督干预
- JR/T 0221-2021《人工智能算法金融应用评价规范》(央行)------安全/可解释/精准/性能四维评价(可追溯性、可解释性判据的权威对照物;是评价规范,不是准入强制)
- JR/T 0197-2020《金融数据安全 数据安全分级指南》、JR/T 0171-2020《个人金融信息保护技术规范》、《银行保险机构数据安全管理办法》(金规〔2024〕24 号)
- 《中华人民共和国反洗钱法》(2024 修订)第 34 条------客户身份资料和交易记录至少保存十年
- 《银行业金融机构销售专区录音录像管理暂行规定》(银监办发〔2017〕110 号)------双录锚在销售行为
- JR/T 0044-2008《银行业信息系统灾难恢复管理规范》、GB/T 20988(信息系统灾难恢复规范)------容灾等级(RTO/RPO 数值待核实)
- 密码学手段技术参照 :GB/T 43580-2023(区块链存证通用服务指南)、GB/T 43572-2023(区块链术语)、GB/T 20520(时间戳规范)、JR/T 0184-2020(金融分布式账本技术安全规范)------技术参照,非"金融 AI 决策日志"强制要求
- 框架参照:SR 11-7(美联储/OCC,模型风险管理三支柱)、BCBS 239(风险数据聚合原则)、中国银行业协会《人工智能模型风险管理框架》
说明(口径统一性) :上表中"不相容岗位分离""数据分级标准号""容灾等级表""等保密评"有相对权威统一口径;而"AI 决策留痕留存期限""AI 决策是否要双录""算法备案是否必然触发(金融 AI)""可复现/可审计的强制技术条款""金融 AI 决策日志必须防篡改"口径不统一或核不到统一口径 ------这几类正文一律写成"核不到/待核实",不编死。"四可"这个说法是本篇为了可核对做的工程化归纳,不是某个监管文件的官方分类。
附录 D:审计链算法说明
demo 是纯标准库的确定性近似,不是真实合规审查、不是真实监管报送。
- 为什么决策是数据不是一行日志 :
DecisionRecord把一笔决策拆成(decision_id, ts, scenario, action, input_fp, triplet, grounds, operator, approver, owner, prev_hash, chain_hash)。为什么这么拆:"谁、凭什么、依据哪版"三件事,一条记录里没有,后面再补就补不回来------把举证要哪些字段焊进 schema,比事后补日志靠谱(踩坑②的代码落点)。 - 为什么哈希链能"一改就断链" :
chain_hash(r) = H(prev_hash + 规范化内容),verify_chain()从头发到尾重算,任一条对不上就在那一条断链。为什么不是比对存量:存量本身可能就是被改过的,只有重算才能发现内容被动过;而它的链哈希又是下一条的prev_hash,所以断点及其之后全废(断言①、取舍点②)。 - 为什么四可是"逐笔核、缺一不予放行" :
audit_decision()把四可逐条核一遍,_overall_of()里任一 FAIL 即"不可举证"。为什么不是"平均分够高":四可缺一,这一笔就举不了证------是"每一笔都要过"(断言②、取舍点①)。 - 为什么"申请人≠审批人"判 FAIL :
rule_accountable里operator == approver直接 FAIL(断言③、踩坑③,依据不相容岗位分离)。 - 为什么"可复现"只核版本在不在 :
replay()只查triplet三版在不在册,绝不假装重放 LLM 逐字输出------LLM 有随机性、供应商会静默更新,"逐字一致"很多场景做不到(断言④、取舍点③)。 - 为什么放行和拒绝走一样的核对 :
audit_all()对action不做区分------一笔"说得清凭什么"的拒绝和一笔"说得清凭什么"的放行,价值一样高(断言⑤)。 - 为什么判定是四态 :
PASS/FAIL/PENDING/NEEDS_HUMAN。只给两态会逼你对"核不到的东西"编一个答案;四态让"我不知道"成为合法结论,并让manual_review从非决定性判定里自然长出来(断言⑥⑧)。 - 为什么每条结论带依据 :
explain()返回维度/依据/出处/核实日期------只吐 PASS/FAIL 不吐依据,审计员问一句就哑(断言⑦,开篇那个场景的教训)。 - 为什么审计要求一改结论就改 :
load_policies()是数据,Policy.rule是规则表的键;加一条要求 = 加一行数据、引一个规则,audit_all()一行不改。且Policy.verified_at=None的条目输出里显式标pending------把"这份口径会烂"焊进数据结构(断言⑨)。 - 真实生产怎么替换 :把
load_policies()/load_registry()换成你们机构维护的真实口径数据与模型/Prompt/数据注册表、给链哈希加上签名和密钥管理、把render_audit_table()换成内部平台/前端,verify_chain()/audit_all()/explain()的逻辑一行不改------同前几篇"生产换数据、骨架不动"的替换心智。
🎯 更多专栏系列文章可以查看博客主页📑 👍 若文章对你有所触动,恳请点赞 ⭐ 关注 ⭐ 收藏