**同样是"写 Prompt",为什么有人月薪数万做"Prompt 工程师",有人只是把 AI 当高级补全工具?**差别不在天赋,而在认知------你是在"调用 API",还是在"设计 DSL"。本文从底层逻辑、核心区别、实战写法三个维度拆透。
ChatGPT 问世三年,AI 编程早已不新鲜。但团队里总有一种撕裂感:一边是工程师把"帮我写个排序算法"丢给 AI,一边是 Prompt 工程师为某个垂直场景打磨百字以内的提示词。两者都叫"写 Prompt",却是两种根本不同的技能。
01重新定义:Prompt 不是"问题",是"指令集"
先建立共识:传统编程中,我们通过代码告诉计算机如何做(How) ;AI 交互中,我们通过 Prompt 告诉模型做什么、以及以什么方式呈现(What + How of presentation)。
所以"日常开发写 Prompt"和"Prompt 工程"的区别,本质上就是**"调用 API"和"设计 DSL"**的区别:一个面向当前任务,一个面向一类问题。
02日常开发 Prompt:工具思维的"函数调用"
日常开发中的 Prompt,大多数是功能性的、一次性的、结果导向的。典型场景:调试代码时让 AI 解释报错、要一段样板代码(CRUD 接口)、把自然语言需求转成正则或 SQL、为函数生成单测用例。
【日常开发 Prompt 模板】
角色:你是一个资深 Java 工程师
任务:将以下 JSON 结构转换为对应的 POJO 类
约束:使用 Lombok 注解,字段名保持驼峰
输入:{ "user_id": 123, "user_name": "Alice" }
写法核心是清晰、具体、可验证,追求"一次命中"。最佳实践清单:① 明确角色,避免泛泛回答;② 提供示例,Few-shot 比 Zero-shot 稳定得多;③ 指定输出格式(JSON/Markdown/纯文本必须明确);④ 设置约束边界------不要做什么,比要做什么更重要。
这种 Prompt 的本质,是把 AI 当作超高速的代码补全引擎:不产生新范式,只节省机械劳动。
03Prompt 工程:系统思维的"协议设计"
Prompt 工程不是"写一句话让 AI 干活",而是为特定任务设计一套可复用的、高稳定性的交互协议。典型场景:电商客服自动回复 Agent、法律文书条款抽取流水线、游戏 NPC 一致性格对话引擎、RAG 系统的 Query 改写与重排序策略。
【Prompt 工程片段------多阶段推理】
阶段1(规划):分析用户问题,拆解为最多3个子任务,输出 JSON 任务列表。
阶段2(检索):按任务列表从知识库检索相关文档块,标注相关性分数。
阶段3(推理):Step1 识别核心诉求 → Step2 评估材料充分性 → Step3 充分则作答,不充分则生成追问清单。
阶段4(自检):检查是否存在事实性幻觉、是否与检索材料矛盾、是否覆盖所有子任务。
写法核心是稳定性、可观测性、容错性。Prompt 工程师真正在做的,是控制高维空间中的概率分布------知道同样的 Prompt 在不同温度、不同模型版本下会怎么漂移,再用手段驯服不确定性:
手段 | 说明
思维链 CoT:强制模型展示推理过程,而非直接给结论
自我一致性:多次采样,投票选出最一致的答案
结构化解构:拆分为原子步骤,降低单步认知负载
对抗性测试:主动设计边界 case,观察 Prompt 鲁棒性
动态 Few-shot:根据输入语义实时检索最相关的示例
04一张表说清楚:两种写法的本质差异
维度 | 日常开发 Prompt | Prompt 工程
目标:完成一次性任务 | 构建可复用的能力接口
生命周期:分钟到小时 | 周到月,持续迭代
评估标准:当前输出是否正确 | 多轮测试下的准确率、召回率、稳定性
复杂度:线性单轮 | 多阶段、多分支、有条件路由
调优手段:改几个字、加几个例子 | 组合 CoT、Few-shot、元提示、输出解析
失败处理:重写 Prompt 重试 | 设计降级策略、异常捕获、人工兜底
抽象层级:面向具体需求 | 面向一类问题
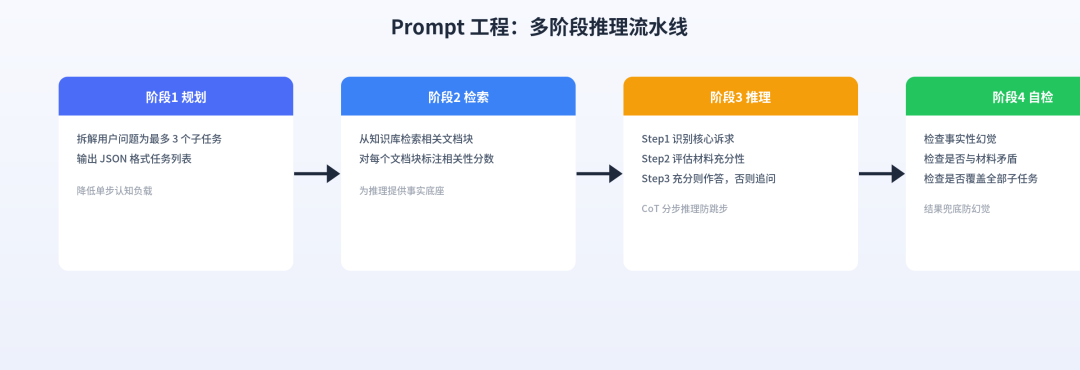
图:Prompt 工程多阶段推理流水线------规划 → 检索 → 推理 → 自检
05实战:同一个需求,两种写法
假设需求:从产品评论中提取情感倾向和关键问题。先看日常开发的一次调用写法:
分析以下评论的情感倾向(正面/负面/中性),
并提取用户提到的具体问题点。
评论:"{review}"
输出 JSON 格式。
再看 Prompt 工程的多阶段流水线写法:
【系统角色】你是电商评论分析专家,输出严格符合 JSON Schema。
【阶段一:粗筛】判断评论是否含有效信息,排除"不错""还行"等无意义评价;无效则返回 {"valid": false} 并终止。
【阶段二:细粒度拆解】按产品质量/物流服务/客服体验/性价比四个维度分别打分(1-5分)。
【阶段三:问题抽取与归因】提取负面/中性表述中的问题点,按"问题类型-具体描述-严重程度"三元组输出。
【阶段四:最终输出】整合阶段二、三,按 Schema 输出 scores/issues/summary。
【约束】① 输出必须基于评论原文,禁止外推;② 无相关信息标注 null 而非臆测;③ 输出前自检是否与原文矛盾。
区别一目了然:前者追求**"能用",后者追求"可控"**------同一个输入,工程化写法从源头约束了幻觉、空值和不一致。
写给开发者:精力怎么分配:函数级 Prompt 是基础功,像写清晰注释一样属于职业素养,每个开发者都该掌握角色设定、Few-shot、输出约束;当你开始反复为同一类任务修改同一段 Prompt,就该把它抽象成可配置模板,加上验证、降级和监控;Prompt 工程不是玄学,是实验科学------合格的 Prompt 工程师,一半时间写 Prompt,另一半时间写评估 Prompt 的代码。
关注我们,一起把技术讲明白(寻码札记)