note
- CED:省 Prefill
- CSA2 + FP4:省 KV Cache
文章目录
一、DeepSeek-V4.1-Flash
DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression
技术报告:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash/blob/main/DeepSeek_V41_Tech_Report.pdf Hugging Face
- 模型定位:552B MoE,多模态输入,最大 1M context。最大特点不是单纯"更大",而是专门为 长上下文 + Agentic workload 做低成本推理。Prefill 每 token 只激活约 8B 参数,Decode 约 16B。
- 核心架构:CED。40 层被拆成 20 层 causal encoder + 20 层 decoder。Decoder 的 global KV 不再每层自己为整段 prompt 重算,而是由 encoder 最终 hidden state 投影得到,因此长 prompt 的 prefill 计算接近减半。
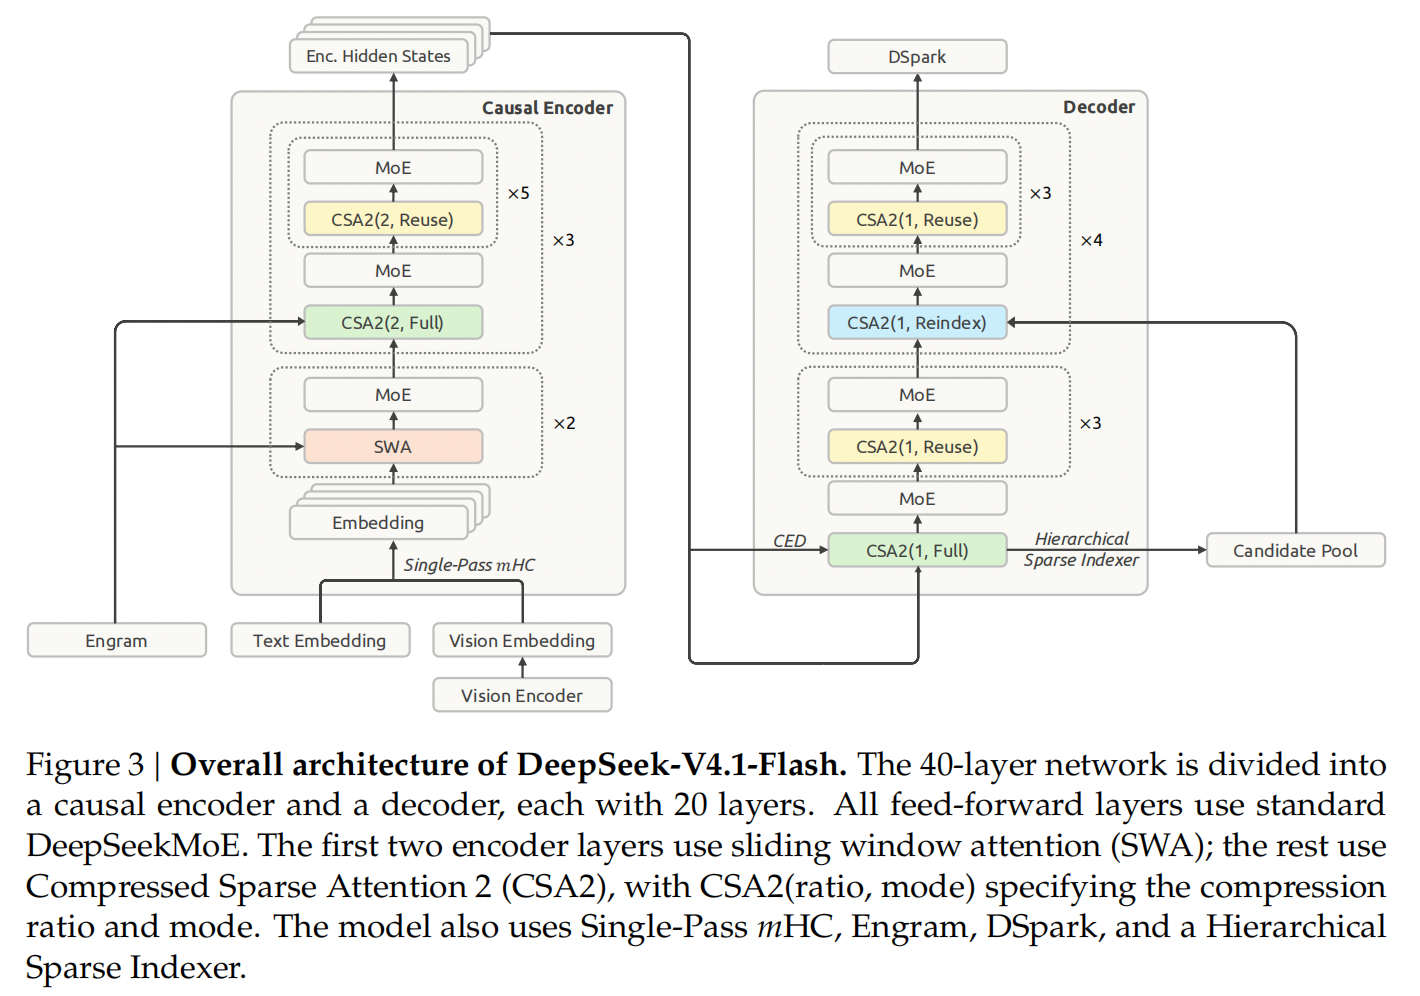
- CSA2:重点解决 KV Cache。Attention 层分成 Full / Reindex / Reuse 三种模式,跨层共享 KV、复用 Top-K sparse index;Decoder 再加 Hierarchical Sparse Indexer,后层只在前层筛出的候选里检索。配合 FP4 KV Cache,global KV 降到约 890 B/token,约为 V4-Flash 的 1/4。
- SWA Bounded Replay:Sliding-window attention 的局部 KV 不长期落 SSD;cache miss 时只 replay 最近一个 window,从而让 persistent KV footprint 降到上一代约 1/8。
- 其他结构升级:Single-Pass mHC 改 residual mixing;Engram 提供 196B 稀疏条件记忆;DSpark 用于 speculative decoding;MoE 每层 384 routed experts + 1 shared expert,每 token 激活 6 个 routed experts。
- 原生多模态:DeepSeek-ViT + 2-layer MLP projector,把 image embedding 从预训练一开始就和 text embedding 联合训练,不再是后挂一个 vision adapter。Vision encoder 使用 2D-RoPE 和 3×3 pixel-unshuffle 降采样。
- 训练:从头在约 45T multimodal tokens 上预训练;64K sparse-attention training,后续扩到 1M context。Post-training 本身没有特别新的 RL 算法,仍是 SFT → RL → On-Policy Distillation,真正的增量主要来自大规模 agent task/environment synthesis 和更多 rollout。
- 效果:官方结果里 Base 模型用 552B、8B/16B active 参数,很多文本/代码指标已经接近甚至超过 1.6T V4-Pro;Agentic benchmark 上 DeepSWE 74.2、Terminal-Bench 2.1 90.6、CyberGym 88.1。