- 核心痛点:电池包CFD热仿真单工况耗时24~48小时,迭代成本高;模型简化与精度之间存在固有矛盾,忽略接触热阻可导致5℃以上温差低估 。
- 方法本质:物理信息神经网络(PINN)将PDE控制方程作为软约束嵌入损失函数,训练后推理阶段仅需毫秒级,相比传统CFD可实现千倍至十万级速度提升 。
- 精度表现:在方形电池温度预测中,PINN模型RMSE低至0.48 ℃(UUDS动态工况),优于纯数据驱动模型;低温下LFP电池MAE可达0.07 ℃ 。
- 落地边界:单物理场前向问题TRL约6级,3D复杂几何与多物理场耦合仍处TRL 3~4级;边界精度、大规模收敛性、生产管线集成是三大落地卡点 。
互动投票
🔍 你认为PINN在电池热管理领域的近期最可能落地场景是什么?
A. 单体/模组级温度场快速预测(设计优化迭代)
B. BMS实时温度估计与热失控预警
C. 多参数敏感性分析与代理模型
D. 目前还看不到落地可能
欢迎在评论区留下你的答案和理由,期待一起交流!
一、问题意识:电池热仿真的"速度-精度"两难
1.1 从工程现场说起:等待48小时的一次迭代
电动汽车电池热管理系统(BTMS)的设计流程中,热仿真是一个不可替代的环节。电池在充放电过程中因欧姆内阻、极化内阻和熵变产生热量,若散热不及时,会导致温度分布不均、加速容量衰减,极端情况下引发热失控。工程师需要通过仿真来预测电池在不同工况下的温度场,进而优化冷却结构、选型材料、确定控制策略。
传统的仿真手段主要依赖计算流体动力学(CFD)和有限元法(FEM)。以一个包含100个单体的电池包为例,若采用百万级网格,需8~16核高性能计算(HPC)集群支持,单工况计算通常需要24~48小时 。而在设计优化流程中,工程师往往需要对数十乃至上百组参数组合进行仿真对比------冷却通道尺寸变化0.5毫米、冷却液流量调整10%、材料导热系数更新10%,每一次参数调整都意味着重新经历一轮漫长的等待。多物理场耦合仿真(如电化学-热耦合)的计算量更是单一物理场的3~5倍,资源不足时项目延期几乎是常态 。
更具体的案例来自相变材料(PCM)耦合场景:18650电芯+PCM翅片模型,网格量达1200万,128G内存服务器跑满,Fluent并行64核单工况耗时42小时;即使用COMSOL 6.1默认网格也要18小时 。相变潜热180 kJ/kg的非线性特性,使得等效热容法的时间步长必须小于0.1秒才能收敛,物理时间200秒的仿真需要跑一整夜。对于需要反复迭代的设计优化而言,这样的计算效率几乎构成了"探索禁区"------参数空间越大,优化越无从谈起。
1.2 模型简化的陷阱:精度与速度的拉锯
面对计算量的压力,工程师的应对策略通常是模型简化:忽略极片纹理、合并模组结构、用均匀化等效替代精细结构。然而,简化是有代价的。例如,忽略电池单体之间的接触热阻(约0.1~0.5 K·m²/W),会低估模组内部的温度差异,低估幅度可能高达5℃以上 。对于电池热管理系统而言,5℃的误差足以影响冷却策略的有效性评估,甚至直接关系到热失控预警的准确性。
反过来,如果拒绝简化,保留所有几何细节,网格数量会突破千万级,计算周期延长至数天,工程上同样不可接受。这种"简化则不准,不简则算不动"的两难,是电池热仿真领域长期存在的结构性矛盾。它不仅限制了设计空间的探索范围,也延缓了新技术从概念验证到工程落地的速度。
1.3 纯数据驱动代理模型的"阿喀琉斯之踵"
为了突破计算效率瓶颈,数据驱动的代理模型(Surrogate Model)近年来被广泛引入。其基本思路是:先用CFD生成一批仿真数据,然后训练一个神经网络来拟合输入参数(如冷却通道几何、材料属性、工况条件)与输出温度场之间的映射关系。训练完成后,单次预测仅需毫秒级,效率提升可达数个数量级。
然而,纯数据驱动模型存在一个根本性缺陷:它对训练数据的质量和数量极度依赖。当设计空间发生变化,或者遇到训练数据未覆盖的"陌生"工况时,模型的预测可能严重偏离物理规律 。例如,在绝热边界上出现不合理的温度梯度,或者能量守恒不再满足。对于热管理这类安全性相关的应用,这种"物理上不可信"的预测结果可能带来比低效率更严重的后果。
数据驱动模型的另一个局限在于泛化能力。如果电池包结构从液冷改为直冷,或者电芯从方形换成软包,之前训练好的代理模型往往需要大量新数据重新训练。这意味着代理模型的构建成本本身并不低------需要先跑上百组CFD仿真才能获得足够的训练样本,而这些样本的生成依然受制于传统方法的计算效率。
1.4 从"二选一"到"第三条路":物理与数据的融合
既然纯物理方法太慢、纯数据方法不可靠,那么将两者结合是否能获得两全其美的效果?物理信息神经网络(Physics-Informed Neural Networks, PINN)正是沿着这一思路发展起来的技术方向。PINN的核心思想简洁而优雅:不将物理定律视为与数据无关的外部验证标准,而是将描述系统行为的控制方程(如热传导方程、Navier-Stokes方程)直接嵌入神经网络的训练目标中,作为损失函数的一部分 。
换句话说,PINN让神经网络在拟合数据的同时,必须"学会遵守"物理守恒定律。这相当于给模型加上了一层物理约束的正则化------即使在数据稀疏的区域,模型也不能随意输出违背能量守恒、质量守恒的结果。对于电池热管理这样数据获取成本高、物理规律明确的领域,PINN的理论优势尤为突出。
当然,PINN不是万能钥匙。它在训练收敛性、边界精度、大规模问题适用性等方面仍有诸多挑战。本文的后续部分将系统展开这些讨论:从PINN的基本原理到完整的代码实现,从一维导热方程的简单验证到三维多物理场的扩展,最后从工程落地的视角评估其成熟度与适用边界。
二、核心方法:PINN原理与PyTorch代码实现
2.1 PINN的数学本质:PDE约束下的函数逼近
要理解PINN,首先需要理解它试图解决的问题类型。在工程热物理中,大多数问题可以抽象为偏微分方程(PDE)的边值问题或初边值问题。以一维瞬态热传导方程为例,其数学形式为:
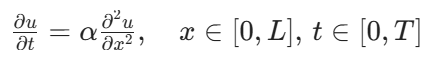
其中 u(x,t)是位置x处时刻t的温度,α是热扩散系数。这个方程描述了热量在一维介质中的扩散过程。给定初始条件u(x,0)=u0(x)和边界条件(如两端固定温度 u(0,t)=u(L,t)=0)),求解温度场随时间的演化,这就是热传导方程的正问题。
传统的有限差分法(FDM)、有限元法(FEM)和有限体积法(FVM)都通过空间离散的方式将PDE转化为代数方程组,然后求解。而PINN走了一条完全不同的路:它用一个神经网络
uθ(x,t)来逼近解函数,其中θ是网络的可训练参数(权重和偏置)。神经网络的输入是空间坐标x 和时间t,输出是温度u。
关键在于如何"教会"这个网络满足热传导方程。PINN的做法是构造一个包含三部分的损失函数:
- PDE残差损失(L_PDE):在求解域内随机采样一批坐标点,将网络输出代入热传导方程左端与右端的差值(即残差),最小化残差的平方和。数学上,残差f(x, t)定义为:
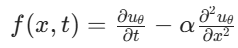
理想情况下,f(x, t) 应该处处为零。通过自动微分(Automatic Differentiation)技术,我们可以精确计算网络输出对输入的各阶导数,从而计算残差。
-
边界条件损失(L_BC):在边界点上计算网络输出与边界条件之间的差异。例如,对于Dirichlet边界条件 u(0, t) = 0,损失就是uθ(0,t) 的平方。
-
初始条件损失(L_IC):在初始时刻采样点上计算网络输出与初始条件之间的差异。
总损失是这三部分的加权和:
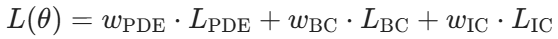
其中权重 w是可调超参数,用于平衡不同约束的相对重要性 。
这种"软约束"方式与传统数值方法的"硬满足"有本质区别。传统方法通过离散格式严格(在截断误差范围内)满足控制方程,而PINN是通过优化过程渐进地逼近满足。这既是PINN的灵活性来源(无需网格、天然支持复杂几何),也是其挑战所在------损失下降不代表物理上一定正确。
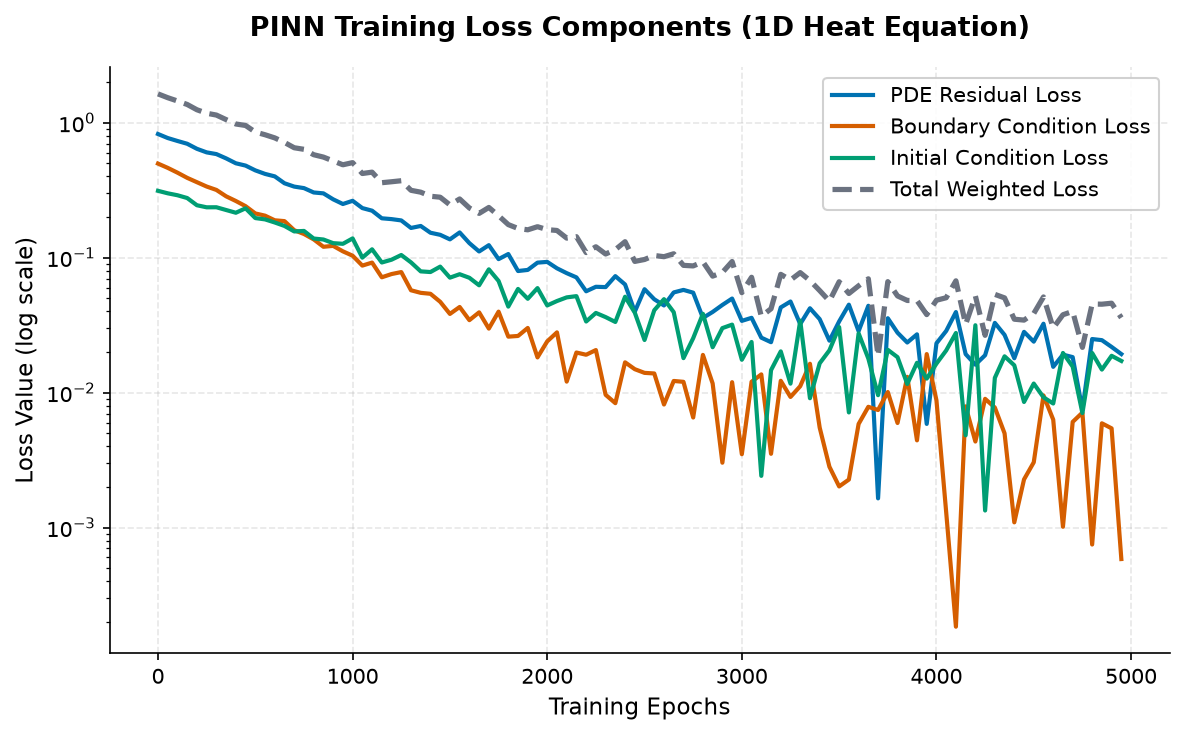
图1:PINN训练过程中PDE残差损失、边界条件损失、初始条件损失及总损失的典型变化趋势。三类损失在训练中同步下降,但下降速率和最终收敛值受权重分配影响。
2.2 自动微分:PINN的技术基石
PINN之所以可行,很大程度上得益于深度学习框架中的自动微分(Autograd)技术。在PyTorch中,torch.autograd.grad 函数可以计算标量输出对输入的任意阶导数,且计算结果在数学上是精确的(与数值微分相比,不存在截断误差)。
具体来说,计算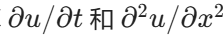 的过程如下:
-
第一步:计算一阶导数
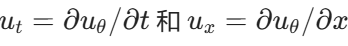
-
第二步:用一阶导数的结果再次求导,得到二阶导数
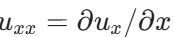
-
第三步:将各阶导数代入PDE,计算残差
这个过程需要注意几个技术细节:计算高阶导数时必须设置 create_graph=True(保留计算图以支持更高阶微分)和 retain_graph=True(避免中间计算图被释放)。此外,显存管理也是一个需要关注的问题,特别是在三维问题中,高阶导数的计算图可能占用大量显存 。
2.3 极简版PyTorch实现(100行内)
下面给出一维热传导方程PINN的完整PyTorch实现,代码控制在100行以内,包含网络定义、残差计算、损失函数、训练循环和结果可视化。对应物理问题:两端固定温度为0的一维杆,初始温度分布为正弦函数,求温度随时间的扩散过程。
python
import torch
import torch.nn as nn
import numpy as np
import matplotlib.pyplot as plt

torch.manual_seed(42)

# ============================================================
# 1. 定义PINN网络:6层全连接 + SiLU激活
# ============================================================
class PINN(nn.Module):
    def __init__(self, hidden=64, layers=6):
        super().__init__()
        modules = [nn.Linear(2, hidden), nn.SiLU()]  # 输入: x, t
        for _ in range(layers - 2):
            modules += [nn.Linear(hidden, hidden), nn.SiLU()]
        modules.append(nn.Linear(hidden, 1))        # 输出: u(温度)
        self.net = nn.Sequential(*modules)

    def forward(self, x, t):
        inputs = torch.cat([x, t], dim=1)
        return self.net(inputs)

# ============================================================
# 2. 计算PDE残差(核心:自动微分求导)
# ============================================================
def pde_residual(model, x, t, alpha=0.1):
    x.requires_grad_(True)
    t.requires_grad_(True)
    u = model(x, t)

    # 一阶导数
    u_t = torch.autograd.grad(u, t, torch.ones_like(u),
                              create_graph=True, retain_graph=True)[0]
    u_x = torch.autograd.grad(u, x, torch.ones_like(u),
                              create_graph=True, retain_graph=True)[0]
    # 二阶导数
    u_xx = torch.autograd.grad(u_x, x, torch.ones_like(u_x),
                               create_graph=True)[0]
    # 热传导方程残差: ∂u/∂t - α·∂²u/∂x² = 0
    residual = u_t - alpha * u_xx
    return residual

# ============================================================
# 3. 采样函数:在求解域、边界、初始时刻分别采样
# ============================================================
def sample_domain(n=1000):
    x = torch.rand(n, 1)                     # x ∈ [0, 1]
    t = torch.rand(n, 1) * 0.5               # t ∈ [0, 0.5]
    return x, t

def sample_boundary(n=200):
    t = torch.rand(n, 1) * 0.5
    x_left = torch.zeros(n, 1)                # x=0 边界
    x_right = torch.ones(n, 1)                # x=1 边界
    u_bc = torch.zeros(n, 1)                  # 两端温度为0
    return (x_left, t, u_bc), (x_right, t, u_bc)

def sample_initial(n=500):
    x = torch.rand(n, 1)
    t = torch.zeros(n, 1)
    u_ic = torch.sin(np.pi * x)               # 初始温度: sin(πx)
    return x, t, u_ic

# ============================================================
# 4. 训练循环
# ============================================================
model = PINN(hidden=64, layers=6)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=2000, gamma=0.5)

alpha = 0.1  # 热扩散系数
loss_history = []

for epoch in range(5001):
    optimizer.zero_grad()

    # (1) PDE残差损失
    x_d, t_d = sample_domain(1000)
    residual = pde_residual(model, x_d, t_d, alpha)
    loss_pde = torch.mean(residual ** 2)

    # (2) 边界条件损失
    (xl, tl, ubl), (xr, tr, ubr) = sample_boundary(200)
    loss_bc = (torch.mean((model(xl, tl) - ubl) ** 2) +
               torch.mean((model(xr, tr) - ubr) ** 2))

    # (3) 初始条件损失
    xi, ti, uic = sample_initial(500)
    loss_ic = torch.mean((model(xi, ti) - uic) ** 2)

    # 总损失(加权和)
    loss = loss_pde + 10 * loss_bc + 5 * loss_ic
    loss_history.append(loss.item())

    loss.backward()
    optimizer.step()
    scheduler.step()

    if epoch % 500 == 0:
        print(f"Epoch {epoch:4d} | Loss: {loss.item():.6f} | "
              f"PDE: {loss_pde.item():.6f} | BC: {loss_bc.item():.6f} | "
              f"IC: {loss_ic.item():.6f}")

# ============================================================
# 5. 结果可视化
# ============================================================
model.eval()
with torch.no_grad():
    x_test = torch.linspace(0, 1, 200).unsqueeze(1)
    t_test = torch.ones_like(x_test) * 0.3  # t = 0.3 时刻
    u_pred = model(x_test, t_test).numpy().flatten()

    # 解析解: u(x,t) = sin(πx) * exp(-α·π²·t)
    u_exact = np.sin(np.pi * x_test.numpy().flatten()) * np.exp(-alpha * np.pi**2 * 0.3)

print(f"\n=== 误差分析 (t=0.3) ===")
print(f"MAE: {np.mean(np.abs(u_pred - u_exact)):.6f}")
print(f"RMSE: {np.sqrt(np.mean((u_pred - u_exact)**2)):.6f}")
运行上述代码,在普通CPU上约需2~3分钟完成5000轮训练,最终温度场与解析解的均方根误差(RMSE)通常在0.001~0.005量级(归一化温度)。
2.4 代码要点解读
以上代码虽然简洁,但覆盖了PINN实现的全部核心要素,以下逐一说明。
网络架构的选择。代码中使用了6层全连接网络,隐藏层宽度为64,激活函数为SiLU(Sigmoid Linear Unit)。对于简单的一维问题,这样的网络规模已经足够。SiLU激活函数(即x⋅σ(x))相比ReLU具有平滑的梯度,在PINN训练中通常表现更稳定。更深的网络(8~10层)和更宽的隐藏层(128~512)通常用于更高维或更复杂的问题,但并非越深越好------网络容量过大会增加训练难度和过拟合风险。
损失函数的权重分配。代码中将边界损失的权重设为10、初始损失设为5,而PDE损失权重为1。这样的设置反映了一个常见的工程经验:边界条件和初始条件是PDE问题的"硬约束",需要更强的惩罚力度才能保证模型在边界处的精度。权重的最优值因问题而异,通常需要通过网格搜索或自适应调整来确定。权重选择不当可能导致某一类损失主导训练,从而使其他约束得不到充分满足。
采样策略。PINN的训练数据不是标注样本(输入-输出对),而是求解域内的随机采样点。代码中使用了均匀随机采样------在整个求解域内均匀分布的坐标点。对于一维问题,均匀采样通常足够;但对于高维问题或解的空间变化剧烈的问题,自适应采样(在梯度大的区域加密采样点)能显著提升训练效率和精度。
优化器与学习率调度。代码使用Adam优化器,初始学习率为 10^-3,每2000轮衰减为原来的0.5倍。这是一个相对保守的设置,适用于大多数PINN问题。对于更难收敛的问题,可以结合使用L-BFGS优化器(二阶优化)在Adam之后进行精细调优------L-BFGS在局部收敛速度上通常优于Adam,但对内存和计算资源的需求也更高。
2.5 与解析解/有限差分法的对比验证
为了验证PINN的有效性,我们从三个维度进行对比:精度、速度和适用场景。
精度对比。对于上述一维热传导问题(解析解已知),PINN在5000轮训练后的RMSE通常在 10^-3~10^-4 量级(归一化温度),与有限差分法(FDM)在中等网格(100个空间格点)下的精度相当。如果增加训练轮次或使用更复杂的网络结构,PINN的精度还可以进一步提升。值得注意的是,PINN的误差在整个求解域内分布相对均匀,而FDM的误差受网格分辨率和时间步长的共同影响。
速度对比。这里需要区分"训练时间"和"推理时间"两个概念。PINN的训练阶段需要数千次迭代,每次迭代涉及前向传播和多次反向传播(计算高阶导数),因此单问题的训练时间可能从几分钟到数小时不等------这与FEM/FDM相比并不占优势,甚至可能更慢。PINN的速度优势体现在推理阶段:一旦模型训练完成,对新的时空坐标点进行温度预测仅需一次前向传播,耗时在毫秒级以下。对于需要大量重复计算的场景(如参数优化、批量工况计算),这种"一次训练、多次推理"的模式可以带来千倍乃至万倍的效率提升。
场景对比。FEM/FDM的优势在于通用性和成熟度------几乎任何几何形状、任何边界条件、任何材料属性的问题都可以用商用软件(如ANSYS、COMSOL)求解,且结果的可靠性经过了数十年工程实践的检验。PINN的优势在于参数化问题:当需要对不同参数组合(如不同导热系数、不同热源强度、不同边界温度)反复求解时,PINN可以将参数也作为网络输入,实现一次训练覆盖整个参数空间。这是传统数值方法难以比拟的。
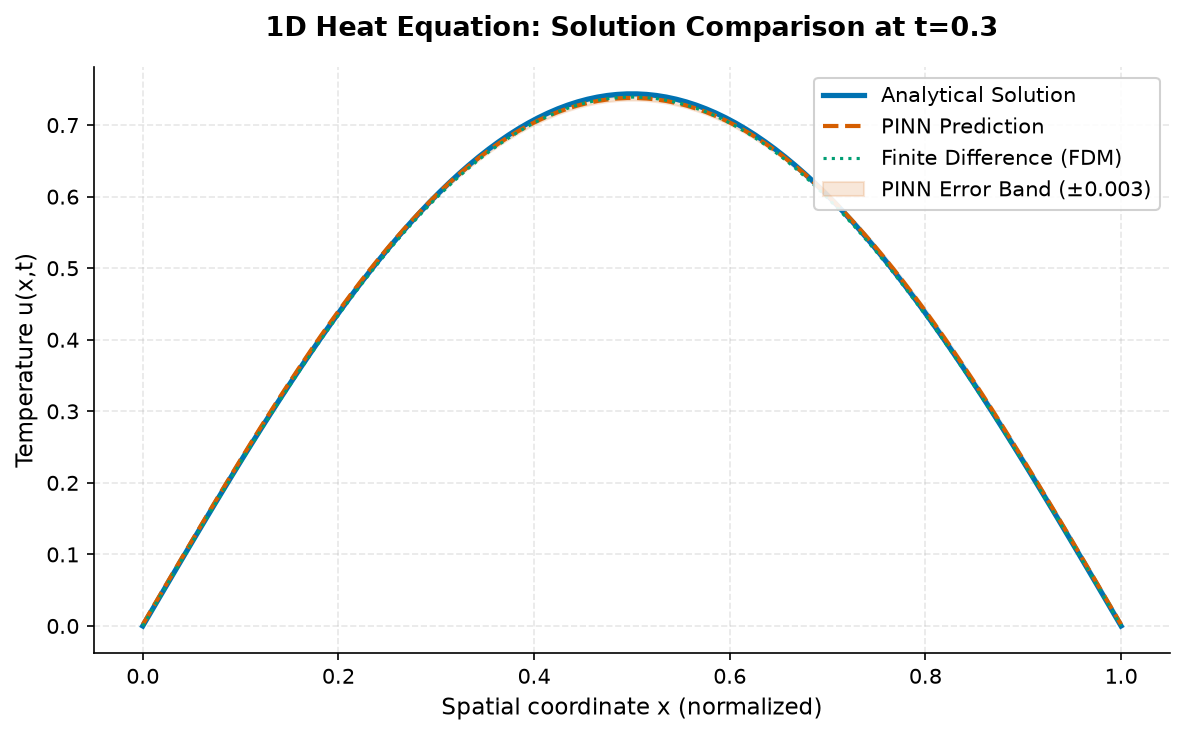
图2:一维热传导方程在t=0.3时刻的温度分布对比。PINN预测(红色虚线)与解析解(蓝色实线)几乎重合,有限差分法(绿色点线)也给出了高度一致的结果。误差条显示PINN的典型预测偏差范围。
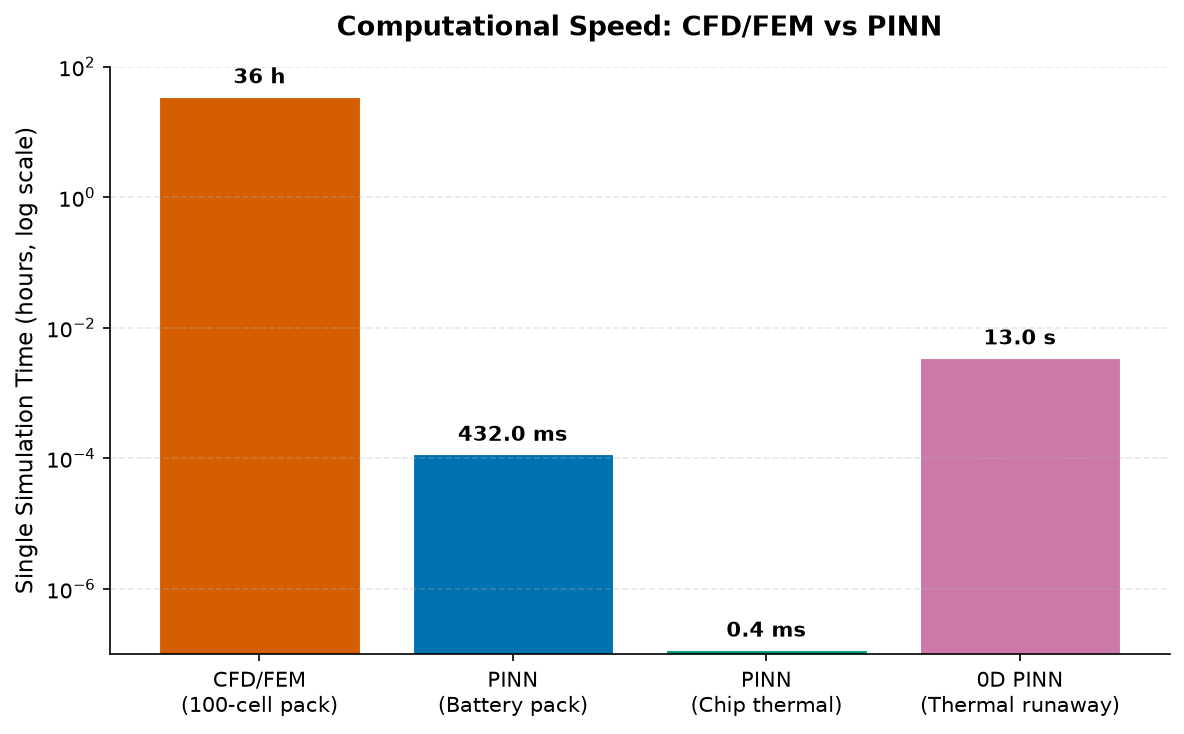
图3:不同方法在典型应用场景下的单次计算时间对比(对数坐标)。PINN推理阶段的速度优势可达3~6个数量级,但需注意这是训练完成后的推理速度。
三、进阶讨论:从一维导热到电池热管理的真实场景
3.1 三维问题:维度升高带来的挑战
一维热传导方程是PINN最基础的验证案例。实际的电池热管理问题通常涉及三维空间(电芯内部三维温度分布、模组级温度场、电池包级流固耦合等)。从一维到三维,PINN面临的挑战并非简单的线性增长。
首先是采样效率问题。三维空间中,均匀随机采样的覆盖率随维度升高而急剧下降("维度灾难"的一种表现)。要在三维空间中获得与一维问题相当的采样密度,需要的采样点数量呈指数增长,这直接增加了每轮训练的计算量。
其次是网络容量问题。三维问题的解空间结构更为复杂,通常需要更深、更宽的网络来表达。以电池包热管理为例,研究者使用了6层512隐藏单元的前馈网络配合SiLU激活函数来表示电池包内各域的温度分布 。网络参数的增加不仅意味着更多的计算量,也意味着优化难度的上升------参数空间更加非凸,训练更容易陷入局部最优。
第三是边界条件的复杂性。三维问题的边界不再是两个端点,而是复杂的三维曲面。如何高效地在曲面上采样、如何准确计算边界法向导数(Neumann边界条件)、如何处理不同边界类型的混合(Dirichlet、Neumann、Robin),都需要更精巧的设计。特别是对于电池包这类包含多种材料界面的复杂结构,界面处的温度连续和热流连续条件对PINN提出了额外的约束要求。
针对这些挑战,研究者提出了多种改进方向,包括傅里叶神经网络(Fourier Neural Network)用于捕捉高频解 、自适应配点采样(Adaptive Collocation Sampling)用于提高采样效率、残差注意力机制用于强化界面和大梯度区域的表示能力 。这些改进在特定问题上取得了效果,但距离通用的、可工程化部署的三维PINN求解器仍有距离。
3.2 多物理场耦合:热-电-化学的统一建模
电池热管理并非纯热传导问题。电池的产热源于电化学过程------焦耳热、反应热、熵热同时存在,且产热率与电池的SOC(State of Charge)、电流、温度等状态量密切相关。更精确的电池热模型需要热-电-电化学多物理场的耦合求解。
传统仿真工具处理多物理场耦合通常采用"分区耦合"或"松耦合"策略:先求解电化学场得到产热率,再导入热模型计算温度场,温度场的变化又反过来影响电化学参数(如内阻随温度变化),如此迭代直至收敛。这种方法在工程上可行,但存在两个问题:一是不同物理场的时间尺度差异巨大(电化学反应毫秒级,热扩散秒级),需要精心设计时间步长和耦合频率;二是场间数据传递可能引入插值误差和数值耗散。
PINN在多物理场耦合方面有一个天然的理论优势:多个物理场的控制方程可以统一嵌入到同一个损失函数中,由同一个神经网络同时预测所有场量。例如,在电热耦合问题中,网络可以同时输出温度场和电势场,热传导方程与欧姆定律同时作为约束出现在损失函数中。近期的研究提出了残差注意力PINN(RA-PINN)框架,用于稳态电热能源系统的多物理场仿真,在耦合速度场、压力场、电势场和温度场的问题上,相比纯MLP和传统PINN架构取得了更低的误差 。
然而,多物理场耦合也显著增加了PINN的训练难度。不同物理场的残差在数值量级上可能相差数个数量级,如何平衡各场损失的权重是一个棘手的问题。权重失衡会导致某一个物理场的约束被"淹没",训练结果只满足部分方程。自适应权重调整(Adaptive Loss Weighting)是目前常用的应对策略,但尚无通用的最优方案。
在电池领域,已有研究将PINN用于耦合电池电化学-热特性的物理建模。例如,通过计算电池SOC和生热率作为模型输入,将导热模型集成到神经网络框架中,实现未知电池参数的在线识别和无传感器温度预测 。增强型PINN模型则进一步将焦耳热、可逆熵热和辐射损失同时纳入损失函数,并引入电荷一致性项将SOC行为与热动力学关联起来,在三种商用电池化学体系(LFP、LCO、NMC)中均取得了良好效果 。
3.3 边界条件泛化:从固定约束到参数化约束
在一维导热的简单案例中,边界条件是固定的(两端温度为零)。但在工程实践中,边界条件往往是设计变量或工况参数------冷却液入口温度、对流换热系数、环境温度等,都可能在不同场景下变化。如果PINN只能针对一组特定的边界条件训练,那么它在工程中的价值将大打折扣。
参数化边界条件(Parametric BC)是解决这一问题的思路:将边界条件参数(如对流换热系数 h、环境温度T∞)也作为神经网络的输入维度。这样,同一个模型就可以覆盖一定范围内的不同边界条件组合,实现"一次训练、多工况适用"。这对于设计优化和参数敏感性分析场景特别有价值------训练好的模型可以在毫秒级完成任意参数组合下的温度场预测,使得大规模参数扫描成为可能。
边界条件泛化的另一个方向是处理复杂的边界类型,如Robin边界条件(对流边界)、混合边界条件(部分Dirichlet部分Neumann)、移动边界(相变界面)等。这些在传统CFD中已有成熟处理方案的边界条件,在PINN框架下如何准确、高效地施加,仍是一个活跃的研究方向。特别是Robin边界条件,它涉及法向导数的计算,对PINN的自动微分精度和边界采样密度都有较高要求。
现有研究表明,PINN在边界处的精度往往低于域内精度,这是PINN应用中一个普遍存在的问题。这种现象有时被称为"梯度病理"或"频谱偏差"------优化过程倾向于最小化全域的平均残差,而边界处的点在总采样点中占比较小,其误差对总损失的贡献有限,因此容易被"忽视" 。对于热管理工程而言,边界处的热通量精度往往是最关键的设计指标(如冷却液带走的热量、壁面最高温度),边界精度不足是PINN走向工程应用必须解决的问题。
混合正则化(Hybrid Regularization)是一种提升边界精度的可行策略:在保留自动微分计算的PDE残差作为主损失的同时,额外引入一个基于有限差分的辅助正则化项,专门针对边界附近的区域进行强化约束 。这种方法在不改变PINN整体框架的前提下,有针对性地提升了关键区域的精度,是一种工程上实用的折中方案。
四、AI工具使用心得:如何快速上手PINN这类前沿算法
4.1 学习路径与工具选择
对于有一定Python和深度学习基础但从未接触过PINN的工程技术人员,从零开始学习这一前沿方向通常需要经历三个阶段:概念理解、代码复现、问题移植。AI编程工具在每个阶段都可以显著降低学习曲线的陡峭程度。
概念理解阶段,首要任务是建立对PINN核心思想的直觉认知------物理方程如何嵌入损失函数、自动微分如何计算PDE残差、训练过程如何推动网络满足物理约束。这个阶段的学习素材来源广泛,包括Raissi等人的经典论文 、GitHub上的开源实现(如maziarraissi/PINNs官方仓库)、以及各类技术博客。AI工具的价值在于将抽象的数学公式转化为可理解的直觉解释------可以让AI用类比的方式解释PINN与传统数值方法的区别,用流程图描绘训练过程,用具体的数值例子说明残差的计算方式。
代码复现阶段,直接从论文公式推导到完整代码实现之间存在一个"实现鸿沟"。公式是连续的、符号化的,而代码是离散的、工程化的------数据类型选择、张量维度管理、自动微分API的正确使用、损失函数的数值稳定性等,都是论文不会详细讨论但决定代码能否跑通的关键。AI工具可以在这个阶段发挥"结对编程"的作用:将PINN的数学描述转化为PyTorch/TensorFlow代码,指出代码中可能存在的维度不匹配或梯度计算错误,提供可运行的最小示例。
问题移植阶段,也就是将通用的PINN框架应用到自己关心的具体问题(如电池热管理)上。这是最困难也最有价值的一步。需要根据具体物理问题调整PDE形式、修改边界条件处理方式、设计合适的网络架构和损失权重。AI工具可以帮助快速迭代不同的方案,快速验证某个改动是否有效,但需要警惕的是,AI给出的方案可能在数学上正确但在工程上不实用------比如推荐的网络规模过大导致训练无法收敛,或者建议的采样策略忽略了数值稳定性问题。
4.2 Prompt设计的实用技巧
使用AI工具学习和实现PINN的过程中,Prompt的质量直接影响产出的质量。以下是一些经过实践验证的技巧:
明确问题的物理定义。 不要只说"帮我写一个PINN",而要具体说明是求解什么PDE、几维问题、什么类型的边界条件和初始条件、需要求解正问题还是反问题。例如:"用PyTorch实现一个求解二维稳态热传导方程的PINN,左边界为第一类边界条件(固定温度100°C),右边界为第二类边界条件(绝热),上下边界为第三类边界条件(对流换热,换热系数h=100 W/m²K,环境温度25°C),区域内有均匀内热源Q=5e5 W/m³"。这样的Prompt所得到的代码质量远高于模糊的需求描述。
分步验证,逐步推进。 不要试图让AI一次性生成完整的训练代码然后期待它能直接运行。正确的做法是分模块验证:先验证网络定义和前向传播是否正确,再验证PDE残差计算是否正确(可以用一个简单的已知函数代入验证),再验证损失函数的各部分计算是否独立工作,最后组装成完整的训练循环。每一步都让AI输出可单独测试的代码片段,测试通过后再进入下一步。
用物理直觉审查AI的输出。 AI生成的PINN代码可能在语法上正确但在物理上有错误------比如PDE残差的符号搞反了(虽然不影响损失值,但可能导致理解混乱)、边界条件的类型与代码实现不匹配、热扩散系数的单位与其他参数不一致等。这些问题需要使用者具备基本的物理判断力,不能盲目信任AI的输出。一个实用的验证方法是:先用一个已知解析解的简单问题来测试代码,如果在简单问题上结果正确,再逐步增加复杂度。
主动要求AI解释关键部分。 对于自动微分计算高阶导数这类容易出错的环节,应该要求AI解释每一步的计算逻辑,而不是只给出代码。理解了"为什么这样写",才能在出问题时快速定位原因。同样,对于损失函数的权重选择、网络架构的设计依据,也应该要求AI给出理由,而不是当作黑盒使用。
4.3 踩过的坑与验证方法
在将AI工具辅助开发的PINN代码用于实际问题之前,以下几个常见的"坑"值得特别注意。
第一个坑:自动微分的retain_graph参数误用。 计算PDE残差需要多次调用torch.autograd.grad,如果retain_graph设置不正确,要么会报计算图已释放的错误,要么会因为重复保留计算图导致显存泄漏。AI生成的代码有时会图省事地在所有地方都设为True,这在小规模问题上没问题,但在三维问题上可能导致显存爆炸。正确的做法是只在需要保留计算图的地方(计算高阶导数时)设为True,最后一次求导时可以设为False以释放显存。
第二个坑:损失函数的数值尺度差异。 AI生成的PINN代码通常直接将各部分损失简单相加,但PDE残差、边界损失、数据损失的数值量级可能相差几个数量级。如果不做归一化或加权处理,数值大的那一项会主导训练,其他约束形同虚设。解决方法包括:对各损失项做无量纲化处理、使用自适应权重调整策略、或者根据物理直觉手动设置权重(如本文代码中给边界损失加10倍权重)。
第三个坑:采样点数量与分布不当。 AI代码中常见的设置是固定数量的随机均匀采样,但对于解的梯度变化剧烈的区域(如热源附近、材料界面处),均匀采样的覆盖率不足,会导致这些区域的精度显著低于其他区域。验证方法是画出残差的空间分布------如果某些区域的残差系统性地高于其他区域,就说明采样密度不够。改进方向包括自适应采样(残差大的地方增加采样点)或重要性采样。
第四个坑:验证方式单一。 只看总损失曲线是否下降是不够的。损失下降只说明模型在优化目标上取得了进展,但不代表物理上一定正确------可能存在"损失低但解偏"的情况。正确的验证方式应该是多维度的:与解析解对比(如果有)、与传统数值方法的结果对比、检查物理守恒量(如总热量是否守恒)、检查边界条件的满足程度、在训练集外的测试点上评估精度。AI工具可以辅助生成这些验证代码,但验证的设计和判断仍需要人的物理直觉。
总的来说,AI工具是PINN学习和开发的"加速器"而非"替代者"。它可以显著缩短从概念到可运行代码的时间,但代码的物理正确性、数值稳定性、工程实用性仍需要开发者自己把关。将AI的快速生成能力与人的物理判断和工程经验相结合,是高效掌握PINN这类前沿技术的最佳路径。
五、跨体系对比与拓展
5.1 PINN vs 传统CFD/FEM:不是替代而是互补
在讨论PINN的工程价值时,一个常见的问题是:它能替代传统CFD/FEM吗?答案是否定的,至少在可预见的未来是否定的。PINN和传统数值方法各有其适用场景,两者更像是互补关系而非竞争关系。
传统CFD/FEM的优势在于成熟度和通用性。经过数十年的发展,商用CFD软件(ANSYS Fluent、Star-CCM+、COMSOL等)已经形成了完整的生态:从几何建模、网格生成、求解器选择到后处理,都有标准化的工具链和成熟的用户社区。几乎任何类型的热流体问题都可以用这些工具求解,且结果的可靠性经过了大量工程验证。对于需要高精度认证的场景(如航空航天、核电安全),传统数值方法仍然是不可替代的标准方法。
PINN的优势集中在参数化问题和实时性需求场景。当需要对同一物理模型的不同参数组合进行大量计算时(如设计优化、参数敏感性分析、蒙特卡洛不确定性分析),PINN的"一次训练、多次推理"模式可以带来数量级的效率提升。当需要嵌入式实时计算时(如BMS中的温度估计、数字孪生中的实时预测),PINN的毫秒级推理速度是CFD无法比拟的。此外,PINN在反问题(如根据有限测点反求材料参数、边界热流)上也有独特的优势------只需将待反求的参数设为可训练变量,即可在同一框架下求解。
一个合理的工程定位是:传统CFD/FEM用于高保真基准仿真和验证,PINN用于基于这些基准的快速预测和参数空间探索。两者可以形成"CFD生成少量高精度样本 → PINN学习并覆盖整个参数空间 → 关键工况返回CFD验证"的协同工作流。
5.2 PINN vs 纯数据驱动代理模型:物理约束的价值
与纯数据驱动的代理模型(如普通神经网络、高斯过程回归、多项式混沌展开等)相比,PINN的核心差异在于物理约束的嵌入。这种差异带来了几方面的影响。
在数据充足的情况下,纯数据驱动模型的精度可能不低于甚至高于PINN。毕竟,PINN的物理约束是"软约束",模型仍需要通过数据来确定具体的解。当数据足够丰富时,数据本身已经足以约束模型,额外的物理约束可能贡献有限。
在数据稀疏的情况下,PINN的优势开始显现。物理约束起到了正则化的作用,防止模型在数据不足的区域随意外推。这一点对于电池热管理尤其重要:极端工况(如快充、低温启动、热失控初期)的实验数据往往难以获取,而这些工况恰恰是安全设计的关键。PINN可以在少量数据的基础上,结合物理定律给出相对可靠的预测,而纯数据驱动模型在这些区域的外推结果可能完全不可信。
PINN的另一个优势是物理一致性。即使预测结果与真实值有偏差,至少满足基本的守恒定律(能量守恒、质量守恒),不会出现"绝热面有热流"或"能量凭空产生"这类违反物理常识的错误。对于工程设计中的定性判断和趋势分析,物理一致性的保证比绝对精度的高低有时更为重要。
当然,PINN也并非在所有方面都优于纯数据驱动模型。PINN的训练难度更高------需要调整的超参数更多(损失权重、采样策略、网络深度等),训练收敛的不确定性更大。纯数据驱动模型的训练则相对直接,调参经验也更成熟。对于已经积累了大量仿真数据的场景,纯数据驱动模型可能是更经济的选择。
5.3 与其他AI加速仿真方法的横向对比
PINN只是AI加速仿真的众多路径之一。了解其他路径的特点,有助于在工程实践中选择最合适的方法。
神经算子(Neural Operator),如DeepONet、FNO(Fourier Neural Operator),是另一类重要的AI仿真方法。与PINN学习单个解不同,神经算子学习的是PDE的解算子------即从参数空间到解空间的映射。训练完成后,神经算子可以直接对新的参数组合(新的边界条件、新的源项、新的系数)给出预测,无需重新训练。这与参数化PINN有相似之处,但神经算子的理论基础和训练方式与PINN不同。一般来说,神经算子更适合"从一种参数到另一种参数"的快速泛化,而PINN更适合"在已知参数下高精度求解"。
物理约束的降阶模型(Physics-informed ROM),即将POD(本征正交分解)等降阶技术与物理约束相结合。这类方法通过将高维解投影到低维子空间来实现加速,物理约束则保证降阶模型在低维空间中的演化仍然满足基本物理规律。与PINN相比,ROM的物理基础更扎实、可解释性更强,但适用的问题类型也更受限制。
混合方法是一个越来越受关注的方向。例如,在大部分区域使用PINN快速求解,在关键的局部区域(如材料界面、强梯度区)嵌入传统数值方法的精细计算;或者用传统方法生成高质量训练数据,用PINN做参数空间插值。这类"各取所长"的混合策略,可能比纯PINN或纯传统方法更接近工程实用。
六、工程落地成熟度评估
6.1 技术就绪水平(TRL)评估
技术就绪水平(Technology Readiness Level, TRL)是评估技术成熟度的常用框架,从TRL 1(基本原理发现)到TRL 9(实际系统飞行验证)共9级。结合当前的研究进展和产业应用现状,可以对PINN在电池热管理领域不同应用场景的TRL做一个初步评估。
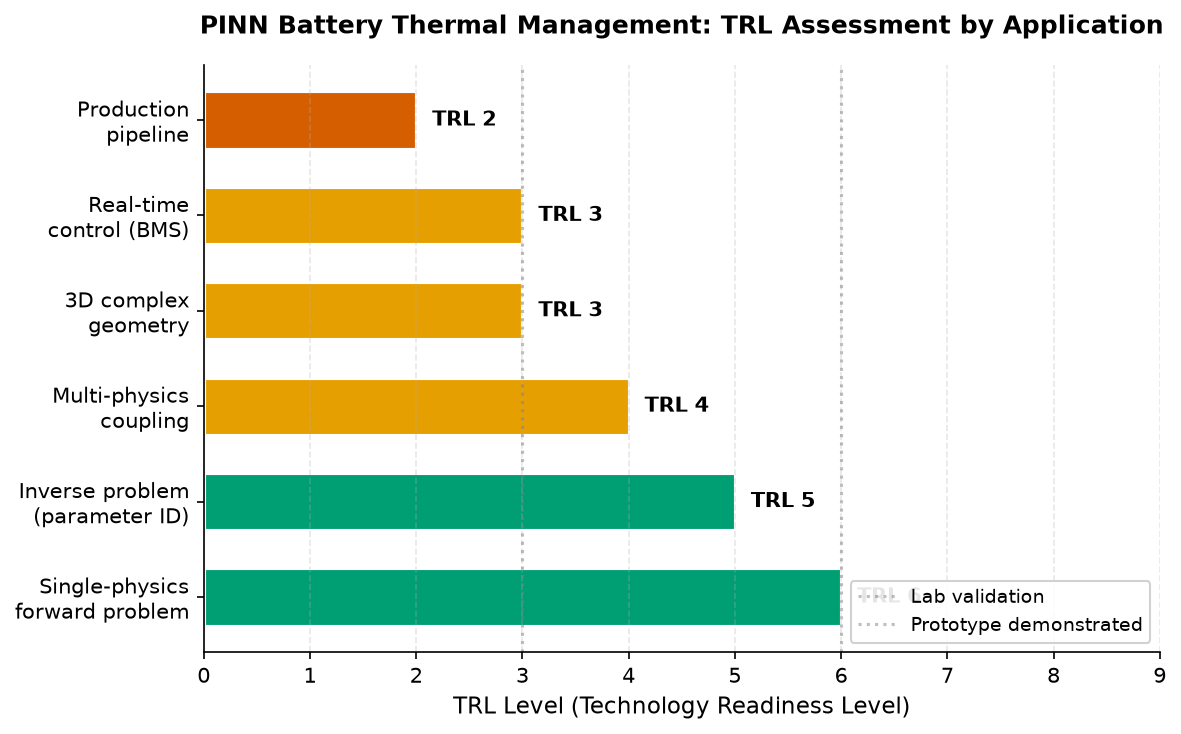
图4:PINN在电池热管理领域不同应用场景的TRL评估。单物理场前向问题已达到较高成熟度,而3D复杂几何、多物理场耦合和生产管线集成仍处于早期阶段。
单物理场前向问题(TRL 6)。 对于几何相对简单、单物理场(纯热传导)的正问题,PINN已经有较多的研究验证,精度和速度优势均有文献支持。在学术界和部分企业的R&D部门,PINN已被用于一些原理验证和概念设计阶段的计算。但距离完全替代传统工具还有差距,主要体现在结果的可靠性和稳定性尚未经过大规模工程验证。
反问题/参数识别(TRL 5)。 PINN在反问题(如根据有限温度测点反求材料导热系数、内热源强度)上有天然的框架优势------待反求的参数可以直接作为可训练变量加入损失函数。已有多项研究展示了PINN在电池参数识别方面的潜力,但大多基于实验室理想条件下的标准数据集。产业端数据的噪声、缺失和多场景特性,给反问题的鲁棒性带来了挑战 。
多物理场耦合(TRL 4)。 电热耦合、电化学-热耦合等多物理场场景下,PINN的研究正在快速推进,已有RA-PINN等改进架构在耦合问题上展示出优于传统PINN的性能 。但耦合问题的训练难度显著上升,不同物理场的损失平衡、强非线性的处理、界面条件的精确满足等问题尚未有通用的解决方案。大多数研究仍停留在简化的二维或准三维模型上。
三维复杂几何(TRL 3)。 三维复杂几何(如完整电池包、带冷却流道的冷板)的PINN求解是当前研究的热点和难点。虽然已有电池包级别的PINN建模尝试,但通常依赖于傅里叶特征网络等特殊架构,且精度和稳定性还有待提升。复杂几何的边界采样、界面条件处理、多尺度问题(电芯毫米级与电池包米级共存)都是需要突破的技术瓶颈。
BMS实时控制(TRL 3)。 PINN用于BMS中的实时温度估计和热失控预警,是一个非常有吸引力的应用方向------PINN的推理速度完全满足实时性要求,物理约束也比纯数据驱动模型更让工程师放心。但边缘算力的限制是主要障碍:BMS的MCU算力远低于训练用的GPU,复杂PINN模型的实时推理需要进行模型压缩和轻量化。此外,功能安全标准(如ISO 26262)对AI模型的可解释性和可靠性有严格要求,PINN目前还不满足这些标准的认证要求 。
生产管线集成(TRL 2)。 从学术论文中的"演示代码"到工业仿真工作流中的"生产工具",中间有巨大的工程鸿沟。学术代码通常针对特定问题编写,假设固定的输入格式,缺乏错误处理和鲁棒性设计。要将PINN集成到企业现有的CAD/CAE工作流中,需要处理网格格式兼容、单位系统统一、结果格式标准化、多平台部署等一系列工程问题。已有工程团队的实践表明,这一步的工作量和难度往往远超算法开发本身 。
6.2 落地的关键卡点
综合现有研究和工程实践经验,PINN在电池热管理领域规模化落地面临几个核心卡点。
第一,训练收敛的稳定性与可预测性不足。 这是当前PINN应用中最普遍的问题。同样的网络结构和超参数,换一个物理参数或换一个随机种子,训练结果可能差异很大。对于工程应用而言,"有时能收敛有时不能"是不可接受的------工程师需要的是可靠的、可重复的工具,而不是需要"调参玄学"的实验性方法。导致收敛不稳定的原因包括:损失函数的高度非凸性、不同损失项之间的梯度竞争、频谱偏差(低频成分容易学习而高频成分难以学习)等。自适应采样、课程学习、注意力机制等方法在特定问题上有改善效果,但尚未形成通用的解决方案。
第二,边界和界面精度不足。 如前所述,PINN在域内的精度通常优于边界处的精度,而工程设计最关心的往往是边界热流、壁面最高温度等边界物理量。对于电池包这类包含多种材料界面的复杂结构,界面处的温度连续和热流连续条件的满足程度直接影响整体精度。如何系统性地提升边界和界面精度,是PINN从"能用"到"好用"必须跨越的门槛。
第三,大规模问题的计算效率瓶颈。 虽然PINN的推理速度很快,但训练阶段的计算量并不小,特别是对于三维大规模问题。每轮训练需要计算大量采样点上的PDE残差,而每个残差的计算又涉及多阶自动微分,计算和显存开销都很大。对于工程级别的三维模型,PINN训练时间可能达到数小时甚至数天,与传统CFD相比并没有显著的时间优势------如果PINN需要针对每个新问题重新训练的话。PINN真正的效率优势体现在"训练一次,推理千次"的参数化场景。如果每次遇到新问题都要重新训练,那么PINN的价值就大打折扣了。因此,如何提升模型的泛化能力(即一个模型能覆盖多少种工况、多少种几何),是决定其工程价值的关键。
第四,验证标准与认证体系的缺失。 在工程领域,一种新的仿真方法要被广泛接受,需要有明确的验证(Verification)和确认(Validation)标准。传统CFD方法经过数十年的发展,已经建立了相对完善的验证体系------有大量的标准算例、基准实验、误差评估方法。PINN目前还缺乏这样的体系:不同研究使用不同的评估指标、不同的基准问题、不同的训练设置,结果之间难以横向对比。没有统一的验证标准,企业就难以评估PINN的结果是否可靠,监管机构就难以基于PINN的结果做审批决策。
第五,人才与工具链的差距。 掌握PINN需要同时具备物理建模能力和深度学习实践能力,这种跨学科的复合型人才目前还比较稀缺。大多数热工程师熟悉CFD工具但不了解深度学习,大多数AI工程师懂神经网络但不懂热物理------而PINN的有效应用需要两者兼修。此外,目前还没有成熟的商业软件将PINN集成到易用的GUI中,使用者往往需要自己写代码、自己调参、自己解决各种工程问题。工具链的不成熟进一步提高了应用门槛。
6.3 适用边界与建议
基于以上分析,可以给出PINN在电池热管理领域的适用边界和应用建议。
推荐优先尝试的场景:(1)设计优化阶段的参数扫描------当需要对几十个到上百个参数组合进行温度场评估时,先用少量CFD样本训练PINN代理模型,再用PINN快速扫描整个参数空间,筛选出几个有潜力的方案,最后返回CFD做高精度验证。这种"PINN粗筛+CFD精算"的组合可以在保证精度的前提下显著缩短优化周期。(2)实时温度估计与预警------对于有实时性要求的场景(如BMS、数字孪生),PINN的推理速度优势可以充分发挥。(3)反问题与参数识别------当实验数据有限、需要从少量观测反推内部状态或参数时,PINN的物理约束框架有独特优势。
暂不推荐的场景:(1)需要最高精度的最终验证仿真------PINN目前的精度和可靠性还不足以替代高保真CFD作为最终设计的验证工具。(2)涉及强间断、强激波的问题------这类问题对PINN来说特别困难,传统数值方法有更成熟的处理方案。(3)只有单个工况需要计算的场景------如果只算一次,PINN训练的时间成本可能高于直接用CFD计算。
从技术路线角度,建议企业采用"渐进式引入"策略:先在设计前期、概念验证阶段引入PINN作为辅助工具,积累经验和数据后逐步向详细设计阶段推进;先从单物理场、简单几何的问题入手,建立信心和方法论后再向多物理场、复杂几何拓展;先与现有CFD工具形成互补,而非试图一步到位地替代它们。
FAQ
Q1:PINN训练需要数据吗?没有实验数据能用PINN吗?
PINN有两种典型的使用模式。第一种是"纯物理驱动"模式------完全不依赖数据,仅靠PDE约束和边界/初始条件来训练网络,本质上是在用神经网络作为PDE的求解器。这种模式下不需要任何实验或仿真数据,但训练难度相对较高,对网络结构和超参数更敏感。第二种是"数据+物理混合驱动"模式------同时使用PDE约束和少量观测数据来训练,数据可以来自实验或高保真仿真。这种模式下数据帮助确定具体解,物理约束保证泛化性,通常更容易训练且精度更高。电池热管理中大多数有工程价值的场景属于第二种模式------已有一定的仿真或实验数据,但数据不足以覆盖整个参数空间。
Q2:PINN的精度能达到工业应用的要求吗?
这个问题需要分场景来看。对于温度估计类应用(如BMS中的温度预测),PINN的精度已经有较多验证:在方形电池温度预测中RMSE可低至0.48 ℃(动态工况),低温下LFP电池MAE可达0.07 ℃ ,这样的精度水平对于温度估计和热预警来说是足够的。对于需要精确温度场分布的设计类应用(如冷却结构优化),PINN在简单几何和单物理场下的精度可以与传统数值方法相比拟,但在复杂几何和多物理场下仍有差距。总体而言,PINN目前更适合作为"快速评估工具"而非"最终验证工具"。
Q3:PINN为什么有时候损失下降但结果不对?
这是PINN应用中一个常见且令人困扰的现象,被称为"物理正确性的隐形丢失"。原因主要有几个方面:一是"软约束"的本质------PINN是最小化PDE残差的平均,而残差的分布可能不均匀,全域平均小不代表局部误差也小;二是"频谱偏差"------神经网络倾向于先学习低频成分,高频成分收敛慢,如果提前停止训练,高频部分的误差可能很大;三是损失权重不平衡------如果某类损失被过度惩罚,其他约束可能被忽略;四是局部最优------优化可能陷入了一个"总损失看起来低但物理解不对"的局部极小值。应对策略包括:检查残差的空间分布(而不仅是平均值)、增加验证点(特别是边界和大梯度区域)、使用自适应权重、尝试不同的初始化和优化器。
Q4:PINN能处理电池包这种包含多种材料的复杂结构吗?
可以,但有条件。目前的研究中,PINN处理多材料问题主要有两种思路。一种是"全域单网络"------用一个网络表示整个求解域的温度场,在界面处额外施加温度连续和热流连续的约束(作为损失项)。这种方法实现简单,但界面处的精度往往是瓶颈,因为界面点在整个求解域的采样点中占比很小,约束容易被"稀释"。另一种是"分域多网络"------不同材料域用不同的网络表示,界面条件作为不同网络之间的连接约束。研究表明,使用傅里叶神经网络架构可以有效处理材料性质相差达两个数量级的热扩散问题 。但对于包含数十上百个电芯、多种结构件和冷却系统的完整电池包,目前的PINN技术还难以做到端到端的高精度求解,通常需要与传统方法结合使用。
Q5:PINN的训练一定比CFD快吗?
不一定,需要区分"训练"和"推理"两个阶段。PINN的训练阶段涉及大量的PDE残差计算(每步都需要自动微分求高阶导数),对于三维大规模问题,训练时间可能达到数小时甚至数天,这并不一定比同等规模的CFD仿真更快。PINN的速度优势体现在推理阶段:一旦模型训练完成,新工况下的温度预测只需要一次前向传播,耗时通常在毫秒级以下。因此,PINN的效率优势只有在需要多次推理的场景下才能体现------比如参数优化(上千次评估)、实时预测(每秒都要算)、不确定性分析(蒙特卡洛抽样)。如果只需要计算单个工况,直接用CFD可能更直接。
Q6:PINN在电池热管理中有落地产品吗?
目前在学术研究和R&D层面已有较多应用案例,但大规模工业化落地的案例还比较有限。已有的落地尝试主要集中在几个方向:一是作为设计优化的代理模型,嵌入企业内部的仿真工作流中,用于加速参数迭代;二是用于BMS中的温度估计和热失控预警算法开发,主要在预研和原型验证阶段;三是数字孪生中的实时温度场重构,同样多处于试点阶段。总体而言,PINN在电池热管理领域的应用还处于"技术验证向工程试点过渡"的阶段,距离大规模商业化应用还有2~5年的路要走。
Q7:想入门PINN需要什么基础?推荐的学习路径是什么?
入门PINN最好具备三方面的基础:一是Python编程和深度学习基础(PyTorch或TensorFlow),理解反向传播和自动微分的原理;二是偏微分方程和数值方法基础,理解PDE的分类、边界条件的类型、有限差分/有限元的基本思想;三是具体应用领域的物理知识(如热传导、流体力学)。如果三者都有基础,那么入门PINN很快------核心概念一天就能理解,一周左右可以自己实现简单的问题。如果只有某一方面的基础,补另外两方面需要2~4周。推荐的学习路径是:先读Raissi的经典论文建立概念 ,然后复现1D热传导或Burgers方程的PINN代码,再逐步向自己关心的具体问题迁移。过程中可以大量借助AI工具加速理解和编码,但一定要自己动手验证物理正确性。
参考文献
1 Raissi M, Perdikaris P, Karniadakis G E. Physics-informed neural networks: A deep learning framework for solving forward and inverse problems involving nonlinear partial differential equationsJ. Journal of Computational Physics, 2019, 378: 686-707.
2 Eric L. Pereira, Davi M. Soares; Low-Temperature Prediction in Commercial Lithium-Ion Batteries during Dynamic Usage via Enhanced Physics-Informed Neural Networks. ACS Omega 26 May 2026; 11 (20): 29461--29476.
3 基于物理信息神经网络的锂离子电池温度预测研究J. 工程科学学报, 2026. https://cje.ustb.edu.cn/cn/article/id/7db3c224-aac6-458c-92a3-c128a4bbe9b3
4 Physics-Informed Neural Networks for Advanced Thermal Management in Electronics and Battery Systems: A Review of Recent Developments and Future ProspectsJ/OL. Semantic Scholar, 2025. https://pdfs.semanticscholar.org/e8f8/40b31cef1a4ce4ab2400df26fd2985dfa958.pdf
5 Liu Y, et al. Residual Attention Physics-Informed Neural Networks for Robust Multiphysics Simulation of Steady-State Electrothermal Energy SystemsJ/OL. arXiv:2603.23578, 2026. https://arxiv.org/html/2603.23578v1
6 Multi-Parameter modelling of heat transfer in a battery pack using PINNsR. CASML Oorja Poster, 2024. https://casml.cc/wp-content/uploads/2024/12/Oorja_Poster_Multi.pdf
7 电池组热管理模拟:核心方法拆解与常见问题深度分析EB/OL. 懂车帝, 2025-12-31. https://www-lf.dongchedi.com/article/7589925154151793177
8 物理信息神经网络(PINNs)嵌入电化学机理:AI驱动储能全生命周期状态估计的精度突破与泛化瓶颈EB/OL. 科学网-赵丹博文, 2026-04-30. https://blog.sciencenet.cn/blog-3655709-1532960.html
9 用PINNs将芯片热仿真速度提升50倍:工程落地的三个陷阱EB/OL. 稀土掘金, 2025-12-22. https://juejin.cn/post/7586482851102097443
10 Raissi M. PINNs GitHub RepositoryEB/OL. GitHub: maziarraissi/PINNs. https://github.com/maziarraissi/PINNs
11 sr5434. Physics-Informed Neural Networks (1D/2D/3D heat equation) EB/OL. GitHub: sr5434/pinns. https://github.com/sr5434/pinns
12 tsa2000. 0D Battery Thermal Runaway Digital Twin EB/OL. GitHub: tsa2000/Battery-Digital-Twin. https://github.com/tsa2000/Battery-Digital-Twin
本文内容仅用于技术交流和学习参考,不构成任何工程设计、产品开发或商业决策的依据。文中提及的性能数据(如速度提升倍数、精度指标)均来自特定研究场景,实际效果受问题复杂度、硬件配置、实现质量等多种因素影响,可能与文中数据存在差异。读者在将PINN技术应用于实际工程项目时,应结合具体需求进行充分的验证和测试,并遵守相关行业标准和安全规范。本文作者不对因使用本文内容而导致的任何直接或间接损失承担责任。