ELK日志分析:Elasticsearch索引、Logstash接入与Kibana可视化
前言
ELK 的价值不在于单独安装三个组件,而在于把日志采集、索引存储和可视化分析串成一条完整链路。Elasticsearch 负责保存和检索数据,Logstash 负责接入与处理日志,Kibana 则提供查询、索引管理和图表展示。
本文按照现有实操顺序展开:先准备 CentOS 环境、关闭 Swap、创建 Elasticsearch 用户,再导入 Elasticsearch GPG 密钥和仓库配置;随后安装 Logstash,设置 Beats 输入和 Elasticsearch 输出,最后部署 Kibana 7.15.0。
Kibana 页面跑起来以后,还会继续创建索引、写入测试文档、执行查询、设置中文界面,并使用 Visualize 创建图表。这样验证的不只是服务能启动,而是数据从 Elasticsearch 到 Kibana 的查询和展示链路确实能够工作。
最后再补充远程访问,让内网里的 Kibana 页面可以从其他设备继续查看。整篇重点放在"环境---数据接入---索引---查询---可视化"这几个环节,而不是把 Kibana 简单当成一个监控大屏。
对于第一次搭 ELK 的人来说,把三个组件的职责拆开理解,再一层层验证,会比看到某个页面打不开就整套重装更清楚。
对于第一次搭建 ELK 的人来说,最容易混在一起的就是"服务启动"和"数据链路正常"这两件事。Kibana 页面能打开,只能说明 Web 服务可用;索引、写入、查询和可视化继续跑通以后,才算把整条日志分析链真正接起来。
1. 为什么我不想再只靠 grep 查日志
日志最麻烦的地方,不是没有,而是太多。
系统日志、应用日志、Nginx、数据库、业务错误信息,全都散在不同文件里。问题发生以后,靠命令行当然能查,但时间范围、关键词、字段和多台机器一叠加,效率就开始下降。
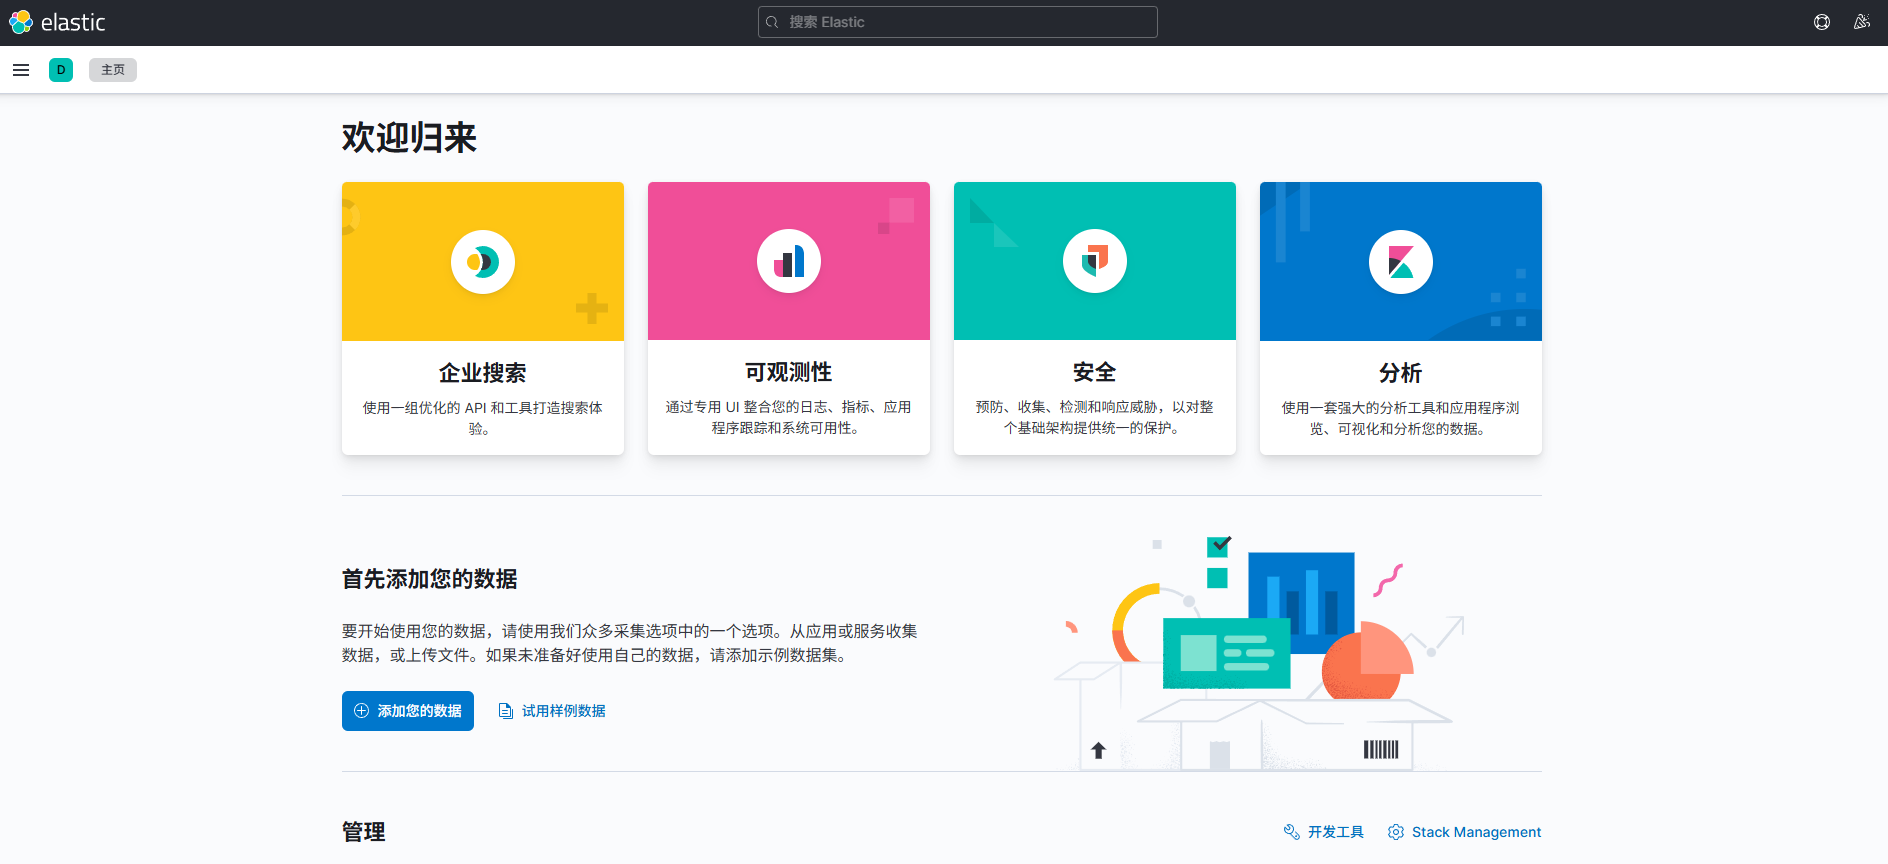
ELK 里三个组件的分工比较清楚:
- Elasticsearch:负责存储和检索数据;
- Logstash:负责接入和处理日志;
- Kibana:负责查询、数据探索和可视化展示。
我更看重 Kibana 的地方,是它能把 Elasticsearch 里的数据从"我知道有这些日志",变成"我能按字段、时间和条件快速筛出来"。
1.1 Kibana 主要能做什么
这里涉及的能力包括:
- Discover 数据探索;
- 索引模式管理;
- Visualize 图表;
- Dashboard 仪表盘;
- 日志和 APM 分析;
- 告警与监控;
- 权限和安全相关功能。
对我来说,先把最基本的"索引能建、数据能查、图表能画"跑通,比一开始就研究复杂告警更重要。
2. 部署前先准备系统环境
2.1 基础要求
这里使用的环境要求包括:
| 项目 | 要求 |
|---|---|
| 操作系统 | CentOS 7.6 或更高 |
| 架构 | x86_64 |
| 权限 | root 或 sudo |
| 网络 | 能访问外网 |
| 内存 | 最低 4 GB,推荐 8 GB 及以上 |
| CPU | 最低 2 核,推荐 4 核以上 |
| 磁盘 | 最低 20 GB,推荐更大 SSD |
这里还要求关闭 Swap。
执行:
shell
# 临时关闭
sudo swapoff -a

# 永久关闭:注释 /etc/fstab 中的 swap 行
sudo sed -i '/swap/s/^/#/' /etc/fstab
Java 方面,当前流程里区分 Elasticsearch 8.x 和 7.x 的环境说明,并建议优先使用 Elastic 官方包附带的兼容 JDK。
2.2 创建 Elasticsearch 用户
执行:
shell
adduser elasticsearch  # 创建名为 'elasticsearch' 的新用户
passwd elasticsearch  # 为 'elasticsearch' 用户设置密码
这一步先把后面 Kibana 和 Elasticsearch 相关文件的用户环境准备出来。
3. 准备 Elasticsearch 仓库
先导入 GPG 密钥:
shell
sudo rpm --import https://artifacts.elastic.co/GPG-KEY-elasticsearch然后创建仓库文件:
shell
sudo vi /etc/yum.repos.d/elasticsearch.repo 写入:
shell
[elasticsearch-7.x]
name=Elasticsearch repository for 7.x packages
baseurl=https://artifacts.elastic.co/packages/7.x/yum
gpgcheck=1
gpgkey=https://artifacts.elastic.co/GPG-KEY-elasticsearch
enabled=1
autorefresh=1
type=rpm-md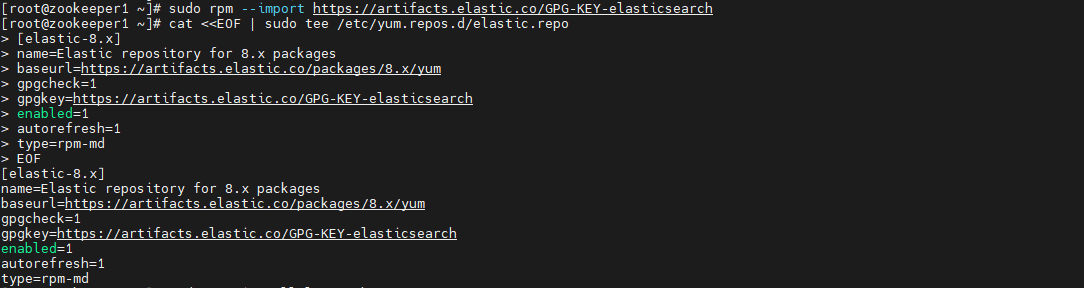
这一段的目的,是先把 Elasticsearch 7.x 的软件源配置准备好。
4. 安装并配置 Logstash
安装 Logstash:
shell
sudo yum install logstash -y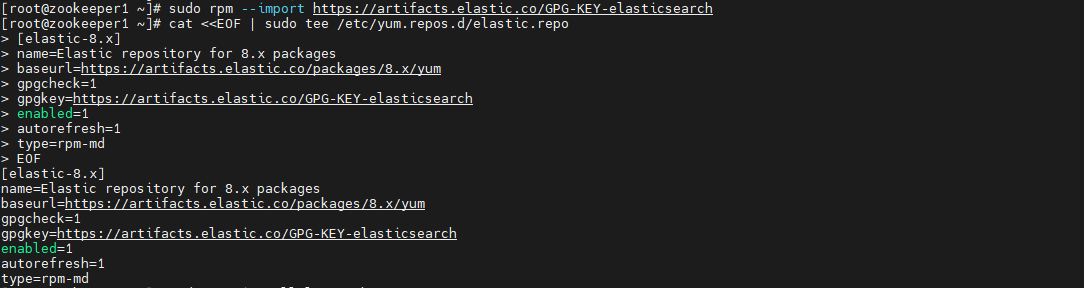
接着创建配置文件:
shell
sudo vi /etc/logstash/conf.d/logstash.conf写入:
shell
input {
beats {
port => 5044
}
}

output {
elasticsearch {
hosts => ["localhost:9200"]
index => "logstash-%{+YYYY.MM.dd}"
}
stdout { codec => rubydebug }
}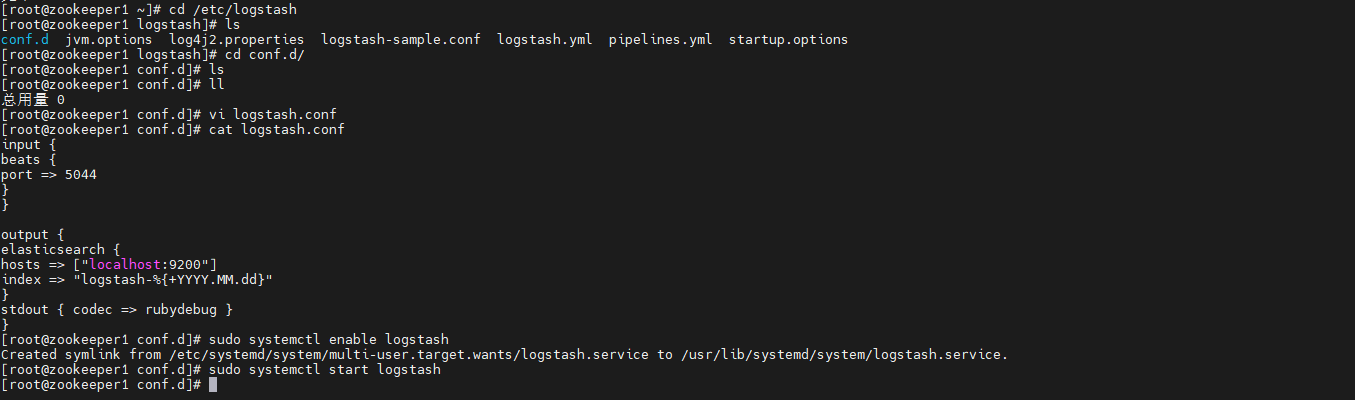
这里的逻辑很直观:
- Beats 输入端口使用
5044; - Elasticsearch 地址使用
localhost:9200; - 索引名称按日期生成;
- 同时输出 rubydebug 方便查看。
配置完成以后启动并设置开机启动:
shell
sudo systemctl enable logstash
sudo systemctl start logstash
到这里,Logstash 这一层已经具备了基础输入和输出配置。
5. 安装 Kibana 7.15.0
5.1 下载并解压
执行:
shell
iptables -nvL  # 显示当前iptables规则
wget https://artifacts.elastic.co/downloads/kibana/kibana-7.15.0-linux-x86_64.tar.gz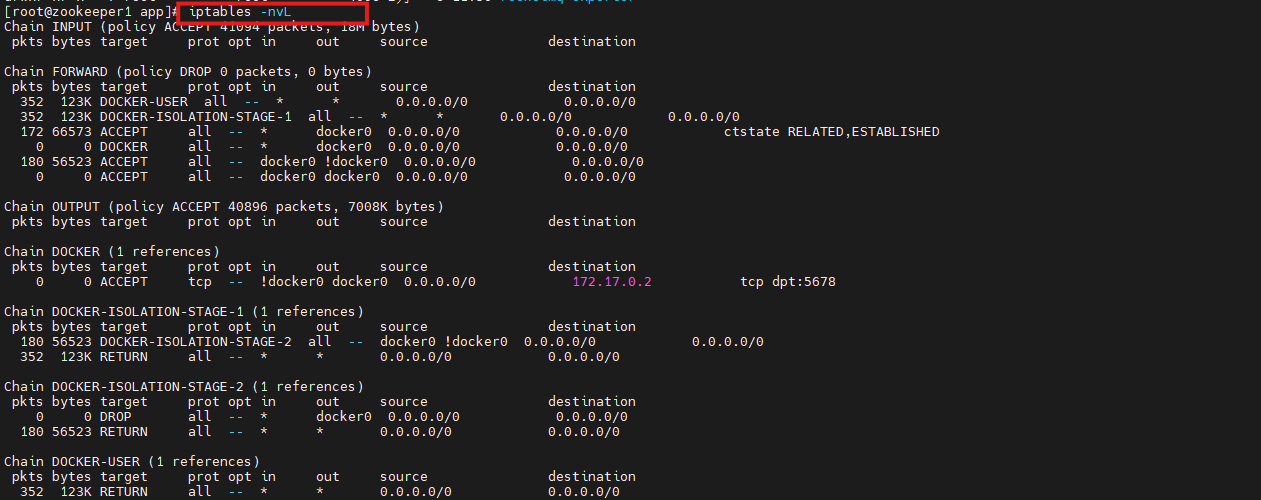
下载完成后解压并修改权限:
shell
tar -zxvf kibana-7.15.0-linux-x86_64.tar.gz  # 解压Kibana存档
chown -R elasticsearch kibana-7.15.0-linux-x86_64  # 将Kibana文件的所有权更改为 'elasticsearch' 用户
然后把目录改名:
shell
mv kibana-7.15.0-linux-x86_64/ kibana
chown -R elasticsearch kibana
接着移动到用户主目录并处理权限:
shell
cp -r elasticsearch /home/elasticsearch/  # 将Elasticsearch文件复制到 'elasticsearch' 用户的主目录
cp -r kibana /home/elasticsearch/  # 将Kibana文件复制到 'elasticsearch' 用户的主目录
cd /home/elasticsearch/  # 移动到 'elasticsearch' 用户的主目录
chown -R elasticsearch kibana/
chown -R elasticsearch elasticsearch/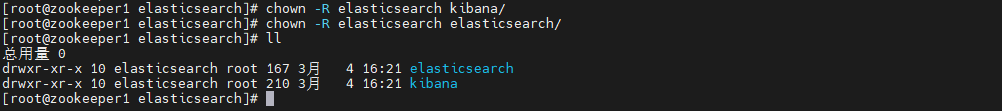
5.2 修改 Kibana 配置
编辑配置文件:
shell
sudo vi /etc/kibana/kibana.yml修改:
shell
server.host: "0.0.0.0"
elasticsearch.hosts: ["http://localhost:9200"]
这里把 Kibana 监听地址设为 0.0.0.0,同时让它连接本机 Elasticsearch 的 9200 端口。
启动 Kibana:
shell
./bin/kibana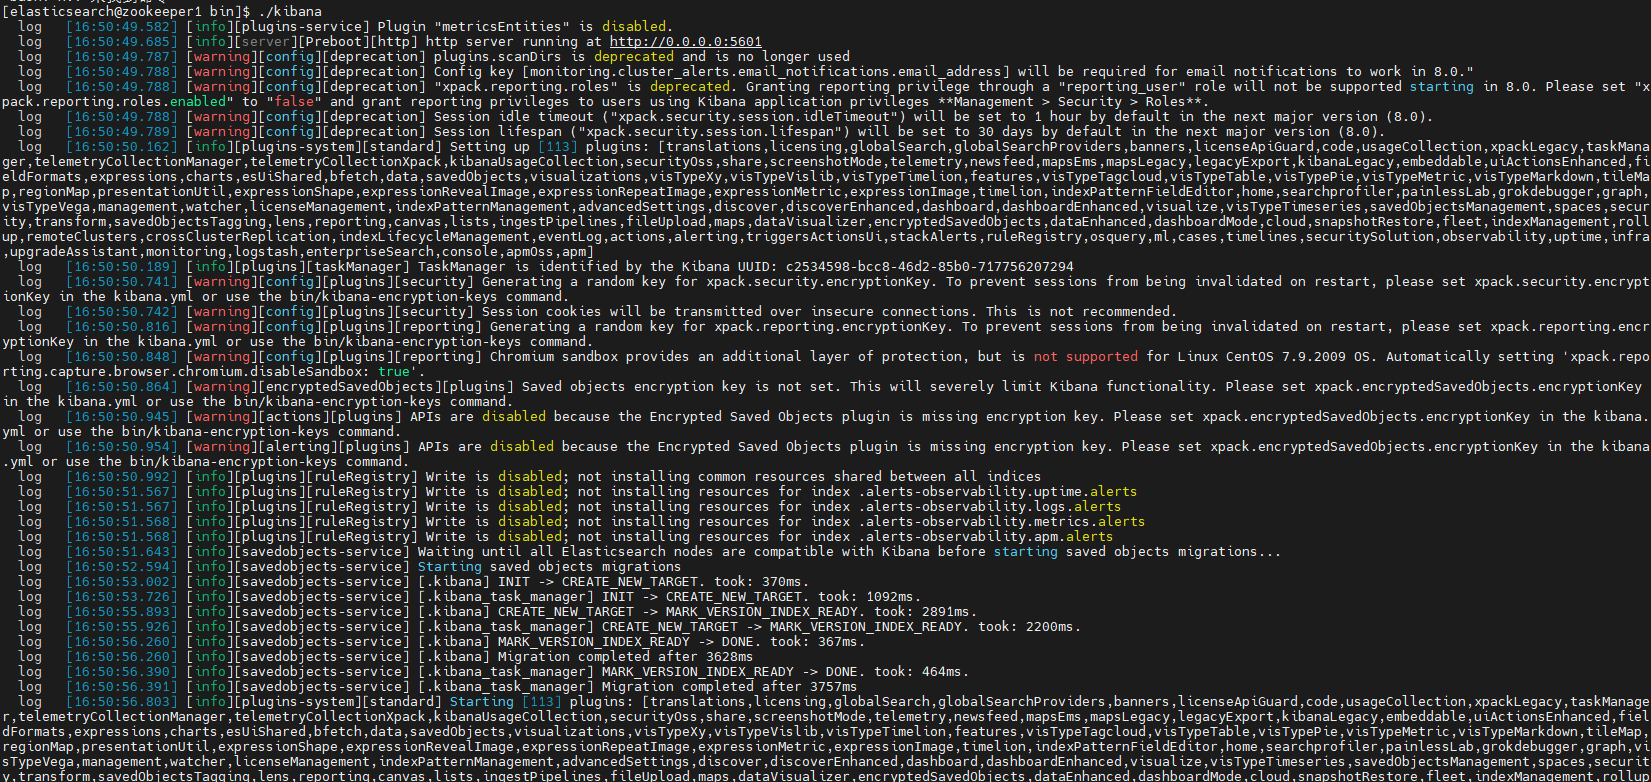
浏览器访问:
http://localhost:5601/
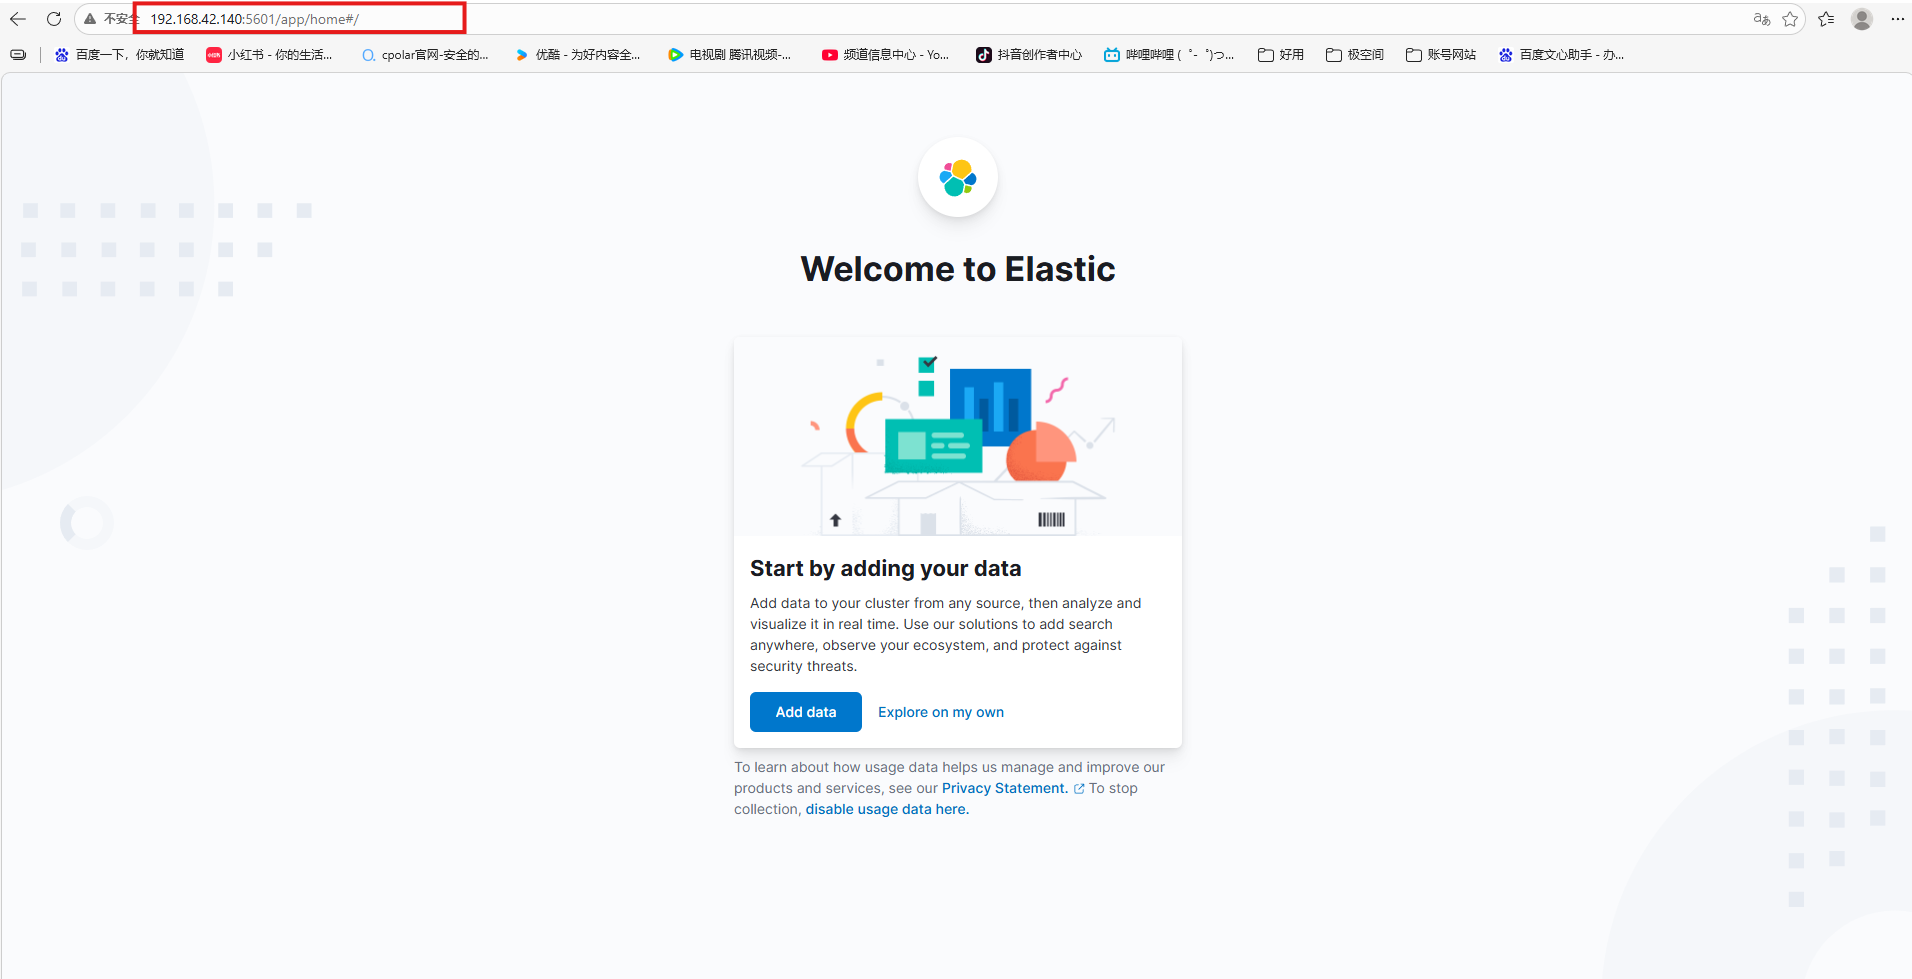
到这里,只能说明 Kibana 页面已经能打开。接下来还要继续创建索引、写数据和查询,才能验证真正的数据链路。
6. 用测试数据验证 Elasticsearch 和 Kibana
6.1 先创建测试文档
这里先向 pro 索引写入一条测试数据:
shell
x curl -X POST "http://localhost:9201/pro/_doc" \-H "Content-Type: application/json" \-d '{ "name": "iPhone 15", "price": 7999, "category": "phone"}'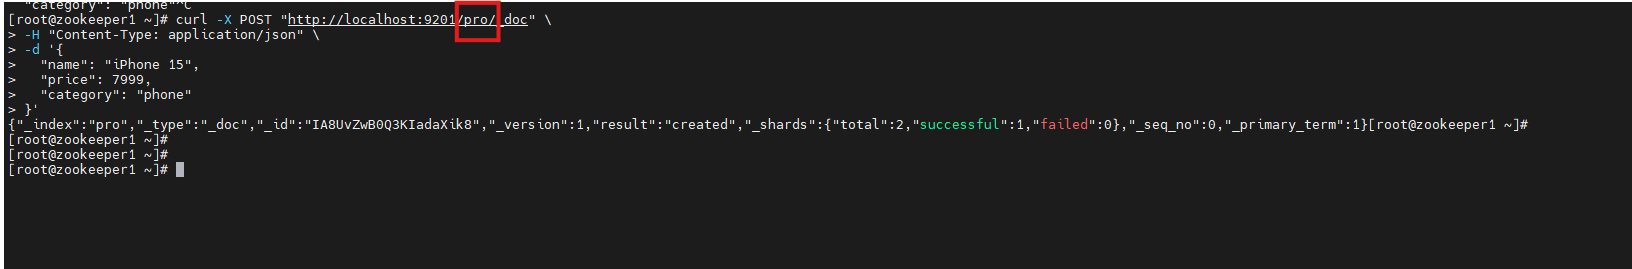
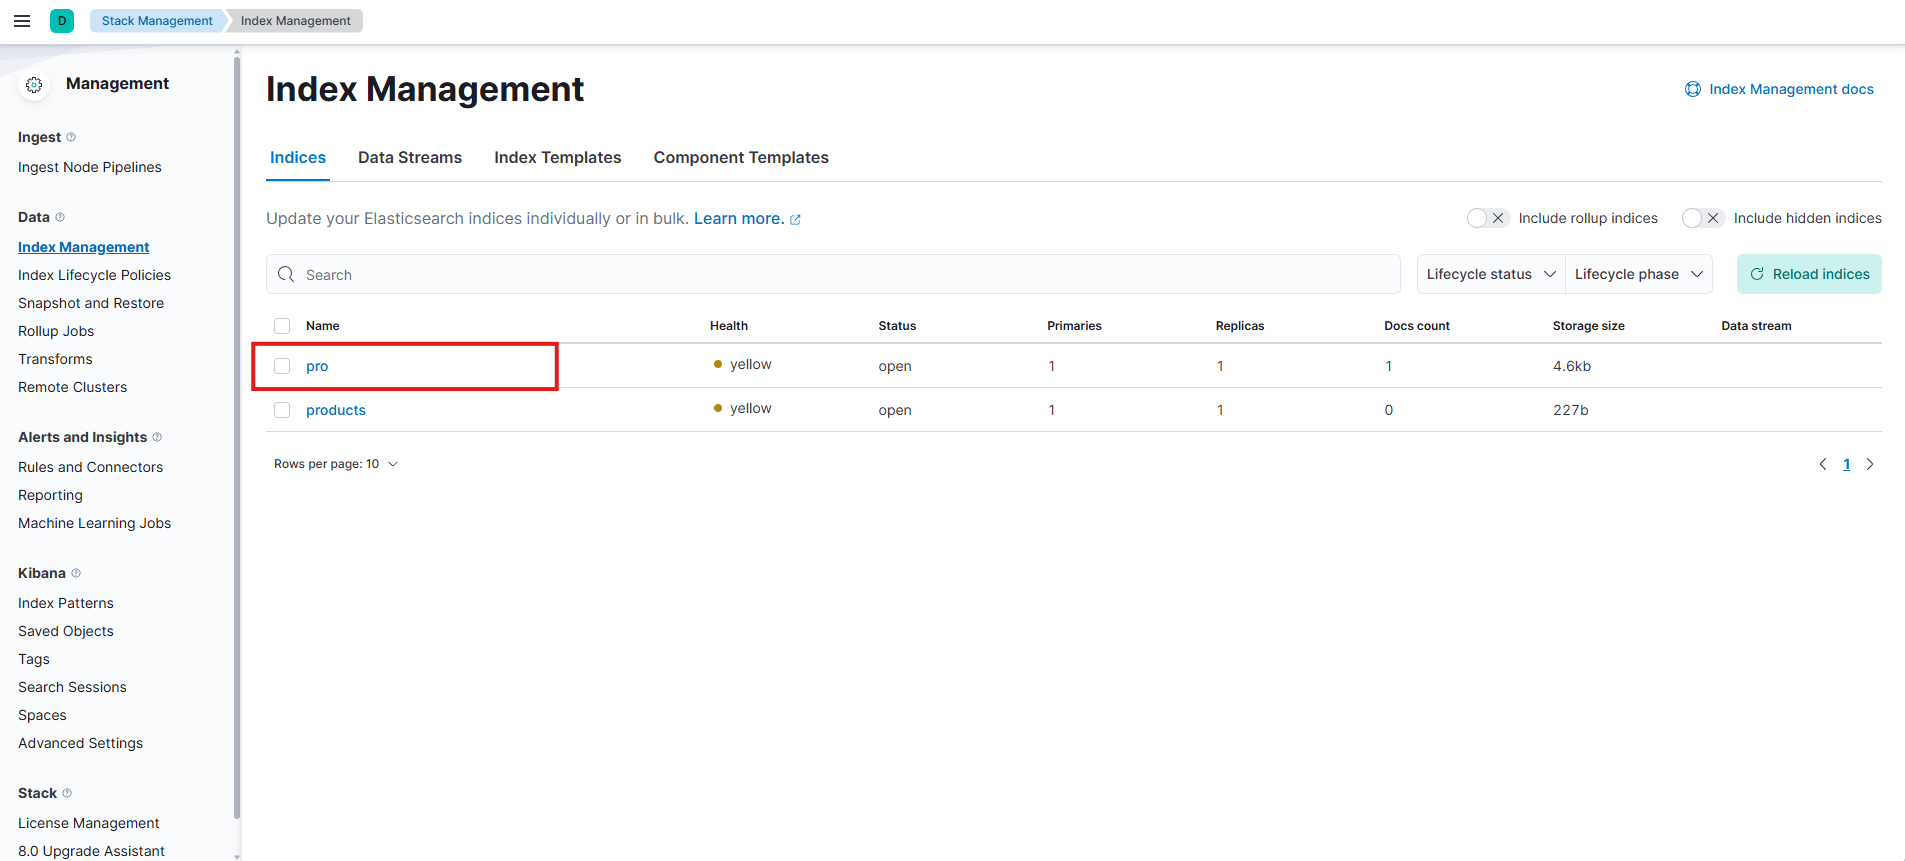
然后回到 Kibana 页面查看:
6.2 创建和管理索引模式
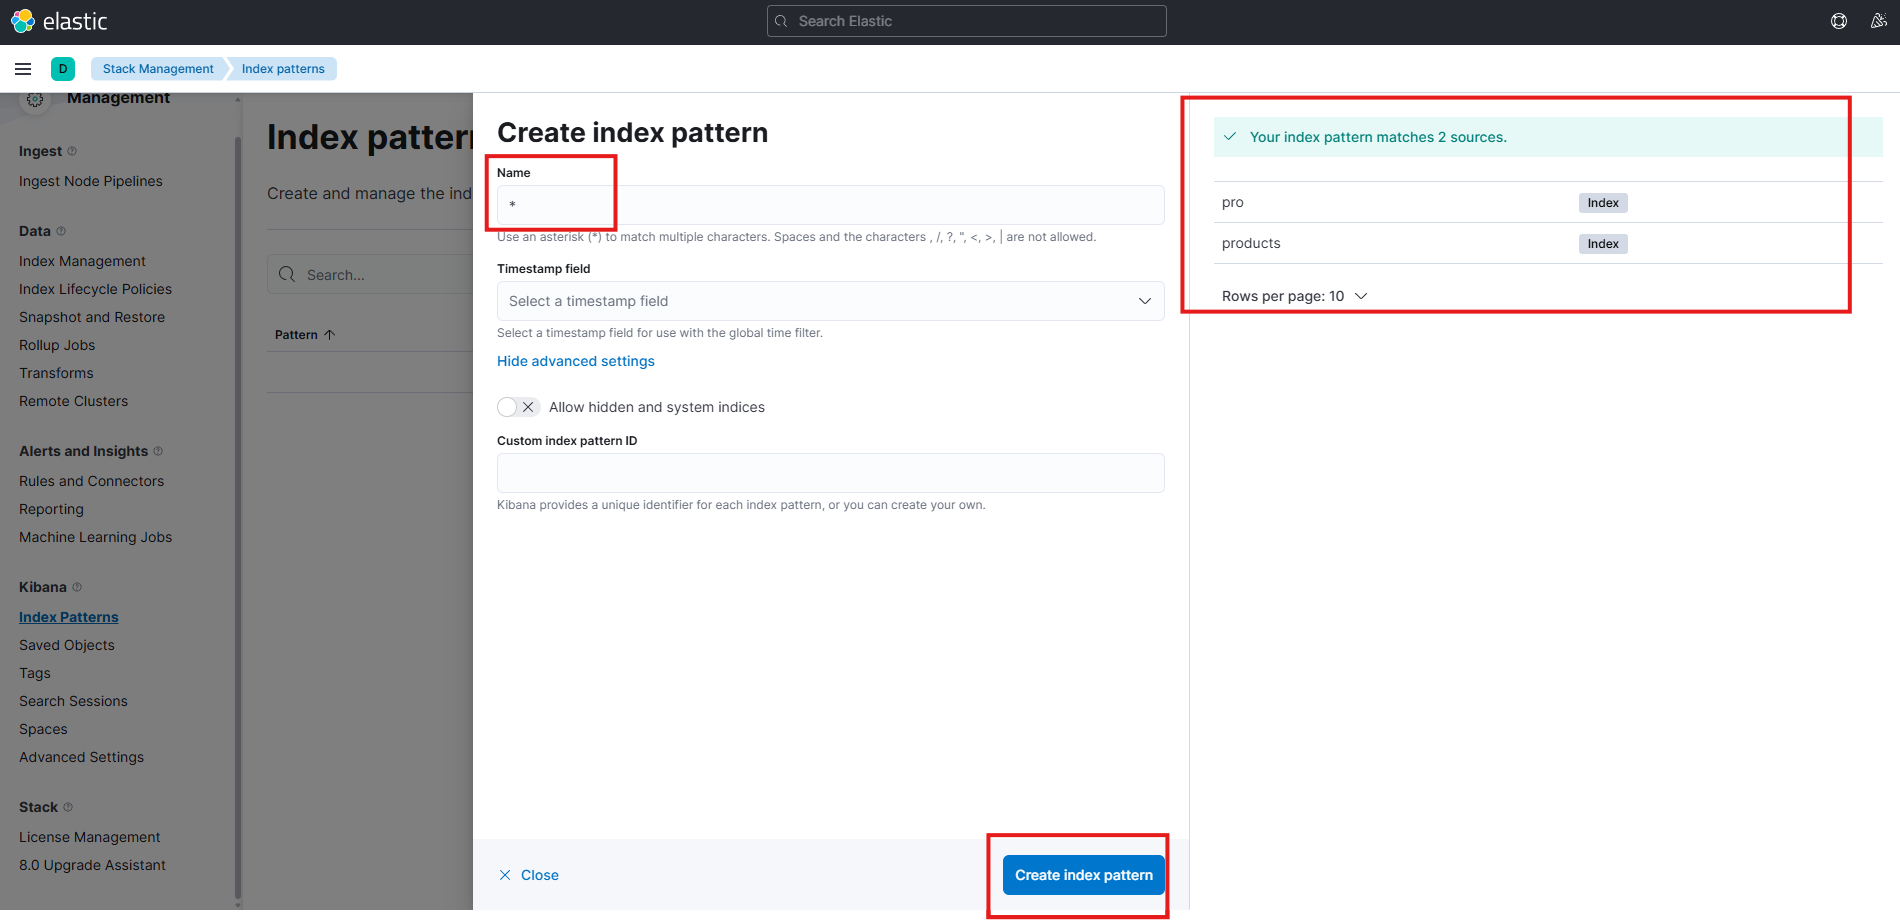
进入索引模式相关页面:
继续查看和编辑字段:
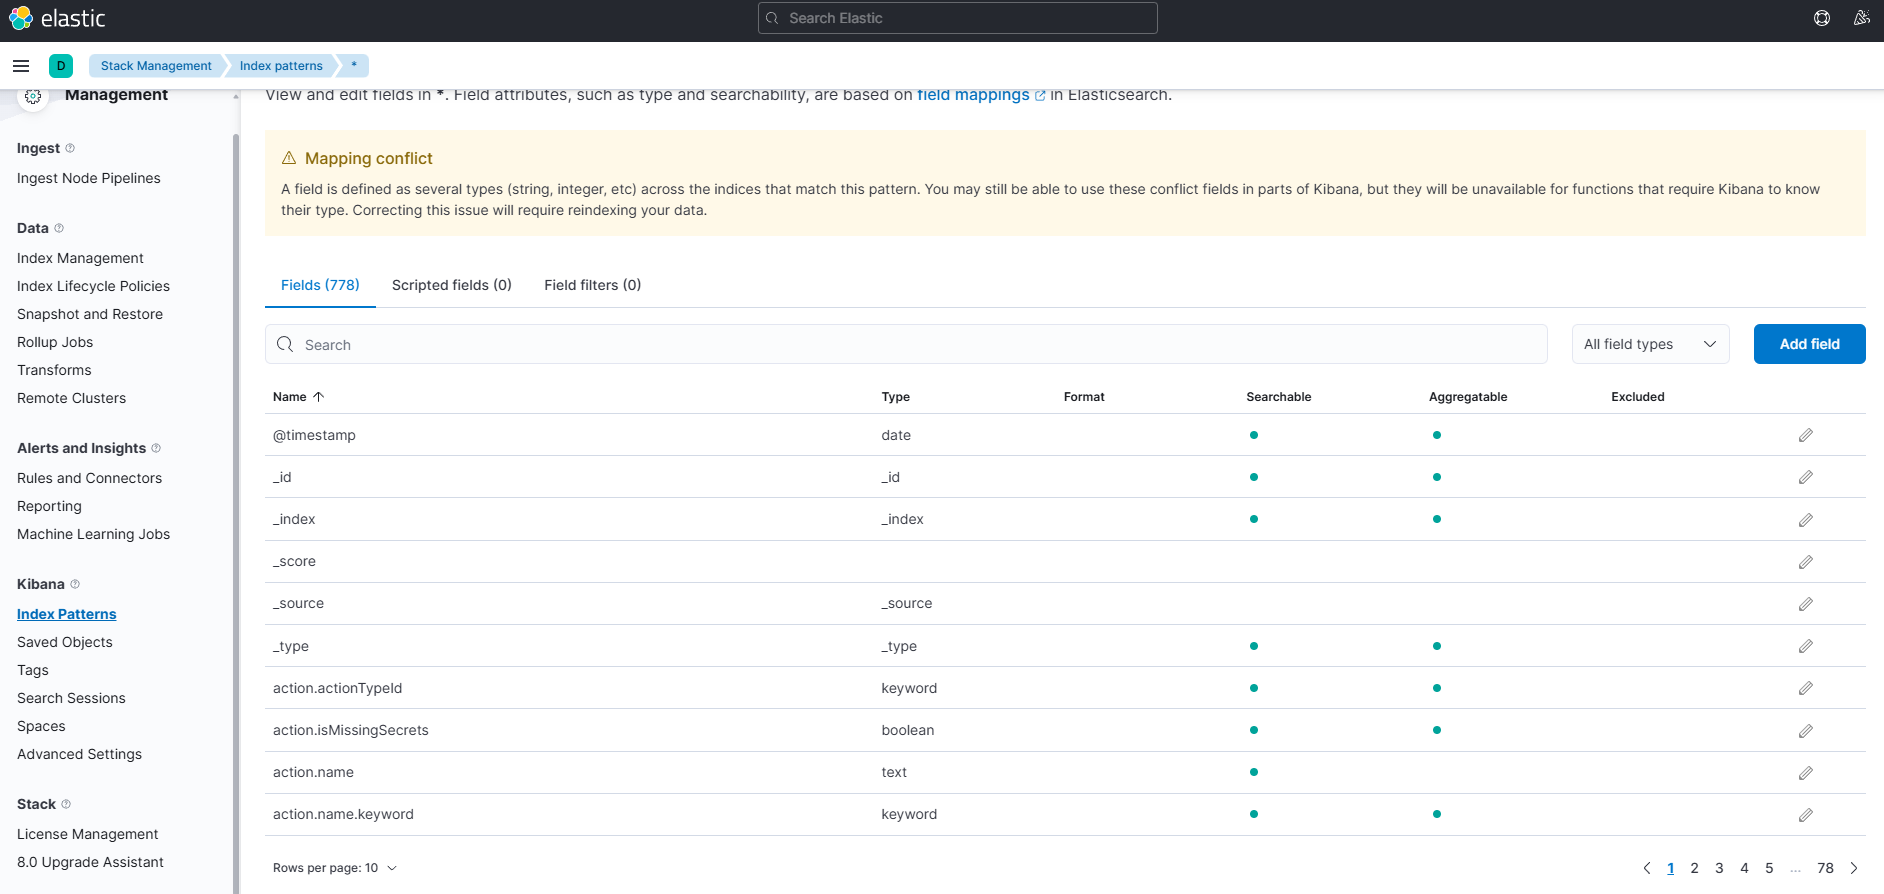
这一步开始以后,Kibana 才真正从"页面已经启动"进入"开始理解 Elasticsearch 里的数据"。
6.3 切换中文界面
在 config/kibana.yml 添加:
shell
i18n.locale: "zh-CN"重启以后生效:
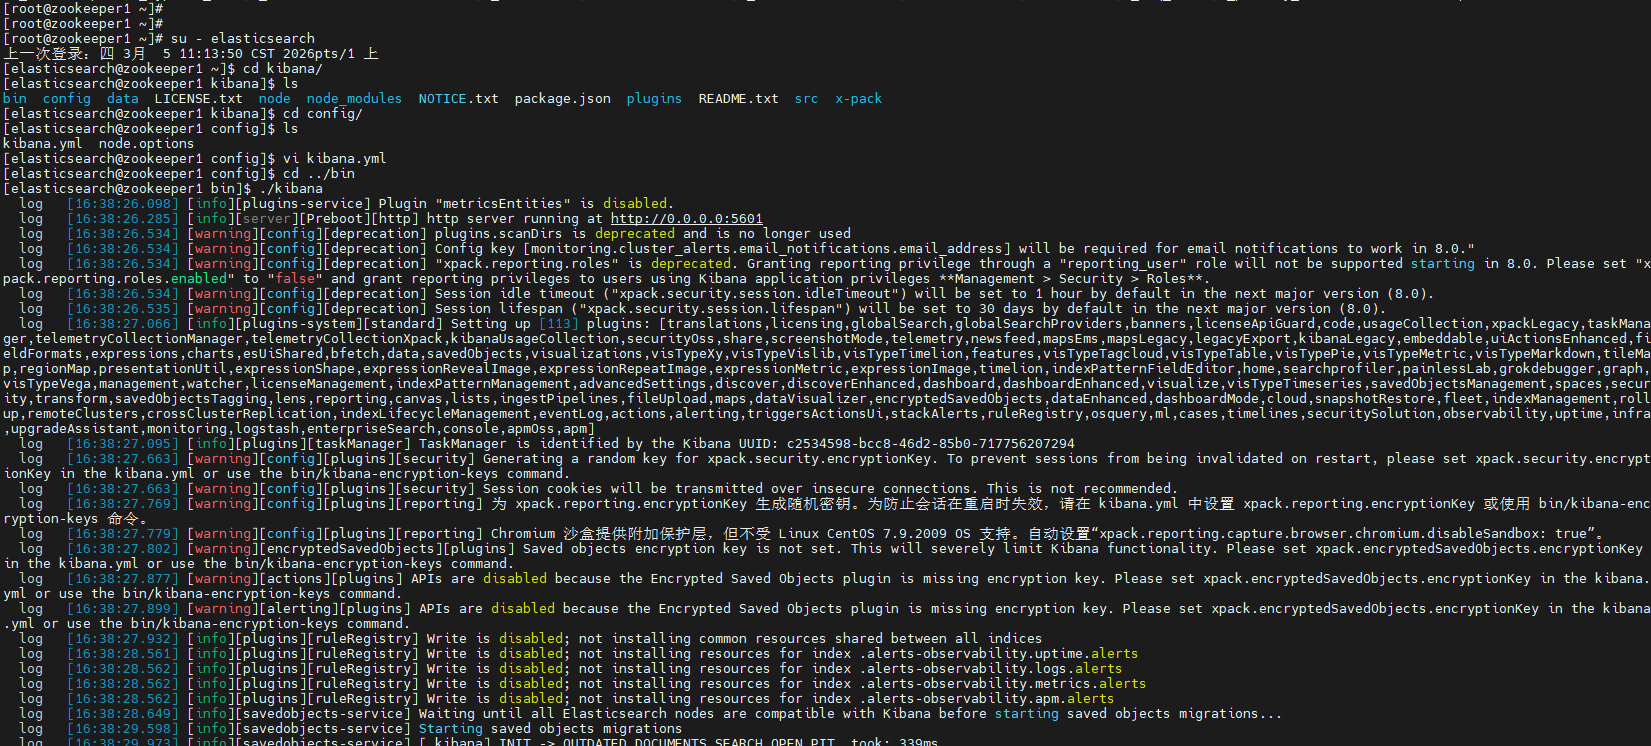
对于长期使用来说,界面语言虽然不是核心能力,但确实会影响日常操作效率。
7. 继续做查询和索引测试
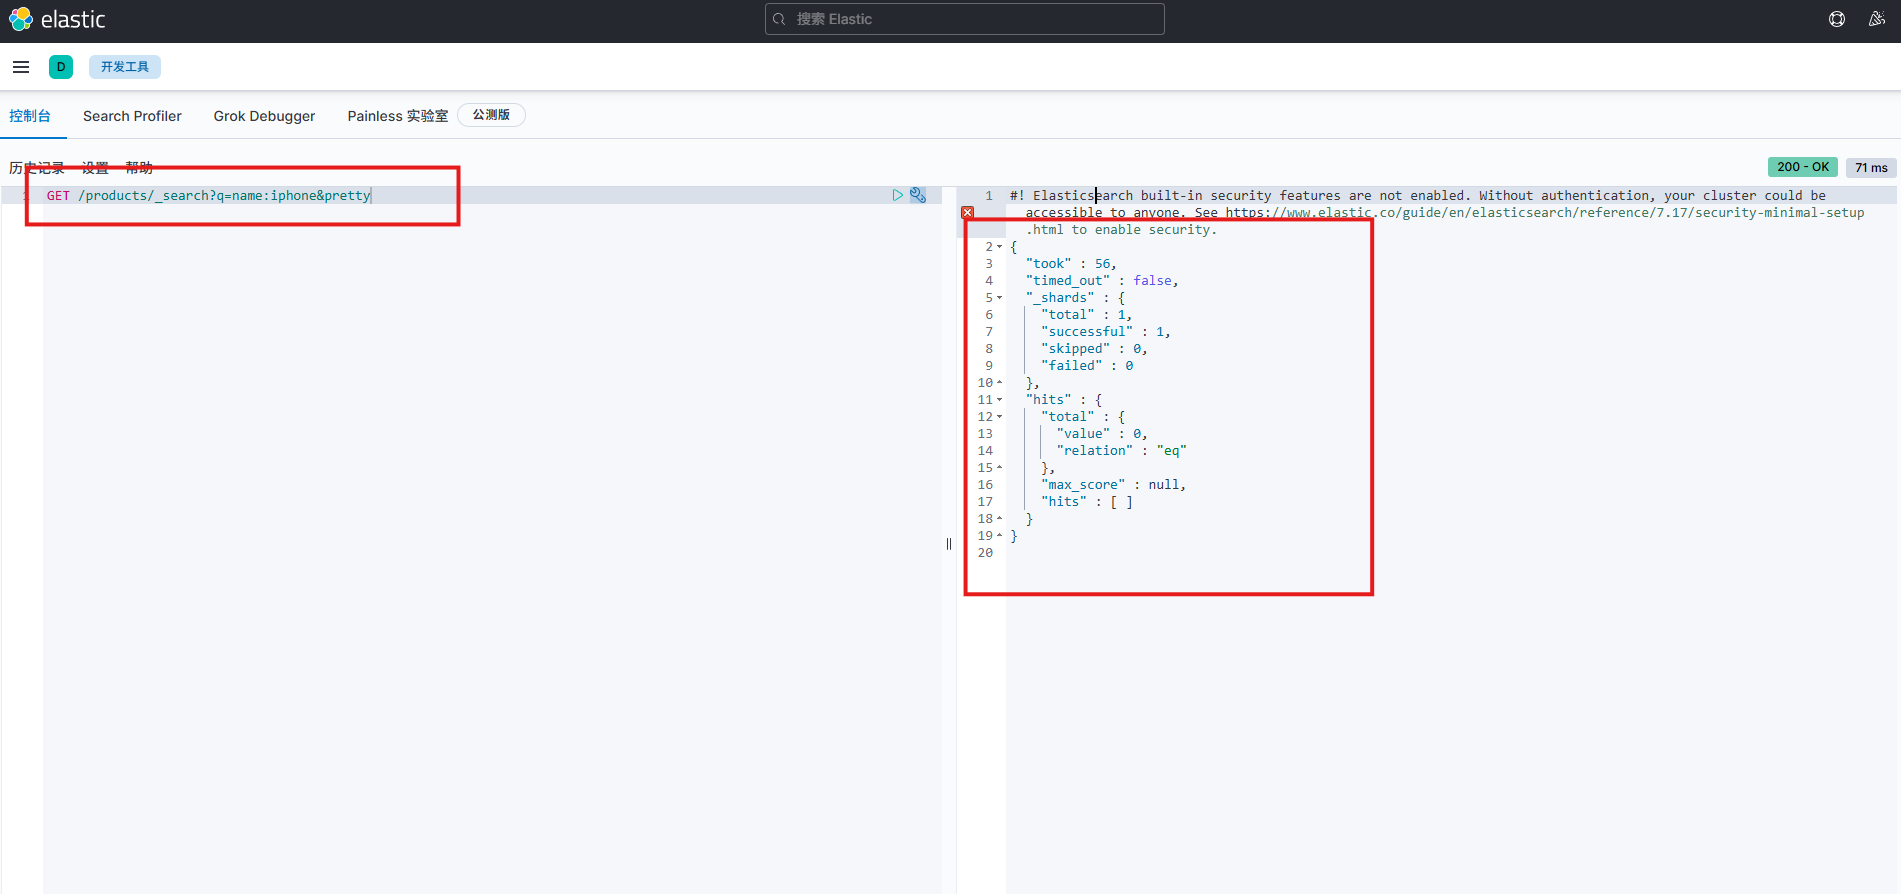
7.1 查询数据
执行:
shell
curl -X GET "http://localhost:9201/products/_search?q=name:iphone&pretty"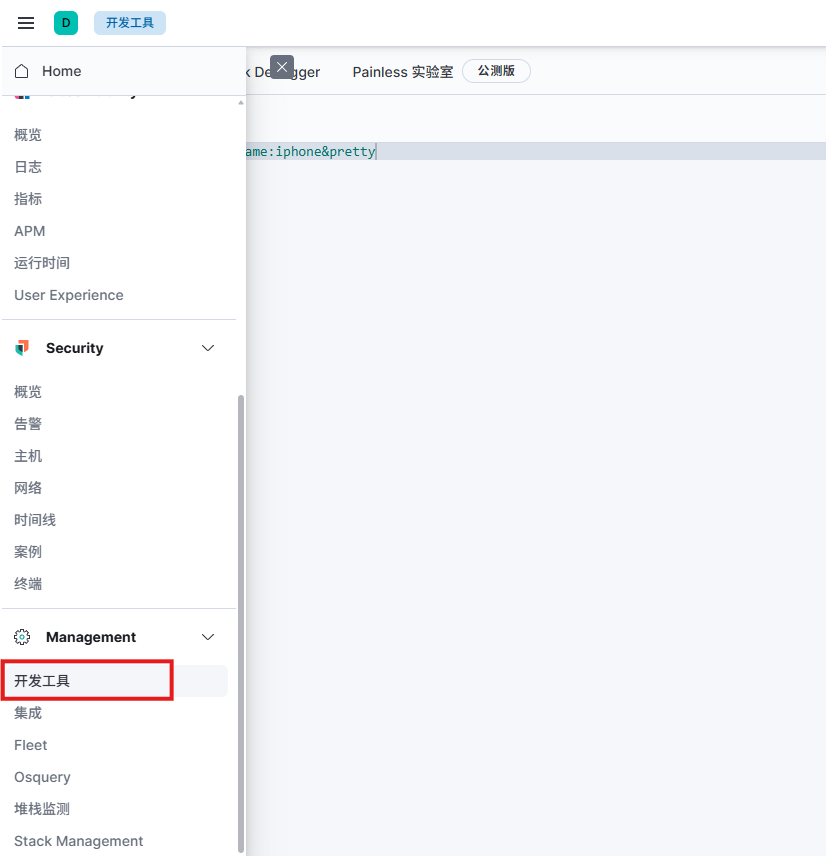
查询结果:
7.2 创建新索引
执行:
shell
curl -X PUT "http://localhost:9201/xinke?pretty"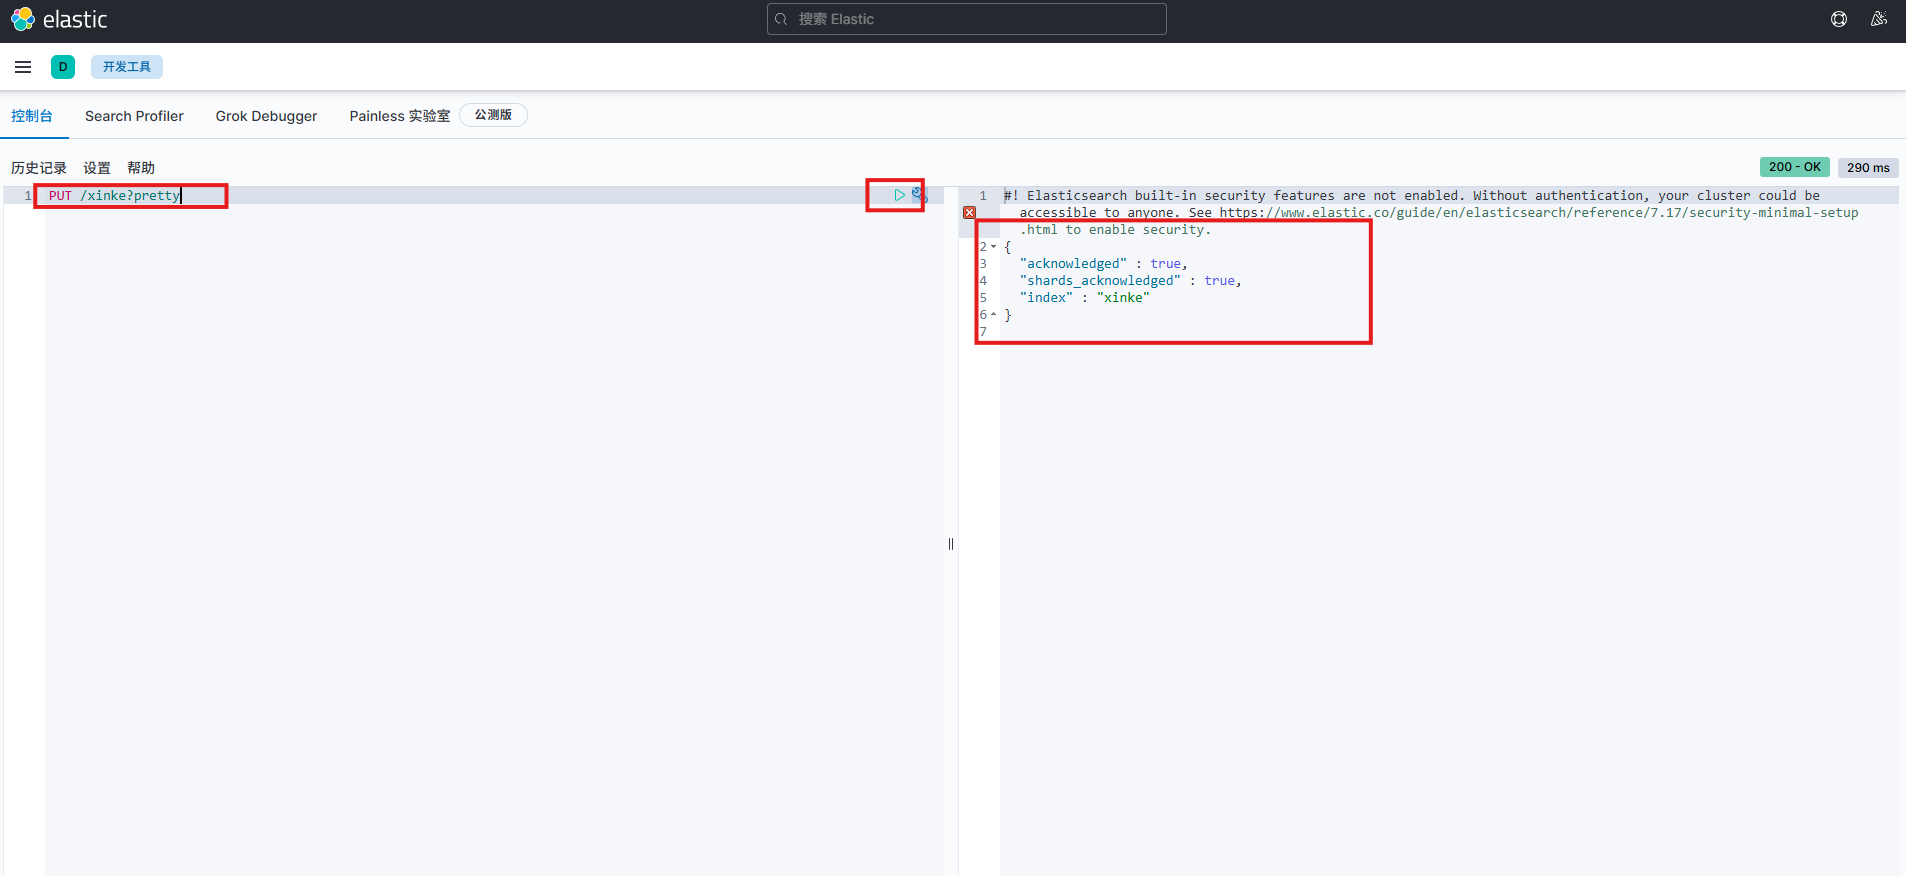
7.3 写入文档
执行:
shell
curl -X POST "http://localhost:9201/xinke/_doc" \
-H "Content-Type: application/json" \
-d '{
  "name": "iPhone 15",
  "price": 7999,
  "category": "phone"
}'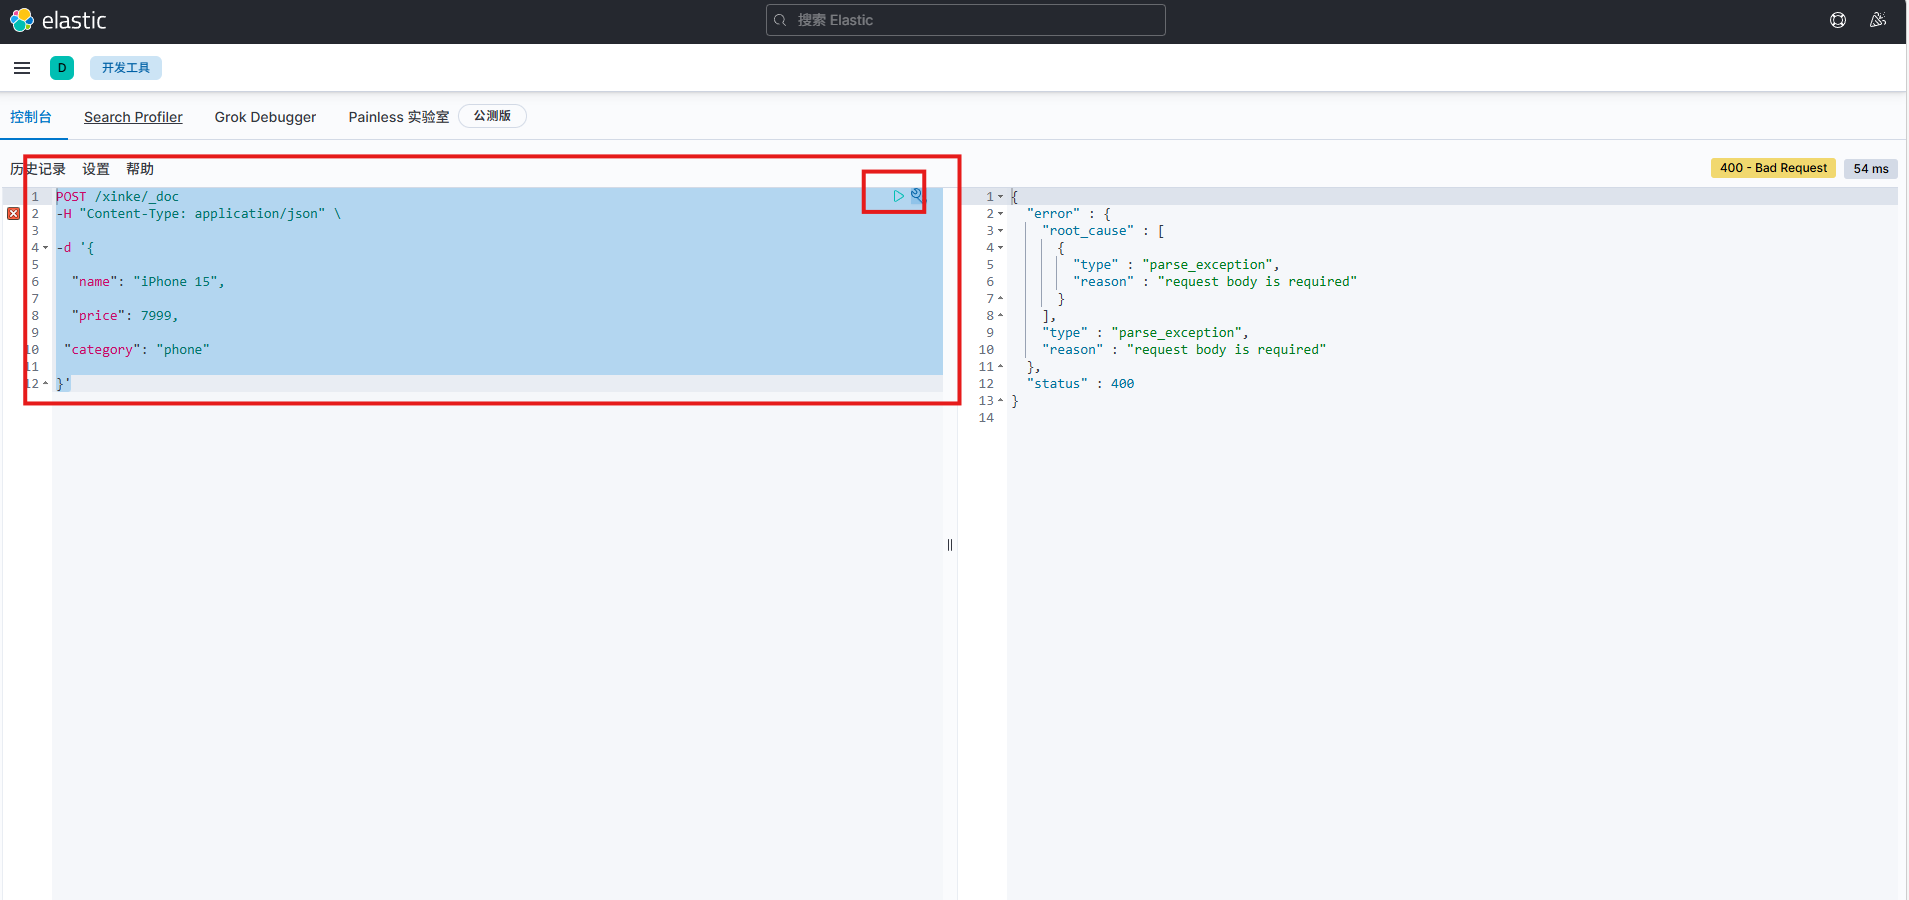
做到这里,创建索引、写入文档、查询数据这几件最基础的事情已经串起来了。
我会把这一段看得比"Dashboard 能不能打开"更重要,因为只有数据真正进入 Elasticsearch,后面的 Kibana 可视化才有意义。
8. 用 Kibana Visualize 创建图表
Kibana 的可视化建立在 Elasticsearch 查询和聚合之上。
先进入 Visualize:
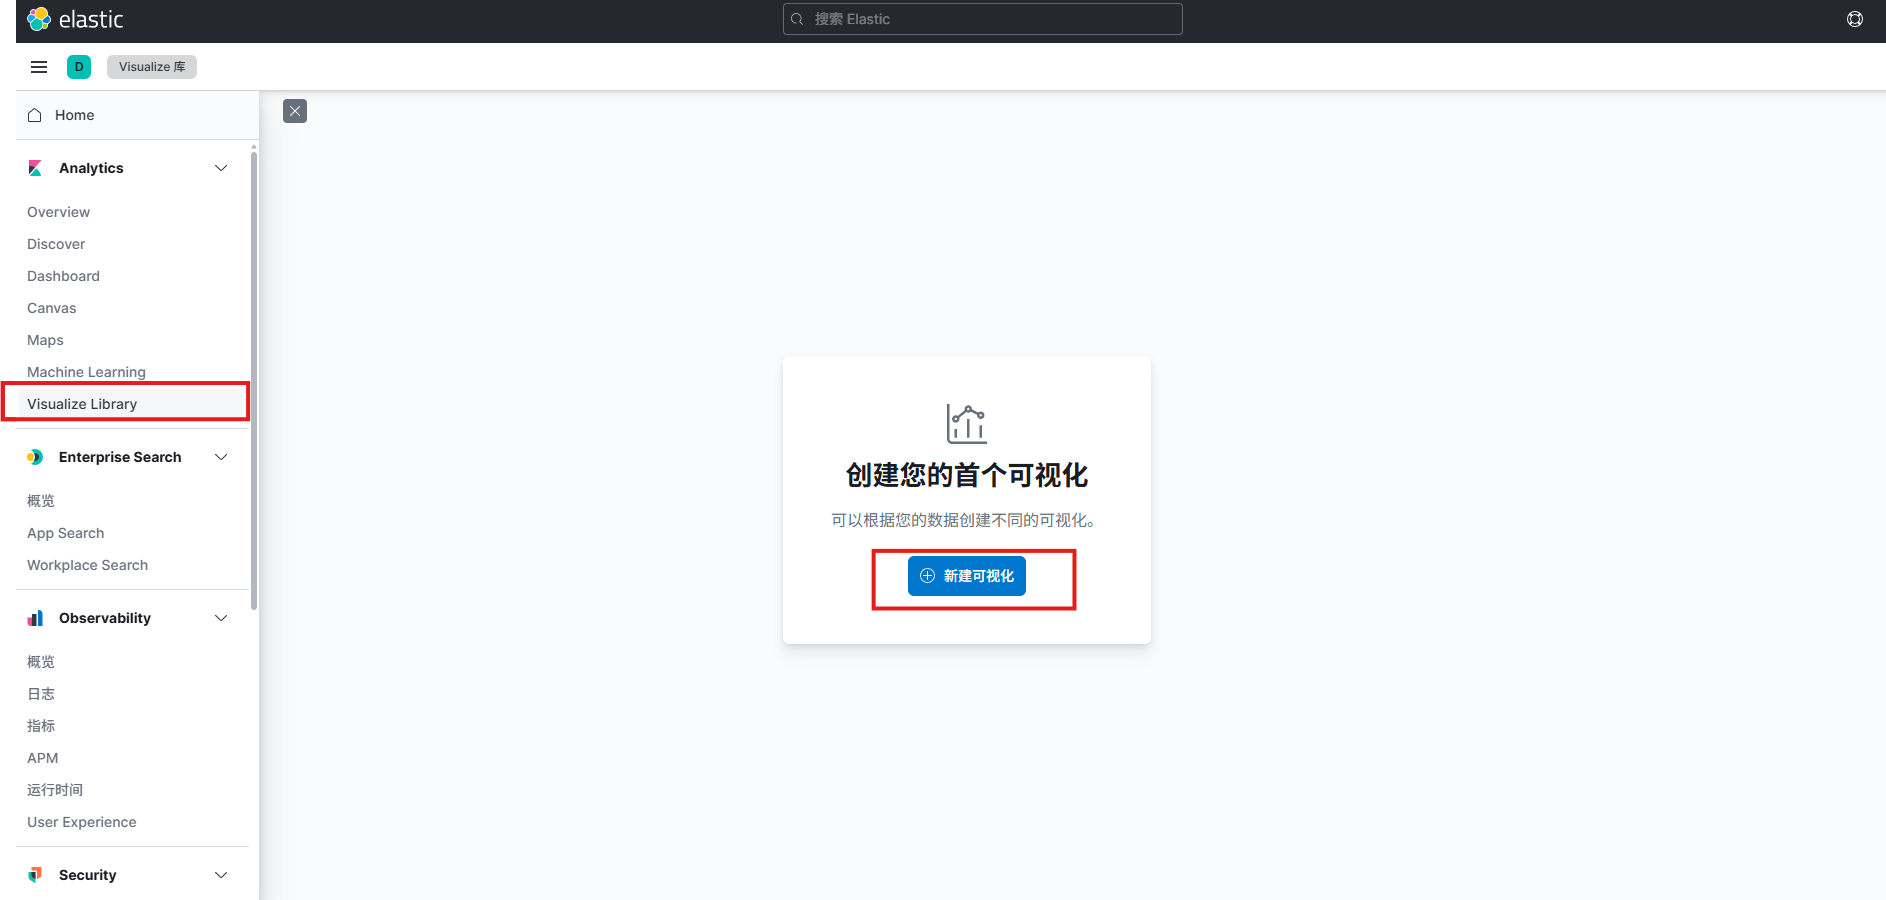
可以看到多个图表类型:
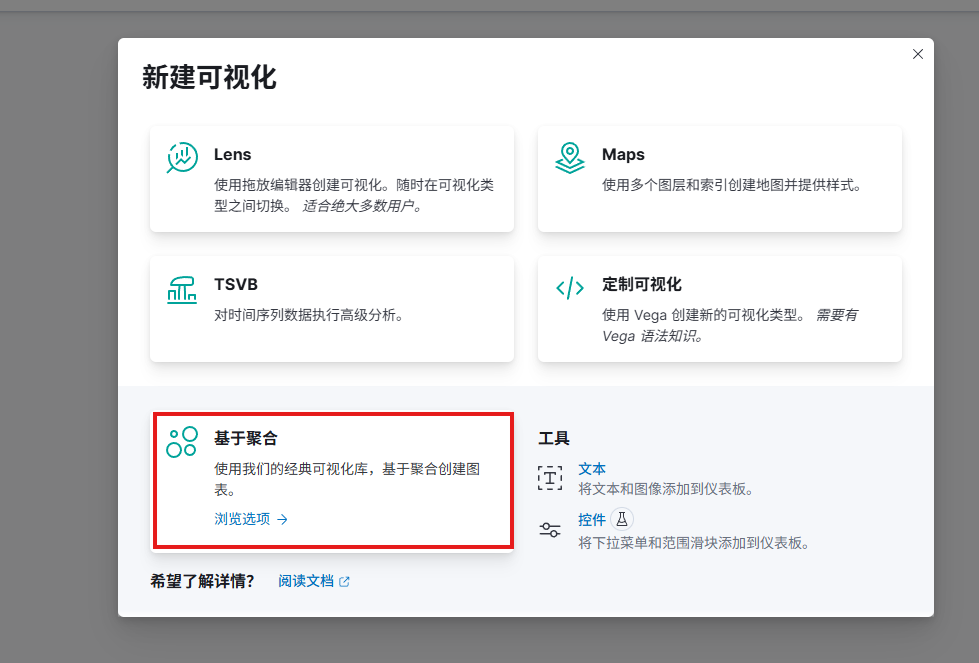
这里选择垂直条形图:
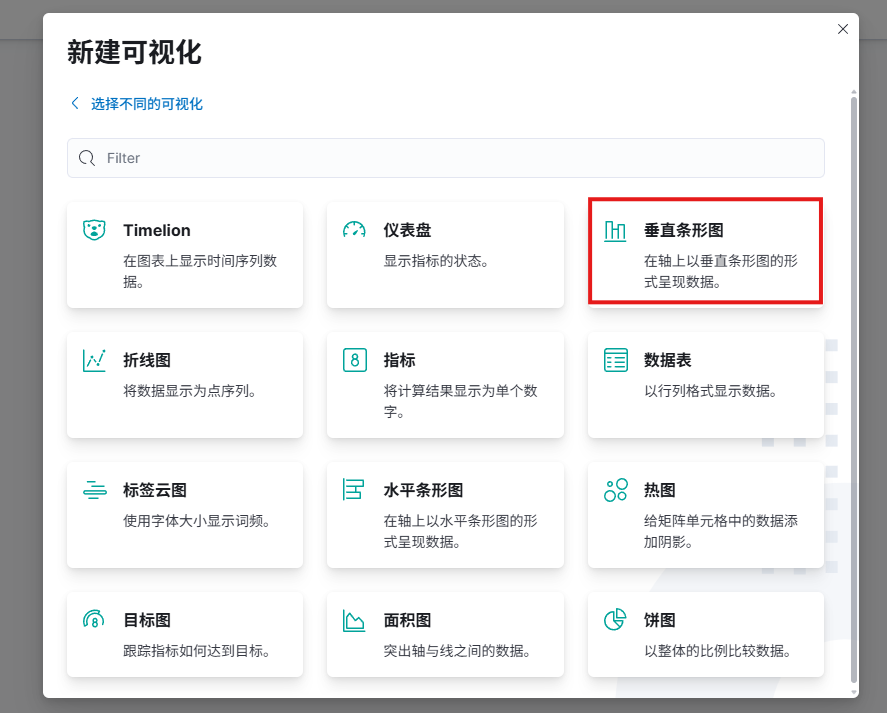
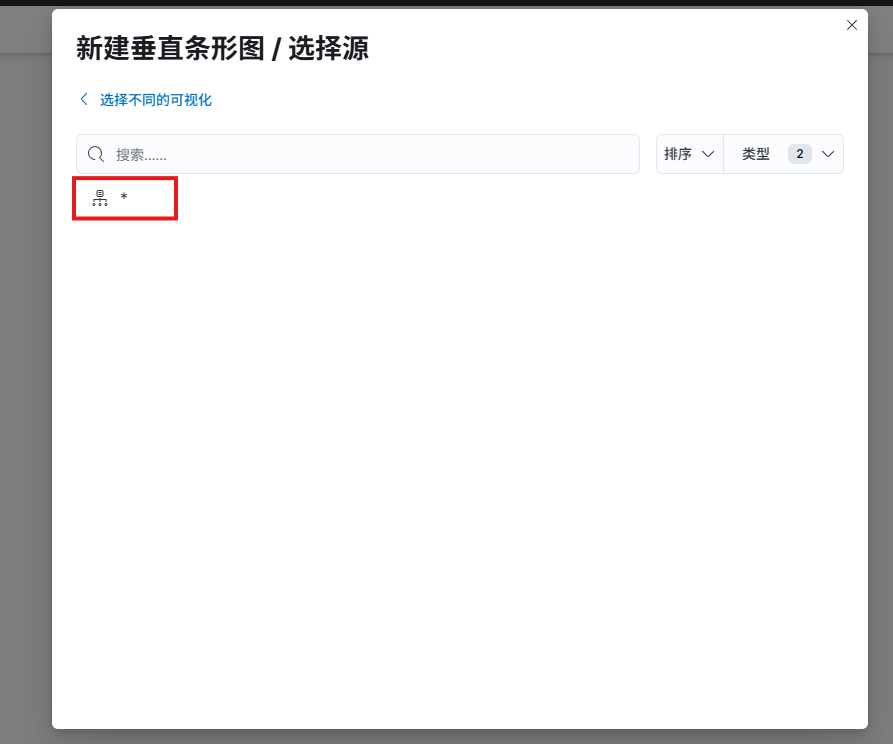
然后继续设置 X 轴和 Y 轴:
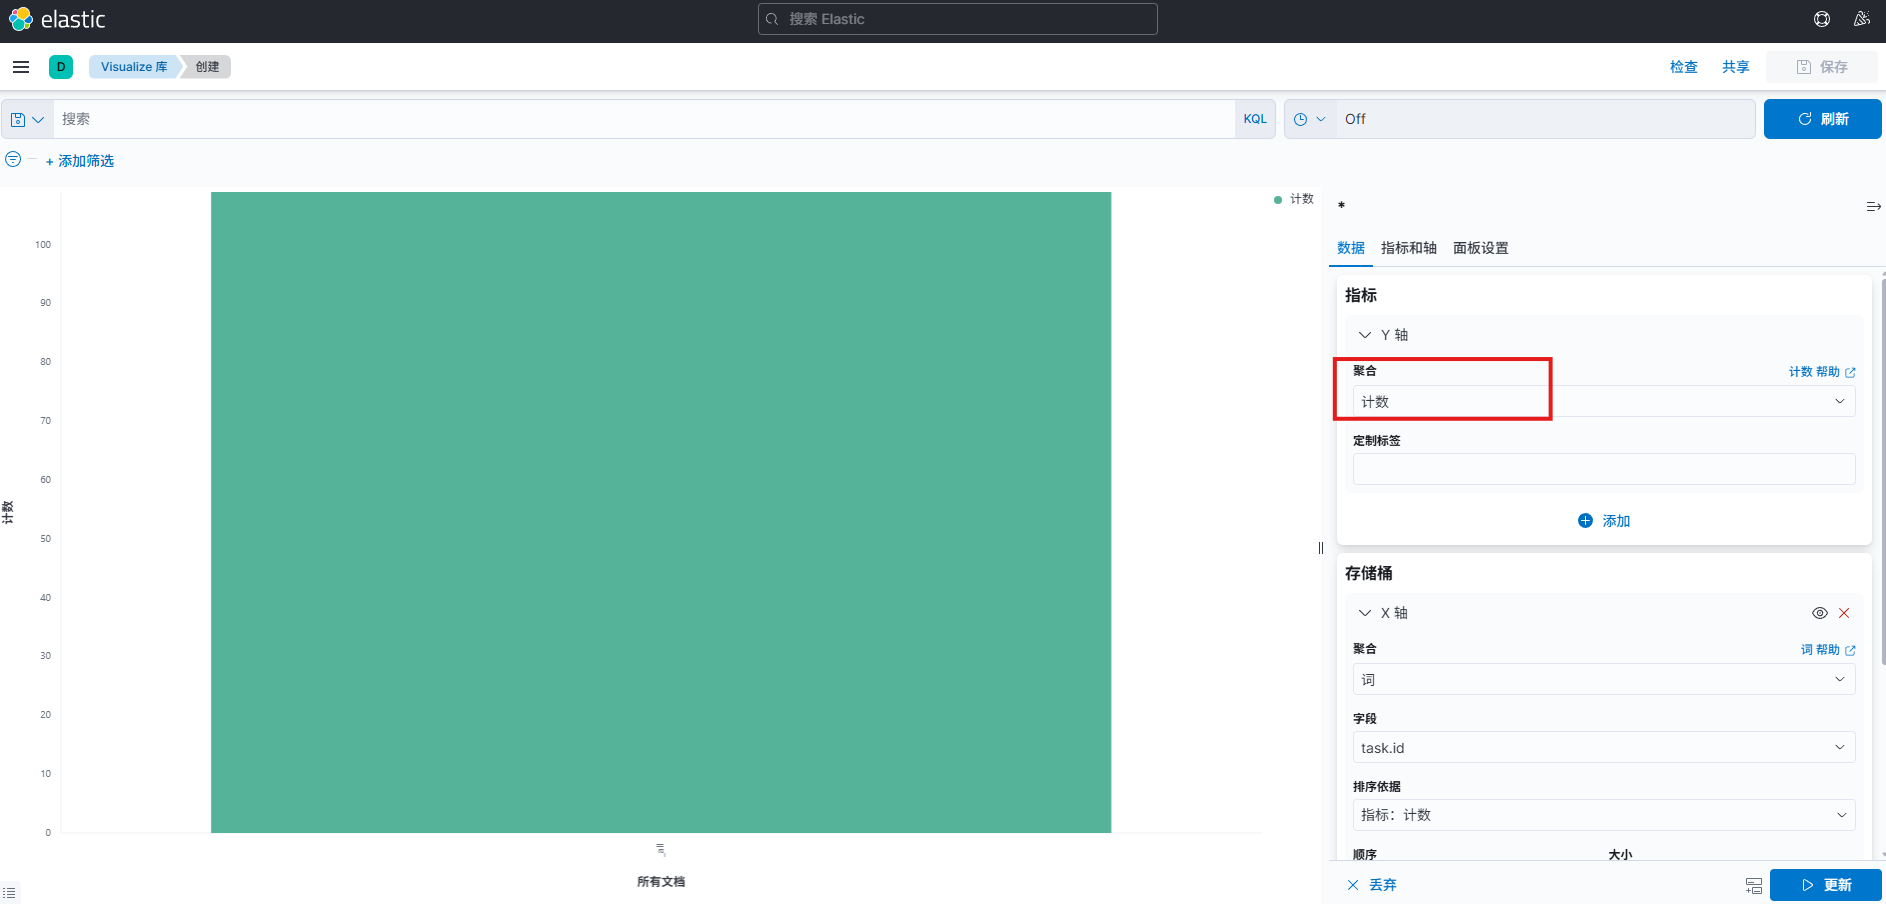
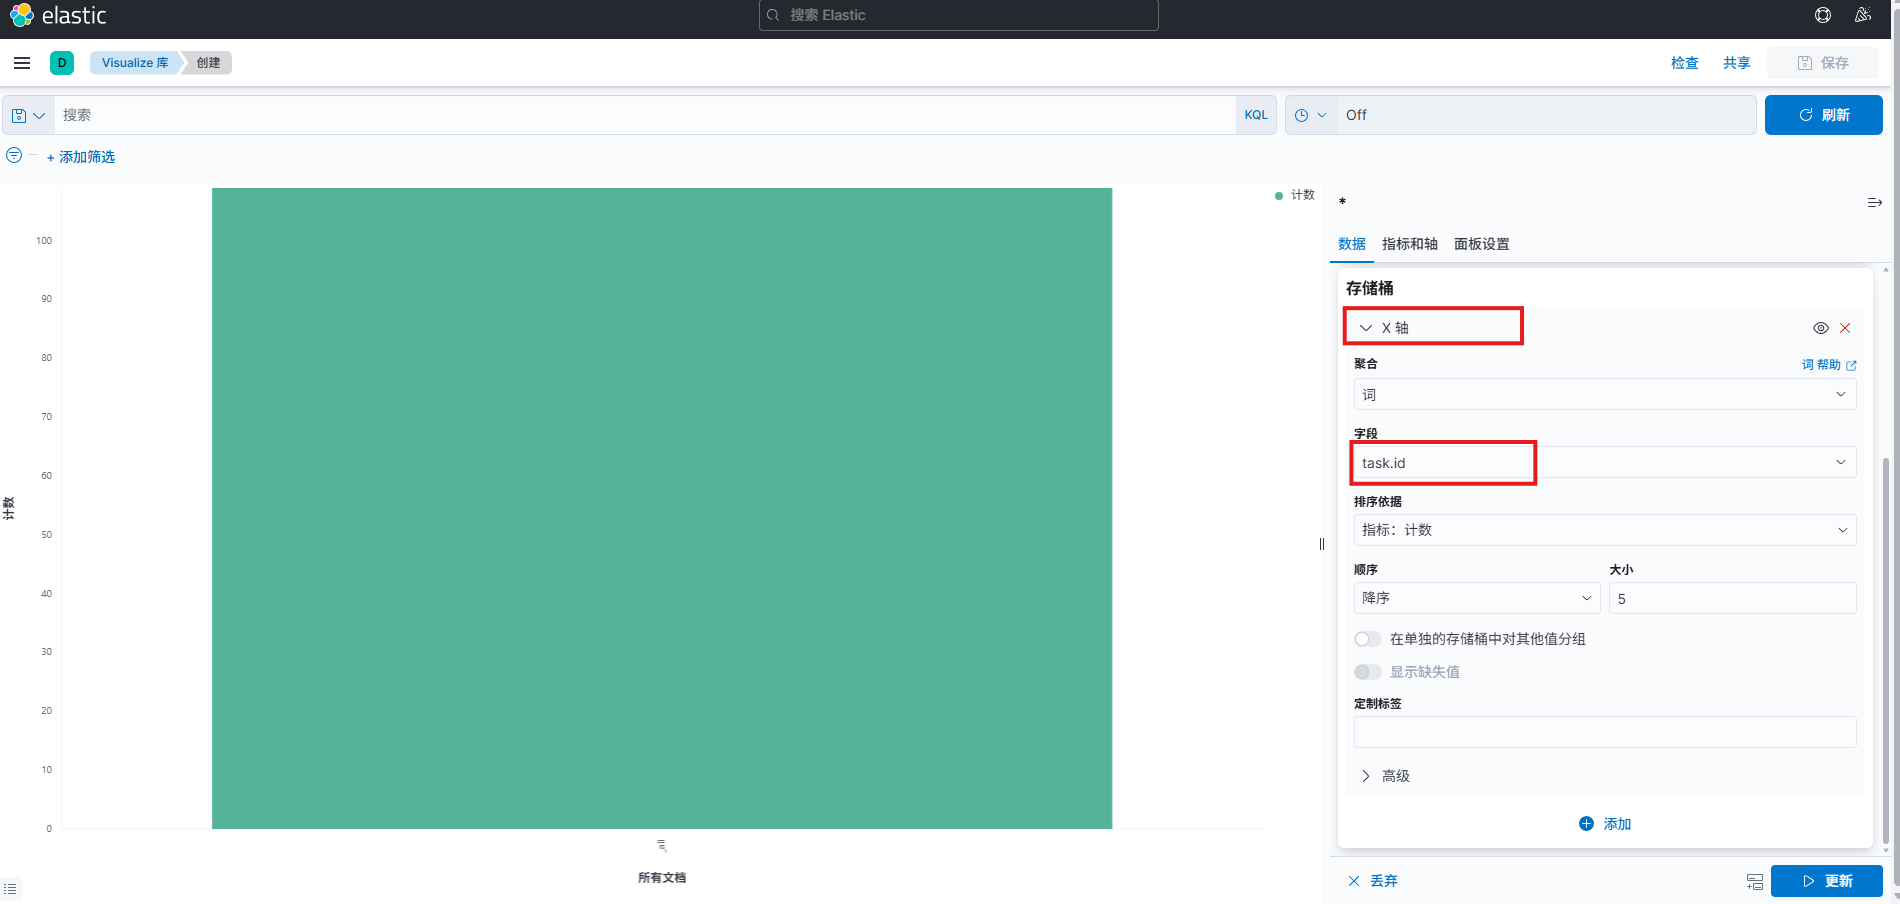
执行以后得到图表:
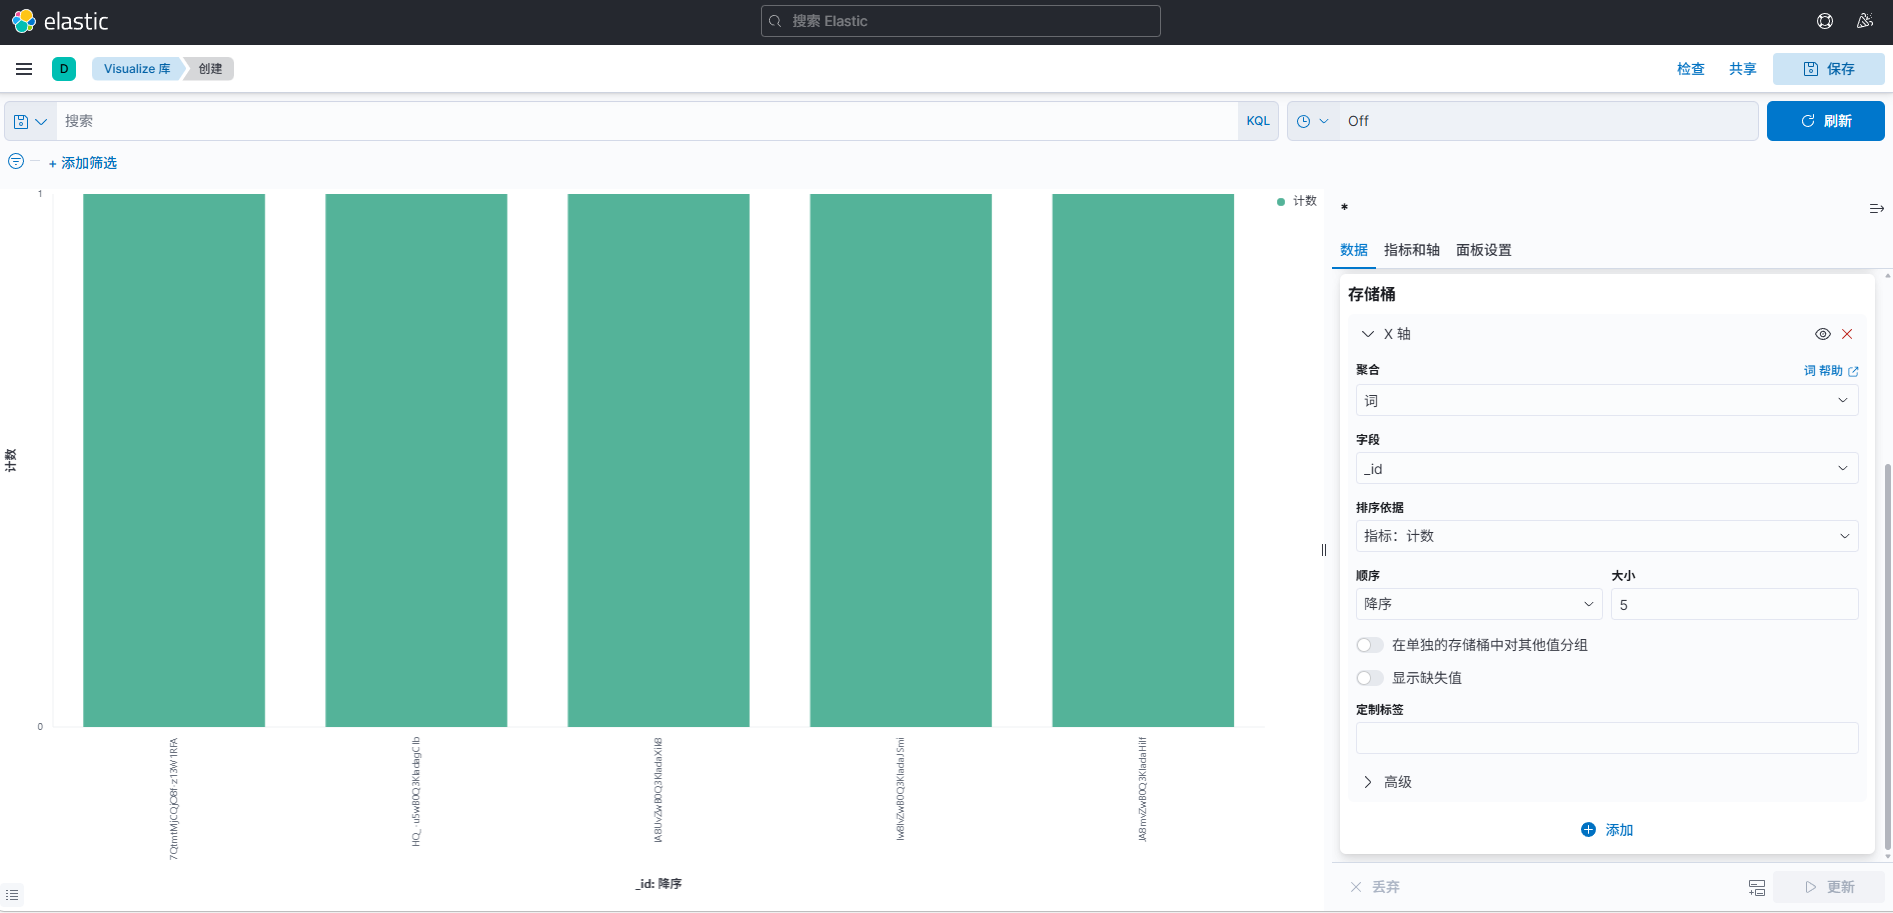
保存后的效果:
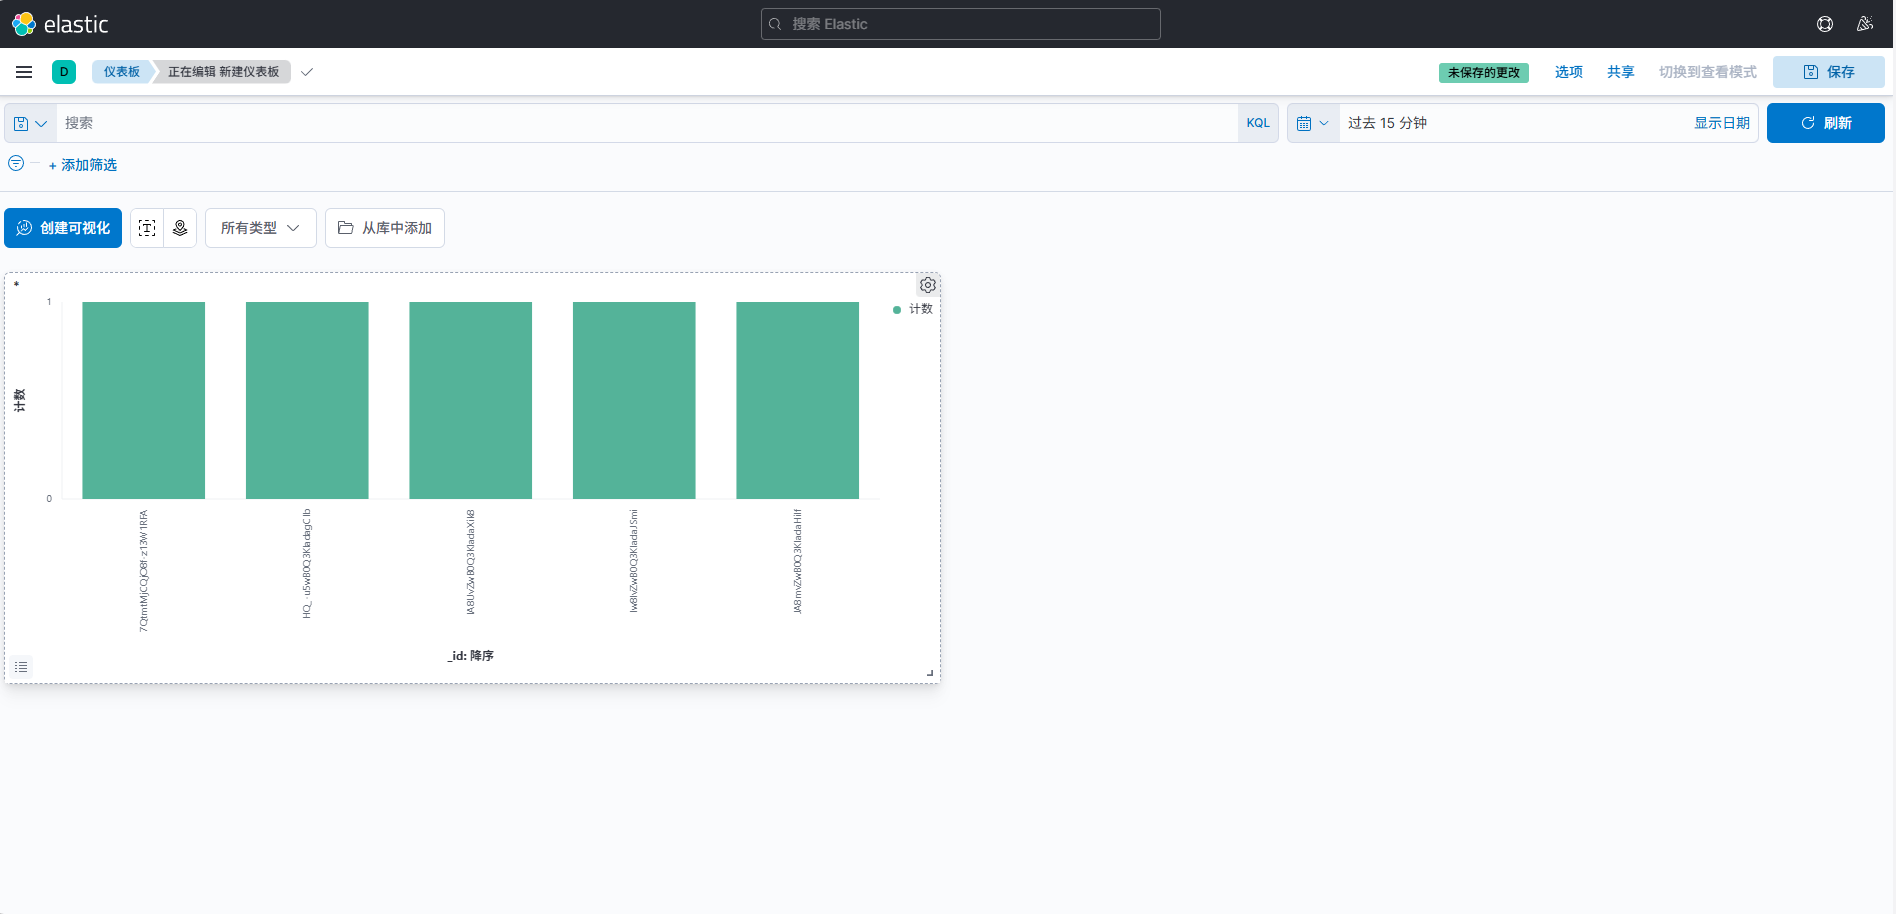
到这里,这条链路才真正闭环:
数据写入 → Elasticsearch 索引 → Kibana 查询 → Visualize 展示。
9. 本地分析跑通以后,再处理远程查看
如果 Kibana 只在本地或内网使用,前面的流程已经能完成查询和可视化。
如果还需要在外出、协作或者应急排查时查看,再继续增加远程入口。
这里 cpolar 负责的是网络访问范围,Kibana 仍然负责日志查询和可视化。
10. 安装 cpolar
执行:
shell
sudo curl https://get.cpolar.sh | sh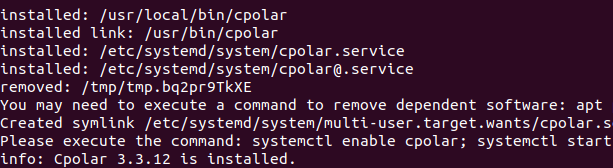
检查服务状态:
shell
sudo systemctl status cpolar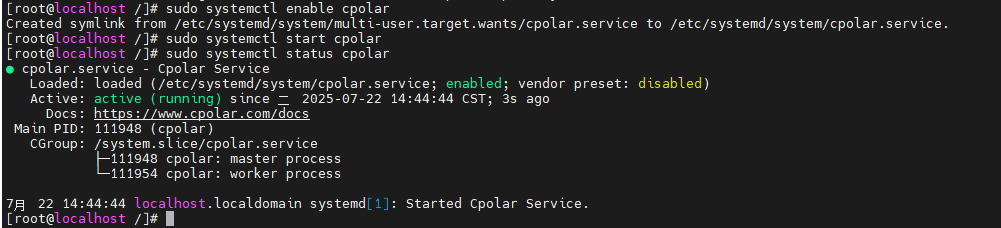
浏览器通过主机 IP 加 9200 进入 cpolar Web UI:
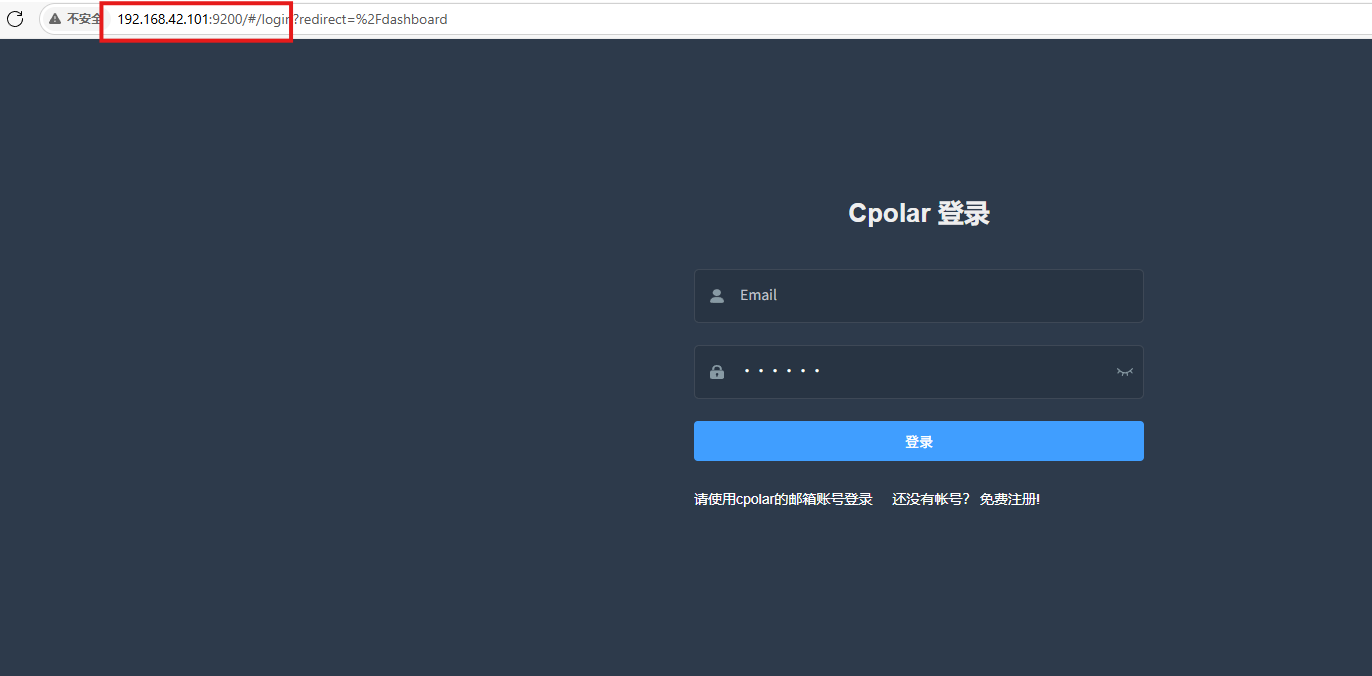
11. 给 Kibana 创建远程访问地址
进入 cpolar Web UI 创建隧道。
参数按现有配置:
- 隧道名称:
kibana - 协议:
http - 本地地址:
5601 - 域名类型:随机域名
- 地区:
China Top
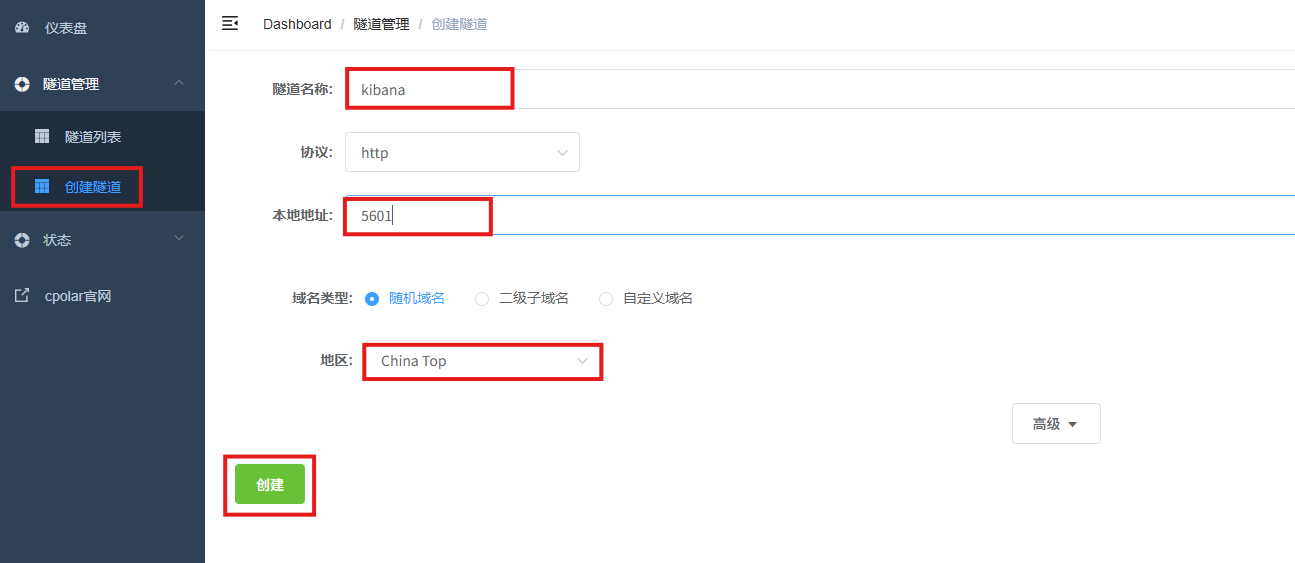
创建以后查看在线隧道:
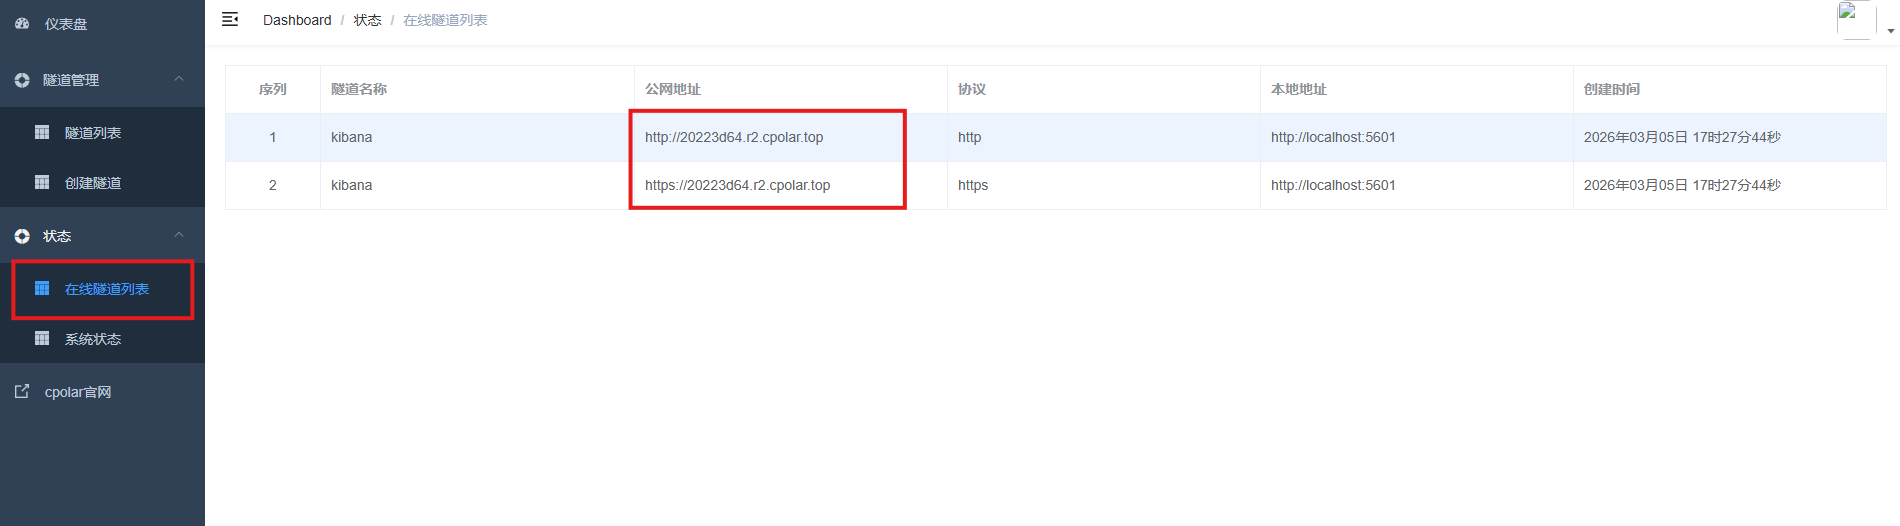
再从其他设备访问:
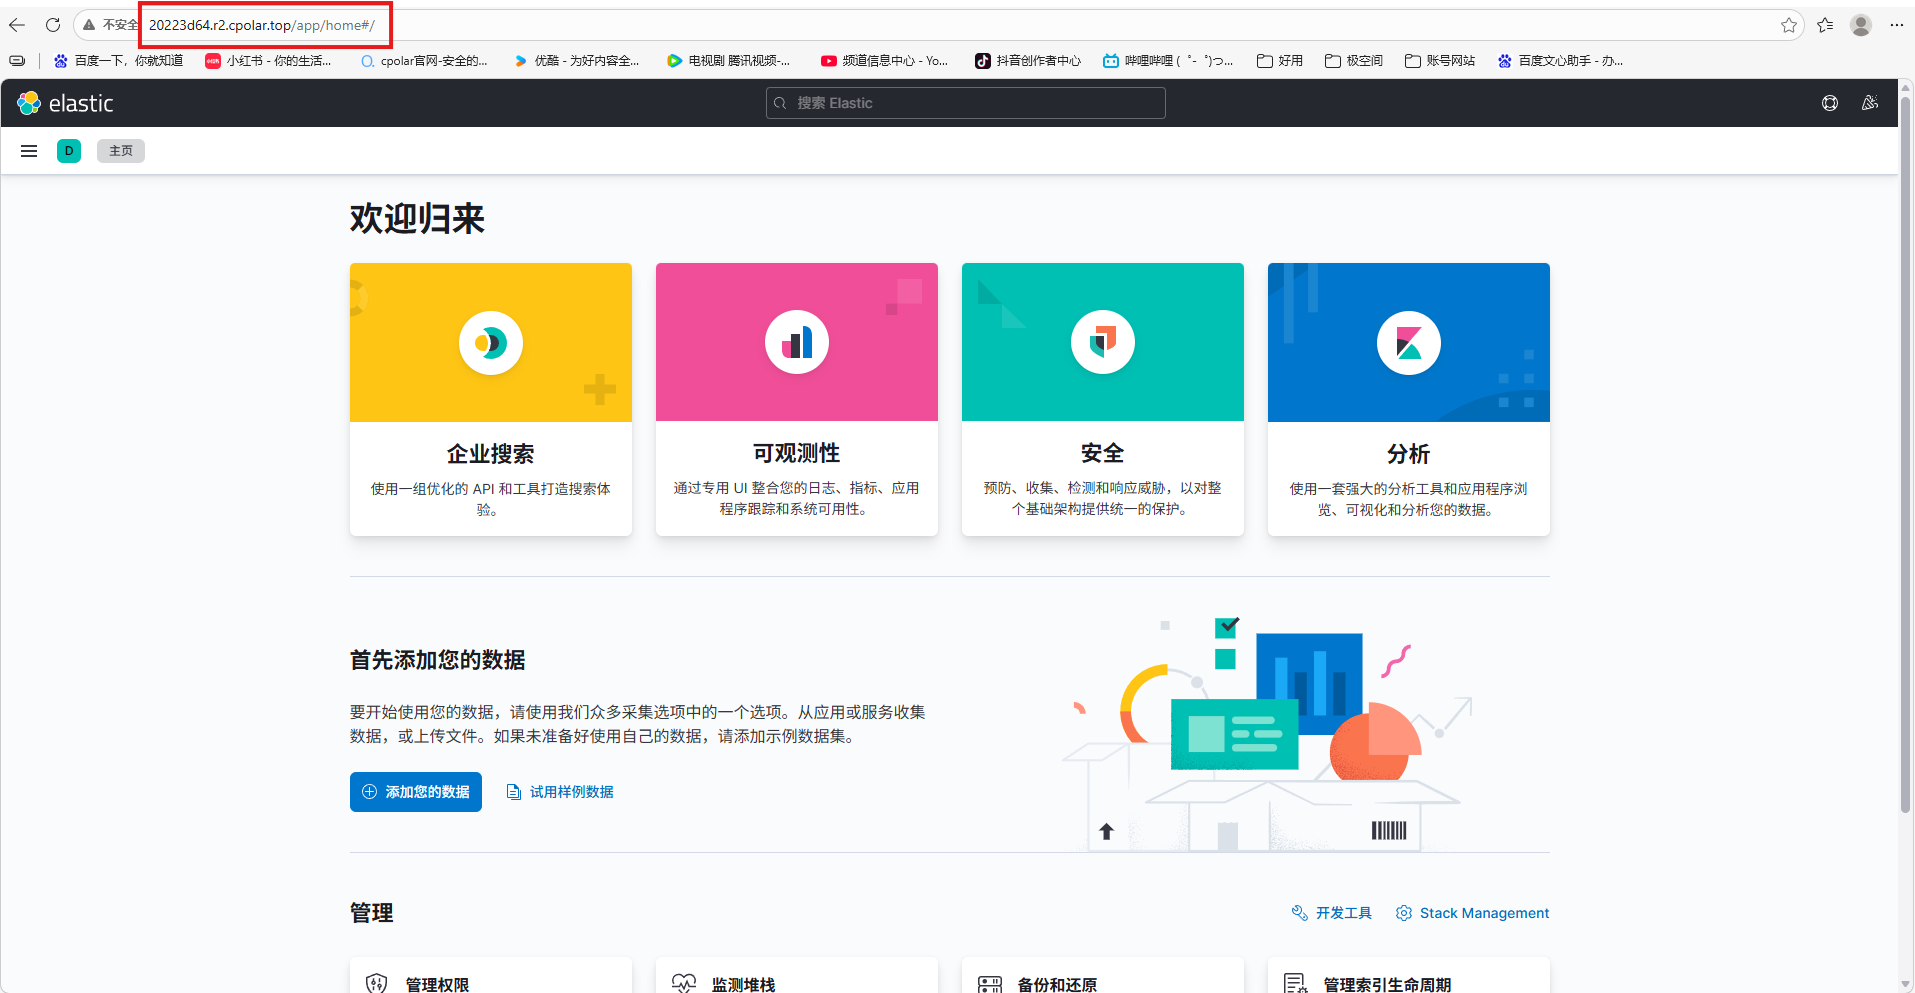
页面能够打开以后,Kibana 就可以从外部网络继续查看。
12. 配置固定二级子域名
如果准备长期使用,再继续配置固定地址。
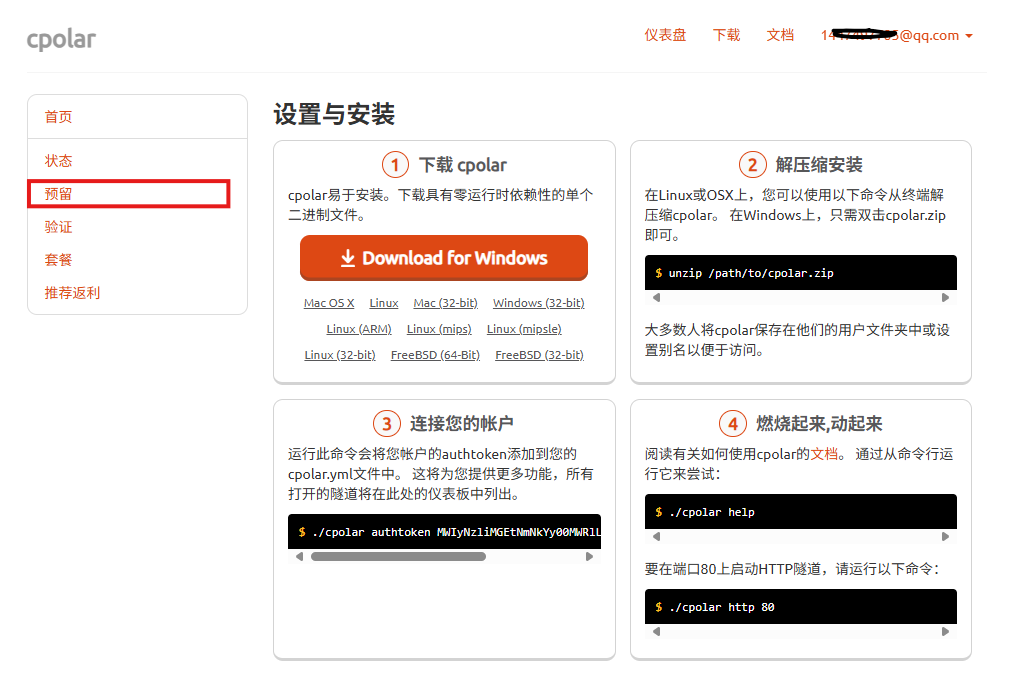
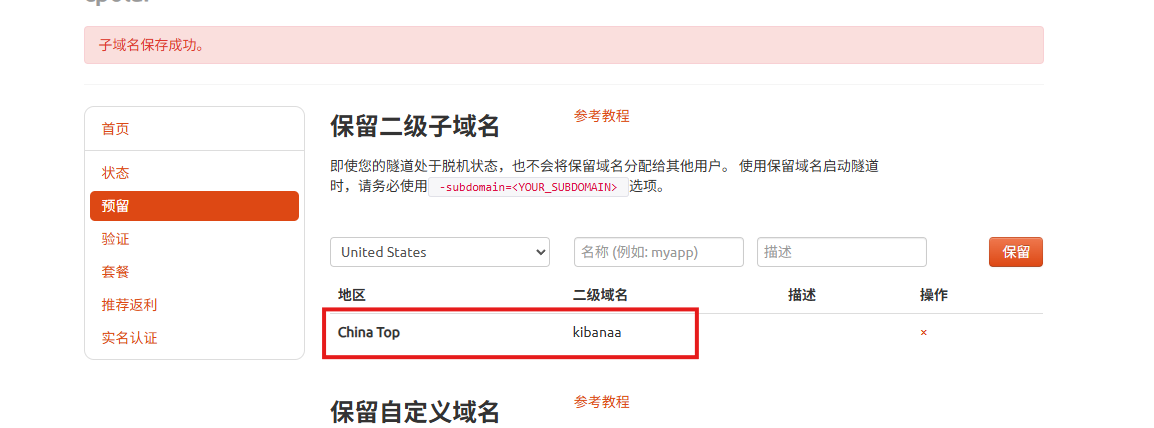
进入预留页面,地区选择 china Top,名称示例使用 kibanaa:
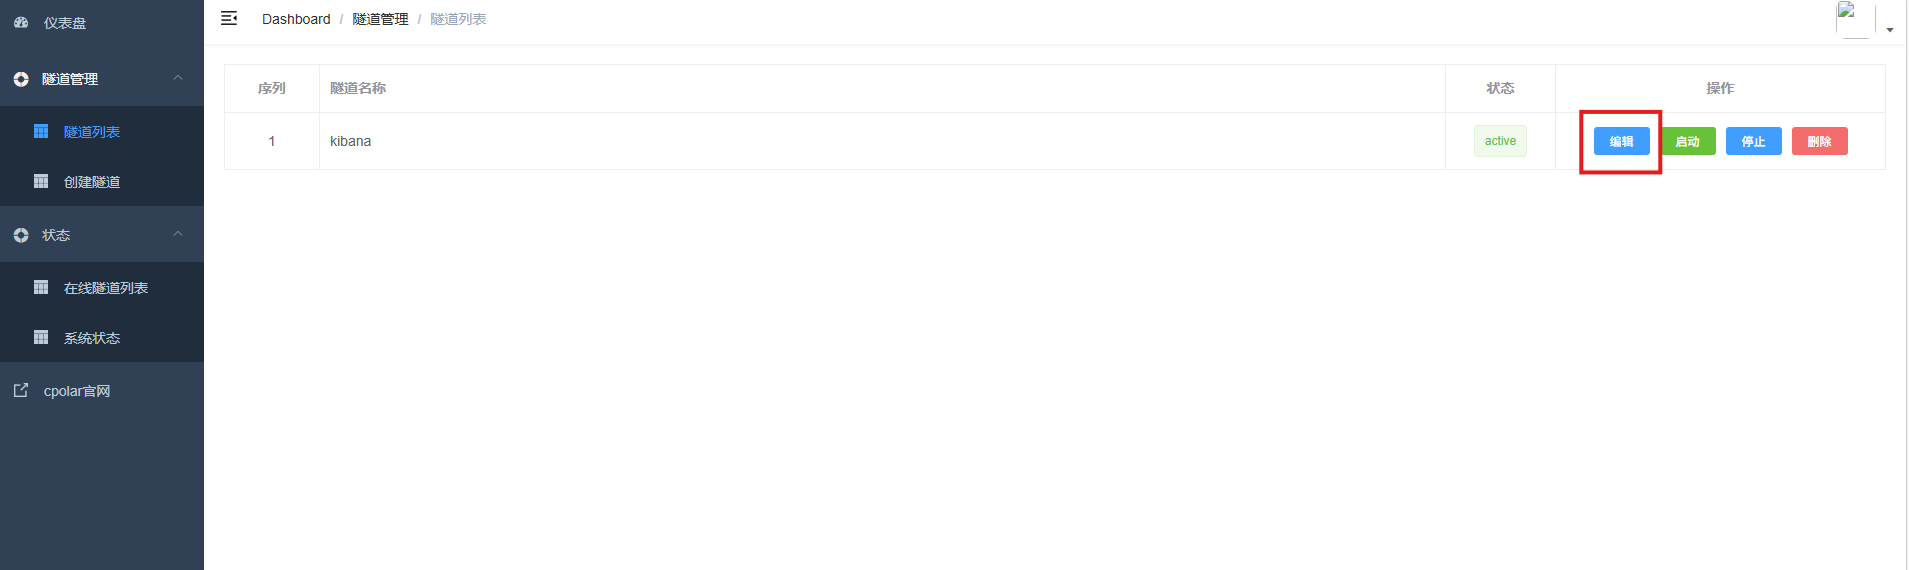
然后回到隧道列表编辑:
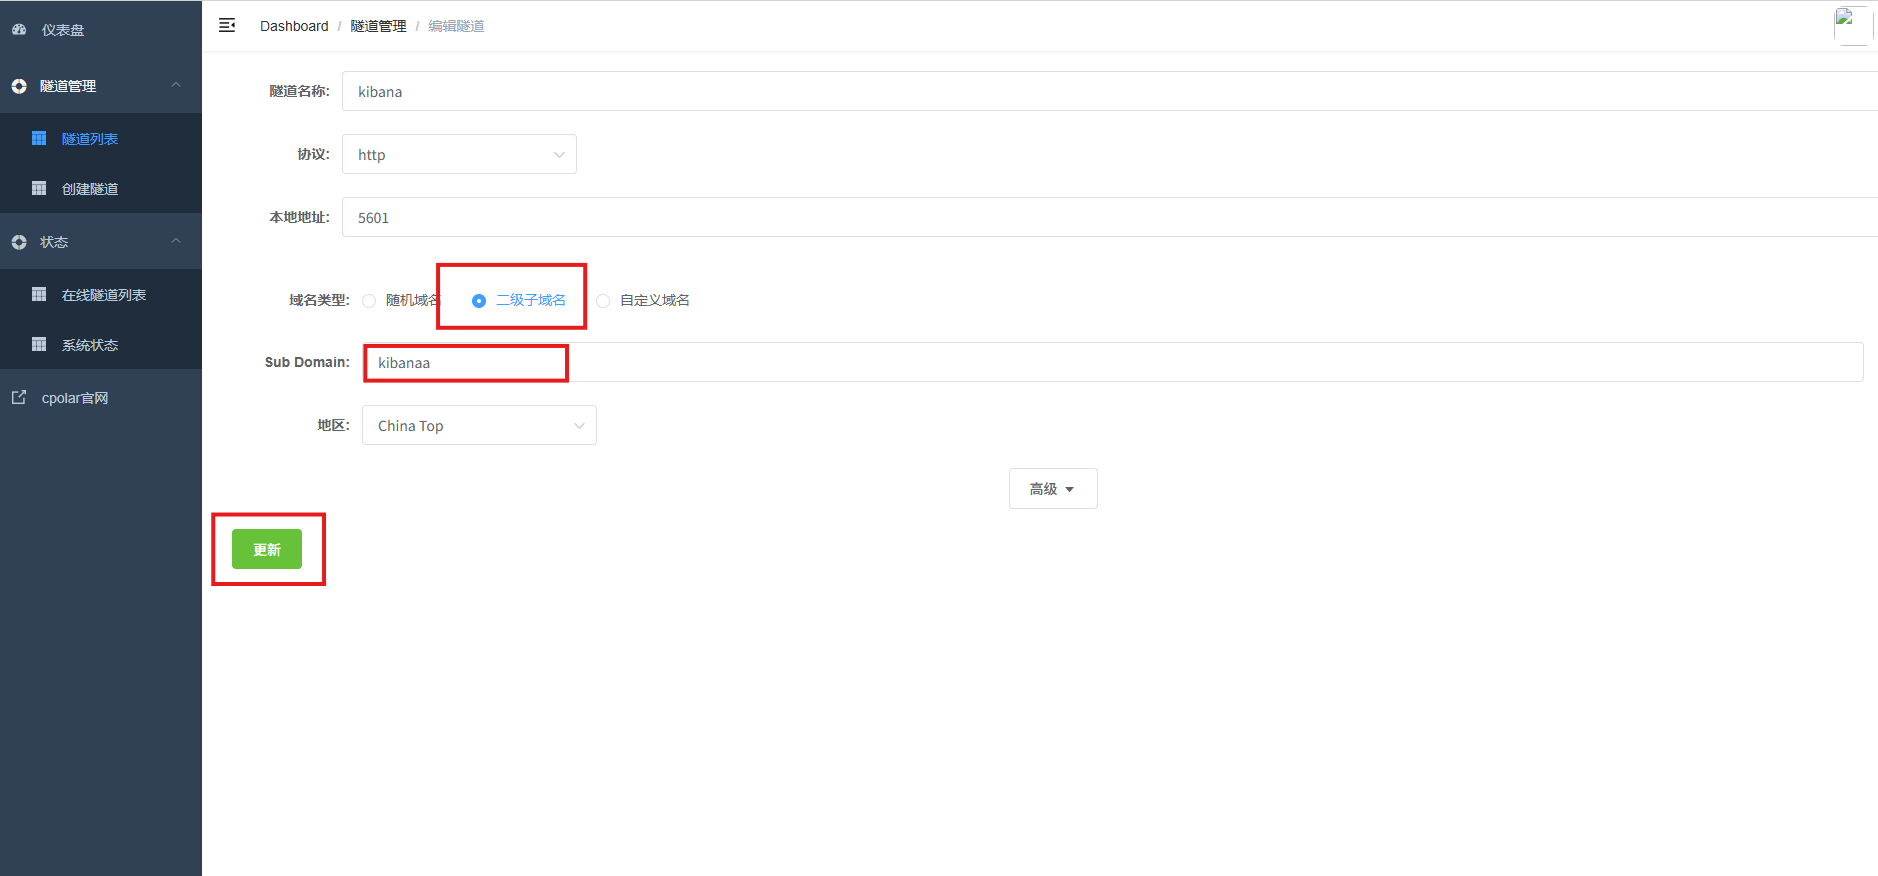
把域名类型改成二级子域名,并填写保留成功的名称:
更新以后,再查看在线隧道列表:
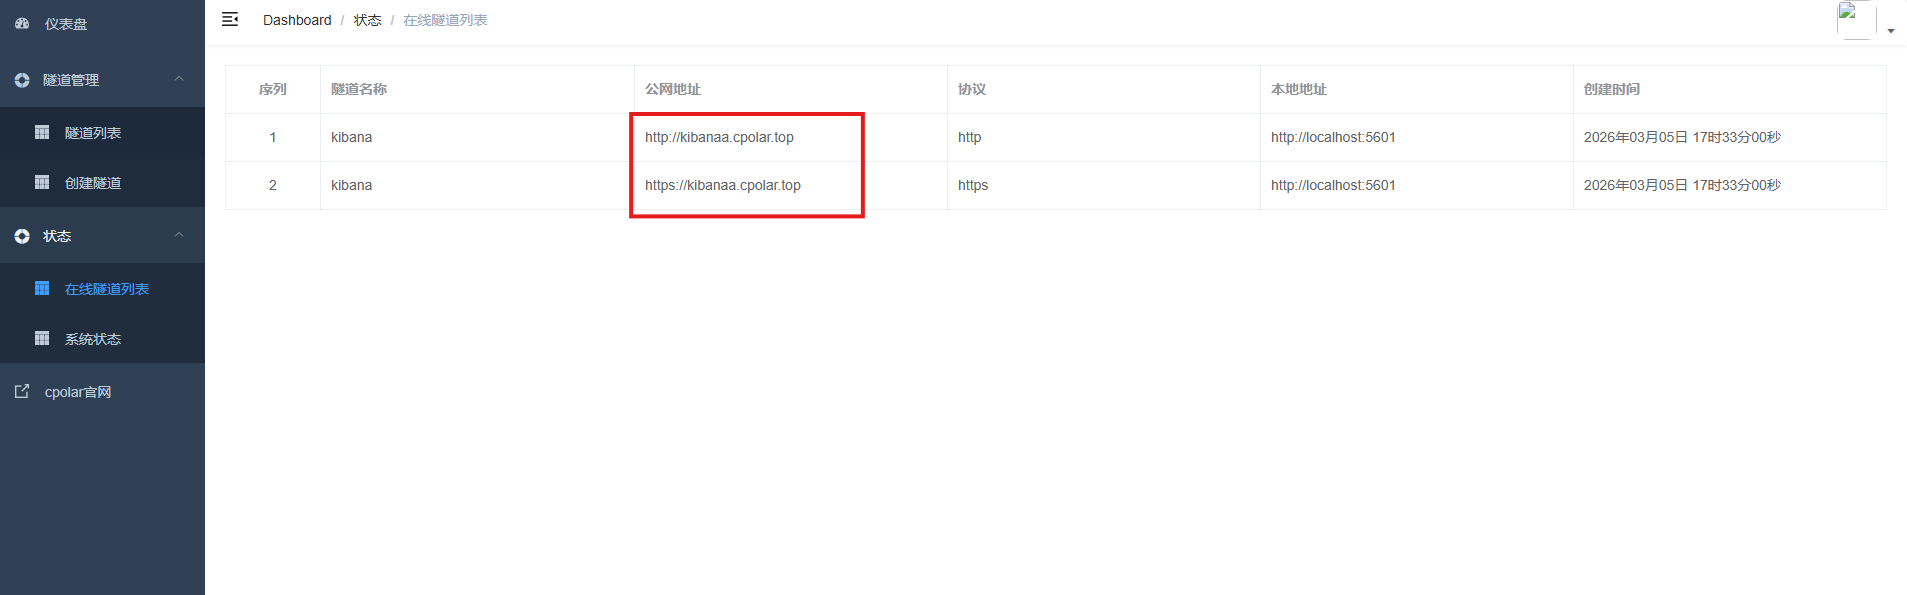
最后用固定地址重新访问:
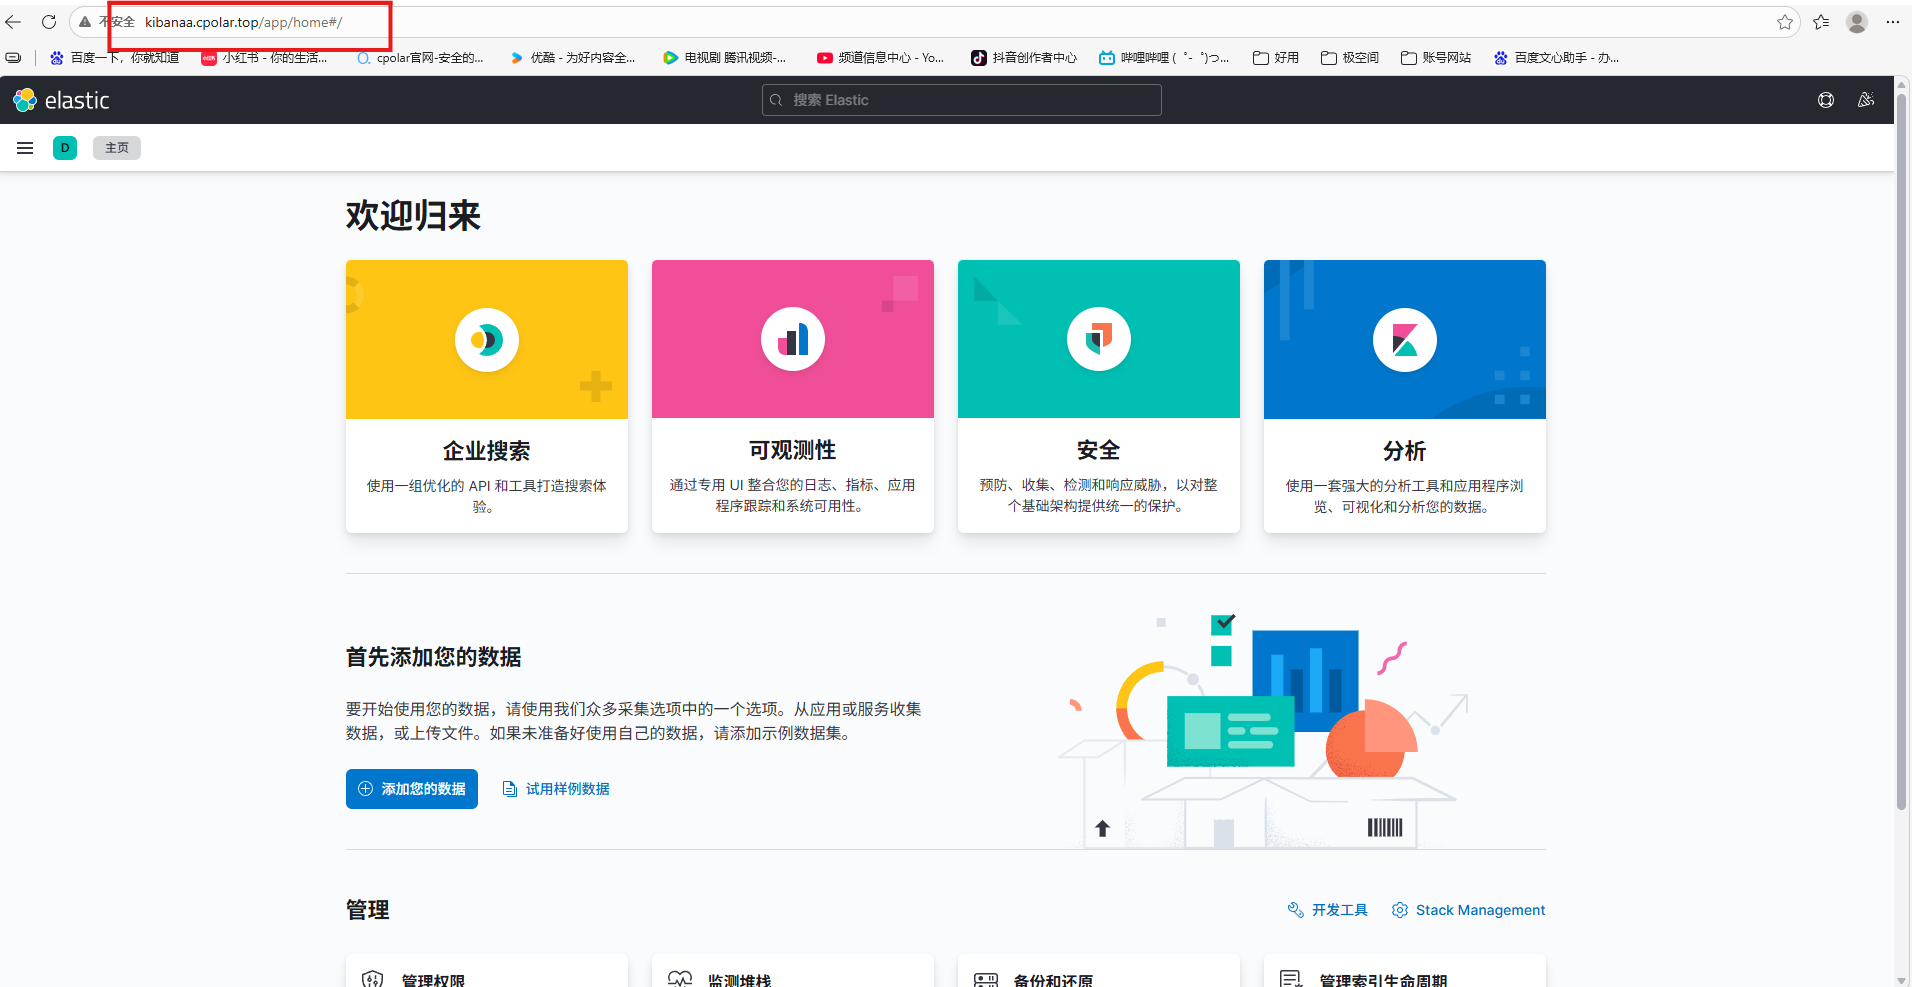
固定入口配置完成以后,后续就不需要反复更换随机地址。
13. 我更看重 Kibana 的哪一部分
我觉得 Kibana 最容易被误解成"做漂亮图表的工具"。
真正长期用起来,更重要的是 Discover、索引、字段、查询和时间范围这些基础能力。图表只是最后一层展示,前面的数据和查询如果没理顺,再漂亮的 Dashboard 也没有意义。
所以这篇我更愿意把它理解成一条链:日志先进来,数据能查,再去做可视化。
总结
整套流程可以拆成三层:Logstash 负责日志接入和转发,Elasticsearch 负责索引与搜索,Kibana 负责查询、字段管理和可视化展示。
本地搭建完成以后,还要继续做索引创建、文档写入、搜索查询、中文界面和 Visualize 图表等验证。只有这些环节都跑通,ELK 才真正具备从原始数据到可视化结果的完整链路。
需要异地查看时,再给 5601 页面增加远程入口,并根据长期使用需求配置固定地址即可。这样不会把网络问题和 ELK 本身的安装、索引或查询问题混在一起。
如果后面继续用于真实日志环境,我会优先关注索引规模、数据接入方式、查询效率和日志保留策略。Kibana 的价值不只是看图,而是把原来散落的日志变成可以快速搜索和分析的数据。