KS正态性检验方法是通过构建样本的cdf,然后和指定的均值和标准差构建的正态分布的cdf比,计算两个cdf的最大绝对距离,如果距离显著大,就说明样本来自的总体不服从正态分布,反之则服从正态分布。 整体的逻辑就是首先假定样本从正态分布中抽出来,然后和对应的正态分布一比,如果距离差异不大,说明就是从正态分布中抽出。(如果直接使用样本的均值和标准差作为总体均值和标准差,可能引入人为的相似性)
Lilliefors方法则不需要知道总体的均值和标准差,只需要样本的均值和标准差就可以了。具体步骤如下:
1.零假设是样本取自正态分布;
2.对样本进行z分数转换;
3.对样本z分数计算cdf,然后和标准正态分布的cdf进行比较,计算最大绝对距离Dreal。
其实这里等同于是先把总体标准化,然后抽样,再算z分数:
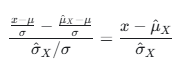
μ是总体均值,σ是总体标准差;μx尖就是样本均值,σx尖就是样本标准差。
拿这个分数构建的cdf和从标准正态分布得到的cdf进行比较,就具有可比性。但是毕竟样本的均值和标准差未必代表总体,所以这个z分数的cdf和标准正态分布的cdf肯定有一些偏差。所以就使用蒙特卡洛模拟的方法,把这种偏差引入零模型中,然后将Dreal和零模型得到的D分布进行比较。
4.然后进行蒙特卡洛模拟,每次从标准正态分布中抽样(相当于从一个假定为正态分布,并经过z转换的总体中抽样,和step3一致),然后对样本计算z分数,之后再对样本z分数计算cdf,同样和标准正态分布的cdf进行比较,计算最大绝对距离Dsurr,构建零分布。这里同样存在样本z分数的cdf和标准正态分布的cdf之间的的偏差。
5.看Dreal是否在零分布右侧0.05,如果是就说明显著,反对零假设。
基本的逻辑和KS检验一样的,都是首先假定样本从正态分布中抽出来,和对应正态分布一比,看差异。