用 AI Agent 构建全栈应用,是指由 Claude Code 这类 AI 编程智能体读取项目、制定计划、编写前后端代码、运行测试并修复错误,开发者负责需求、架构和验收。要让这套流程稳定运转,就需要一个可靠的本地运行环境和统一的模型接入层。本文用 Claude Code 搭配 ServBay 的 MCP 服务和 AI 网关,从需求简报到上线,完整走一遍任务管理应用 TaskFlow 的搭建过程。
文章会告诉你一套可复用的 AI 全栈开发流程,一组可以直接运行的代码,以及一种把多家模型和订阅账号收拢到同一个入口的做法。
AI 编程智能体和代码补全有什么区别
代码补全工具只预测下一行代码,思考、拼装和纠错都由人完成。AI 编程智能体接到的是一个任务,它会自己查看项目结构,拆分步骤,跨文件修改,运行命令验证结果,发现报错后继续修。
| 对比项 | 代码补全 | AI 编程智能体(如 Claude Code) |
|---|---|---|
| 工作单位 | 单行或单个函数 | 完整任务 |
| 项目感知 | 当前文件 | 整个代码库 |
| 执行命令 | 不能 | 可以运行构建、测试、迁移 |
| 纠错 | 人工 | 读取报错后自行迭代 |
| 人的角色 | 逐行编写 | 提需求、审方案、做验收 |
Cursor、GitHub Copilot 的 Agent 模式、Codex 同属这一类,本文以 Claude Code 为例,思路可以迁移到其他工具。
需要注意的是,Agent 的输出质量取决于输入质量。需求含糊时它会自行补全假设,错误假设积累起来,返工的成本比事先写五句话高得多。所以整个流程的第一步是写清楚简报。
工具链选择与整体流程
这套方案由四部分组成。
-
Claude Code:负责规划、写代码、跑测试。
-
ServBay:提供本地运行环境,包括 Node.js、PostgreSQL、站点域名和 SSL 证书,同时内置 MCP 服务,让 Claude Code 可以直接操作这些服务。
-
ServBay AI 网关:作为 AI 开发的底座,统一管理模型来源。
-
Next.js 与 PostgreSQL:应用本身的技术栈。
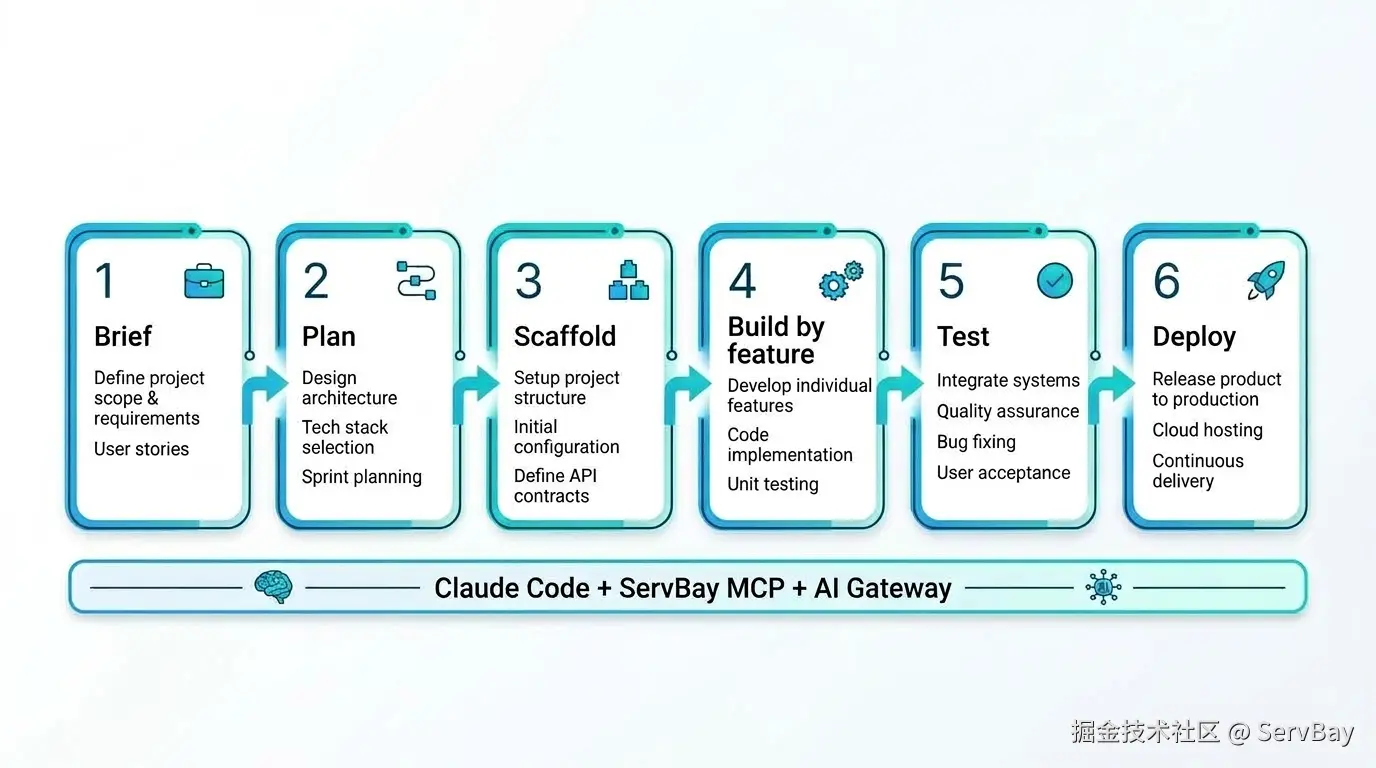
整个流程分六步:简报、规划、脚手架、按功能开发、测试、部署。后面的章节按这个顺序展开。
为什么需要 ServBay 作为 AI 开发底座
多数人开始用 AI 编程后,很快会碰到三类麻烦。
第一,模型来源分散。官方 API、订阅账号、第三方中转站各有一套地址和密钥,每个项目都要单独配置。第二,协议不统一。Claude Code 走 Anthropic 协议,很多 SDK 走 OpenAI 协议,想换一个便宜的模型,工具往往不支持。第三,密钥管理混乱。真实密钥写进多个项目的 .env,泄露风险高,也无法统计每个项目花了多少。
ServBay 的 AI 网关针对这些问题给出了统一入口。
- 统一接入:云端模型和本地 Ollama 模型放在同一个地址之后。官方 API、订阅账号以及任何兼容 OpenAI 协议的服务,包括各类中转站,都可以作为渠道添加。
- 协议转换:支持 Anthropic、OpenAI、Gemini 三种格式互相转换。上层应用使用哪种协议,下游渠道可以是另一种协议,应用端不需要关心。
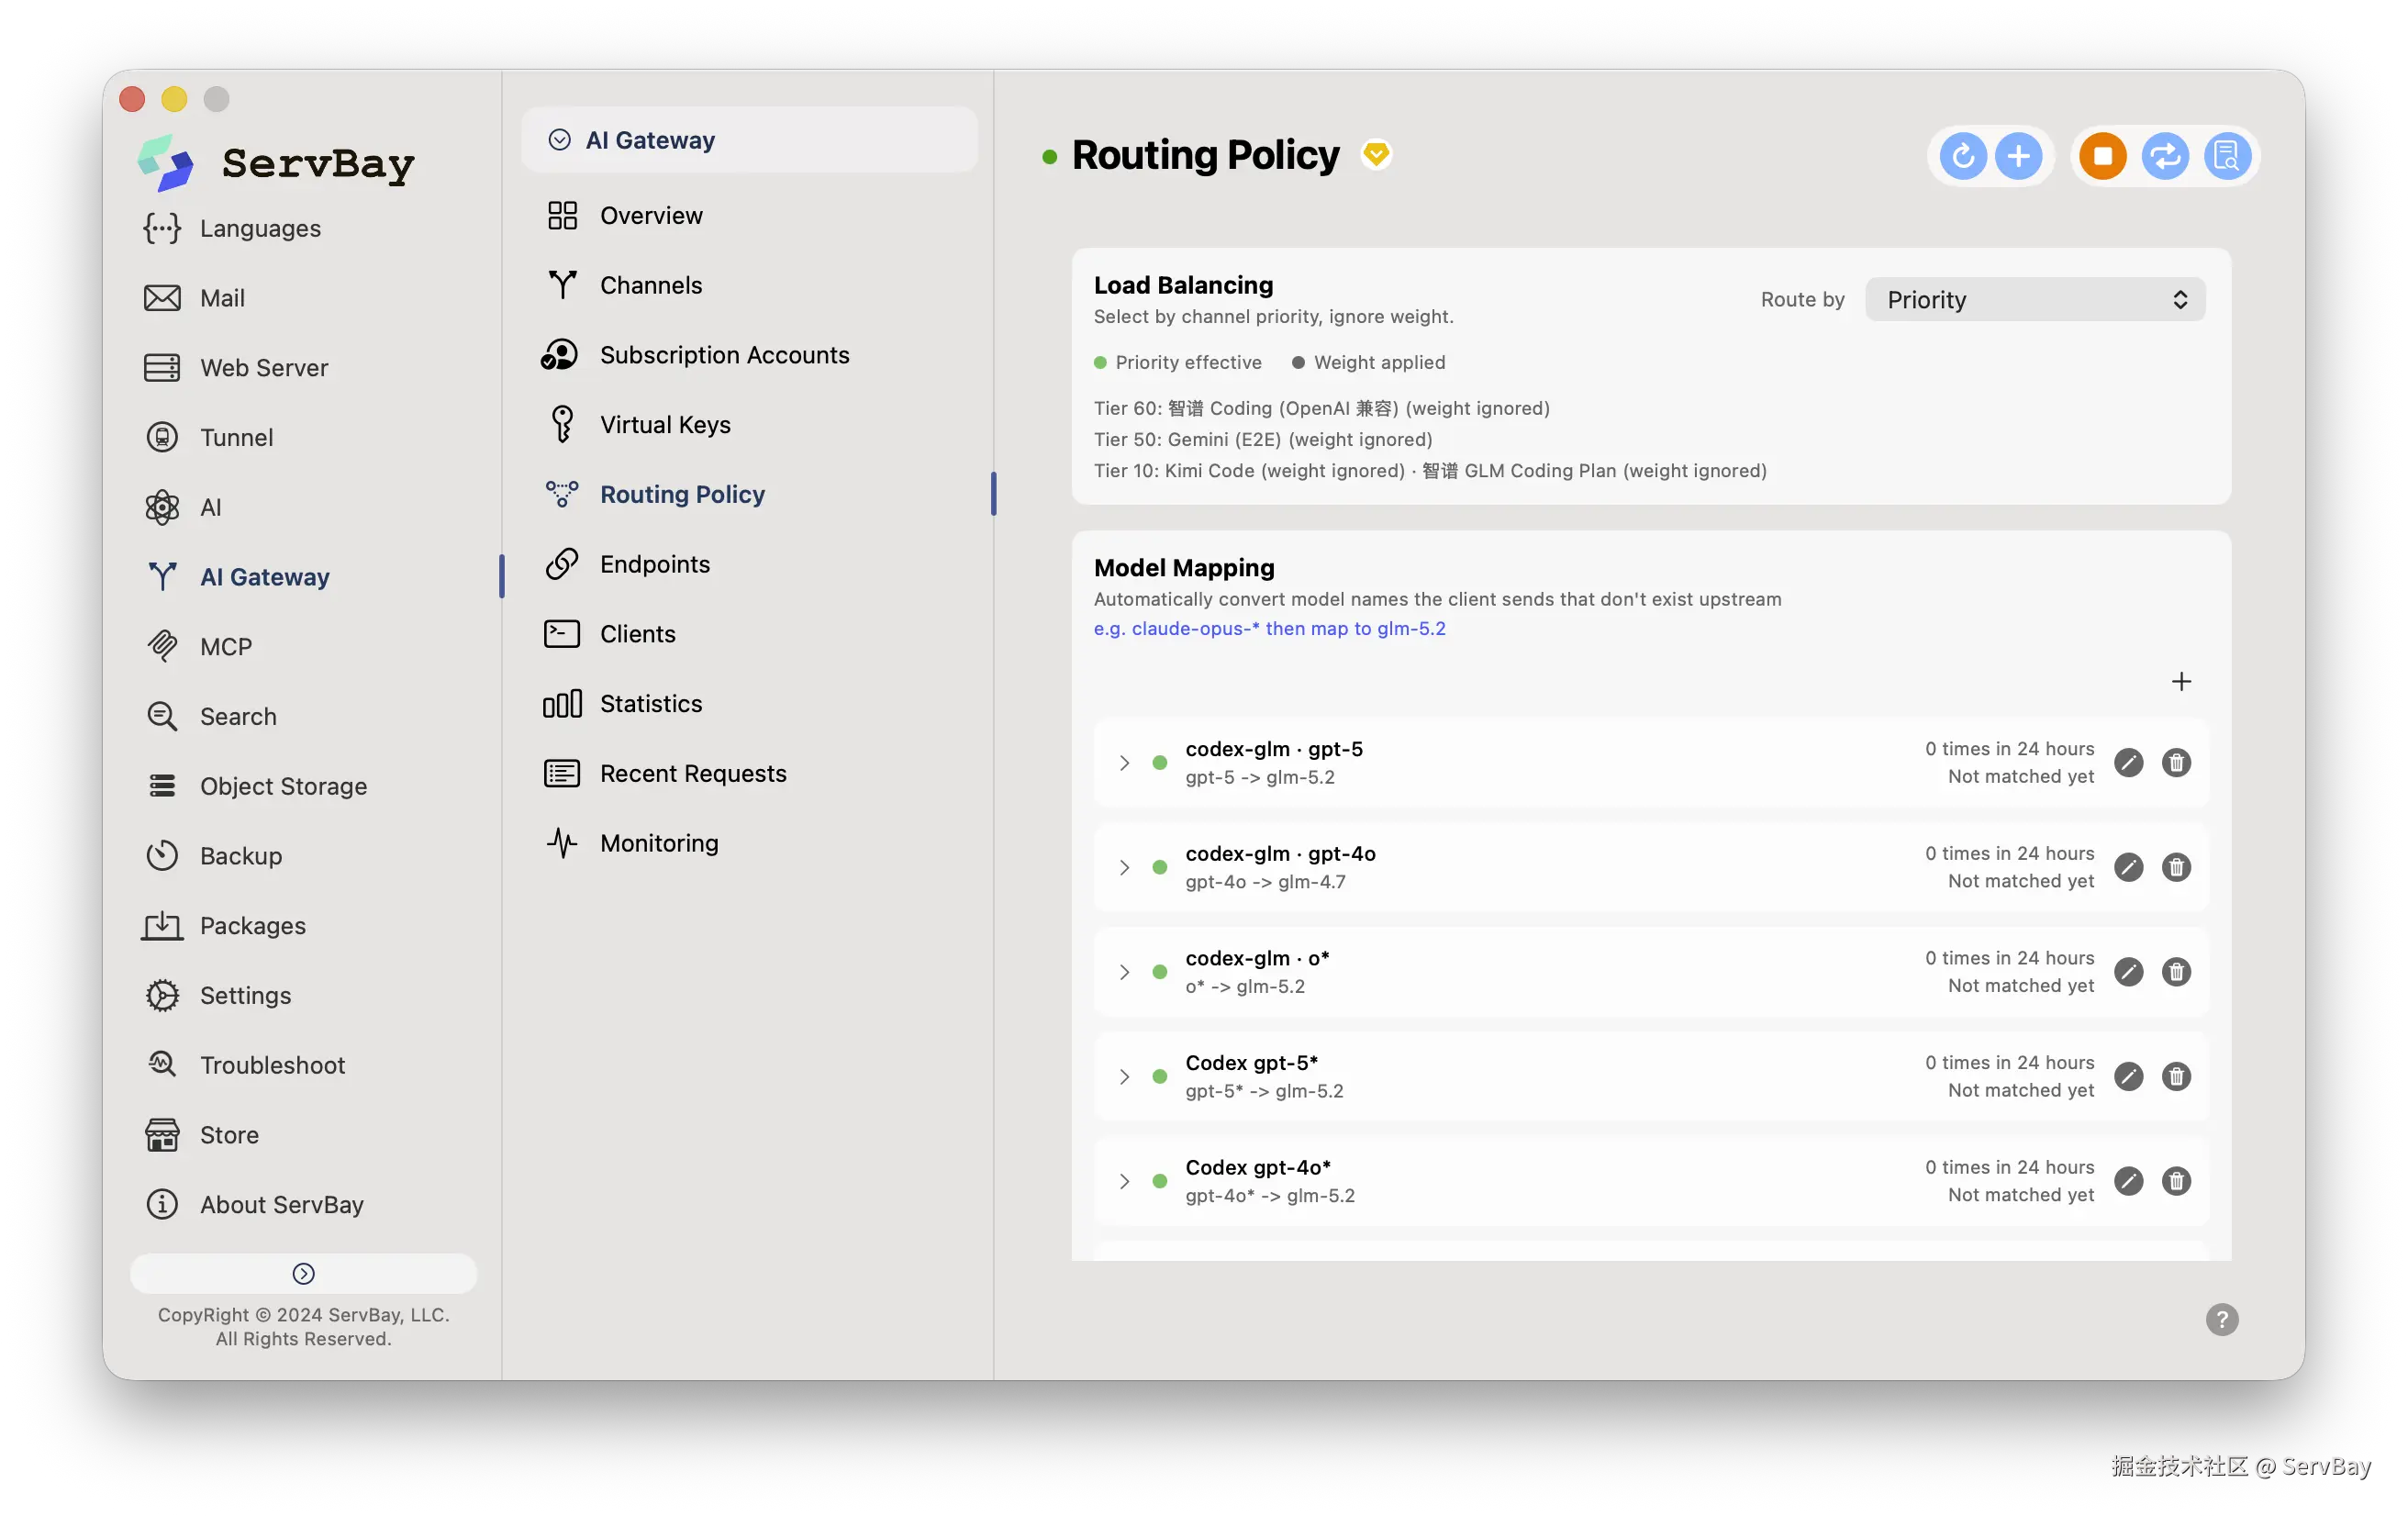
- 模型映射:可以把客户端请求的模型名映射到实际渠道的模型。例如把 claude-opus-5 映射为 glm-5.2,Claude Code 保持原有配置不变。
-
渠道路由:同一个模型有多个渠道时,可以选择固定、故障转移或均衡三种方式。固定始终使用一个渠道,故障转移按优先级依次尝试备用渠道,均衡则轮流分配。官网说明网关本身不替客户端选模型,模型由客户端在请求里指定,网关只负责把请求送到能提供该模型的渠道。
-
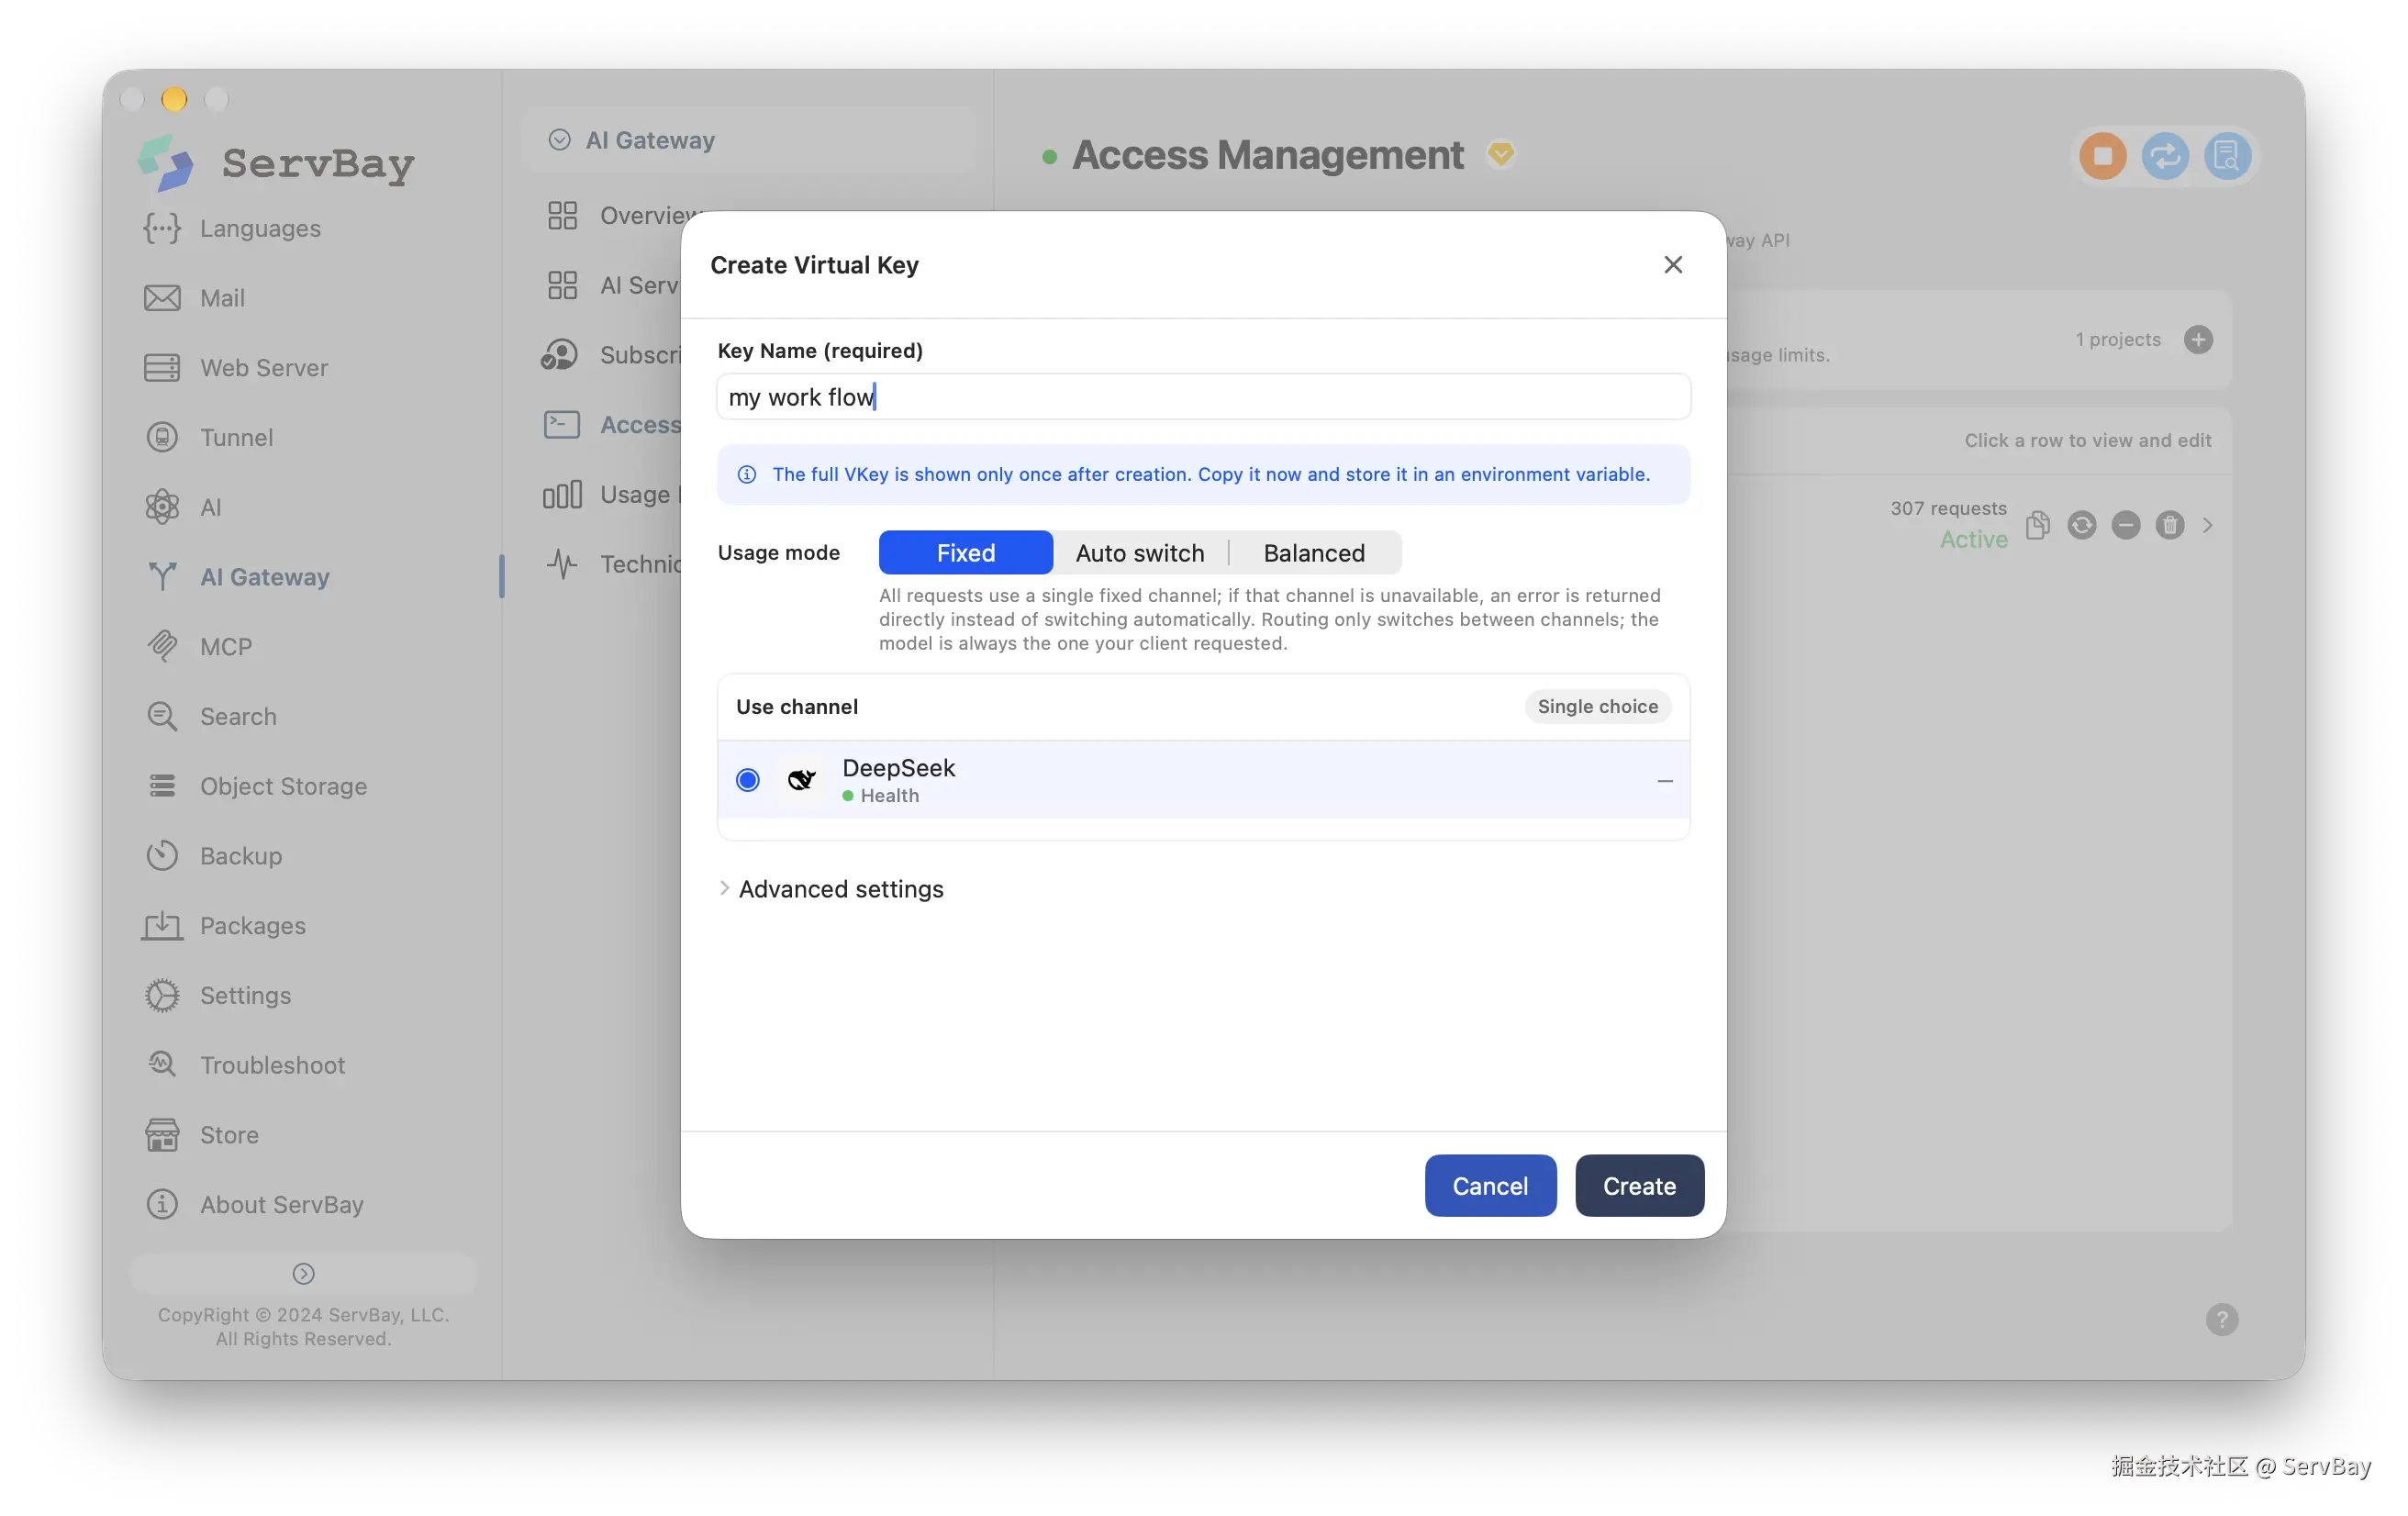
虚拟密钥:为每个项目或工具创建独立的虚拟密钥,可以单独撤销,真实密钥加密保存在本机,不会上传。
-
用量与成本统计:按项目查看调用量和花费,订阅账号还能查看多时间窗口的额度使用情况。
按官网的划分,统一入口、虚拟密钥、用量统计、自动故障转移和本机加密属于免费核心功能,多渠道负载均衡、预算上限、团队共享密钥等面向团队的功能需要升级。
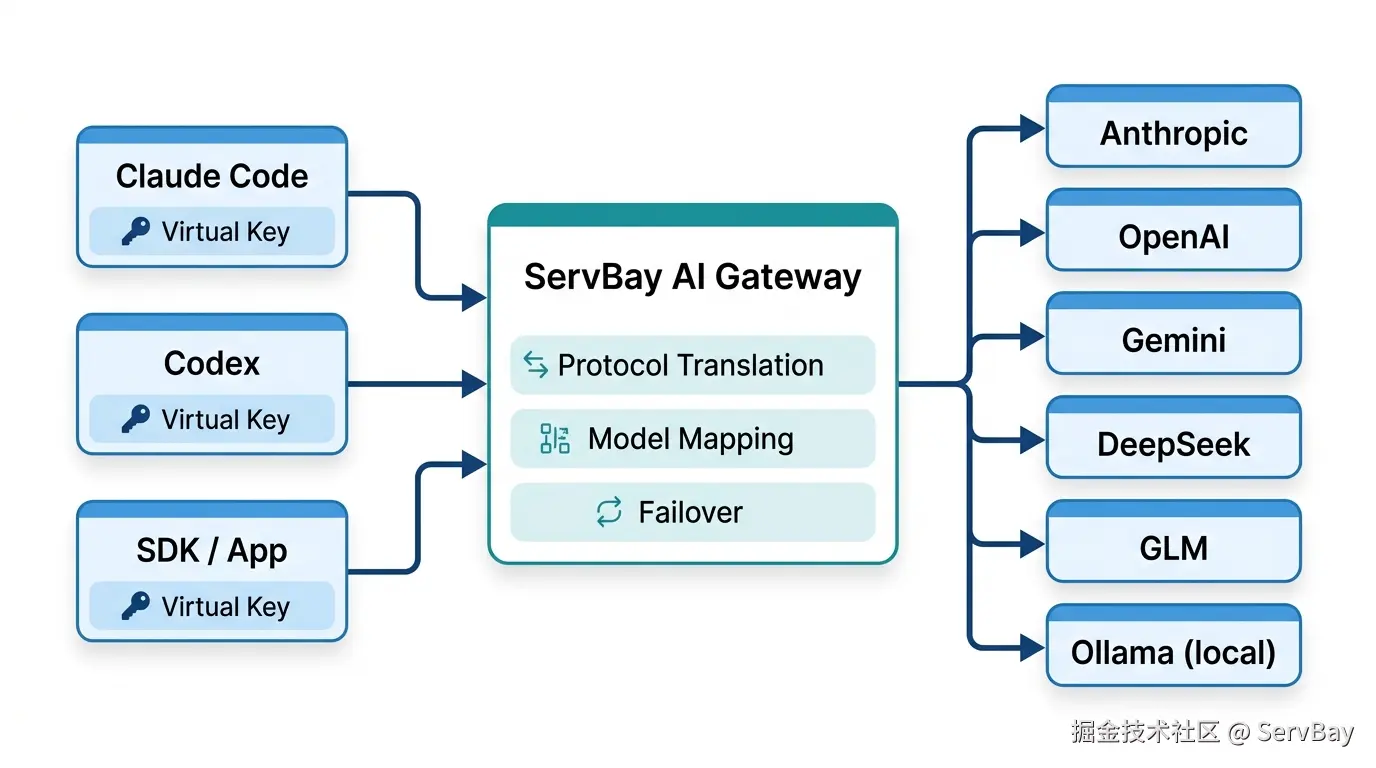
这样一来,多个项目的 Claude Code、Codex 和自己写的应用,都只和一个本地地址通信,模型和渠道的调整在网关里完成。
准备工作
1. 在网关中添加渠道和虚拟密钥
在 ServBay 的 AI 网关里依次完成三件事。
- 添加渠道。填入官方 API 密钥、订阅账号授权,或者中转站的地址和密钥。添加时网关会自动检测渠道支持的能力。
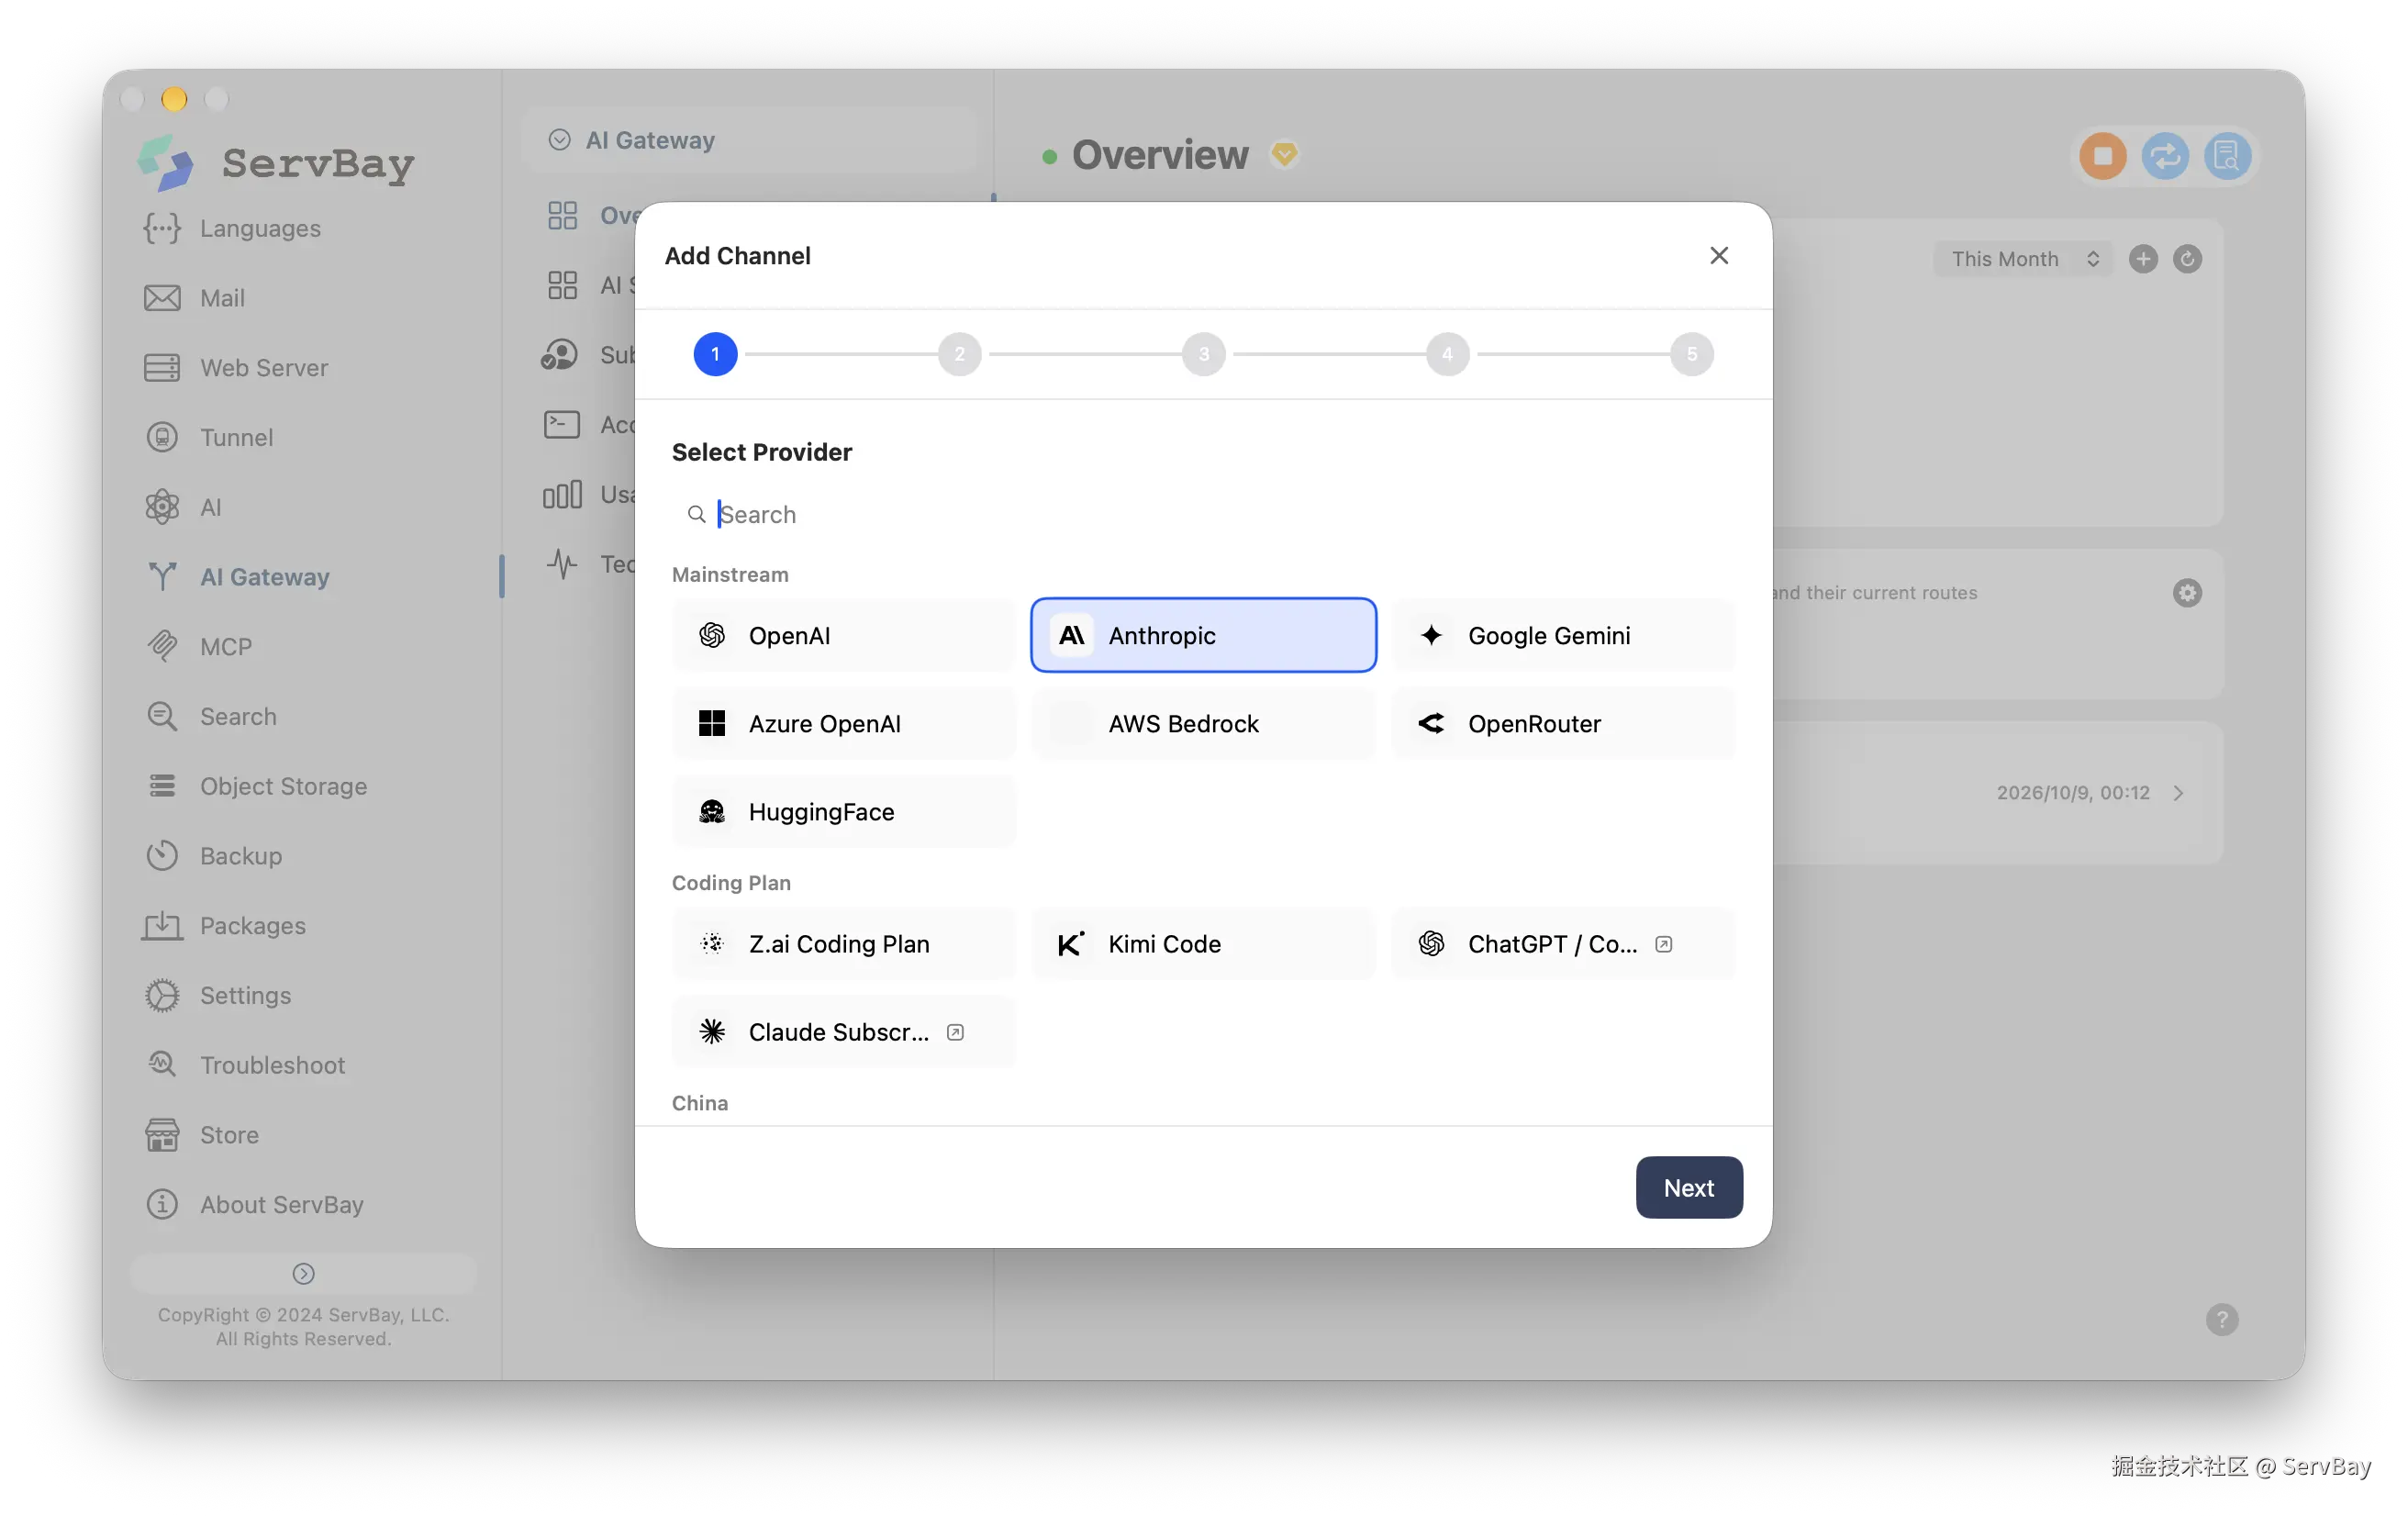
- 设置模型映射和渠道优先级。如果主力渠道额度紧张,可以把备用渠道设为故障转移。
- 为 TaskFlow 创建一个虚拟密钥,以后项目只使用这个密钥。
2. 让 Claude Code 连接网关
Claude Code 支持通过环境变量指定接口地址和认证令牌。安装并配置的命令如下,Node.js 需要 20 或更高版本。
bash
npm install -g @anthropic-ai/claude-code

export ANTHROPIC_BASE_URL="<ServBay 网关地址>"
export ANTHROPIC_AUTH_TOKEN="<TaskFlow 项目的虚拟密钥>"
网关地址和密钥以 ServBay 界面中显示的为准。也可以把这两项写入项目目录下 .claude/settings.json 的 env 字段,这样配置跟随项目,不污染全局环境。
json
{
  "env": {
    "ANTHROPIC_BASE_URL": "<ServBay 网关地址>",
    "ANTHROPIC_AUTH_TOKEN": "<TaskFlow 项目的虚拟密钥>"
  }
}
注意不要把含有密钥的 settings 文件提交到 Git,建议改用 .claude/settings.local.json,并加入 .gitignore。
配置完成后启动 claude,发一个简单问题,再回到网关的用量统计里确认出现了对应记录,说明链路已经打通。
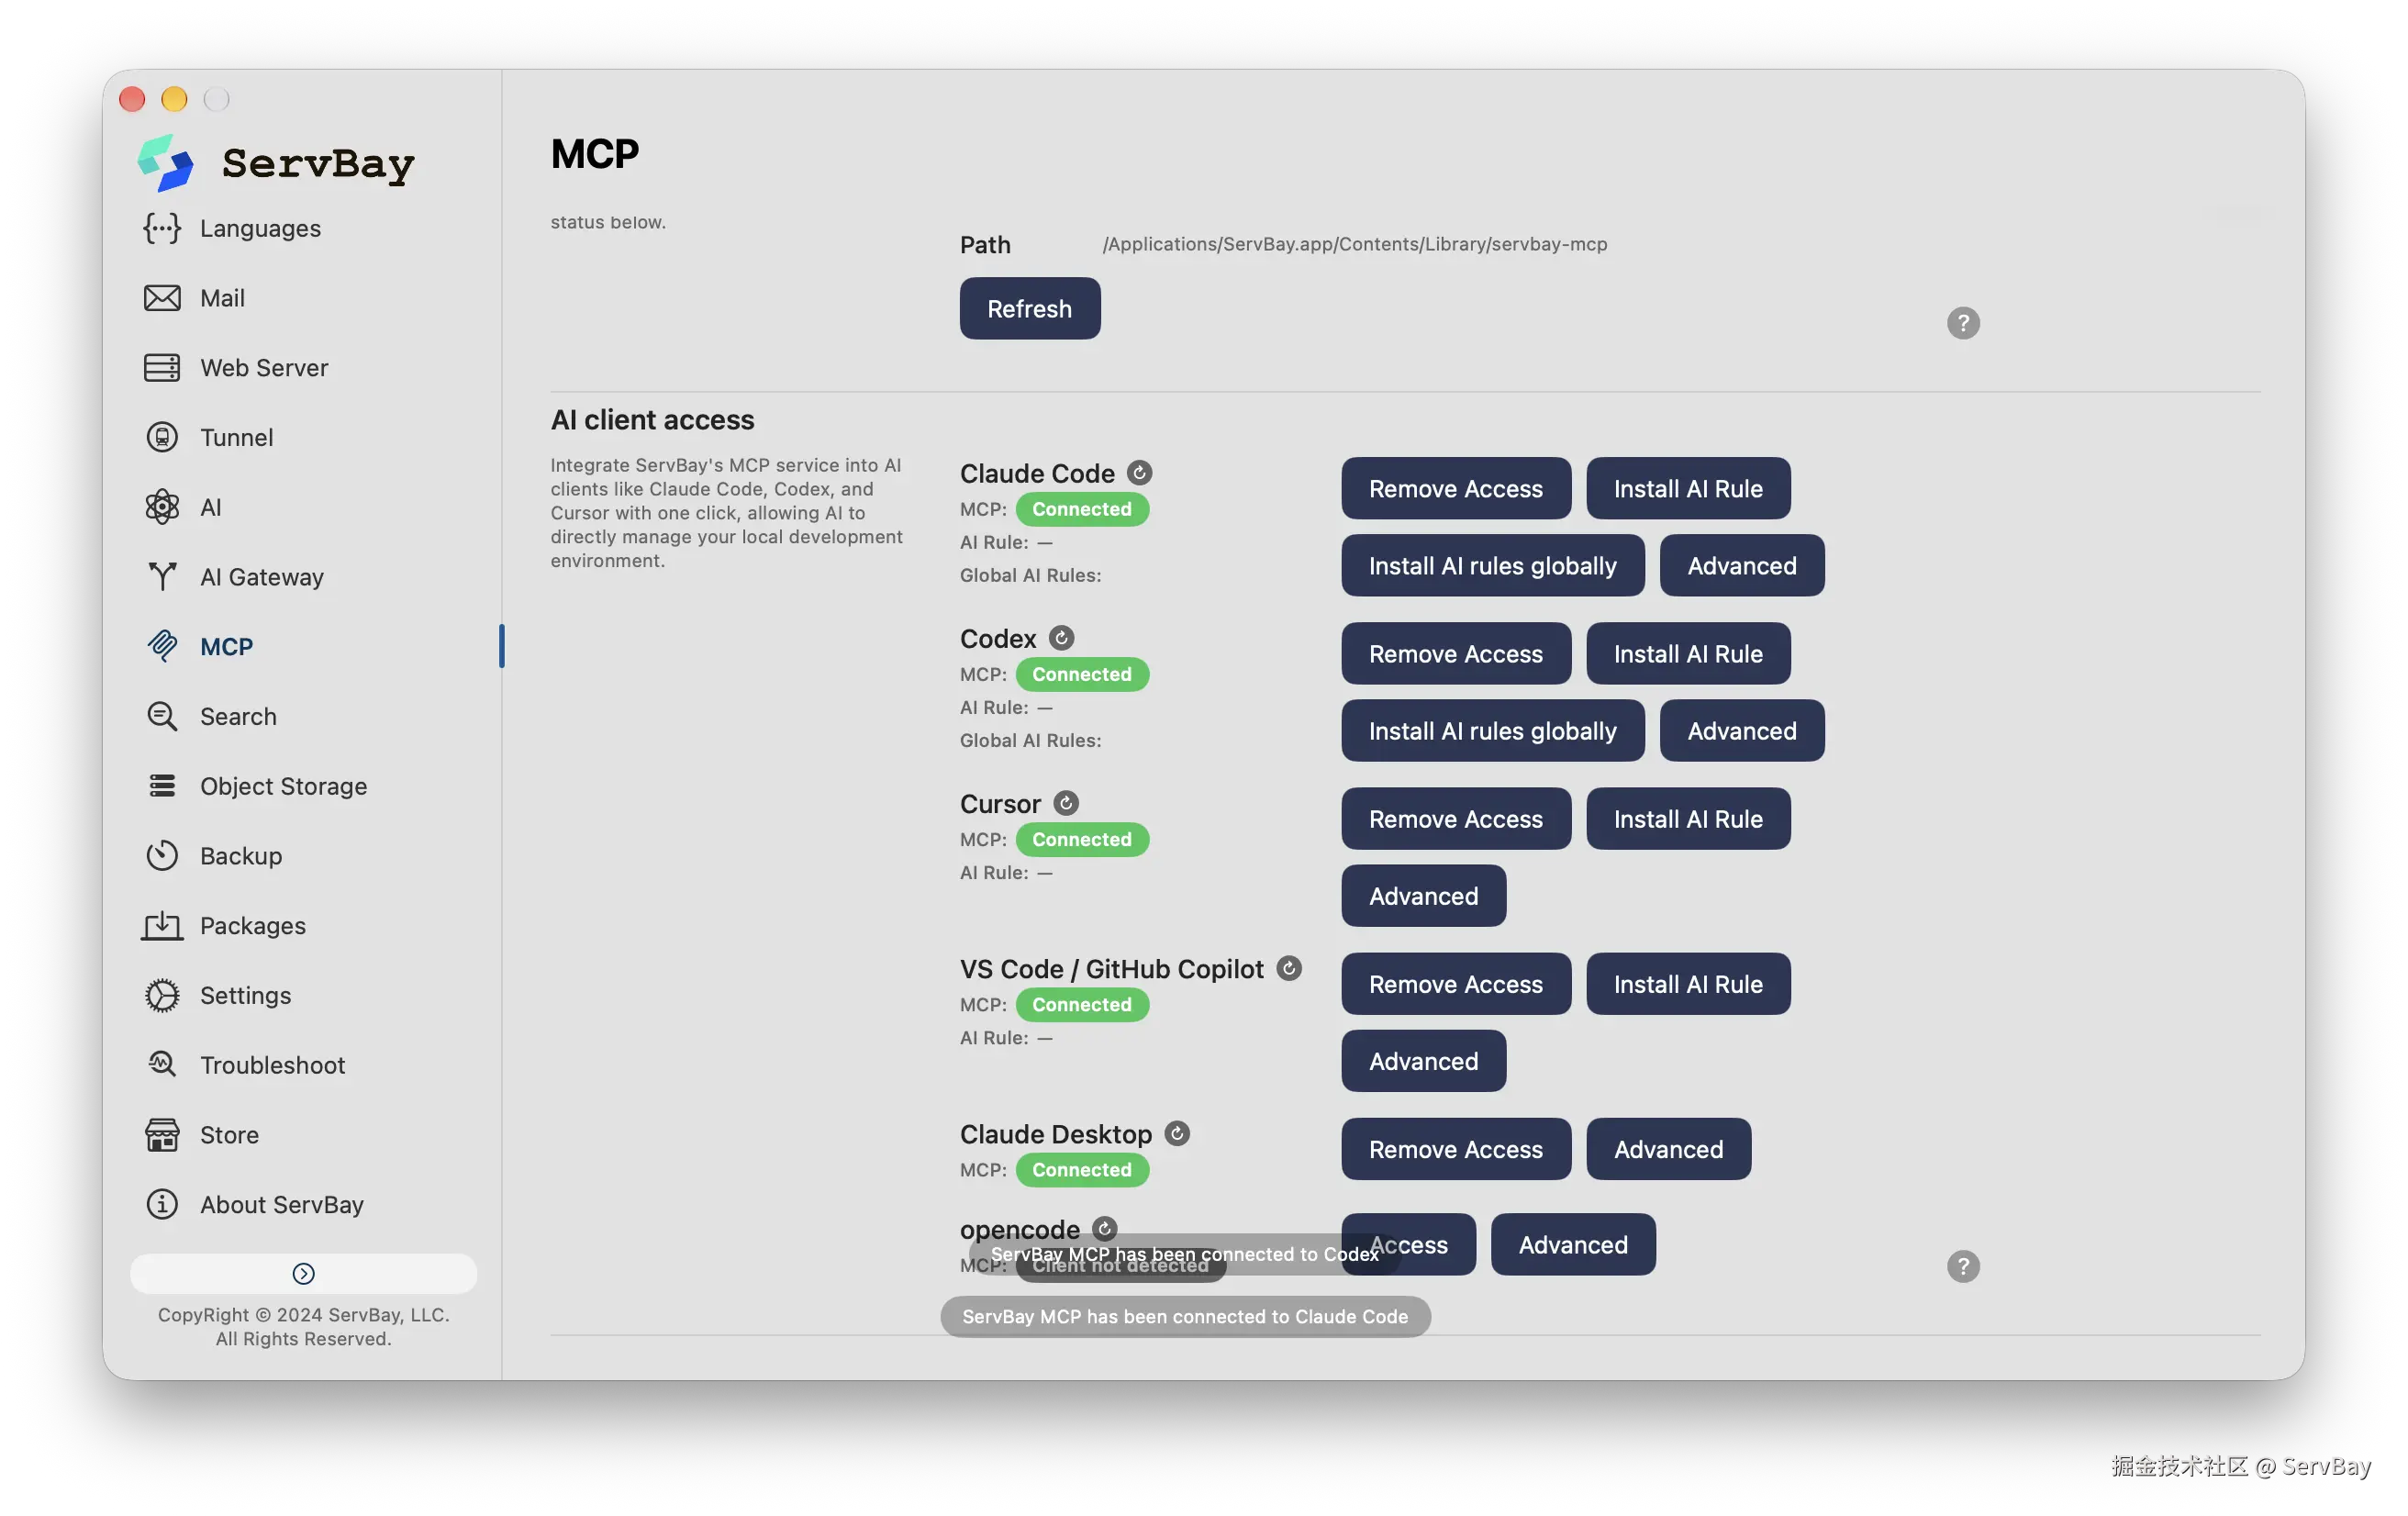
3. 接入 ServBay MCP 服务
ServBay 内置 MCP 服务,官网提供一键写入配置的入口,支持 Claude Code、Cursor、Codex 等客户端。接入后,Claude Code 可以用自然语言完成以下操作。
-
启动、停止服务,切换 Node.js 等语言版本
-
创建站点,配置本地域名和免费 SSL 证书
-
创建 PostgreSQL 数据库并管理账号
-
查看服务日志,检查端口冲突
官网说明,涉及重要变更的操作,Agent 会先请求确认,所有动作都能在 ServBay 界面中看到。
如何用AI Agent构建自己的项目:详细步骤
第一步,写需求简报
动手前先写一段简报,交给 Agent 作为所有后续对话的起点。TaskFlow 的简报如下。
plain
项目名称:TaskFlow
用途:面向小团队的任务管理应用
核心功能:项目管理、任务管理(标题、状态、优先级、截止日期)、任务列表筛选
暂不包含:用户登录、实时协作(第二阶段再做)
技术栈:Next.js App Router、TypeScript、Tailwind CSS、PostgreSQL
本地环境:ServBay 提供的 Node.js 和 PostgreSQL
简报里写明暂不做什么,同样重要,它能防止 Agent 自行扩展功能。
第二步,让 Agent 先规划
在 Claude Code 中按 Shift+Tab 切换到 Plan 模式,Agent 在这个模式下只分析和出方案,不修改文件。输入如下提示词。
plain
根据上面的简报,给出项目目录结构、数据库表设计和 API 接口清单。先不要写代码。拿到方案后重点看三件事。表设计是否覆盖所有核心功能,接口是否按资源划分,有没有出现简报里没有要求的内容。发现问题直接用口语指出,比如"tasks 表缺少截止日期",让 Agent 修改方案,确认后再进入实现。
第三步,初始化项目与数据库
1. 创建项目
bash
npx create-next-app@latest taskflow --typescript --tailwind --eslint --app
cd taskflow
npm install pg zod
npm install -D @types/pg
这一步也可以直接交给 Claude Code,上面只是它会执行的命令。
2. 用 MCP 创建数据库
对 Claude Code 说:
plain
通过 ServBay 创建一个名为 taskflow 的 PostgreSQL 数据库,告诉我连接信息。拿到连接信息后,写入项目根目录的 .env.local,并确认该文件已被 .gitignore 忽略。
plain
DATABASE_URL=postgresql://<用户名>:<密码>@127.0.0.1:5432/taskflow3. 建表
让 Agent 把结构保存为 db/schema.sql,后续对话都可以引用这个文件。对应的内容如下。
sql
CREATE TABLE projects (
  id uuid PRIMARY KEY DEFAULT gen_random_uuid(),
  name text NOT NULL,
  color text NOT NULL DEFAULT '#3b82f6',
  created_at timestamptz NOT NULL DEFAULT now()
);

CREATE TABLE tasks (
  id uuid PRIMARY KEY DEFAULT gen_random_uuid(),
  project_id uuid NOT NULL REFERENCES projects(id) ON DELETE CASCADE,
  title text NOT NULL,
  status text NOT NULL DEFAULT 'todo' CHECK (status IN ('todo', 'doing', 'done')),
  priority smallint NOT NULL DEFAULT 2 CHECK (priority BETWEEN 1 AND 3),
  due_date date,
  created_at timestamptz NOT NULL DEFAULT now()
);

CREATE INDEX idx_tasks_project_status ON tasks (project_id, status);
gen_random_uuid() 是 PostgreSQL 13 及以上版本的内置函数。用 psql "$DATABASE_URL" -f db/schema.sql 执行,或者让 Agent 通过 MCP 直接执行。
4. 写入 CLAUDE.md
在项目根目录创建 CLAUDE.md,这是 Claude Code 每次会话都会读取的项目说明,建议写入以下内容。
markdown
# TaskFlow

- 技术栈:Next.js App Router、TypeScript、PostgreSQL(使用 pg 直连)
- 数据库结构见 db/schema.sql,修改表结构后同步更新该文件
- 每次改动后执行 npm run build,构建通过才算完成
- API 入参统一用 zod 校验,SQL 一律使用参数化查询
- 不要提交 .env.local
第四步,按功能逐个开发
数据库连接
让 Agent 先实现数据库连接模块。开发模式下热更新会反复加载模块,需要把连接池挂在全局对象上,避免连接数暴涨。
typescript
// lib/db.ts
import { Pool } from "pg";

const globalForPg = globalThis as unknown as { pool?: Pool };

export const pool =
  globalForPg.pool ?? new Pool({ connectionString: process.env.DATABASE_URL });

if (process.env.NODE_ENV !== "production") {
  globalForPg.pool = pool;
}
项目接口
提示词写具体一些,Agent 的自行假设就会少。
plain
参考 db/schema.sql,实现 /api/projects 的 GET 和 POST。
POST 需要校验 name(1 到 80 个字符)和可选的 color(十六进制色值)。
完成后给出 curl 命令,依次测试创建和查询。
Agent 生成的代码应该与下面的实现等价。
typescript
// app/api/projects/route.ts
import { NextResponse } from "next/server";
import { z } from "zod";
import { pool } from "@/lib/db";

const createSchema = z.object({
  name: z.string().trim().min(1).max(80),
  color: z
    .string()
    .regex(/^#[0-9a-fA-F]{6}$/)
    .optional(),
});

export async function GET() {
  const { rows } = await pool.query(
    "SELECT id, name, color, created_at FROM projects ORDER BY created_at DESC"
  );
  return NextResponse.json(rows);
}

export async function POST(request: Request) {
  const parsed = createSchema.safeParse(await request.json().catch(() => null));
  if (!parsed.success) {
    return NextResponse.json(
      { error: "invalid input", issues: parsed.error.issues },
      { status: 400 }
    );
  }

  const { name, color } = parsed.data;
  const { rows } = await pool.query(
    `INSERT INTO projects (name, color)
     VALUES ($1, COALESCE($2, '#3b82f6'))
     RETURNING id, name, color, created_at`,
    [name, color ?? null]
  );
  return NextResponse.json(rows[0], { status: 201 });
}
启动开发服务后,用 curl 验证。
bash
npm run dev

curl -X POST http://localhost:3000/api/projects \
  -H "Content-Type: application/json" \
  -d '{"name":"官网改版"}'

curl http://localhost:3000/api/projects
第一条应返回 201 和新建的项目,第二条应返回包含该项目的数组。传入空名称时应返回 400。
后续功能
任务接口、项目页面、任务看板都按同一个节奏推进,每个功能一轮。
-
用新的会话描述一个功能,范围控制在一个页面或一组接口。
-
阅读 Agent 的改动,重点看校验、错误处理和 SQL 是否参数化。
-
要求 Agent 为这个功能写测试并运行,执行
npm run build。 -
通过后提交 Git,再开始下一个功能。
用 Git 管理检查点比依赖对话回退更可控,需要撤销时一条命令即可。
界面类需求用使用者的视角描述。比如写"项目页用卡片展示,每张卡片显示颜色标记和创建日期,右上角有新建按钮",不要写"用 useState 实现一个组件"。生成后在浏览器里实际点一遍,发现问题再口语化地提出修改。
第五步,调试与安全检查
出错时给 Agent 足够的线索,只说"坏了,修一下"效果很差。
-
贴出完整的报错信息
-
说明出错前正在做什么
-
要求它先解释原因,再修复
只要求修复的话,同类问题会反复出现。要求解释原因,可以让开发者逐渐了解自己的代码库。
安全方面,让 Agent 针对当前代码做一轮检查,范围包括输入校验、SQL 注入、密钥是否进入版本库、接口是否缺少限流。需要强调,AI 生成的代码必须经过人工审查,尤其是涉及权限、支付和数据删除的部分。
进阶,为应用加入 Agent 能力
前面讲的是用 Agent 开发应用。应用本身也可以内置 Agent,例如让用户直接问"这周有哪些高优先级任务没完成"。这类 Agent 的基本机制是工具调用。模型判断是否需要调用工具,应用执行工具并把结果回传,模型再据此作答。
设计工具时有三个原则。
-
描述清晰,让模型明确知道什么时候该用
-
职责单一,工具之间尽量不重叠
-
数量克制,工具过多会让模型选择变得困难
通过 ServBay 网关接入模型有一个实际好处。应用端只需用 OpenAI 兼容的 SDK 指向网关地址,底层用 Claude、GLM 还是别的模型,在网关里调整即可,代码不用改动。
typescript
// lib/agent.ts
import OpenAI from "openai";
import { pool } from "@/lib/db";

const client = new OpenAI({
  baseURL: process.env.AI_GATEWAY_URL,
  apiKey: process.env.AI_GATEWAY_KEY,
});

const tools: OpenAI.Chat.Completions.ChatCompletionTool[] = [
  {
    type: "function",
    function: {
      name: "list_tasks",
      description: "按状态查询任务列表,状态可选 todo、doing、done,不传则返回全部",
      parameters: {
        type: "object",
        properties: {
          status: { type: "string", enum: ["todo", "doing", "done"] },
        },
        additionalProperties: false,
      },
    },
  },
];

async function listTasks(status?: string) {
  const { rows } = status
    ? await pool.query(
        "SELECT title, status, priority, due_date FROM tasks WHERE status = $1 ORDER BY priority, due_date",
        [status]
      )
    : await pool.query(
        "SELECT title, status, priority, due_date FROM tasks ORDER BY priority, due_date"
      );
  return rows;
}

export async function askAgent(question: string) {
  const messages: OpenAI.Chat.Completions.ChatCompletionMessageParam[] = [
    { role: "system", content: "你是 TaskFlow 的任务助手,只依据工具返回的数据回答。" },
    { role: "user", content: question },
  ];

  for (let round = 0; round < 5; round++) {
    const res = await client.chat.completions.create({
      model: process.env.AGENT_MODEL!,
      messages,
      tools,
    });
    const message = res.choices[0].message;
    messages.push(message);

    if (!message.tool_calls?.length) {
      return message.content;
    }

    for (const call of message.tool_calls) {
      if (call.type !== "function") continue;
      const args = JSON.parse(call.function.arguments || "{}");
      const result =
        call.function.name === "list_tasks"
          ? await listTasks(args.status)
          : { error: "unknown tool" };
      messages.push({
        role: "tool",
        tool_call_id: call.id,
        content: JSON.stringify(result),
      });
    }
  }
  return "未能在限定轮数内完成,请换个问法。";
}
对应的环境变量如下,模型名填写网关中已配置、可调用的名称。
bash
AI_GATEWAY_URL=<ServBay 网关的 OpenAI 兼容地址>
AI_GATEWAY_KEY=<项目虚拟密钥>
AGENT_MODEL=<网关中可用的模型名>
代码里限制了最多 5 轮循环,避免模型反复调用工具造成无限循环。工具内部使用参数化查询,模型传入的参数不会拼进 SQL。需要多个 Agent 协作、保存会话上下文时,可以进一步使用 OpenAI Agents SDK、LangGraph、CrewAI 这类框架。
第六步,部署上线
部署前先在本地跑一遍生产构建。
bash
npm run build
npm run start
Vercel 是 Next.js 的常见部署选择,Railway 等平台也可以。基本步骤是把代码推到 GitHub,在平台创建项目并关联仓库,配置与 .env.local 对应的环境变量,然后触发部署。线上数据库需要使用托管的 PostgreSQL,本地的连接信息不能直接带上去。
部署失败的原因大多是环境变量缺失或构建报错,把报错日志贴给 Claude Code,通常能快速定位。建议在项目早期就完成一次部署,问题越早暴露,排查越容易。部署后按清单检查一遍,包括首页能否打开、接口能否读写、控制台有无报错。
实践经验总结
-
任务切小。因为「给任务卡片加删除按钮」比「把任务模块做完」要稳定得多。
-
先规划后编码。方案阶段的修改成本远低于代码阶段。
-
持续验证。每个功能都跑测试和构建,不要攒到最后。
-
文档同步。数据库结构和约定变化后,要求 Agent 更新
db/schema.sql和CLAUDE.md。 -
按项目隔离密钥。每个项目使用独立的虚拟密钥,便于统计成本,泄露时也只需撤销一把。
-
保留人工审查。权限、支付、数据删除等逻辑必须亲自核对。
常见问题
AI Agent 能独立完成一个全栈应用吗?
可以完成大部分实现工作,但需求定义、架构取舍和上线前的验收仍需要人来做。需求越具体,Agent 的产出越接近预期。
不会编程能用 AI Agent 做应用吗?
可以做出原型。但出现报错、安全问题或性能问题时,需要有基本的判断能力,否则很难评估结果是否可靠。
Claude Code、Cursor 和 Copilot 怎么选?
三者的差别主要在使用形态。Claude Code 以命令行为主,适合整体任务和项目级改动,Cursor 是集成的编辑器,Copilot 与 GitHub 生态结合紧密。可以根据已有的工作习惯选择,通过 ServBay 的 MCP 服务,这几类客户端都能接入本地环境。
使用 AI 网关会不会泄露密钥?
按 ServBay 官网说明,真实密钥加密保存在本机,工具端只拿到虚拟密钥,虚拟密钥可随时撤销。仍然建议不要把任何密钥提交到代码仓库。
应用内的 AI Agent 和编码 Agent 有什么区别?
编码 Agent 服务于开发者,产出的是代码。应用内的 Agent 服务于最终用户,通过工具查询或操作业务数据。两者都可以通过同一个网关调用模型。
结语
用 AI Agent 构建全栈应用的关键是流程,而不是某一个工具。先写清简报,让 Agent 规划,按功能小步实现,每一步验证,再部署上线。ServBay 在其中承担两个角色,一是通过 MCP 提供本地运行环境,二是通过 AI 网关统一管理模型渠道、密钥和用量。两者配合,开发者可以把精力放在需求和验收上,把环境配置与模型切换的重复工作交给底座。