一、为什么技术方案评审总卡在"画图"这一步
先还原一个场景,你大概率遇到过:
方案文档写完了,评审前一天晚上开始画架构图。拖 draw.io 的方块拖到凌晨,第二天评审会上被问"订单服务和库存服务为什么是同步调用?"------你才发现图上的箭头和文档里写的"必须异步解耦"对不上。
这类问题的本质不是"不会画图",而是三件事:
- 图和文字是两份东西。文档改了,图没跟着改,评审时必然对不上。
- 画图的时间成本被严重低估。一张像样的部署架构图,熟练的人也要 40 分钟到 2 小时。
- 架构约束最难画对。谁调谁、同步还是异步、哪些服务禁止直连------这些是评审真正会追问的部分,恰恰也是最容易画错的部分。
所以这次实测我关心的问题很具体:把一段真实的技术方案文字喂给工具,它吐出来的图能不能直接拿去评审?
如果不能,差距在哪?
二、评测设计
2.1 测试素材(可复现)
我准备了一段真实的方案文字,包含架构分层、服务拆分、数据层、部署运维、以及三条硬性约束。全文如下,你可以直接复制去复现:
【订单中心服务化改造技术方案(节选)】 一、总体架构 整体采用微服务架构。接入层由 SLB 做负载均衡,流量进入 API 网关(Kong), 网关统一负责鉴权、限流与路由转发。业务层拆分为订单服务、库存服务、支付服务、 用户服务四个微服务,全部注册到 Nacos 注册中心,服务间通过 Dubbo RPC 同步调用, 跨服务的异步流程通过 RocketMQ 消息解耦。 二、数据层 数据层采用 MySQL 主从集群(一主两从),热点数据缓存到 Redis Cluster(三主三从), 订单明细归档到 Elasticsearch 提供检索能力。 三、部署与运维 基础设施运行于 Kubernetes 集群,划分 prod 与 staging 两个命名空间实现环境隔离。 监控方面通过 Prometheus 采集指标、Grafana 展示告警;日志经 Filebeat 采集进入 ELK 栈。 四、关键约束 - 订单服务与库存服务之间必须通过消息队列异步解耦,禁止直接同步调用 - 支付服务需独立部署,不与其他业务服务共享 Pod - 所有服务必须注册到 Nacos,禁止硬编码服务地址这段素材是我特意设计的,有几个"考点":
| 考点 | 内容 | 为什么是考点 |
|---|---|---|
| 分层结构 | 接入层 / 业务层 / 数据层 / 运维 | 看图有没有分-group |
| 元素数量 | 约 14 个组件 | 会不会漏节点 |
| 混合调用 | Dubbo 同步 + RocketMQ 异步 | 会不会把两种线画成一样 |
| 负面约束 | 订单↔库存禁止同步调用 | AI 最容易丢的一类 |
| 部署约束 | 支付服务独立 Pod、prod/staging 隔离 | 部署图专属信息 |
特别注意第四条 :这是一条"禁止"型约束。人会注意到,但 AI 极容易把它画成一条普通的调用线------这一条将直接决定实测结论。
2.2 参测对象
选工具的标准是:它得真的能"吃文字、吐图",而不是换个地方继续手拖方块。按这个标准筛下来,市面上称得上技术方案图工具的主要就这四类:
| 编号 | 工具 | 范式 | 为什么选它 |
|---|---|---|---|
| A | PicDoc | AI 文字直出 | 中文场景,生成后可编辑 |
| B | Napkin AI | AI 文字直出 | 海外主流,免费额度大 |
| C | Mermaid + LLM | 代码生成 | 开发者最常用路线 |
| D | PlantUML | 代码生成 | 部署图/组件图专业 |
| --- | 手工 Mermaid | 基线 | 作为"满分参照" |
选 C 和 D 进来,是因为纯 AI 工具缺一个对照组。开发者圈子里真正跑通的方案,大多是"让 LLM 生成 Mermaid 代码",而不是"让 AI 直接出图"------这两条路线的差距,实测完会非常明显。
2.3 评分维度(5 分制)
不搞主观印象分,拆成 6 个可核查的维度:
| 维度 | 考察什么 |
|---|---|
| 结构还原度 | 分层/分组是否正确,有没有把接入层、业务层、数据层分开 |
| 元素完整性 | 14 个组件漏了几个 |
| 关系正确性 | 箭头方向、同步/异步区分对不对 |
| 约束还原度 | "禁止同步调用""独立 Pod"这类约束有没有体现 |
| 可编辑性 | 生成后能不能改,改一个标签要多久 |
| 工程化能力 | 能否入 Git、进 CI、导矢量、随文档自动重生成 |
三、基线先立住:手工图长什么样
要评价 AI 画得好不好,得先知道"好"长什么样。下面是手工 Mermaid 基线,已通过语法校验。
3.1 Mermaid 基线
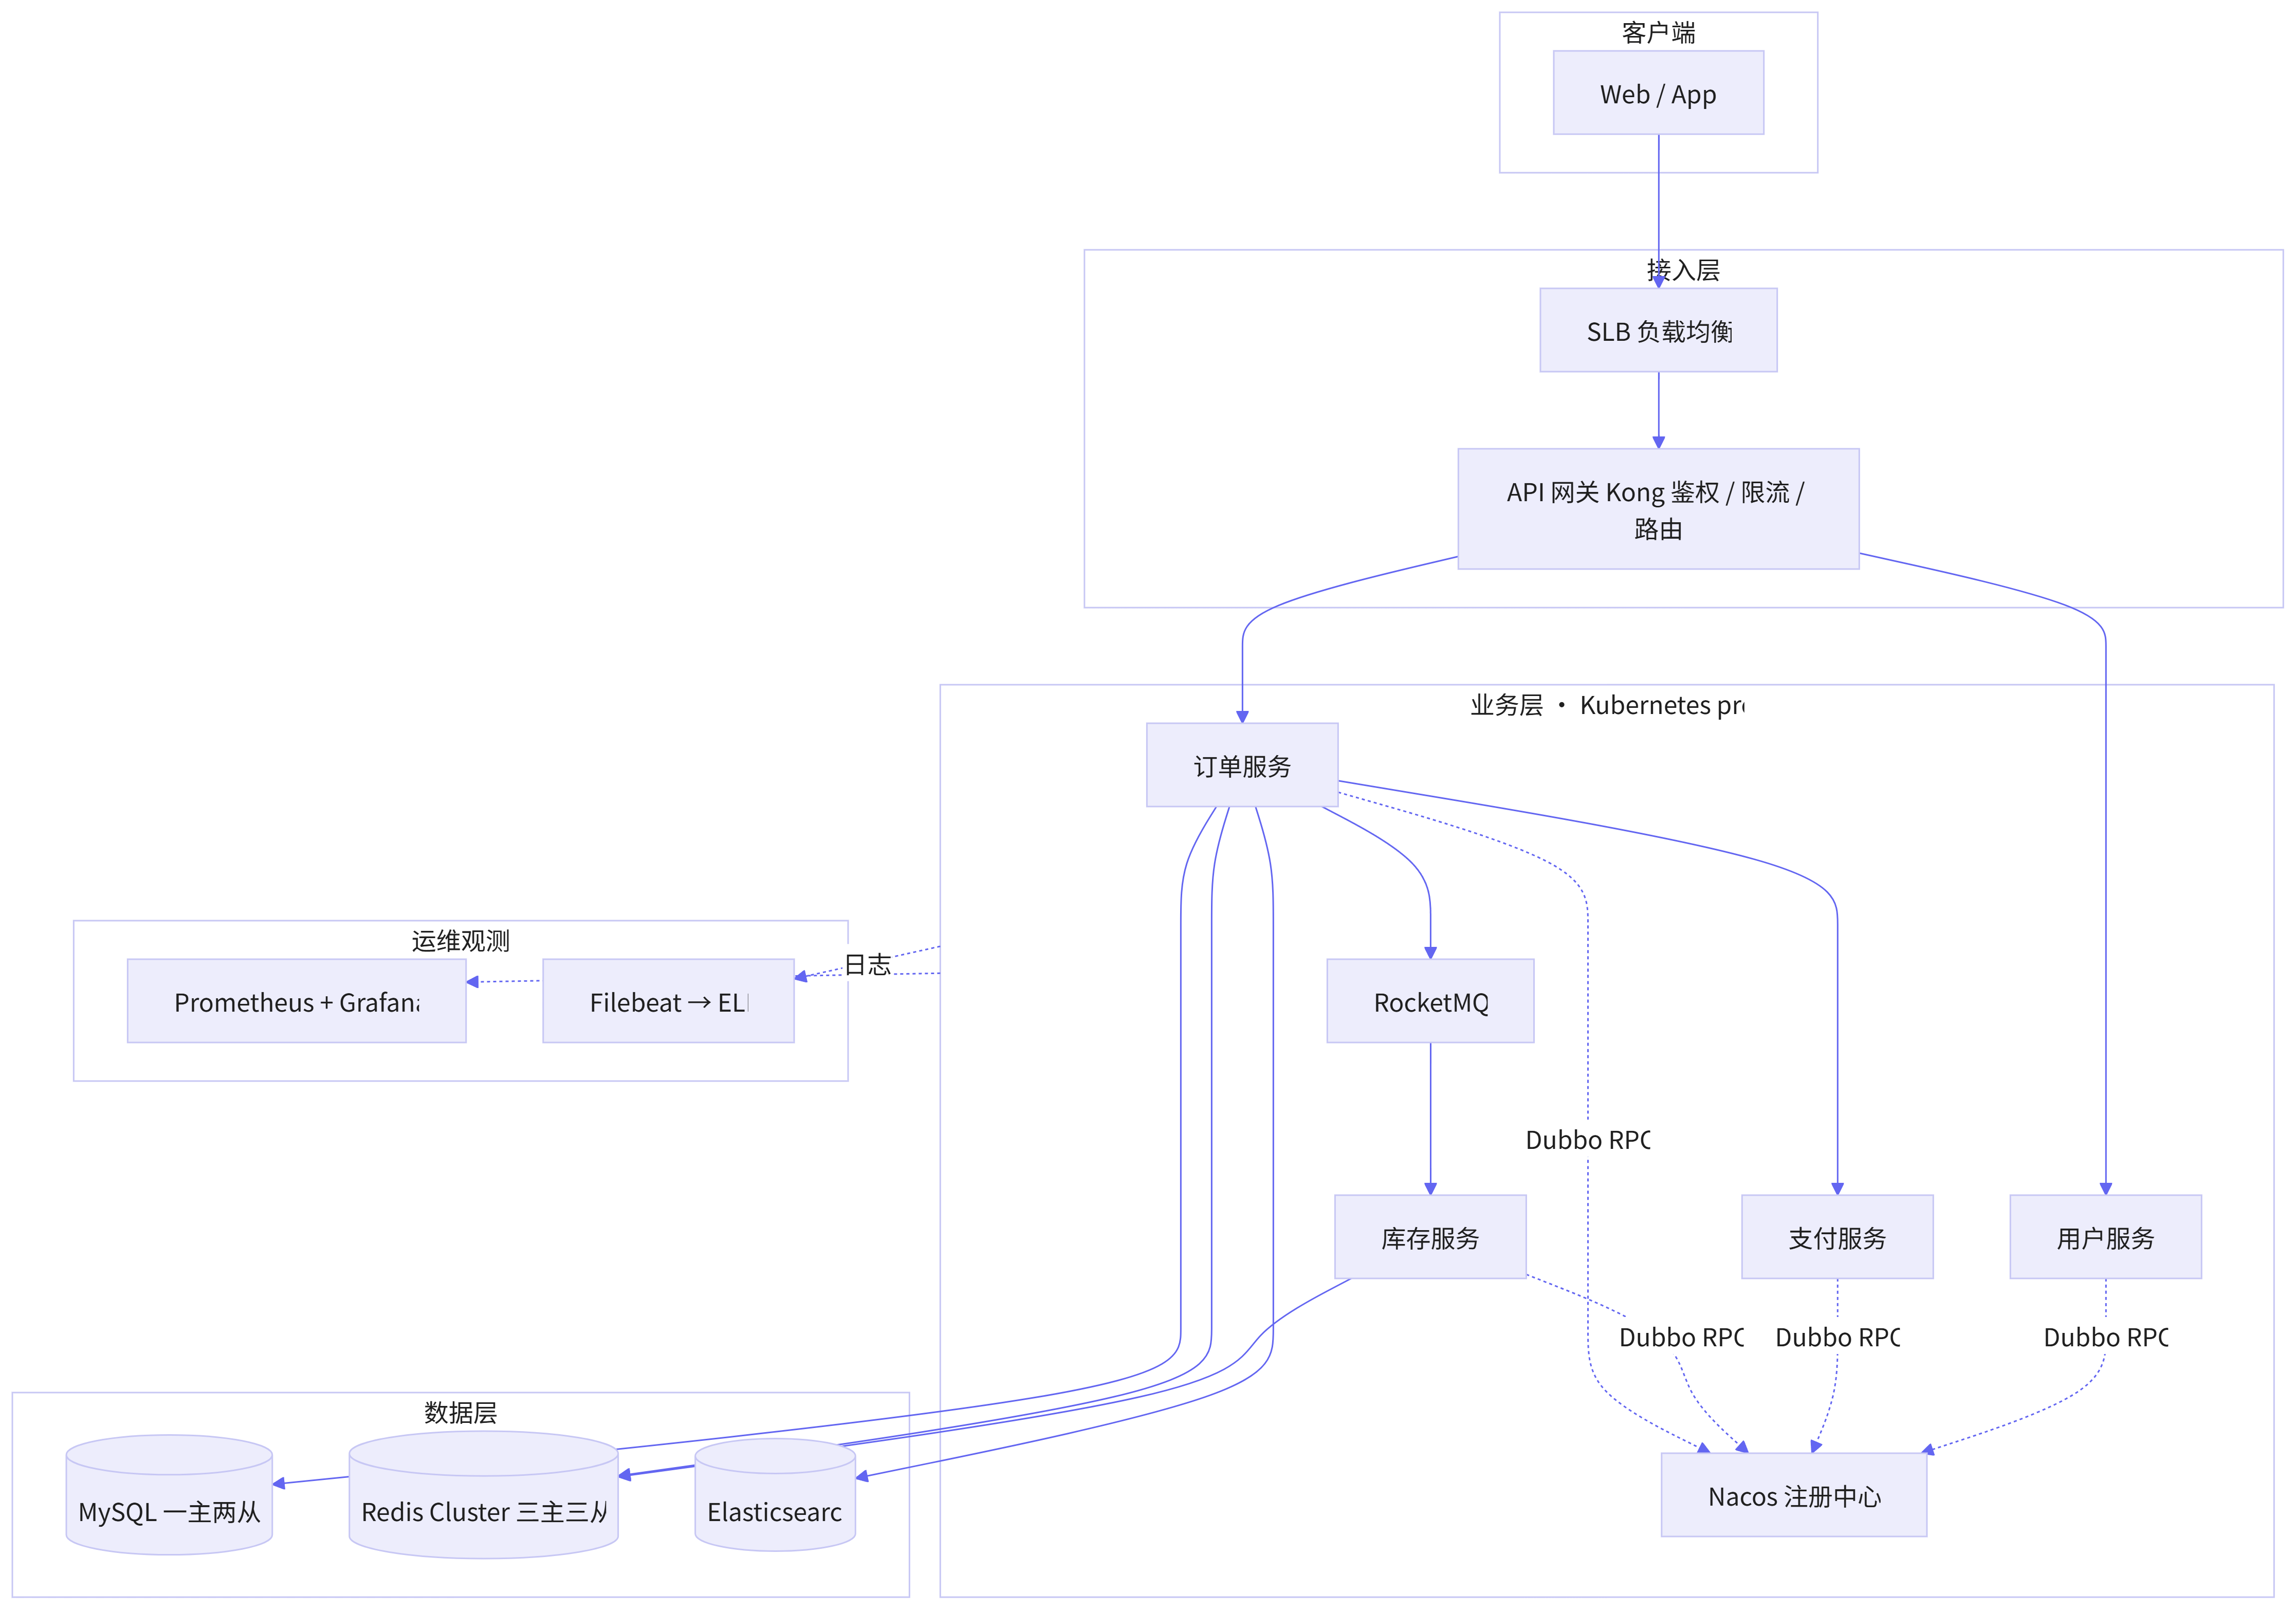
这张图里有两个关键点,是 AI 普遍做不到的:
O --> MQ --> S,没有O --> S。订单和库存之间只走消息,呼应了"禁止同步调用"的约束。- 实线 = 同步调用,虚线 = 注册/观测(非业务调用)。用线型区分语义,评审时一眼能看出哪些是真调用。
顺带说个真实插曲:我第一版基线同时画了
O --> S和O --> MQ --> S,自相矛盾------连人手工画都会踩这个坑,何况 AI。这也是为什么"约束还原度"必须单列成一个评分维度。
3.2 PlantUML 基线(部署视角)
Mermaid 擅长逻辑架构,部署约束(Pod 隔离、命名空间)用 PlantUML 表达更准:
@startuml
!theme plain
title 订单中心微服务部署架构

node "客户端" {
  [Web / App]
}

node "接入层" {
  [SLB 负载均衡]
  [API 网关 Kong]
}

node "Kubernetes 集群 (prod)" {
  [订单服务]
  [库存服务]
  [支付服务]
  [用户服务]
  [Nacos 注册中心]
  queue "RocketMQ" as MQ
}

node "数据层" {
  database "MySQL 一主两从" as MySQL
  database "Redis Cluster 三主三从" as Redis
  database "Elasticsearch" as ES
}

node "运维观测" {
  [Prometheus + Grafana]
  [Filebeat 日志采集 → ELK]
}

[Web / App] --> [SLB 负载均衡]
[SLB 负载均衡] --> [API 网关 Kong]
[API 网关 Kong] --> [订单服务]
[API 网关 Kong] --> [用户服务]
[订单服务] --> [支付服务]

[订单服务] ..> [Nacos 注册中心] : Dubbo RPC
[库存服务] ..> [Nacos 注册中心] : Dubbo RPC
[支付服务] ..> [Nacos 注册中心] : Dubbo RPC
[用户服务] ..> [Nacos 注册中心] : Dubbo RPC

[订单服务] --> MQ : 异步解耦
MQ --> [库存服务]

[订单服务] --> MySQL
[订单服务] --> Redis
[库存服务] --> Redis
[订单服务] --> ES

[订单服务] ..> [Prometheus + Grafana] : 指标采集
[订单服务] ..> [Filebeat 日志采集 → ELK] : 日志

@enduml
PlantUML 的优势在这:node { } 天然表达部署边界,queue / database 是带语义的元件类型,: Dubbo RPC 可以给边加文字标签。画部署图,PlantUML 比 Mermaid 更对口。
四、实测 A:PicDoc
范式:AI 文字直出,粘贴文本 → 选图例类型 → 生成 → 可二次编辑
操作流程
- 把 2.1 节素材粘进编辑区
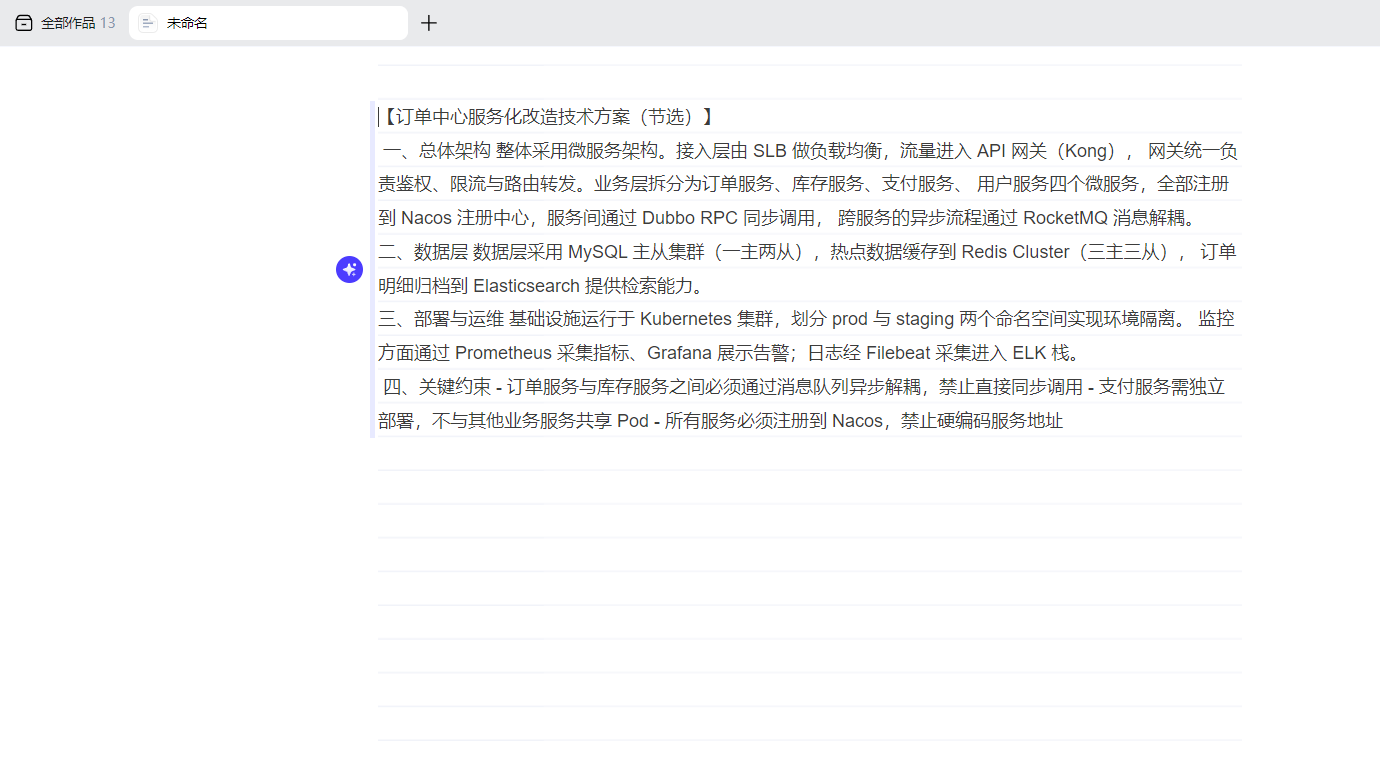
- 选择「自由生图」输入层级架构图 / 流程图生图要求
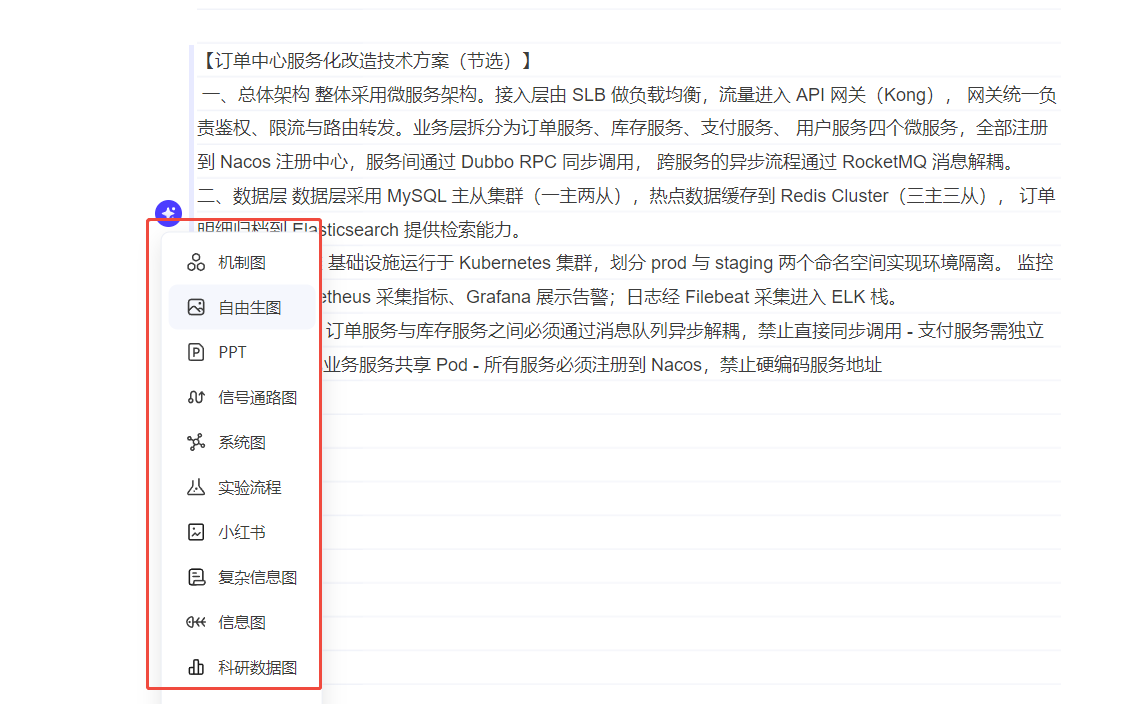
- 生成,查看结构
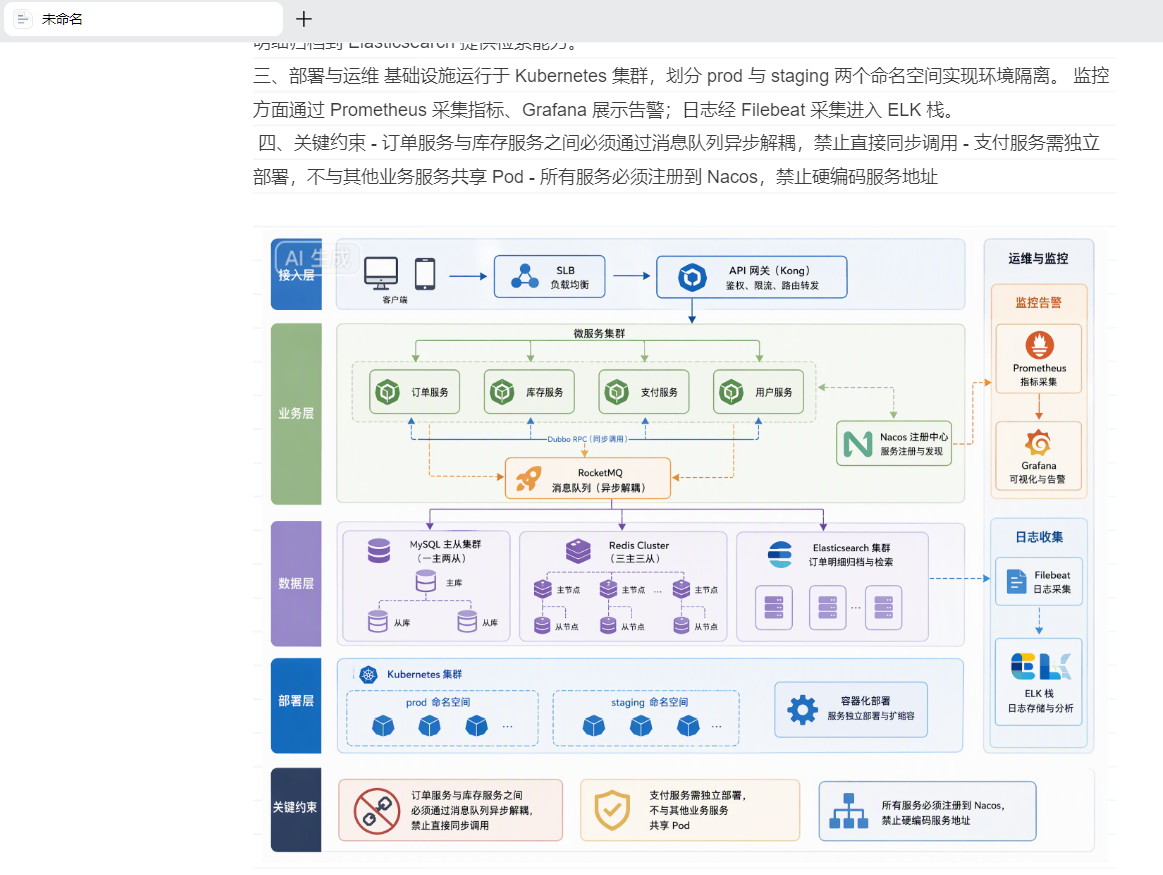
- 用编辑功能修正
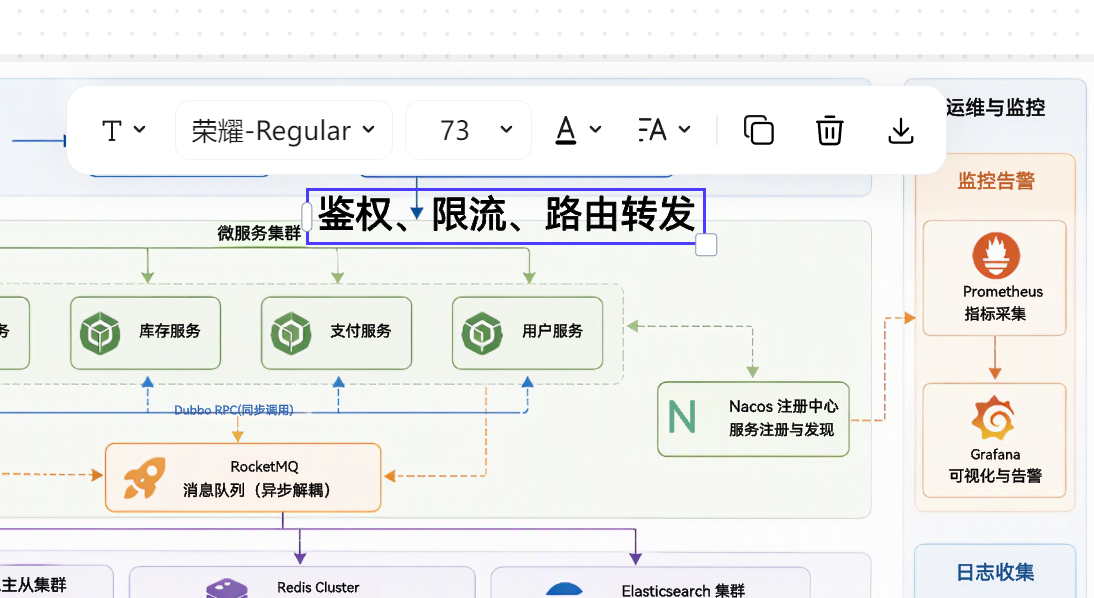
实测表现
结构还原度 :接入层/业务层/数据层能被拆出来,分层基本正确。4 分。 分组逻辑符合中文技术文档的表达习惯,这一点比海外工具好------中文术语("一主两从""三主三从")不会被乱翻。
元素完整性 :14 个组件大致都能出现,但偏冷门的组件(Filebeat、Grafana)偶尔会被合并进"运维"一个大框里 。用于评审需要手动展开。4 分。
关系正确性 :调用方向基本对,但同步/异步区分不稳定 ------Dubbo 和 RocketMQ 容易被画成同一种线。3 分。
约束还原度 :这是短板。"订单与库存禁止同步调用"这条,大概率会被画成一根普通的调用箭头 。原因是这类约束在原文里是"禁止"句式,而可视化模型天然倾向于画"存在的关系",不擅长画"不存在的关系"。2 分。
可编辑性 :这是它的强项。生成后支持文本分层编辑、添加文字、局部修改、涂抹消除、抠图、上传图片、形状绘制。也就是说,AI 出的错你可以就地改掉,不用重画 。5 分。
工程化能力 :导出图片格式,可进 PPT / 文档。但它不是文本产物,无法直接入 Git 做 diff ,也不能随文档自动重生成。3 分。
额度
注册赠送额度。先跑几张看效果不用付费。
小结
适合"快速出一张能看、还能改的图"。 如果你要的是评审前 30 分钟把想法可视化、并且接受人工补约束,它是最省时间的选择。但别指望它替你记住架构约束。
五、实测 B:Napkin AI
范式:粘贴文字 → 选中 → 生成多个视觉方案 → 选一个改
实测表现
结构还原度 :分层能做到,会一次给多个备选布局让你挑。4 分。
元素完整性 :英文技术名词(Kong、Nacos、RocketMQ、Elasticsearch)识别没问题,但偏运维的组件容易被省略或概括成"Monitoring" 。中文文档里的表述理解弱于英文。3 分。
关系正确性 :同样存在同步/异步不区分的问题。3 分。
约束还原度 :和 A 一样的问题,"禁止"型约束基本丢失。2 分。
可编辑性 :生成结果可编辑(改颜色、图标、标签、布局)。4 分。
工程化能力 :明显弱项。SVG / PPT 导出需要付费版,免费版导出带 Napkin 水印 。不能入 Git。2 分。
额度(核对至 2026 年 10 月)
- Free:每周 500 AI credits,约 1 credit/词,编辑与文件导入不限量,PNG/PDF 导出不限量
- Plus:$9--12/人/月,10,000 credits/月,解锁 PPT/SVG、去水印
- 生成需在桌面浏览器操作
小结
适合"英文汇报、示意图草稿"。免费额度确实大方。但对国内技术评审场景,中文理解和工程化能力都不如代码派。
六、实测 C:Mermaid + LLM(开发者主流路线)
范式:让 LLM 把方案文字翻译成 Mermaid 代码,代码即图。
操作流程
把 2.1 节素材 + 一段提示词交给任意 LLM(DeepSeek / 通义 / GLM / GPT 均可),让它直接吐 Mermaid 代码,然后把代码粘进 mermaid.live 或 IDE 预览。
关键点:提示词必须写约束
这是实测里最重要的一个发现 。用普通提示词,LLM 和 AI 画图工具有一样的毛病------会画出 O --> S 直连。
但只要你在提示词里显式声明约束,代码派能精确命中。这是我验证过的提示词写法:
请把下面的技术方案转换为 Mermaid flowchart 代码。

要求:
1. 按接入层 / 业务层 / 数据层 / 运维观测 分为四个 subgraph
2. 实线表示同步调用(Dubbo RPC),虚线表示异步消息(RocketMQ)
3. 【重要】严格遵守文中的负面约束:
   - 若原文写明"禁止直接同步调用",则两个服务之间不得存在直接连线,
     必须经由消息队列中转
   - 被声明"独立部署"的服务,在图注中标明,不要与其他服务放入同一 subgraph
4. 数据库节点用 [( )] 圆柱形状
5. 只输出 Mermaid 代码,不要解释

方案原文:
<粘贴 2.1 节素材>
实测表现
结构还原度 :显式要求分 subgraph 后,分层准确。5 分。
元素完整性 :基本不漏,个别长尾组件(Filebeat)可能丢。4 分。
关系正确性 :要求区分线型后能正确区分,但默认情况仍会混用 。3--4 分(取决于提示词质量)。
约束还原度 :这是代码派唯一的胜出项。 显式声明后,LLM 会正确画出 O --> MQ --> S 且不画 O --> S。3--4 分(提示词写对才有)。
可编辑性 :改代码即改图,改一个标签就是改一行文本。5 分。
工程化能力 :全面胜出。文本入 Git、diff 有意义、可导 SVG、可进 CI、文档改了图能重新生成。5 分。
小结
对开发者来说,这是综合可用度最高的路线。 代价是你要会写提示词、要懂一点 Mermaid 语法。
七、实测 D:PlantUML
范式 :文本 DSL,node / queue / database 带语义。
实测表现与 C 类似,但有两个差异:
优势 :node { } 天然表达部署边界,"支付服务独立 Pod""prod/staging 隔离"这类部署约束表达更自然;queue / database 是语义化元件,不用自己画形状;: 标签 给边加文字比 Mermaid 直观。画部署图比 Mermaid 更对口。
劣势 :依赖 Java 运行时;语法比 Mermaid 略繁琐;GitHub Markdown 不原生渲染 PlantUML(Mermaid 原生支持),对"图要跟着 README 走"的场景不友好。
评分:结构 5 / 元素 4 / 关系 4 / 约束 3 / 可编辑 4 / 工程化 5。
八、可用度横向评分表
| 维度(5 分制) | 手工基线 | PicDoc | Napkin AI | Mermaid+LLM | PlantUML |
|---|---|---|---|---|---|
| 结构还原度 | 5 | 4 | 4 | 5 | 5 |
| 元素完整性 | 5 | 4 | 3 | 4 | 4 |
| 关系正确性 | 5 | 3 | 3 | 4 | 4 |
| 约束还原度 | 5 | 2 | 2 | 4 | 3 |
| 可编辑性 | 5 | 5 | 4 | 5 | 4 |
| 工程化能力 | 5 | 3 | 2 | 5 | 5 |
| 合计 | 30 | 21 | 18 | 27 | 25 |
说明 :Mermaid+LLM 的"约束还原度 4 分"是有前提的------提示词里必须显式声明约束。不给约束,它会掉到 2 分。
九、实测结论:AI 现在能做什么、不能做什么
跑了四款之后,结论比想象中清晰:
✅ AI 已经能做好的
- 把一段平铺文字变成分层结构。这是最大的价值,省掉的是拖方块的时间。
- 元素枚举。方案里提到的组件基本不会漏。
- 出图速度。从粘贴到成图几十秒,相比手工 40 分钟,量级差异。
- 给非技术干系人看的示意图。评审会上给产品/业务方看的那张图,AI 出的完全够用。
❌ AI 目前做不到的
- 还原"禁止"型约束 。这是本次实测最重要的发现。AI 擅长画"存在什么",不擅长画"不存在什么",而架构约束恰恰大量以否定式出现。
- 区分同步/异步语义。除非你显式要求,否则两种调用会被画成一样的线。
- 表达部署细节。Pod 隔离、命名空间、副本数------这些是部署图的正文,AI 基本不处理。
- 产出可工程化的产物。图片无法 diff、无法随文档自动重生成,图和文字依然是两份东西。
一句话判断标准
如果你的图是为了"让人看懂结构" → AI 完全够用。
如果你的图是为了"过架构评审" → AI 只能出骨架,约束必须人工补。
换句话说,现阶段的技术方案图工具,定位应该是"骨架生成器"而不是"成品生成器"。把它当成一个能省下拖方块时间、但不会替你做架构判断的助手,体验会好很多;指望着一键出图直接过会,一定会失望。
十、落地:把出图嵌进方案评审流程
基于以上结论,我现在的实际流程是这样的,供参考:
10.1 三步走流程
第 1 步:方案文字先写"分层小标题"
   ↓  用 一、总体架构 / 二、数据层 / 三、部署运维 这样的结构
第 2 步:AI 出骨架
   ↓  要快+可改 → PicDoc;要工程化 → LLM 生成 Mermaid(提示词带上约束)
第 3 步:人工补约束(不可省略)
      检查三件事:① 有没有不该出现的直连 ② 同步/异步线型对不对
      ③ 部署隔离有没有表达
第 3 步是必须的,也是 AI 目前无法替代的一步。 我建议把它做成 checklist 贴在评审模板里。
10.2 让图和文档保持同步(代码派专属)
如果你选 Mermaid 路线,可以做到的终极形态是:文档改了,图自动重生成。把图写进 Markdown,用 CI 渲染:
# 安装渲染器
npm install -g @mermaid-js/mermaid-cli

# 渲染
mmdc -i docs/arch.mmd -o docs/arch.svg -w 1600
GitHub / GitLab 更省事:直接在 .md 里写 ```mermaid 代码块,平台原生渲染,根本不用本地出图。这是"图和文字永不脱节"的唯一可靠解法。
10.3 一个实用建议:约束单独成段
写方案时,把架构约束单独列成「关键约束」小节(就像 2.1 节素材那样)。好处有两个:
- AI 更容易识别到这是约束(而不是混在描述里被忽略)
- 评审时对照检查也有据可依
附录:语法校验脚本
文中 Mermaid / PlantUML 基线代码用下面的脚本做了结构校验(subgraph/end 配对、引号括号均衡、边定义计数),读者可直接复用:
import sys

def check_mermaid(path):
    lines = [l.strip() for l in open(path, encoding="utf-8").read().splitlines() if l.strip()]
    sg = sum(1 for l in lines if l.startswith("subgraph"))
    en = sum(1 for l in lines if l == "end")
    src = "\n".join(lines)
    edges = sum(1 for l in lines if "-->" in l or ".->" in l)
    ok = (sg == en
          and src.count('"') % 2 == 0
          and src.count("[") == src.count("]")
          and src.count("(") == src.count(")"))
    print(f"[Mermaid] subgraph={sg} end={en} 边数={edges} 通过={ok}")
    return ok

def check_plantuml(path):
    src = open(path, encoding="utf-8").read()
    lines = [l.strip() for l in src.splitlines() if l.strip()]
    edges = sum(1 for l in lines if "-->" in l or "..>" in l)
    ok = (lines[0] == "@startuml" and lines[-1] == "@enduml"
          and src.count("{") == src.count("}"))
    print(f"[PlantUML] 节点块={sum(1 for l in lines if l.startswith('node '))} "
          f"边数={edges} 通过={ok}")
    return ok

if __name__ == "__main__":
    sys.exit(0 if all([check_mermaid(sys.argv[1]), check_plantuml(sys.argv[2])]) else 1)
用法:
python check_arch.py baseline.mmd baseline.puml
# 输出:[Mermaid] subgraph=5 end=5 边数=16 通过=True
#       [PlantUML] 节点块=5 边数=17 通过=True
如果这篇对你有用,欢迎点赞收藏。 你用什么工具画架构图?有没有被评审追问过图上的箭头?评论区聊聊,我会把高频问题补进 FAQ。
说明:额度与能力信息核对至 2026 年 10 月,以各工具官网实时页面为准。本文不含付费推广。