从一段老动画出发,做一个能抽帧、GPU 超分、保留音轨、合成视频的 Windows 软件。本文介绍它的使用方法、实现原理,以及最新一轮优化的真实耗时。
一、为什么想做这个项目
做这个项目,最初的想法其实很简单:把以前的动画片处理得清晰一些,给现在的小朋友看。
小时候让我们着迷的那些角色和故事,今天依然值得被看见。但一些老片源放到现在的大屏幕上,模糊的轮廓、压缩后的色块、发虚的线条,也会变得更加明显。
我觉得,为这些画面做一点改善,是一件很有意思的事情。它既是一个可以认真研究的技术项目,也是一种把童年的快乐继续分享出去的方式。
于是,我把动画超分辨率模型、Vulkan GPU 推理和 FFmpeg 的视频处理流程整合到了一起,再做了一个 WinForms 界面。使用者选择一个视频,先处理一段样片,确认效果以后再处理整集,不需要手动管理几万张图片。
这个软件叫 APISR Vulkan 视频超分工作台。
它使用现成的 APISR 模型。我在这个项目中主要完成的是 C# 与 C++ 部署、Vulkan 执行、批量处理、视频工作流和界面,让模型能够方便地用于实际视频。
二、软件现在能做什么
目前的完整流程是:
objectivec
输入动画视频
    ↓
FFprobe 分析分辨率、帧率、帧时间轴和音轨
    ↓
分离音频、字幕等媒体轨道
    ↓
FFmpeg 按分段提取 PNG 图片
    ↓
APISR Vulkan ×4 超分
    ↓
FFmpeg 将超分图片编码为 HEVC 视频分段
    ↓
拼接分段,并合并音轨、适配字幕
    ↓
输出 MKV 或 MP4
界面提供"完整视频处理"和"图片序列处理"两个入口。已经有图片序列时,可以直接批量超分;手里只有视频时,则让软件完成整条流程。
主要功能包括:
- APISR ×4 超分,模型推理使用 Vulkan。
- 设置核心边长、上下文重叠、GPU 会话数和读取/保存线程。
- 选择起始时间与样片帧数,先检查效果再处理整集。
- 输出 MKV 或 MP4,支持 HEVC NVENC 和 CPU libx265 编码。
- 分段处理、取消、断点续跑、日志和任务报告。
- 默认相对路径,工作目录放在程序所在目录下的"工作区"。
- 提供 C# 和 C++ 一起编译的 VS2022 解决方案。
下面是实际界面,参数区集中显示,底部为进度和日志。
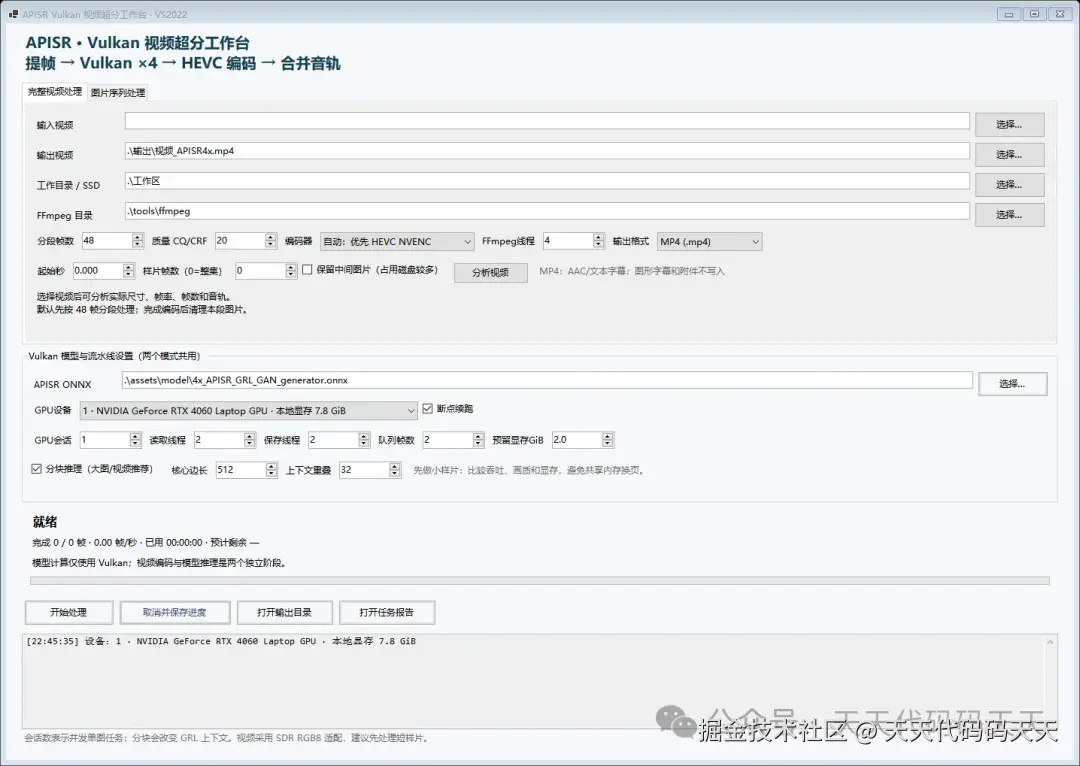
APISR Vulkan 视频超分工作台 WinForms 界面
三、先跑一个样片:从选择视频到生成 MP4
1. 启动软件
使用运行包时,完整解压后启动程序。机器需要安装 .NET 8 Desktop Runtime x64,显卡驱动需要支持程序所用的 Vulkan 功能;本项目以 Vulkan 1.1 为运行基础。
模型推理不需要安装 CUDA、cuDNN 或 OnnxRuntime。模型、FFmpeg/FFprobe 和所需原生文件已经随包整理好,不要只把 exe 单独复制出去。
使用源码包编译的方法在后面介绍。
2. 选择输入、输出和工作目录
在"完整视频处理"页面选择动画视频,指定一个新的输出文件,再选择 MKV 或 MP4。
默认路径以 exe 所在目录为基准:
.\assets\model\4x_APISR_GRL_GAN_generator.onnx
.\tools\ffmpeg
.\工作区
.\输出
工作目录用于保存临时图片、视频分段和任务记录,建议放在空间充足的 SSD 上。同盘选择的路径尽量以相对形式保存;跨盘路径仍可使用绝对路径。
3. 点击"分析视频"
先查看软件读出的真实分辨率、帧率、帧数和音轨,再决定如何处理。
我使用的一份《龙珠》测试文件,实际信息是:
| 项目 | 数值 |
|---|---|
| 视频尺寸 | 1440×1080 |
| 帧率 | 24000/1001,约 23.976 fps |
| 总帧数 | 35,487 帧 |
| 时长 | 约 24 分 40 秒 |
| 音轨 | 1 条 DTS 音轨 |
| APISR ×4 输出尺寸 | 5760×4320 |
×4 表示宽和高分别变为原来的 4 倍,像素总数变为 16 倍。 因此,1440×1080 经过当前模型会输出 5760×4320。虽然目标是让老动画更清晰,处理时仍要注意输出尺寸、磁盘空间和播放设备的能力。
4. 设置短样片
先用以下参数作为起点:
| 参数 | 初始设置 | 作用 |
|---|---|---|
| 起始秒 | 60 | 从第 60 秒附近取画面 |
| 样片帧数 | 48 | 先处理约 2 秒的视频 |
| 分段帧数 | 48 | 每段处理多少张图片 |
| GPU 会话数 | 1 | 从一个推理会话开始观察吞吐 |
| 核心边长 | 512 | 每块实际保留的输入区域边长 |
| 上下文重叠 | 32 | 每侧额外读取的上下文像素 |
| 读取/保存线程 | 2 / 2 | CPU 图片读写并行度 |
| 队列容量 | 2 | 限制等待中的图片数量 |
| 预留显存 | 2 GiB | 为系统和其他应用留出空间 |
| 编码器 | 自动 | 先尝试 HEVC NVENC |
| 质量 CQ/CRF | 20 | 编码质量的初始值 |
这些是本项目默认设置附近的起点,并不代表所有显卡和片源的最佳组合。质量数字越小通常意味着更高质量和更大文件;NVENC 的 CQ 与 libx265 的 CRF 不能按相同数字直接比较画质。
GPU 序号以当前机器枚举为准。尤其是带核显的笔记本,请确认选中了准备使用的独立显卡。
点击"开始处理",软件会依次显示抽帧、Vulkan 超分、编码和合并阶段。第一次遇到新块尺寸,会生成执行计划并让驱动编译计算管线,可能比后续帧慢。
5. 看完样片,再跑整集
样片生成以后,我建议同时检查两件事:
- 暂停画面,观察人物轮廓、头发、字幕、细线和背景是否自然。
- 连续播放,观察是否出现闪烁、接缝或不舒服的锐化效果。
超分模型根据输入估计更高分辨率的画面,生成的细节不等于找回了原始画稿。对于老动画,保留画风、让人看得舒服,比单纯追求像素数更重要。
确认样片以后,把"起始秒"设为 0,"样片帧数"设为 0,就会处理整集。
四、MKV 和 MP4 怎么选
输出格式会影响音轨、字幕和附件的保存方式:
| 格式 | 本项目的处理方式 | 适合的用途 |
|---|---|---|
| MKV | 复制原音轨,保留字幕、字体/其他附件和章节 | 希望保留源文件的媒体信息 |
| MP4 | AAC 音轨直接复制;其他音轨转 AAC;常见文本字幕转 mov_text,图形字幕和附件不写入 | 需要 MP4 封装的分享或播放场景 |
例如,测试文件中的 DTS 音轨,在 MKV 输出中可以保留;选择 MP4 时,软件会将它转换为 AAC。ASS 等字幕转 mov_text 后,样式可能变化。
当前两种输出格式都使用 HEVC Main10 视频编码。选择 MP4 会改变封装和音轨适配,不会自动改成 H.264;播放兼容性还要结合实际播放器、解码器和输出尺寸检查。
MP4 最终合并启用了 faststart,并通过精确帧率处理避免中间 MKV 的时间基舍入改变最终帧率。这些都由软件自动完成。FFmpeg 的封装选项可参考其 官方格式文档(ffmpeg.org/ffmpeg-form...
五、APISR 为什么适合用来处理动画
APISR 的全称是 Anime Production Inspired Real-World Anime Super-Resolution 。它面向真实场景中的低质量动画图像和视频源,是 CVPR 2024 的动画超分工作。模型与研究背景可以在 APISR 官方项目(github.com/Kiteretsu77... 和 论文(openaccess.thecvf.com/content/CVP... 中了解。
本项目部署的是已有的 APISR GRL GAN ×4 ONNX 模型。动画的线条、平涂色块和轮廓是我重点观察的对象,所以选择动画超分模型作为这套工具的核心。
运行时,软件将一张 RGB 图片整理为模型输入张量,执行网络计算,再把输出转换为 RGB 图片:
css
RGB 图片
  → RGB / 255
  → NCHW FP32 张量 [1, 3, H, W]
  → APISR 网络
  → 输出张量 [1, 3, 4H, 4W]
  → 检查数值、裁切上下文、量化为 RGB8
  → 无损 PNG
当前视频处理采用逐帧图片超分,保留帧数和原始帧率,没有加入插帧,也没有加入跨帧时序网络。因此,画质评估需要包含连续播放,而不只看单张截图。
六、Vulkan 在这里做了什么
很多人认识 Vulkan,是因为它常被用于游戏和图形渲染。它也支持 Compute Shader,也就是计算着色器 ,可以直接执行 GPU 并行计算,无需绘制画面。Khronos 对这种用途有专门的 Vulkan 计算介绍(www.khronos.org/blog/gettin...
在这个项目里,卷积、矩阵乘法、归一化、注意力和张量变形等计算被实现为 GPU 内核。Vulkan 负责创建设备、分配缓冲、绑定数据、调度内核并同步结果。
计算内核的源码先编译成 SPIR-V ,再交给显卡驱动建立计算管线。SPIR-V 是 Vulkan 等 API 使用的二进制中间表示,官方说明见 What is SPIR-V(docs.vulkan.org/guide/lates...
源码包中已经嵌入编译好的 SPIR-V,因此客户正常使用 VS2022 编译程序时,不需要额外安装着色器编译器。
Vulkan 的价值还在于提供一种面向不同显卡厂商的 GPU 计算接口。不过,接口的可移植性不等于已经完成所有硬件验证。本项目的性能数字来自实际测试机器,没有把一张显卡的结果当成所有显卡的结果。
C# 与 C++ 的分工
bash
C# WinForms
    ├─ 参数、界面、进度和设置
    ├─ FFmpeg 进程与视频工作流
    ├─ ONNX 解析、形状推导、算子融合和内存计划
    └─ 调用原生 C ABI
             ↓
C++ apisr_vulkan.dll
    ├─ Vulkan 设备与缓冲区
    ├─ 权重上传、计算管线、描述符绑定
    ├─ 命令缓冲和 GPU 同步
    └─ 执行 SPIR-V 内核并读回输出
这里没有把 ONNX 文件交给一个通用推理框架。C# 端读取模型图,针对当前 APISR 网络生成 GPU 执行计划;C++ 端按照计划执行。
这个导入器目前覆盖的是 APISR 所需的图结构和算子,不能把任意 ONNX 模型放进去就直接运行。以后接入其他模型时,可以复用设备管理、缓冲、原生桥接和任务流水线,但仍要补齐对应的算子、形状规则和预后处理。
七、一次完整的 Vulkan 推理是怎样完成的
以默认的 576×576 输入块为例,可以分成"准备"和"执行"两部分。
准备阶段:为这个尺寸建立可重复执行的计算图
- 解析模型与权重。 读取 ONNX 图,把静态常量、权重和输入输出信息整理好。
- 推导形状和常量。 根据当前块尺寸确定各层张量尺寸,提前计算只依赖形状或常量的部分。
- 融合算子。 将符合条件的组合改成融合操作,例如部分归一化、注意力、矩阵乘法偏置/激活,以及尾部上采样卷积。
- 规划 GPU 工作区。 根据张量最后一次使用的位置复用内存,避免为每一层长期保留独立缓冲。
- 准备 Vulkan 管线与命令。 上传权重和计划数据,建立计算管线、描述符绑定,录制后续可以重复提交的命令缓冲。
准备结果会缓存。对于视频中的同尺寸图片,不需要每帧重新解析模型、分配全部缓冲或建立整套管线;同一个任务跨视频分段也会保留推理会话。
执行阶段:输入一块图片,得到一块超分结果
CPU 输入浮点缓冲
    ↓ 写入上传缓冲
复制到 GPU 输入工作区
    ↓ 传输 → 计算屏障
按执行计划调度卷积、注意力等内核
    ↓ 算子之间的内存屏障
复制输出到读回缓冲
    ↓ 等待 GPU Fence 完成
CPU 读取结果并处理像素
内存屏障保证前一个操作的结果可以被后面的操作正确访问,Fence 用来确认这次 GPU 提交已经完成。
原生接口按职责分为:
apisr_dynamic_create    创建会话、上传基础权重
apisr_dynamic_prepare   准备某个尺寸的执行计划
apisr_dynamic_run       执行一次输入/输出计算
apisr_dynamic_destroy   释放会话资源
C# 端通过动态加载原生 DLL 和 C ABI 调用它们。图片块的浮点输入、输出数组也会重复使用,减少批量任务中的反复分配。
这套结构的意义是:把"准备好一个模型"与"反复处理几万张图片"分开,让可复用的工作尽量只做一次。
八、核心边长和上下文重叠到底是什么
整张大图直接推理,需要的显存不仅是输入和输出,还包括网络中间特征。对于 ×4 超分,这些中间数据可能很大。
因此,软件可以把原图划分为多个块,并为每个块增加上下文。
以"核心 512、重叠 32"为例:
ini
模型输入边长 = 核心边长 + 2 × 上下文重叠
             = 512 + 2 × 32
             = 576
模型实际看到一个 576×576 的区域。中间 512×512 是最终需要保留的核心,四周每侧 32 个像素帮助网络理解边缘附近的内容。
经过 ×4 超分以后:
模型输出块:2304×2304
每侧裁掉上下文:128 像素
保留核心输出:2048×2048
图像边缘没有足够上下文时,软件采用 reflect-101 反射边界扩展。边缘的最后一个块仍使用固定输入尺寸,只保留与原图范围相符的核心输出。
1440×1080 输入在这个设置下需要 3×3,共 9 个块。这些块共用同一份尺寸计划和缓冲。
分块使大图能够在有限显存上处理,但也会改变 GRL 网络看到的上下文。提高重叠可能改善边缘表现,同时增加计算量;本项目不保证分块与整图结果完全一致。具体参数要通过样片观察接缝与连续画面来选择。
九、一集三万多帧,怎样让处理过程更实用
1. 分段处理,控制磁盘占用
如果一次把整集的全部图片都抽出来,再保存全部超分图片,磁盘很快就会成为问题。
本项目默认每段 48 帧:提取这一段、超分、编码,确认分段视频有效以后,清理这一段的中间 PNG,再处理下一段。
以 1440×1080 → 5760×4320 的 RGB 数据估算,48 帧的输入加输出未压缩像素约 3.55 GiB。PNG 实际大小随画面内容变化,软件会在磁盘预检时留出余量。
已编码的视频分段继续保存,用于断点续跑。这样,处理整集时不需要让所有中间图片同时占着磁盘。
2. 读取、GPU 推理、保存组成有界流水线
一个分段内部的图片处理结构是:
CPU 读取线程 → 有界队列 → Vulkan 工作会话 → 有界队列 → CPU 保存线程当 GPU 在处理一帧时,CPU 可以准备后续帧,保存线程可以写出上一帧结果。有界队列限制待处理数据的数量,避免生产速度大于消费速度时持续堆积内存。
目前不同视频分段之间仍按抽帧、推理、编码的阶段顺序执行,还没有把下一段的 Vulkan 推理与上一段的 NVENC 编码同时重叠。
3. 多会话、分段和模型 Batch 是三回事
"GPU 会话数"表示多个独立的单图工作会话,每个会话有自己的 GPU 工作区。
"分段 48 帧"表示视频任务每次管理 48 张图片。
模型输入的 batch 仍是 1,当前没有实现张量 Batch=N。因此,把分段帧数调大,并不会自动让神经网络一次计算 48 帧;增加 GPU 会话也会增加显存占用,吞吐是否提高需要实际测量。
8 GiB 设备可以先从 1 个会话观察;对于客户的 RTX 4080 16 GiB,可以使用相同样片、不同输出名称,比较 1 个与 2 个会话。软件带有显存预算检查,遇到预检失败时,应减少会话或块尺寸。
十、最新一轮优化,实际快了多少
最新 r4 优化了三个位置:
第一,短窗口注意力打包。 部分计算每组启动 64 个线程,而查询长度只有 16,存在大量闲置线程。现在将多个独立窗口打包到同一组,每个查询保留原有 FP32 计算与累加顺序。
第二,大尺寸卷积的权重复用。 NVIDIA 上符合条件的 64 通道大尺寸卷积,使用 M64/N64/K32 计算块,原来是 M32/N64/K32。同一份权重服务更多输出位置;每个线程仍使用 4×4 FP32 累加器。其他厂商继续保留原卷积内核。
第三,直接编码 RGB PNG。 保存图片时,减少额外的 GDI Bitmap、RGB/BGR 交换和整图复制,使用 SIMD 行滤波与快速 zlib 压缩,压缩数据缓冲固定为 64 KiB。PNG 仍是无损 RGB8 格式。
测试条件
- NVIDIA GeForce RTX 4060 Laptop GPU,8 GiB。
- Release | x64,单 Vulkan 会话,默认核心 512、重叠 32。
- 《龙珠》同一段画面,输入 1440×1080,输出 5760×4320。
- 使用已预热的计划和管线缓存,正式测速关闭逐算子 GPU 分析。
| 项目 | r3 | r4 | 耗时减少 |
|---|---|---|---|
| 平均 Vulkan 推理/帧,2 帧样本 | 7.221 秒 | 6.851 秒 | 5.1% |
| 图片任务总耗时,2 帧 | 17.81 秒 | 16.52 秒 | 7.3% |
| 独立 PNG 保存/帧,2 次平均 | 696.5 毫秒 | 594.0 毫秒 | 14.7% |
| 完整 MP4 流程,4 帧、每段 2 帧 | 40.22 秒 | 37.15 秒 | 7.6% |
| 整卡峰值显存 | 约 3.74 GiB | 约 3.74 GiB | 基本相同 |
两张完整超分图片的 r3/r4 输出逐 RGB 像素比较,最大差异为 0;完整流程生成的视频,解码后的 4 帧 framemd5 也一致。帧数、尺寸、24000/1001 帧率和 AAC 音轨均通过检查。
这里要把三个指标分开看:模型推理耗时、包括图片读写的任务耗时、包括抽帧和编码的完整视频耗时。整卡显存包含桌面等其他应用,不能当成程序独占显存;本次也没有测出可以发布的 GPU 利用率百分比。
这些数字来自短样片,没有测完整集。长任务仍主要受 GPU 推理吞吐影响,因此不能用这 4 帧的数据直接承诺整集处理时间。
十一、开发者如何用 VS2022 编译
当前视频项目使用 .NET 8 WinForms + C++17,提供完整的 VS2022 解决方案:
bash
APISR.Vulkan.Video.VS2022.sln
    ├─ ApISR.Video.WinForms    C# 界面、模型计划、图片与视频任务
    └─ ApISR.Vulkan           C++ Vulkan 原生执行器
编译步骤:
- 安装 VS2022 17.8 或更高版本。
- 选择".NET 桌面开发"和"使用 C++ 的桌面开发",包含 .NET 8 SDK、MSVC v143 和 Windows SDK;也可导入包内
.vsconfig。 - 完整解压源码包,打开解决方案。
- 将
ApISR.Video.WinForms设为启动项目。 - 选择
Release | x64,按 Ctrl+F5。
也可以使用源码根目录中的 Build.cmd 和 Run.cmd。
包中已带普通编译需要的 Vulkan 头文件、导入库和嵌入 SPIR-V。正常构建无需 Vulkan SDK、Python 或 CMake;如果要修改本版优化着色器并重新生成 SPIR-V,再使用提供的维护脚本。
命令行批量调用
图形界面和命令行复用同一个程序:
css
.\ApISR.Video.WinForms.exe --video-job .\examples\video-job-mp4.example.json运行包内提供配置模板。修改输入视频、输出路径、GPU 序号和样片范围即可。下面是一个配置示例:
swift
{
  "Processing":{
    "ModelPath":".\assets\model\4x_APISR_GRL_GAN_generator.onnx",
    "DeviceIndex":1,
    "GpuWorkers":1,
    "ReadWorkers":2,
    "SaveWorkers":2,
    "QueueCapacity":2,
    "Tiled":true,
    "TileSize":512,
    "TileOverlap":32,
    "ReserveGiB":2
},
"InputVideo":".\输入视频\动画样片.mkv",
"OutputVideo":".\输出\动画样片_APISR4x.mp4",
"WorkDirectory":".\工作区",
"FfmpegDirectory":".\tools\ffmpeg",
"Encoder":"auto",
"Quality":20,
"SegmentFrames":48,
"FfmpegThreads":4,
"StartSeconds":60,
"MaxFrames":48,
"Resume":true,
"KeepImages":false
}
这里的设备 1 只是示例,必须按本机设备列表修改。配置文件内的业务相对路径以 exe 为基准;--video-job 后面的配置文件路径以命令行当前目录为基准。
在现有 C# 项目内部调用图片批处理
以下是解决方案内部的调用示意,相关处理器是本项目代码,不是需要安装的额外 NuGet API:
ini
using ApISR.Batch;

var processing = new ProcessingOptions
{
    DeviceIndex = 1, // 示例序号,实际从设备列表选择。
    GpuWorkers = 1,
    Tiled = true,
    TileSize = 512,
    TileOverlap = 32
};

var progress = new Progress<WorkProgress>(state =>
{
    Console.WriteLine(
        $"{state.Stage}: {state.Completed}/{state.Total}, " +
        $"{state.FramesPerSecond:F3} 帧/秒");
});

usingvar processor = new BatchProcessor(processing);
await processor.RunAsync(new BatchOptions
{
    Processing = processing,
    InputDirectory = @".\输入帧",
    OutputDirectory = @".\输出帧",
    Resume = true
}, progress, CancellationToken.None);
一个 BatchProcessor 可以继续处理后续分段,复用模型和工作会话。GUI 中的取消令牌也会传给处理流程,避免在界面线程直接执行长时间推理。
十二、长任务为什么要保留进度记录
三万多帧的任务,中途取消、重启或调整工作安排都很常见。软件会记录任务参数、已保存图片、已编码分段和最终输出信息。
点击"取消并保存进度"以后,会停止继续安排新工作,并等待当前 GPU 调用退出。再次使用相同输入、输出、工作目录、模型、分块设置、帧范围和编码参数开始,会检查记录并跳过已完成部分。
这些记录保存在工作目录的 video-<任务标识> 下。图片模式则默认在输出目录的 _apisr-report 下保存报告。
软件用文件长度、修改时间以及必要的帧数、尺寸检查判断已有结果,因此续跑时请保留任务目录,不要手动修改里面的文件。最终视频确认无误以后,可以清理对应任务目录释放分段文件的空间。
十三、目前的适用范围
目前视频工作流面向已经验证的 恒定帧率 SDR 视频。发现可变帧率或时间轴跳变时,会拒绝继续;HDR PQ/HLG 视频也不能直接套用这条处理流程。
图片入口是 RGB8。10 bit 源视频会先解码为 RGB24 PNG,超分以后再编码为 HEVC Main10,所以输出文件标记 10 bit,并不意味着保留了原始 10 bit 精度。
超分效果还会受片源质量、模型、分块上下文和编码设置影响。后续有价值的方向包括进一步减少张量复制、研究 FP16/矩阵加速内核,以及改进视频时序表现;这些需要分别验证画质、数值与硬件兼容性。