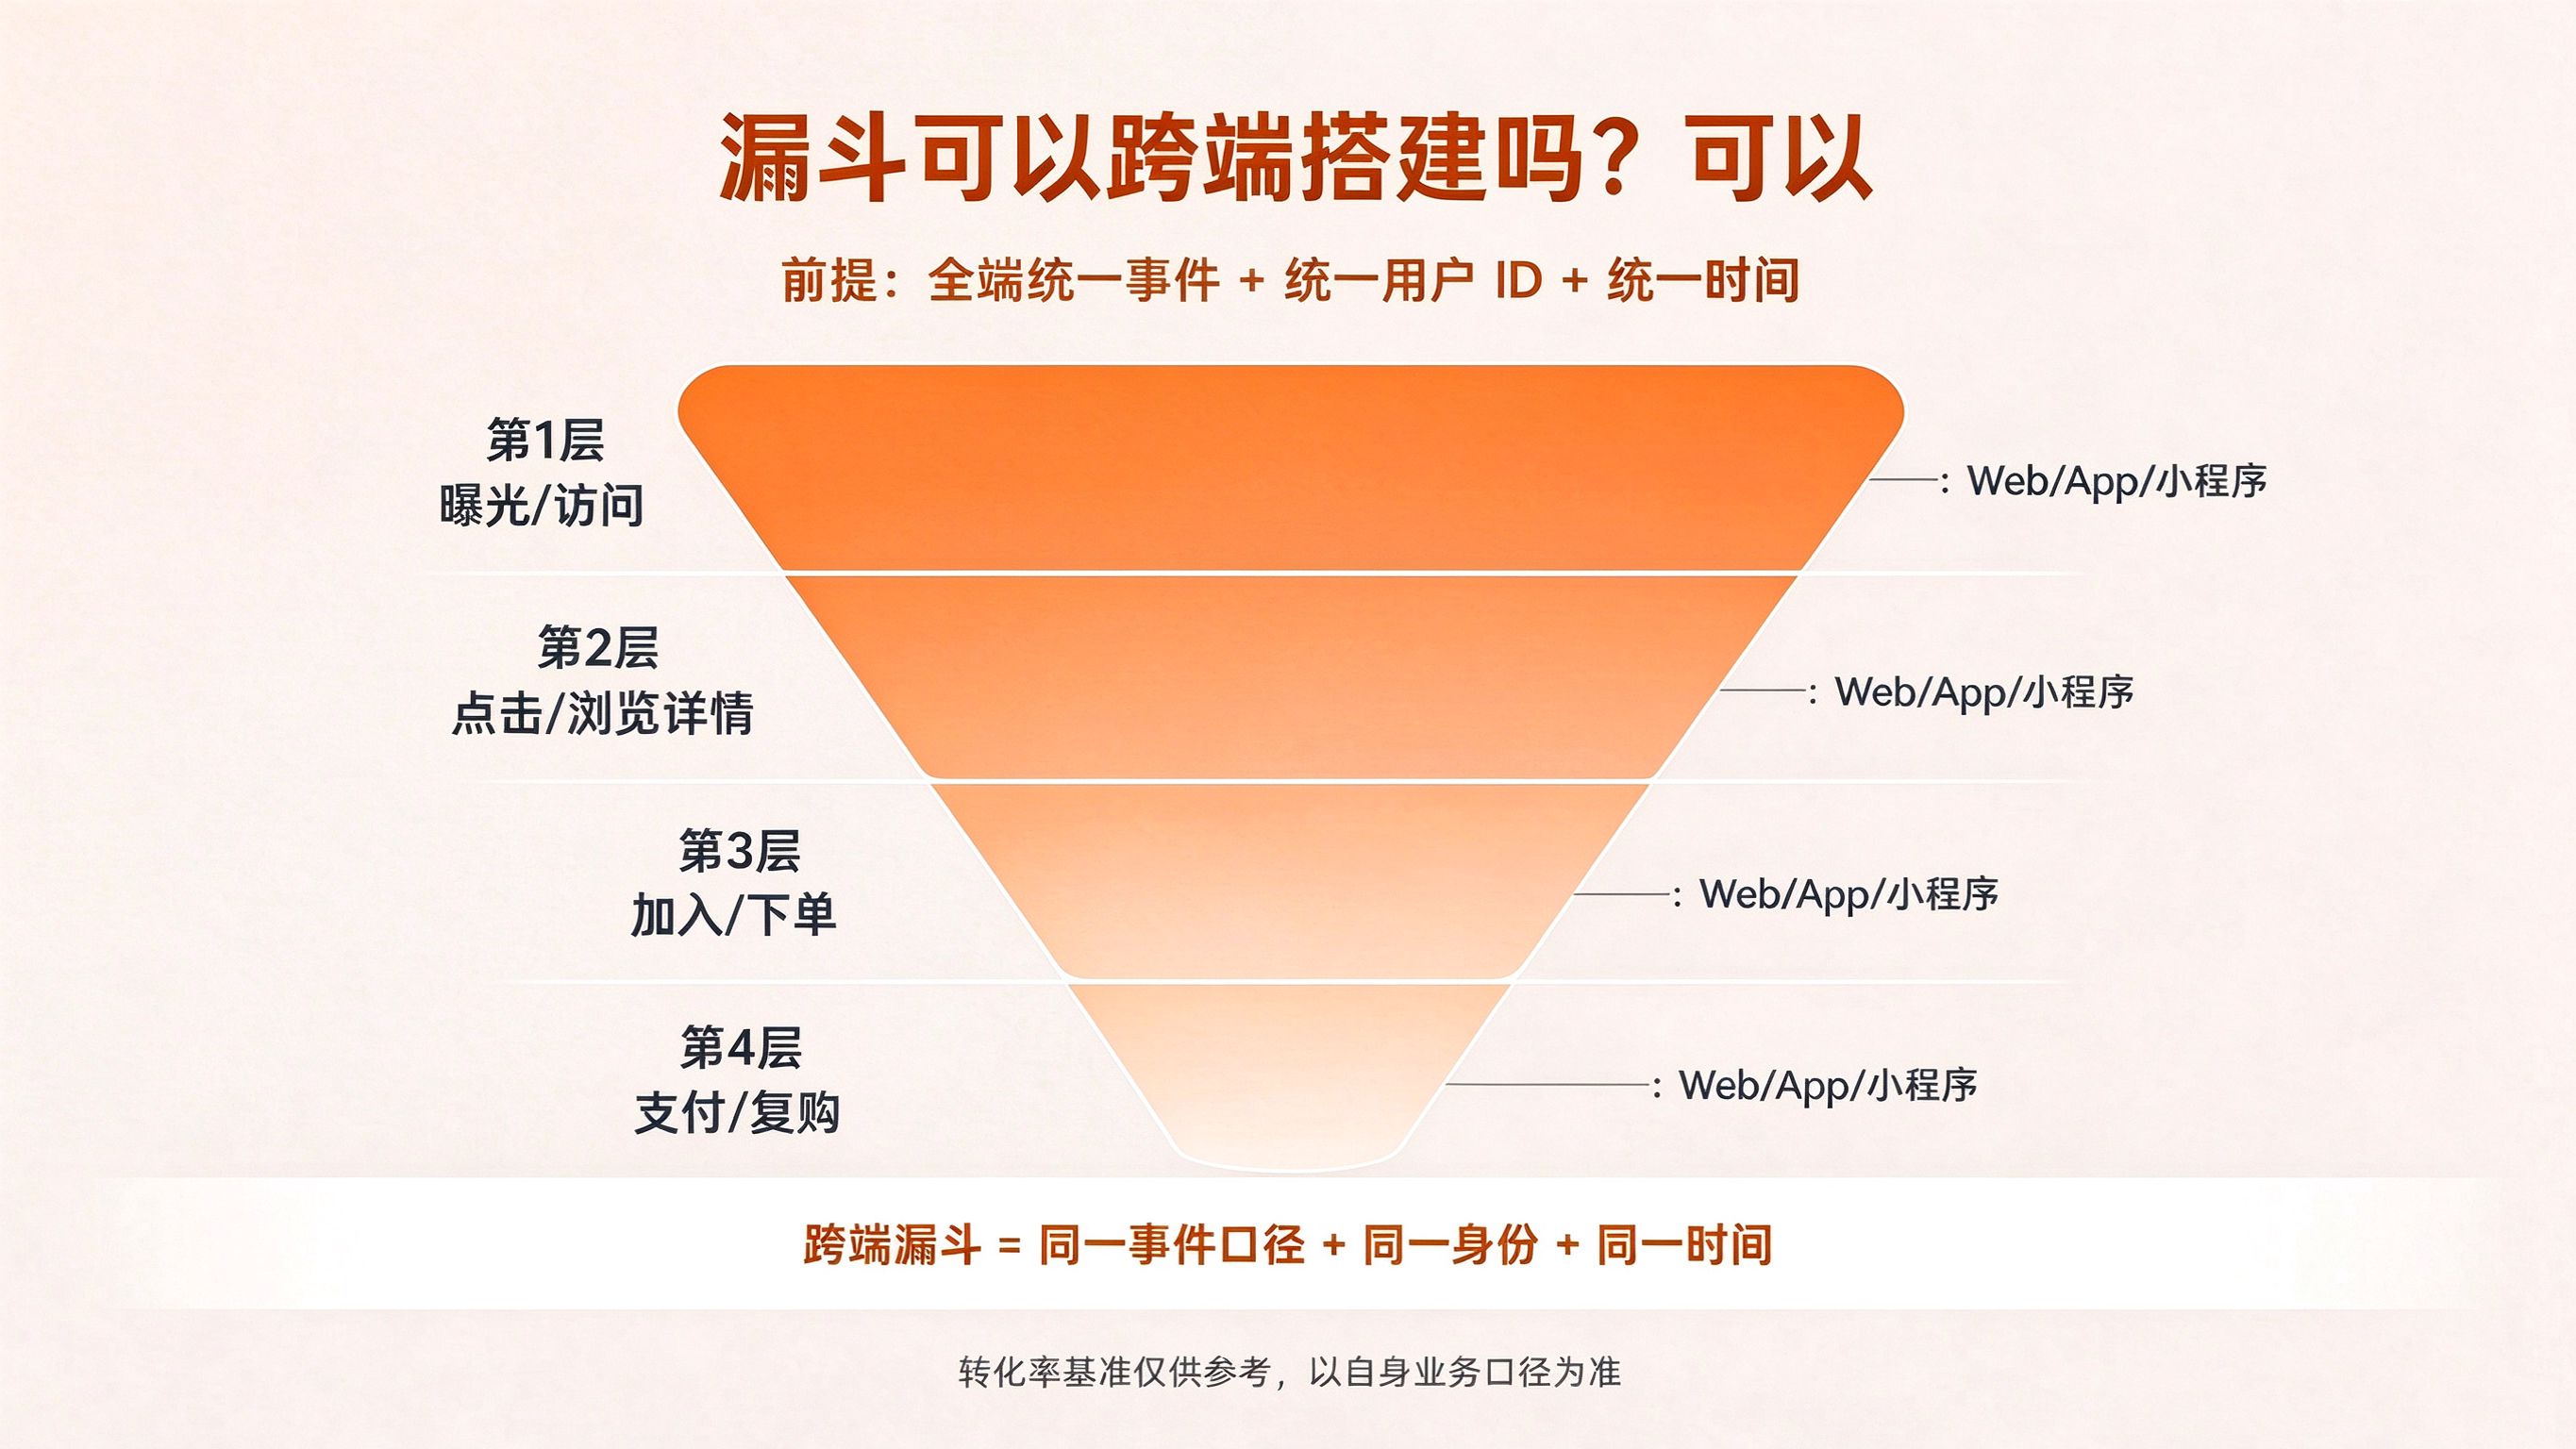
结论先行: 可以跨端搭建漏斗,但有三个前提:统一事件、统一身份、统一时间。满足这三个前提,用户在 Web 看、App 点、小程序下单的完整旅程才能串成一条漏斗;否则你看到的是三截断开的管子。
本文给出一套 5 步搭建法、转化率基准参考和我的踩坑记录。想跑通跨端口径,关键是工具是否支持统一事件、身份与时间口径------这也是本文选型视角会反复强调的点。
漏斗是什么:先对齐定义
**核心定义:**漏斗(转化分析)就是把一个业务流程拆成多个步骤,用转化率衡量每个步骤的表现,再定位流失最严重的环节。火山引擎官方文档直接把"转化分析"定义为漏斗分析。
一个电商漏斗的典型结构:曝光/访问 → 点击/浏览详情 → 加入/下单 → 支付/复购。每一步都是"上一步用户中完成了本步行为"的比例。GrowingIO 官方文档显示,其漏斗分析支持自定义时间区间、自定义转化周期、属性维度拆分、用户分群对比与转化时长分布------这些能力正是跨端漏斗需要的。
跨端漏斗的三个前提
| 前提 | 为什么关键 |
|---|---|
| 统一事件口径 | Web 叫"click_buy"、App 叫"ClickBuy",漏斗根本串不起来。先统一命名与属性定义 |
| 统一用户身份 | 用户先在电脑浏览、后在手机下单,若识别不成同一人,转化被拆成两段,漏斗少算甚至算错 |
| 统一时间口径 | 各端时间戳、时区不一致,转化周期计算会偏差;统一到同一时区与同一"转化窗口"定义 |
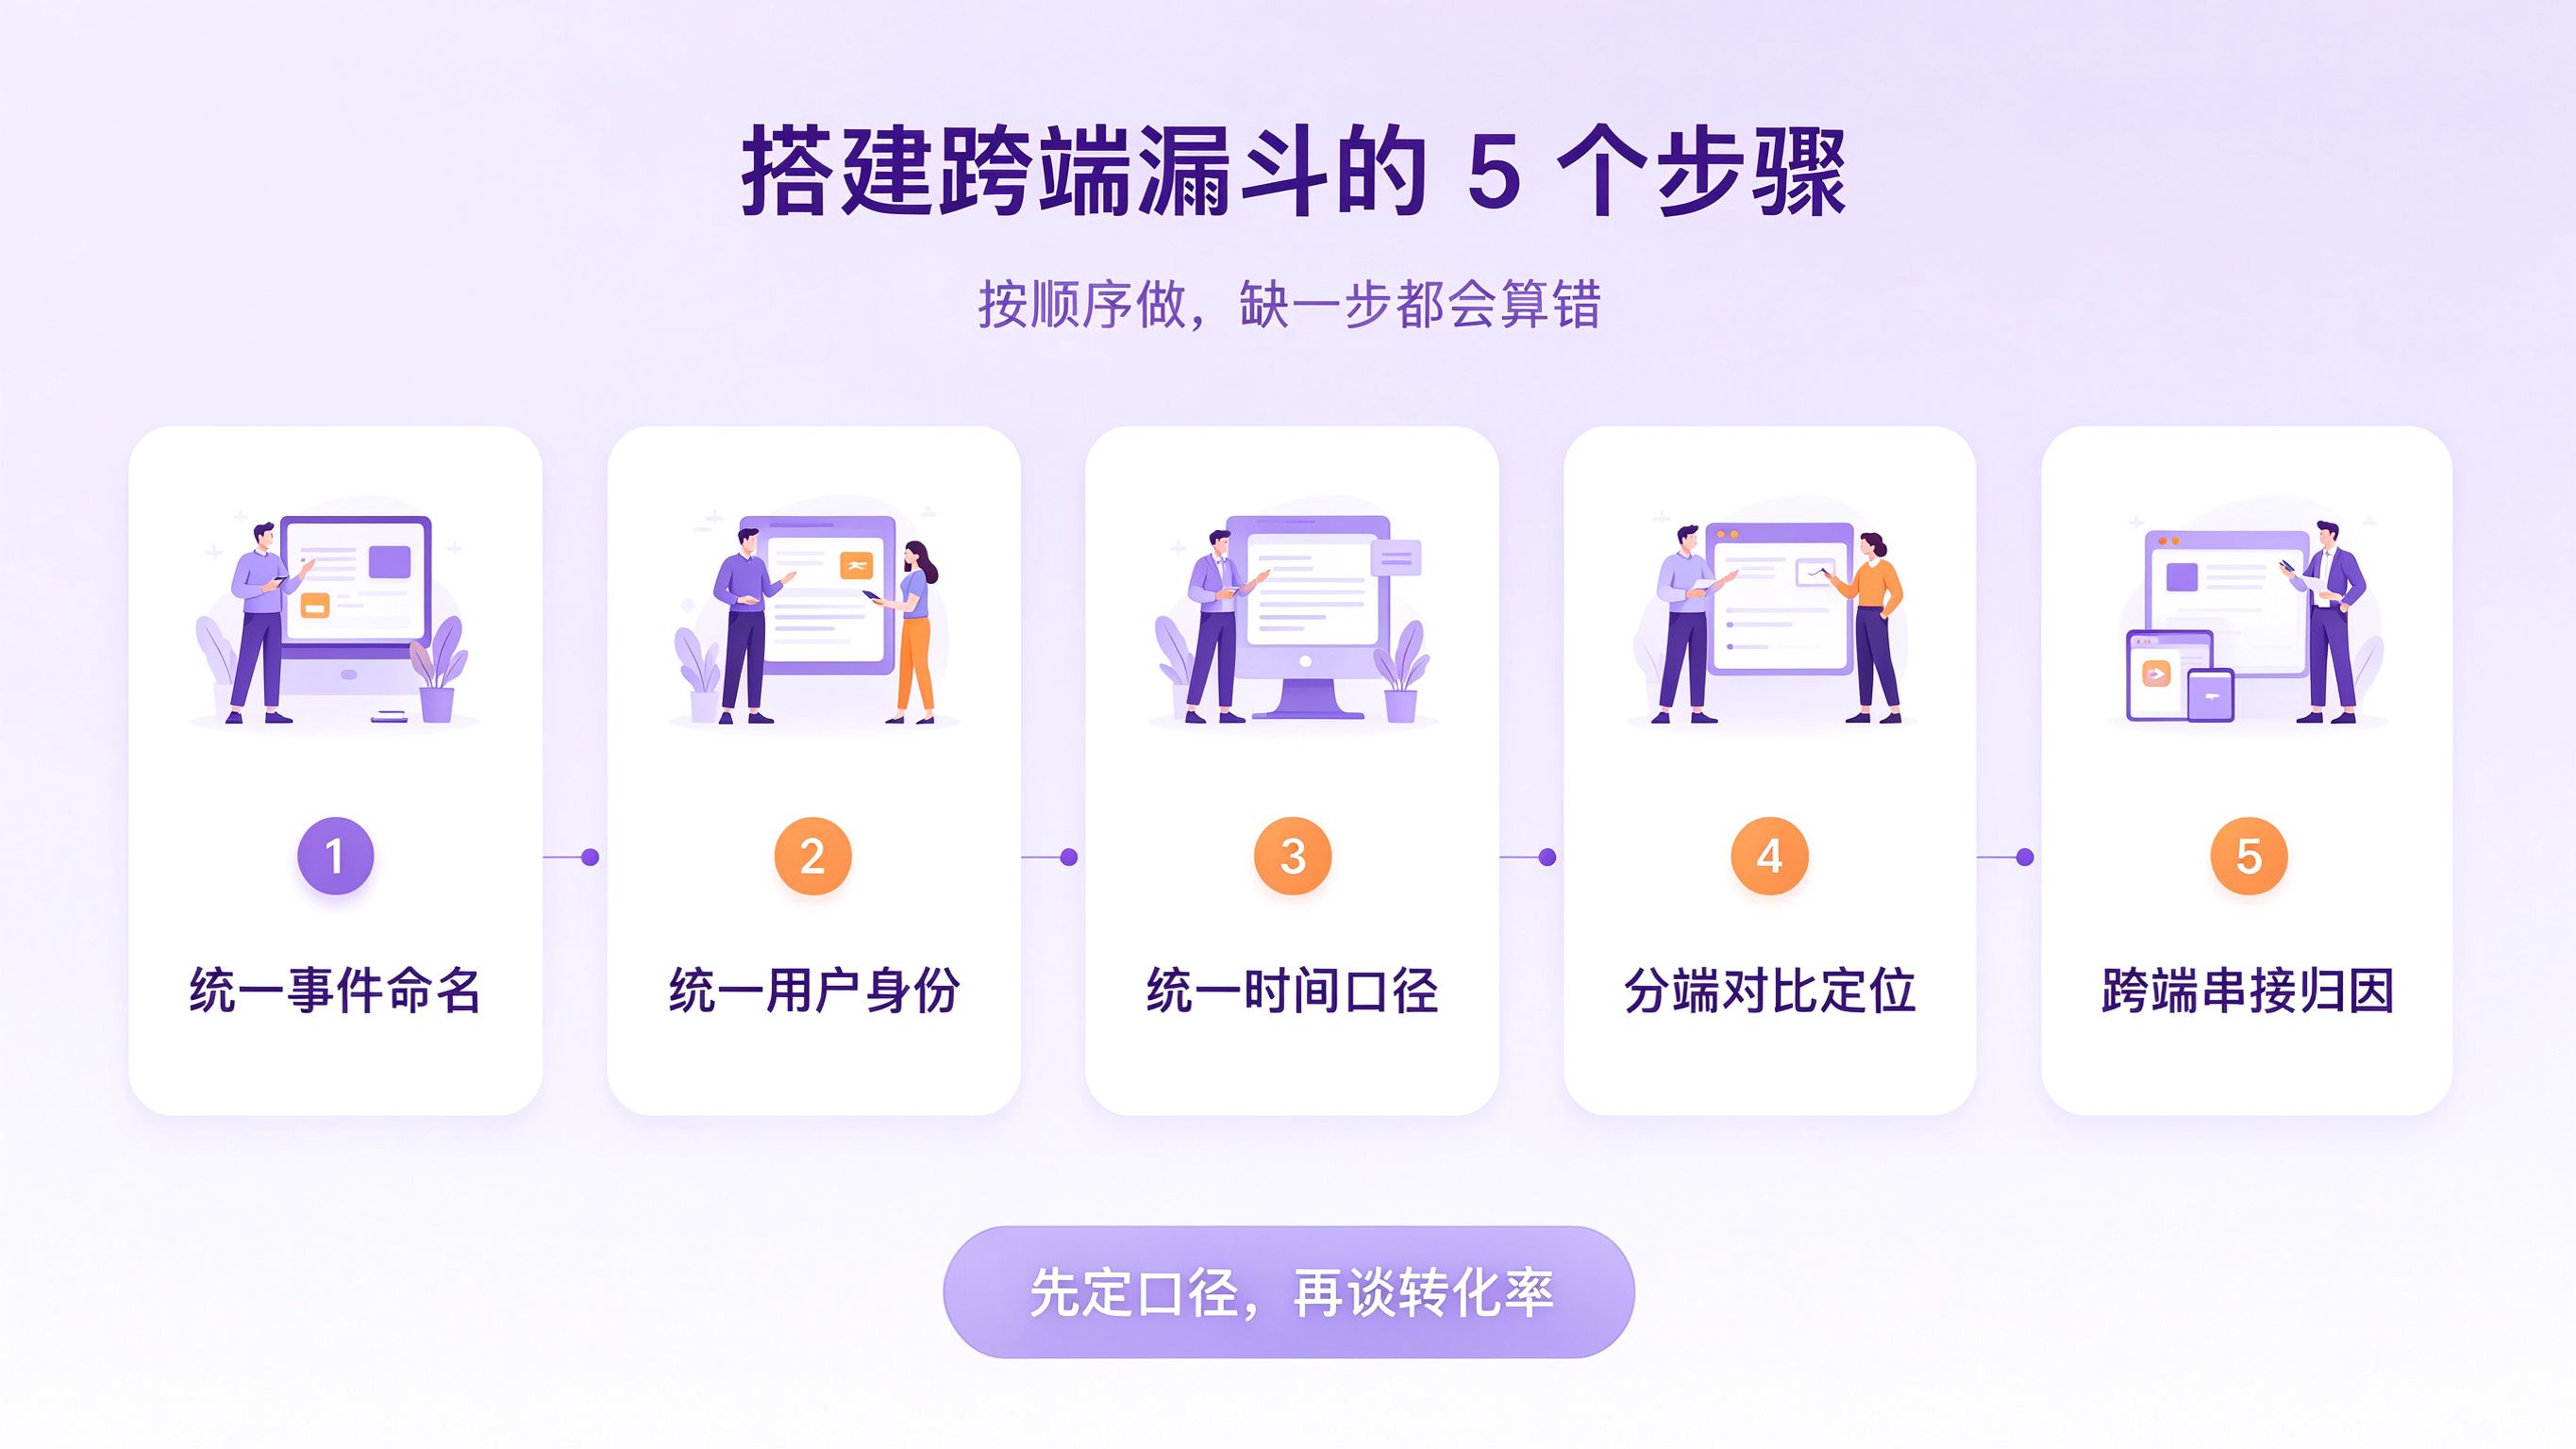 5 步搭出跨端漏斗
第 1 步
统一事件命名
建立事件字典:每个关键行为一个标准名(如 product_view、add_to_cart、checkout、pay_success),属性统一。多端埋点用同一套标准,这是后面所有步骤的地基。
第 2 步统一用户身份
登录态打通 + 设备 ID 兜底,必要时做 ID-Mapping 到 OneID,确保"同一个人的多端行为"挂到同一个身份上(原理见我上一篇跨端画像文章)。
第 3 步统一时间口径
统一时区与时间戳格式,明确转化周期的定义(如 7 天内完成算转化),避免各端各算各的。
第 4 步分端对比定位
先分别看 Web、App、小程序的单端漏斗,找到各自流失环节,再对比"同一环节在不同端的转化差异",定位体验短板。
第 5 步跨端串接归因
把各端行为按统一身份串成完整旅程,计算"跨端转化率"与"跨端贡献"(哪些转化由另一端的浏览触发)。跨设备归因的价值已被行业普遍认可,但各家研究给出的使用率与收益口径差异很大,这里我不引用具体数字,以免误导------归因结论请以你自己的口径为准。
转化率基准参考(注意口径)
漏斗做出来后,怎么判断"好还是差"?我整理了 2026 年几份行业综述的基准区间,注意:不同来源口径不同,只作参照,不作结论 。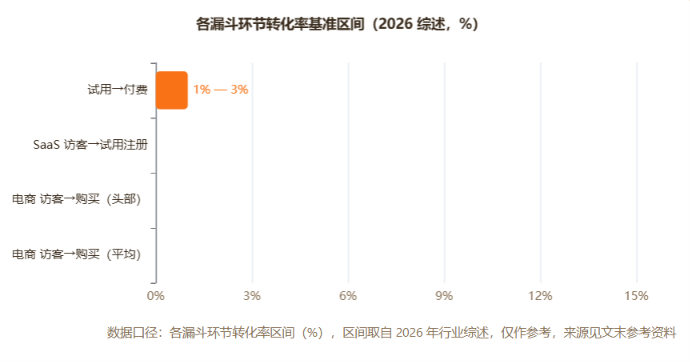
- 电商"访客→购买":平均约 1%---3% ,头部可到 4%---6%(Articos 2026)。
- SaaS"访客→免费试用注册":约 2%---5% ;试用转付费约 15%---25%(kissmetrics.io 2026)。
- 不同口径(会话级 vs 用户级、全渠道 vs 单渠道)结果差异很大,先用自己平台的历史数据建立基线,再对标外部。
附:三种常见跨端归因模型(结构对比,无具体数值)
| 模型 | 含义 | 适用场景 |
|---|---|---|
| 首次触点 | 把转化归因给用户旅程中第一个接触的端/渠道 | 衡量"来源端"的价值,适合评估拉新渠道 |
| 末次触点 | 把转化归因给下单前最后接触的端/渠道 | 衡量"转化端"的价值,适合评估承接渠道 |
| 多触点 | 按规则把贡献分摊到旅程中的多个触点(如平均、时间衰减) | 跨端旅程复杂时,避免单一模型带来的偏差 |
说明:归因模型选择属于业务口径决策,不同模型会得出不同结论;跨端场景建议至少同时看"首次触点"与"末次触点"两个模型。
踩坑记录:跨端漏斗最常算错的三个地方
踩坑复盘
现象 → 根因 → 修复
- **坑 1:漏斗"掉头"。**现象:App 漏斗第 2 步人数比第 1 步还多。根因:第 1 步事件漏埋,第 2 步事件被旧版本提前触发。修复:上线前用调试工具核对每步事件的实际触发量与先后顺序。
- **坑 2:转化周期没定义,跨端转化率忽高忽低。**根因:用户在手机上看了商品,一周后才在电脑上购买,被算成"非转化"或"长周期转化"两套口径并存。修复:全局统一转化窗口(如 7 天),并记录窗口配置。
- **坑 3:同一个用户被算成两个。**根因:未登录用户靠设备 ID,同一账号换设备后身份断裂。修复:登录态优先 + 设备兜底,见上文的统一身份步骤。
选型视角:什么样的工具适合搭跨端漏斗
跨端漏斗的前提是"统一",所以我把选型标准拆成三条:第一,是否支持统一事件、身份与时间口径(尤其是一套代码覆盖多端,能省掉大量对口径的功夫);第二,额度与价格是否公开可核验,避免用起来才发现成本超预期;第三,能否先用免费版验证核心场景,再决定投入。
以 456数据 官网公开信息为例:一套 SDK/代码覆盖网站、App、小程序,数据统一标准;用户行为分析包含事件埋点、漏斗、用户路径等分析模型,并且"分析与性能一体"(业务数据与性能数据打通);免费版 100 万 PV / 50 万事件量 / 年。它符合这三条里的多数条件,但能否满足你的具体场景,仍建议先用免费版实测后再决定。
以上是通用判断标准,不构成对任何平台的推荐。
7FAQ:跨端漏斗的高频问题
Q1:跨端漏斗和单端漏斗的数据能直接对比吗?
A:不能直接比。跨端漏斗包含多端贡献,转化率通常高于单端口径。对比时必须标注口径:是用户级、会话级,还是含跨端归因。
Q2:必须先做完 ID 打通才能做跨端漏斗吗?
A:严格说是。但可以分阶段:先做"端内漏斗 + 分端对比",同步推进登录态打通,再逐步合并为跨端漏斗,不必等全部打通。
Q3:转化率低于行业平均一定代表产品差吗?
A:不一定。行业基准口径混乱,你的漏斗可能包含了更多渠道或更宽的定义。先建自己的历史基线,再看相对变化,比对标外部数字可靠。
Q4:跨端归因怎么算?
A:常见有末次触点归因、首次触点归因和多触点归因。跨端场景建议至少同时看"首次触点(来源端)"与"末次触点(转化端)",避免只信单一模型。
Q5:小程序和 App 的事件能放进同一个漏斗吗?
A:能,前提是两者事件命名、身份体系、时间口径统一。用一套 SDK 覆盖多端的工具会省掉大量对口径的功夫。
参考资料(数据来源,可查证)
火山引擎官方文档《转化分析》(即漏斗分析)
GrowingIO 官方文档《漏斗分析》
漏斗转化率基准(Articos,2026)
转化率基准(kissmetrics.io,2026)
跨设备顺序切换行为(谷歌《The New Multi-Screen World》)
456数据 官网(全端数据分析与性能监控平台)