清华VPP2登顶RoboDojo:凭预测解耦突围GPT-6
目录
- 一、导语
- [二、先说清楚:VPP2 是什么,RoboDojo 又是什么](#二、先说清楚:VPP2 是什么,RoboDojo 又是什么)
- [三、它赢在哪:14B 模型靠"预测-动作解耦"突围](#三、它赢在哪:14B 模型靠"预测-动作解耦"突围)
- [四、榜单实测:VPP2 把谁甩在身后](#四、榜单实测:VPP2 把谁甩在身后)
- [五、现在就能跑:开源复现 VPP2](#五、现在就能跑:开源复现 VPP2)
- 六、冷静视角:登顶之外,三盆冷水
- 总结
一、导语
2026年10月8日,清华系具身公司星动纪元(RobotEra)在 GitHub 宣布,其自研的世界动作模型 VPP2(Video Prediction Policy 2)登顶 RoboDojo-Sim 官方榜单,以 39.26 分、32.26% 平均成功率拿下综合第一,并在泛化、精细操作、记忆等维度领先,把上个月刚跨界登顶的 GPT-6-Astra、以及 Physical Intelligence 的 π0.5、英伟达 GR00T-N1.7 等一众头部模型甩在身后。更扎眼的是,这是一个只有 14B 参数、不靠额外数据、不开外挂增强、且完全开源可复现的模型------性能提升不是靠"堆料"或"刷分",而是来自预训练基座本身的泛化。
二、先说清楚:VPP2 是什么,RoboDojo 又是什么
先把两个容易被名字劝退的概念拆开。
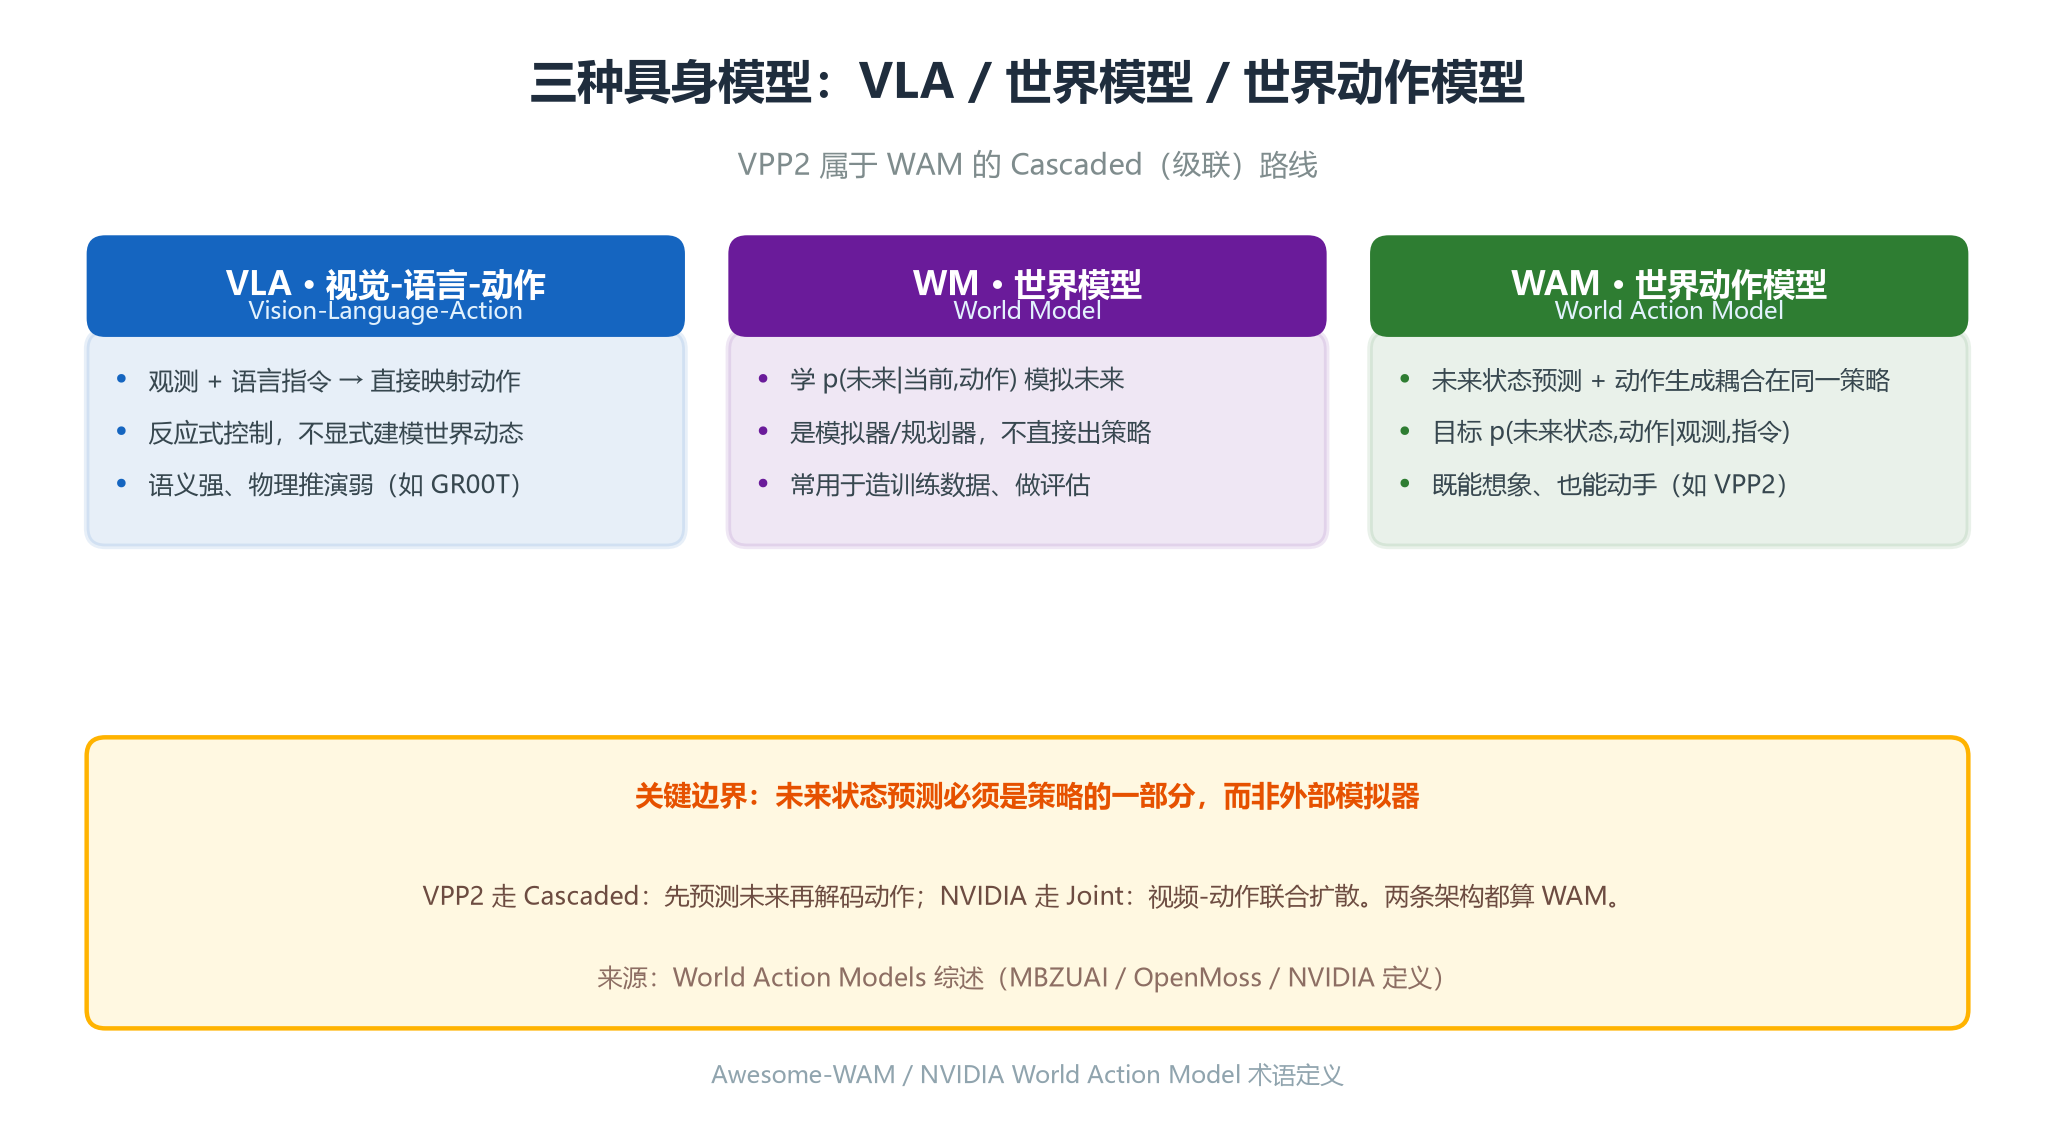
VPP2 属于"世界动作模型"(WAM,World Action Model)。 这个名字要和两类更常说的模型区分开:
- VLA(视觉-语言-动作模型),比如英伟达 GR00T:把"看到什么 + 听到什么指令"直接映射到"该做的动作",本质是反应式控制。它语义理解强,但大多不显式建模世界的物理演变。
- 世界模型(World Model),比如星动纪元自己 2 月登顶 WorldArena 的 Ctrl-World:学的是"如果这么做,世界会变成什么样",本身是模拟器/规划器,并不直接输出机器人策略,常用来批量造训练数据。
- 世界动作模型(WAM) :把"预测未来状态"和"生成可执行动作"耦合进同一个策略框架,目标不是只想象,而是想象完直接动手。VPP2 走的是 Cascaded(级联) 路线------先想清楚未来会怎样,再据此解码动作,而不是把视频和动作"一锅炖"。
多说一句 WAM 内部的两条技术支线。同样叫"世界动作模型",有的走 Joint(联合) 路线------视频预测和动作决策共享同一套参数、端到端一起训;有的走 VPP2 这种 Cascaded(级联) 路线------先独立把视频预测器训扎实,再外接一个动作专家。Joint 看似更"原生",但实践中动作噪声极易回灌污染视频表征,导致"看不准 → 做不对"的连锁崩塌;Cascaded 用显式解耦换来了模块独立优化的空间,代价是多一道接口工程。VPP2 选 Cascaded,本质上是用工程上的"分步可验证"去换训练上的"稳"------视频预测器可以先单独评测、单独迭代,确认"眼睛"够准了,再谈"手"的事。
(图二:VLA / 世界模型 / 世界动作模型 三者区别)
RoboDojo 又是什么? 它是一个由香港大学 MMLab(罗平教授、陈天行博士)牵头,联合 UC 伯克利、清华等全球近 20 所机构共建的统一评测基准,背后是 RoboTwin 原班人马,被业内戏称为"具身智能界的珠穆朗玛峰"。它干的事用一句话概括:给全世界的机器人模型办一场"统一高考"------过去各家发 Demo、报成功率,但考卷不同、硬件不同、评分标准不同,横向比较几乎无从谈起;RoboDojo 把 42 个仿真任务、18 个真实机器人任务、30 个主流策略模型塞进同一套评分,覆盖泛化、记忆、精细操作、长程执行、开放语义理解五大能力。这五个词各有实指:泛化考"换个物体、挪个位置还灵不灵",记忆考"长任务做到一半还记不记得前置状态",精细操作考"东西摆歪了还能不能抓准",长程执行考"连续多步不跑偏",开放语义考"听懂模糊自然语言指令"。也正是因为这套卷子专挑机器人不擅长的地方出题,想靠刷熟练度蒙混过关基本没戏。
三、它赢在哪:14B 模型靠"预测-动作解耦"突围
VPP2 最反直觉的地方在于:它没去卷参数量,也没在测试时偷偷加数据或接 Agent 增强(Agent RSI 这类手段没用),而是把功夫花在了一条更朴素的技术路线上------先把视频预测练到足够强,再让机器人真正动起来。
具体是一条三阶段的训练流水线:
(图三:VPP2 三阶段训练流程------练眼、提速、练手)
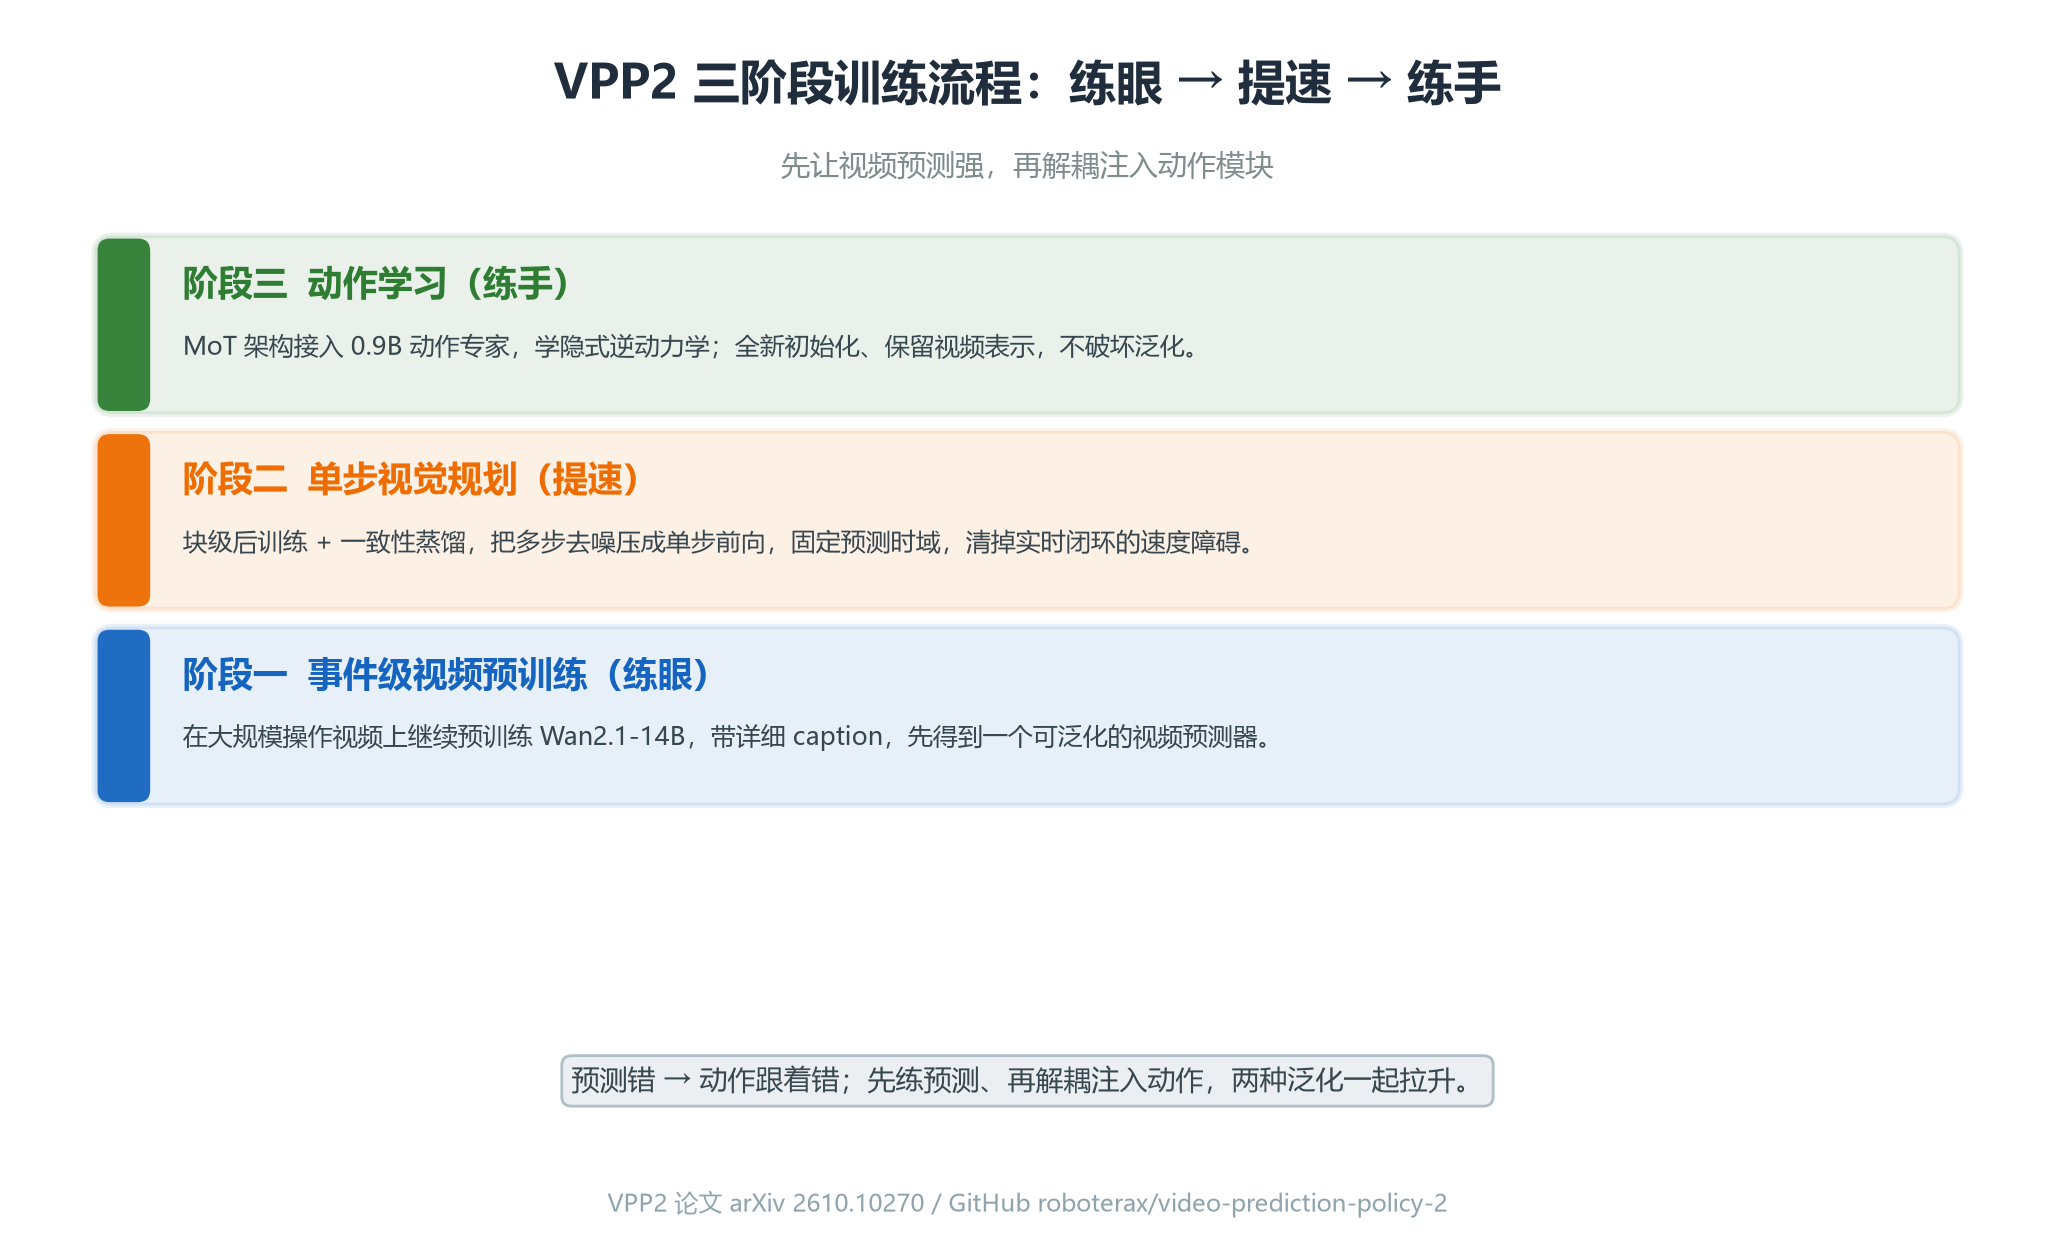
- 事件级视频预训练(练眼):在覆盖完整操作轨迹的大规模视频上继续预训练底层的 Wan2.1-14B 视频模型,并给片段打上详细文字描述,目标是先得到一个能泛化到开放任务的可信视频预测器,而不是急着出动作。
- 单步视觉规划(提速):把事件级片段切成固定时域的视频块后训练,并引入一致性蒸馏(Consistency Distillation),把原本需要多步迭代去噪的生成过程压成"单次前向出结果",为实时闭环清掉速度障碍。
- 动作学习(练手):最后才引入一个仅 0.9B 参数的动作专家,用混合 Transformer(MoT)架构学习隐式逆动力学,根据视频预测反推该执行的动作;动作模块全新初始化、全程保留视频表示,从而注入动作能力时不破坏前面练出的泛化性。
这条路线的针对性很强。世界动作模型一道老大难是:预测错了,动作就跟着错。如果视频和动作从一开始就搅在一起训,动作噪声会反过来污染本就不稳的视频表征,导致泛化崩塌。VPP2 反过来------先让"眼睛"在大量无动作标注的视频上把世界动力学学扎实,再单独接一个轻量"手",于是视频预测和动作生成两种泛化被一起拉升。论文里的两组数字能说明问题:在开放任务的视频预测指令跟随成功率上,VPP2-14B 比 Cosmos3-64B 高 11.0 个百分点;在真实零样本 ALOHA 操作任务上,比最强基线高 18.5 个百分点。换句话说,基座视频模型练得越准,下游动作就越不容易"想错导致做错"。
单步蒸馏这一步对真机部署尤其关键。机器人控制讲究闭环时延------如果每一步都要视频模型迭代去噪几十次才能出预测,等"想清楚"的时候手早就抖了。VPP2 把生成过程压成单次前向,等于把"思考"的时间成本降到了和反应式 VLA 同量级,却保留了预测式模型的泛化优势。代价是蒸馏会损失一点视频保真度,但动作专家只取视频里的语义和时序线索、对像素级细节并不敏感,所以这点损失在动作维度几乎无感。这也解释了为什么它能在"不接 Agent 外挂"的前提下还跑得动实时闭环:省掉的不是模型能力,而是推理链路上的冗余计算。
此外,VPP2 还用一个 VLM 承担分层高层规划:面对"收拾餐桌"这类模糊的长任务,VLM 把它拆成一串详细子任务描述,再依次交给动作专家------VLM 管推理、语义和记忆,动作专家管底层执行。这种"预测-动作解耦 + 分层规划"的组合,正是它不靠额外数据也能泛化的根因。把视野拉回清华系的技术脉络,这条解耦思路同星动纪元 2 月登顶 WorldArena 的 Ctrl-World 世界模型其实一脉相承:前者擅长"造出高保真的虚拟训练场",后者擅长"在虚拟里想清楚后直接动手",同一个人马,把"会想象"和"能动手"两件事都推到了头部。Ctrl-World 当时在 WorldArena 具身任务上拿下全球第一,四大维度全部登顶------主体一致性 0.8411、轨迹精度 0.4766、深度精度 0.9300、策略评估 Pearson 相关系数 0.986,而同期英伟达同类方案在策略评估一栏只有 0.483。也就是说,星动纪元先把"让世界模型会想象、且想象得可信"做到头部,再用 VPP2 把"想象完能落地动手"也补齐。这比单篇登顶更能说明团队的技术连续性和数据飞轮的扎实程度。
四、榜单实测:VPP2 把谁甩在身后
把 VPP2 放进 RoboDojo-Sim 的同一张考卷里看,差距是量化的。更新后登顶的那一版,VPP2 拿到 39.26 分、32.26% 平均成功率,综合第一;在泛化、精细操作、记忆等维度也都居首。
| 排名 | 模型 | 类型 | 机构 | 得分 / 成功率 |
|---|---|---|---|---|
| 1 | VPP2 | WAM | 星动纪元(清华系) | 39.26 / 32.26% |
| 2 | PhysicalRSI | Agent+VLA | HKU MMLab & KAI | 36.27 / 31.38% |
| 3 | Awomo-0.5 | WAM | Awomo | 35.34 / 29.64% |
| 4 | Simate-beta | VLA | Simate | 33.95 / 27.96% |
| 9 | GPT-6-Astra | Agent | RoboDojo Team | 28.97 / 22.48% |
(图一:RoboDojo-Sim 主要模型得分对比,VPP2 登顶)
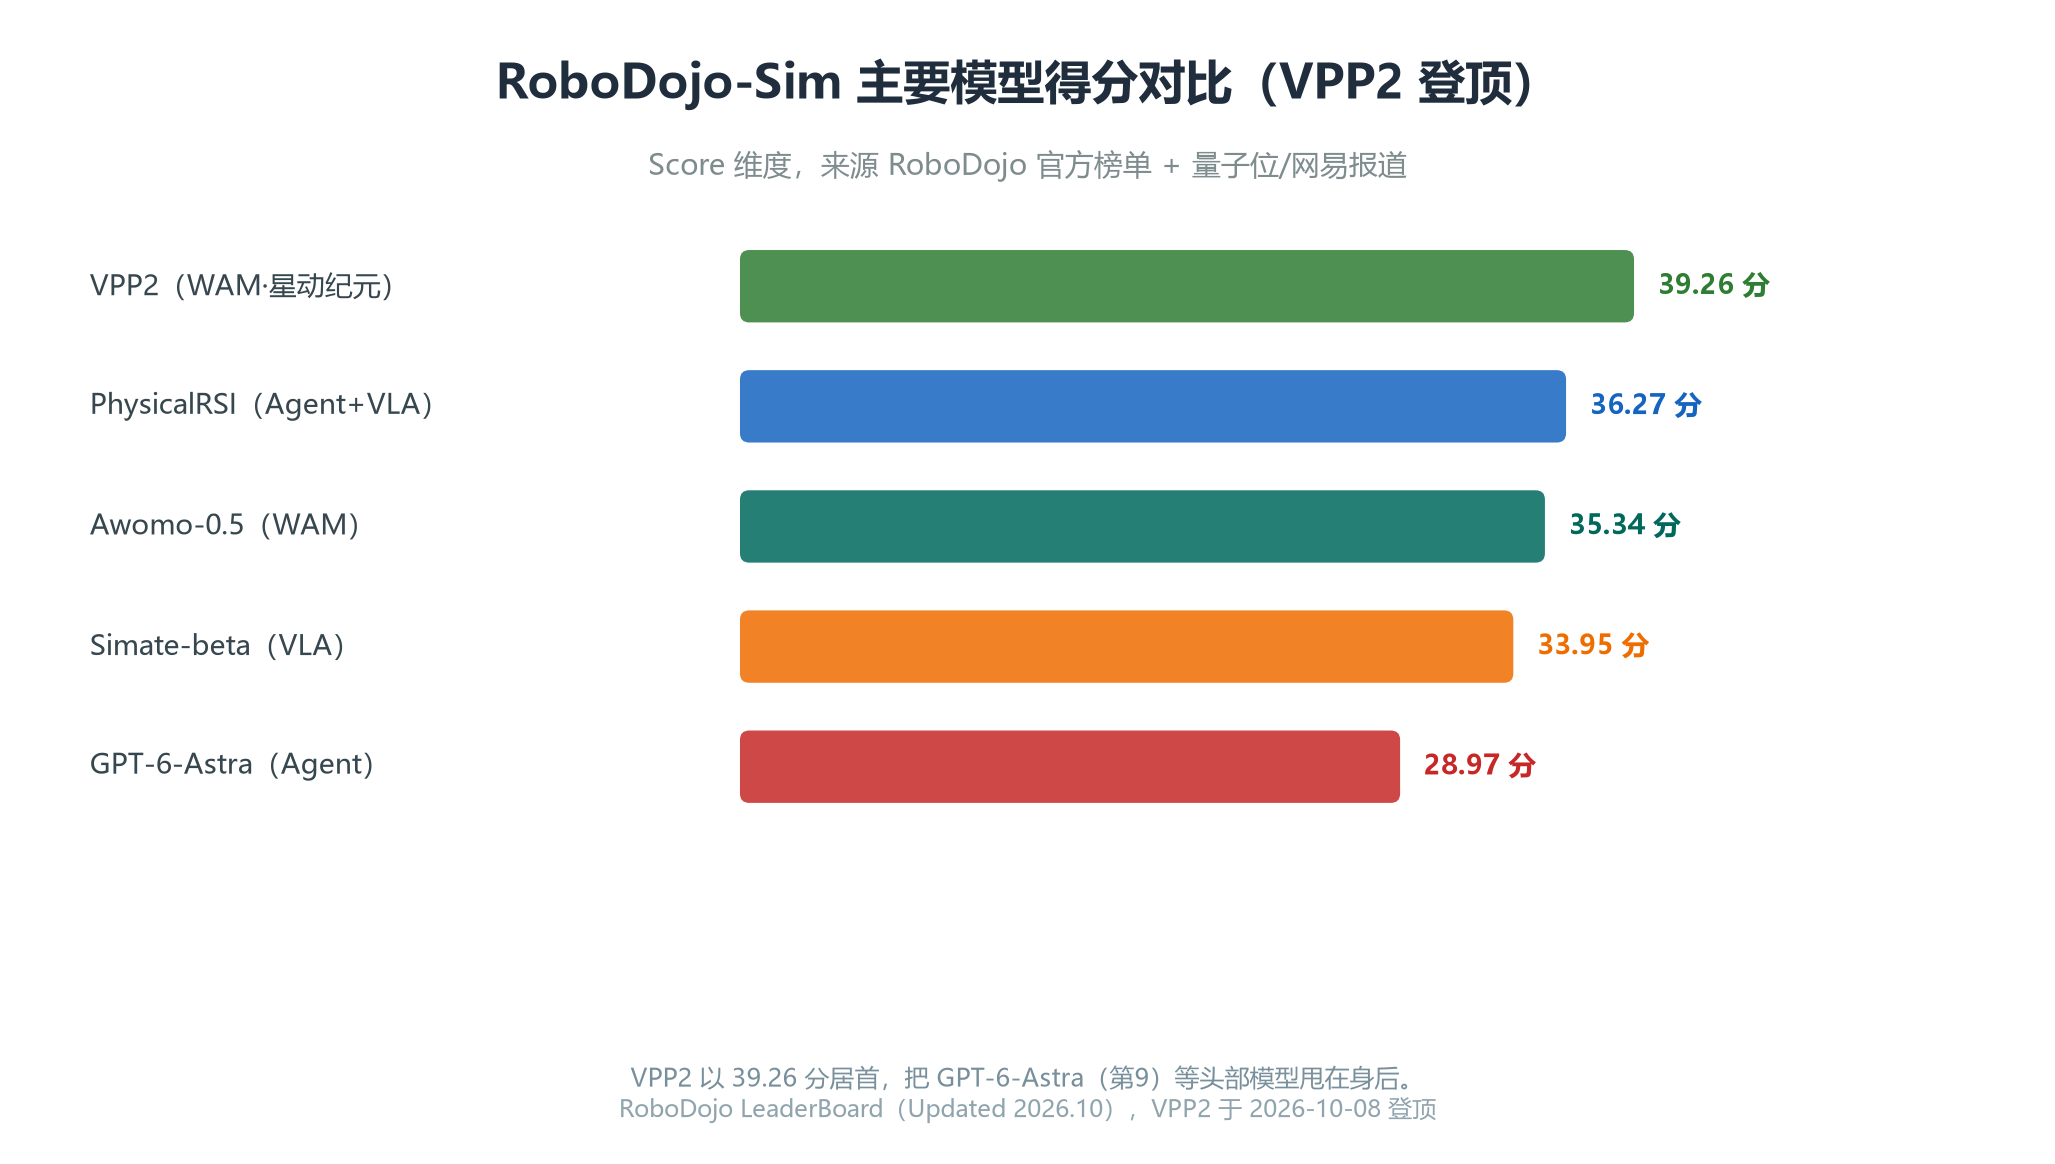
几个读数值得记一下:第一,被甩开的不只是"传统具身公司"------上个月刚跨界来考机器人、引发"通用大模型下场抢饭碗"讨论的 GPT-6-Astra,这次掉到了第 9;第二,VPP2 是榜上少有的"开源 + 无额外数据 + 无 Agent RSI"夺冠模型,意味着它的分数不是测试期工程堆出来的;第三,它击败的对手里既有 WAM 同赛道(Awomo-0.5),也有 VLA 和 Agent 路线,说明"预测-动作解耦"这条路线在当前考卷上暂时压过了"直接映射"和"接外部推理"。不过也要看清,榜单按"平均得分"排序,VPP2 在长程执行、开放语义这两个维度并非第一,它的领先主要来自泛化、精细操作与记忆------这恰好对应它"视频预测强 → 动作泛化强"的技术长板。
"综合第一"不等于"每个维度都第一",这个结构反而值得工程团队记下来:如果你的场景是"同一张桌子换个不同形状的物体去抓",VPP2 的高泛化红利最容易吃到;如果你的场景是"听一句模糊自然语言指令、连续干十分钟家务",那它还远没到能独当一面。换句话说,选模型不能只看榜单名次,得先看自己的任务落在五个能力里的哪几格------VPP2 当前最强的三格(泛化、精细操作、记忆)恰好对应"视频预测长板 → 动作泛化外溢"这条因果链,而它没拿首的两格(长程、开放语义)恰恰更吃"持续推理与抽象规划",这部分的差距不是换基座能立刻补上的。
五、现在就能跑:开源复现 VPP2
VPP2 是开源的(代码 MIT 许可,模型权重上 Hugging Face 与 ModelScope),官方仓库 roboterax/video-prediction-policy-2 自带 RoboDojo、LIBERO 等评测脚本。想自己复现这次登顶,有两条路。
路径一:官方完整复现(带环境)
bash
# 1) 克隆并建环境(Python 3.10)
git clone https://github.com/roboterax/video-prediction-policy-2.git
cd video-prediction-policy-2
conda create -n vpp2 python=3.10 -y
conda activate vpp2
pip install -r requirements-train.txt -c environment-reference.txt

# 2) 取权重(Hugging Face 公开;ModelScope 需账号)
#    Haodong082399/VPP2 下包含 RoboDojo 的 Video / Action 配对 checkpoint

# 3) 跑 RoboDojo 闭环评测(configs/robodojo/ 下配置)
python tools/eval_robodojo.py --config configs/robodojo/eval.yaml \
    --video_ckpt <Video权重> --action_ckpt <Action权重> \
    --output predictions.jsonl
路径二:只看架构、不跑全量评测
显存或数据不够时,可以先把论文的三阶段流水线当成"设计模板"读:用一份事件级操作视频做视频预测继续预训练 → 一致性蒸馏成单步规划 → 接一个小型 MoT 动作专家。哪怕不训机器人,这套"先练预测、再解耦注入动作"的顺序,对做视频生成或仿真数据引擎的人也有参考价值。读代码时建议重点看三处:event_level_pretrain 的数据组织方式、consistency_distill 的单步蒸馏损失、以及 action_mot 里动作专家如何只接视频表示而不重训主干。
对资源有限的团队,直接复现 14B 的视频预训练不现实,但"三阶段解耦"的思路可以降维借用:用你手里已有的操作视频先只做视频预测继续预训练(即便 backbone 小几号),再把动作模块做成可插拔的轻量专家,而不是一上来就端到端硬训。这样做有两个实在的好处------视频预测器能独立评测、单独迭代,动作模块坏了也能单独换;同时视频侧积累的数据和表征,未来还能复用到仿真数据合成、异常检测等别的任务上,投入不是一次性的沉没成本。换句话说,VPP2 给中小团队最大的启发,可能不是"去买 14B 算力",而是"把预测和动作切开训"这个工程顺序本身。
跑的时候重点看三件事:泛化维度(换个物体/场景还灵不灵)、记忆维度(长任务中途是否还记得前置状态)、以及单步蒸馏后的推理时延------这三项是 VPP2 这次真正拉开的差距,也是它能不能落地到真机的关键。
六、冷静视角:登顶之外,三盆冷水
VPP2 的登顶值得记一笔,但把它放回整个领域看,有三处得降温。
- 榜单整体水位还很低。 RoboDojo 公开资料显示,当前最强模型在仿真任务平均成功率仅约 8.8%、真实世界任务最高约 12.8%,而人类专家分别是 76.03% 和 100%。换句话说,VPP2 拿的是"矮子里拔将军"的第一,距离"机器人真能干活"仍有数量级差距;把它读成"具身智能已经通关"是严重的过度解读。
- "登顶 GPT-6"不能简单读成"具身超越通用大模型"。 GPT-6-Astra 在 RoboDojo 走的是 Agent 路线(外接推理),和 VPP2 的端到端 WAM 路线考核重点不同;一个是"派一个会思考的代理去考",一个是"让模型自己动手考",直接比名次容易误导。更稳妥的解读是:在"统一高考"的同一张卷子上,当前 WAM 路线在动手类任务上暂时占优,而非通用大模型被"击败"。
- 开源 ≠ 真机落地,时延仍是坎。 VPP2 的优势建立在大量视频预训练与单步蒸馏之上,但 WAM 类模型在推理时延、3D 空间精度(单目视频训练带来的深度偏差)、跨本体适配上仍有公认短板。论文也只承诺了仿真与有限真机零样本结果,距离工厂、家庭这类非结构化现场的稳定部署,中间还隔着数据、本体和安全的长链条。
第三盆冷水之外,还要补一句关于"基准本身"的提醒。RoboDojo 把 42 个仿真任务、18 个真实任务、30 个策略塞进同一套评分,价值在于"终于有了可横向比较的考卷",但考卷的设计天然偏向它列出的五大能力,并不覆盖具身落地要面对的全部麻烦:本体异构、安全合规、长周期维护都不在分数里。所以既不能因为一次登顶就神话某个模型,也不能因为"真机只有 12.8%"就否定它的意义------它至少把"谁的基座更会泛化"这件事量化了出来,给后来者一个明确的追赶靶子。
把时间轴拉长看,清华系(星动纪元)在两条赛道上的连续登顶更有意思:2 月 Ctrl-World 在 WorldArena 拿下世界模型具身任务全球第一,10 月 VPP2 又在 RoboDojo 拿下世界动作模型第一。同一个团队,先把"让机器人会想象"做到头部,再把"想象完能动手"也做到头部------这比单篇登顶更能说明,具身智能的竞争正在从"Demo 谁更炫"转向"谁的基座更会泛化、谁的数据飞轮更扎实"。
总结
VPP2 是清华系星动纪元推出的世界动作模型,以 14B 参数、不靠额外数据与外挂增强、完全开源的姿态登顶 RoboDojo-Sim,把 GPT-6-Astra、π0.5、GR00T 等头部模型甩在身后。它的核心不在堆料,而在"先练视频预测、再解耦注入动作"的三阶段路线------用预测-动作解耦换来了真正的零样本泛化。对做具身智能和仿真数据引擎的团队,这是一份可复现、可拆解的样本;但也要看清,榜单整体水位仍低、路线对比不宜神化、真机落地还早。下一步值得盯的是:当更多团队采纳"预测-动作解耦"这条路线,WAM 能否把那一纸 12.8% 的真实世界成功率真正往上推。