简介:拿到项目先用 SDD、Harness、Loop 三种思维想清楚,再把已有文档变成施工方案,最后用 Spec-Kit 把需求拆成可执行的任务
AI 编程改变了什么
简介:目的没变,变的是路径;核心动作从「写代码」变成「驾驭 AI 把事做成」
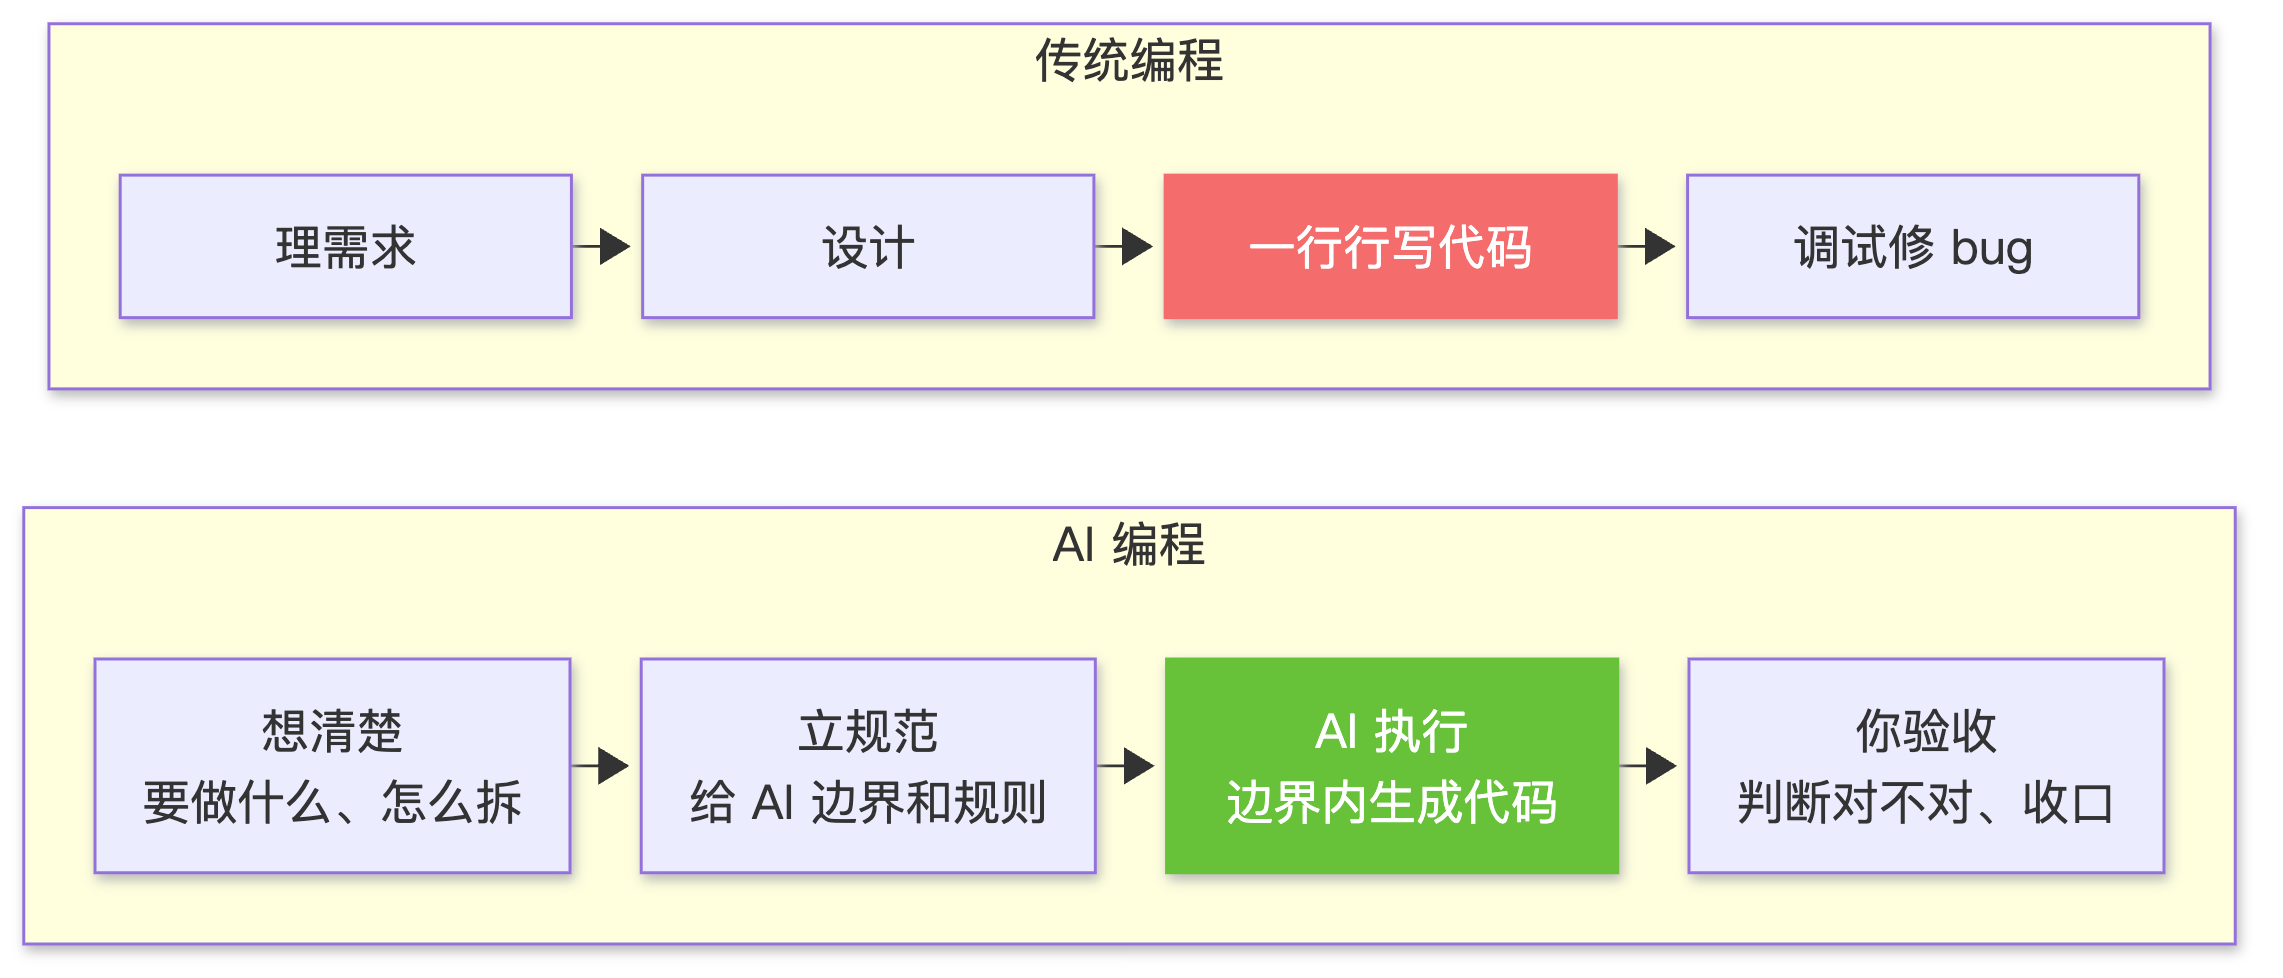
- 两种做法对比
-
红色是传统编程的核心动作,绿色是 AI 编程里交出去的执行
-
传统编程的思考绕着「这段代码怎么实现」转
-
AI 编程的思考绕着「怎么更快更好地把事做成」转,代码从「你判断、AI 执行、你验收」这条新链路产生
-
变了什么
| 维度 | 传统编程 | AI 编程 |
|---|---|---|
| 核心动作 | 写代码 | 驾驭 AI |
| 思考重心 | 实现细节 | 设计、拆解、验证 |
| 衡量标准 | 代码量、提交数、bug 数 | 把事做成 |
| 依靠 | 手感 | 判断 |
- 没变什么
- 目的:更快更好地产生价值
- 动手前要先想清楚需求
- 工程判断力依然是核心,计算机基础照样躲不掉
拿到项目的三种思维
简介:别从「第一行代码」想起,用 SDD、Harness、Loop 三个角度把「怎么做成」想清楚
| 思维 | 想什么 | 目的 |
|---|---|---|
| SDD | 怎么拆分:拆成什么、规格是什么 | 把模糊需求拆成清晰、可执行的块 |
| Harness | 怎么立规范:给 AI 什么边界、规则、怎么验证 | 把约束架好,AI 才不跑偏 |
| Loop | 怎么自动化:哪些步骤让 AI 在循环里自己跑、哪里设检查点 | 把执行循环设计好 |
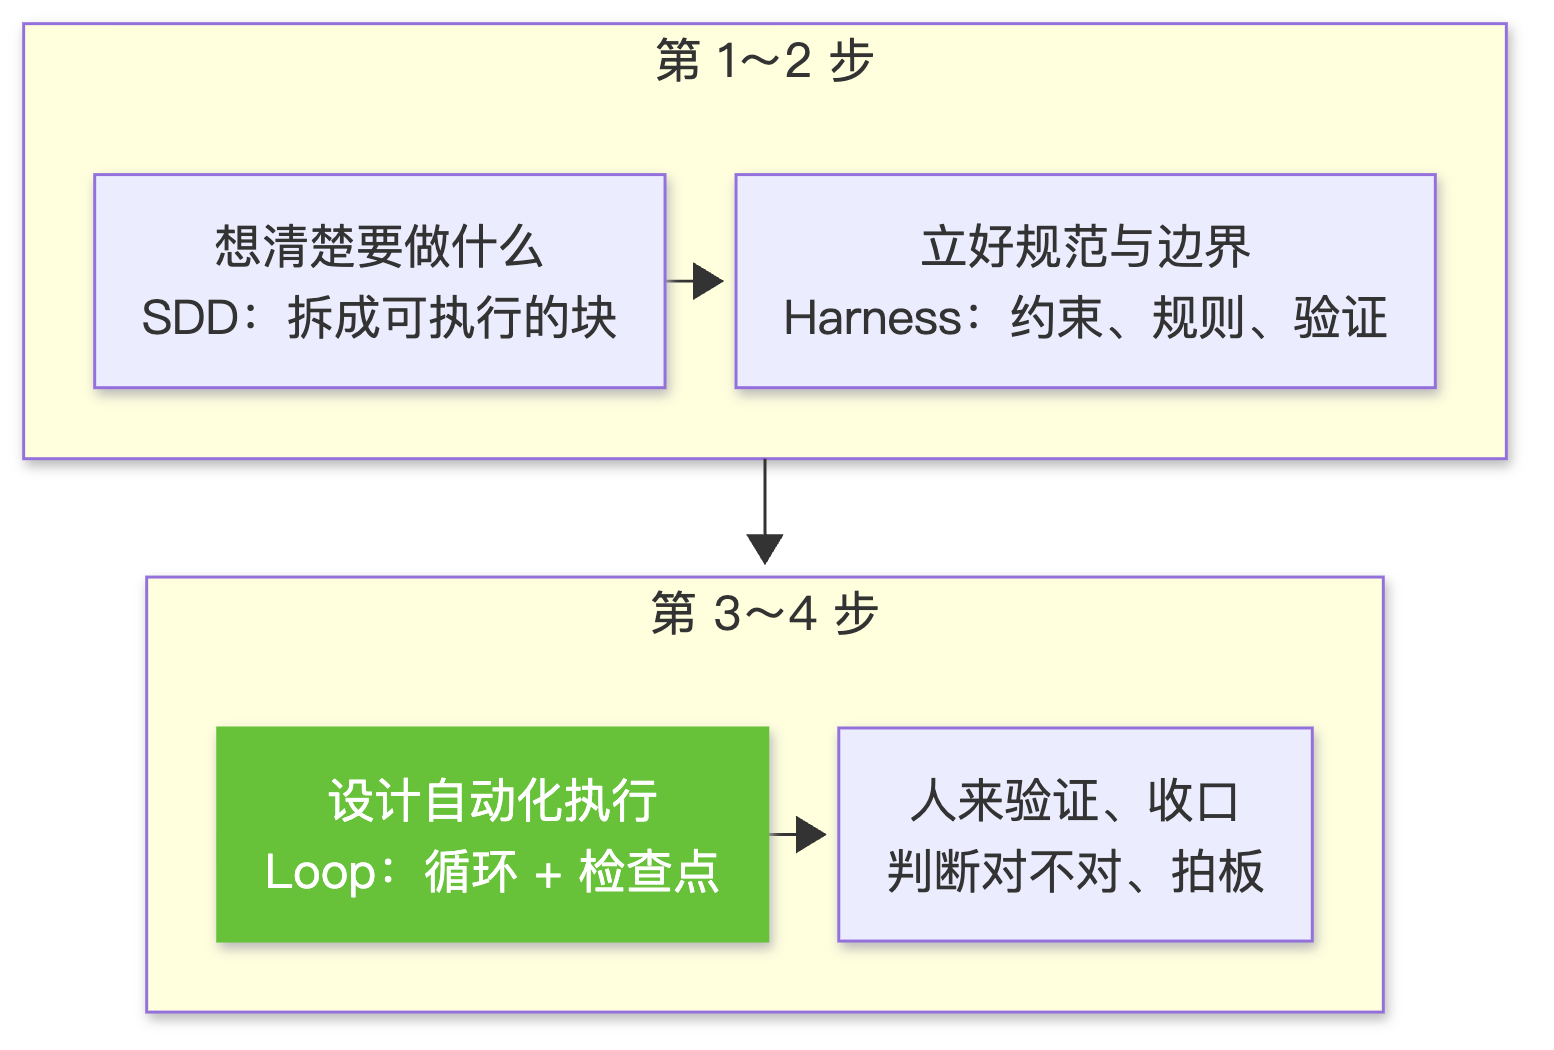
- 一条思考路径
-
绿色这一步交给 AI 执行,其余三步是人的
-
顺序不是死的,但这套骨架最稳
-
控制权在人手里
| 人定的(判断不能交出去) | AI 做的(执行可以交出去) |
|---|---|
| 拆分方案:拆成什么块 | 在划好的边界内生成代码 |
| 规范与边界:什么能做、什么不能 | 按规格逐个执行任务 |
| 关键技术决策:选哪条路线 | 做完自动跑检查 |
| 验收标准:什么算做对了 | 卡住时把情况报告给人 |
- 注意点
- 三种思维是「想」的三个角度,不是三个工具操作,先在脑子里想清楚再落到工具
- 执行可以交出去,判断不能;人是工作流的设计者,不是旁观者
选择落地模式:为什么主体用 Spec-Kit
简介:SDD 有三种落地模式,没有最好只有最合适,按项目类型和能力阶段切换
| 模式 | 工具 | 分工 | 适合 |
|---|---|---|---|
| 自动化 | Spec-Kit | AI 拆任务 + 执行,人写 spec、review | greenfield 中大型、需求清晰、新手学方法论 |
| 手动控制 | OpenSpec | 人拆任务,AI 只执行单个;delta-spec 写增量 | brownfield 改造、资深、系统级 |
| 轻量手工 | CLAUDE.md + Skill | 不用 SDD 工具,方案在脑子里跑通,AI 一段段执行 | 熟悉的技术栈、小改动 |
-
greenfield:从零开发的新项目;brownfield:在老代码上改造
-
企业级 Agent OS 项目对照 Spec-Kit 适用场景,五条全中
- greenfield:全新项目,不是改造老代码
- medium 规模、模块清晰:9 个 Maven 模块、五大核心能力
- 需求清晰:已有完整需求文档 + 技术方案
- AI agent 协作:本来就用 Claude Code 做主体开发
- 方法论场景:强制 spec 流程,能学到工程方法论
-
结论
- 主体开发用 Spec-Kit,增量阶段切手动提示词,OpenSpec 作对照理解 delta 范式
已有文档怎么喂给 Spec-Kit
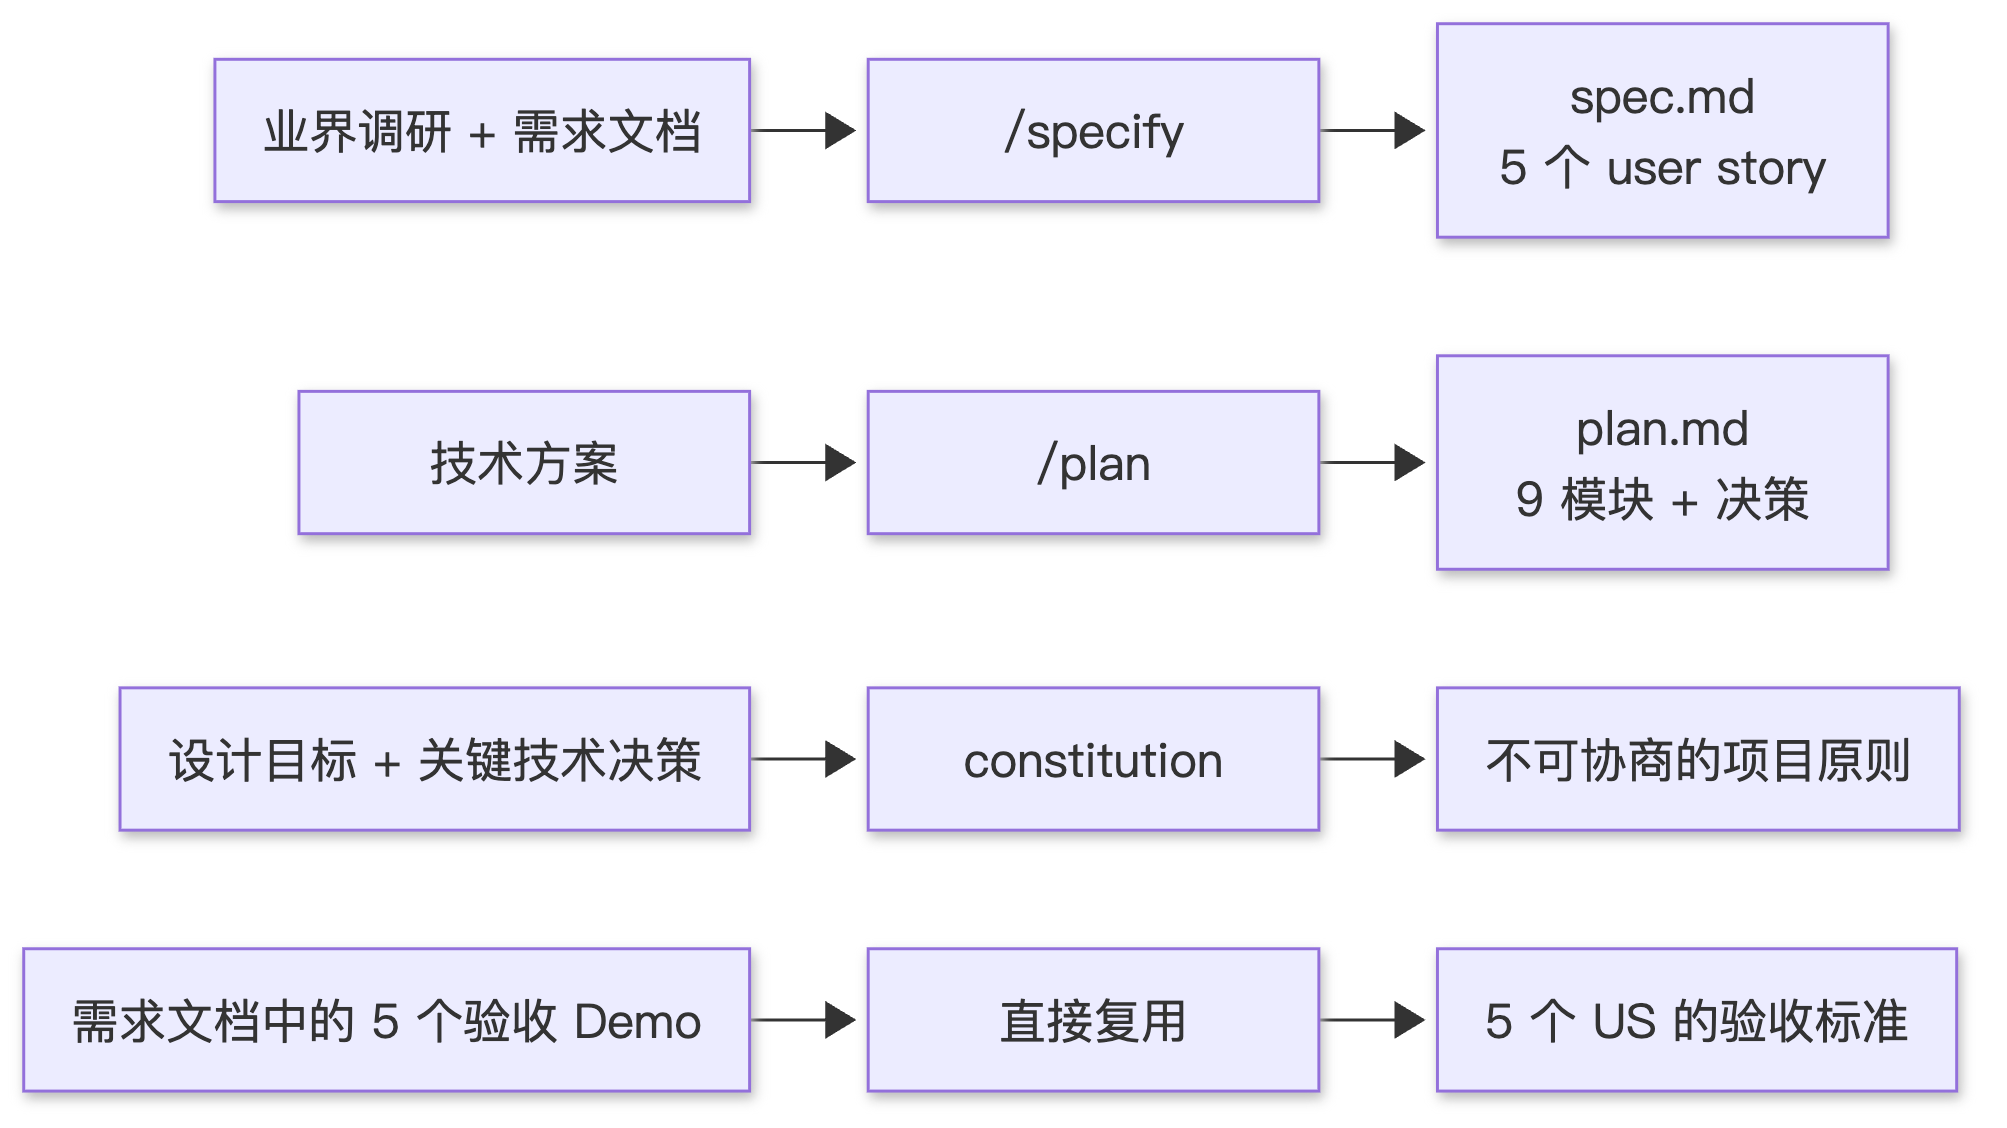
简介:已有的调研、需求、技术方案不重写,只是转成 AI 能直接消费的格式
-
喂的必须是最新版文档,例如模块是 9 个而不是旧版的 11 个,否则 plan 会按错误结构走偏
-
准备阶段:先产出三份 artifacts
| 步骤 | 产物 | 内容 |
|---|---|---|
| 1 | constitution | 项目宪法:非协商原则,所有命令都引用 |
| 2 | specify | 把需求转成 5 个 user story 的 spec |
| 3 | plan | 技术栈 + 9 模块职责 + 关键技术决策 |
-
三份产物放进
.specify/,整个主体开发期间作为依据 -
plan 生成后必须人工 review:防止 AI 把 Memory 合进 Session、把 Tool 拆成多模块、或启用 Spring AI 自动执行
-
constitution:把最容易写错的先钉死
| 原则 | 内容 |
|---|---|
| 自实现 ReAct | 循环自己写,不用 Spring AI 的 Agent 抽象,核心完全可控 |
| Spring AI 只用一半 | 只用 Provider 抽象 + schema 生成,禁用自动 tool 执行,否则 tool 会被调两次 |
| 审计 day one 落库 | tool_invocations / llm_calls 核心阶段就写库,不是只写日志 |
| 五大能力优先 | 先交付运行时内核,多租户、SSO 等治理放扩展阶段 |
- AI 生成的代码违反这几条,立刻让它重读 constitution 改正
任务拆解、协作纪律与节奏
简介:按 user story 拆而不是按时间拆,5 个 US 对应五大核心能力,按依赖顺序推进
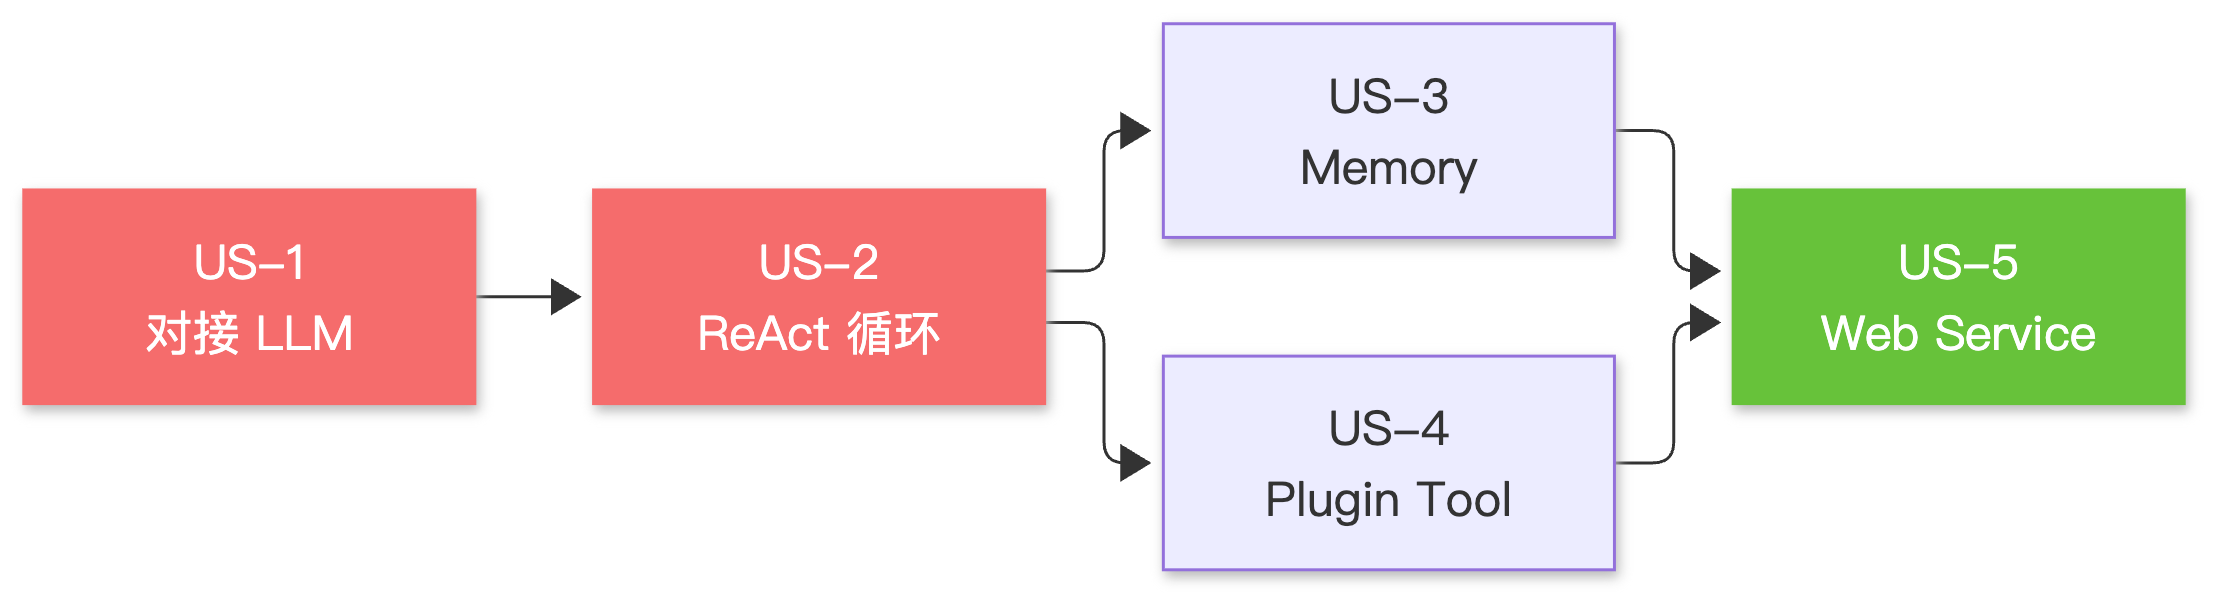
- 依赖顺序
-
红色是基础,US-3 / US-4 互不依赖可并行,绿色 US-5 收口、对外暴露所有能力
-
Spec-Kit 的
/tasks本就按 user story 组织任务,按五大能力拆正好顺着它的工作方式 -
五个 user story 一览
| US | 核心能力 | 涉及模块 | 验收 Demo |
|---|---|---|---|
| US-1 | 对接 LLM | provider、core、boot | Demo 一的前置 |
| US-2 | ReAct 循环 | core、tool、channel-cli、cli | Demo 一:查天气穿衣 |
| US-3 | Memory 记忆 | memory | Demo 二:跨对话记偏好 |
| US-4 | Plugin Tool | tool、core | Demo 三:零代码 PR digest |
| US-5 | Web Service | web、storage、cli | Demo 四 / 五:REST 集成 |
-
每个 US 完成后都有一个可演示的 Demo
-
和 AI 协作的四条纪律
| 纪律 | 做法 | 防什么 |
|---|---|---|
| 每个 US 后跑 analyze | /speckit.analyze 检查 constitution、spec、plan、tasks、代码是否一致 |
防漂移 |
| 违反宪法就重读 | 代码不符合 constitution,立刻让 AI 重读宪法改正 | 纠跑偏 |
| 上下文丢失回到 spec | 跨 task 时让 AI 重读 spec.md + plan.md + 最近代码 | 防断片 |
| 每个 US 一次 commit | git commit 标记每个 US 完成,随时回到稳定状态 | 可回退 |
-
AI 负责执行,人负责守住方向
-
开发节奏:4 个迭代,每个迭代一组能力
| 迭代 | 能力 | 内容 | 可演示成果 |
|---|---|---|---|
| 1 | 对接 LLM + ReAct | 搭骨架、Provider、ReAct 循环、HTTP Tool、CLI | chat 多轮 + 调 Tool |
| 2 | Memory + Tool | MEMORY.md、内置 Tool、MCP Client、SKILL.md | 记偏好 + 调外部 MCP |
| 3 | Web Service | Spring MVC、6 个 Controller、10 个端点 | 外部系统完整调用 |
| 4 | 多 Agent + 收尾 | 多 Agent 并存、Session 落库、12 个命令、主页 | 多 Agent + 跨重启 |
- 给的是顺序与节奏的骨架,不是死的时间表,具体投入由团队定
Spec-Kit 原理与价值
简介:Spec-Kit 不是 AI agent,而是套在 AI agent 之上的「工作流层」:一个 CLI + 一套 slash command,支持 20+ AI agent
- 为什么需要 SDD:vibe coding 在大项目上的四个问题
| 问题 | 表现 |
|---|---|
| 需求漂移 | 跨会话进行,AI 每次重新理解,决策被遗忘 |
| 架构失控 | AI 只求「看起来能跑」,迭代几次变成一团乱麻 |
| 回退困难 | 没有正式需求文档,错了不知该回到哪 |
| 无法协作 | 每个人的提示词理解不同,产出风格不一致 |
-
仅靠 prompt 不够,要在 prompt 之上加一层结构化的「需求层」,这就是 SDD,Spec-Kit 是它最纯粹的实现
-
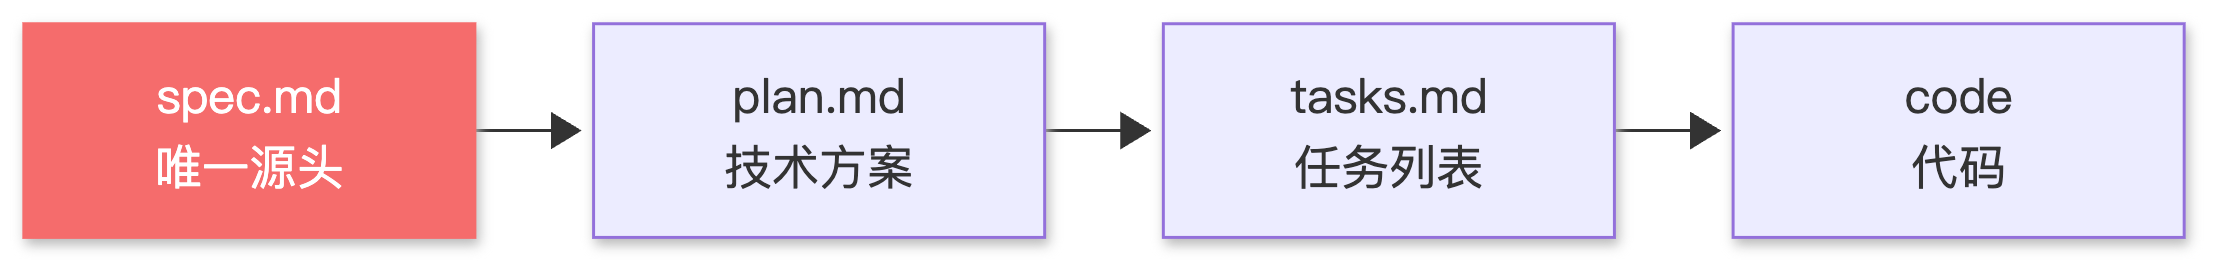
原理一:spec-as-source
-
spec 是项目的唯一事实来源,不是 chat 历史
-
spec 变了,下游 plan、tasks、code 全部重新生成
-
spec 是仓库里的正式文件,跟代码一起版本管理
-
原理二:三大设计支柱
| 支柱 | 作用 |
|---|---|
| constitution 项目宪法 | 把技术栈、规范、边界等非协商原则固化成文件,所有命令都引用,钉死方向 |
| 4 阶段闭环 | specify、plan、tasks、implement 每阶段有正式 artifact,前一阶段输出是后一阶段输入,不跳步 |
| analyze 防漂移 | 跨 artifact 一致性检查,防止 spec 和代码渐渐对不上 |
- 原理三:四个正式产物
| 文件 | 内容 |
|---|---|
constitution.md |
项目宪法:非协商原则,写一次定下来,全程不轻易改 |
spec.md |
需求规格:user story + acceptance criteria(验收标准)+ 功能边界 |
plan.md |
技术方案:技术栈选型、模块划分、关键技术决策 |
tasks.md |
任务清单:按 user story 分组,标好依赖与可并行 |
-
四个文件是「人和 AI 之间的契约」,也是项目决策的留底,可审查、可共享、可回溯
-
有什么用:从作坊到工程
- 管住 vibe coding:需求漂移、架构失控被 spec 兜住
- 立契约:spec 是双方都遵守的依据,AI 不再靠概率猜意图
- 可追溯:所有决策有 artifact 留底,跟代码一起版本管理
- 可演进:跨会话切换不丢决策,spec 跟代码同步演进
- 没有 SDD 的 AI 编程,就像没有版本控制的传统编程:能跑,但不可持续
Spec-Kit 用法与时机
简介:specify init 起手,按命令顺序走完闭环;它是「重武器」,用对场景威力巨大,用错就是负担
-
初始化
#specify init --here --integration claude --forcespecify init --here --integration claude --force
-
--here:在当前目录初始化 -
--integration claude:接入 Claude Code -
--force:仓库非空时跳过确认 -
生成的目录结构
项目根目录
├── .claude/skills/ # speckit-* 命令以 skill 形式安装
├── .specify/
│ ├── memory/constitution.md # 项目宪法,初始是带占位符的空模板
│ ├── templates/
│ ├── scripts/
│ └── workflows/
└── specs/
└── 001-xxx/ # 每个特性一个目录
├── spec.md
└── checklists/ -
命令执行顺序
| 顺序 | 命令 | 作用 | 是否必需 |
|---|---|---|---|
| 1 | constitution |
立项目宪法,把技术栈、铁律写进 constitution.md,后续所有阶段受它约束 |
先做 |
| 2 | specify |
用自然语言描述特性「做什么、为什么」,自动建分支 + specs/xxx/spec.md,不谈实现 |
每个特性 |
| 3 | clarify |
对 spec 里模糊的地方提最多 5 个精准问题,答案写回 spec,降低返工 | 强烈建议 |
| 4 | plan |
定技术方案、架构、选型,产出 plan.md + 设计文档 |
必需 |
| 5 | checklist |
按需求生成验收 / 质量检查清单 | 可选 |
| 6 | tasks |
把 plan 拆成依赖有序的 tasks.md |
必需 |
| 7 | analyze |
交叉核对 spec / plan / tasks 有无矛盾、遗漏,非破坏性 | 建议 |
| 8 | implement |
按 tasks.md 逐个写代码 |
必需 |
-
命令以
/speckit.前缀触发,在 Claude Code 中以 skill 形式出现,例如/speckit-specify -
辅助命令
converge:拿现有代码库对照 spec / plan / tasks,把还没做的补成新任务,适合中途接手或迭代taskstoissues:把 tasks 转成 GitHub issues
-
命令语法不用背,理解每个命令解决什么问题,跑一遍就熟
-
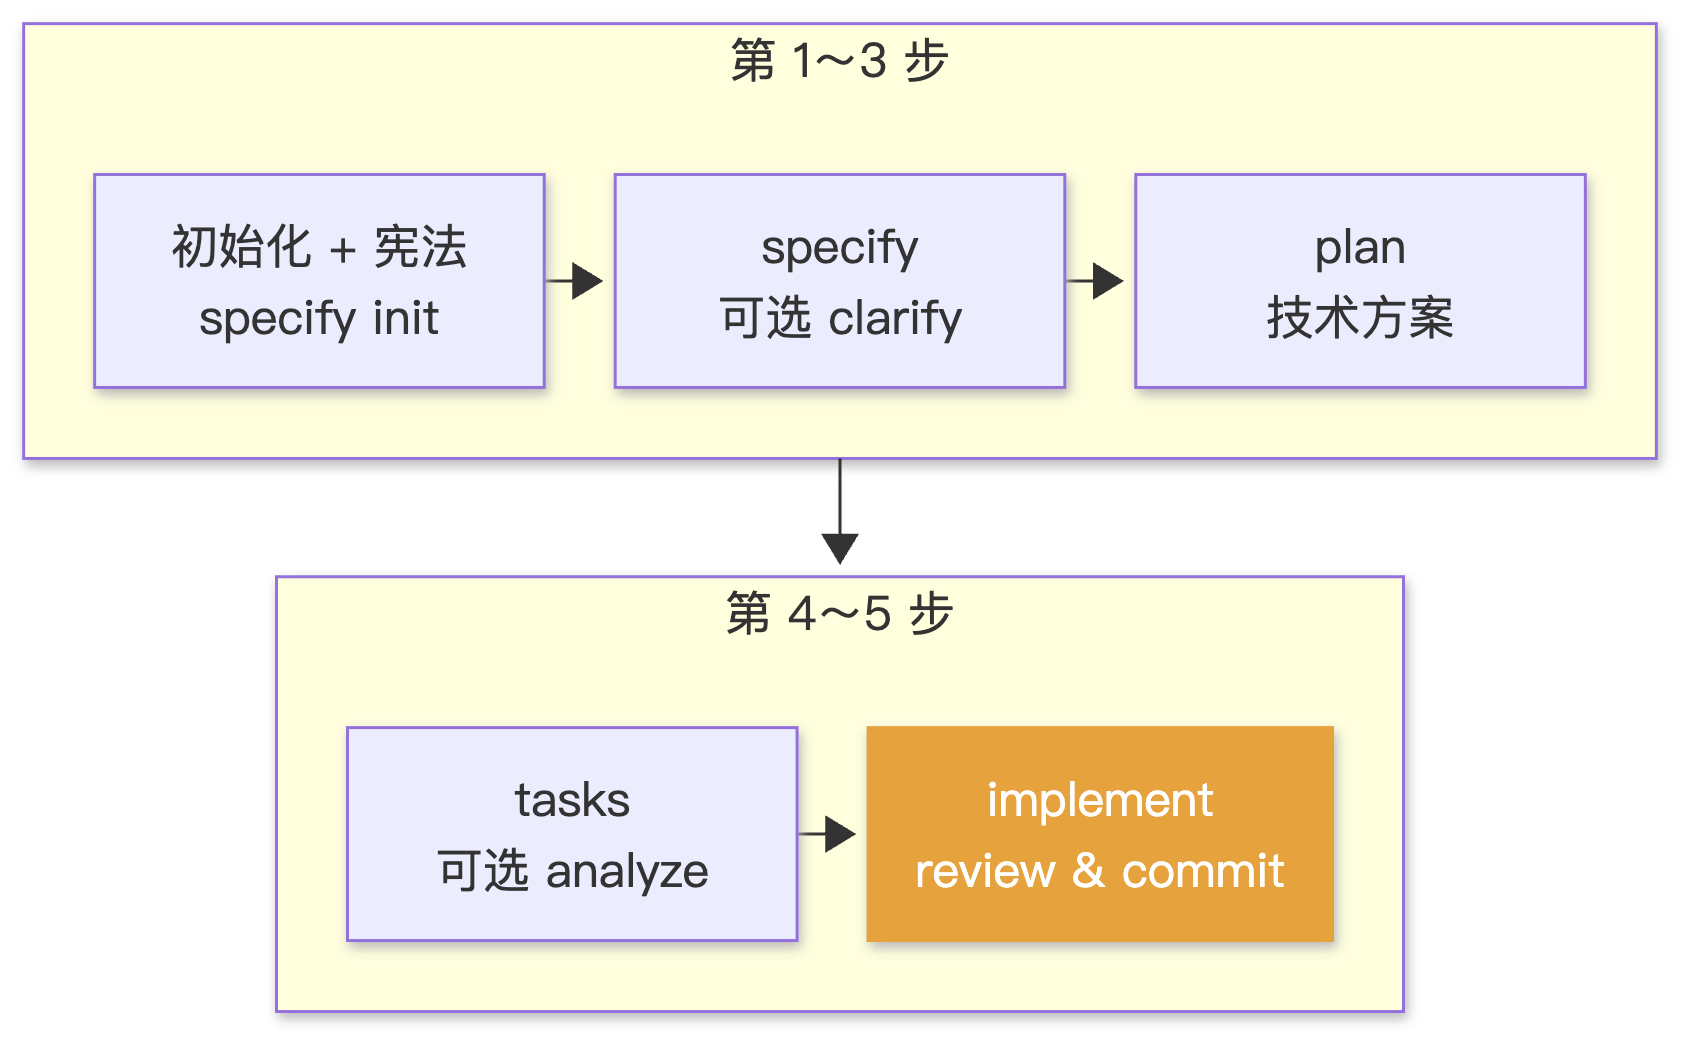
典型工作流
-
橙色一步要注意:每个 task 写完先人工 review 再 commit
-
没有跨阶段 shortcut,不能凭感觉跳过 plan 直接写代码
-
两个关键命令的输入输出
| 命令 | 输入 | 输出 |
|---|---|---|
/speckit.specify |
一句话或一段粗略需求 | spec.md(约 800 行):背景、user story、acceptance criteria、非目标(明确不做什么) |
/speckit.tasks |
spec.md + plan.md |
tasks.md:几十个有序任务,按 user story 分组,标好依赖和可并行项 |
-
人只写第一份 spec、检查 plan、最后 review 代码,中间的拆任务和执行由 AI 自动跑
-
什么时候用
| 适合(威力巨大) | 不适合(开销大于收益) |
|---|---|
| greenfield 中到大型项目 | 小 feature、单文件、快速原型 |
| 需求清晰,上游有文档或决策 | 大型 brownfield 改造,上下文超限 |
| 用 AI agent 做主体开发 | 探索性研究,需求未定会返工 |
| 团队要学 SDD 工程方法论 | 个人小实验,命令流程太重 |
- 工具匹配工作性质:强在强制完整流程、产出结构化 artifact,代价是流程开销大
面试/考试记忆点
- AI 编程的核心动作从写代码变成驾驭 AI,执行可以交出去,判断不能
- 拿到项目的三种思维:SDD 想怎么拆分,Harness 想怎么立规范,Loop 想怎么自动化
- 人定拆分方案、规范边界、关键技术决策、验收标准;AI 在边界内执行、自检、卡住上报
- SDD 三种落地模式:Spec-Kit 自动化、OpenSpec 手动控制、CLAUDE.md + Skill 轻量手工
- 已有文档不重写:需求进 specify,技术方案进 plan,关键决策进 constitution,验收 Demo 直接复用
- 任务按 user story 拆而不是按时间拆,每个 US 完成都有可演示的 Demo
- 协作四纪律:analyze 防漂移、重读宪法纠跑偏、回到 spec 防断片、每个 US 一次 commit 可回退
- Spec-Kit 核心原理是 spec-as-source:spec 是唯一事实来源,plan、tasks、code 都从它派生
- Spec-Kit 三大支柱:constitution 钉死方向、4 阶段闭环不跳步、analyze 防漂移
- Spec-Kit 是重武器,适合需求清晰的 greenfield 中大型项目,不适合小改动、探索性研究和大型 brownfield