目录
[二、JSON 封装:让消息层只关心正文转换](#二、JSON 封装:让消息层只关心正文转换)
[2.1 serialize():Json::Value → std::string](#2.1 serialize():Json::Value → std::string)
[2.2 unserialize():std::string → Json::Value](#2.2 unserialize():std::string → Json::Value)
[三、JSON 工具怎样接进 JsonMessage](#三、JSON 工具怎样接进 JsonMessage)
[四、为什么每个请求都需要自己的 RID](#四、为什么每个请求都需要自己的 RID)
[五、UUID::uuid() 怎样生成一个 RID](#五、UUID::uuid() 怎样生成一个 RID)
[5.1 前 8 字节:生成随机部分](#5.1 前 8 字节:生成随机部分)
[5.2 为什么一个字节要固定输出两个十六进制字符](#5.2 为什么一个字节要固定输出两个十六进制字符)
[5.3 后 8 字节:加入进程内递增序号](#5.3 后 8 字节:加入进程内递增序号)
[六、它是 UUID 风格 RID,但不是标准 UUID v4](#六、它是 UUID 风格 RID,但不是标准 UUID v4)
前言
系列:C++ RPC 框架从设计到实现,第八篇
项目源码:
Json-Rpc: 实现Json-Rpc框架
https://gitee.com/kuang-zhenting/json-rpc
第七篇我们已经把 BaseMessage 落成了真正可以承载业务数据的消息对象。
其中 JsonMessage 已经在使用:
cpp
JSON::serialize(_body, body);
JSON::unserialize(msg, _body);
而客户端真正组织 RPC 请求时,还会出现:
cpp
req_msg->setId(UUID::uuid());也就是说,消息体系虽然已经搭起来了,但还有两个公共工具一直在幕后工作:
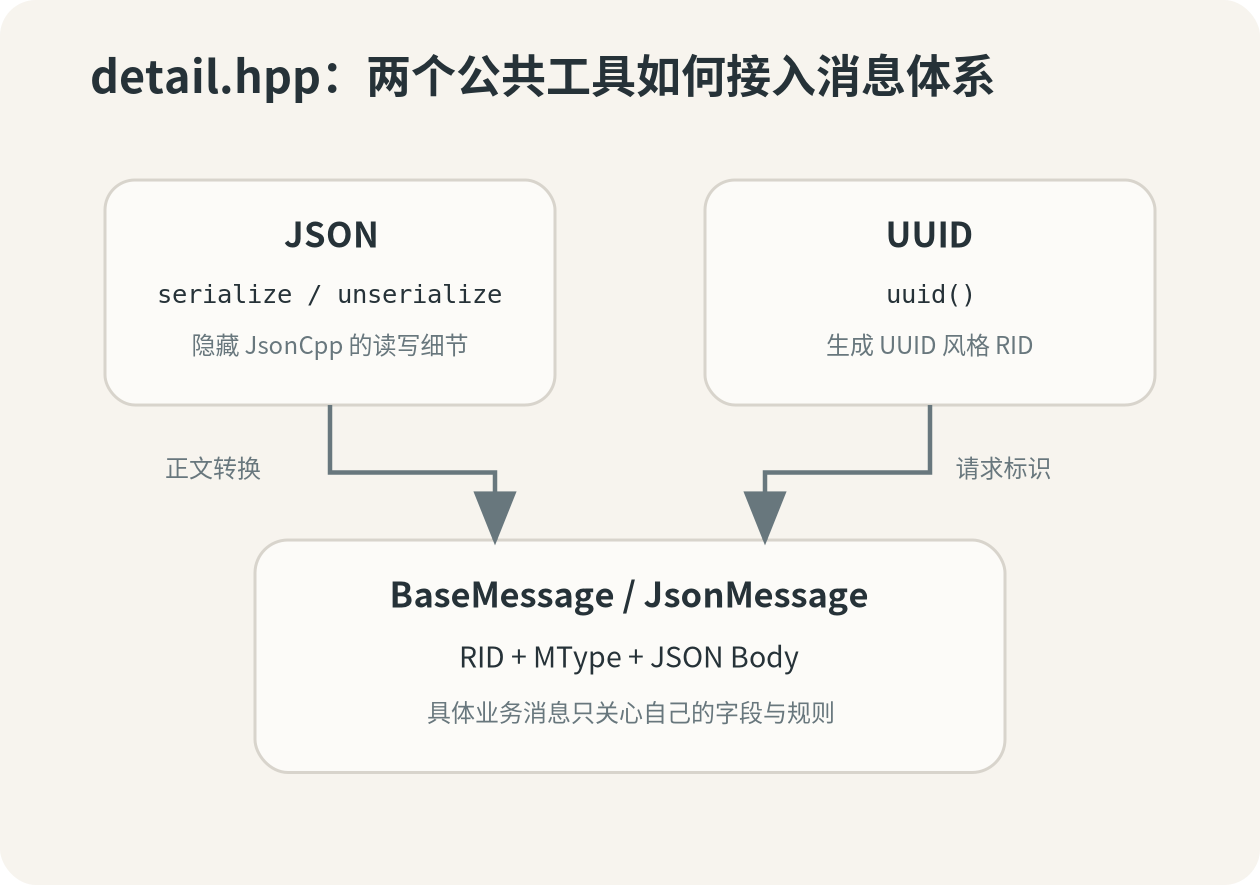
- JSON → 负责 Json::Value 与字符串之间的转换;
- UUID → 负责生成请求 RID。
它们都位于:
cpp
source/common/detail.hpp第六篇已经把这个文件里的日志宏讲过了,所以这一篇不再重复日志部分。我们只把剩下的两个工具补完整,并重点回答两个问题:
为什么消息层还要再封装一层 JSON 工具?请求为什么必须有自己的 RID?
一、为什么现在要补齐这两个公共工具
detail.hpp 里的 JSON 和 UUID 有一个共同特点:它们都不是某一种业务消息专属的能力。
例如 RPC、Topic、Service 的正文虽然字段完全不同,但只要继承自 JsonMessage,最终都需要完成:
cpp
Json::Value
    ↓
序列化
    ↓
std::string
接收消息时又要反过来:
cpp
std::string
    ↓
反序列化
    ↓
Json::Value
RID 也是一样。
它不是:RPC 专属 ID,Topic 专属 ID,Service 专属 ID。
而是一条请求在整个请求---响应链路里的公共标识。
所以当前项目没有把 JsonCpp 的具体 API 塞进每一种消息,也没有让每个业务模块自己发明请求 ID,而是统一提供:
cpp
myrpc::JSON::serialize(...);
myrpc::JSON::unserialize(...);
myrpc::UUID::uuid();
上层只使用这些能力,具体的 JsonCpp 写入器、解析器、随机数和十六进制格式化都留在 detail.hpp 内部。
这和前面做网络抽象层的思路其实很像:
上层只看到"我需要什么能力",具体库怎么完成这件事由更底层负责。
二、JSON 封装:让消息层只关心正文转换
前面学习 JsonCpp 时,我们已经直接使用过:
cpp
Json::StreamWriterBuilder
Json::StreamWriter
Json::CharReaderBuilder
Json::CharReader
但真正进入框架以后,如果 JsonMessage::serialize() 还要自己创建 StreamWriter,RpcRequest、TopicRequest 等消息类就会逐渐和 JsonCpp 的细节绑在一起。
当前源码因此增加了一个很薄的工具类:
cpp
class JSON
{
public:
    static bool serialize(const Json::Value &val,
                          std::string &body);

    static bool unserialize(const std::string &body,
                            Json::Value &val);
};
两个函数都没有需要保存在对象里的状态,所以直接做成静态成员即可。
消息层最终只需要表达:
- 把正文转成字符串;
- 把字符串恢复成正文。
而不用关心 JsonCpp 对象怎样创建和释放。
2.1 serialize():Json::Value → std::string
当前实现如下:
cpp
static bool serialize(const Json::Value &val, std::string &body)
{
    std::stringstream ss;

    Json::StreamWriterBuilder swb;
    std::unique_ptr<Json::StreamWriter> sw(
        swb.newStreamWriter());

    int ret = sw->write(val, &ss);
    if (ret != 0)
    {
        ELOG("Json serialize failed!");
        return false;
    }

    body = ss.str();
    return true;
}
这段代码的主线只有四步:
cpp
Json::Value
    ↓
StreamWriterBuilder 创建 StreamWriter
    ↓
写入 stringstream
    ↓
ss.str() 得到正文字符串
其中:
cpp
std::unique_ptr<Json::StreamWriter>负责管理写入器的生命周期,函数结束后对象会自动释放。
序列化失败时也不再由消息类各自打印错误,而是统一走第六篇已经实现的:
cpp
ELOG(...)这样 JSON 工具和项目自己的日志入口也接到了一起。
2.2 unserialize():std::string → Json::Value
反序列化则使用 CharReader:
cpp
static bool unserialize(const std::string &body, Json::Value &val)
{
    Json::CharReaderBuilder crb;

    std::string errs;
    std::unique_ptr<Json::CharReader> cr(
        crb.newCharReader());

    bool ret = cr->parse(
        body.c_str(),
        body.c_str() + body.size(),
        &val,
        &errs);

    if (ret == false)
    {
        ELOG("Json unserialized failed:%s", errs.c_str());
        return false;
    }

    return true;
}
这里有一个小细节:
cpp
errs.c_str()日志宏最终使用的是 printf 风格可变参数,因此 %s 需要接收 C 风格字符串,不能直接把 std::string 对象传进去。
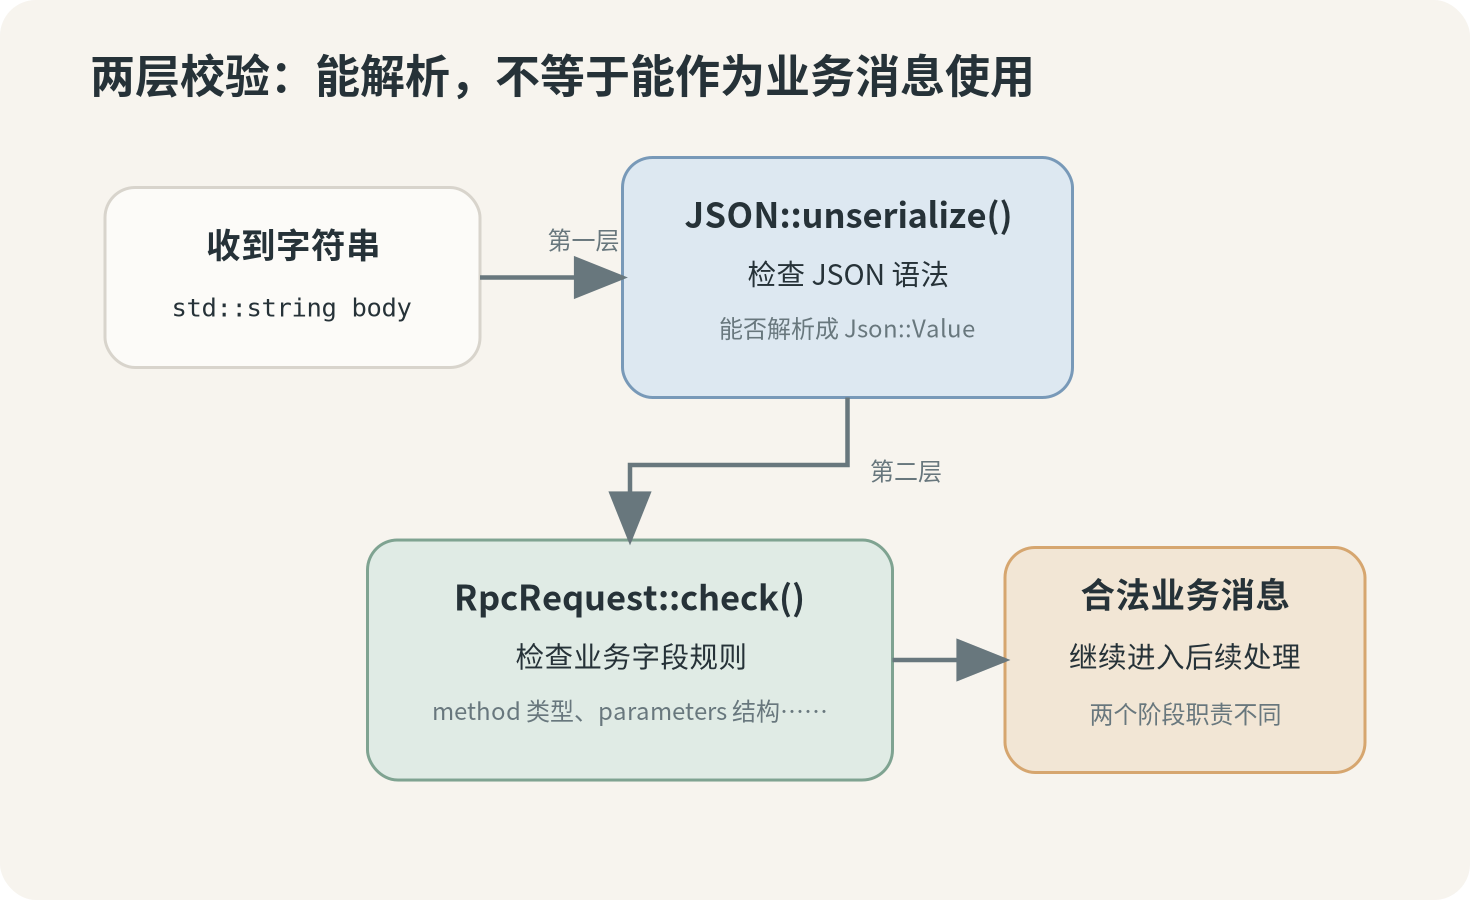
真正更重要的是:这里返回 true,只代表 JSON 文本解析成功。
它还不能证明这条消息满足当前业务规则。
比如:
cpp
{
  "method": 123,
  "parameters": {}
}
它是合法 JSON,因此:
cpp
JSON::unserialize(...) == true但第七篇已经看到,RpcRequest::check() 要求:
- method 必须是字符串;
- parameters 必须是对象。
所以同一份数据仍然可能:
cpp
rpc_req->check() == false这两个阶段分别解决不同问题:
- JSON::unserialize() → 文本能不能解析成 JSON
- RpcRequest::check() → 这个 JSON 能不能作为合法 RPC 请求使用
把这层边界分清楚,后面协议解析和业务校验就不会混在一起。
三、JSON 工具怎样接进 JsonMessage
工具类本身写完以后,真正重要的是它怎样进入现有消息体系。
第七篇的 JsonMessage 已经给出了答案:
cpp
class JsonMessage : public BaseMessage
{
public:
    virtual std::string serialize() override
    {
        std::string body;
        bool ret = JSON::serialize(_body, body);
        if (ret == false)
        {
            ELOG("serialize fail");
            return std::string();
        }

        return body;
    }

    virtual bool unserialize(const std::string &msg) override
    {
        bool ret = JSON::unserialize(msg, _body);

        if (ret == false)
        {
            ELOG("unserialize fail");
        }

        return ret;
    }

protected:
    Json::Value _body;
};
于是整个关系变成:
cpp
RpcRequest / TopicRequest / ServiceRequest
    ↓
JsonMessage
    ↓
JSON
    ↓
JsonCpp
业务消息负责字段语义,例如:
cpp
method
parameters
topic_key
host
JsonMessage 负责"消息正文需要序列化 / 反序列化"这件事;JSON 再负责真正调用 JsonCpp。
这样每层的职责就比较清楚:
| 层次 | 负责什么 |
|---|---|
| 具体业务消息 | 字段、业务结构、check() |
JsonMessage |
统一保存 _body,提供序列化入口 |
JSON |
封装 JsonCpp 的读写过程 |
| JsonCpp | 真正完成 JSON 文本编码与解析 |
到这里,第七篇里那两个看起来像"黑盒"的函数就完全接上了。
但消息对象还有另一个公共字段:
cpp
std::string _rid;接下来就来看它为什么存在。
四、为什么每个请求都需要自己的 RID
假设一个客户端连续发出三次调用:
cpp
请求 A:Add(11, 22)
请求 B:Sub(100, 7)
请求 C:GetUser(1001)
网络通信是异步发生的,响应并不需要严格按照调用代码的先后顺序到达。
如果客户端只看到:
cpp
result = 93
result = { ... }
result = 33
它还必须知道:
每一条响应,到底应该交给之前的哪一次请求?
所以项目在 BaseMessage 中统一保存:
cpp
std::string _rid;并提供:
cpp
virtual void setId(const std::string &id)
{
    _rid = id;
}

virtual std::string rid() const
{
    return _rid;
}
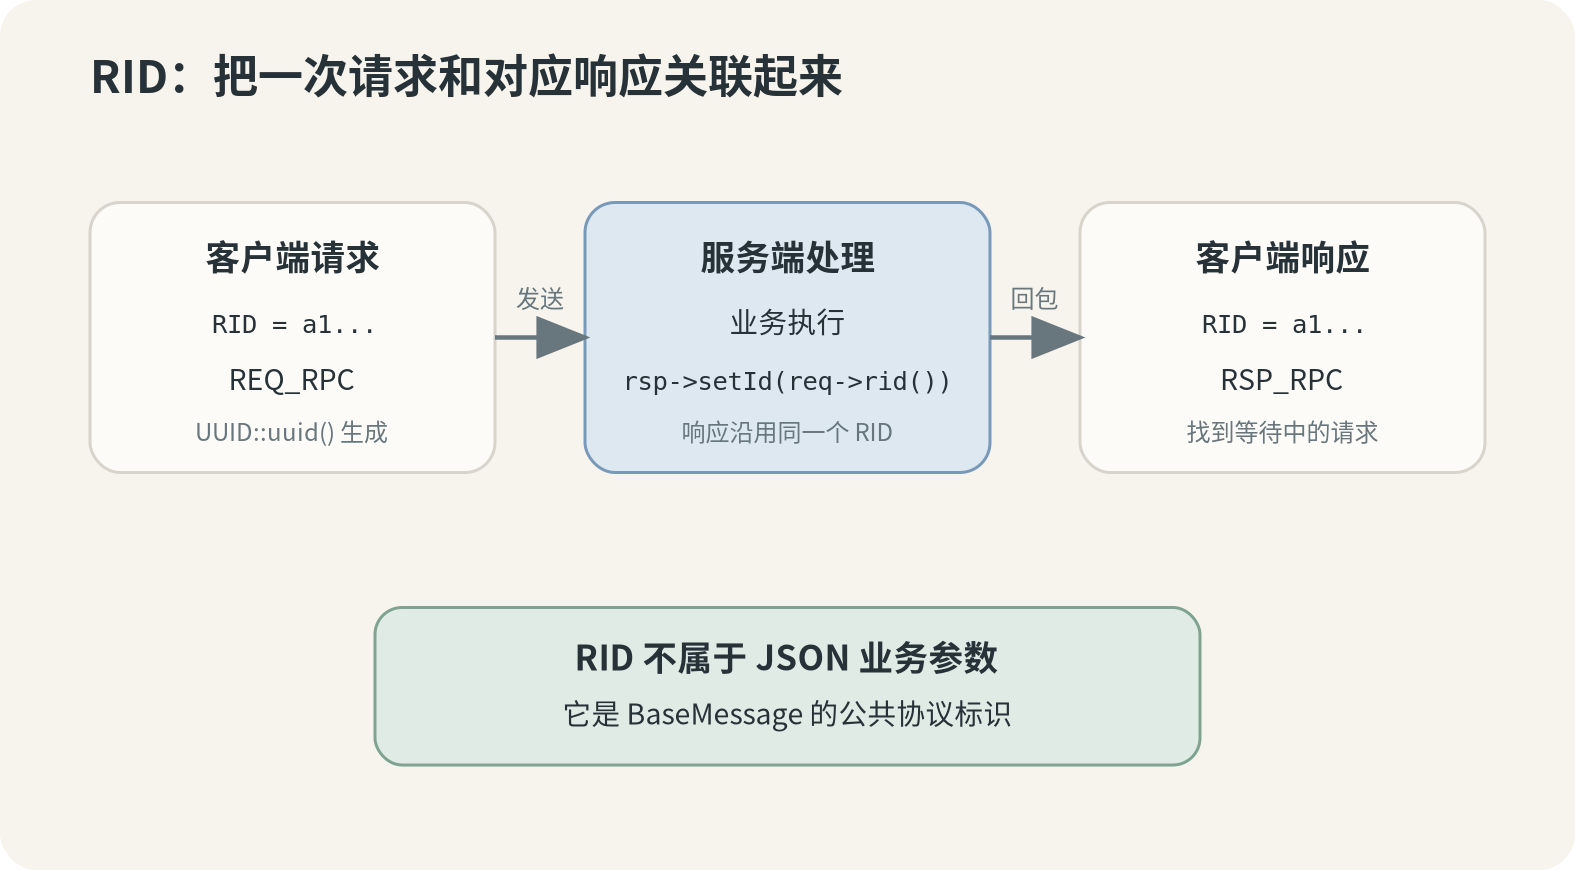
客户端创建请求时会生成新的 RID,例如当前 RpcCaller 中:
cpp
auto req_msg = MessageFactory::create<RpcRequest>();
req_msg->setId(UUID::uuid());
req_msg->setMType(MType::REQ_RPC);
req_msg->setMethod(method);
req_msg->setParams(params);
服务端构造响应时,则会把请求的 RID 原样带回去:
cpp
msg->setId(req->rid());
msg->setMType(MType::RSP_RPC);
因此,请求与响应之间会形成一条稳定的关联:
后面的客户端请求管理模块会继续利用 RID,把到达的响应找到对应的等待请求。
这一篇先不用展开 Requestor 的完整实现,只要先记住:
RID 不是业务参数,它是框架用来关联一次请求和对应响应的公共标识。
这也是为什么 RID 保存在 BaseMessage,而不是塞进 RPC 的 JSON parameters 中。
五、UUID::uuid() 怎样生成一个 RID
现在来看 detail.hpp 中第二个工具类:
cpp
class UUID
{
public:
    static std::string uuid();
};
虽然类名叫 UUID,但当前实现不是直接调用某个 UUID 库,而是自己组织一段 16 字节数据,再格式化成常见的:
cpp
8-4-4-4-12整体结构可以先看成:
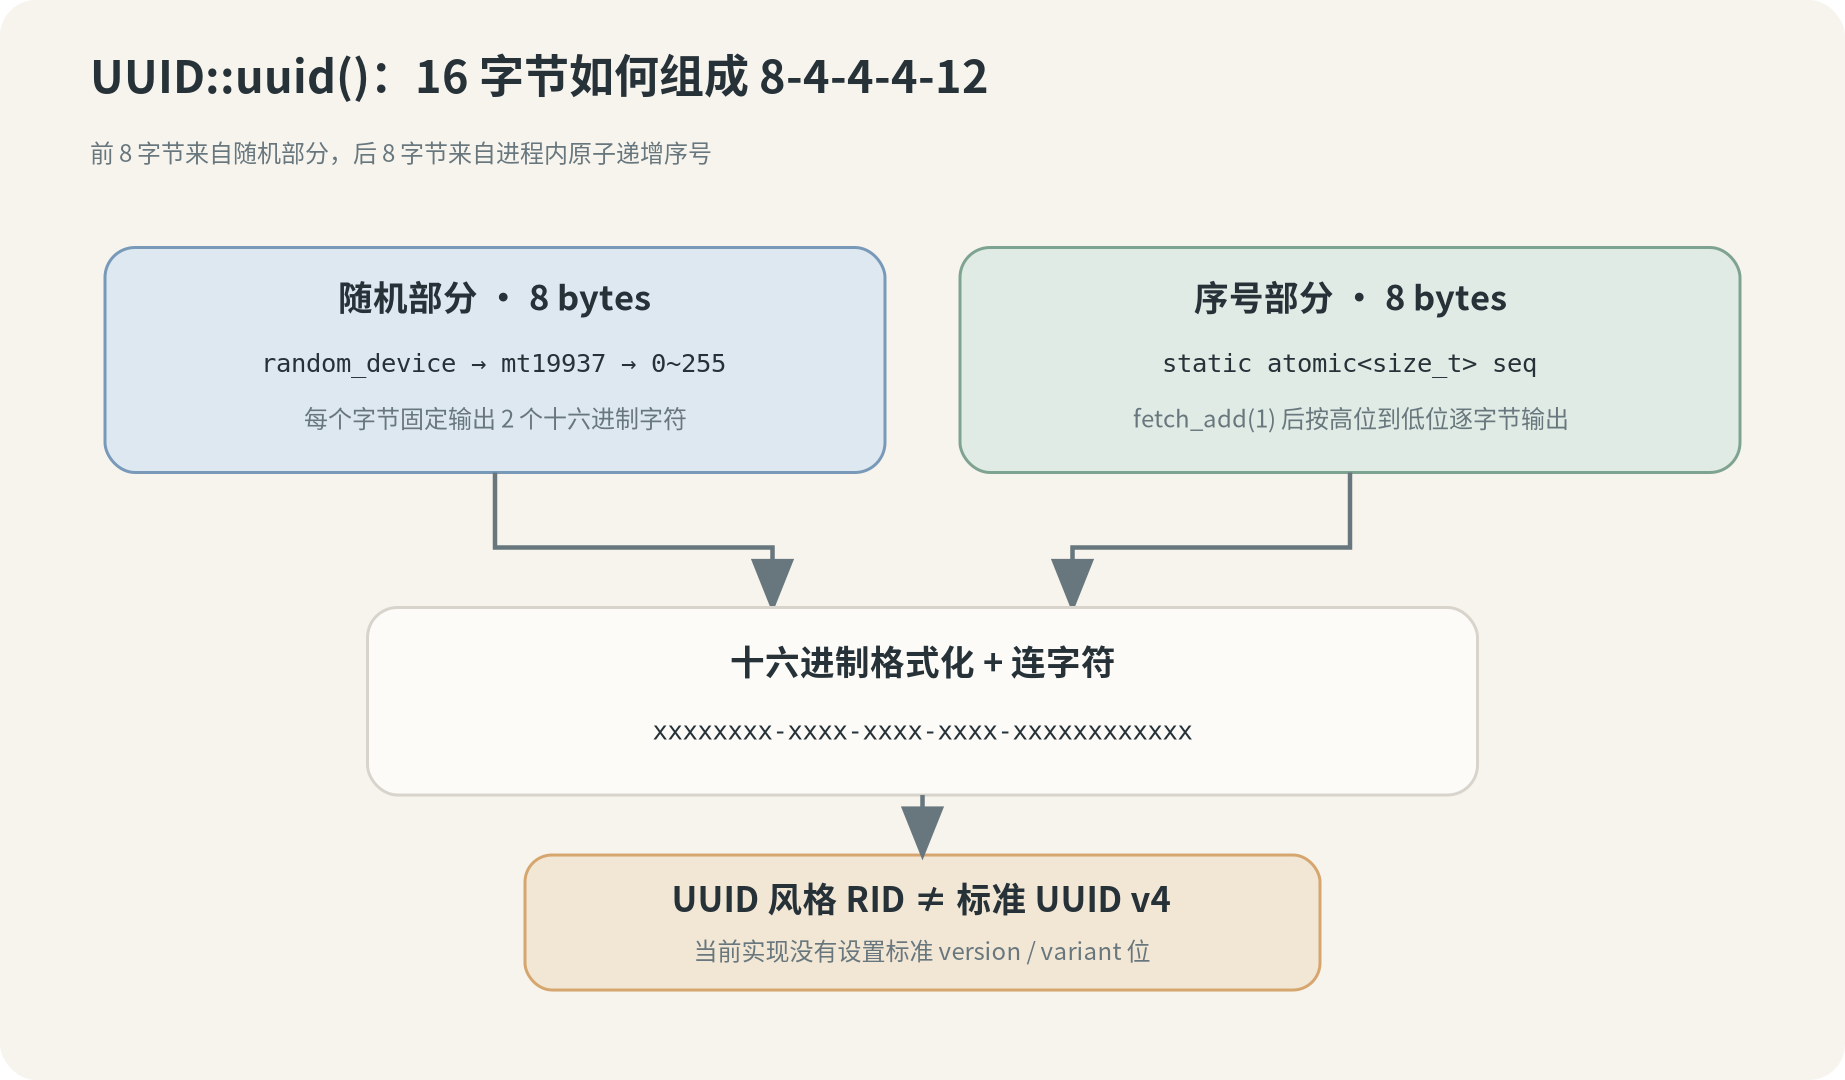
- 前 8 字节 → 随机部分;
- 后 8 字节 → 进程内原子递增序号;
- 最后 → 十六进制输出并插入连字符。
5.1 前 8 字节:生成随机部分
当前源码使用 C++11 <random>:
cpp
std::random_device rd;
std::mt19937 generator(rd());
std::uniform_int_distribution<int> distribution(0, 255);
三个对象各负责一件事:
- random_device → 给随机引擎提供种子
- mt19937 → 生成伪随机序列
- uniform_int_distribution<int>(0, 255) → 把每次结果限制在一个字节范围
随后循环 8 次:
cpp
for (int i = 0; i < 8; i++)
{
    if (i == 4 || i == 6)
    {
        ss << "-";
    }
    ss << std::setw(2)
       << std::setfill('0')
       << std::hex
       << distribution(generator);
}
每轮得到一个 0 ~ 255 的整数,也就是一个字节。
5.2 为什么一个字节要固定输出两个十六进制字符
假设随机结果是十进制:
cpp
5转成十六进制只有:
cpp
5但一个字节完整显示时应该占两个十六进制字符,所以我们希望得到:
cpp
05代码中的:
cpp
std::hex
std::setw(2)
std::setfill('0')
分别负责:
- std::hex → 按十六进制输出;
- std::setw(2) → 本次输出宽度至少为 2;
- std::setfill('0') → 不足时用 0 填充。
因此:
cpp
5   → 05
10  → 0a
255 → ff
前 8 个字节一共形成 16 个十六进制字符,并在第 4、6 个字节之后插入连字符,于是先得到:
cpp
xxxxxxxx-xxxx-xxxx-5.3 后 8 字节:加入进程内递增序号
随机部分之后,源码定义:
cpp
static std::atomic<size_t> seq(1);这里的两个关键字分别解决不同问题。
static 让 seq 只初始化一次,不会每次进入 uuid() 又重新从 1 开始。
atomic 则让多个线程同时获取下一个序号时,不需要手工再加一把互斥锁。
当前代码取号方式是:
cpp
size_t cur = seq.fetch_add(1);fetch_add(1) 会原子地把 seq 加 1,同时把增加之前的值返回给 cur。
例如:
cpp
初始 seq = 1

第一次调用
    cur = 1
    seq = 2

第二次调用
    cur = 2
    seq = 3
接下来再把这个整数按字节拆开:
cpp
for (int i = 7; i >= 0; i--)
{
    if (i == 5)
    {
        ss << "-";
    }

    ss << std::setw(2)
       << std::setfill('0')
       << std::hex
       << ((cur >> (i * 8)) & 0xFF);
}
其中:
cpp
(cur >> (i * 8)) & 0xFF可以拆成两步理解:
- cur >> (i * 8) → 把目标字节移动到最低 8 位;
- & 0xFF → 只保留最低 8 位。
循环从 7 到 0,就是按高位字节到低位字节的顺序输出。
于是后 8 字节最终补成:
cpp
xxxx-xxxxxxxxxxxx和前面的随机部分拼起来,就是:
cpp
xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx这正是当前 UUID::uuid() 最终返回的字符串外形。
六、它是 UUID 风格 RID,但不是标准 UUID v4
看到:
cpp
8-4-4-4-12很容易直接把它理解成"标准 UUID"。
但这里要把边界说清楚。
当前项目实现的是:
cpp
8 字节随机数据
+
8 字节原子递增序号
然后把结果排成 UUID 常见的字符串外形。
源码并没有设置标准 UUID v4 所要求的 version / variant 位,也没有使用专门的 UUID 实现。
所以更准确的说法是:
UUID::uuid()生成的是项目自定义的 UUID 风格请求 RID。
另外,std::random_device 也不应该理解成"标准保证一定来自硬件、并且绝不会重复"。这里真正采用的是"随机部分 + 进程内递增序号"的组合方案。
其中原子序号解决的是当前进程内并发取号问题;这个实现本身并没有声明跨进程、跨机器或进程重启之后仍然提供永久全局唯一保证。
对当前框架来说,它的职责很明确:
cpp
为一次请求生成足够好用的字符串标识
    ↓
放进 BaseMessage::_rid
    ↓
随着请求发送出去
    ↓
响应继续携带同一个 rid
    ↓
客户端据此关联请求与响应
所以我们关注的是它在当前 RPC 框架中的用途,而不是把它包装成一套标准 UUID 库。
写在最后
这一篇把 detail.hpp 中前面还没有展开的两个公共工具补齐了。
JSON 这条线完成的是:
cpp
JsonCpp
    ↓
JSON::serialize / unserialize
    ↓
JsonMessage
    ↓
RPC / Topic / Service 消息
而 RID 这条线完成的是:
cpp
UUID::uuid()
    ↓
生成 UUID 风格请求 ID
    ↓
BaseMessage::_rid
    ↓
请求与响应保持同一个 rid
到这里,消息对象已经具备了三个关键部分:
- MType → 表示消息大类;
- RID → 关联请求与响应;
- JSON Body → 承载真正的业务数据。
下一篇就可以正式回到网络主线。
TCP 给我们的并不是一个个 BaseMessage,而是一段连续字节流。接下来需要解决的是:
cpp
Muduo Buffer
    ↓
LVProtocol
    ↓
判断一条消息是否完整
    ↓
读取 Length / MType / IDLength / RID / Body
    ↓
MessageFactory::create(mtype)
    ↓
恢复成具体消息对象
也就是:
怎样从 TCP 字节流中准确取出一条完整消息,再把它还原成前面已经设计好的消息对象。