目录
前言
学习 Steven Brunton 讲授的强化学习入门概述视频,本篇文章记录第一讲:强化学习:机器学习与控制理论的交汇,记录下个人学习笔记,和大家一起分享交流😄
video :https://www.youtube.com/playlist?list=PLMrJAkhIeNNQe1JXNvaFvURxGY4gE9k74
1. 引言
强化学习本质上是机器学习的一个分支,专注于如何学习控制策略以与复杂环境进行交互,我对强化学习的理解是,它是一种通过经验学习如何与环境交互的框架。
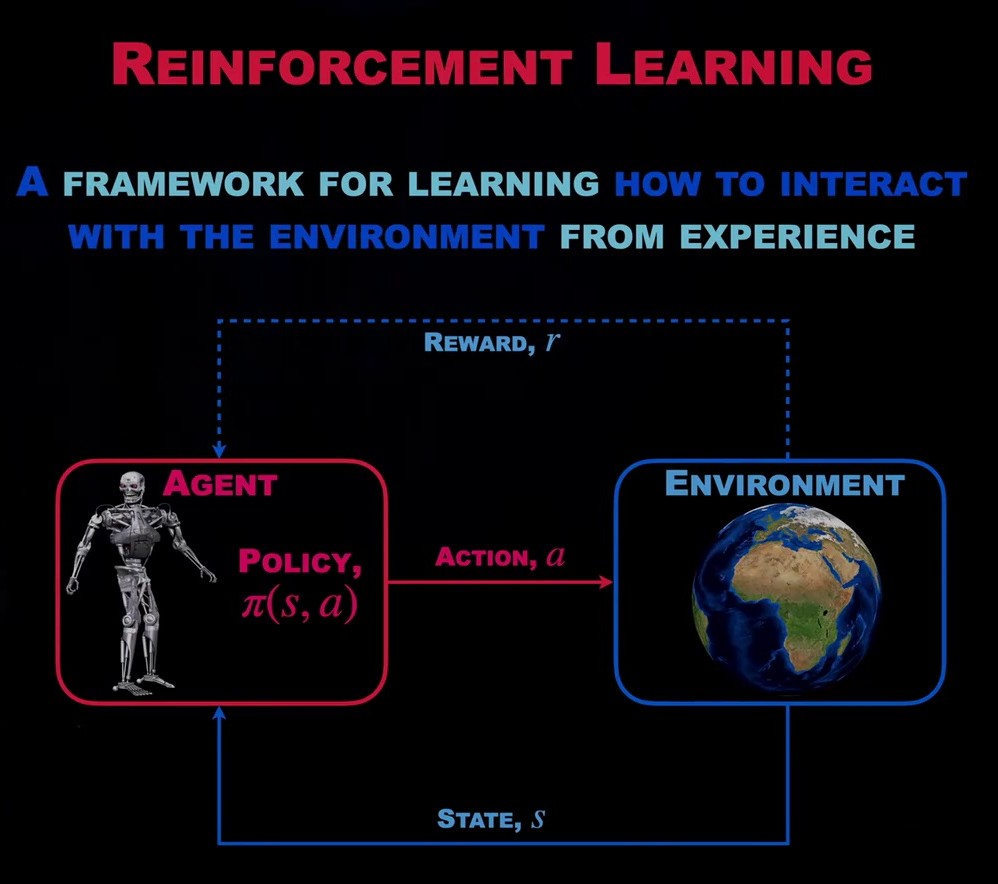
这是一个极具生物学启发的概念,这正是动物所做的事情,通过试错、经验积累、正负奖励和反馈,它们学会了如何与环境互动。
在深入探讨之前,我想先展示一些激发兴趣的视频:
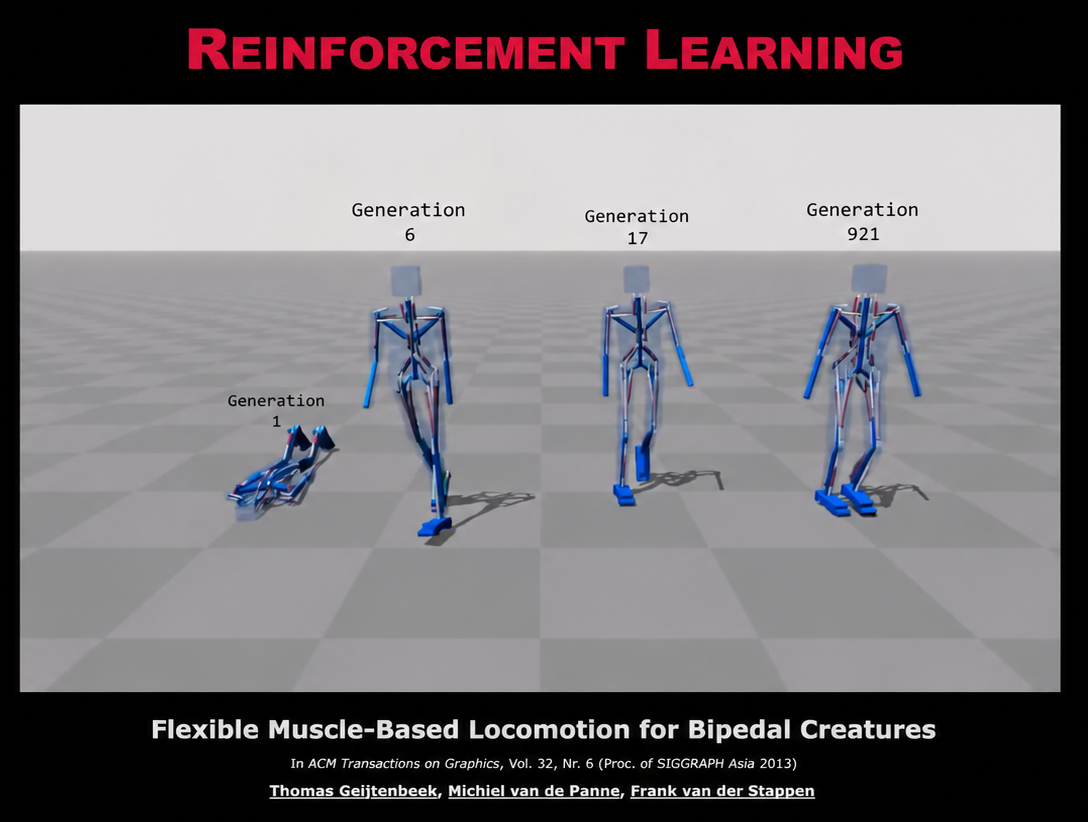
它展示了强化学习如何在人工环境中学会行走,类似的论文有很多,研究者们将强化学习作为一种优化框架,用于学习如何控制复杂系统。
例子中,是一个双足步行机器人,通常是在模拟环境中进行训练,这看起来非常酷,而且是一个极具挑战性的控制问题,这是一个非常复杂的非线性控制问题,现在的目标是将虚拟环境学到的知识迁移到现实世界中应用以制造出更好的机器人,以及能够与我们共同在现实世界中互动的实体智能体,学习如何像人类和动物那样学习。
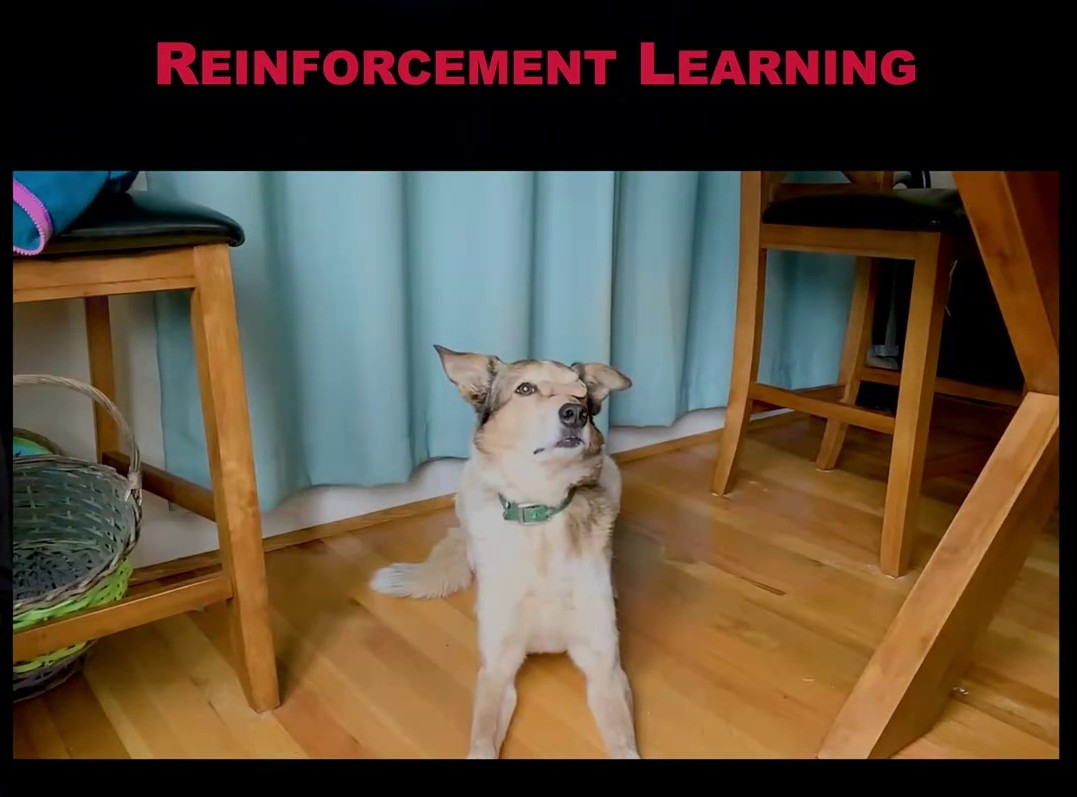
无论何时,任何训练过动物的人,无论是狗还是其他动物,都进行过某种形式的强化学习或强化训练,没错,这实际上就是 "强化" 一词的由来。
无论是在动物系统还是人类系统中,你都会通过奖励(比如零食)来强化好的行为,因此,这里的核心就是通过正向强化学习一种良好的控制策略或一系列有效的行为。
OK,这就是我们今天要讨论的内容。
2. 强化学习概述
我将带大家梳理整个框架,因此我想理清其中的关键点,我们将讨论两个主要部分:首先是强化学习的框架,即如何学习与环境互动的基本方法;其次是在此框架下,如何实际优化智能体的行为或策略,这是一个复杂的优化问题,今天我们会围绕这两点展开讨论。
而在之后的视频中,我们将深入探讨深度强化学习,即结合现代技术和深度神经网络的强化学习方法,以及这些系统所能实现的惊人应用和性能表现。
OK,接下来我们将从头开始一步步构建这个强化学习框架,其核心在于,你需要从一个智能体和一个环境开始,智能体能够采取行动与环境进行交互:
在第一个例子中(我还会举几个例子),我们将讨论一只老鼠在迷宫中的情境:
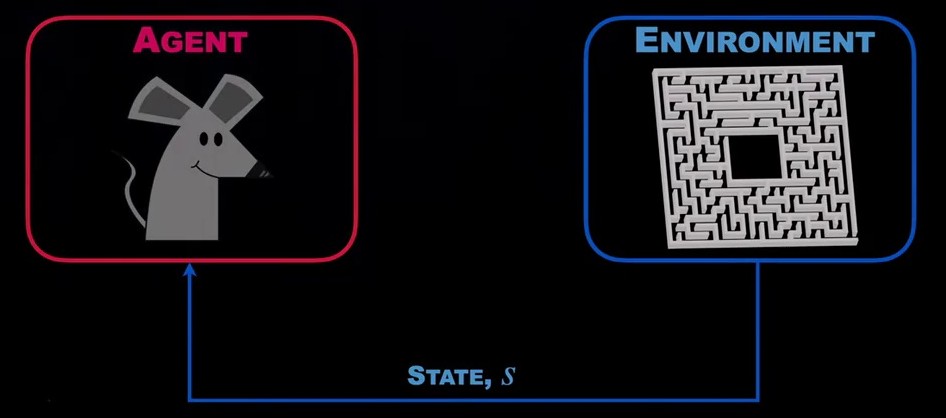
因此,智能体是一只老鼠,环境则是一个迷宫,老鼠能够测量它在环境中的当前状态,即测量状态 s s s ,需要注意的是,它测量的并非完整状态,老鼠并没有对整个迷宫的全局视角,它只知道当前所处的位置以及过去的位置。
接着,老鼠会采取某个动作 a a a 即决定下一步该做什么:
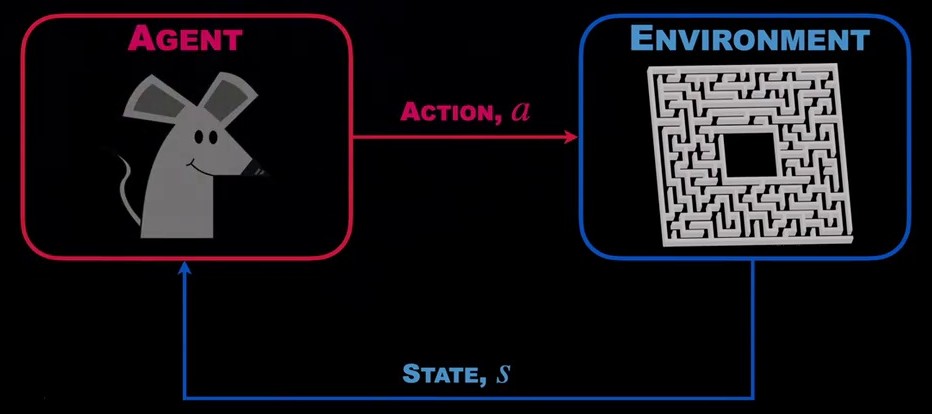
OK,在这种情况下,它可以选择左转、右转或直行,而只有在迷宫尽头时,老鼠才能真正获得奖励:
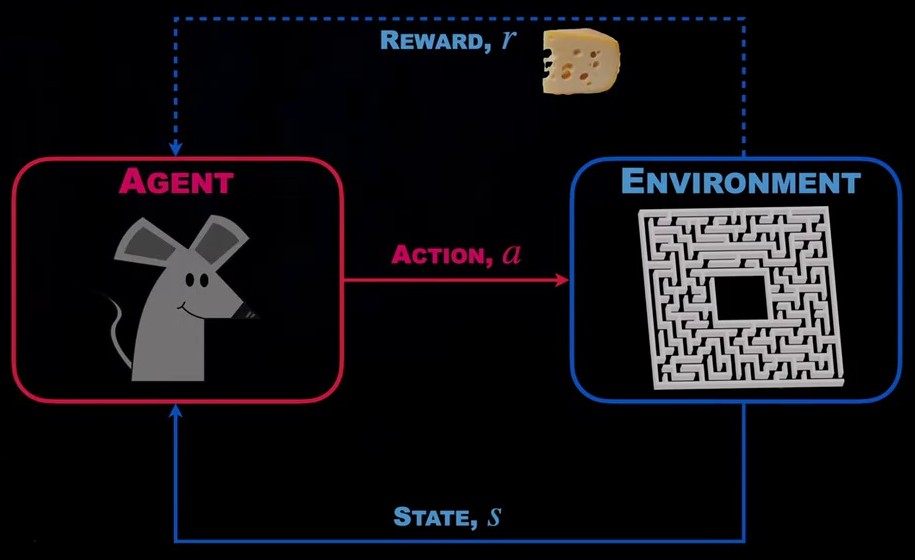
因此,这些奖励非常稀疏,数量少且间隔远,在这种情况下,如果它走到迷宫的尽头,可能会得到一块奶酪。
这个故事的核心在于,这个智能体需要做出一些决策,它能够控制自己的行为,因此具备自主性和对环境的掌控能力,它能够感知自己在环境中的位置,并且偶尔会获得奖励,奖励的获得并不频繁,因此这个系统的目标之一就是学习哪些行为真正导致了奖励的获得或缺失:
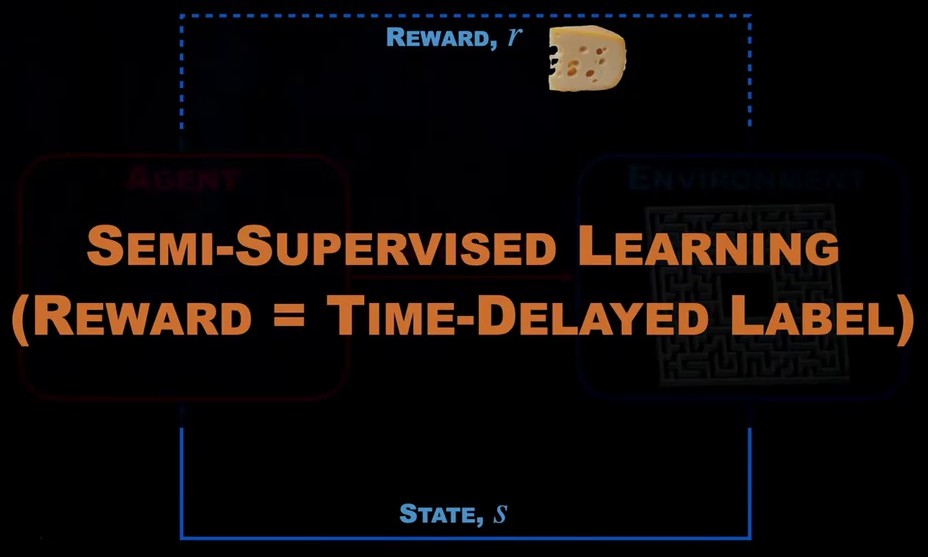
从某种意义上来说,这属于机器学习的范畴,这被称为半监督学习,如果老鼠在迷宫的每一个阶段都能获得奖励,即在每一个正确的转弯处都能得到一块奶酪,那么这就只是普通的监督学习,而这些奖励则被称为标签,它们会告诉你,"是的,你做对了!",或者,"不,你做错了!"。
但由于这里的奖励是延迟的 --- 它只在游戏结束时或非常零星地出现,并且并不与每一个单独地行为直接关联,我们将这种时间延迟的标签称为 奖励(reward),而这就变成了一个半监督学习问题。
因此,从某种意义上说,它仍然是监督学习,因为有监督反馈告诉智能体哪些行为有效,哪些无效,但它提供的信息远不及经典监督学习中的那样丰富,而这正是强化学习的主要挑战之一:这些标签极为稀少,且很难判断究竟是哪些行为促成了最终获得奖励。
因此,这是一个更加复杂的优化问题,通常需要更多的数据以及更多的试错过程,接下来,我们将详细讨论这一点。
我还喜欢以国际象棋、跳棋或井字棋为例 --- 基本上就是各种游戏,在这些游戏中,智能体遵循一定的规则,并通过一系列有限的动作与环境互动,以国际象棋为例:
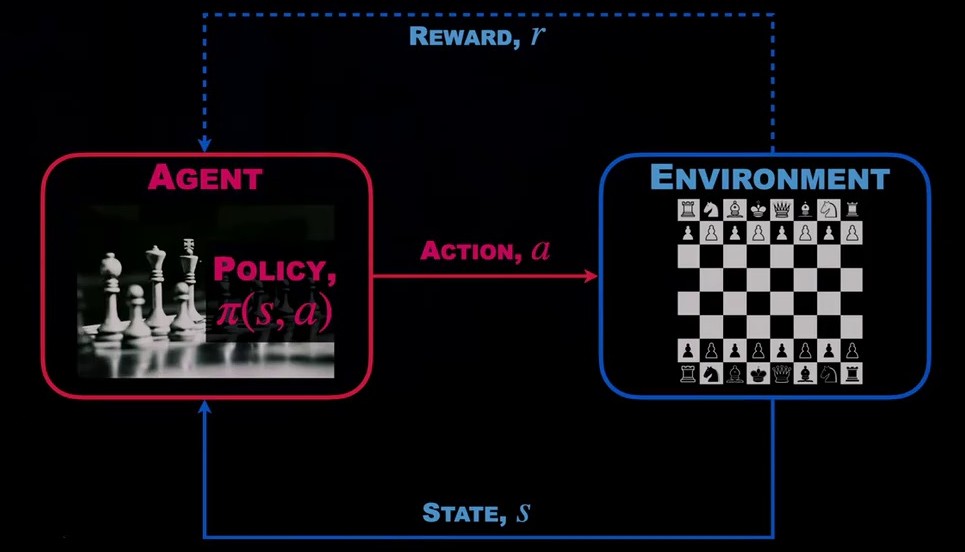
有趣的是,环境不仅包括游戏规则,还包括一个试图击败你的对手,你的目标是击败对手,试图将对方将死,而对方也在努力战胜你,因此,有趣的是,游戏的规则本身就在引导这种对抗,从强化学习的角度来看,《黑客帝国》中的尼奥实际上就是智能体,他试图学习矩阵(即环境)的规则。
OK,让我们回到国际象棋的例子,这个例子很好地体现了强化学习中的许多问题,所以我们将用它作为我们的典型问题。
3. 强化学习的数学基础
归根结底,强化学习中的一大挑战是设计一种策略(Policy),即在给定状态 s s s 的情况下,决定采取哪些行动,以最大化未来获得奖励的概率,这个智能体所能做的全部就是决定一个策略,这被称为策略而非控制律(control law),原因有很多,部分是因为环境并非确定性的,而是概率性的,因此这个策略也将是概率性的。
POLICY π ( s , a ) = Pr ( a t = a ∣ s t = s ) \color{red} \text{POLICY} \quad \pi(s,a) = \text{Pr}(a_t=a \mid s_t=s) POLICYπ(s,a)=Pr(at=a∣st=s)
OK,所以我们的策略 π \pi π 会告诉我,在当前处于状态 s s s 的情况下,采取动作 a a a 的概率是多少,再次强调,这是概率性的,因为我们可能会决定采用混合策略。
一个典型的控制系统,比如从车上摆动起一个摆锤,规则永远不会改变,系统的运动始终遵循 F = m a F=ma F=ma 的规律,因此我的控制法则也是确定性的,且永远不会改变,但在国际象棋游戏中,我的对手可能有些随机性,或者我可能正在学习如何下棋,因此,我的策略可能是这样的:80% 的情况下,我会选择移动我的兵 --- 比如朝左侧这个方向移动,但 20% 的情况下,我会尝试另一种走法,以防环境发生变化,那时候可能会出现一些不同的情况,因此,你将采用一种概率性策略来探索并优化从环境中获得的奖励。
很好,接下来你可以采取行动了,没错,关键在于一旦你制定了这个策略,并且知道在给定状态下采取某个动作的概率,你就可以运行这个策略,然后观察能获得多少奖励:
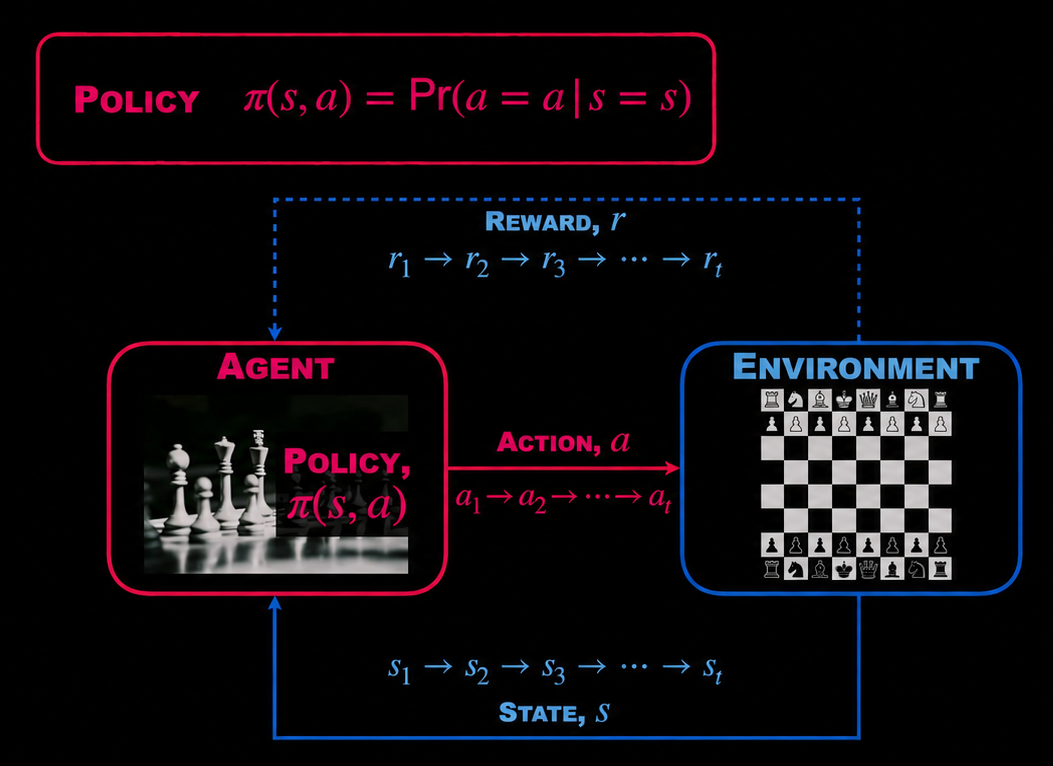
而这一切都是在时间中发生的,因此,你会在时间步长 1、时间步长 2 等时刻依次采取行动,并在时间步长 1、时间步长 2、时间步长 3,一直到时间步长 t t t 时测量状态,并且在每个动作和每次测量中都有可能获得相应的奖励,大多数情况下,这些奖励会是空值或零,你可能直到国际象棋游戏的最后才能获得奖励,但原则上,在过程中的某些时刻你也可能获得奖励。
再次强调,国际象棋是一个很好的例子,说明了这有多难,因为你可能会制定一个你认为在国际象棋中击败对手的正确策略,但你只能在游戏结束时获得一次奖励。
也许我下了一盘精彩绝伦的棋,但仅仅因为一个失误,就输掉了整场比赛,我是否应该完全抛弃那一系列的动作?你如何判断哪些动作是好的,哪些动作是坏的?这是一个极其复杂的优化问题,而这正是强化学习的核心所在。
OK,因此设计一个优秀策略的部分工作在于理解在给定策略 π \pi π 的情况下,处于某个特定状态 s s s 的价值是什么:
VALUE V π ( s ) = E ( ∑ t γ t r t ∣ s 0 = s ) \color{blue} \text{VALUE} \quad V_{\pi}(s) = \mathbb{E} \left( \sum_{t} \gamma^t r_t \mid s_0 = s \right) VALUEVπ(s)=E(t∑γtrt∣s0=s)
因此,一旦我选定了一个策略,我就可以开始学习系统中每个状态的价值,例如国际象棋中每个棋盘位置的价值,这是基于如果我从那个状态开始并执行该策略,未来预期能获得的奖励。
让我再重复一遍,这句话有点复杂,因此,在给定策略 π \pi π 下状态 s s s 的价值,是我从该状态开始并执行该策略时,未来预期能获得的奖励。
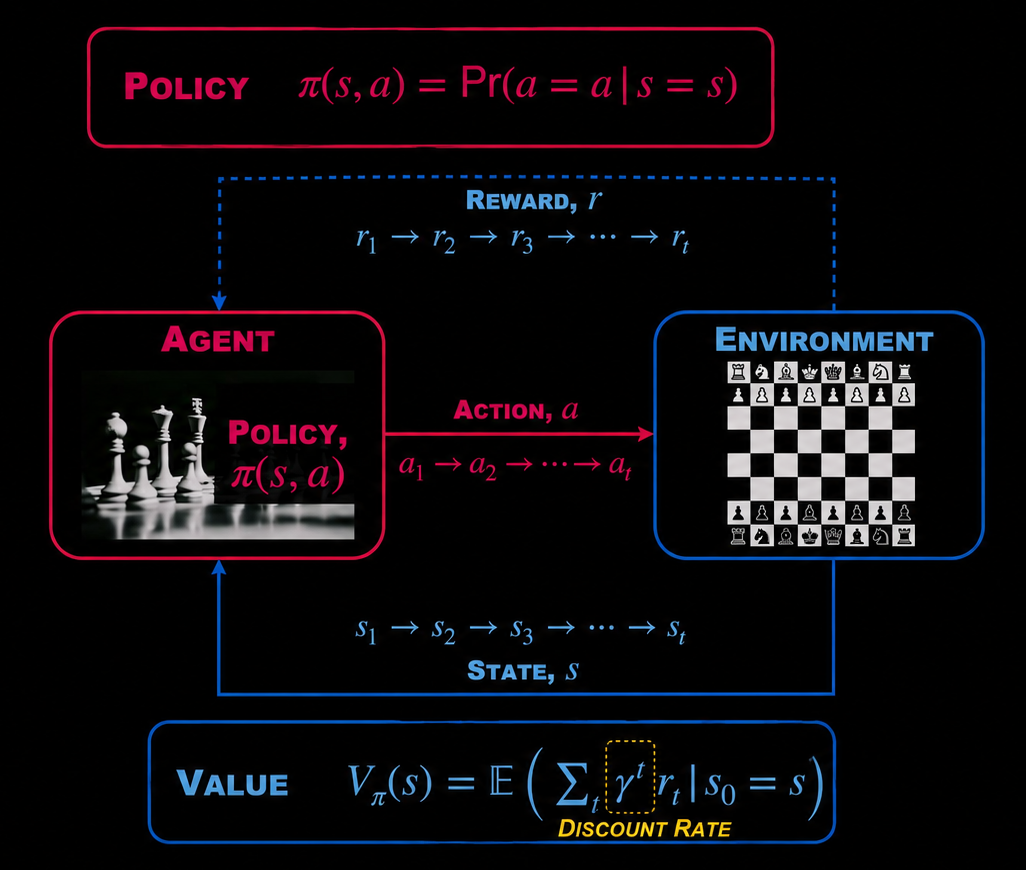
这里有一个 γ t \gamma^t γt ,它是一个 折扣率(discount rate) ,这意味着与即时奖励相比,我会稍微折现未来的奖励, γ \gamma γ 是一个介于 0 和 1 之间的常数,它基本上告诉你,你有多倾向于立即获得奖励,而不是在遥远的未来获得奖励。这与经济理论和心理学密切相关,一般来说,人们更渴望立即获得奖励,而不是等待很久之后的延迟奖励,明白吧。
但基本思想是,你可以开始理解这个策略,以及哪些策略是好是坏,基于哪些棋盘位置是好的,哪些价值函数是好的,这某种程度上也是人类下棋的方式。因此,棋盘的所有可能状态集合在组合上是极其庞大的,状态数量多到无法计数,你永远无法在脑海中全部记住它们,但我们会开始总结一些经验法则,来判断哪些棋盘位置是好的。
例如,如果我吃掉了对手的皇后,而我的皇后还在,那么我赢得比赛并获得奖励的预期概率可能会更高,因此,你可以通过计算棋盘上的棋子价值来近似评估某个状态的价值,这是一种非常基础的价值函数,随着你不断练习并掌握技巧,你可能会逐步优化你的价值函数,从而更好地理解游戏中哪些因素至关重要,没错,这也会帮助你优化策略,从而更有效地达到那些有利的状态。
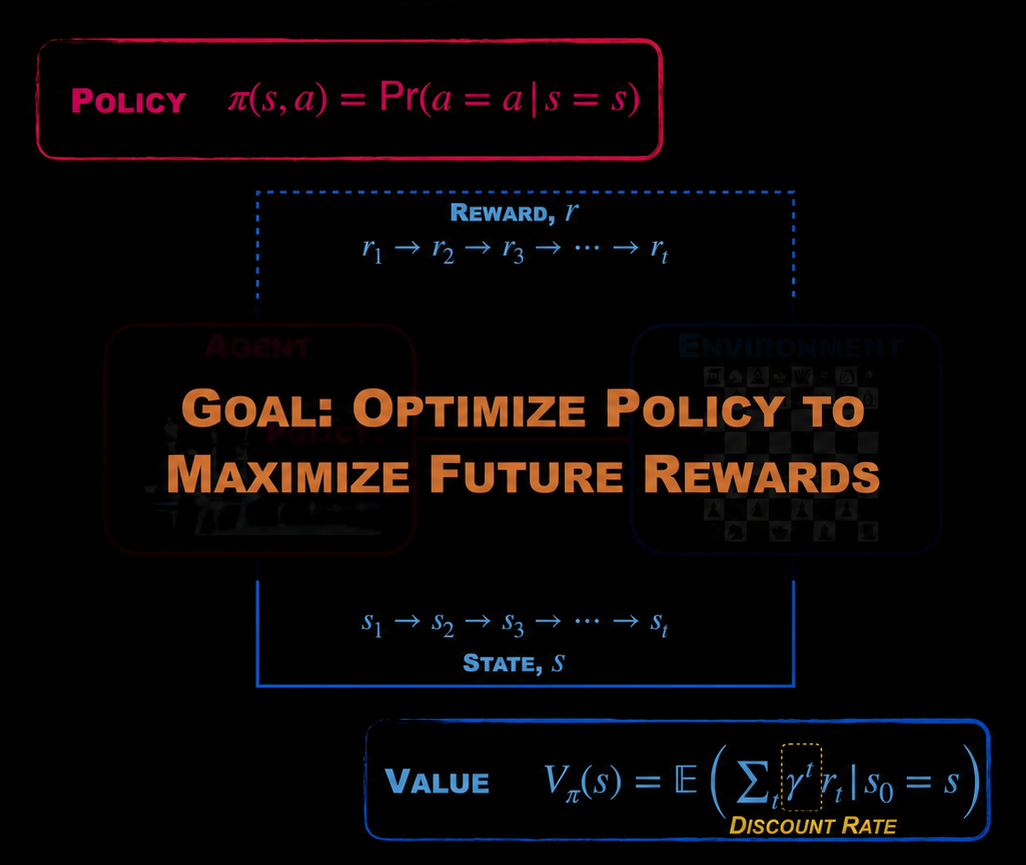
因此,在这个大框架下 --- 也就是强化学习框架 --- 目标是通过优化策略来最大化未来奖励 ,归根结底,这是一个关于求解策略 π \pi π 的优化问题。
4. 马尔可夫决策过程
通常,我们认为环境并非完全确定性的,这与经典力学和经典控制系统中的假设不同,相反,我们认为环境中存在某种随机或概率性的成分,因此这些被称为马尔可夫决策过程(MDPs):
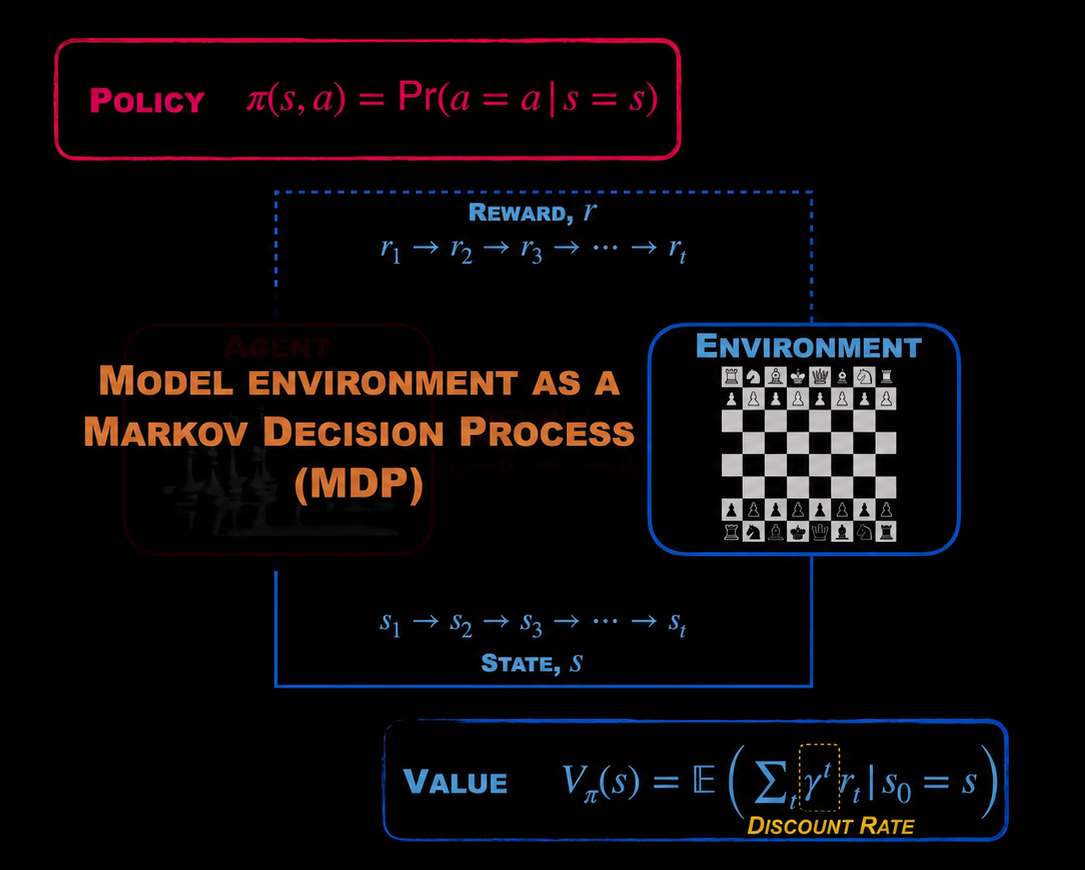
这意味着,如果我们当前处于状态 s s s 并采取动作 a a a ,那么在下一个时间步,我们有可能转移到多个不同的新状态 s ′ s' s′ ,且每个状态转移都有一定的概率,这有点像掷骰子,然后根据结果转移到下一个状态,明白了吗?
这让我们想到了双陆棋,我认为这是一个很好的例子,因为双陆棋既有规则性,包含确定性的元素,但每一回合掷骰子又引入了随机性,从而形成了这种随机的马尔可夫决策过程。因此,从当前状态和动作转移到下一个状态 s ′ s' s′ 存在一定的概率,这也使得优化策略变得更加困难,正因如此,策略本身必须是概率性的,因为环境本身也是概率性的。
5. 信用分配问题
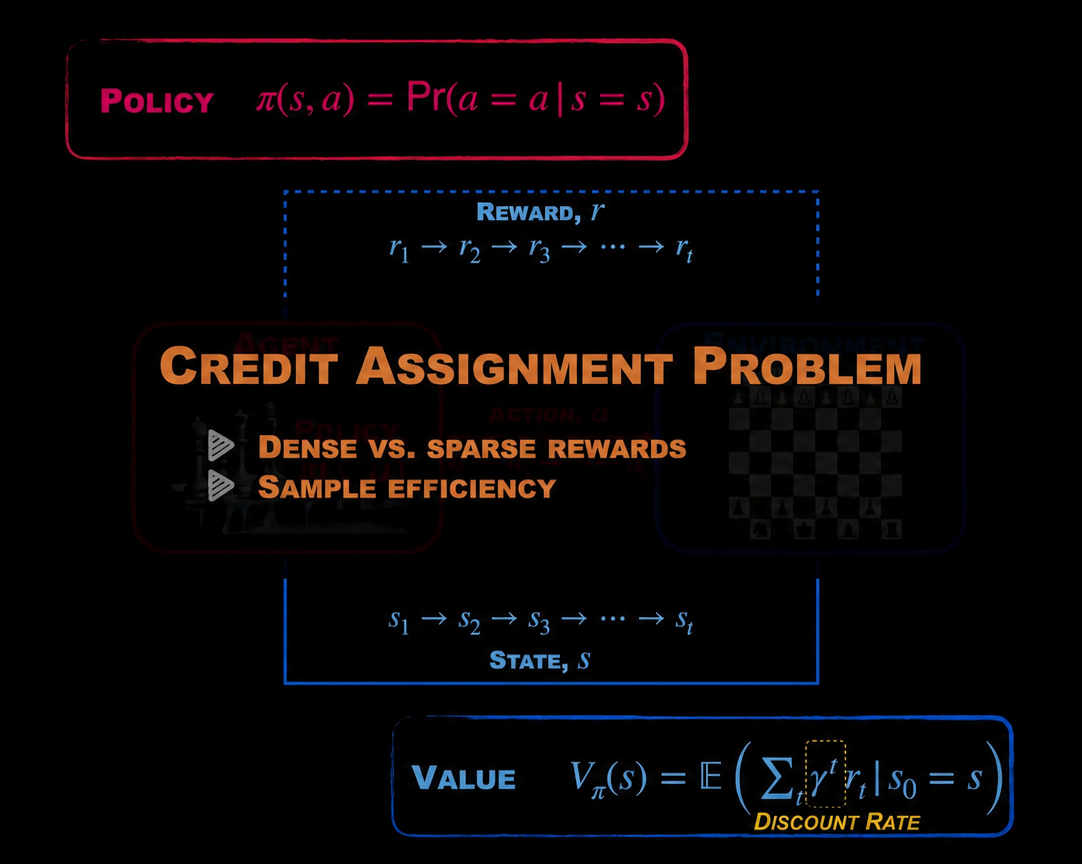
我们之前提到的信用分配问题,其核心在于:由于奖励通常是稀疏且不频繁的,因此很难判断究竟是哪些动作序列真正导致了奖励的获取。
早在 20 世纪 60 年代,Minsky 就认识到了这个问题,并且它一直是强化学习领域的核心挑战之一,这一挑战已经持续了六十年,这个问题至今仍然是研究者们努力攻克的难题 --- 如何解决信用分配问题。
我认为有几个关键词非常重要,那就是 密集奖励与部分奖励。同样地,国际象棋的奖励非常稀疏,你只有在将死对方或被对方将死时才知道自己是否获胜,而在游戏过程中,你并不一定能在中间阶段获得具体的奖励,如果奖励更加密集 --- 比如,如果你在与一位更精通棋艺的大师对弈,他们会在每一步棋后告诉你:"我不会这么走,因为接下来我会这样应对" 或 "不,这样不行",这步棋走得非常好,因为它构建了这样的局面,这是一个非常有利的局面,他们会为你提供更密集的奖励反馈,从而帮助你更快地学习。
但一般来说,如果奖励是稀疏的,那么从机器学习的术语来看,强化学习的样本效率会非常低,这意味着,如果我只能获得零星的奖励,我就需要反复进行无数次尝试,在奖励稀疏的情况下,我需要大量的示例才能学习到一个良好且最优的策略,因此,稀疏奖励和信用分配问题使得通过优化学习正确策略变得非常困难,而这与样本效率密切相关。
因此,通常情况下,我们在许多系统中采用的方法称为奖励塑形,即使你获得的奖励是稀疏的,专家也可以通过构建代理奖励,让你在达到最终奖励的过程中获得更密集的中间奖励。这样一来,专家实际上通过提供更密集的中间奖励来引导学习过程,这就是所谓的奖励塑形。
6. 强化学习的优化技术
OK,接下来,我们将讨论如何实现最终目标 --- 优化这个策略。针对这个优化问题,存在许多策略,需要记住的是,无论是机器学习还是控制理论,几乎所有问题都可以归纳为优化问题。
确实如此,你可以将这些问题表述为复杂的非线性、非凸优化问题,在机器学习中,我们通过数据来解决它们,而在控制领域,我们则是在动态约束条件下求解这些问题,这并无不同,这正处在机器学习与控制理论的交汇点上,而强化学习则是这一框架下的一个大型优化问题。
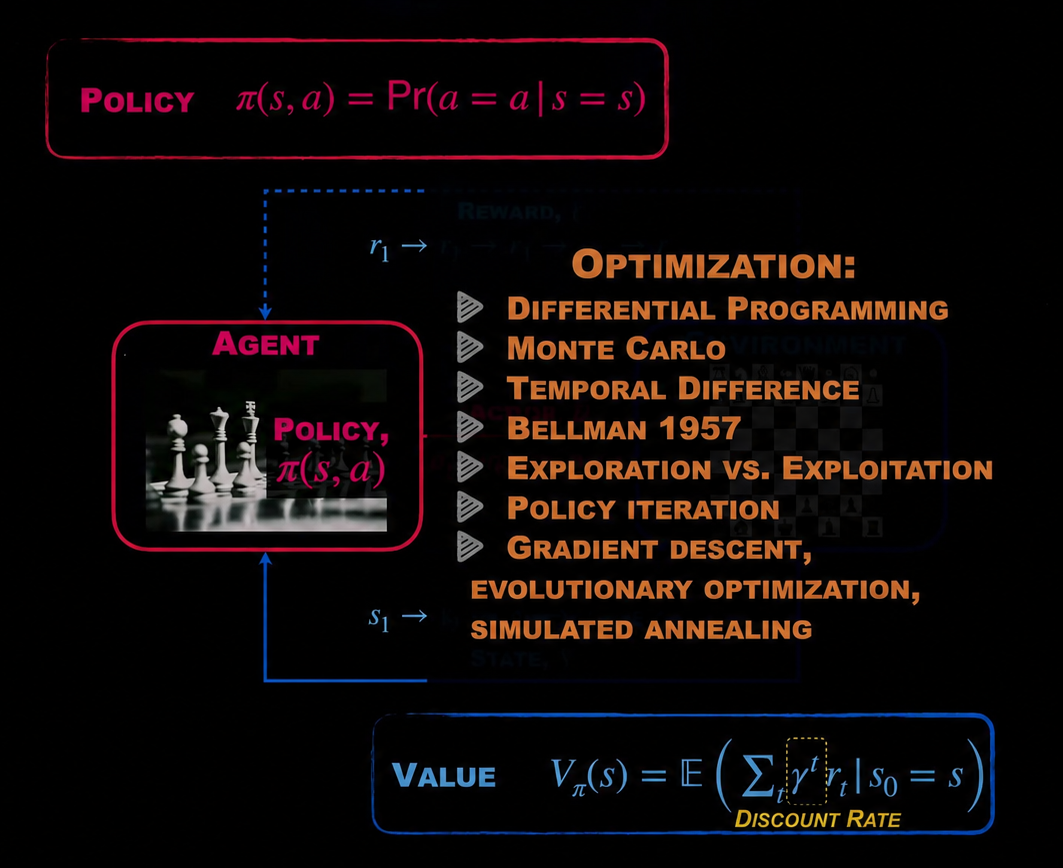
因此,为了优化策略 s s s 并根据给定的奖励测量值(即这种间歇性反馈),存在多种策略可供选择,于是,就有了微分编程。强化学习与博弈论几乎是同步发展的,而微分编程正是其中的一项优化技术。蒙特卡洛方法是一种用于优化这些策略的经典方法,基本上就是随机尝试各种可能性。时序差分法就像是微分编程与蒙特卡罗方法之间的最佳平衡点,它巧妙地结合了两者的优点,这种方法是无模型的,因此不需要对系统建立任何模型,并且它与贝尔曼优化密切相关。
贝尔曼是最优控制理论的先驱之一,同时也为当今强化学习奠定了许多基础,在强化学习问题中 --- 这一点同样适用于大多数机器学习 --- 存在一种平衡,即探索与利用之间的取舍,这一点在控制理论中也是如此。因此,这个策略 π \pi π 通常会被参数化,我们会引入一些参数,并尝试优化这些参数以赢得游戏或达成目标。
那么,我们应该在优化策略或利用策略上投入多少精力,又该在尝试可能的新方法上投入多少努力呢?这些新方法可能不会奏效,但也可能带来更高的回报,是我从未尝试过的,也就是说,我们需要在探索优质策略与利用现有策略之间分配多少精力,关于这一点,这里就不多赘述了,我们在其他视频中对此多有讨论。
但探索与利用的平衡是机器学习和控制理论中的一个基本挑战,同时也是强化学习中的一大难题,策略迭代也是如此。你建立了一个动态系统,在这个系统中,根据所获得的奖励,通过迭代更新策略,使其随着时间的推移,基于新信息和更优的奖励信息,变得越来越好,这就是策略迭代。
而实现这一目标的方法多种多样,下面我们将列举一些常见的策略。你可以采用模拟退火、进化优化、梯度下降等方法,同时也可以运用神经网络和机器学习领域的所有现代工具 --- 如随机梯度下降、Adam 优化器等。
7. 强化学习示例
在过去的 10 到 15 年间,利用深度学习优化这些策略的研究取得了许多引入注目的新进展,接下来我们将分享一些有趣的实例:
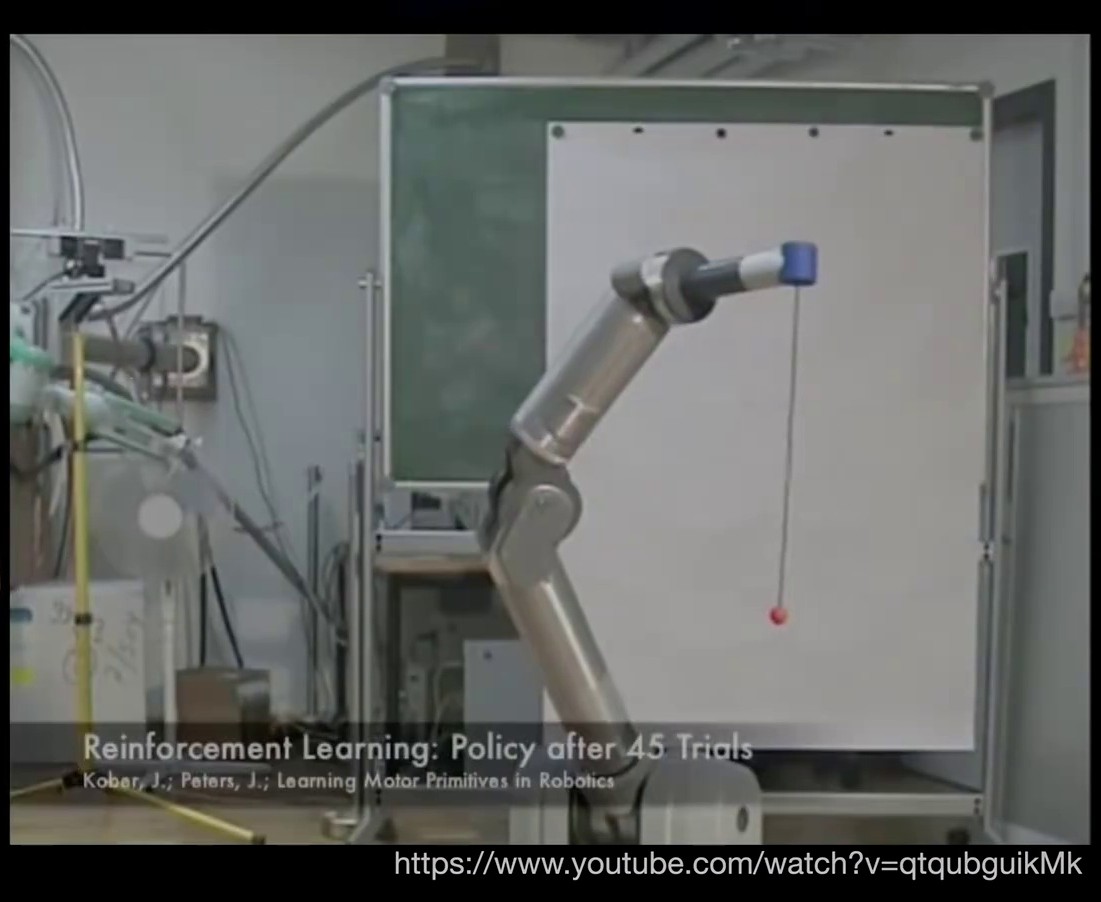
上面这个例子是:学习如何用杯子接住球,这是一个有趣的儿童游戏,首先,由一位人类专家为机器人演示一次,展示如何完成这个动作(如果可能的话)。接着,在模仿学习之后,机器人通过反复试验,逐渐注意到背景是白色的,杯子是蓝色的,而球是红色的,它利用摄像头捕捉的视觉信息,经过几次迭代后,已经能够相当接近目标了。
这与儿童的学习方式并无太大差异,要知道,孩子们也不可能在两三次尝试中就学会这个动作,可能需要几十次的尝试,才能真正接近目标,然后学会如何将球接进杯子里,最终,经过一百次试验,这个系统真正掌握了游戏的规则,理解了如何利用物理原理将球投入杯中。
这是一个非常简单的机器人示例,虽然这个视频不算最新,但它非常有趣,展示了学习真实物理系统的可能性。
下面是另一个例子:
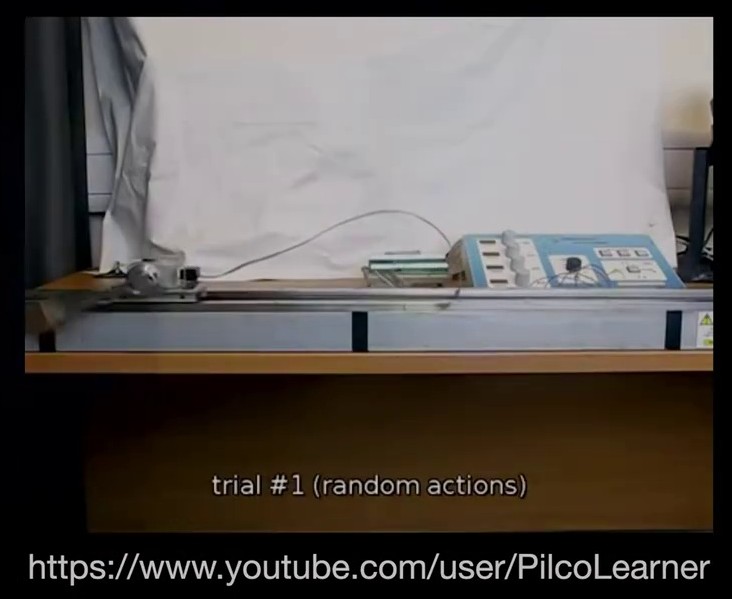
这被称为 Pilco 学习器,大家感兴趣的可以去详细了解 Pilco 的相关内容,在这个例子中,他们学习如何通过摆动和稳定小车上的摆杆,同时结合试错法和物理模型,以极少的样本高效地掌握这一技能。因此,如果不学习模型或不具备基于牛顿定律的物理模型,就无法学会如何完成这一任务。
整个实验的学习过程非常低效,比如随机控制信号只能让你接近直立位置,然后才能开始稳定它,因此,如果没有模型,就需要大量的试错。从某种意义上说,Pilco 学习器利用了物理规律的存在,我们确实了解物理规律,也拥有模型 --- 这使得学习过程变得更快、更高效,所需的样本数量大幅减少,在第六次尝试后,它确实学会了如何让这个系统直立并保持稳定。
8. Q-Learning
最后我们要介绍的是 Q-Learning:
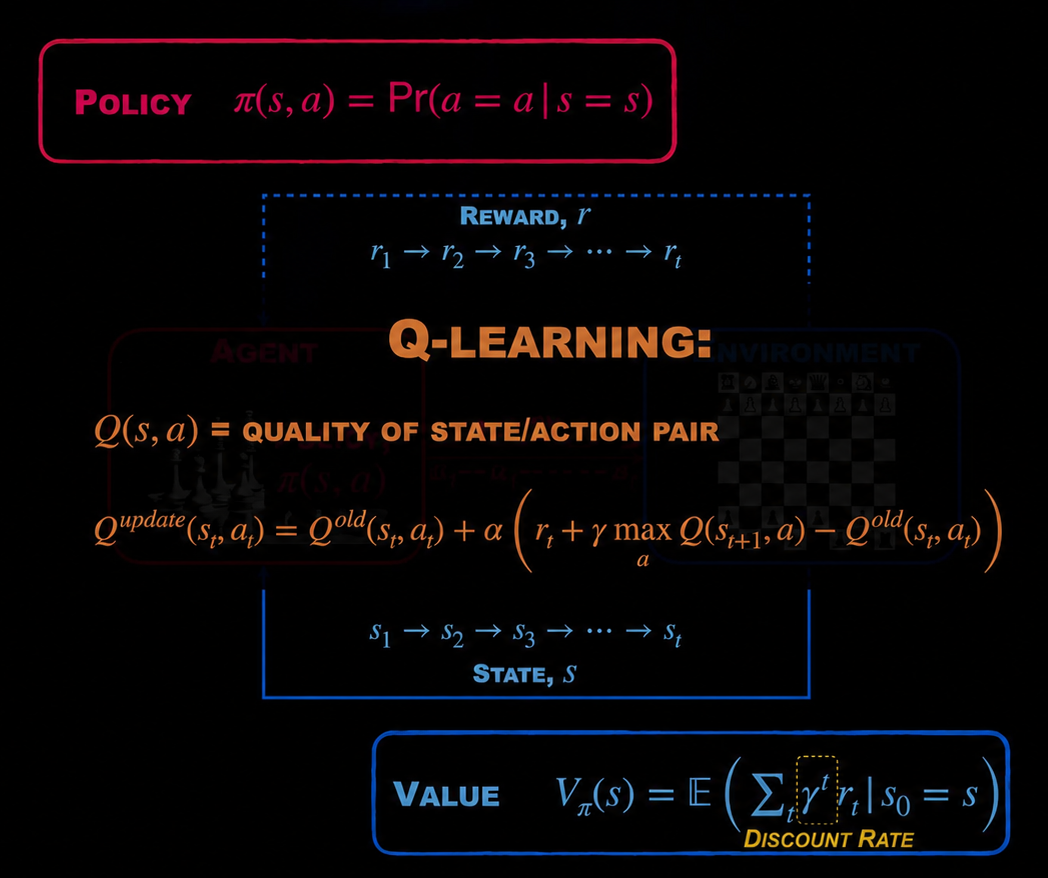
在 Q-Learning 中,你无需分别学习策略和价值函数,而是可以同时学习这两者。这里有一个 Q 函数,它不仅仅是状态 s s s 的函数,而是状态和动作的函数即 Q ( s , a ) Q(s,a) Q(s,a) ,它告诉你处于该状态并采取该动作的质量如何,因此,它某种程度上结合了价值和策略,你可以将其视为状态和动作的价值函数,假设我在未来会采取最明智和最优的动作。
接下来,我们将详细讲解这一过程的具体表现,更新这个质量函数的方法是:你保留原有的质量函数,然后在获得奖励时,对其进行更新:
Q u p d a t e ( s t , a t ) = Q o l d ( s t , a t ) + α ( r t + γ max a Q ( s t + 1 , a ) − Q o l d ( s t , a t ) ) \color{orange} Q^{update}(s_t, a_t) = Q^{old}(s_t, a_t) + \alpha \left( r_t + \gamma \max_{a} Q(s_{t+1}, a) - Q^{old}(s_t, a_t) \right) Qupdate(st,at)=Qold(st,at)+α(rt+γamaxQ(st+1,a)−Qold(st,at))
其中 α \alpha α 是学习率, γ \gamma γ 是折扣率,而你所做的操作正是基于这两个参数。这个未来 Q Q Q 的最大值基本上表示,我假设自己在未来总是会采取最优的动作,如果我在未来采取最优动作,那么我当前状态和动作的质量会如何呢?
让我们再重复一遍,这看起来有点像循环逻辑,但它确实是一种巧妙的方法,将策略和价值结合到一个可以学习的函数中,同样地,你可以通过深度神经网络来学习这个函数。
如今的定义是:给定状态 s s s 和动作 a a a ,并假设我在未来采取最优动作,那么处于该状态并执行该动作的质量如何?这非常有用,因为如果你确实知道质量函数,那么一旦我处于状态 s s s ,我只需遍历所有可能的动作 a a a ,并选择质量最高的那个动作即可,因此,这是一种非常优雅的选择动作的方式。
基于这个质量函数,当我处于状态 s s s 时,只需选择能带来最高质量的动作并执行它。如果我在未来一直这样做就能最大化我的价值,从而得到一种策略,所以这非常酷。
9. 事后经验回放
另一件我认为非常有趣的事情是事后经验和回放机制,再次谈到信用分配问题以及由此产生的部分奖励问题时,以倒立摆实验为例,系统需要花费相当长的时间才能接近直立位置,从而开始获得奖励。
在事后经验回放中,你并不会丢弃那些未能带来奖励的数据,而是会思考:也许我的系统或这一系列动作对于实现另一种奖励是有价值的。以球进杯的例子来说,如果球没有进杯,而是飞到了另一个位置,我会回顾并回放这一事件,然后思考:也许有一天,我实际上会希望重复刚才的动作,因此,我最好记住这一点,并将其编码保存下来,这是一组适用于不同奖励结构的有效动作序列,虽然这不是我期望的球进杯的奖励,而是将球移动到另一个位置的奖励,通过学习如何进入这些不同的状态,你会获得更多的强化信号。类似于人工奖励,从而更深入地理解系统的物理特性和动力学特性,进而提升其价值,这种价值带来了深刻的洞察力。
回放机制在提高数据效率和学习涉及更复杂状态空间的困难任务方面绝对是一项关键性进展,这更接近人类的行为方式,比如打网球时,如果我击球失误,球飞向了意料之外的方向,但也许未来这正是我希望实现的效果,因此我会将其记录下来,以便在需要时能够利用这些信息,因此,这种方式奖励效率更高,样本效率更高。
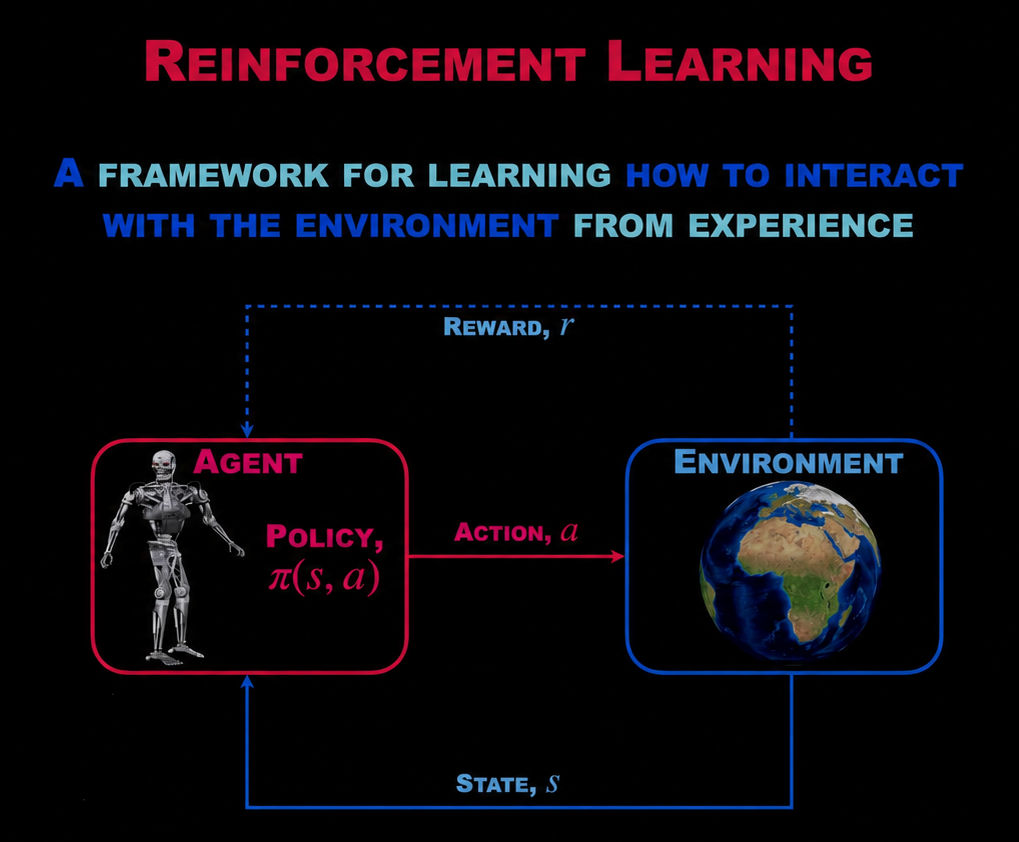
在本次课程中,我们讨论了强化学习,这是一种通过经验学习如何与环境交互的框架,在下一讲中,我们将探讨如何结合神经网络实现这一目标,并介绍该领域一些令人振奋的最新进展。
结语
本讲作为强化学习的入门第一课,从框架、数学基础到核心挑战与优化技术,为我们勾勒出了 RL 的完整轮廓。强化学习本质上是一个在不确定环境中通过试错来最大化累积奖励的优化问题,其核心要素包括:智能体(Agent)、环境(Environment)、策略(Policy π \pi π)、价值函数(Value Function V π V_{\pi} Vπ)以及奖励信号(Reward)。
课程中反复强调的几个关键挑战构成了 RL 研究的核心议题:信用分配问题 (Credit Assignment)---由于奖励稀疏且延迟,如何判断哪些动作真正贡献了最终的奖励;探索与利用的权衡 (Exploration vs. Exploitation)---在优化已知策略与尝试未知可能之间如何分配资源;以及样本效率(Sample Efficiency)---在奖励稀疏的环境下如何用更少的试错次数学到有效的策略。
在方法论层面,我们从马尔可夫决策过程(MDP)的概率框架出发,了解了蒙特卡洛方法、时序差分学习(TD Learning)、Q-Learning 等经典优化技术,也接触了奖励塑形(Reward Shaping)和事后经验回放(HER)等提升学习效率的实用技巧。这些方法并非孤立存在,而是根植于贝尔曼最优控制理论,并站在机器学习与控制理论的交汇点上。
回顾开篇的例子---从迷宫中的老鼠到国际象棋对弈,从双足机器人行走到用杯子接球---我们可以看到 RL 的强大之处在于其通用性:同一个框架可以适用于完全不同的领域和问题。而随着深度神经网络的引入(下一讲的主题),这一框架的能力边界还将被进一步拓展。
最后,这门课程不仅传授技术,更传递了一种思考方式:学习本身就是一个优化问题---就像智能体在环境中通过试错不断改进策略一样,我们在学习 RL 的过程中,也需要不断实践、反思和迭代,才能真正内化这些思想 🚀。
下一讲我们将来学习如何利用强化学习算法训练一个神经网络来替代传统控制器,敬请期待🤗