视觉SLAM第5讲|相机成像模型:针孔投影、畸变修正与深度感知全拆解
前面三讲我们把刚体运动、李群李代数啃完,算是把「相机自身位姿怎么描述、怎么优化」的数学工具备齐了。但SLAM的核心是"观测"------光知道自己怎么动没用,还得知道相机拍到的三维世界,是怎么变成二维像素的。反过来,我们又怎么从像素里,反推出空间的几何信息。
第5讲就把相机成像这件事从根上讲透:从经典针孔模型,到透镜畸变修正,再到双目、RGB-D两种深度感知方案,最后落到代码里的图像操作。
一、针孔相机模型:三维世界的二维投影
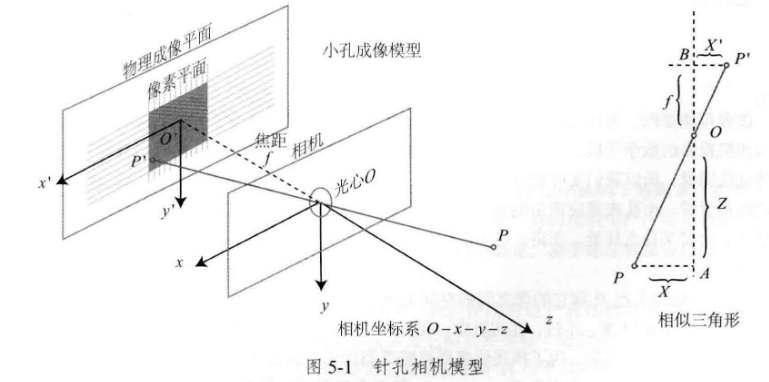
最基础的成像模型就是针孔模型,本质就是初中物理课的小孔成像:所有光线穿过一个极小的针孔,在后方的成像平面上形成倒立的实像。
1.1 内参矩阵:相机的「出厂身份证」
理想针孔只有一个光心,空间点投影到成像平面的位置,可以通过相似三角形精确计算。
工程上我们会把成像平面对称"挪"到相机前方,省去倒立的负号,再把物理长度换算成像素单位,最终得到内参矩阵K。
内参只和相机自身硬件有关,一共4个核心参数:
fx、fy:x、y方向的等效焦距,单位为像素cx、cy:光心在图像中的像素偏移
💡通俗解释:焦距决定了相机"看得广不广",焦距越小视野越宽;光心偏移是因为生产装配时,图像传感器不可能和光心完美对齐,会有几个像素的偏差。
内参出厂就固定了,和相机怎么动、拍什么东西完全无关。做SLAM的第一步通常是标定相机,本质就是测出这四个值。
1.2 外参:相机此刻在哪里
内参是固定的,但相机是运动的。空间点首先要从世界坐标系,通过旋转和平移,变换到相机坐标系下,这部分变换参数就是外参 :旋转矩阵R和平移向量t,也就是我们前几讲反复讨论的相机位姿。
完整的成像链条是:
世界坐标点 → 外参变换到相机坐标系 → 投影到z=1归一化平面 → 内参变换得到像素坐标
1.3 四层坐标:从世界到像素的递进
整个成像过程一共涉及四层坐标,层层递进,新手最容易在这里绕晕:
| 坐标类型 | 说明 | 特点 |
|---|---|---|
| 世界坐标 | 点在真实环境中的绝对位置 | 固定不变 |
| 相机坐标 | 以相机光心为原点的相对坐标 | 随相机运动同步变化 |
| 归一化坐标 | 投影到z=1平面的坐标 | 消掉了深度维度,单目无法恢复真实尺度 |
| 像素坐标 | 图像中的行列号 | 最终输出的二维图像坐标 |
💡通俗解释:就像你坐在车里看路边的树。世界坐标就是树在路边的真实位置;相机坐标就是相对于你坐的车,树在你的左前方还是右前方;归一化坐标就是你把胳膊伸直,在你前方1米的虚拟玻璃上画出树的位置;像素坐标就是这个位置落在你视网膜上的哪个点。
1.4 单目尺度不确定性的根源
单目相机只能得到归一化坐标,只要深度和物体尺寸等比例缩放,像素坐标完全不变。
这就是单目SLAM经典的尺度不确定性:你没法区分是"大物体远距离"还是"小物体近距离",必须靠其他方式(比如IMU、双目、已知尺寸的参照物)来标定真实尺度。
二、透镜畸变:真实镜头的误差修正
理想针孔模型是完美的,但真实相机前面都有玻璃透镜。透镜加工的形状误差、装配时透镜和传感器不平行,都会让真实成像偏离针孔模型,直线拍成曲线,这就是畸变。
2.1 径向畸变:透镜形状带来的弯曲
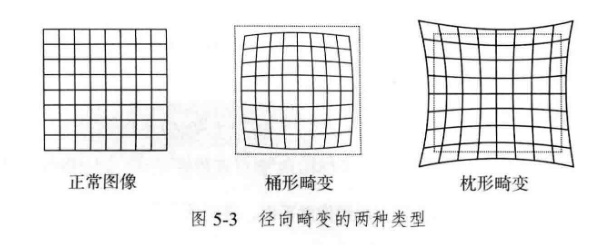
由透镜球面本身的形状导致,畸变沿径向分布,越靠近图像边缘越明显。分为两类:
- 桶形畸变:越往边缘放大率越小,直线向内凹;
- 枕形畸变:越往边缘放大率越大,直线向外凸。
工程上用多项式拟合,通常用k1、k2、k3三个系数描述径向畸变,k3主要校正边缘的大畸变。
2.2 切向畸变:装配歪了带来的偏移
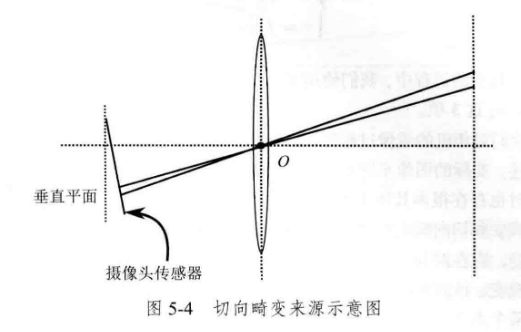
如果透镜和图像传感器不平行,相当于镜头歪着装,就会引入切向畸变。用p1、p2两个系数描述。
一共5个畸变参数(k1、k2、k3、p1、p2),就能完整描述主流相机的径向+切向畸变。
2.3 去畸变的两种工程思路
- 整图预去畸变 :先把整张畸变图像修正成理想针孔图像,后续所有算法都在去畸变图上做。 SLAM领域最常用,逻辑简洁,一次修正全程使用。
- 点级去畸变 :用到哪个像素点,就按畸变公式反推它畸变前的位置。 适合只需要少量点的场景,不用整图运算,省算力。
三、双目相机:用视差换回深度
单目天生丢了深度信息,最经典的找补方案就是再加一个相机,组成双目系统,原理和人眼靠视差判断远近一模一样。
3.1 视差测距的原理
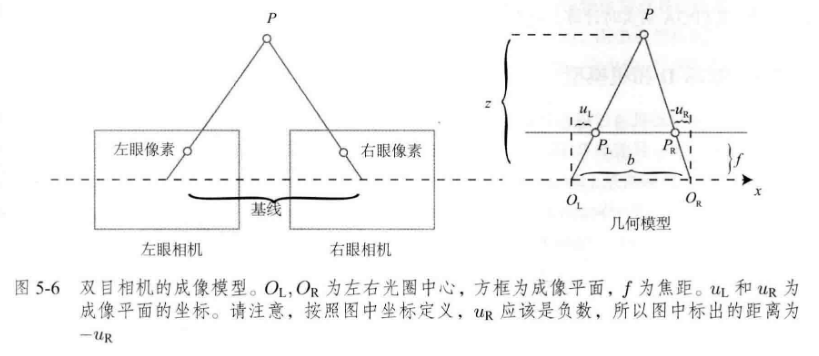
两个相机水平放置,光心之间的距离叫基线b 。同一个空间点,在左右两个相机上的成像横坐标不一样,这个差值就叫视差d。
通过相似三角形可以直接推导出深度公式:
深度 z = 焦距f × 基线b / 视差d
3.2 核心结论
- 深度和视差成反比:视差越大,物体离得越近;视差越小,距离越远。
- 基线越长,能探测的最远距离越远;小基线双目只能测很近的物体。
- 视差最小精度是1个像素,因此双目有最大探测距离上限。
💡通俗解释:就像人两只眼睛分得越开,判断远近越准;看很远的物体时,两眼视差太小,就很难判断距离了,和这个原理完全一样。
3.3 立体匹配:难的不是公式,是找对应
双目深度的公式很简单,真正难的是立体匹配 :找到左图每个像素在右图中对应的位置。
纹理丰富的地方匹配准,弱纹理的墙面、天空、光滑表面很容易匹配错误。工程上常用SGBM等半全局匹配算法,平衡精度和速度。
四、RGB-D相机:主动测量的深度方案
双目靠算法算深度,算力开销大,弱纹理还容易崩。RGB-D相机走了另一条技术路线:主动发射红外光,通过物理方法直接测量每个像素的深度。
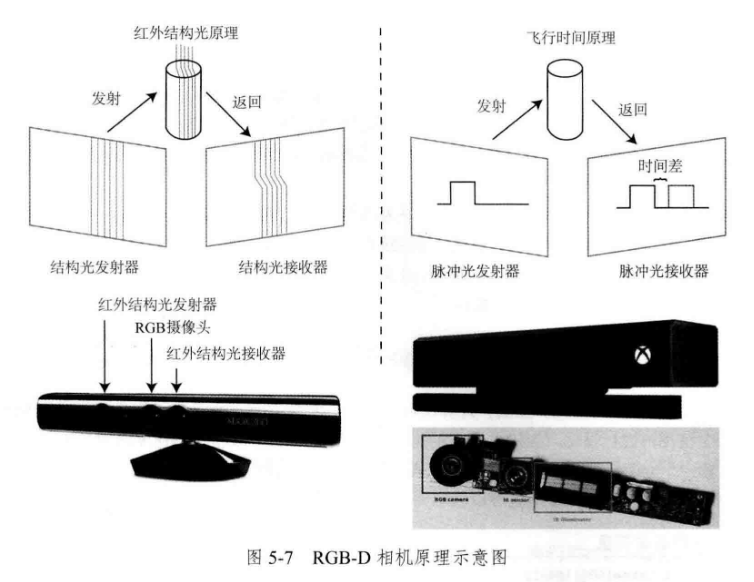
4.1 结构光方案
代表设备:Kinect一代、Intel RealSense。
原理:投射带编码的红外结构光到物体表面,接收器接收变形的图案,通过变形程度计算深度。
- 优点:近距离精度高,室内效果稳定;
- 缺点:易受太阳光干扰,室外基本失效,测量距离近。
4.2 飞行时间(ToF)方案
代表设备:Kinect二代、工业ToF传感器。
原理:发射脉冲红外光,测量光从发射到返回的时间差,直接换算成距离。
- 优点:速度快,抗干扰性比结构光好一些;
- 缺点:近距离噪声大,整体精度略低于结构光。
4.3 方案对比
RGB-D相机直接输出像素级对齐的彩色图+深度图,省去了立体匹配的算力。但也有明显局限:
- 绝大多数仅限室内使用,室外日光下红外传感器容易饱和;
- 透明、吸光、黑色材质无法有效反射,测不到深度;
- 有效测量距离大多在0.5~10米区间。
五、图像在计算机里是什么样
相机输出的图像,到了计算机里本质就是数值矩阵。这部分看似基础,却是新手踩坑的重灾区。
5.1 像素坐标系:最容易写反的坐标
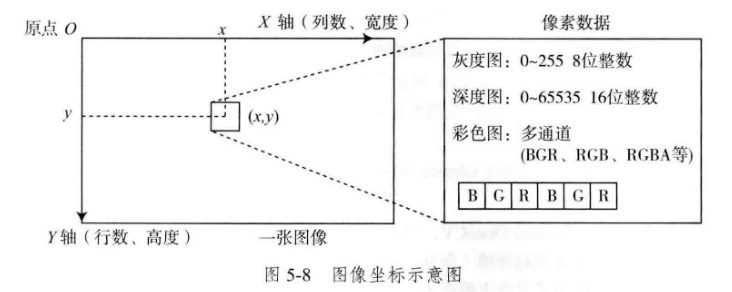
图像的像素坐标系原点在左上角,u轴向右(对应列),v轴向下(对应行)。
⚠️ 高频踩坑提醒:
计算机里图像按「先行后列」存储,也就是image[y][x]。y对应行(高度方向),x对应列(宽度方向)。
写代码把x、y顺序写反,编译器不会报错,但出来的结果全是错的,还很难定位问题。
5.2 常见的图像存储类型
- 灰度图:每个像素1个字节(0~255),只有亮度信息。SLAM的特征提取、光流大多用灰度图,计算量小。
- 彩色图 :每个像素3个字节,分别对应蓝、绿、红三个通道。 💡注意:OpenCV默认通道顺序是BGR,不是RGB!直接按RGB顺序读取,颜色会完全错位。
- 深度图:每个像素2个字节(0~65535),通常单位为毫米,存储深度值。
六、实践:从公式到代码
第5讲的实践围绕四个核心实验展开,从基础操作到完整点云拼接逐级递进。
6.1 OpenCV图像基础操作
核心操作:图像读取、显示、像素遍历、深浅拷贝。
新手必注意:
cv::Mat直接赋值是浅拷贝,修改一个另一个会同步变;深拷贝必须调用.clone()。- 遍历图像用行指针效率最高,不要逐个调用
.at(),性能差距很大。
6.2 手写实现图像去畸变
不用OpenCV内置的去畸变函数,自己按畸变公式逐像素计算,彻底理解畸变修正的过程。
核心思路:遍历去畸变图像的每个像素,反算它在原始畸变图中的坐标,用最近邻插值取灰度值。
6.3 双目视差与三维点云
输入左右目图像,调用SGBM算法计算视差图,再根据双目成像公式,把每个有效像素转换成三维空间点,生成点云。
工程提示:SGBM的参数对效果影响极大,最小视差、视差范围要根据相机基线、测量量程针对性调整。
6.4 RGB-D多帧点云拼接
输入多组彩色图、深度图,以及对应帧的相机位姿,把每帧的点云都变换到世界坐标系下拼接,形成稠密点云地图。
这也是RGB-D SLAM最基础的建图思路。
小结
这一讲本质上是把SLAM的观测方程完整拆解透了。三维空间点经过刚体变换、针孔投影、透镜畸变,最终落到二维像素矩阵上,这就是视觉信息从真实世界到计算机数据的完整链条。
有了前几讲的运动方程,加上这一讲的观测方程,我们就有了SLAM问题的完整数学描述。下一讲我们正式进入非线性优化,看看怎么在带噪声的观测数据里,解出最优的相机位姿和地图点坐标。