本文是「Spring Boot + AI 全栈后端」系列第 08 篇。前面几篇我们让模型能对话、能省钱、能按格式输出、能查实时数据、能读私有文档、能自己串起多步任务。这一篇解决一个更工程化的问题:工具越加越乱,每个 AI 应用都要把内部系统重新接一遍。示例基于 Spring AI 2.0 / Boot 4.1。
一个"接了三遍还是接不完"的场景
去年给一家做企业服务的客户做 AI 助手复盘,他们内部已经有三套 AI 应用:
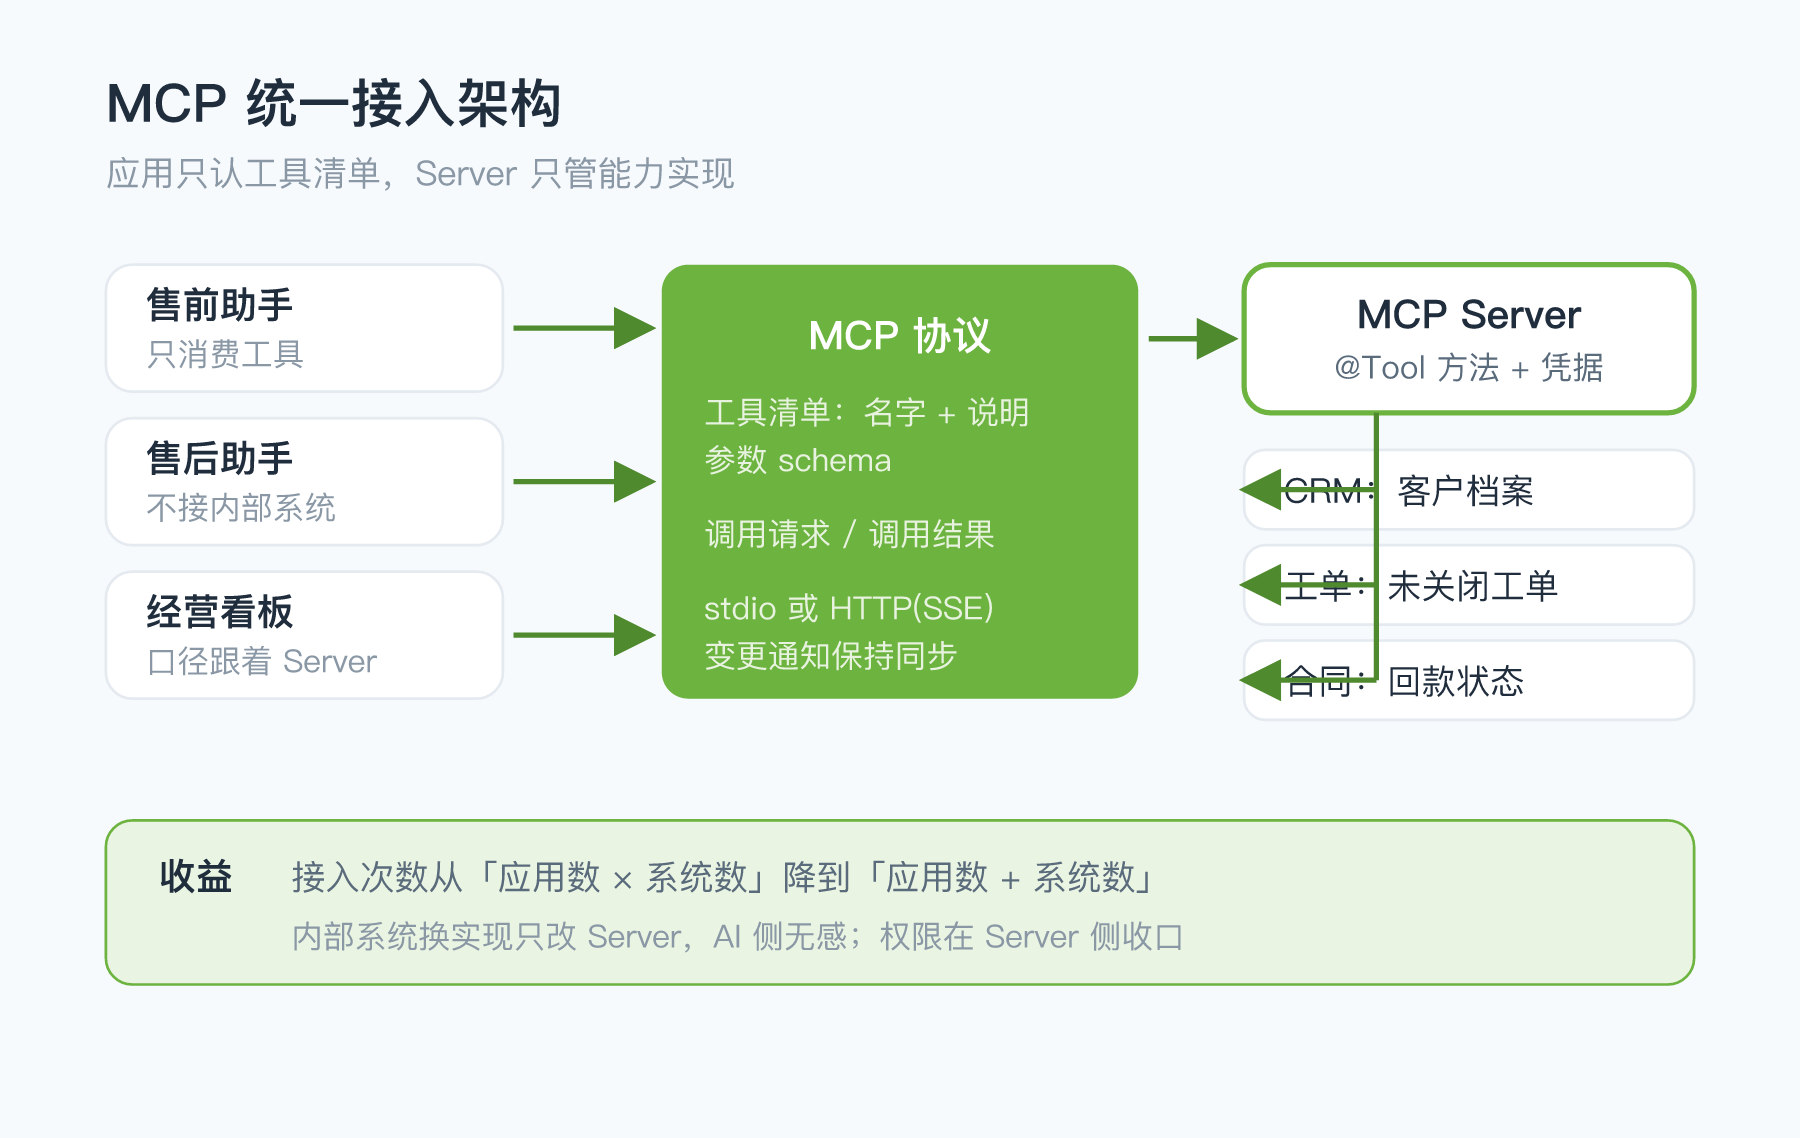
- 售前助手:要查客户档案、查合同金额;
- 售后助手:要查客户档案、查未关闭工单;
- 经营分析看板:要查合同回款、查工单积压情况。
三个应用,三个团队,三种写法。售前助手直接写了一条 MyBatis 查询,售后助手用 Feign 调了工单系统的 HTTP 接口,看板那边又让数据组重新封装了一次 SDK。结果是:同一个"查客户"动作,代码里有三份实现,口径有三个版本。销售说客户等级是 A,售后系统里显示 B,没人知道哪个是对的。
更要命的是新增能力的时候。合同系统加了一个"回款状态"字段,三个团队各改各的,改完还要各测各的。上线那天,看板显示"已结清",售前助手还说是"有欠款",客服拿着两套说法给客户打电话。
这个场景的真正痛点不是"AI 不会调接口"------第 05 篇的 Tool Calling 已经解决了这个问题。痛点是:能力的接入方式和接入次数,随着应用数量线性增长。三个应用接三个系统,理论上是九次集成;十个应用接十个系统,就是一百次。
一、Tool Calling 解决了"能不能调",没解决"接几遍"
先把话说清楚:MCP 不是 Tool Calling 的替代品,它是 Tool Calling 的组织方式。
| 维度 | 只有 Tool Calling | 引入 MCP 之后 |
|---|---|---|
| 工具定义在哪 | 写在每个应用里 | 写在 MCP Server 里,各应用只消费 |
| 新增一个系统 | 每个要用的应用都改一遍 | Server 改一次,所有客户端自动拿到 |
| 工具口径 | 各应用自己解释字段含义 | Server 统一返回格式,口径唯一 |
| 跨语言复用 | Java 写的工具,Python 应用用不了 | 协议层标准,什么语言都能连 |
| 权限边界 | 工具在应用进程里,权限跟着应用走 | Server 独立部署,权限在 Server 侧收口 |
表里最后一条是 V哥 最看重的:工具放在应用进程里,意味着每个应用都持有一份访问内部系统的凭据。把工具抽到独立的 MCP Server,凭据只在 Server 一份,AI 应用拿到的只是"能调哪些工具"的清单,这在生产环境里是实打实的安全收益。
一句话总结:Tool Calling 解决"模型怎么调你的方法",MCP 解决"这些方法放在哪、谁来维护、谁能调"。
二、MCP 到底是什么:三个角色,一张清单
别被名词吓住,MCP(Model Context Protocol)在这套体系里只有三个角色:
- MCP Server:把内部系统的能力包装成"工具",按协议对外发布。它不知道谁会来调用;
- MCP Client:AI 应用这一侧的组件,连上 Server,把工具清单拉回来;
- 传输层:stdio(本地子进程)或 HTTP(SSE / Streamable HTTP),负责两边说话。
而整个协议交换的核心数据,其实就三样东西:工具清单(名字 + 说明 + 参数 schema)、调用请求、调用结果 。这跟第 05 篇的 @Tool 方法元数据是一一对应的------Spring AI 的 MethodToolCallbackProvider 生成的正是这份清单。也就是说,你在 Spring Boot 里写 @Tool,本质上已经在生产 MCP 需要的数据了,只差"用哪个传输方式发布出去"。
这个认知很重要:先把工具层独立出来,发布方式可以后定 。你不加任何 MCP 依赖,这份清单也能在进程内直接喂给 ChatClient;加了 spring-ai-starter-mcp-server-webmvc,同一份代码就具备了对外发布的能力。
三、第一步:把内部系统能力写成工具
真实项目里,建议按"系统"拆类,一个系统一个 @Service,工具方法统一加系统名前缀。下面是三个内部系统的最小实现(CRM、工单、合同)。
CRM:客户档案与续约风险
java
@Service
public class CrmTools {

    private final Map<String, Customer> customers = Map.of(
            "C-1001", new Customer("C-1001", "星海科技", "智能制造", "A", LocalDate.of(2026, 11, 30), "张涛"),
            "C-1002", new Customer("C-1002", "云澜数据", "互联网", "B", LocalDate.of(2026, 10, 15), "李敏"),
            "C-1003", new Customer("C-1003", "恒通物流", "交通运输", "A", LocalDate.of(2027, 3, 1), "王强"));

    @Tool(description = "按公司名关键词查客户档案,返回客户ID、行业、等级、合同到期日和客户经理")
    public String crm_findCustomer(
            @ToolParam(description = "公司名关键词,支持模糊匹配,如「星海」") String keyword) {
        return customers.values().stream()
                .filter(c -> c.company().contains(keyword))
                .findFirst()
                .map(c -> "客户ID=" + c.id()
                        + "; 公司=" + c.company()
                        + "; 行业=" + c.industry()
                        + "; 等级=" + c.level()
                        + "; 合同到期=" + c.contractEnd()
                        + "; 客户经理=" + c.owner())
                .orElse("NOT_FOUND:CRM 里没有匹配「" + keyword + "」的客户");
    }

    @Tool(description = "按客户ID评估续约风险,返回距合同到期天数与风险等级")
    public String crm_renewalRisk(
            @ToolParam(description = "客户ID,形如 C-1001") String customerId) {
        Customer c = customers.get(customerId);
        if (c == null) {
            return "NOT_FOUND:客户 " + customerId + " 不存在";
        }
        long days = ChronoUnit.DAYS.between(LocalDate.of(2026, 9, 29), c.contractEnd());
        String level = days < 30 ? "高" : (days < 90 ? "中" : "低");
        return "客户=" + c.company()
                + "; 距到期=" + days + "天"
                + "; 风险等级=" + level
                + "; 建议=" + (days < 30 ? "本月内启动续约谈判" : (days < 90 ? "提前排入回访计划" : "常规跟进即可"));
    }

    public record Customer(String id, String company, String industry, String level,
                           LocalDate contractEnd, String owner) {
    }
}
工单系统:查未关闭工单
java
@Service
public class TicketTools {

    private final Map<String, List<Ticket>> tickets = Map.of(
            "C-1001", List.of(
                    new Ticket("T-9001", "P1", "真空泵异响,现场停机", "售后组-陈工"),
                    new Ticket("T-9002", "P3", "操作手册补充英文版", "文档组-刘工")),
            "C-1002", List.of(
                    new Ticket("T-9011", "P2", "API 调用偶发超时", "研发组-赵工")));

    @Tool(description = "按客户ID查未关闭工单,返回工单号、优先级、标题和当前处理人")
    public String ticket_openTickets(
            @ToolParam(description = "客户ID,形如 C-1001") String customerId) {
        List<Ticket> list = tickets.get(customerId);
        if (list == null || list.isEmpty()) {
            return "NOT_FOUND:客户 " + customerId + " 当前没有未关闭工单";
        }
        StringBuilder sb = new StringBuilder("共 " + list.size() + " 条未关闭工单:");
        for (Ticket t : list) {
            sb.append("\n- [").append(t.priority()).append("] ").append(t.no())
                    .append(" ").append(t.title()).append("(处理人:").append(t.owner()).append(")");
        }
        return sb.toString();
    }

    public record Ticket(String no, String priority, String title, String owner) {
    }
}
合同系统:回款状态
java
@Service
public class ContractTools {

    private final Map<String, Contract> contracts = Map.of(
            "C-1001", new Contract("星海科技", 1200000, 720000, "2026-08-20"),
            "C-1002", new Contract("云澜数据", 480000, 480000, "2026-07-05"));

    @Tool(description = "按客户ID查合同与回款情况,返回合同金额、已回款、待回款和最近一笔回款日期")
    public String contract_paymentStatus(
            @ToolParam(description = "客户ID,形如 C-1001") String customerId) {
        Contract c = contracts.get(customerId);
        if (c == null) {
            return "NOT_FOUND:客户 " + customerId + " 没有生效中的合同";
        }
        long unpaid = c.amount() - c.paid();
        return "公司=" + c.company()
                + "; 合同金额=" + c.amount() + "元"
                + "; 已回款=" + c.paid() + "元"
                + "; 待回款=" + unpaid + "元"
                + "; 最近回款日期=" + c.lastPaidDate()
                + "; 状态=" + (unpaid == 0 ? "已结清" : "有欠款");
    }

    public record Contract(String company, long amount, long paid, String lastPaidDate) {
    }
}三个类、四个工具。真实项目里,Map.of(...) 这一段会换成 JDBC、Feign 或者 ES 查询,工具方法的签名和说明不用动------这就是分层带来的好处:内部系统换实现,AI 侧无感。
四、命名先定规矩:系统名前缀不是洁癖,是刚需
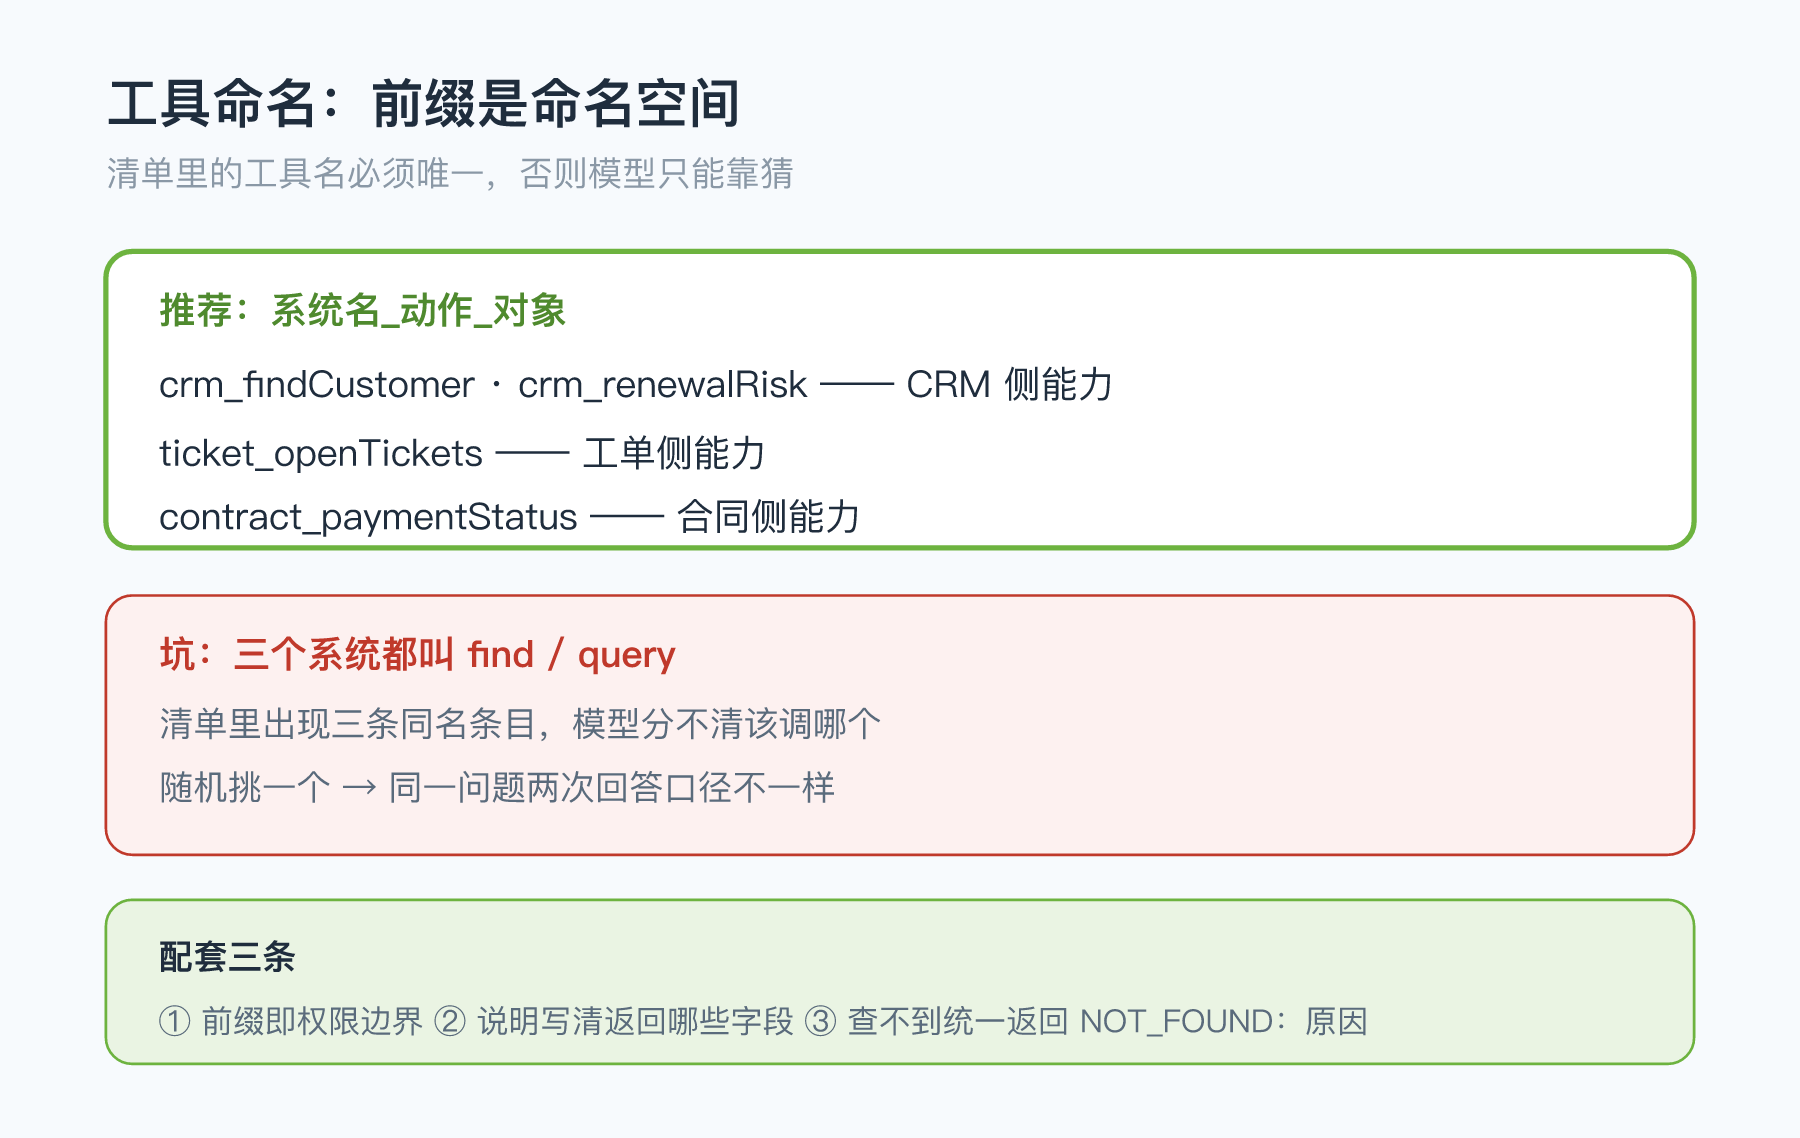
上面四个工具分别叫 crm_findCustomer、crm_renewalRisk、ticket_openTickets、contract_paymentStatus。加前缀看着啰嗦,实际是踩过坑的结论:
工具名在整份清单里必须唯一 。CRM 想叫 query、工单想叫 query、合同也想叫 query,三份清单合并后,模型拿到三个同名条目,它没法判断该调哪个。更隐蔽的情况是:两个系统的方法名不同但语义相同(如 find 和 search),模型会随机挑一个,返回口径就飘了。
命名约定是「系统名_动作_对象 」,比如 crm_find_customer、ticket_list_open。配套三条:
- 前缀即权限边界 :
crm_开头的一律走 CRM 的只读账号,contract_开头的才碰金额字段; - 说明写给人看 :
@Tool(description)里那句中文,是模型判断"该不该调"的唯一依据,别写"查询数据"这种废话,写清楚"返回什么字段"; - 查不到统一返回
NOT_FOUND:原因:这是第 05 篇就立的规矩,模型看到这个前缀就知道要如实说没查到,而不是硬编一个答案。
五、第二步:注册成一份工具清单
三个工具类写好了,需要一个地方把它们收成一份清单:
java
@Configuration(proxyBeanMethods = false)
public class InternalToolsConfig {

    @Bean
    ToolCallbackProvider internalToolCallbacks(CrmTools crm, TicketTools ticket, ContractTools contract) {
        return MethodToolCallbackProvider.builder()
                .toolObjects(crm, ticket, contract)
                .build();
    }
}
MethodToolCallbackProvider 会扫描这三个对象上所有带 @Tool 的方法,生成 ToolCallback 列表,每个回调里都带着工具名、中文说明和参数 schema。这一步不依赖任何 MCP 组件 ,也就是说,此时你已经可以把它直接喂给 ChatClient 用了。
想发布成真正的 MCP Server,只需要加一个依赖:
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-mcp-server-webmvc</artifactId>
</dependency>
版本由 spring-ai-bom 统一管理(本文示例为 2.0.1)。然后在配置文件里声明这个 Server 的身份和协议:
yaml
spring:
  ai:
    mcp:
      server:
        enabled: true
        name: internal-systems
        version: 1.0.0
        type: SYNC
        protocol: STREAMABLE
        instructions: 提供 CRM、工单、合同三个内部系统的只读查询能力
        streamable-http:
          mcp-endpoint: /mcp
几个配置项说明一下,都是 Spring AI 2.0 里的实际字段:
type: SYNC | ASYNC:同步还是异步,业务系统查询一般用SYNC,逻辑简单、好排查;protocol: STREAMABLE | SSE | STATELESS:STREAMABLE是当前的推荐选项,兼顾流式与无状态部署;instructions:给对端模型看的一段"这个 Server 是干什么的",会随工具清单一起发过去;streamable-http.mcp-endpoint:对外暴露的 HTTP 路径,网关和鉴权都挂在这个路径上。
Server 起在这一侧,工具清单就发布出去了。至于谁连它、拿去干什么,Server 完全不关心。
六、第三步:客户端接入,业务代码一行不用改
AI 应用这一侧加客户端依赖:
xml
<dependency>
    <groupId>org.springframework.ai</groupId>
    <artifactId>spring-ai-starter-mcp-client</artifactId>
</dependency>
然后告诉它去哪儿连。本地子进程用 stdio:
yaml
spring:
  ai:
    mcp:
      client:
        enabled: true
        type: SYNC
        toolcallback:
          enabled: true
        stdio:
          connections:
            internal:
              command: java
              args:
                - -jar
                - /opt/mcp/internal-systems.jar
远程 Server 用 SSE:
yaml
spring:
  ai:
    mcp:
      client:
        enabled: true
        type: SYNC
        toolcallback:
          enabled: true
        sse:
          connections:
            internal:
              url: http://internal-systems.internal:8080
toolcallback.enabled: true 会开启自动把 MCP 工具注册成 Spring AI 的 ToolCallbackProvider。客户端启动时会连上 Server、拉回工具清单,之后业务代码里注入的 ToolCallbackProvider,跟你本地 MethodToolCallbackProvider 生成的那个是同一个接口。
这就是 MCP 落地最舒服的地方------业务侧代码完全不用知道工具是本地的还是远程的:
java
@Service
public class InternalAssistantService {

    private static final String SYSTEM_PROMPT = """
            你是企业内部运营助手,可以调用 CRM、工单、合同三个系统的工具回答问题。
            规矩:
            1. 需要实时数据时必须先调工具,凭记忆回答一律判错;
            2. 工具返回 NOT_FOUND 就如实说没查到,不许编;
            3. 回答里带上关键数据(金额、日期、工单号),一句话说清结论。
            """;

    private final ChatClient chatClient;
    private final List<ToolCallback> callbacks;

    public InternalAssistantService(ChatModel chatModel, ToolCallbackProvider tools) {
        this.callbacks = List.of(tools.getToolCallbacks());
        this.chatClient = ChatClient.builder(chatModel).build();
    }

    public String ask(String question) {
        return chatClient.prompt()
                .system(SYSTEM_PROMPT)
                .toolCallbacks(callbacks)
                .user(question)
                .call()
                .content();
    }

    /** 对外暴露当前接了哪些系统,方便运维一眼看清楚 AI 的「手」伸到了哪里。 */
    public List<String> availableTools() {
        return callbacks.stream()
                .map(c -> c.getToolDefinition().name())
                .sorted()
                .toList();
    }
}
注意 availableTools() 这个方法。V哥 在每个项目里都会留这么一个口子:AI 到底能碰哪些系统,必须可查、可审计。工具清单一旦变成动态的(从 MCP Server 拉回来),没有人能靠读代码搞清楚它当前的边界,那就必须让运行时告诉你。
七、第四步:对外接口
java
@RestController
@RequestMapping("/api/internal")
public class InternalAskController {

    private final InternalAssistantService service;

    public InternalAskController(InternalAssistantService service) {
        this.service = service;
    }

    @PostMapping("/ask")
    public InternalAnswer ask(@Valid @RequestBody InternalAskRequest request) {
        return new InternalAnswer(request.question(), service.ask(request.question()));
    }

    @GetMapping("/tools")
    public List<String> tools() {
        return service.availableTools();
    }

    public record InternalAnswer(String question, String answer) {
    }
}
入参校验和异常兜底沿用第 02 篇的写法,空问题直接 400:
java
public record InternalAskRequest(
        @NotBlank(message = "问题不能为空") String question) {
}
八、离线环境怎么验证这套链路
MCP 的真实链路要起 Server、连传输层,在没有服务端和密钥的环境里,V哥 的做法是把"模型那颗脑子"换成桩,其余全用框架真跑------工具注册、参数解析、方法执行、结果回传都是真的,只有"判断该调哪个工具"这一步是脚本化的。
桩的核心逻辑长这样:
java
public class McpStubChatModel implements ChatModel {

    private final List<ToolCallback> callbacks;
    public final List<String> invoked = new ArrayList<>();

    public McpStubChatModel(ToolCallbackProvider provider) {
        this.callbacks = List.of(provider.getToolCallbacks());
    }

    @Override
    public ChatResponse call(Prompt prompt) {
        List<ToolResponseMessage> results = prompt.getInstructions().stream()
                .filter(m -> m instanceof ToolResponseMessage)
                .map(m -> (ToolResponseMessage) m)
                .toList();
        if (!results.isEmpty()) {
            return text(compose(results.get(0).getResponses().get(0).responseData()));
        }

        String[] plan = plan(userTextOf(prompt));
        String data = callbacks.stream()
                .filter(c -> plan[0].equals(c.getToolDefinition().name()))
                .findFirst()
                .map(c -> {
                    invoked.add(plan[0]);
                    return c.call(plan[1]);
                })
                .orElse("NOT_FOUND:工具清单里没有 " + plan[0]);

        return text(compose(data));
    }

    /** 模拟模型决策:返回 {工具名, 参数 JSON}。 */
    private static String[] plan(String question) {
        Matcher matcher = Pattern.compile("C-\\d{4}").matcher(question);
        String customerId = matcher.find() ? matcher.group() : "C-1001";
        String args = "{\"customerId\":\"" + customerId + "\"}";
        if (question.contains("工单")) {
            return new String[]{"ticket_openTickets", args};
        }
        if (question.contains("回款") || question.contains("欠款") || question.contains("合同")) {
            return new String[]{"contract_paymentStatus", args};
        }
        if (question.contains("续约") || question.contains("风险") || question.contains("到期")) {
            return new String[]{"crm_renewalRisk", args};
        }
        return new String[]{"crm_findCustomer", "{\"keyword\":\"" + keywordOf(question) + "\"}"};
    }
}
有了这个桩,可以离线验证的关键断言就成立了:清单里四个工具且系统前缀齐全、工具名没有重复、中文说明进了 schema、查不到返回 NOT_FOUND、问工单走 ticket_openTickets、问回款答出"待回款=480000元"、/api/internal/tools 返回四个、空问题返回 400。这些断言覆盖的是接入结构,不是模型的聪明程度------前者才是工程侧要保证的东西。
九、上线前要盯的五件事
| # | 事项 | 具体做法 |
|---|---|---|
| 1 | 工具粒度 | 一个工具只做一件事,别做 crm_queryAll。工具越多越杂,模型选错的代价越大 |
| 2 | 只读优先 | 初期只发布只读工具;写操作(改客户等级、开工单)单独放一个需要审批的 Server |
| 3 | 超时与重试 | spring.ai.mcp.client.request-timeout 要小于网关超时,重试放在客户端而不是 Server |
| 4 | 凭据收口 | 访问内部系统的账号只配在 Server 侧,客户端不持有任何内部系统凭据 |
| 5 | 清单可观测 | 把 availableTools() 接到健康检查或运维面板,工具增减要能被第一时间发现 |
第 2 条 V哥 单独强调一下:AI 一旦具备写能力,出问题时就不是"回答错了",而是"数据被改错了"。让 AI 只读地跑顺半年,再考虑开放写操作,这个节奏省下的返工时间远超你的预期。
十、几个躲不开的坑
| 现象 | 原因 | 处理 |
|---|---|---|
| 启动报工具名冲突 | 两个系统的方法同名 | 强制加系统名前缀,启动时断言清单无重名 |
| 模型乱调工具 | description 写得太笼统 |
说明里写清"返回哪些字段",并在系统提示词里限定可用范围 |
| 工具改了客户端没生效 | Server 端工具变更没通知 | 开启变更通知,或干脆滚动重启客户端 |
| 客户端启动很慢 | stdio 子进程冷启动 | 远程部署用 SSE,避免每个客户端都拉起一个 JVM |
| 返回数据超大 | 工具直接吐了整表 | 工具内部先做聚合和截断,只给模型摘要字段 |
最后一句 :MCP 的价值不在"又学了一个新协议",而在于它逼你把散落在各个 AI 应用里的集成代码收拢成一份可独立维护、可独立鉴权、可跨语言复用的工具清单------先按系统拆好 @Tool、定死命名前缀和 NOT_FOUND 约定,接不接 MCP 你都已经赢了一半;真正让它上线的,是第 4 条凭据收口和第 2 条只读优先这两条纪律。下一篇(09)解决另一个体验问题:点下去要等好几秒才出结果,用流式输出把等待变成打字机。