一、估计问题的一般形式
估计理论处理的问题是:手上有一串观测,要从里面读出一个未知参数。观测记作 x0,x1,...,xN−1x0, x1, \ldots, xN-1x0,x1,...,xN−1,它们与待估参数 θ\thetaθ 的联系由一族由 θ\thetaθ 参数化的概率密度 p(x;θ)p(x;\theta)p(x;θ) 描述。
这一阶段 θ\thetaθ 不是随机变量。p(x;θ)p(x;\theta)p(x;θ) 读作「如果未知参数取值 θ\thetaθ,这串观测就服从密度 p(x;θ)p(x;\theta)p(x;θ)」。它与条件密度 p(x∣θ)p(x\vert\theta)p(x∣θ) 在表达式上完全一样,区别只在 θ\thetaθ 怎么解释:θ\thetaθ 是某个随机过程的实现时写 p(x∣θ)p(x\vert\theta)p(x∣θ),是确定性常数时写 p(x;θ)p(x;\theta)p(x;θ)。前半本书一直按后者处理,到第十章把 θ\thetaθ 换成随机变量,才进入贝叶斯估计。
估计量是一段只依赖观测的确定性映射:
θ^=g(x0,x1,...,xN−1)(1-1)\hat{\theta}=g\left(x0,x1,\ldots,xN-1\right)\tag{1-1}θ^=g(x0,x1,...,xN−1)(1-1)
把 NNN 个样本摞成列向量,上式可以写得更紧凑:
θ^=g(x),x=x\[0,x1,...,xN−1]T(1-2)\hat{\theta}=g(\mathbf{x}),\qquad \mathbf{x}=\leftx\[0,x1,\ldots,xN-1\right]^{T}\tag{1-2}θ^=g(x),x=x\[0,x1,...,xN−1]T(1-2)
估计量的定义里只有一条约束:ggg 的自变量是观测,不能是待估参数。这条约束看上去平淡,却是第二节那个不可实现例子的全部由来。
观测是随机的,所以估计量也是随机变量。这一点决定了后面全部的讨论方式:可以谈它的期望,也可以谈它的方差。观测本身的依赖结构由模型给定,可能独立也可能相关,后面的 1.4 与 2.1 两道题恰好分别落在互不相关与独立这两种情形上。
五道题给的观测模型可以归成同一类:参数经过某个物理过程,输出一个确定值,再叠加上一份随机扰动。写出来都是
xn=f(θ)+wn,n=0,1,...,N−1(1-3)xn=f(\theta)+wn,\quad n=0,1,\ldots,N-1\tag{1-3}xn=f(θ)+wn,n=0,1,...,N−1(1-3)
区别只在 fff 是什么、对 www 做了什么假设。
| 题号 | 观测模型 | 待估参数 | 对噪声的假设 |
|---|---|---|---|
| 1.1 | 雷达回波时延 τ0\tau_0τ0 | 距离 R=cτ0/2R=c\tau_0/2R=cτ0/2 | 估计量 τ^0\hat\tau_0τ^0 服从正态分布 |
| 1.4 | xn=A+wnxn=A+wnxn=A+wn | 直流电平 AAA | 零均值、互不相关、方差 σ2=1\sigma^2=1σ2=1 |
| 2.1 | xn∼N(0,σ2)xn\sim N(0,\sigma^2)xn∼N(0,σ2) | 方差 σ2\sigma^2σ2 | 高斯、独立同分布 |
| 2.2 | xn∼U0,θxn\sim U0,\\thetaxn∼U0,θ | 参数 θ\thetaθ | 均匀、独立同分布 |
| 2.5 | x0,x1∼N(0,σ2)x0,x1\sim N(0,\sigma^2)x0,x1∼N(0,σ2) | 方差 σ2\sigma^2σ2 | 高斯、两个样本独立 |
可见模型一确定,待估量是什么、噪声能用什么工具,就都定下来了。1.1 与 1.4 的模型是线性的,2.2 的模型在参数上却是截断的,这个差别后面会直接决定估计量的形态。
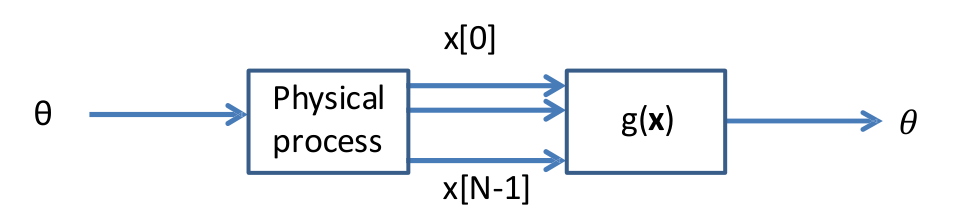
图 1:估计问题的数学表述
图源:课程讲义第 1 讲,第 11 页。
二、无偏性、方差与均方误差
衡量一个估计量,最顺手的判据是均方误差:
mse(θ^)=E(θ\^−θ)2(2-1)\mathrm{mse}(\hat{\theta})=E\left\\left(\\hat{\\theta}-\\theta\\right)\^{2}\\right\tag{2-1}mse(θ^)=E(θ\^−θ)2(2-1)
把括号里的量拆成围绕自身均值的抖动与系统性偏离两部分,交叉项的期望为零,于是
mse(θ^)=E((θ\^−E(θ\^))+(E(θ\^)−θ))2(2-2)\mathrm{mse}(\hat{\theta})=E\left\\left(\\left(\\hat{\\theta}-E(\\hat{\\theta})\\right)+\\left(E(\\hat{\\theta})-\\theta\\right)\\right)\^{2}\\right\tag{2-2}mse(θ^)=E((θ\^−E(θ\^))+(E(θ\^)−θ))2(2-2)
mse(θ^)=var(θ^)+b2(θ)(2-3)\mathrm{mse}(\hat{\theta})=\mathrm{var}(\hat{\theta})+b^{2}(\theta)\tag{2-3}mse(θ^)=var(θ^)+b2(θ)(2-3)
其中
b(θ)=E(θ^)−θ(2-4)b(\theta)=E(\hat{\theta})-\theta\tag{2-4}b(θ)=E(θ^)−θ(2-4)
称作偏差。均方误差于是分成两块,一块是估计量的抖动,一块是它系统性地偏离真值。图 2 是这一步展开的原文。
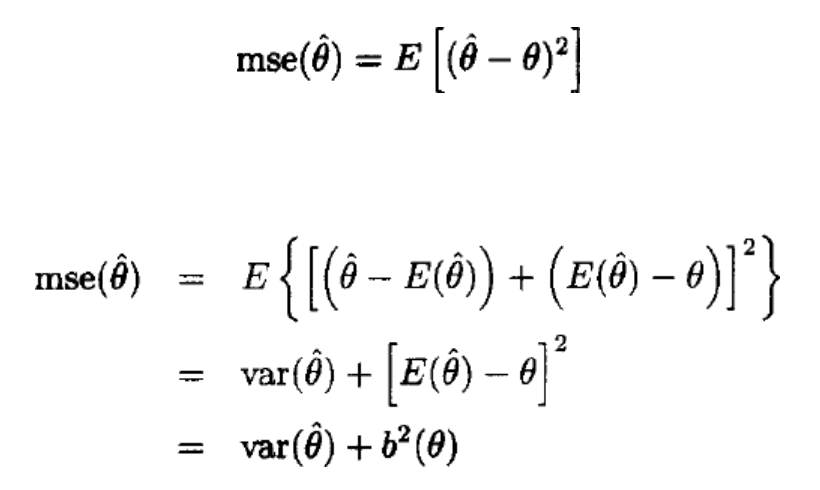
图 2:均方误差的偏差与方差分解
图源:课程讲义第 1 讲,第 20 页。
如果对所有 θ\thetaθ 都有
E(θ^)=θ,∀θ(2-5)E(\hat{\theta})=\theta,\qquad \forall\theta\tag{2-5}E(θ^)=θ,∀θ(2-5)
就称 θ^\hat{\theta}θ^ 是无偏估计量。注意这个要求比看上去重:它不是「在某个 θ\thetaθ 上碰巧对」,而是对整条参数轴同时成立。
只盯着方差也不行。取 g(x)=0g(\mathbf{x})=0g(x)=0,方差恒为零,比任何估计量都小,但它对每个 θ\thetaθ 都有 b(θ)=−θb(\theta)=-\thetab(θ)=−θ,显然不是无偏估计量。方差小与无偏必须同时要求。
无偏也不等于好用。无偏只约束均值,不约束集中程度,一个估计量可以完全无偏却因方差过大而毫无用处。再补上「方差随样本数趋于零」这一条,才得到一致估计量,后面 2.1 题算的就是这个。无偏与一致互不包含:无偏不保证一致,一致也不保证对每个 θ\thetaθ 都无偏。
无偏更不是自动成立的属性。把直流电平 xn=A+wnxn=A+wnxn=A+wn 的样本均值再乘一个系数 aaa,得到
A~=a1N∑n=0N−1xn(2-6)\tilde{A}=a\dfrac{1}{N}\sum_{n=0}^{N-1}xn\tag{2-6}A~=aN1n=0∑N−1xn(2-6)
它的偏差是 (a−1)A(a-1)A(a−1)A,均方误差是
mse(A~)=a2σ2N+(a−1)2A2(2-7)\mathrm{mse}(\tilde{A})=\dfrac{a^{2}\sigma^{2}}{N}+(a-1)^{2}A^{2}\tag{2-7}mse(A~)=Na2σ2+(a−1)2A2(2-7)
对 aaa 求导置零,得到使均方误差最小的那个系数
aopt=A2A2+σ2/N(2-8)a_{\mathrm{opt}}=\dfrac{A^{2}}{A^{2}+\sigma^{2}/N}\tag{2-8}aopt=A2+σ2/NA2(2-8)
aopta_{\mathrm{opt}}aopt 里带着 AAA。要算出它就得先知道 AAA,而 AAA 正是待估的量,这个估计量因此不可实现。图 3 是这个例子的完整一步。
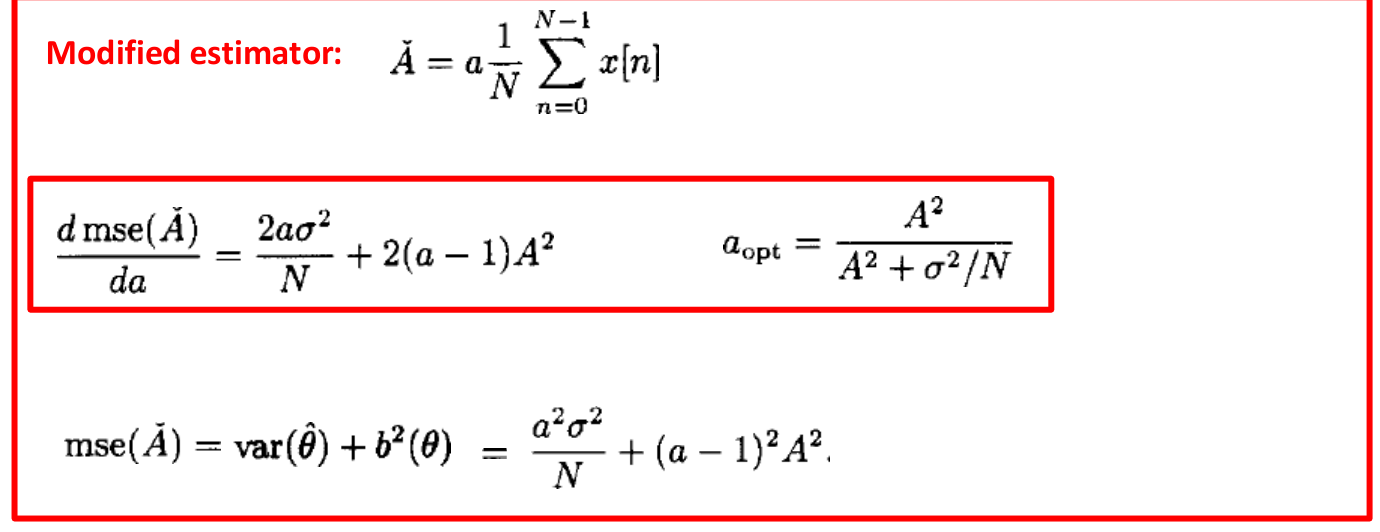
图 3:修正估计量的均方误差及其最优系数
图源:课程讲义第 1 讲,第 25 页。
把准则限制在无偏估计量里,这类麻烦就没有了。由式(2-5),偏差项为零,均方误差退化成方差,剩下的问题是:在所有无偏估计量中挑方差最小的那一个。
三、最小方差无偏估计
如果某个无偏估计量 θ^\hat{\theta}θ^ 满足
var(θ^)≤var(θ~),∀θ(3-1)\mathrm{var}(\hat{\theta})\le\mathrm{var}(\tilde{\theta}),\qquad \forall\theta\tag{3-1}var(θ^)≤var(θ~),∀θ(3-1)
其中 θ~\tilde{\theta}θ~ 是任意另一个无偏估计量,就称 θ^\hat{\theta}θ^ 是最小方差无偏估计量(minimum variance unbiased,MVU)。「对所有 θ\thetaθ 都最小」这几个字是必须的:方差本身可以随 θ\thetaθ 变,只在某一个 θ\thetaθ 上占优不作数。
图 4 的两个面板说的就是这件事。左边三条方差曲线互不交叉,最下面那条在整个 θ\thetaθ 范围内都最小,它就是 MVU 估计量。右边的 θ^2\hat{\theta}_2θ^2 与 θ^3\hat{\theta}_3θ^3 在 θ0\theta_0θ0 两侧各占优一段,谁都不是 MVU,最优估计量随 θ\thetaθ 改变,在无偏类里也不存在全局最优解。
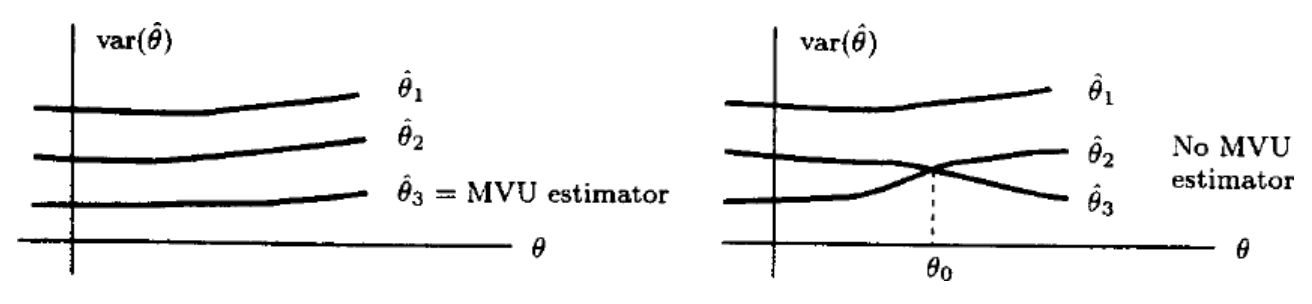
图 4:MVU 估计量与不存在 MVU 的情形
图源:课程讲义第 1 讲,第 32 页。
MVU 这个定义只要求存在某个估计量在无偏类里占优,并不给出构造方法。无偏类是无穷的,要在整类里逐个比较方差,实际做题时几乎做不到。常用的做法反过来:先构造出一族无偏估计量,再比较它们的方差,取方差最小的那个;如果这一族里正好有一个对所有 θ\thetaθ 都最小,它就是 MVU。第五节与第七节两道题都是这个套路。
还有一层意思需要点明:MVU 是「在无偏类里」的最优,不等于「所有估计量里」的最优。一个方差稍大但带有很小偏差的估计量,均方误差可能反而更低。无偏这条约束换来的好处是把比较准则从均方误差简化成方差,代价是放弃了有偏估计量里可能存在的改进。
两点提醒。MVU 只在部分问题里存在,有时甚至连无偏估计量都不存在。另外,无偏这个限制消掉的是偏差对 θ\thetaθ 的依赖,方差对 θ\thetaθ 的依赖还在。第八节的 2.5 题就是一个例子:σ^2\hat{\sigma}^2σ^2 是无偏的,它的方差 2σ4/N2\sigma^4/N2σ4/N 却仍然随 σ2\sigma^2σ2 变。
四、习题 1.1:雷达双程时延与距离估计
题目给的是:雷达系统中双程时延的估计量 τ^0\hat\tau_0τ^0 服从正态分布,均值是真值 τ0\tau_0τ0,方差是 στ^02\sigma_{\hat\tau_0}^2στ^02。要据此估计距离,提出估计量 R^\hat{R}R^ 并求出它的概率密度;再确定标准偏差 στ^0\sigma_{\hat\tau_0}στ^0,使距离估计值有 99% 的概率落在真值 100 m100\ \mathrm{m}100 m 以内,电磁传播速度取 c=3×10⁸ m/sc=3\times10^{8}\ \mathrm{m/s}c=3×108 m/s。
这道题的考点是估计量的变换。上游给的是时延的统计特性,下游要的是距离的统计特性,两者由一个确定性关系连起来,所以不必重新推导一遍,只需把已知的分布按这个关系搬过去。
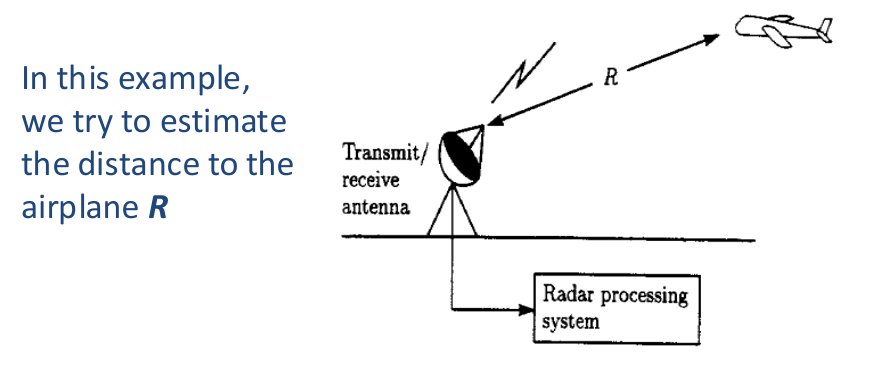
图 5:雷达距离估计示意
图源:课程讲义第 1 讲,第 5 页。
距离与时延的关系是双程的。脉冲往返各走一趟,总路程 2R2R2R,除以速度 ccc 得到时延:
R=c2τ0(4-1)R=\dfrac{c}{2}\tau_{0}\tag{4-1}R=2cτ0(4-1)
估计量取同一形式:
R^=c2τ^0(4-2)\hat{R}=\dfrac{c}{2}\hat{\tau}_{0}\tag{4-2}R^=2cτ^0(4-2)
这里用到一条性质:若 X∼N(μ,σ2)X\sim N(\mu,\sigma^2)X∼N(μ,σ2),则 aX+b∼N(aμ+b,a2σ2)aX+b\sim N(a\mu+b,a^2\sigma^2)aX+b∼N(aμ+b,a2σ2),其中 aaa 是常数。取 a=c/2a=c/2a=c/2、b=0b=0b=0 即可,尺度因子为正时分布形状不变,方差按 a2a^2a2 缩放。线性变换因此不改变正态性,R^\hat{R}R^ 仍然服从正态分布,均值与方差分别是
E(R^)=c2E(τ^0)=c2τ0=R0(4-3)E(\hat{R})=\dfrac{c}{2}E(\hat{\tau}{0})=\dfrac{c}{2}\tau{0}=R_{0}\tag{4-3}E(R^)=2cE(τ^0)=2cτ0=R0(4-3)
var(R^)=(c2)2var(τ^0)=(c2στ^0)2(4-4)\mathrm{var}(\hat{R})=\left(\dfrac{c}{2}\right)^{2}\mathrm{var}(\hat{\tau}{0})=\left(\dfrac{c}{2}\sigma{\hat{\tau}_0}\right)^{2}\tag{4-4}var(R^)=(2c)2var(τ^0)=(2cστ^0)2(4-4)
R^∼N(R0,(c2στ^0)2)(4-5)\hat{R}\sim N\left(R_{0},\left(\dfrac{c}{2}\sigma_{\hat{\tau}_0}\right)^{2}\right)\tag{4-5}R^∼N(R0,(2cστ^0)2)(4-5)
把距离的标准差单独记一个符号,后面的密度与分位数都写它:
σR≡c2στ^0(4-6)\sigma_{R}\equiv\dfrac{c}{2}\sigma_{\hat{\tau}_0}\tag{4-6}σR≡2cστ^0(4-6)
于是概率密度写成
fR^(r)=12πσRexp(−(r−R0)22σR2)(4-7)f_{\hat{R}}(r)=\dfrac{1}{\sqrt{2\pi} \sigma_{R}}\exp\left(-\dfrac{\left(r-R_{0}\right)^{2}}{2\sigma_{R}^{2}}\right)\tag{4-7}fR^(r)=2π σR1exp(−2σR2(r−R0)2)(4-7)
其中 R0=cτ0/2R_0=c\tau_0/2R0=cτ0/2。
第二问把「99% 的概率落在 100 m100\ \mathrm{m}100 m 以内」写成一条概率约束:
P(∣R^−R0∣≤100)=0.99(4-8)P\left(\left|\hat{R}-R_{0}\right|\le100\right)=0.99\tag{4-8}P( R^−R0 ≤100)=0.99(4-8)
令 Z=(R^−R0)/σRZ=(\hat{R}-R_0)/\sigma_RZ=(R^−R0)/σR,ZZZ 服从标准正态分布,于是
P(∣Z∣≤100σR)=0.99(4-9)P\left(\left|Z\right|\le\dfrac{100}{\sigma_{R}}\right)=0.99\tag{4-9}P(∣Z∣≤σR100)=0.99(4-9)
标准正态分布的双侧 99% 分位点是 z0.995=2.5758z_{0.995}=2.5758z0.995=2.5758,所以
100σR=2.5758⟹σR=1002.5758≈38.82 m(4-10)\dfrac{100}{\sigma_{R}}=2.5758\quad\Longrightarrow\quad\sigma_{R}=\dfrac{100}{2.5758}\approx38.82\ \mathrm{m}\tag{4-10}σR100=2.5758⟹σR=2.5758100≈38.82 m(4-10)
距离的标准差定下来之后,时延的标准差由式(4-4)反解:
στ^0=2σRc=2×38.823×108≈2.588×10⁻⁷ s(4-11)\sigma_{\hat{\tau}0}=\dfrac{2\sigma{R}}{c}=\dfrac{2\times38.82}{3\times10^{8}}\approx2.588\times10^{-7}\ \mathrm{s}\tag{4-11}στ^0=c2σR=3×1082×38.82≈2.588×10⁻⁷ s(4-11)
数量级上可以核一遍。100 m100\ \mathrm{m}100 m 的测距误差对应 200 m200\ \mathrm{m}200 m 的单程行程,也就是 0.667 μs0.667\ \mathrm{\mu s}0.667 μs 的双程时延;这个时延是 99% 置信区间的半宽,等于 2.5758στ^02.5758\sigma_{\hat{\tau}0}2.5758στ^0,反推出来的 στ^0\sigma{\hat{\tau}_0}στ^0 落在 0.259 μs0.259\ \mathrm{\mu s}0.259 μs,与式(4-11)一致。
五、习题 1.4:两个直流电平估计量的比较
题目给的是 xn=A+wnxn=A+wnxn=A+wn,n=0,1,...,N−1n=0,1,\ldots,N-1n=0,1,...,N−1,wnwnwn 零均值且互不相关,每个样本的方差 σ2=1\sigma^2=1σ2=1。考察两个估计量
A^=1N∑n=0N−1xn(5-1)\hat{A}=\dfrac{1}{N}\sum_{n=0}^{N-1}xn\tag{5-1}A^=N1n=0∑N−1xn(5-1)
A~=1N+2(2x0+∑n=1N−2xn+2xN−1)(5-2)\tilde{A}=\dfrac{1}{N+2}\left(2x0+\sum_{n=1}^{N-2}xn+2xN-1\right)\tag{5-2}A~=N+21(2x0+n=1∑N−2xn+2xN−1)(5-2)
问哪一个更好,以及这个判断与 AAA 的取值有没有关系。
先算偏差。样本均值直接给出 E(A^)=AE(\hat{A})=AE(A^)=A。第二个估计量的系数之和是 2+(N−2)+2=N+22+(N-2)+2=N+22+(N−2)+2=N+2,与分母正好抵消:
E(A~)=1N+2(2A+(N−2)A+2A)=A(5-3)E(\tilde{A})=\dfrac{1}{N+2}\left(2A+(N-2)A+2A\right)=A\tag{5-3}E(A~)=N+21(2A+(N−2)A+2A)=A(5-3)
两个估计量的偏差都是零,而且都不含 AAA。
再算方差。样本互不相关,var(xn)=σ2=1\mathrm{var}(xn)=\sigma^2=1var(xn)=σ2=1,线性组合的方差就是系数平方和:
var(∑nanxn)=∑nan2var(xn)(5-4)\mathrm{var}\left(\sum_{n}a_{n}xn\right)=\sum_{n}a_{n}^{2}\mathrm{var}\left(xn\right)\tag{5-4}var(n∑anxn)=n∑an2var(xn)(5-4)
var(A^)=1N2⋅N⋅1=1N(5-5)\mathrm{var}(\hat{A})=\dfrac{1}{N^{2}}\cdot N\cdot 1=\dfrac{1}{N}\tag{5-5}var(A^)=N21⋅N⋅1=N1(5-5)
var(A~)=22+(N−2)⋅1+22(N+2)2=N+6(N+2)2(5-6)\mathrm{var}(\tilde{A})=\dfrac{2^{2}+(N-2)\cdot 1+2^{2}}{(N+2)^{2}}=\dfrac{N+6}{(N+2)^{2}}\tag{5-6}var(A~)=(N+2)222+(N−2)⋅1+22=(N+2)2N+6(5-6)
两个方差都只与 NNN 有关,不含 AAA。相减:
var(A^)−var(A~)=1N−N+6(N+2)2(5-7)\mathrm{var}(\hat{A})-\mathrm{var}(\tilde{A})=\dfrac{1}{N}-\dfrac{N+6}{(N+2)^{2}}\tag{5-7}var(A^)−var(A~)=N1−(N+2)2N+6(5-7)
var(A^)−var(A~)=(N+2)2−N(N+6)N(N+2)2=4−2NN(N+2)2(5-8)\mathrm{var}(\hat{A})-\mathrm{var}(\tilde{A})=\dfrac{(N+2)^{2}-N(N+6)}{N(N+2)^{2}}=\dfrac{4-2N}{N(N+2)^{2}}\tag{5-8}var(A^)−var(A~)=N(N+2)2(N+2)2−N(N+6)=N(N+2)24−2N(5-8)
分子 4−2N4-2N4−2N 在 N=2N=2N=2 时为零,在 N≥3N\ge3N≥3 时为负。N=2N=2N=2 时两个估计量完全相同,把 N=2N=2N=2 代回式(5-2),分子变成 2x0+2x12x0+2x12x0+2x1,除以 N+2=4N+2=4N+2=4,正好是 (x0+x1)/2(x0+x1)/2(x0+x1)/2;N≥3N\ge3N≥3 时样本均值严格更优。
所以 A^\hat{A}A^ 更好,而且这个结论与 AAA 的取值无关,因为偏差与方差都不含 AAA。
式(5-5)与式(5-6)都是随 NNN 递减的,差距则随 NNN 增大而迅速缩小。取几个样本数看一下(σ2=1\sigma^2=1σ2=1):
| NNN | var(A^)\mathrm{var}(\hat{A})var(A^) | var(A~)\mathrm{var}(\tilde{A})var(A~) | 比值 |
|---|---|---|---|
| 2 | 0.5000 | 0.5000 | 1.000 |
| 3 | 0.3333 | 0.3600 | 0.926 |
| 4 | 0.2500 | 0.2778 | 0.900 |
| 5 | 0.2000 | 0.2245 | 0.891 |
| 10 | 0.1000 | 0.1111 | 0.900 |
| 20 | 0.0500 | 0.0537 | 0.931 |
两个估计量的方差都按 1/N1/N1/N 的速度下降,差别体现在前面的常数上:一个损失两个样本的自由度,这个损失在 NNN 小的时候最明显,NNN 大到十几以后可以忽略。
第二个估计量的权重分配本身也值得看一眼。两端的权重是 2/(N+2)2/(N+2)2/(N+2),中间是 1/(N+2)1/(N+2)1/(N+2),两端拿到双倍权重。用有效样本数来表达它的方差,Neff=(N+2)2/(N+6)N_{\mathrm{eff}}=(N+2)^2/(N+6)Neff=(N+2)2/(N+6) 在 NNN 较大时约等于 N−2N-2N−2。把一部分权重从中间挪到两端,并没有换来任何偏差上的好处,只损失了自由度。
如果把无偏的限制放开,结论就会变。第二节里那个乘系数 aaa 的估计量正是例子:aaa 取 111 时无偏,取 aopta_{\mathrm{opt}}aopt 时均方误差更小,而 aopta_{\mathrm{opt}}aopt 依赖 AAA。也就是说,允许有偏时「哪个更好」会随 AAA 变;把比较限制在无偏类里,这个问题才有与 AAA 无关的答案。
六、习题 2.1:高斯样本的方差估计量
题目给的是:观测 xnxnxn 独立同分布服从 N(0,σ2)N(0,\sigma^2)N(0,σ2),用 σ^2=(1/N)∑n=0N−1x2n\hat\sigma^2=(1/N)\sum_{n=0}^{N-1}x^2nσ^2=(1/N)∑n=0N−1x2n 估计 σ2\sigma^2σ2。问它是否无偏,方差是多少,以及 NNN 趋于无穷时会怎样。
先算二阶矩。xnxnxn 零均值,
E(x2n)=var(xn)+(Exn)2=σ2(6-1)E\left(x^{2}n\right)=\mathrm{var}\left(xn\right)+\left(E xn\right)^{2}=\sigma^{2}\tag{6-1}E(x2n)=var(xn)+(Exn)2=σ2(6-1)
于是
E(σ^2)=1N∑n=0N−1E(x2n)=σ2(6-2)E(\hat{\sigma}^{2})=\dfrac{1}{N}\sum_{n=0}^{N-1}E\left(x^{2}n\right)=\sigma^{2}\tag{6-2}E(σ^2)=N1n=0∑N−1E(x2n)=σ2(6-2)
无偏。方差要从四阶矩来,记 Y=x2nY=x^2nY=x2n,
var(Y)=E(x4n)−(Ex2n)2(6-3)\mathrm{var}(Y)=E\left(x^{4}n\right)-\left(E x^{2}n\right)^{2}\tag{6-3}var(Y)=E(x4n)−(Ex2n)2(6-3)
零均值高斯的四阶矩有现成的分解式,把四个因子两两配对:
Ex1x2x3x4=Ex1x2Ex3x4+Ex1x3Ex2x4+Ex1x4Ex2x3(6-4)Ex_{1}x_{2}x_{3}x_{4}=Ex_{1}x_{2}Ex_{3}x_{4}+Ex_{1}x_{3}Ex_{2}x_{4}+Ex_{1}x_{4}Ex_{2}x_{3}\tag{6-4}Ex1x2x3x4=Ex1x2Ex3x4+Ex1x3Ex2x4+Ex1x4Ex2x3(6-4)
四个二阶矩都是 σ2\sigma^2σ2,三项相加给出
E(x4n)=3(σ2)2=3σ4(6-5)E\left(x^{4}n\right)=3\left(\sigma^{2}\right)^{2}=3\sigma^{4}\tag{6-5}E(x4n)=3(σ2)2=3σ4(6-5)
var(x2n)=3σ4−(σ2)2=2σ4(6-6)\mathrm{var}\left(x^{2}n\right)=3\sigma^{4}-\left(\sigma^{2}\right)^{2}=2\sigma^{4}\tag{6-6}var(x2n)=3σ4−(σ2)2=2σ4(6-6)
样本之间独立,方差可加:
var(σ^2)=1N2∑n=0N−1var(x2n)(6-7)\mathrm{var}(\hat{\sigma}^{2})=\dfrac{1}{N^{2}}\sum_{n=0}^{N-1}\mathrm{var}\left(x^{2}n\right)\tag{6-7}var(σ^2)=N21n=0∑N−1var(x2n)(6-7)
var(σ^2)=1N2⋅N⋅2σ4=2σ4N(6-8)\mathrm{var}(\hat{\sigma}^{2})=\dfrac{1}{N^{2}}\cdot N\cdot 2\sigma^{4}=\dfrac{2\sigma^{4}}{N}\tag{6-8}var(σ^2)=N21⋅N⋅2σ4=N2σ4(6-8)
NNN 增大时
limN→∞var(σ^2)=limN→∞2σ4N=0(6-9)\lim_{N\to\infty}\mathrm{var}(\hat{\sigma}^{2})=\lim_{N\to\infty}\dfrac{2\sigma^{4}}{N}=0\tag{6-9}N→∞limvar(σ^2)=N→∞limN2σ4=0(6-9)
无偏加上方差趋于零,估计量是均方收敛的,因而也依概率收敛。对任意 ε>0\varepsilon>0ε>0,切比雪夫不等式给出
P(∣σ^2−σ2∣≥ε)≤var(σ^2)ε2(6-10)P\left(\left|\hat{\sigma}^{2}-\sigma^{2}\right|\ge\varepsilon\right)\le\dfrac{\mathrm{var}(\hat{\sigma}^{2})}{\varepsilon^{2}}\tag{6-10}P( σ^2−σ2 ≥ε)≤ε2var(σ^2)(6-10)
P(∣σ^2−σ2∣≥ε)≤2σ4Nε2→0(6-11)P\left(\left|\hat{\sigma}^{2}-\sigma^{2}\right|\ge\varepsilon\right)\le\dfrac{2\sigma^{4}}{N\varepsilon^{2}}\to0\tag{6-11}P( σ^2−σ2 ≥ε)≤Nε22σ4→0(6-11)
这样的估计量称作一致估计量。
换一个角度看会更清楚。把每个样本标准化,Zn=xn/σZ_n=xn/\sigmaZn=xn/σ 服从 N(0,1)N(0,1)N(0,1),
Nσ^2σ2=∑n=0N−1(xnσ)2∼χN2(6-12)\dfrac{N\hat{\sigma}^{2}}{\sigma^{2}}=\sum_{n=0}^{N-1}\left(\dfrac{xn}{\sigma}\right)^{2}\sim\chi_{N}^{2}\tag{6-12}σ2Nσ^2=n=0∑N−1(σxn)2∼χN2(6-12)
所以 σ^2\hat{\sigma}^2σ^2 服从 σ2/N\sigma^2/Nσ2/N 倍的 NNN 自由度卡方分布,方差由卡方分布的性质直接读出 2σ4/N2\sigma^4/N2σ4/N。相对标准差 2/N\sqrt{2/N}2/N 说明这个量收敛得并不快:想把标准差的相对误差压到 10%,需要大约两百个样本。把 N=2N=2N=2 代入式(6-8)得 var(σ^2)=σ4\mathrm{var}(\hat\sigma^2)=\sigma^4var(σ^2)=σ4,与下一节直接算出的结果一致,那道题是本题在最小样本上的特例。
七、习题 2.2:均匀分布参数的无偏估计
题目给的是:(x0,x1,...,xN−1)(x0,x1,\ldots,xN-1)(x0,x1,...,xN−1) 独立同分布服从 U0,θU0,\\thetaU0,θ,θ\thetaθ 的范围是 0<θ<∞0<\theta<\infty0<θ<∞。问能否求出 θ\thetaθ 的无偏估计。
一阶矩给出 θ/2\theta/2θ/2,矩估计法直接把样本均值翻倍:
E(xn)=θ2(7-1)E\left(xn\right)=\dfrac{\theta}{2}\tag{7-1}E(xn)=2θ(7-1)
θ^MoM=2xˉ=2N∑n=0N−1xn(7-2)\hat{\theta}{\mathrm{MoM}}=2\bar{x}=\dfrac{2}{N}\sum{n=0}^{N-1}xn\tag{7-2}θ^MoM=2xˉ=N2n=0∑N−1xn(7-2)
E(θ^MoM)=2⋅θ2=θ(7-3)E\left(\hat{\theta}_{\mathrm{MoM}}\right)=2\cdot\dfrac{\theta}{2}=\theta\tag{7-3}E(θ^MoM)=2⋅2θ=θ(7-3)
这是一个无偏估计量。
极大似然给出的却是另一个东西。似然函数是
L(θ)=∏n=0N−11θ=1θN,θ≥maxnxn(7-4)L(\theta)=\prod_{n=0}^{N-1}\dfrac{1}{\theta}=\dfrac{1}{\theta^{N}},\qquad \theta\ge\max_{n}xn\tag{7-4}L(θ)=n=0∏N−1θ1=θN1,θ≥nmaxxn(7-4)
θ−N\theta^{-N}θ−N 关于 θ\thetaθ 单调递减,最大值落在允许范围的下边界上,也就是样本最大值:
θ^MLE=x(N)=max(x0,...,xN−1)(7-5)\hat{\theta}{\mathrm{MLE}}=x{(N)}=\max\left(x0,\ldots,xN-1\right)\tag{7-5}θ^MLE=x(N)=max(x0,...,xN−1)(7-5)
最大值小于 yyy 等价于每个样本都小于 yyy,分布函数可以直接写出:
Fx(N)(y)=(yθ)N,0≤y≤θ(7-6)F_{x_{(N)}}(y)=\left(\dfrac{y}{\theta}\right)^{N},\quad 0\le y\le\theta\tag{7-6}Fx(N)(y)=(θy)N,0≤y≤θ(7-6)
密度是它的导数:
fx(N)(y)=NyN−1θN,0≤y≤θ(7-7)f_{x_{(N)}}(y)=\dfrac{Ny^{N-1}}{\theta^{N}},\quad 0\le y\le\theta\tag{7-7}fx(N)(y)=θNNyN−1,0≤y≤θ(7-7)
它的期望是
E(x(N))=∫0θyNyN−1θNdy=NN+1θ(7-8)E\left(x_{(N)}\right)=\int_{0}^{\theta}y\dfrac{Ny^{N-1}}{\theta^{N}}\mathrm{d}y=\dfrac{N}{N+1}\theta\tag{7-8}E(x(N))=∫0θyθNNyN−1dy=N+1Nθ(7-8)
比 θ\thetaθ 小,偏差来自一个固定的因子 N/(N+1)N/(N+1)N/(N+1)。这个方向是可以预料的:所有样本都不超过 θ\thetaθ,样本最大值必然低估,把因子除掉就得到无偏版本:
θ^unb=N+1Nx(N)(7-9)\hat{\theta}{\mathrm{unb}}=\dfrac{N+1}{N}x{(N)}\tag{7-9}θ^unb=NN+1x(N)(7-9)
这类现象并不特殊。参数有上界、估计量落在边界上时,偏差就来自定义域的边界而不是噪声,修正办法往往是一个与 NNN 有关的简单因子。
于是这道题有两个无偏估计量。再比较它们的方差。矩估计量的方差由均匀分布的方差算出:
var(θ^MoM)=4⋅θ2/12N=θ23N(7-10)\mathrm{var}\left(\hat{\theta}_{\mathrm{MoM}}\right)=4\cdot\dfrac{\theta^{2}/12}{N}=\dfrac{\theta^{2}}{3N}\tag{7-10}var(θ^MoM)=4⋅Nθ2/12=3Nθ2(7-10)
样本最大值需要二阶矩:
E(x(N)2)=NN+2θ2(7-11)E\left(x_{(N)}^{2}\right)=\dfrac{N}{N+2}\theta^{2}\tag{7-11}E(x(N)2)=N+2Nθ2(7-11)
var(x(N))=Nθ2(N+2)(N+1)2(7-12)\mathrm{var}\left(x_{(N)}\right)=\dfrac{N\theta^{2}}{(N+2)(N+1)^{2}}\tag{7-12}var(x(N))=(N+2)(N+1)2Nθ2(7-12)
var(θ^unb)=(N+1N)2var(x(N))=θ2N(N+2)(7-13)\mathrm{var}\left(\hat{\theta}{\mathrm{unb}}\right)=\left(\dfrac{N+1}{N}\right)^{2}\mathrm{var}\left(x{(N)}\right)=\dfrac{\theta^{2}}{N(N+2)}\tag{7-13}var(θ^unb)=(NN+1)2var(x(N))=N(N+2)θ2(7-13)
两个方差相除,比值与 θ\thetaθ 无关:
var(θ^unb)var(θ^MoM)=3N+2(7-14)\dfrac{\mathrm{var}\left(\hat{\theta}{\mathrm{unb}}\right)}{\mathrm{var}\left(\hat{\theta}{\mathrm{MoM}}\right)}=\dfrac{3}{N+2}\tag{7-14}var(θ^MoM)var(θ^unb)=N+23(7-14)
N=1N=1N=1 时比值为 111,N≥2N\ge2N≥2 时小于 111。也就是说,除了只有一个样本这个退化情形,最大值修正出来的无偏估计量方差一致地更小。
八、习题 2.5:两样本方差估计量的概率密度
题目给的是:两个独立样本 x0,x1x0,x1x0,x1 服从 N(0,σ2)N(0,\sigma^2)N(0,σ2),σ^2=(x20+x21)/2\hat\sigma^2=(x^20+x^21)/2σ^2=(x20+x21)/2 是无偏的。求 σ^2\hat\sigma^2σ^2 的概率密度,判断它关于 σ2\sigma^2σ2 是否对称。
标准化之后每个样本的平方服从自由度为 1 的卡方分布:
Zi=xiσ∼N(0,1),Zi2∼χ12(8-1)Z_{i}=\dfrac{xi}{\sigma}\sim N(0,1),\qquad Z_{i}^{2}\sim\chi_{1}^{2}\tag{8-1}Zi=σxi∼N(0,1),Zi2∼χ12(8-1)
两个独立的卡方变量相加,自由度相加:
Y=Z02+Z12∼χ22(8-2)Y=Z_{0}^{2}+Z_{1}^{2}\sim\chi_{2}^{2}\tag{8-2}Y=Z02+Z12∼χ22(8-2)
自由度为 2 的卡方分布就是参数为 1/21/21/2 的指数分布:
fY(y)=12e−y/2,y≥0(8-3)f_{Y}(y)=\dfrac{1}{2}e^{-y/2},\qquad y\ge0\tag{8-3}fY(y)=21e−y/2,y≥0(8-3)
待求的估计量是 YYY 的线性变换:
σ^2=σ22(Z02+Z12)=σ22Y(8-4)\hat{\sigma}^{2}=\dfrac{\sigma^{2}}{2}\left(Z_{0}^{2}+Z_{1}^{2}\right)=\dfrac{\sigma^{2}}{2}Y\tag{8-4}σ^2=2σ2(Z02+Z12)=2σ2Y(8-4)
线性变换的密度按 y=2w/σ2y=2w/\sigma^2y=2w/σ2 代换,再乘上雅可比行列式:
fσ^2(w)=fY(2wσ2)⋅2σ2(8-5)f_{\hat{\sigma}^{2}}(w)=f_{Y}\left(\dfrac{2w}{\sigma^{2}}\right)\cdot\dfrac{2}{\sigma^{2}}\tag{8-5}fσ^2(w)=fY(σ22w)⋅σ22(8-5)
fσ^2(w)=1σ2e−w/σ2,w≥0(8-6)f_{\hat{\sigma}^{2}}(w)=\dfrac{1}{\sigma^{2}}e^{-w/\sigma^{2}},\qquad w\ge0\tag{8-6}fσ^2(w)=σ21e−w/σ2,w≥0(8-6)
密度的均值确实是 σ2\sigma^2σ2,与题设的无偏性一致:
E(σ^2)=∫0∞w1σ2e−w/σ2dw=σ2(8-7)E\left(\hat{\sigma}^{2}\right)=\int_{0}^{\infty}w\dfrac{1}{\sigma^{2}}e^{-w/\sigma^{2}}\mathrm{d}w=\sigma^{2}\tag{8-7}E(σ^2)=∫0∞wσ21e−w/σ2dw=σ2(8-7)
判断对称性可以看中位数。若密度关于 σ2\sigma^2σ2 对称,中位数必须落在 σ2\sigma^2σ2 上:
∫0m1σ2e−w/σ2dw=1−e−m/σ2=12(8-8)\int_{0}^{m}\dfrac{1}{\sigma^{2}}e^{-w/\sigma^{2}}\mathrm{d}w=1-e^{-m/\sigma^{2}}=\dfrac{1}{2}\tag{8-8}∫0mσ21e−w/σ2dw=1−e−m/σ2=21(8-8)
m=σ2ln2≈0.693σ2≠σ2(8-9)m=\sigma^{2}\ln2\approx0.693\sigma^{2}\ne\sigma^{2}\tag{8-9}m=σ2ln2≈0.693σ2=σ2(8-9)
所以不对称。还可以换一个更快的判据:指数分布的方差等于均值的平方,于是
var(σ^2)=(σ2)2(8-10)\mathrm{var}\left(\hat{\sigma}^{2}\right)=\left(\sigma^{2}\right)^{2}\tag{8-10}var(σ^2)=(σ2)2(8-10)
var(σ^2)=σ2(8-11)\sqrt{\mathrm{var}\left(\hat{\sigma}^{2}\right)}=\sigma^{2}\tag{8-11}var(σ^2) =σ2(8-11)
均值减去一个标准差正好等于零,而零又是密度的支撑下界。对称分布的支撑下界通常在均值下方两三个标准差之外,这里只差一个,偏差方向只能偏在一侧。
结论是这个估计量右偏:密度从 w=0w=0w=0 处的最大值单调下降,长尾拖在右侧。它更经常低估 σ2\sigma^2σ2,只是偶尔高估、而且高估的幅度更大。样本数增加时 σ^2\hat{\sigma}^2σ^2 服从 σ2/N\sigma^2/Nσ2/N 倍的 NNN 自由度卡方分布,密度的形状从偏斜的指数型逐步趋于对称的正态型,偏斜程度随 NNN 减小。
九、五道题的结果一览
| 题号 | 问题 | 结论 |
|---|---|---|
| 1.1 | 由双程时延估计距离 | R^=(c/2)τ^0\hat R=(c/2)\hat\tau_0R^=(c/2)τ^0 服从正态分布,见式(4-5);99% 落在真值 100 m100\ \mathrm{m}100 m 以内要求时延标准偏差约 2.588×10−72.588\times10^{-7}2.588×10⁻⁷ s |
| 1.4 | 两个直流电平估计量的比较 | 两者都无偏;N=2N=2N=2 时完全相同,N≥3N\ge3N≥3 时样本均值方差更小;结论与 AAA 无关 |
| 2.1 | 高斯样本的方差估计量 | 无偏,方差 2σ4/N2\sigma^4/N2σ4/N,NNN 趋于无穷时是一致估计量 |
| 2.2 | 均匀分布参数 θ\thetaθ | 矩估计 2xˉ2\bar{x}2xˉ 与最大值修正 (N+1)/N⋅x(N)(N+1)/N\cdot x_{(N)}(N+1)/N⋅x(N) 都无偏,后者方差 θ2/N(N+2)\theta^2/N(N+2)θ2/N(N+2) 更小 |
| 2.5 | 两样本方差估计量的密度 | 指数型密度,中位数 0.693σ20.693\sigma^20.693σ2,关于 σ2\sigma^2σ2 不对称,右偏 |
这五道题串起来是同一条线:先把估计量当作随机变量,用均方误差分解出偏差与方差;均方误差最优的估计量会依赖待估参数,于是把准则限制到无偏类;在无偏类里比方差,就是后面几章反复要做的事。反复用到的操作有三种,线性变换下的分布平移(1.1)、线性组合的方差由系数平方和给出(1.4、2.1),以及边界型参数的极大似然偏差可以靠一个因子修正回来(2.2)。