第 00 篇 · 为什么是 k6:AI 时代的性能测试工具选型
文章目录
- [第 00 篇 · 为什么是 k6:AI 时代的性能测试工具选型](#第 00 篇 · 为什么是 k6:AI 时代的性能测试工具选型)
-
- 学习目标与前置准备
- 一、先拆工作流,再谈工具
- 二、一张能追溯的选型对照表
- 三、性能倍数怎么核对,而不是怎么引用
- [四、AI 接入改变的是脚本维护成本](#四、AI 接入改变的是脚本维护成本)
- 五、迁不迁,先算三本账
- [六、把 24 篇变成你的计划](#六、把 24 篇变成你的计划)
你敢拍着胸脯说,你电脑里那份 JMeter 测试计划,离开 GUI(图形操作界面)你还能读懂它吗?
说实话,我不敢。JMeter 的测试计划存在 .jmx 文件里,用的是 XML(一种用标签层层嵌套表达结构的文本格式):找一个断言,得在树状结构里一层层往下点,展开好几层才看得到;想改一个参数,一不小心就点错节点,改完还不容易发现。过去我们挑工具的标准很简单:能用就行。直到这两年 AI 开始替我们写脚本、读报告,这个标准站不住了------你的工具,决定了 AI 帮不帮得上你。
这是专栏开篇。我不打算喊 「k6 碾压一切」 的口号,那是对你不负责。这一篇只干一件事:把选型的依据一条条摆出来,每条都给你留出处,你自己判断------而不是听谁喊得响就跟着换工具。
学习目标与前置准备
读完这篇,你要能自己回答两个问题:你们团队该不该用 k6------按协议、手头资产、怎么执行、维护成本来判断,且每条结论说得出出处;网上那些性能宣传数字,先看比较条件成不成立,再决定信不信。
前置准备不多:具备接口测试或性能测试的基本认识;手头备一份你自己团队的清单------现有脚本、用什么协议、流水线长什么样、预算有多少。后面每一节,我们都拿这张清单出来对一遍。
一、先拆工作流,再谈工具
官方素材 1:k6 仓库中的产品标识原文件,按原比例缩小显示。标识的商标权归 Grafana Labs 所有;本专栏为独立技术讨论,与 Grafana Labs 不存在关联、背书或赞助关系。
选型之前,先把一次性能测试拆成 5 个环节:脚本、发压运行时、指标采集、结果输出、门禁判定。k6 在这 5 个环节里各管一段:Go 语言写的运行时负责发压和采集,JavaScript 脚本负责描述你的业务逻辑,门禁阈值可以写在脚本里;实时指标输出通常通过 --out 参数或 K6_OUT 环境变量指定,测试结束的汇总报告还可在脚本中用 handleSummary() 定制。
k6 的用武之地有 4 类:协议级测试(HTTP、WebSocket、gRPC)、真实浏览器测试、合成监控、故障实验。但「能覆盖」不等于「装完就有」:底座是开源命令行;合成监控可以自己定时调度低负载 k6 测试来做,也可采用 Grafana Cloud 的托管服务;故障实验靠 xk6-disruptor 扩展实现,只面向跑在 Kubernetes 上的应用------该扩展本身开源(AGPL 协议),但 2026 年 6 月已被官方归档、停止维护,与现行 k6 v2 的兼容性待验证;团队协作和全球发压节点是 Grafana Cloud 商业服务的事。开源底座、扩展、商业服务三层要分别核对依赖、维护投入与费用------扩展不收授权费,但要投入你自己的安装与维护工时;云服务才直接花钱。把云平台能力当成开源本体能力,是选型报告里最常见的翻车点。
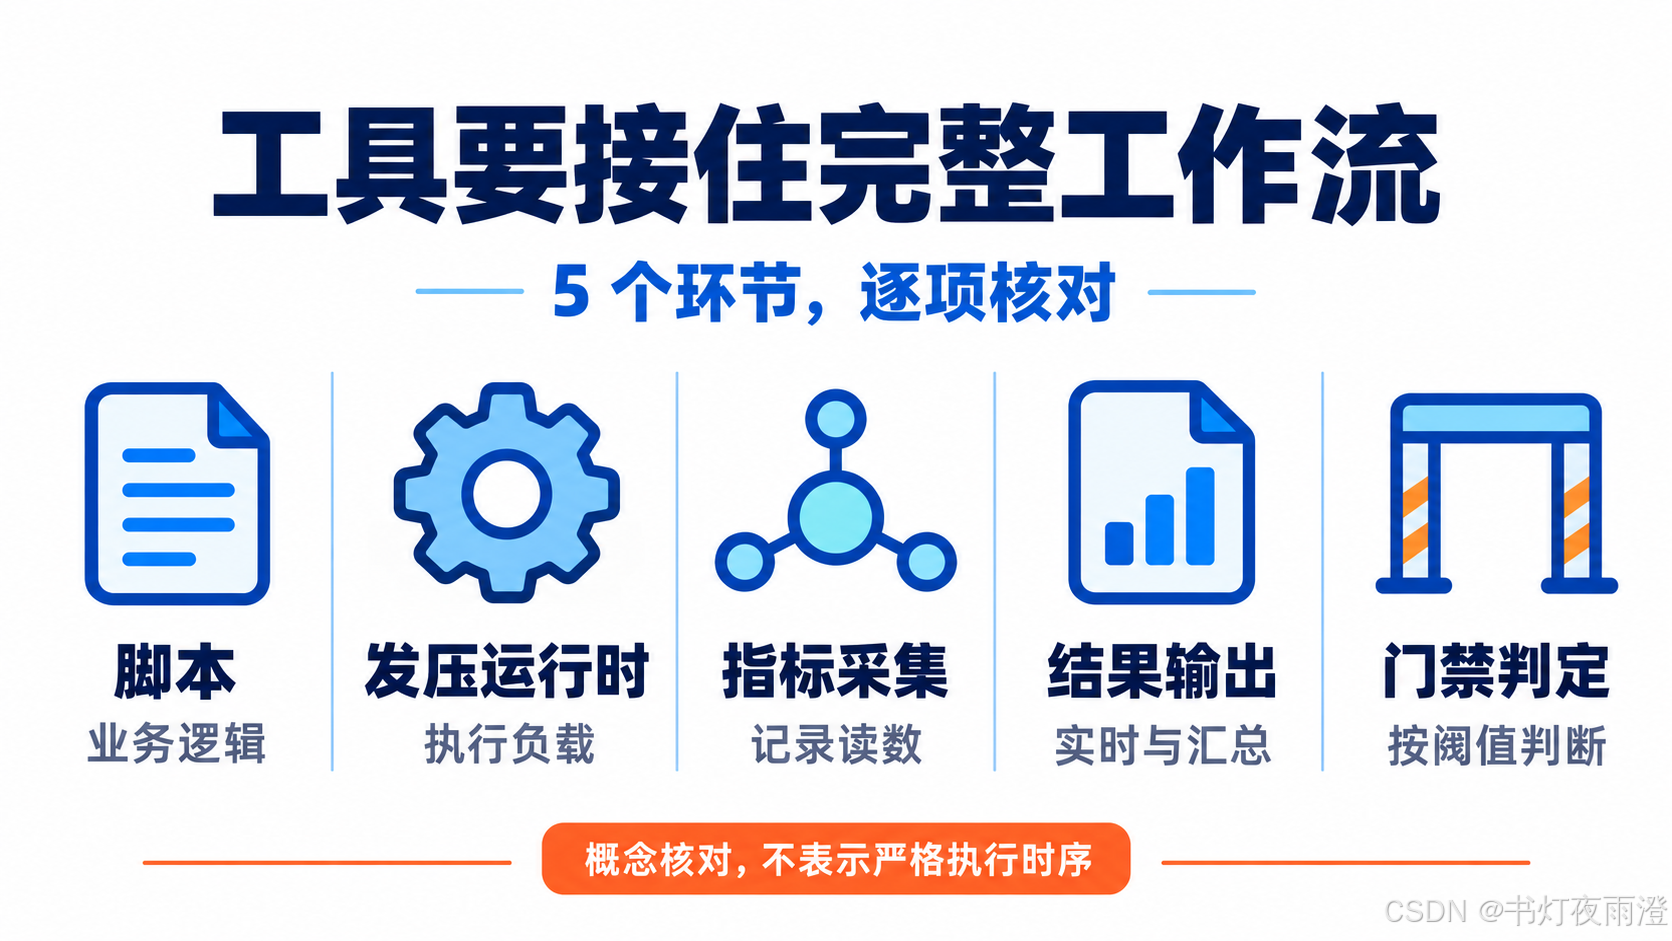
图 1:5 个环节是并列核对项,不表示严格执行时序;能力来源及扩展状态见正文。
先拆环节,是因为工具买回来要嵌进每天的工作里用:脚本得能进 Git 走评审,指标得能接进现有监控栈,门禁得能卡进流水线。哪一环接不上,那一环往后就得靠人肉去补。
再看一段官方仓库留下的命令行演示,感受一下从写脚本、敲命令到看结果是什么样子:
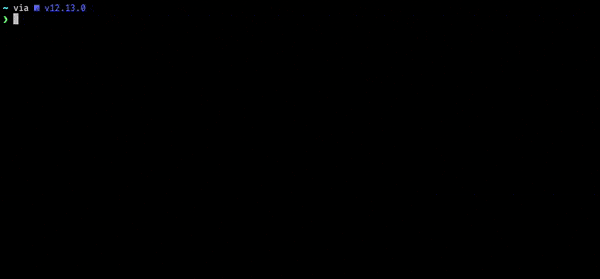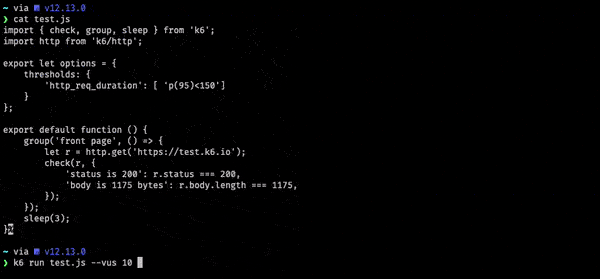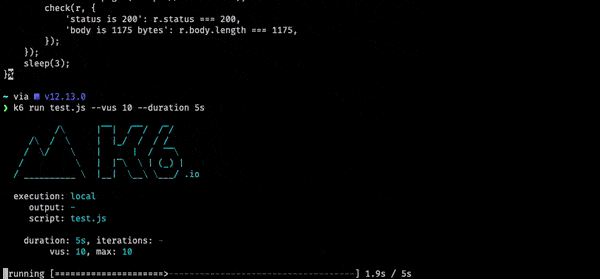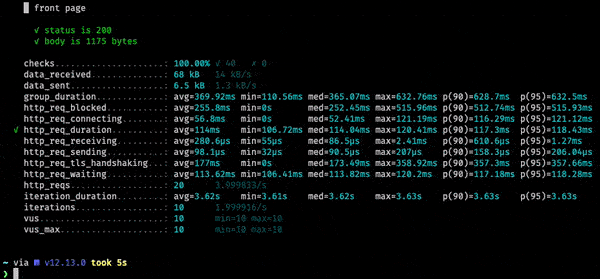
官方素材 2:来源为仓库演示原文件,该文件最近一次更新于 2020-04-16。画面中的命令、界面和读数用于历史演示,具体操作以当前版本文档为准;其中读数不是本专栏实测结果。
二、一张能追溯的选型对照表
先看表,再教你怎么用。
| 维度 | k6 | JMeter | Locust |
|---|---|---|---|
| 脚本形态 | JavaScript 文本 | XML+GUI | Python 文本 |
| 学习曲线 | 会 JavaScript 即上手 | GUI 友好、XML 劝退 | 会 Python 即上手 |
| 发压运行时 | Go 运行时,协程并发 | 跑在 JVM(Java 虚拟机)上 | Python 协程 |
| 容器与云原生 | 原生友好 | 靠外挂组合 | 一般 |
| 实时监控输出 | 自带 InfluxDB 输出;Prometheus 输出为实验性内置 | 内置后端监听器,可输出 InfluxDB/Graphite | 官方可选 OpenTelemetry 集成(另装 locustotel 依赖) |
| 分布式 | 自带负载分割;Operator 为官方扩展;云端执行为商业服务 | 主从架构 | 主从架构 |
| AI 接入 | 官方 MCP(模型上下文协议)子命令扩展,首次使用自动下载、服务预览中;含编辑器接入 | 无官方接入 | 无官方 MCP;提供面向 AI 助手的机器可读文档 |
| 社区生态 | 增长快 | 最厚 | 中等 |
读表方法有 3 条,请记住。
第一,不是数星星谁多谁赢,是拿你自己的场景往上套------全组 Java 出身、躺着几百个 .jmx,JMeter 的生态厚度就是压舱石。
第二,「发压运行时」一行只说原理差别,不代表谁跑得快:Go 协程、JVM、Python 协程落到你的请求链上谁快,以同条件实测为准,方法就是下一节的内容。
第三,分清真身:工具自带、社区扩展、商业服务是三列账,表里 k6 列与两家对手的输出、AI 接入条目已按 2026-10-10 核验的官方文档口径书写,其余概括性条目在文末「素材与验证状态」单独登记。
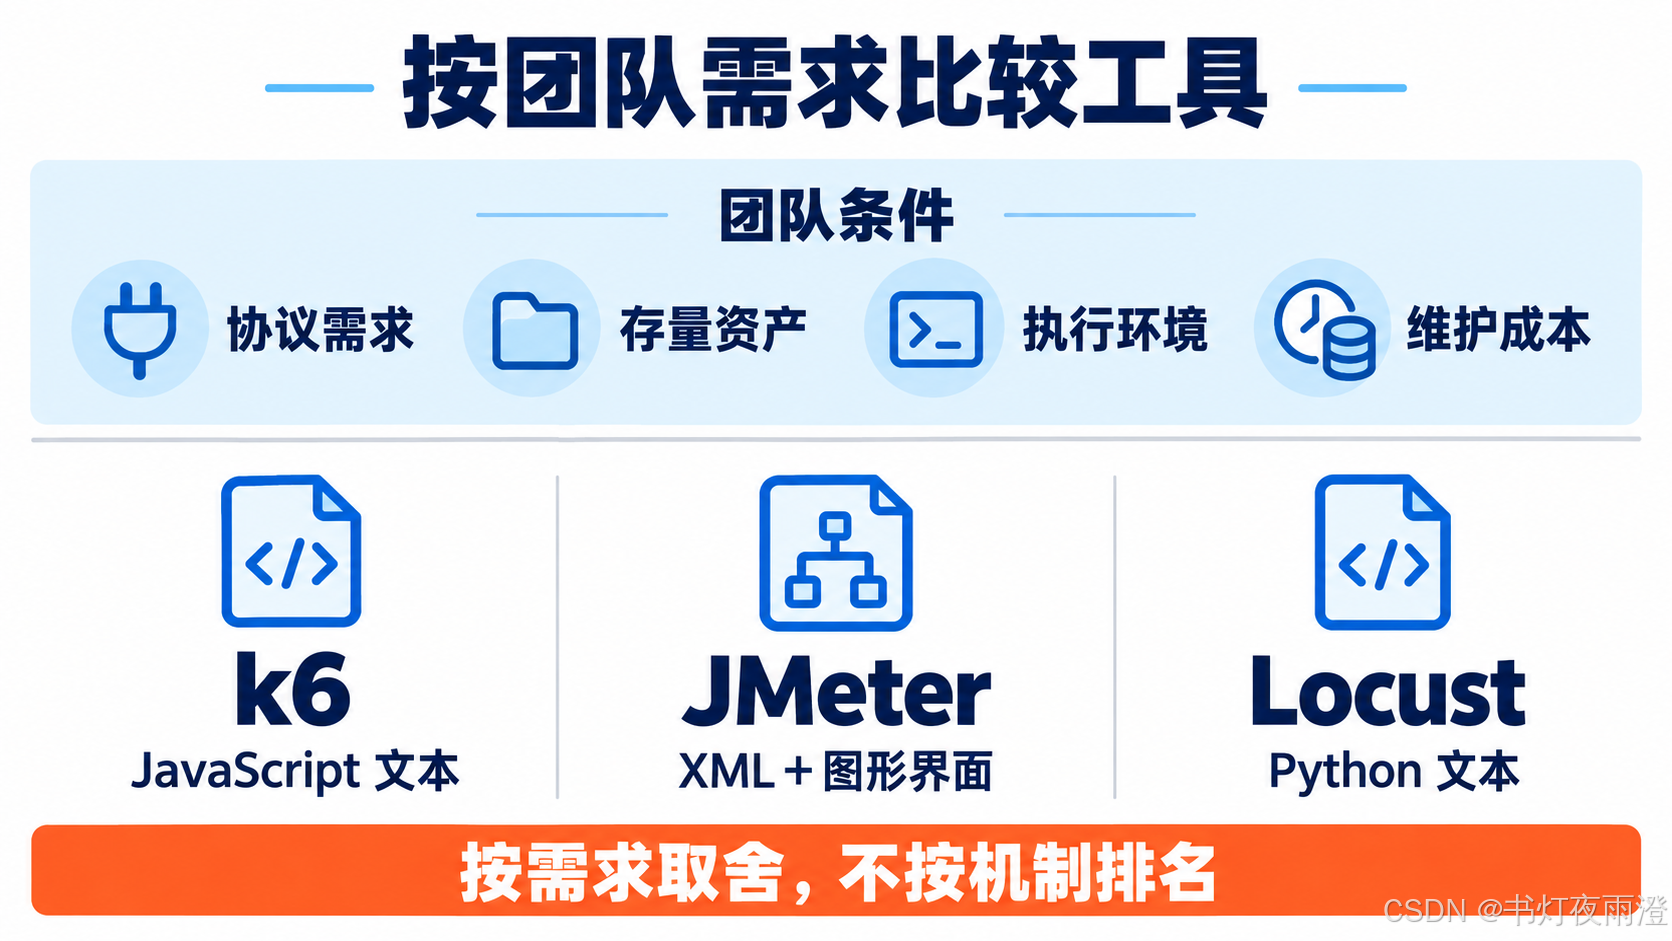
图 2:3 个工具平等并列,按协议需求、存量资产、执行环境和维护成本取舍;图中不作性能排名。
对照表是通用口径,落到你团队得重填一遍。给你一张模板,比原表多出三栏------你的需求、验证动作、采用结论,这三栏才是选型报告里最值钱的部分:
| 能力项 | 你的需求 | 实现方式 | 来源与限制 | 验证动作 | 采用结论 |
|---|---|---|---|---|---|
| 示例:实时监控输出 | 必须进现有 Prometheus 栈 | k6 实验性内置输出 | 官方文档标注实验性 | 跑 1 次短测核对数据完整性 | 待验证 |
| (按你的协议、资产、环境逐项往下填) |
三、性能倍数怎么核对,而不是怎么引用
网上流传比较广的一组对照来自 CSDN 上一篇工具盘点文章(《告别 JMeter?这款性能测试工具让我震惊了》:文中称同等硬件下 k6 内存占用仅为 JMeter 的十分之一、请求吞吐量高出 3 到 5 倍。我把它当线索用,不当结论用,原因有两条:原文没有随文披露硬件配置、工具版本和请求链细节,比较条件核不起来;我也没有在相同硬件上复现。咱们专栏的数字规矩先立在这儿:没复现、条件核不起来的数字不当结论用,只当线索用。
但「线索怎么用」是有方法的。你要自己核,就按同条件实验来:同硬件、同请求链、同连接策略、同思考时间、同输出开销,5 个「同」缺一个,比较就不成立。跑的时候同时看 3 个数:实际吞吐、错误率、发压端资源。
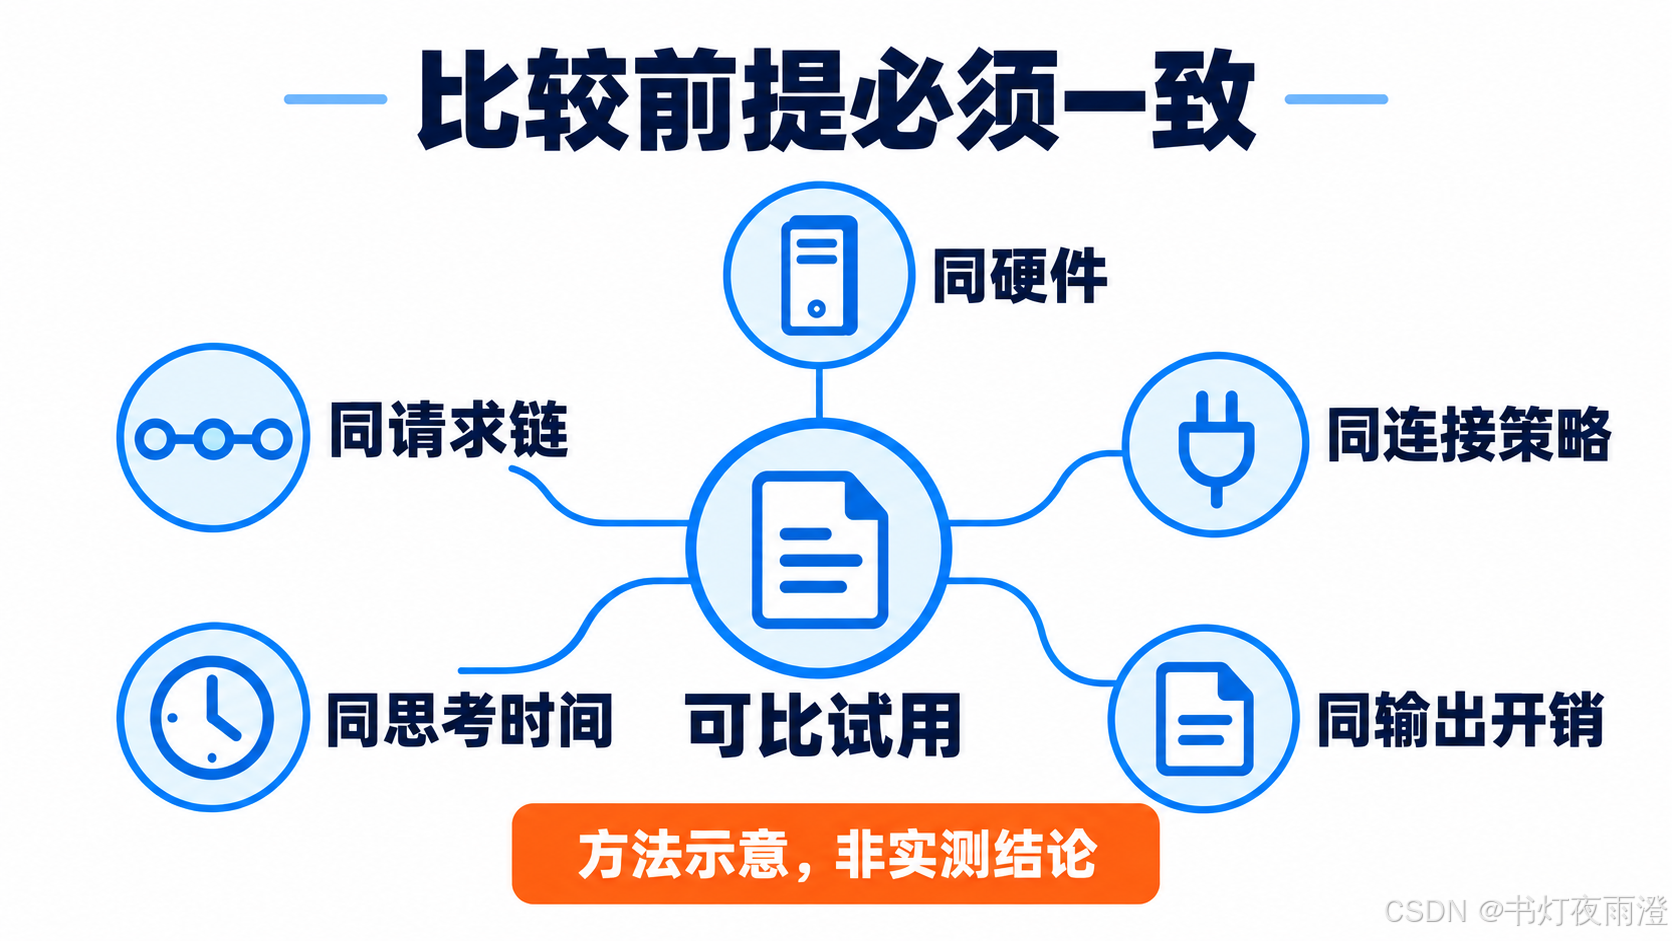
图 3:5 个「同」共同构成比较前提;连接线表示共同约束,图中不含实测结果。
实验设计先落表再开跑,5 个「同」逐条登记双方统一的取值:
| 比较条件(5 个「同」) | 双方统一取值 |
|---|---|
| 同硬件 | 例:同一台发压机,8 核 16G |
| 同请求链 | |
| 同连接策略 | |
| 同思考时间 | |
| 同输出开销 |
还有一个概念必须咬死:目标负载和实际负载是两回事。举个假设的数:你把目标定成每秒启动 1000 次迭代,发压端 CPU 先打满,实际每秒只启动了 600 次。这轮没跑够目标压力不说,连响应时间的读数都可能被发压机自己拖高、变了形。拿这样的数据说你的系统在目标压力下能扛多少,不作数。官方对大规模测试的建议是发压端保留约 20% 空闲 CPU;资源不够时先排查发压端瓶颈,再考虑扩容或把负载分到多台发压机。发压端先饱和,结论作废,这是咱们行当的铁律。
这一节直接连着采购单:发压机要几台、什么规格,是真金白银;信错了倍数,台数就报错了。
四、AI 接入改变的是脚本维护成本
「AI 时代」四个字跟选型的关系,说到底就在脚本维护成本上。我把 AI 接入拆成 4 个环节看:脚本生成、差异评审、机器可读结果、命令行编排。
先看脚本生成。 别争论哪种语言 AI「更熟」,直接试:同一段业务逻辑,让 AI 助手分别生成 k6 脚本和 JMeter 测试计划,各跑一遍,数一数错几处、你亲手改几处,差距摆在那儿。JMeter 的 XML 还要多一道校验:结构错误可能导致测试计划加载失败,报错定位多半要回 GUI 对照树结构,所以生成后先校验结构,再验证一次运行行为。
**再看评审。**纯文本脚本能 diff、能 code review;XML 的改动埋在层层标签里,得靠工具展开才能对照着看。读结果这块说句公道话:JSON 和 JMeter 的 JTL 结果文件都能机器解析,差别在结构规不规整、工具链全不全------各自接进分析链路要多少工作量,拿一份真实结果文件解析一次就有数。最后是编排:k6 命令行全参数化,脚本里的配置从命令行就能覆盖。
v2 版本官方把接入口做成了子命令:k6 x agent init claude-code 一条命令给编辑器装好 k6 技能并注册 MCP 服务------目标编辑器还支持 cursor、vscode-copilot 等。k6 x mcp 则启动这个标准接口的服务端,让 AI 助手直接查文档、校验脚本、跑测试。这两个子命令是官方维护的扩展,不在 k6 二进制里,首次运行时自动下载;MCP 服务目前还在预览阶段。这些不是道听途说,是我 2026-10-10 在官方文档里逐条核对过的、现在还作数的能力。
但丑话说在前头:**AI 生成完不等于能信。**端点对不对、数据对不对、负载模型对不对、判定逻辑对不对,这 4 样必须人工核。具体的生成与分析实操,本栏第 22 篇专门讲。
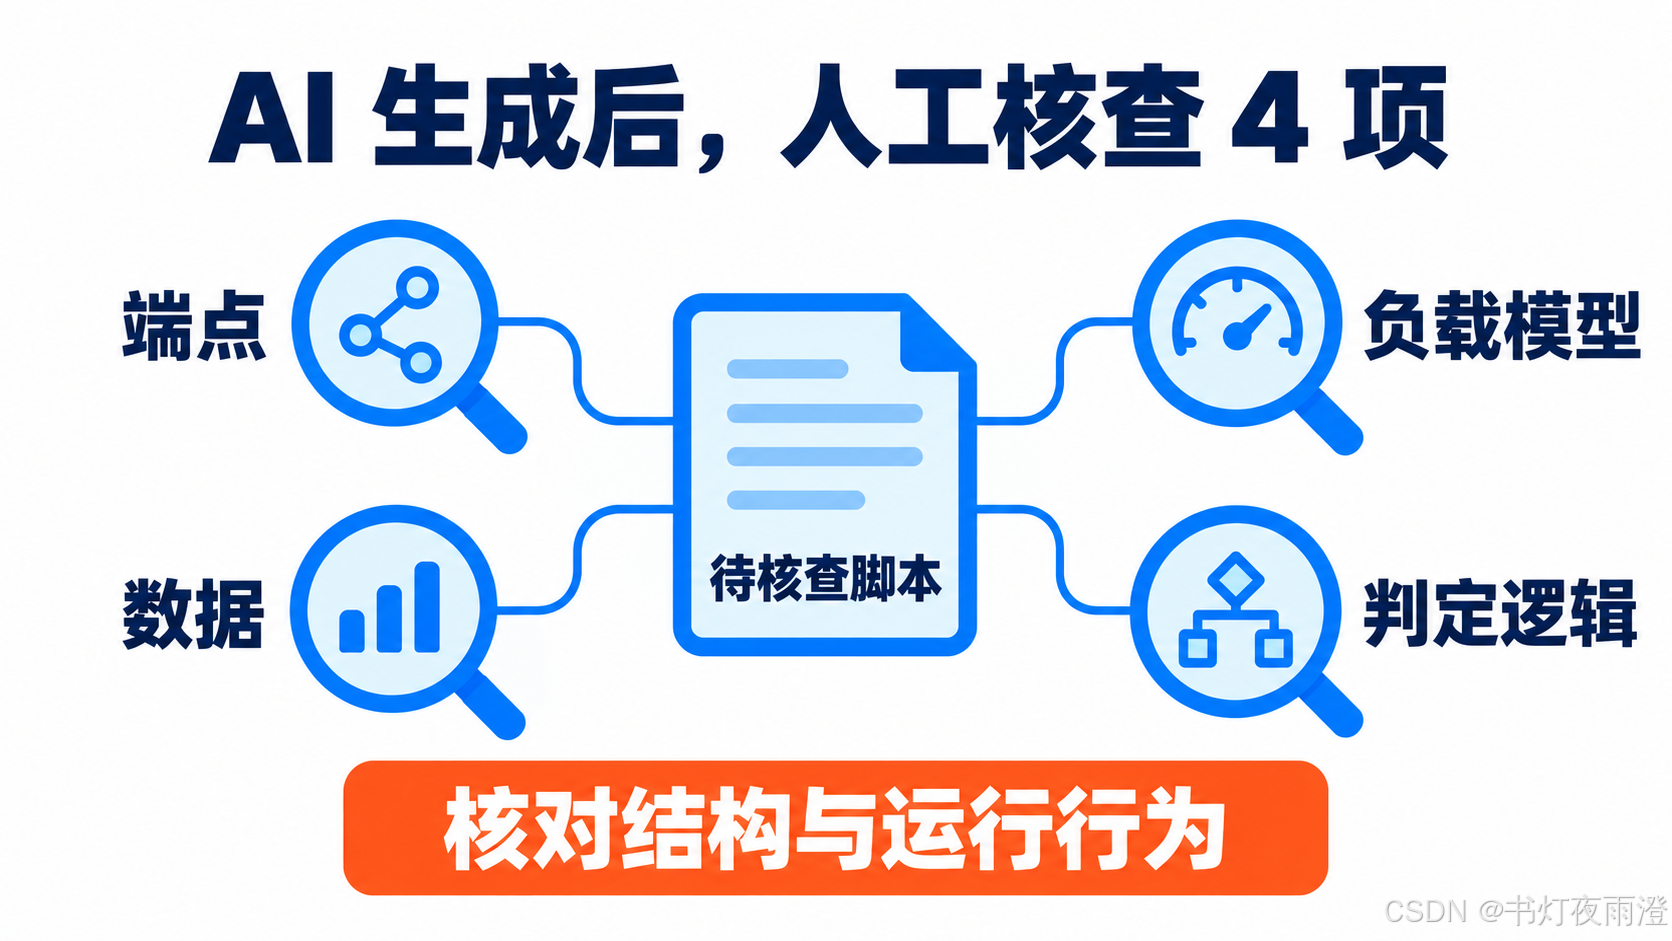
图 4:端点、数据、负载模型和判定逻辑是 4 项人工核查内容;图中脚本处于待核查状态。
顺带交代我自己踩过的一个坑:我原本也想当然,以为网上教程里的 externally-controlled 执行器还能用,翻官方 v2 迁移说明才发现它已被移除、而且没有替代。所以请记住,2026 年 5 月 k6 v2 发布之前的教程,用之前先对照官方迁移页核一遍------本栏第 20 篇会把这些破坏性变更整理成一张迁移清单。
五、迁不迁,先算三本账
话不能说满,有 3 类团队我建议缓一缓:重度依赖 GUI 录制、团队里没人写代码的,k6 没有图形化编排,门槛实打实存在;Java 私有协议栈绑死的,协议支持得重做;JMeter 元件库资产几百上千份的,先算迁移工作量。
真要动,路线有 3 条:
- 保留原工具不动,把 k6 用在新增链路上;
- 双工具并行一段时间,老资产边跑边退;
- 先迁冒烟短测这类小场景,验收过了再扩大范围。
我个人偏好第三条,风险小、证据实,但这是偏好不是定律。
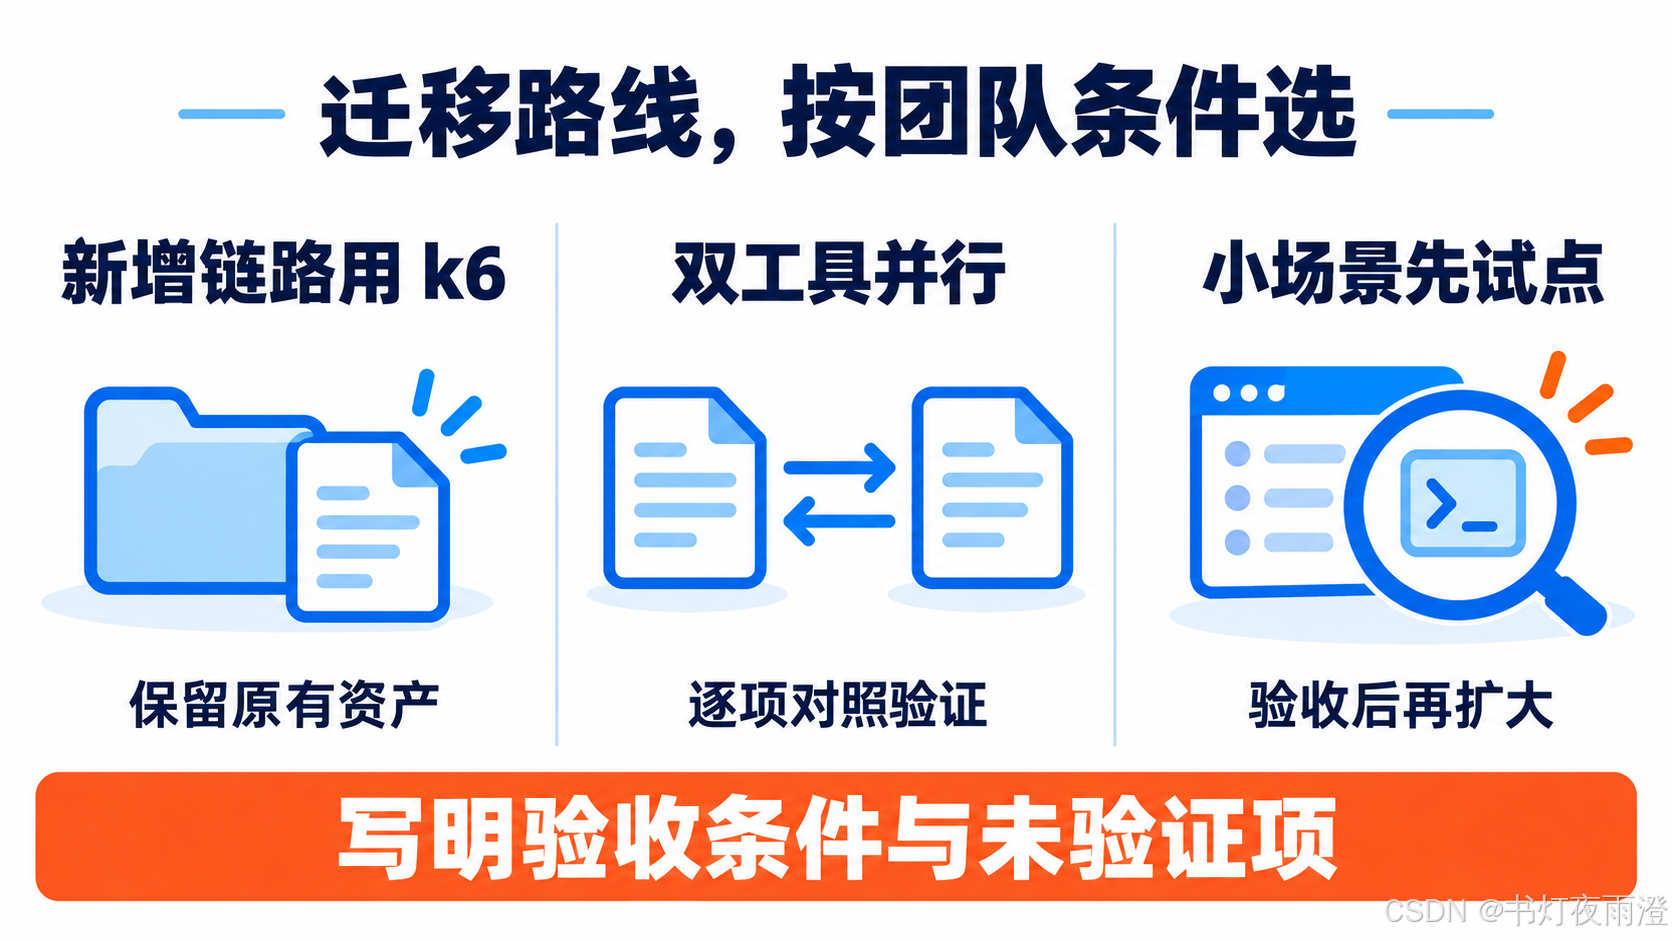
图 5:3 条路线是可选方案,路线之间没有先后顺序;中部双向箭头表示对照验证,采用建议须写明验收条件与未验证项。
迁移决策的输出物很简单:一页采用建议。骨架给你:
| 条目 | 登记内容 |
|---|---|
| 可迁移范围 | 例:新增链路全部、存量冒烟短测 |
| 保留资产 | 例:全部 .jmx 与私有协议元件 |
| 试点验收条件 | 例:1 条链路跑 2 周,结果与原工具对照无未解释偏差 |
| 未验证项 | 例:私有 Java 协议在 k6 侧的等价实现 |
| 结论 | 采用/双轨并行/暂不迁移 |
算的账只有一条:迁移省下的钱,要大于迁移花掉的钱。
六、把 24 篇变成你的计划
全栏 24 篇,四级台阶。
- 入门(00---03 拟免费试读)完成安装、脚本结构、HTTP 参数化,先跑起来;
- 04---06 补门禁、指标与负载模型。进阶(07---14)讲执行器组合、事务粒度、报告体系、监控栈与脚本工程化。
- 精通(15---21)讲扩展、分布式、云端、浏览器测试、版本迁移与流水线门禁。
- 综合实战(22---23)用官方 AI 接入和一个工单系统的全链路压测收尾。
如果你还关注 Agent 系统的任务级判定(一笔工单到底合不合格),那是番外 A 栏和 30 讲主课的地界,本栏只讲工具本身,到那儿我会给你指门。
本篇留 3 个跟练任务,别只看不练:
- 主练:把团队的协议、现有资产、执行环境与验收需求填进第二节的模板表,每项能力补上来源与限制、验证动作和采用结论。
- 对照:挑 1 条已有请求链,按第三节的 5 个「同」设计一个可比试用方案,条件逐条填进登记表------先别跑容量测试,也别预填性能结果。
- 迁移练习:按第五节的骨架写 1 页采用建议,包含可迁移范围、保留资产、试点验收条件与未验证项。
最后收个尾 。团队有人写 JavaScript、脚本要进 Git 评审、流水线要卡性能门禁的,k6 值得现在就开试点;重度依赖 GUI 录制、Java 协议栈绑死、JMeter 资产成山的,留着原工具同样是合理决定。两条路第一步都一样:先挑一条小场景跑试点,按第五节那页采用建议验收,再谈下一步。