一、那个周五下午
你大概经历过这样的场景:周五下午四点,产品经理在群里丢下一句"退款期限改一下,会员延长到 15 天",然后下线。
你打开用例库,搜"退款",出来 87 条。哪些要改?哪些已经过期?自动化脚本里硬编码的那个 7散落在几个文件里?没有人能在五分钟内回答你。
这件事真正消耗人的,不是写用例本身,而是需求、用例、脚本三者之间那条一直在断的线。需求变了,用例没跟上;用例改了,脚本没跟上;脚本挂了,没人说得清它到底在验证哪条业务规则。
所以这篇文章讨论的"不写测试用例",说得准确一点,是不再手写用例。用例不会消失,它会变成需求和脚本之间的中间产物,由 AI 生成,由人审核,全程可追溯。
二、先把话说清楚:AI 不是来替你思考的
直接把需求文档丢给大模型,说"帮我生成测试并执行",得到的通常是这样的东西:
-
覆盖了所有正常路径,看起来很全
-
边界值只有一两个,而且往往取在最"显然"的位置
-
断言停在"页面出现了成功提示"
-
需求里含糊的地方,AI 会自己脑补一个答案,而且写得非常自信
最后一条最危险。一个会自信地写错的测试,比没有测试更糟,因为它会亮绿灯。
所以这套方案的核心设计原则只有一句:让 AI 做它擅长的展开和生成,把判断和把关留在人手里,并用机制保证把关真的发生。
三、整体工作流
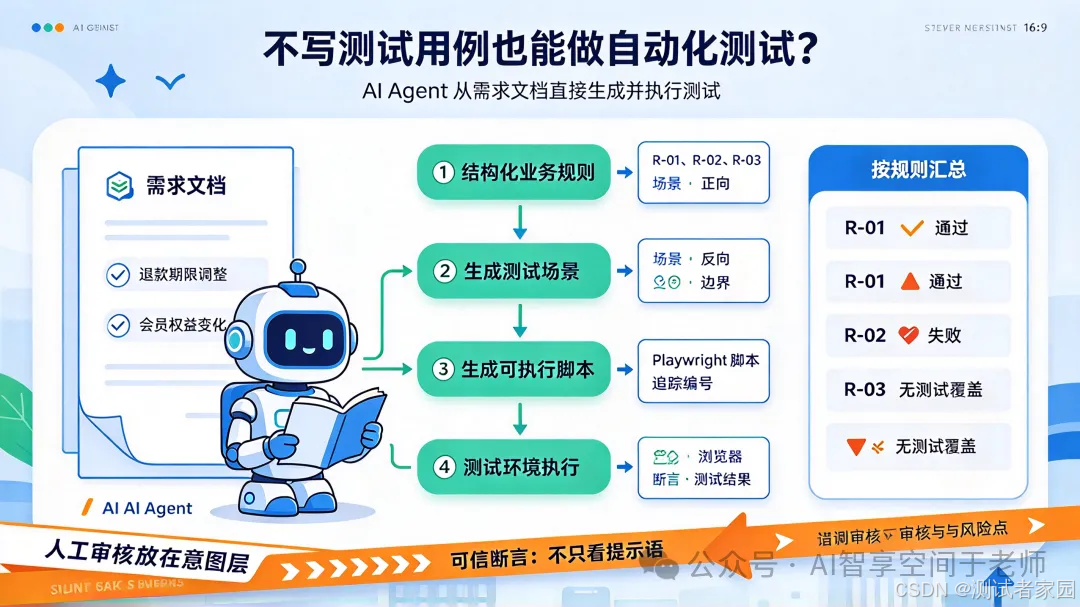
需求文档   │  ① 结构化:拆成带编号的业务规则(R-01, R-02...)   ▼业务规则清单  ──►  【人工审核点 A】确认规则理解无误,处理"待确认"项   │  ② 生成测试场景:每条规则至少对应正向、反向、边界场景   ▼测试场景(即用例)  ──►  【人工审核点 B】只审场景,不审代码   │  ③ 生成 Playwright 脚本,文件头标注追踪的规则编号   ▼可执行脚本  ──►  【自动关卡】断言校验 + 缺陷注入校验   │  ④ 在测试环境执行   ▼结果报告:按规则编号汇总(R-01 ✅ R-02 ❌ R-03 ⚠️无测试覆盖)

     几个设计选择值得单独说。
**第一,两个人工审核点放在"意图"层,而不是"代码"层。**审核点 A 审的是"AI 有没有理解对需求",审核点 B 审的是"场景有没有漏"。这两处用自然语言就能审,一个懂业务的测试工程师十几分钟就能过完。如果把人工审核放在代码层,你会发现审核成本并没有比自己写低多少,这套方案就失去意义了。
**第二,需求追踪是主线,不是附加功能。**每条规则有编号,每个场景标注它验证哪条规则,每个脚本文件头写明追踪的编号。结果报告按规则聚合,而不是按脚本聚合。这样"R-05 没有任何测试覆盖"会作为一种显式状态出现,而不是悄悄消失。
**第三,RAG 是可选项。**需求文档不大、单个模块的规则在几十条以内时,直接放进上下文就行。当规则分散在多份文档、历史变更记录、接口文档里时,再引入检索。不要一开始就上向量库,那会把一个流程问题变成基础设施问题。
四、案例一:一条退款规则,AI 是怎么"绿灯写错"的
以下是我构造的演示场景,用来说明机制,不是某个真实项目的数据。
假设需求文档里有这样一段:
订单签收后 7 天内,用户可申请无理由退款。已使用的虚拟商品不支持退款。退款金额原路退回,不超过实付金额。
步骤①:结构化,同时暴露歧义
让 LLM 输出的不是自由文本,而是固定格式的规则清单,并且明确要求它把无法确定的地方单独列为"待确认",不允许自行假设:
| 编号 | 规则 | 状态 |
|---|---|---|
| R-01 | 签收后 7 天内可申请无理由退款 | 明确 |
| R-02 | 已使用的虚拟商品不可退款 | 明确 |
| R-03 | 退款金额 ≤ 实付金额,原路退回 | 明确 |
| Q-01 | "7 天内"的边界:签收后第 7 天 23:59 是否仍可申请?按自然日还是 168 小时? | 待确认 |
| Q-02 | "已使用"如何判定?是否包含"已下载未打开"? | 待确认 |
| [ ] |
这一步的价值往往被低估。Q-01 是真实项目里最常见的争议来源之一:开发按 168 小时实现,产品脑子里是自然日,测试拿到的用例里写的是"第 7 天"。AI 把它显式列出来,审核点 A 上一个问题就能问清,这比任何一条自动化脚本都早发现问题。
步骤②③:生成场景和脚本
针对 R-01,AI 生成的场景包括:签收后第 1 天申请、第 7 天申请(依 Q-01 的答案取值)、第 8 天申请(应被拒绝)。其中"第 8 天被拒绝"对应的脚本大致如下:
// tests/refund/r01-expired.spec.ts// 追踪:REQ-REFUND / R-01import { test, expect } from '@playwright/test';
test('R-01 签收后第8天申请退款应被拒绝', async ({ page, request }) => {  // 通过测试专用接口造数,避免依赖前置用例  const order = await request    .post('/test-api/orders', {      data: { status: 'DELIVERED', deliveredDaysAgo: 8, amount: 199.0 },    })    .then(r => r.json());
  await page.goto(`/orders/${order.id}`);  await page.getByRole('button', { name: '申请退款' }).click();
  // 业务断言:提示语只是表象,关键是"没有生成退款单"  await expect(page.getByText('已超过退款期限')).toBeVisible();  const refunds = await request    .get(`/test-api/orders/${order.id}/refunds`)    .then(r => r.json());  expect(refunds).toHaveLength(0);});
步骤④:为什么需要"断言校验"
AI 第一版生成的脚本,最后两行很可能只有第一个 expect,也就是只看提示语。这样的脚本有一个致命问题:如果后端 bug 导致"提示语出来了,但退款单其实已经创建",它依然是绿的。
所以在执行之前加一道自动关卡,规则很朴素:
-
每个测试至少包含一个业务状态断言(查接口、查数据库、查订单状态),不能只断言元素可见或文案。
-
每个测试必须带追踪编号,没有编号的直接拒收。
-
禁止
expect(true)、空的try/catch吞异常、waitForTimeout后无断言等已知的"假测试"写法。
前两条可以用简单的静态检查(正则或 AST)实现,第三条同理。这些检查本身不需要 AI,恰恰因为它们不需要 AI,才可靠。
再往上还有一道更硬的关卡:缺陷注入。在测试环境里故意把后端的期限从 7 改成 8,重新跑一遍 R-01 相关脚本。如果没有任何一个测试变红,说明这组测试根本没在守护这条规则,退回重新生成。这个思路就是变异测试的简化版:不问"测试通过了吗",问"如果代码错了,测试会发现吗"。
五、案例二:需求变更,只重跑该重跑的
同样是构造的演示场景。
回到开头那个周五下午。需求变成:"普通用户 7 天,会员 15 天。"
传统做法是人肉搜索、逐个修改。在这套流程里,顺序是这样的:
-
把新版需求丢进结构化步骤,AI 对比新旧两版规则清单,输出差异:R-01 被拆成 R-01a(普通用户 7 天)和 R-01b(会员 15 天),新增了一个待确认项:"会员在退款期内降级,按哪个期限算?"
-
通过追踪编号,直接定位到受影响的场景和脚本:所有标注了 R-01 的文件,其余不动。
-
重新生成受影响的部分,人工审核点 B 只需要看这几个场景的 diff。
-
结果报告里,R-01a、R-01b 的状态一目了然,未受影响的规则保持原状。
这里起作用的不是 AI 有多聪明,而是追踪编号让"变更影响面"从一个靠经验的猜测,变成一次可查询的结果。AI 只是把"拆规则、写场景、写脚本"这些重复劳动做掉了。
六、落地时的几个坑和边界
需求文档质量决定上限。 需求写得含糊,AI 会把含糊原样放大。好消息是,步骤①里的"待确认"清单本身就是一份需求质量报告,很多团队第一次跑这套流程,最大的收获反而是发现需求文档有多少歧义。
**它适合规则清晰的业务逻辑,不适合探索性测试。**校验规则、状态流转、权限、计算类逻辑效果好。涉及视觉、交互体验、复杂时序的场景,仍然要人来判断。这套流程覆盖的是"确定性验证",不是"发现未知问题"。
造数是最大的工程量。 脚本里那个 /test-api/orders造数接口,需要你的系统真的提供。没有稳定的造数手段,AI 生成的脚本只能沿着 UI 一步步点过去,脆弱且慢。在投入 AI 之前,先评估你的测试环境是否支持可控造数,这往往比选哪个模型重要。
测试环境的数据隔离要先做好。 让 AI 自动执行意味着脚本会被频繁运行,如果共用一套数据,互相污染的问题会被放大。
**人工审核不能形式化。**如果审核点变成"点一下通过",整套机制就退化成了"AI 自己给自己打分"。建议在结果报告里保留审核人和被驳回的场景记录,驳回率本身就是很好的反馈信号:驳回很多,说明提示词或需求质量有问题。
七、怎么开始:一个模块,一周
不建议一上来就全量铺开。可以这样试:
-
挑一个规则清晰、造数容易的模块,比如订单状态、优惠计算、权限校验,规则控制在 20 条左右。
-
先只做前三步:结构化、审核点 A、场景生成。哪怕脚本还是手写,先把"规则编号---场景"的追踪关系建立起来,这一步单独就有价值。
-
再接入脚本生成和两道自动关卡,最后才是全流程执行。
-
拿它跑一次真实的需求变更,看影响面定位准不准、重跑耗时和你原来的做法比差多少。用你自己团队的真实耗时数据做判断,不要依赖别人的数字。
八、写在最后
回到"不写测试用例"这个说法。真正被替代的,是把需求翻译成用例、再把用例翻译成脚本这两次机械的"翻译"。而需求有没有说清楚、哪些场景值得测、绿灯到底可不可信,这些判断没有被替代,反而因为流程被显式化,变得更容易被看见、被追问。测试工程师的价值,从来不在敲了多少条用例,而在于对"这个系统到底对不对"有没有一个可靠的判断。工具可以变,这一点不会变。