本文是「Spring Boot + AI 全栈后端」系列第 11 篇。前面 10 篇把"能不能做"讲透了,这一篇讲最扎心的一句:本地能跑,不等于上线不挂。AI 接口比普通接口更娇气------贵、慢、还看第三方脸色。示例基于 Spring AI 2.0 / Boot 4.1。
Spring Boot 把 AI 接口真正上线扛量:限流 / 降级 / 可观测
一、为什么 AI 接口特别容易"上线即事故"
见过太多场景:本地 curl 一下,回答漂亮;一上线,流量进来,三件事同时炸------
- 被刷:有人写了个脚本循环调你接口,模型按 token 计费,一晚上烧掉半个月预算。
- 被慢:模型本身 P99 两秒,并发一高,线程池占满,连带把同进程里的普通接口也拖死。
- 黑盒:挂了不知道挂哪,靠用户投诉才发现,复盘时连"失败了多少次"都说不清。
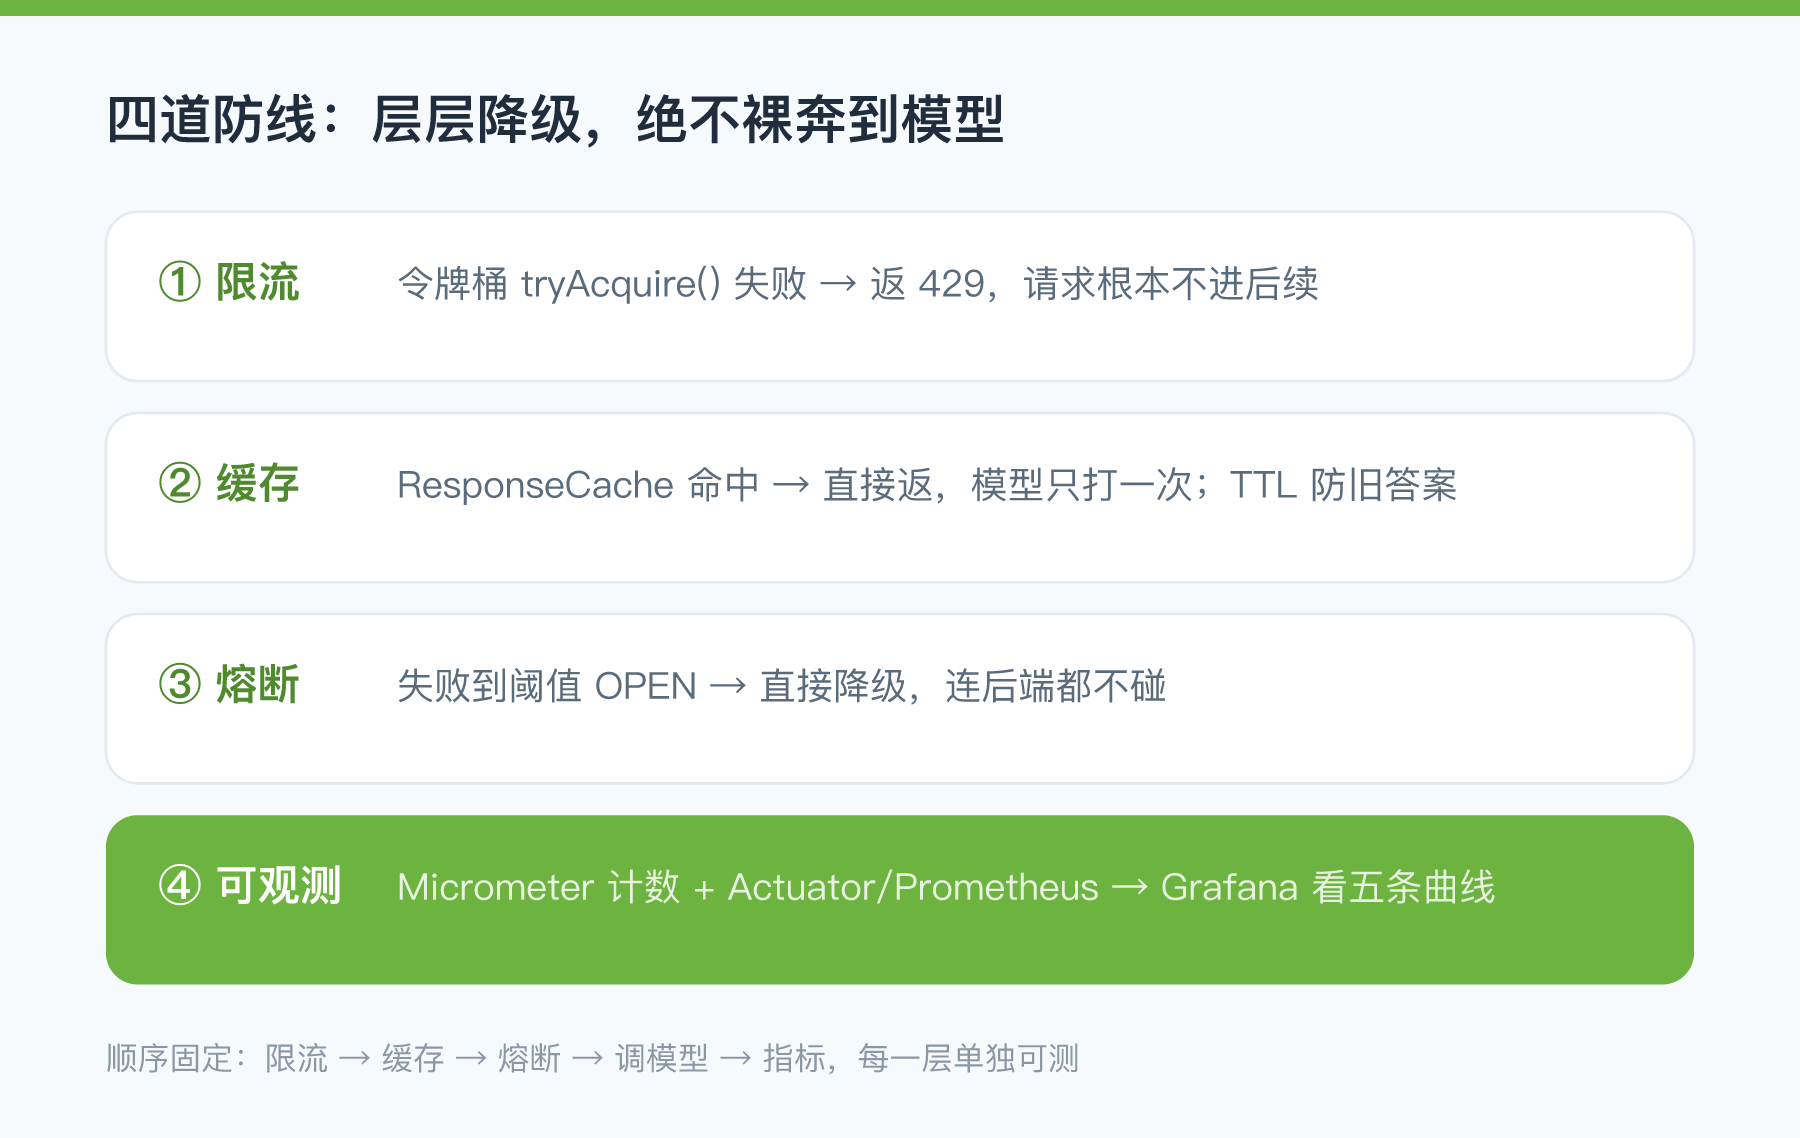
普通 CRUD 接口加个索引、加台机器就能扛;AI 接口的瓶颈在"它身后那个按量付费、还可能限流的模型服务"。所以 V哥给 AI 接口上了四道防线,层层降级,绝不裸奔。
二、第一道:限流,先把刷子挡在门外
限流的意义很简单:单实例扛多少 QPS,明明白白写死,超了直接 429,让客户端退避重试。别让超额请求打到模型------那是最贵的一环。
用令牌桶实现,原子操作避免高并发超卖:
java
public boolean tryAcquire() {
    refill();                       // 先看时间补桶
    long current;
    do {
        current = tokens.get();
        if (current <= 0) return false;   // 桶空了,拒绝
    } while (!tokens.compareAndSet(current, current - 1));
    return true;
}
接口层把"桶空"翻译成 429,前端收到后能退避而不是无脑重发:
java
if (!limiter.tryAcquire()) {
    metrics.rateLimited();
    throw new RateLimitedException("请求过于频繁,请稍后重试");
}
多实例部署时单机令牌桶不够用,要换 Redis + Lua 令牌桶,但算法骨架一模一样,这里先用内存版把逻辑跑通。
三、第二道:缓存,别让同一个问题被问一万次
"你们退货政策是什么"这种高频问题,一天能被问几千次。每次都调模型,既烧钱又慢。加一层带 TTL 的响应缓存,相同问题直接返缓存。
java
public String get(String key) {
    Entry e = store.get(key);
    if (e == null) return null;
    if (nowNanos.getAsLong() > e.expireAt()) {   // TTL 过期
        store.remove(key);
        return null;
    }
    return e.value;
}
关键是 TTL 必须带 ------政策会变,不能把旧答案缓存到天荒地老。V哥把 nowNanos 做成可注入,离线测试里手动拨时间,不用真睡几秒就能验过期。
四、第三道:熔断,后端真挂了别让它被活活打死
限流管"请求太多",熔断管"后端已挂"。模型服务抽风时,如果你还拼命重试,等于往一个已经倒地的同伴身上踩。熔断器的逻辑:连续失败到阈值就 OPEN,OPEN 期间所有请求直接走降级,连后端都不碰;冷却后才给一次复活机会。
java
public <T> T run(Supplier<T> call, Supplier<T> fallback) {
    if (state == OPEN && 未过冷却期) return fallback.get();  // 开门期,直接降级
    try {
        T r = call.get();
        failures.set(0);          // 一次成功清零,避免历史失败一直压着
        return r;
    } catch (Exception ex) {
        if (failures.incrementAndGet() >= threshold) { state = OPEN; openedAt = now; }
        return fallback.get();     // 失败也走降级,给前端一个能展示的底线答案
    }
}
降级不是失败,是"我用一条兜底文案告诉用户稍后再试",比抛 500 体面得多。一次成功就把失败计数清零这个细节很重要,否则"历史上失败过"会一直压着开关,明明后端好了还放不开。
五、第四道:可观测,出了问题你得看得见
前三道是"防",这一道是"看"。AI 接口最怕黑盒------成功率掉了、降级多了、被限流了,你却要等用户投诉才知道。用 Micrometer 计数器把这几个数全埋上:
java
public void request()  { registry.counter("ai.requests").increment(); }
public void success()  { registry.counter("ai.success").increment(); }
public void error()    { registry.counter("ai.error").increment(); }
public void fallback() { registry.counter("ai.fallback").increment(); }
public void cacheHit() { registry.counter("ai.cache.hit").increment(); }
public void rateLimited() { registry.counter("ai.rate.limited").increment(); }
接上 Spring Boot Actuator 的 /actuator/prometheus,再配 OpenTelemetry 导出,Grafana 里就能看"请求量、成功率、降级率、缓存命中率、被限流次数"五条曲线。本地能跑和上线不挂之间,差的就是"出问题你看得见、调得动"。
六、四道防线的顺序,是踩坑踩出来的
把这四层串进一个 ProductionAiService,顺序是固定的,不能乱:
请求 → 1.限流(挡刷子) → 2.缓存(省重复) → 3.熔断(护后端) → 4.调模型 → 指标先限流,超量的根本不进后续;再缓存,高频命中直接返回;再熔断,后端挂了不硬刚;最后才真正打模型。每一层都单独可测、互不耦合------这正是 V哥写代码的原则:拆得开才能验得准。离线验证里,我用一个桩把模型替掉,分别断言:桶空返回 429、缓存命中后模型只被打一次、后端失败后走降级且指标 +1。
七、一个真实翻车现场:重试把后端踩死了
讲个真事。有个团队上线 AI 客服,没熔断,只加了"失败重试三次"。某天模型服务抖动,RT 从 2 秒飙到 20 秒,超时触发重试------重试又超时、又重试。结果:每一次用户请求在后端裂变成 3 次慢调用,线程池 30 秒占满,不但 AI 接口挂了,同进程的健康检查、订单查询全被拖死,整站雪崩。
根因就一句话:重试是"赌它能好",熔断是"确认它没好就先撤"。重试必须配熔断一起用,否则重试本身就是放大器。V哥的规则是------重试最多 1 次,且只在熔断 CLOSED 态才允许;OPEN 态直接降级,绝不重试。
还有个隐藏坑:熔断 OPEN 后,很多人 forgetting 把"冷却期"设得跟他心跳一样短。设 1 秒,等于后端刚想喘口气又被一脚踩上;设 30 秒,给后端足够的缓冲。V哥默认 30 秒起步。
八、上线前 V哥的自查清单
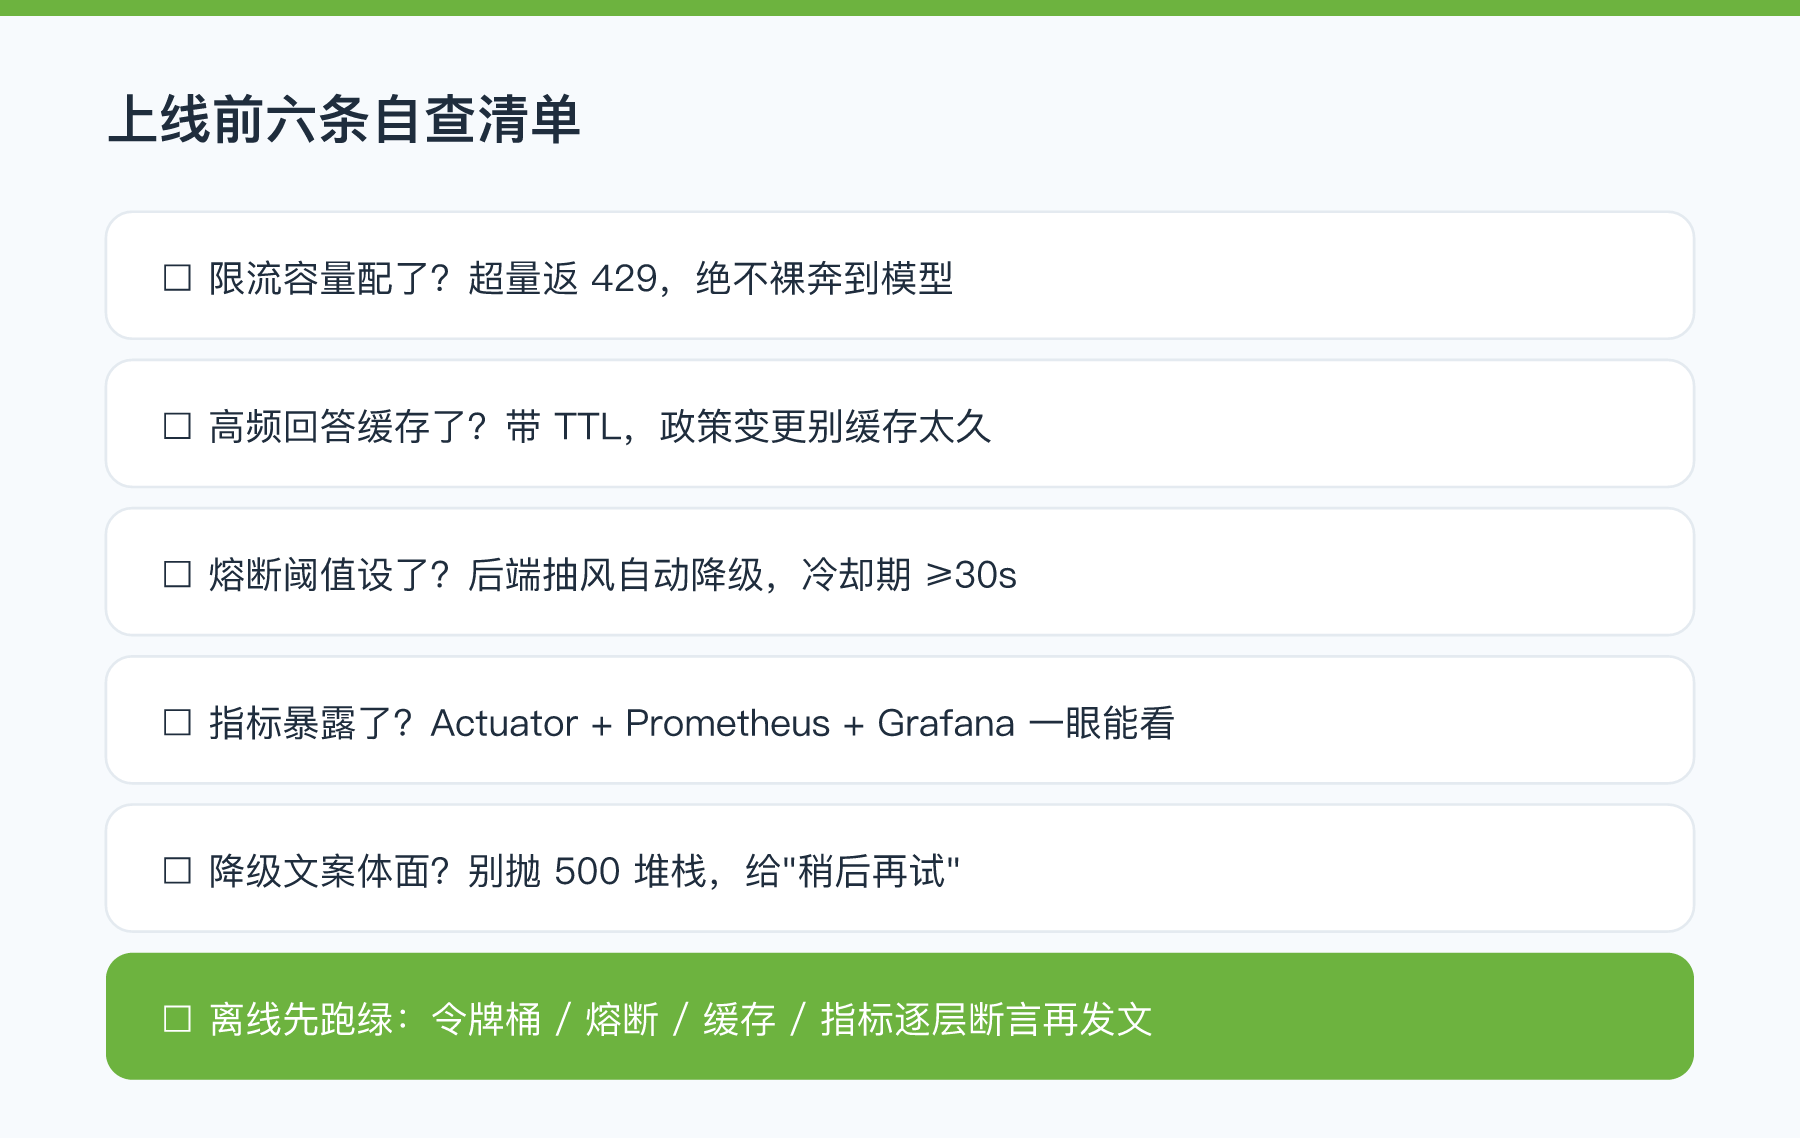
- 限流容量配了吗? 单实例 QPS 写死,超了返 429,绝不裸奔到模型。
- 高频回答缓存了吗? 带 TTL,政策类别缓存太久。
- 熔断阈值设了吗? 后端抽风时自动降级,不把后端打死。
- 指标暴露了吗? Actuator + Prometheus + Grafana,失败率掉了一眼能看到。
- 降级文案体面吗? 不能抛 500 堆栈给用户,给一句"稍后再试"。
- 离线先跑绿:令牌桶、熔断、缓存、指标逐层断言,再写进文章。
九、参数收进配置,别写死在代码里
上一条铁律:能调的参数,绝不写死 。限流容量、熔断阈值、缓存 TTL,都应该跟着环境走------压测环境放宽,生产环境收紧。在 application.yml 里统一收口,再用 @Value 注入:
yaml
ai:
  ratelimit:
    capacity: 200          # 单实例令牌桶容量
    refill-per-second: 200  # 每秒补 200 个令牌
  circuit:
    failure-threshold: 5    # 连续 5 次失败熔断
    cooldown-seconds: 30     # 冷却 30 秒
  cache:
    ttl-minutes: 10          # 答案缓存 10 分钟
ProductionAiService 的构造函数改成读配置,而不是写死 100/5/10:
java
public ProductionAiService(ChatModel chatModel, MeterRegistry registry,
        @Value("${ai.ratelimit.capacity}") long capacity,
        @Value("${ai.ratelimit.refill-per-second}") long refill,
        @Value("${ai.circuit.failure-threshold}") int threshold,
        @Value("${ai.circuit.cooldown-seconds}") long cooldown,
        @Value("${ai.cache.ttl-minutes}") long ttl) {
    this.limiter = new TokenBucketRateLimiter(capacity, Duration.ofSeconds(1), refill);
    this.breaker = new AiCircuitBreaker(threshold, Duration.ofSeconds(cooldown));
    this.cache   = new ResponseCache(Duration.ofMinutes(ttl), System::nanoTime);
    this.metrics = new AiMetrics(registry);
}
这样运维改个 yml 就能调容量,不用改代码重新发版------V哥的经验是,凡是"上线后大概率要调"的旋钮,都从配置里长出来。
十、让指标真正流出去
光有计数器不够,得让它流到监控里。Actuator 默认就把 Micrometer 的计数器暴露成 Prometheus 抓取格式,加一行配置就能用:
yaml
management:
  endpoints:
    web:
      exposure:
        include: health,info,prometheus,metrics
/actuator/prometheus 里就能看到 ai_requests_total、ai_fallback_total 这些序列,Grafana 拖个面板,命中率掉、降级涨、被限流突增,一眼可见。这一步才是"可观测"的闭环------前面埋的计数器,到这里才变成你能盯着的曲线。
四道防线和一份自查清单,把"本地能跑"和"上线不挂"之间的鸿沟填平了。下一篇聊一个更底层的硬活:老项目怎么从 Spring Boot 3.x 迁到 4.x + AI 2.0------Jakarta 11、Jackson 3、包名漂移,这些破坏性变更怎么一步步稳过。