目录
[一、为什么有了 Message,还需要给 TCP 规定消息格式?](#一、为什么有了 Message,还需要给 TCP 规定消息格式?)
[1.1 一个 RpcRequest 不等于一段可以直接发送的网络数据](#1.1 一个 RpcRequest 不等于一段可以直接发送的网络数据)
[1.2 一次网络回调不等于一条消息](#1.2 一次网络回调不等于一条消息)
[1.3 项目使用的 LV 报文:Length + Value](#1.3 项目使用的 LV 报文:Length + Value)
[二、先把 Muduo Buffer 接入项目自己的抽象层](#二、先把 Muduo Buffer 接入项目自己的抽象层)
[2.1 为什么已经有 muduo::net::Buffer,还需要 BaseBuffer?](#2.1 为什么已经有 muduo::net::Buffer,还需要 BaseBuffer?)
[2.2 MuduoBuffer:包装现有 Buffer,不复制整份数据](#2.2 MuduoBuffer:包装现有 Buffer,不复制整份数据)
[2.3 一个容易忽略的生命周期问题](#2.3 一个容易忽略的生命周期问题)
[2.4 BufferFactory:统一对象创建入口](#2.4 BufferFactory:统一对象创建入口)
三、LVProtocol::canProcessed():先判断能不能处理
[3.1 连 4 字节长度字段都没有,就先等](#3.1 连 4 字节长度字段都没有,就先等)
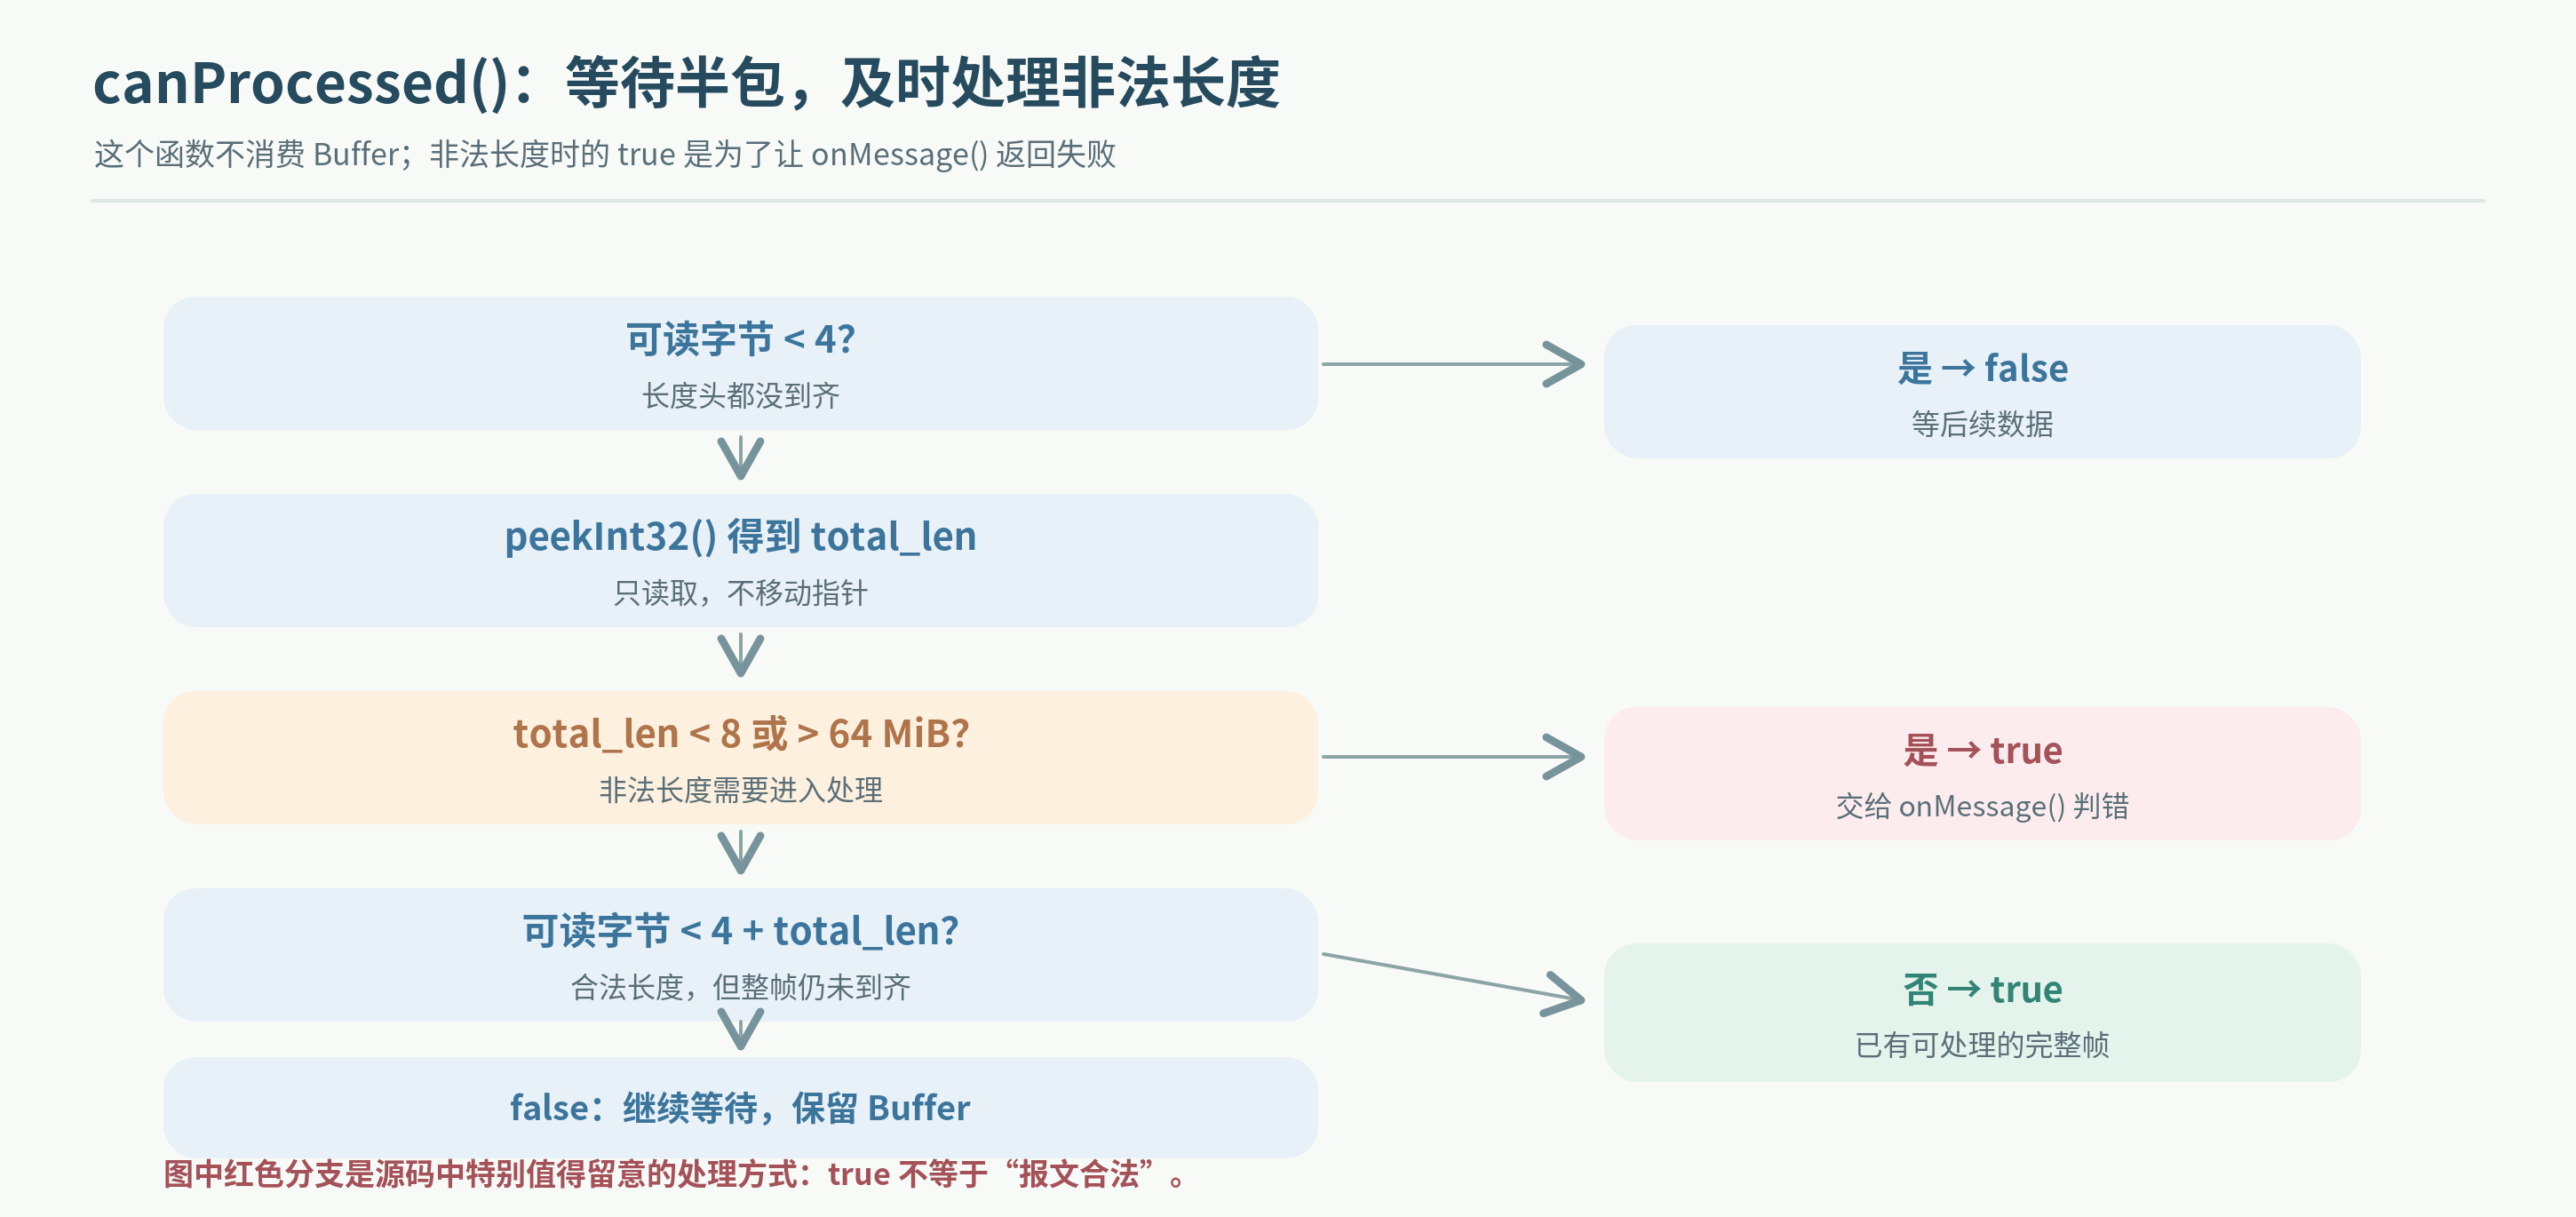
[3.2 最新实现还会先判断长度是否合法](#3.2 最新实现还会先判断长度是否合法)
[3.3 长度合法,还要再判断这一帧是否真正到齐](#3.3 长度合法,还要再判断这一帧是否真正到齐)
四、LVProtocol::onMessage():把一条报文还原成消息对象
[4.1 先消费固定头部,再验证字段](#4.1 先消费固定头部,再验证字段)
[4.2 为什么必须验证 idlen?](#4.2 为什么必须验证 idlen?)
[4.3 再读取变长 ID 和 JSON Body](#4.3 再读取变长 ID 和 JSON Body)
[4.4 MessageFactory 终于在网络接收路径中用起来了](#4.4 MessageFactory 终于在网络接收路径中用起来了)
[4.5 反序列化成功,不代表业务消息一定合法](#4.5 反序列化成功,不代表业务消息一定合法)
[五、发送方向:serialize() 怎样组装完整的 LV 报文?](#五、发送方向:serialize() 怎样组装完整的 LV 报文?)
[5.1 先拿到正文和公共字段](#5.1 先拿到正文和公共字段)
[5.2 为什么整数需要 htonl()?](#5.2 为什么整数需要 htonl()?)
[5.3 total_len 怎样计算?为什么要 reserve()?](#5.3 total_len 怎样计算?为什么要 reserve()?)
[5.4 按既定顺序追加字段](#5.4 按既定顺序追加字段)
[6.1 半包:一条消息还没收齐](#6.1 半包:一条消息还没收齐)
[6.2 粘包:Buffer 里有两条完整消息](#6.2 粘包:Buffer 里有两条完整消息)
[6.3 非法帧:为什么不能一直把它当作半包等待?](#6.3 非法帧:为什么不能一直把它当作半包等待?)
七、ProtocolFactory:把前面的抽象和真实协议接起来
[7.1 工厂只负责创建当前真正使用的协议](#7.1 工厂只负责创建当前真正使用的协议)
[7.2 把本篇三块实现重新接起来](#7.2 把本篇三块实现重新接起来)
前言
系列:C++ RPC 框架从设计到实现,第九篇
项目源码:
 https://gitee.com/kuang-zhenting/json-rpc
第七篇已经有了 JsonMessage、RPC / Topic / Service 消息以及 MessageFactory,第八篇又把 detail.hpp 中的 JSON 转换工具和 UUID 请求 ID 补齐了。现在,我们终于可以把注意力从"内存中的消息对象"转向"真正需要在网络上传输的消息"。
例如,一次 RPC 请求在程序里可以表示成一个 RpcRequest:它知道自己是什么消息类型,保存了请求 ID,也保存了方法名和参数。但 TCP 并不会识别 RpcRequest,也不知道 Json::Value 是什么。
TCP 负责传输字节,框架负责解释这些字节属于哪一条消息。
这一篇就解决这个问题。我们先把 Muduo 的接收缓冲区适配到第五篇定义的 BaseBuffer,然后实现 LVProtocol,把"判断一条消息有没有收完整""从字节中恢复消息对象""把消息对象编码成报文"这三件事真正接起来。
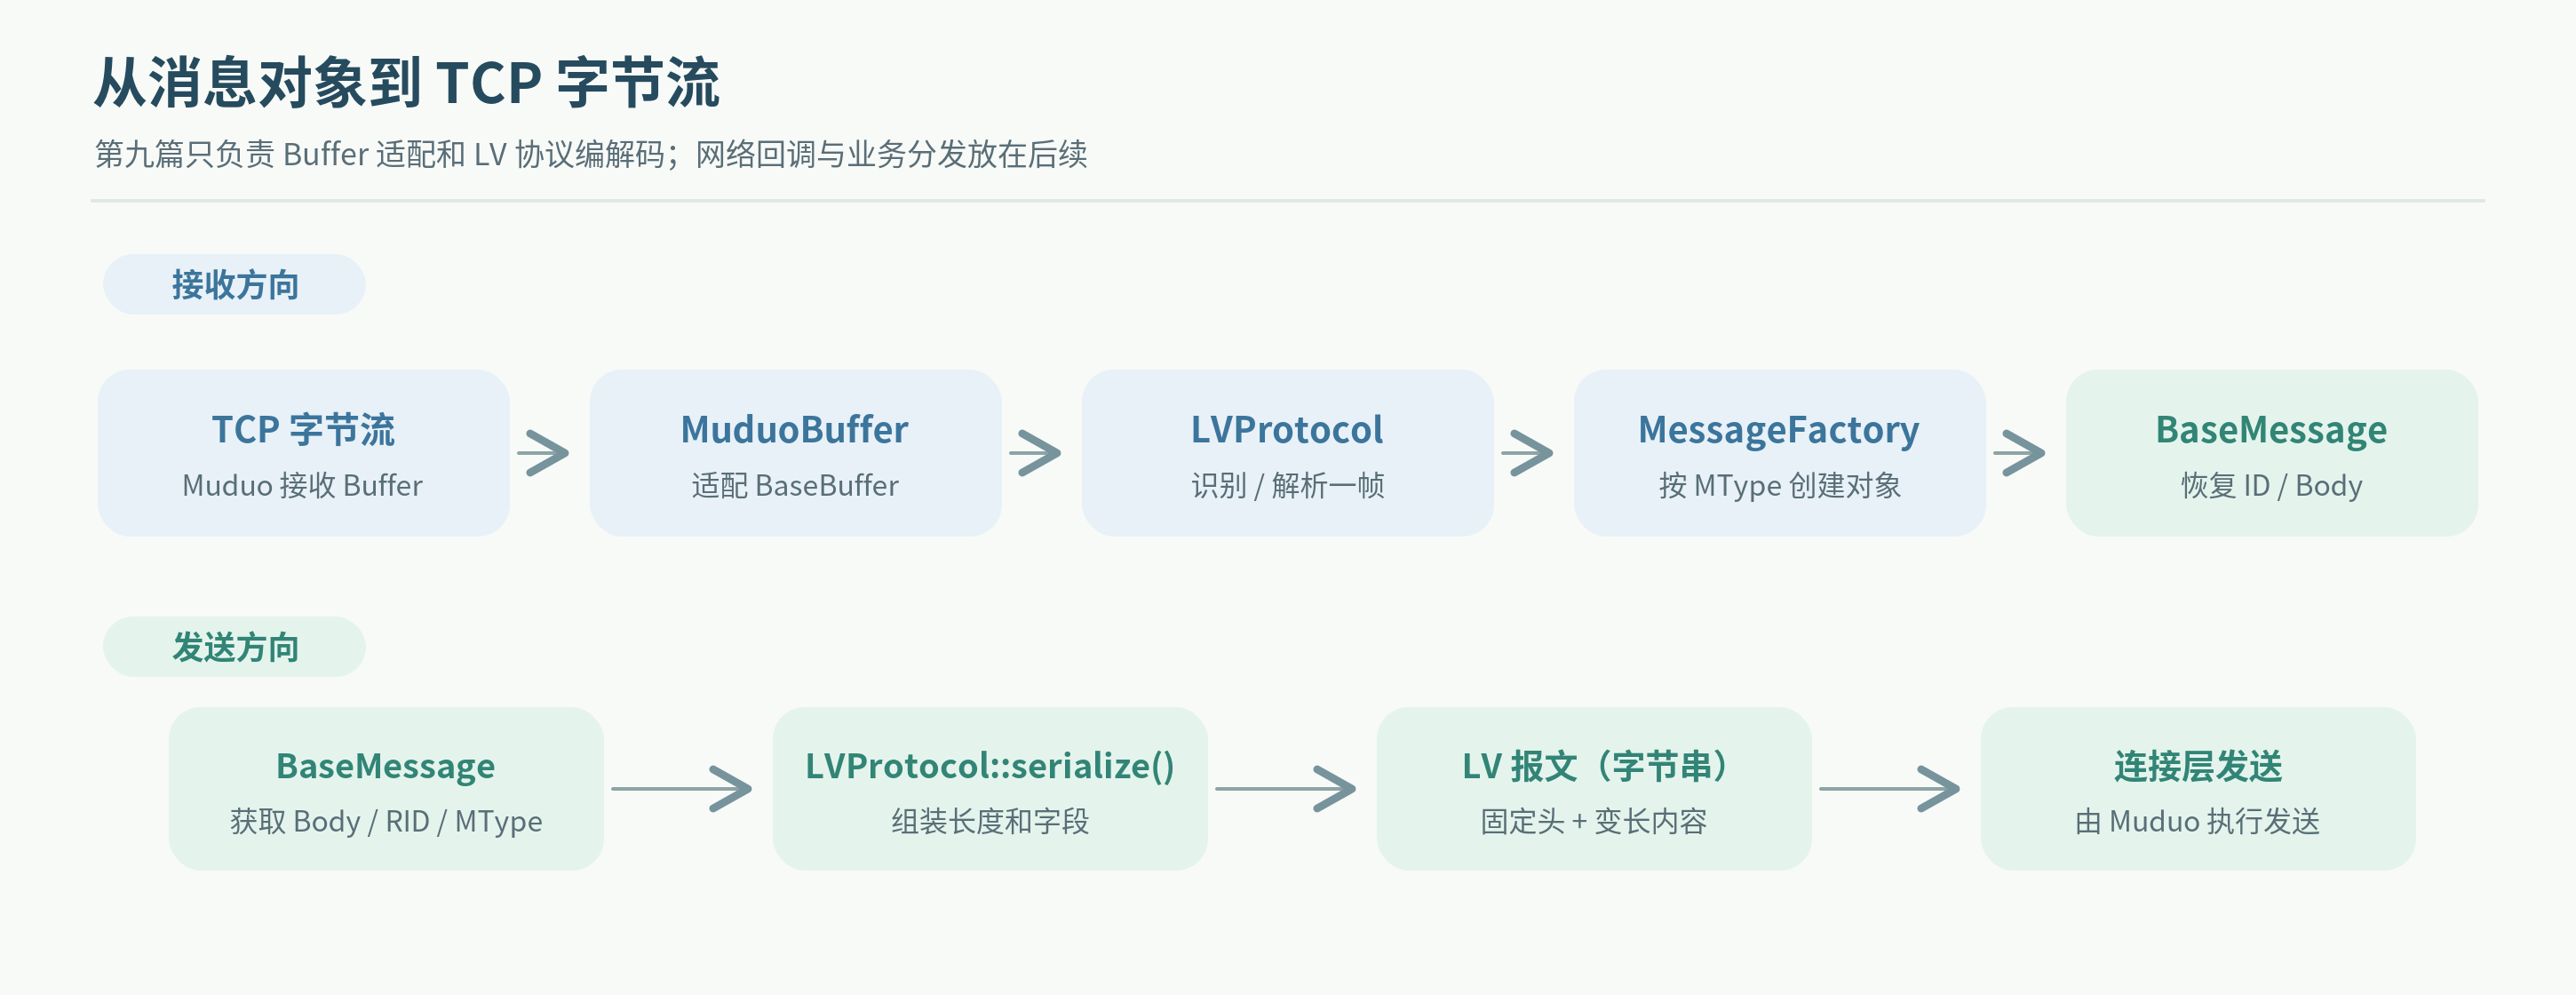
先明确本篇的边界:我们实现的是缓冲区适配和协议编解码 。连接的建立、断开、网络回调以及 Dispatcher 怎样收到完整消息,都留到后面的网络封装与消息分发部分再展开。
一、为什么有了 Message,还需要给 TCP 规定消息格式?
1.1 一个 RpcRequest 不等于一段可以直接发送的网络数据
假设我们要调用一个 Add 方法,并传入两个参数:
cpp
auto req = MessageFactory::create<RpcRequest>();
req->setId(UUID::uuid());
req->setMType(MType::REQ_RPC);
req->setMethod("Add");

Json::Value params;
params["left"] = 11;
params["right"] = 22;
req->setParams(params);
此时业务层已经把一次请求描述完整了。它至少包含三类信息:
| 信息 | 例子 | 保存在哪里 |
|---|---|---|
| 消息类型 | MType::REQ_RPC |
BaseMessage 的公共信息 |
| 请求 ID | rid 字符串 |
BaseMessage 的公共信息 |
| 业务正文 | method、parameters |
JsonMessage 的 JSON Body |
如果直接调用 req->serialize(),得到的只是业务正文对应的 JSON 字符串 。第七篇已经讲过,MType 和 RID 不属于这个 JSON Body,它们由消息对象单独保存。
因此,网络上传输的完整消息不能只有 JSON 正文。接收端还需要知道消息类型、RID,以及最关键的一个信息:
从当前字节开始,到哪里才算一条完整消息?
1.2 一次网络回调不等于一条消息
TCP 是字节流协议。发送端连续写入两条消息,接收端可能分两次、三次收到,也可能在一次回调中同时看到两条消息。
常见的两种情况是:
-
半包:某一条消息还没有到齐,当前只能读到它的一部分。
-
粘包:当前接收缓冲区里同时包含多条消息,甚至还跟着下一条消息的开头。
这里说的"半包、粘包",是从应用层消息边界的角度描述现象,并不是 TCP 传错了数据。
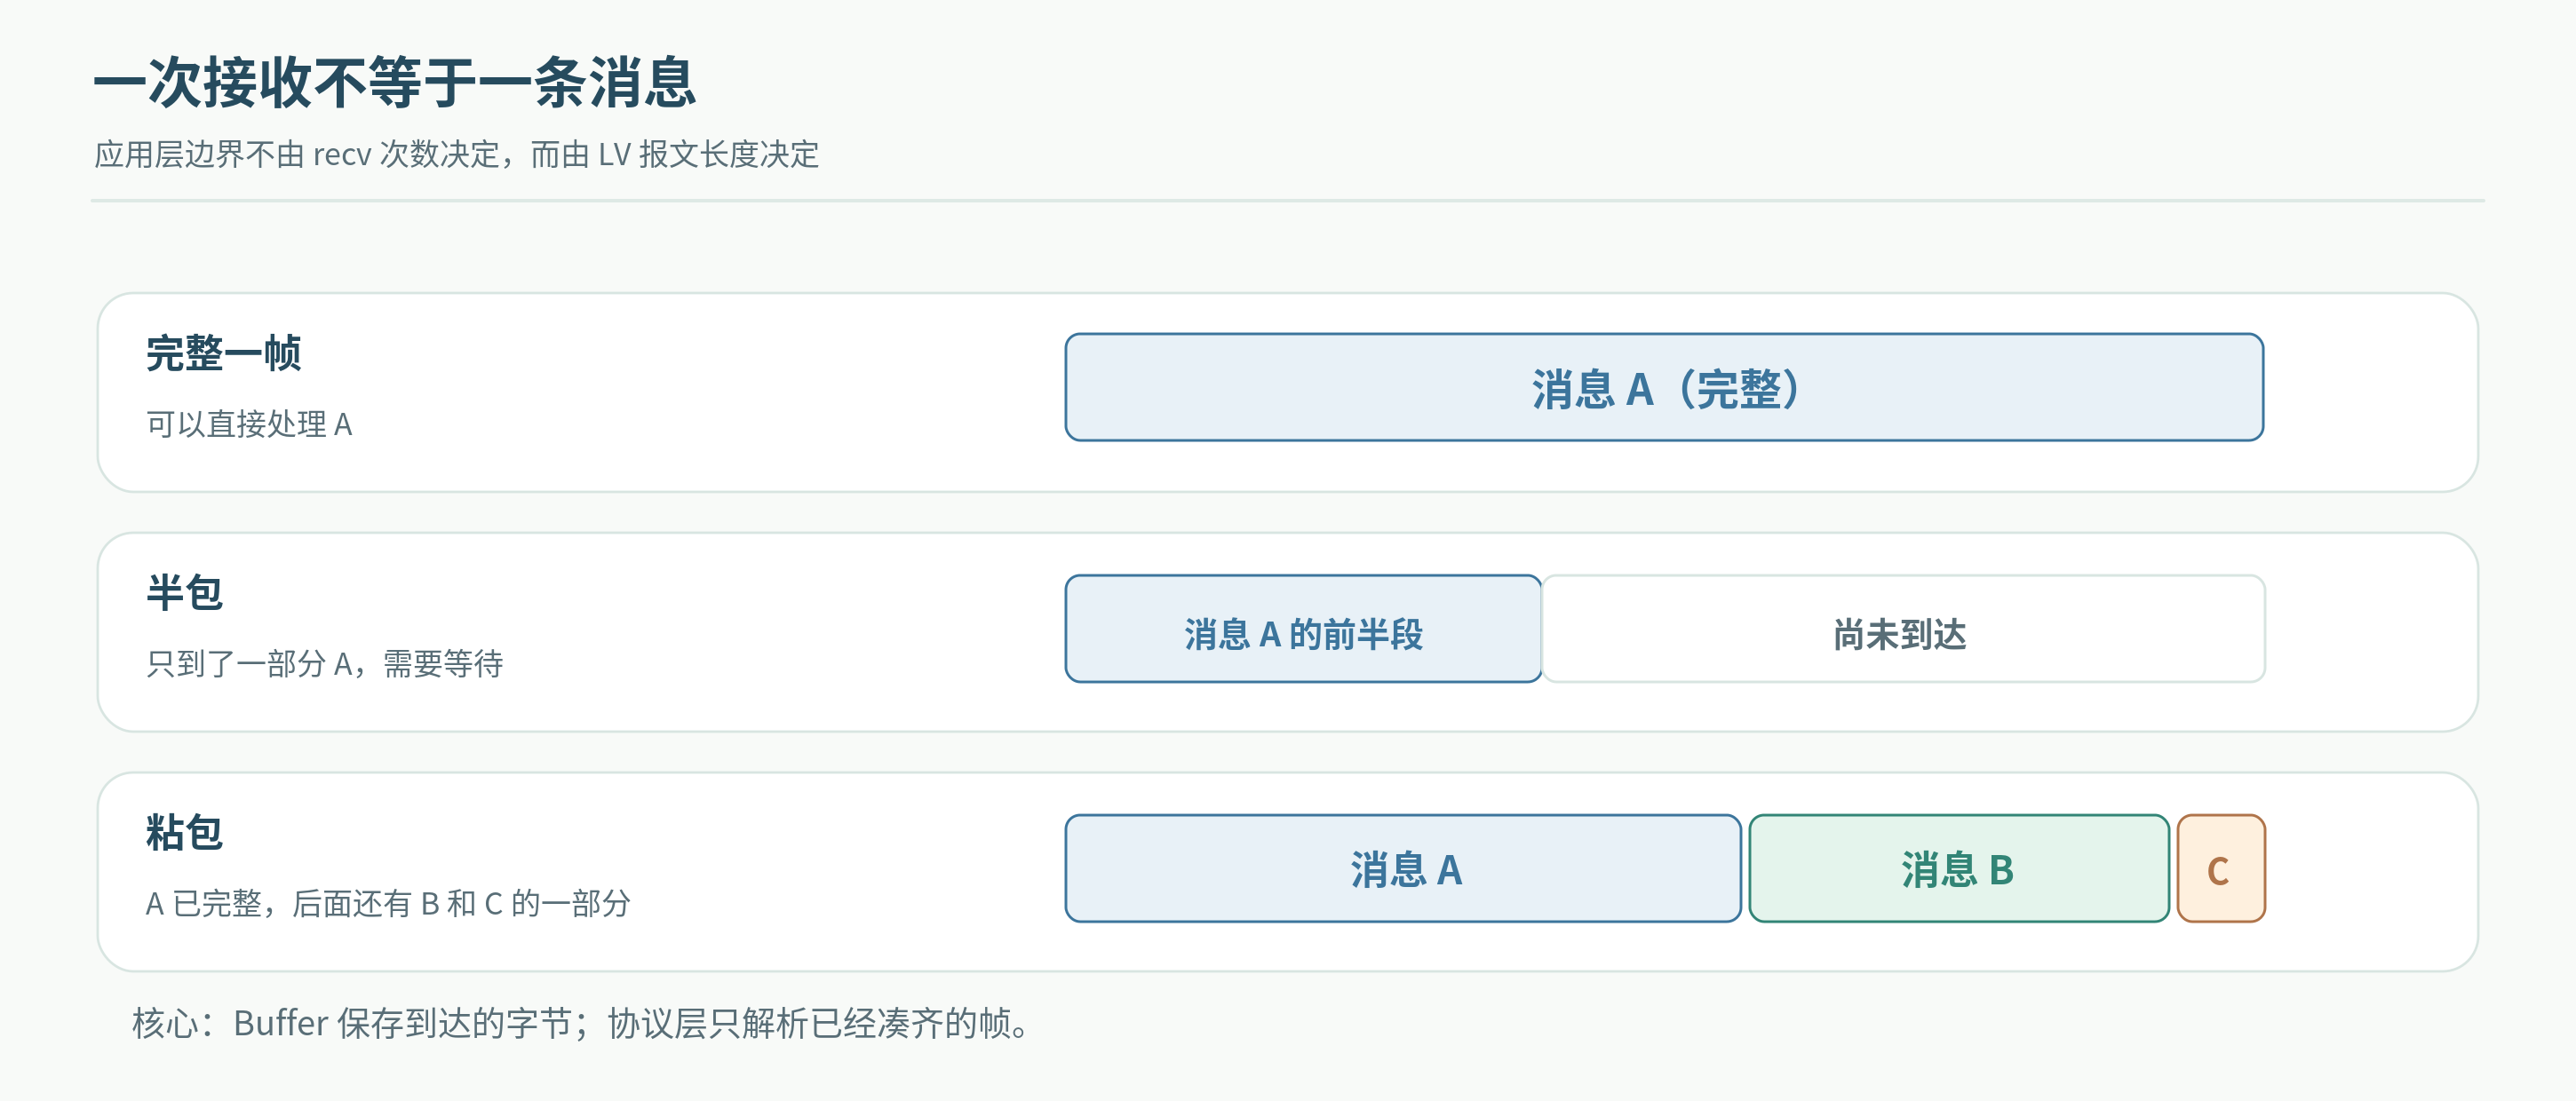
因此不能把这样的代码逻辑当成前提:一次收到数据 = 一条完整的 RPC 消息
协议层真正需要回答的是:
- 现在的 Buffer 有多少字节?
- 最前面那条消息应该有多少字节?
- 数据还没收齐:继续等待,数据已经收齐:解析出一条消息。
1.3 项目使用的 LV 报文:Length + Value
第四篇设计整体框架时,我们已经知道需要一个应用层协议。现在来看项目里真正使用的格式:
cpp
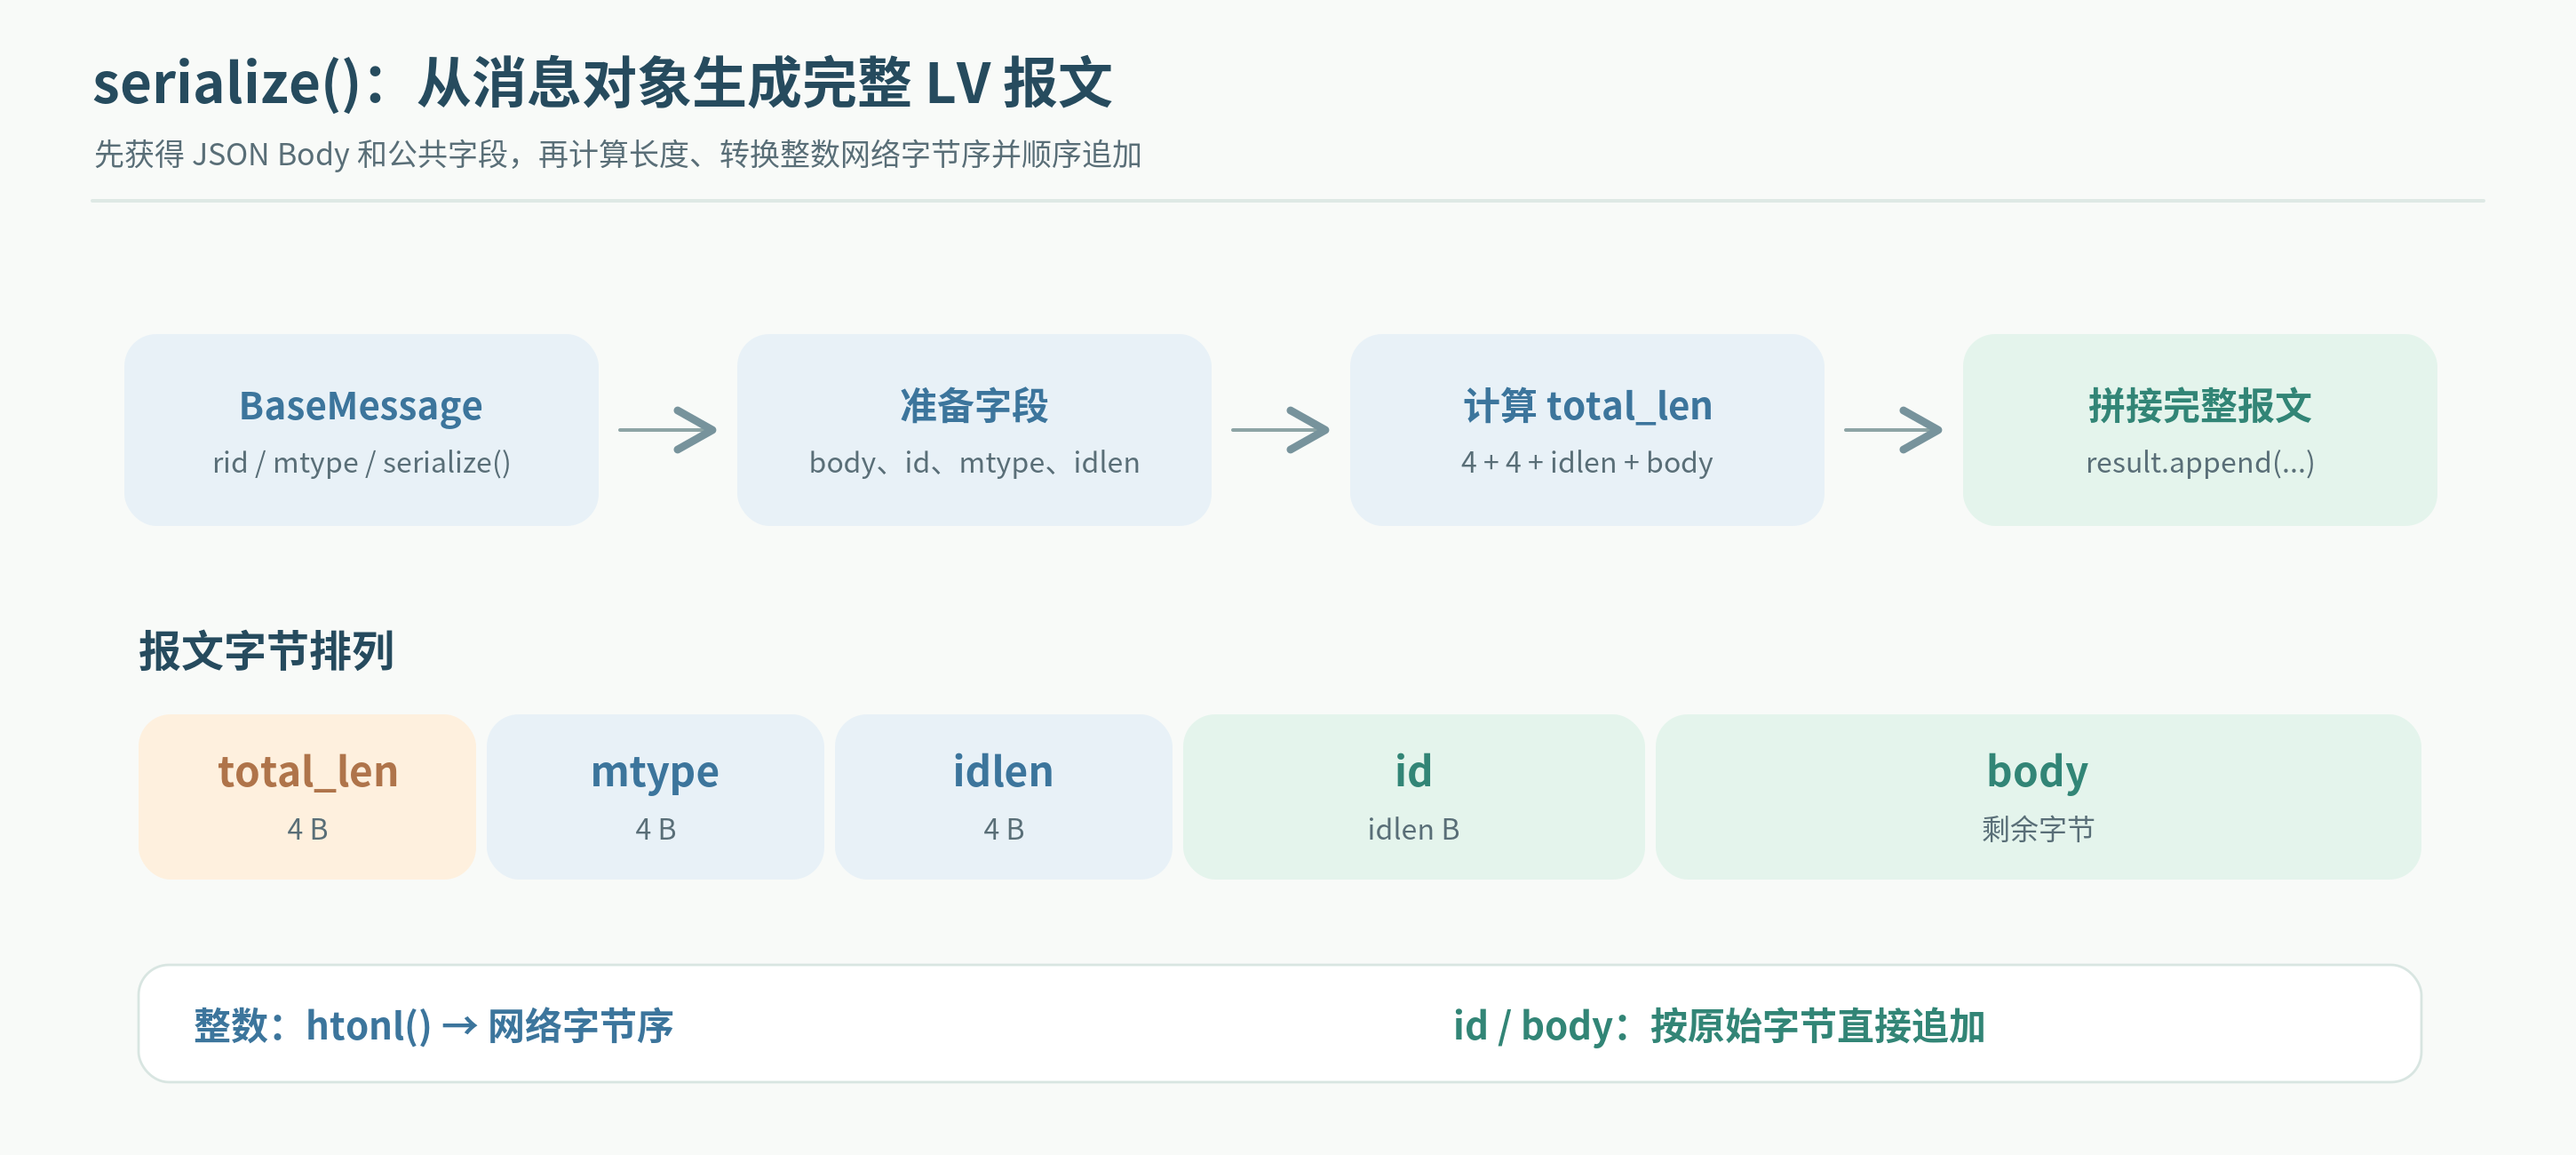
| total_len | mtype | idlen | id | body |其中:
| 字段 | 字节数 | 含义 |
|---|---|---|
total_len |
4 | 后续 Value 部分的长度 |
mtype |
4 | 消息类型,例如 REQ_RPC |
idlen |
4 | 请求 ID 的字节长度 |
id |
idlen |
请求 ID 的字节内容 |
body |
剩余字节 | 消息对象序列化后的 JSON 正文 |
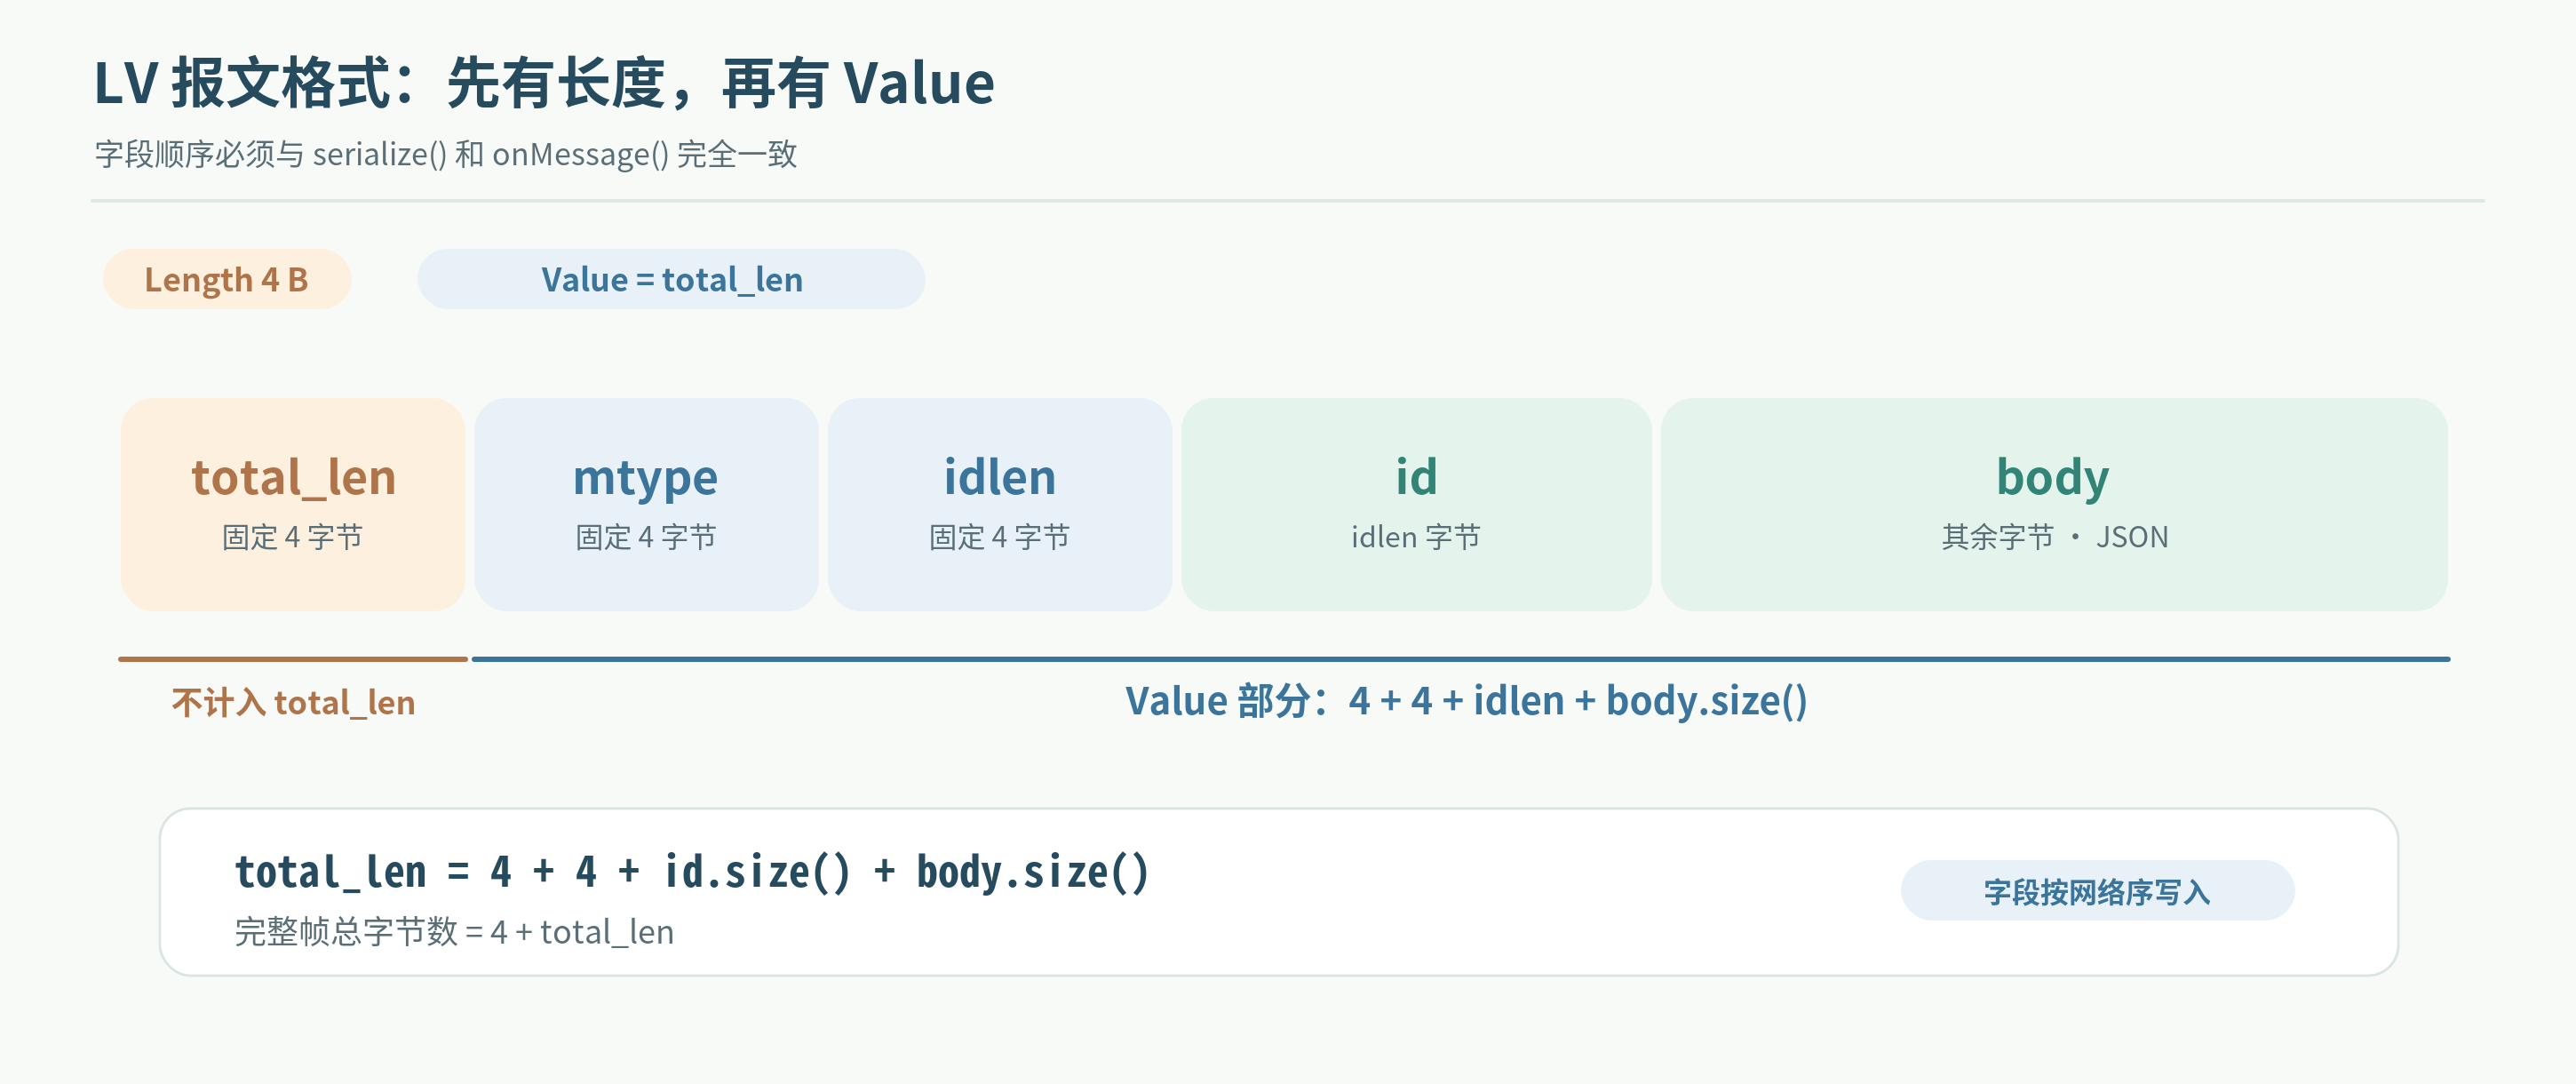
这里有一个后面会反复用到的约定:
\\texttt{total_len}=4+4+\\texttt{id.size()}+\\texttt{body.size()}
也就是说:
total_len 不包括它自己占用的那 4 字节。
因此,一条完整的报文真正占用:
\\texttt{frame_bytes}=4+\\texttt{total_len}
例如,假设请求 ID 占 5 字节,JSON Body 实际编码后占 30 字节,那么:
cpp
mtype     4 字节
idlen     4 字节
id        5 字节
body      30 字节
--------------------
total_len 43 字节

再加最前面 total_len 字段的 4 字节
整条报文  47 字节
这里的 30 字节只是为了演示长度计算,并不代表某段 JSON 的固定长度。真实的 body.size() 要以具体序列化结果为准。
注意:这个协议的 mtype、idlen、total_len 都使用 32 位整数;id 和 body 是按照长度读取的原始字节,不需要靠特殊结束字符来判断边界。
二、先把 Muduo Buffer 接入项目自己的抽象层
2.1 为什么已经有 muduo::net::Buffer,还需要 BaseBuffer?
第五篇我们定义过这样的接口:
cpp
class BaseBuffer {
public:
    using ptr = std::shared_ptr<BaseBuffer>;
    virtual ~BaseBuffer() {}

    virtual size_t readableSize() = 0;
    virtual int32_t peekInt32() = 0;
    virtual void retrieveInt32() = 0;
    virtual int32_t readInt32() = 0;
    virtual std::string retrieveAsString(size_t len) = 0;
};
当时还没有真正处理网络字节,接口看起来比较抽象。现在它们都有实际用途了。
如果直接让协议类接收 muduo::net::Buffer*,当然也能写,但这样 LVProtocol 就会直接依赖具体网络库。项目既然已经定义了 BaseBuffer 和 BaseProtocol,就应该让这一层分工真正成立:
cpp
Muduo 负责保存和管理接收到的字节
    ↓
MuduoBuffer 把接口适配成 BaseBuffer
    ↓
LVProtocol 只依赖 BaseBuffer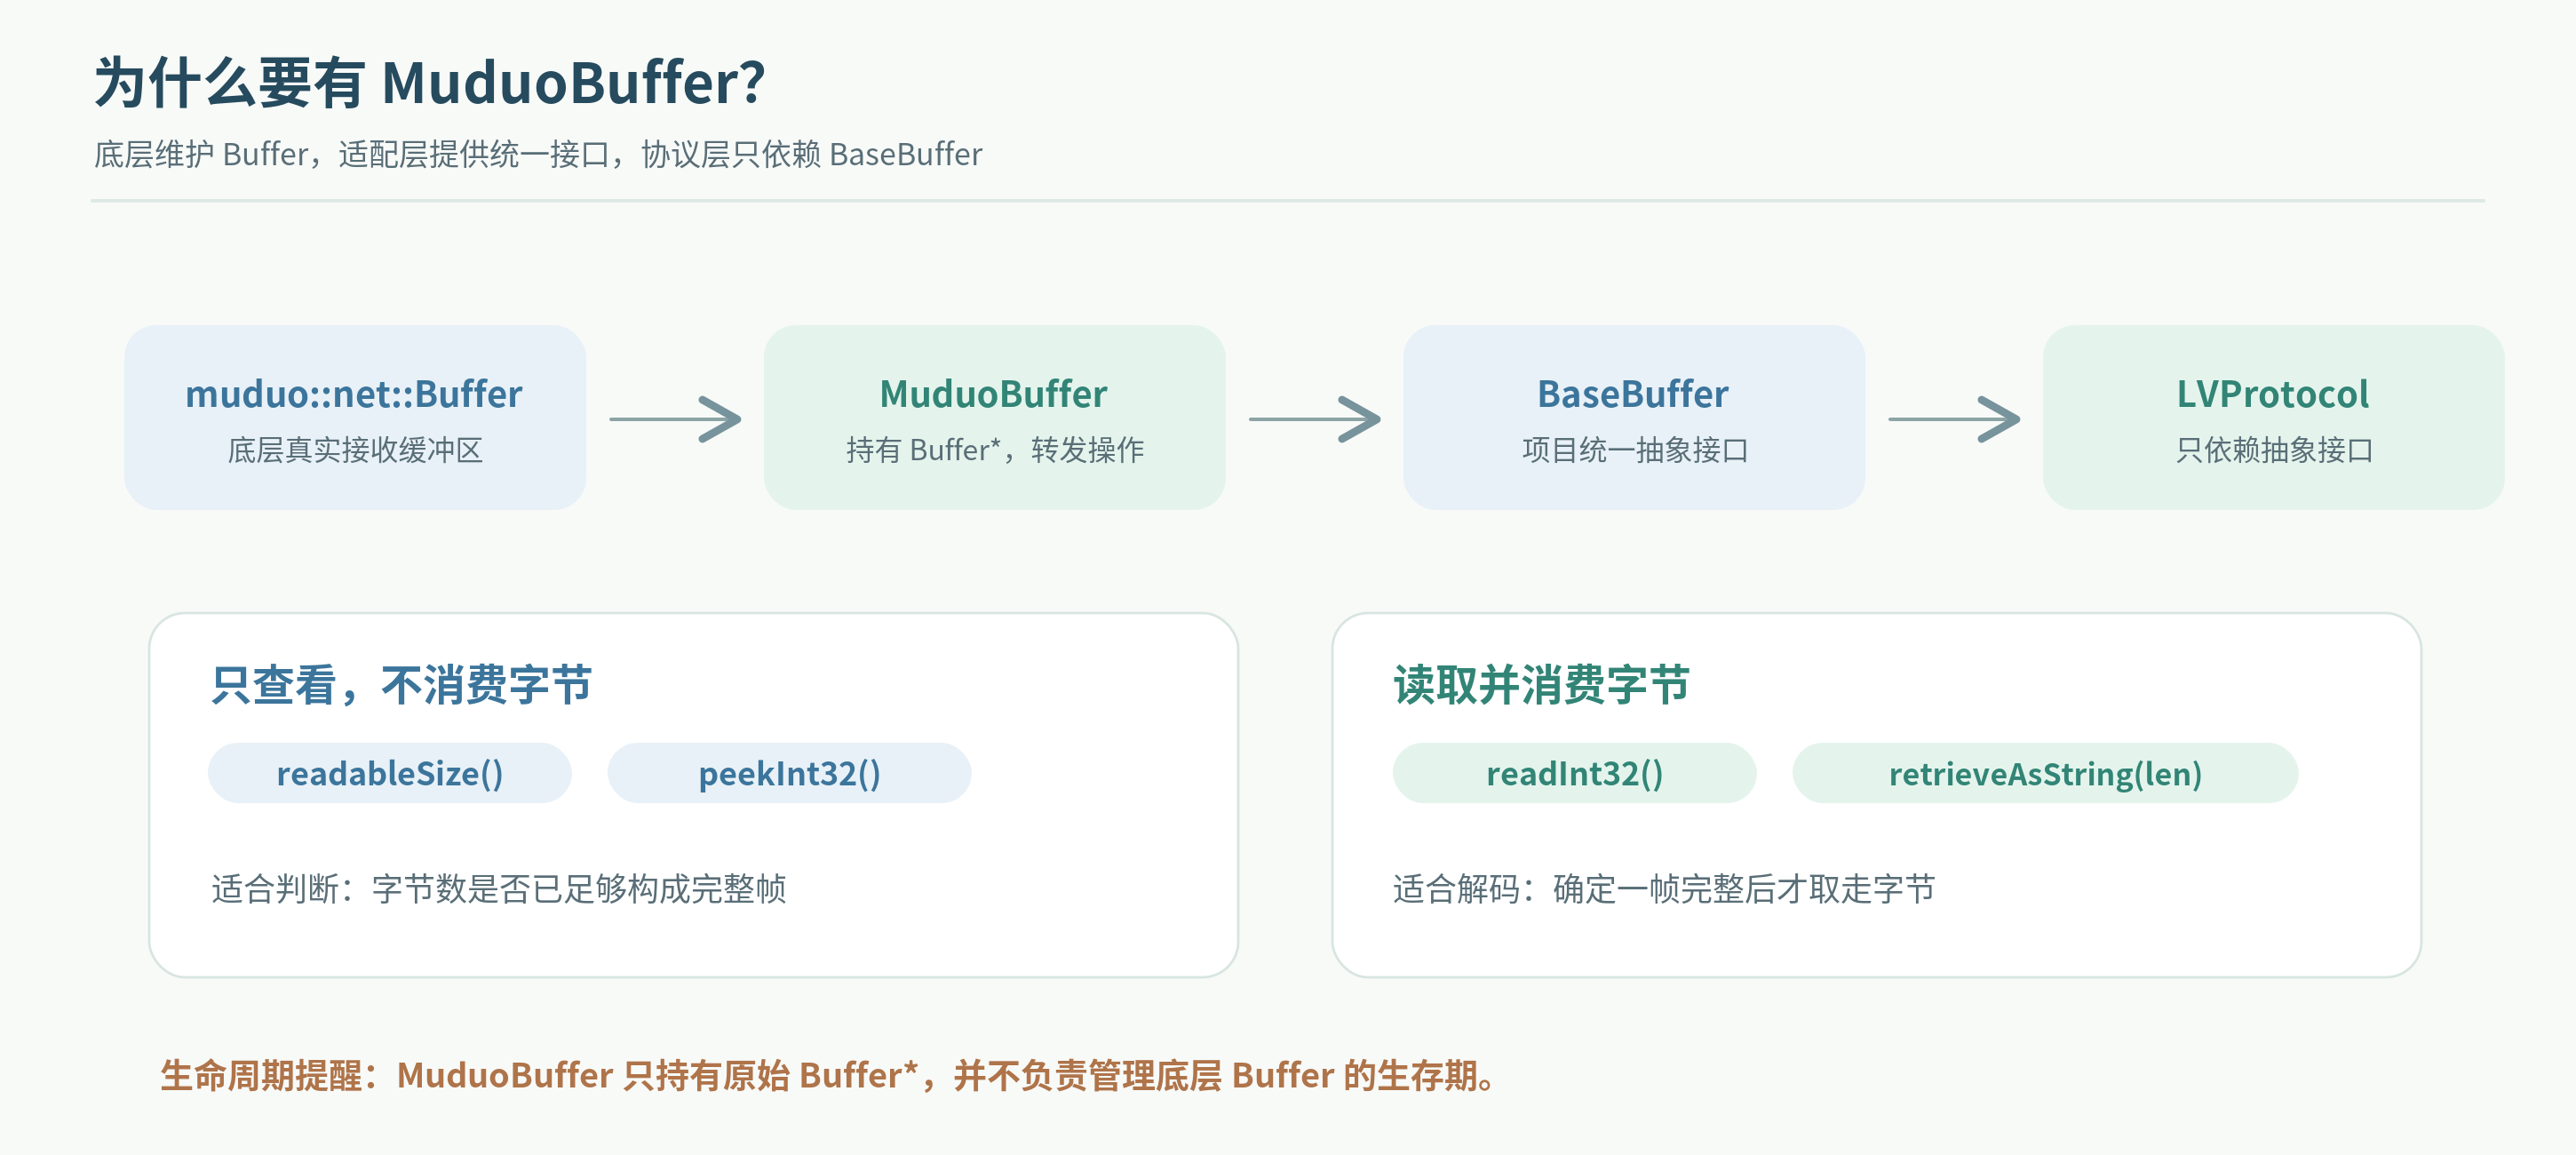
这不是重新写一个缓冲区。我们的 MuduoBuffer 只是把 Muduo 已经提供的几个操作,转换成项目统一的接口形式。
2.2 MuduoBuffer:包装现有 Buffer,不复制整份数据
当前实现位于 source/common/net.hpp,使用的是项目真实的 myrpc 命名空间。
核心代码如下:
cpp
class MuduoBuffer : public BaseBuffer {
public:
    using ptr = std::shared_ptr<MuduoBuffer>;

    MuduoBuffer(muduo::net::Buffer *buf) : _buf(buf) {}

    virtual size_t readableSize() {
        return _buf->readableBytes();
    }

    virtual int32_t peekInt32() {
        return _buf->peekInt32();
    }

    virtual void retrieveInt32() {
        return _buf->retrieveInt32();
    }

    virtual int32_t readInt32() {
        return _buf->readInt32();
    }

    virtual std::string retrieveAsString(size_t len) {
        return _buf->retrieveAsString(len);
    }

private:
    muduo::net::Buffer *_buf;
};
这段代码最重要的不是继承语法,而是区分两类操作。
| 接口 | 作用 | 是否消费字节 |
|---|---|---|
readableSize() |
查询当前可读字节数 | 否 |
peekInt32() |
查看头部一个 4 字节整数 | 否 |
readInt32() |
读取并取走头部一个 4 字节整数 | 是 |
retrieveInt32() |
丢弃头部一个 4 字节整数 | 是 |
retrieveAsString(len) |
取走指定长度的字节并形成字符串 | 是 |
"看一眼"和"真正取走"之间的区别,正是半包处理能否正确的关键。
例如当前 Buffer 只有:
cpp
[total_len = 43][Value 的前 10 字节]整条报文应该有 47 字节,但实际还没到齐。
我们必须先用 peekInt32() 看出长度是 43,同时把整个 Buffer 原封不动地保留下来;否则现在先把长度消费掉,下次更多数据到达时,就不能再从正确位置重新判断这一帧了。
2.3 一个容易忽略的生命周期问题
MuduoBuffer 内部保存的是:
cpp
muduo::net::Buffer *_buf;这是原始指针 。创建 MuduoBuffer 并不会复制底层数据,也不会接管 Muduo Buffer 的所有权。
所以:
MuduoBuffer必须在底层muduo::net::Buffer仍然有效时使用,不能因为外面用shared_ptr<MuduoBuffer>保存,就认为底层_buf的生命周期也自动延长了。
这里的智能指针管理的是适配器对象,不是 Muduo 接收缓冲区本身。
2.4 BufferFactory:统一对象创建入口
当前工厂非常简洁:
cpp
class BufferFactory {
public:
    template <typename... Args>
    static BaseBuffer::ptr create(Args &&...args) {
        return std::make_shared<MuduoBuffer>(
            std::forward<Args>(args)...);
    }
};
网络回调拿到 Muduo 提供的 buf 后,就可以写:
cpp
auto base_buf = BufferFactory::create(buf);上层拿到的类型是 BaseBuffer::ptr。它不需要知道适配器的具体创建过程,后面的协议代码也就可以统一写成:
cpp
bool canProcessed(const BaseBuffer::ptr &buf);
bool onMessage(const BaseBuffer::ptr &buf, BaseMessage::ptr &msg);
这正好让第五篇定义的抽象接口开始发挥作用。
三、LVProtocol::canProcessed():先判断能不能处理
LVProtocol 继承 BaseProtocol,需要实现:
cpp
virtual bool canProcessed(const BaseBuffer::ptr &buf) = 0;

virtual bool onMessage(
    const BaseBuffer::ptr &buf,
    BaseMessage::ptr &msg) = 0;

virtual std::string serialize(
    const BaseMessage::ptr &msg) = 0;
可以先把三个接口记成一句话:
-
canProcessed():先观察接收数据,判断下一步能否进行; -
onMessage():真正从 Buffer 中消费一条报文,还原消息对象; -
serialize():反方向把消息对象编码成报文。
3.1 连 4 字节长度字段都没有,就先等
cpp
if (buf->readableSize() < lenFieldsLength) {
    return false;
}
lenFieldsLength 在本类中是 4。
如果当前只有 1、2、3 字节,协议层根本不知道后续这条消息要占多少字节,所以返回 false。
接着才是:
cpp
int32_t total_len = buf->peekInt32();注意使用的是 peekInt32() ,不是 readInt32()。
因为"数据是否收齐"还没有确定,不能提前移动读指针。
Muduo 的 peekInt32() 已经把网络字节序转换为本机的 int32_t,因此外层不需要再调用一次 ntohl()。
3.2 最新实现还会先判断长度是否合法
当前源码不仅判断数据够不够,还在 canProcessed() 中增加了两条长度护栏:
cpp
const int32_t kMinFrame =
    static_cast<int32_t>(
        mtypeFieldsLength + idlenFieldsLength);

if (total_len < kMinFrame) return true;

if (total_len >
    static_cast<int32_t>(64 * 1024 * 1024)) return true;
为什么最小值是 8?
因为 total_len 统计的是 Value 部分,哪怕 ID 和 Body 都为空,后面也至少需要:
- mtype:4 字节;
- idlen:4 字节;
- 合计: 8 字节。
而 64 × 1024 × 1024 字节,是当前 LVProtocol 给 total_len 设置的上限。
这里还有一个特别容易误解的地方:
非法长度时,
canProcessed()竟然返回true。
这并不表示"非法消息也被认为是完整的"。当前实现选择让后续 onMessage() 真正读取长度字段、记录错误并返回 false,以便调用方进入错误处理,而不是把非法长度当作普通半包一直等待。
因此,准确地说,当前 canProcessed() 的 true 有两种可能:
-
至少有一条长度符合要求、字节也已到齐的报文;
-
已经能够确定长度字段非法,需要立即进入解析失败处理。
这与简单的"true 就代表合法消息"并不一样。
3.3 长度合法,还要再判断这一帧是否真正到齐
cpp
if (buf->readableSize() <
    static_cast<size_t>(total_len) + lenFieldsLength) {
    return false;
}

return true;
这里的判断条件就是:当前可读字节数 是否至少为 4 + total_len
数据不足返回 false,继续等待后续字节;已经足够则返回 true。
注意这里用的是 static_cast<size_t>(total_len)。在此之前,源码已经排除了过小、负数和超上限的长度,才进入这个比较。
把完整逻辑连在一起:
cpp
virtual bool canProcessed(
    const BaseBuffer::ptr &buf) override {

    if (buf->readableSize() < lenFieldsLength) {
        return false;
    }

    int32_t total_len = buf->peekInt32();

    const int32_t kMinFrame =
        static_cast<int32_t>(
            mtypeFieldsLength + idlenFieldsLength);

    if (total_len < kMinFrame) return true;

    if (total_len >
        static_cast<int32_t>(64 * 1024 * 1024)) return true;

    if (buf->readableSize() <
        static_cast<size_t>(total_len) + lenFieldsLength) {
        return false;
    }

    return true;
}
到这里要牢牢记住一件事:
canProcessed()只查看 Buffer,不消费任何字节。
这保证了在半包尚未收齐时,读位置不会被提前破坏。
四、LVProtocol::onMessage():把一条报文还原成消息对象
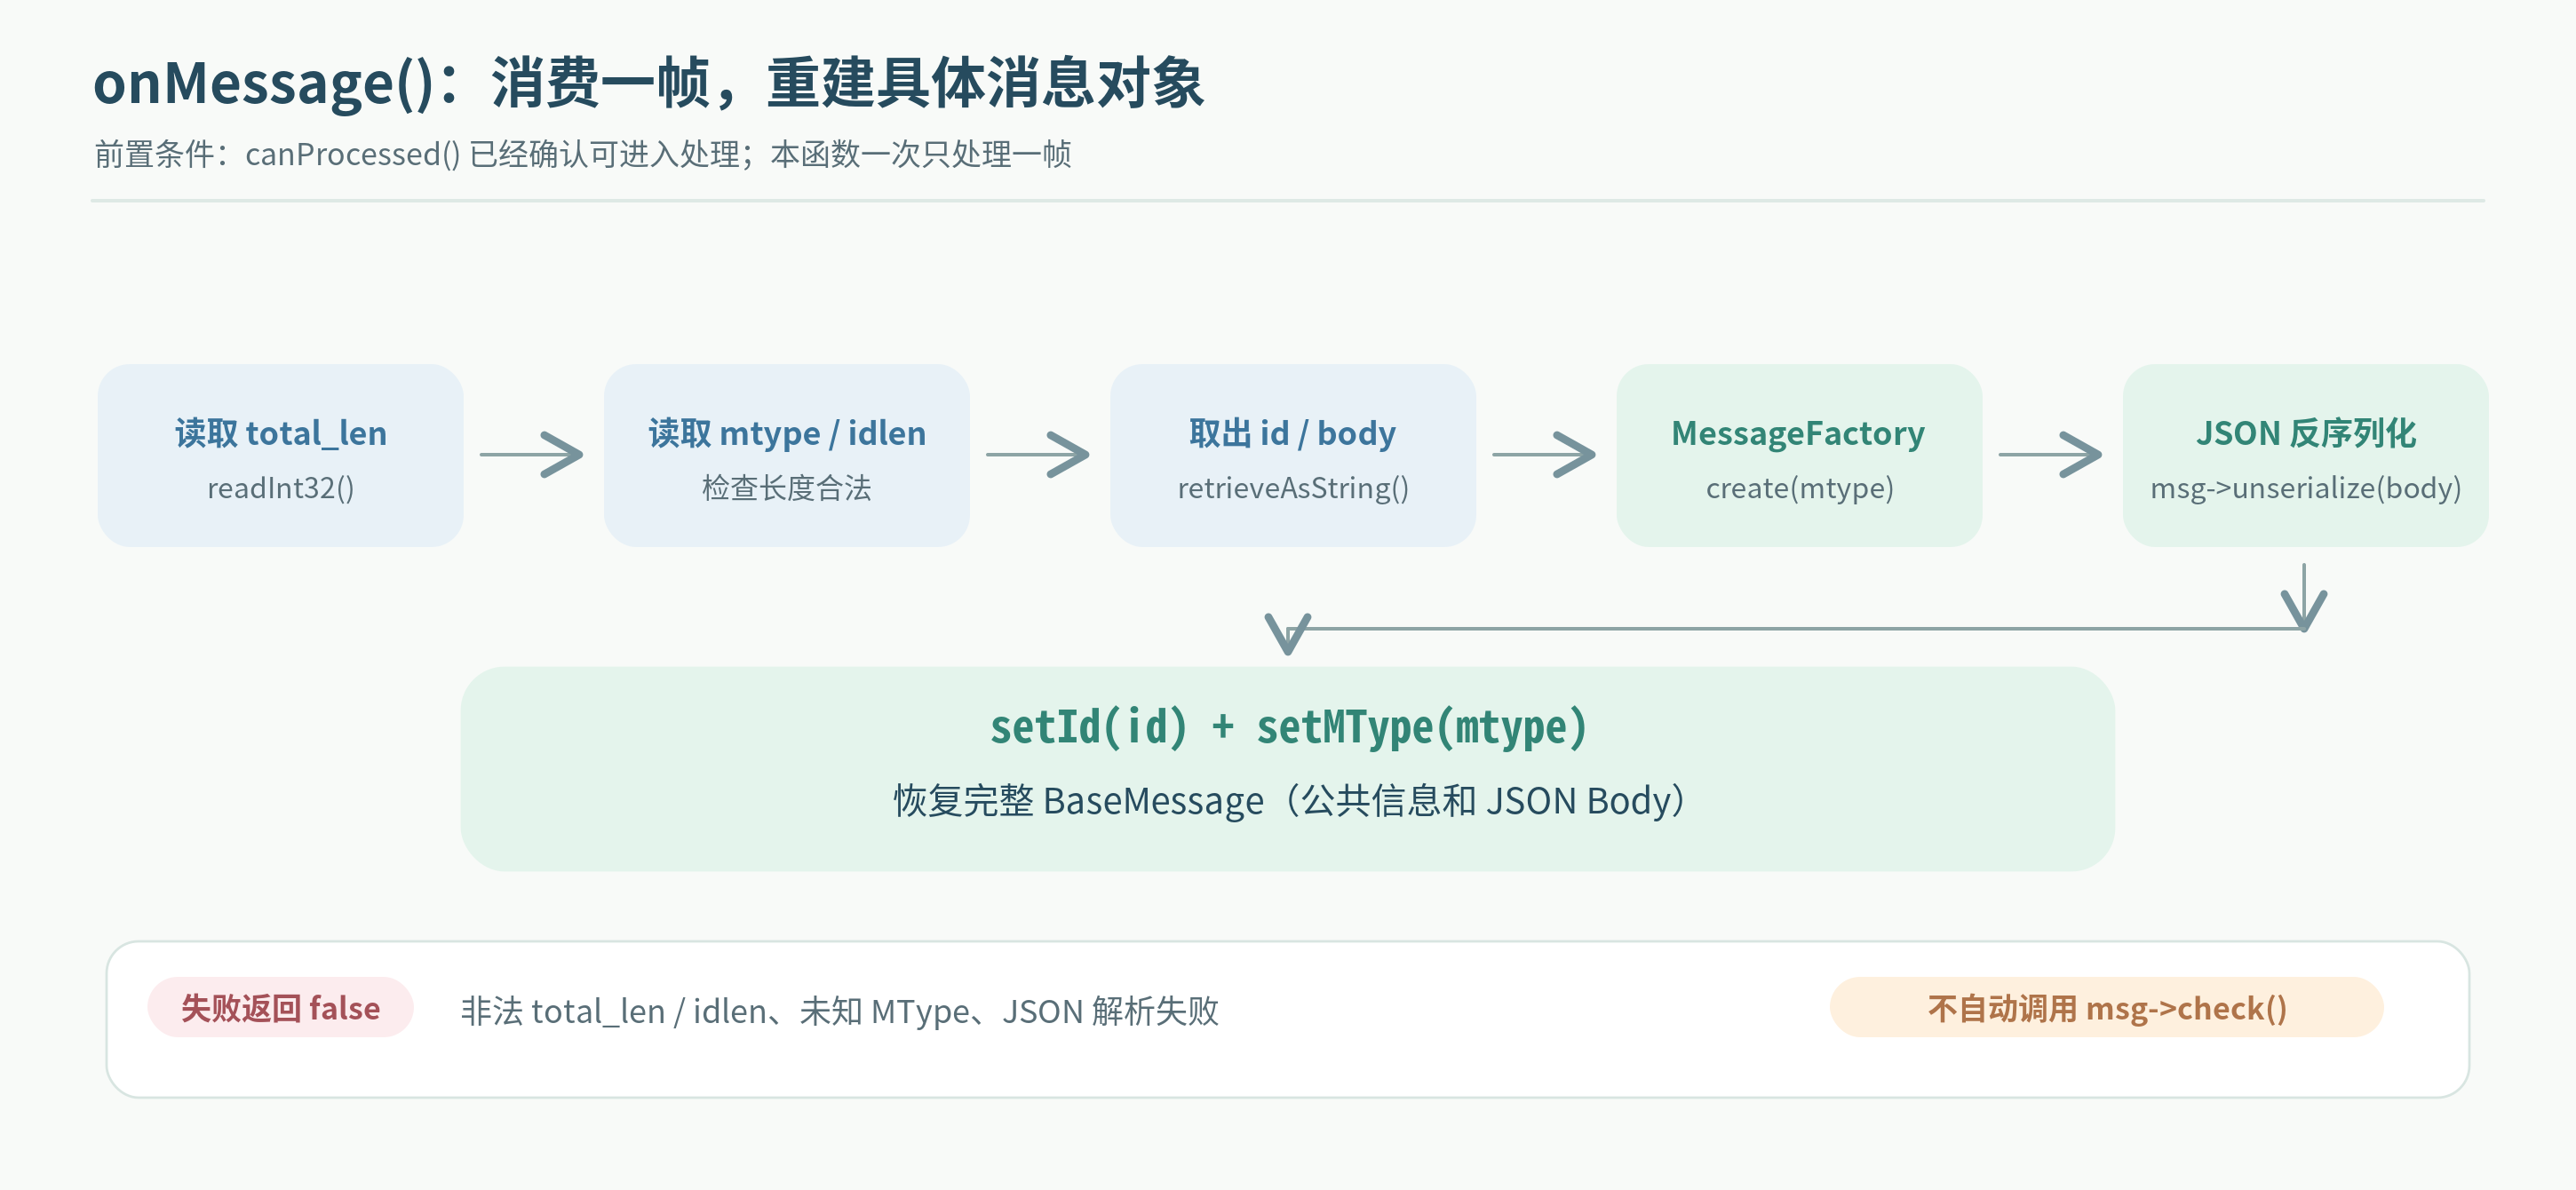
canProcessed() 只是观察。真正拿走字节、创建对象的是:
cpp
bool onMessage(
    const BaseBuffer::ptr &buf,
    BaseMessage::ptr &msg);
它的前提是调用方已经先用 canProcessed() 做了判断。
4.1 先消费固定头部,再验证字段
当前源码先读取 total_len,然后验证范围:
cpp
int32_t total_len = buf->readInt32();

const int32_t kMinFrame =
    static_cast<int32_t>(
        mtypeFieldsLength + idlenFieldsLength);

if (total_len < kMinFrame) {
    ELOG("协议帧总长度非法 total_len=%d", total_len);
    return false;
}

if (total_len >
    static_cast<int32_t>(64 * 1024 * 1024)) {
    ELOG("协议帧总长度超出上限 total_len=%d", total_len);
    return false;
}
这里终于使用 readInt32(),意味着头部 4 字节已经被消费。
如果长度非法,直接返回 false。这也解释了上一节为什么在判断出非法长度时选择让 canProcessed() 返回 true。
长度通过后,继续读取两个固定字段:
cpp
MType mtype = (MType)buf->readInt32();
int32_t idlen = buf->readInt32();
现在我们已经知道:
- total_len:Value 总长度;
- mtype: 应该创建哪一种消息;
- idlen: 接下来 ID 应该读多少字节。
但还不能不加检查就拿 idlen 去读数据。
4.2 为什么必须验证 idlen?
根据协议:
\\texttt{total_len}=4+4+\\texttt{idlen}+\\texttt{body_len}
因此,idlen 不能小于 0,也不能大于 total_len - 8。否则剩下的 Body 长度就会变成负数,甚至导致按错误长度访问 Buffer。
当前实现已经检查:
cpp
if (idlen < 0 || idlen > total_len - kMinFrame) {
    ELOG("协议帧 idlen 非法 idlen=%d total_len=%d",
         idlen, total_len);
    return false;
}
之后才计算:
cpp
int32_t body_len =
    total_len - idlen -
    idlenFieldsLength - mtypeFieldsLength;
源码还保留了一次 body_len < 0 的防御性判断:
cpp
if (body_len < 0) {
    ELOG("协议帧 body_len 非法 body_len=%d "
         "total_len=%d idlen=%d",
         body_len, total_len, idlen);
    return false;
}这一步最值得理解的是:Body 并没有再单独携带一个长度字段。
原因是总长度、固定字段长度和 ID 长度都已经知道了,剩下的自然就是 Body 的长度。
4.3 再读取变长 ID 和 JSON Body
长度都确认后,才能真正消费这两段数据:
cpp
std::string id =
    buf->retrieveAsString(static_cast<size_t>(idlen));

std::string body =
    buf->retrieveAsString(static_cast<size_t>(body_len));
这里 retrieveAsString() 不只是复制字符串,还会推进底层 Buffer 的读取位置。
所以到这一步,本帧已经从接收缓冲区中被取走;如果 Buffer 后面还跟着下一条完整报文,那些字节仍然留着,等待后续解析。
4.4 MessageFactory 终于在网络接收路径中用起来了
第七篇我们已经学过:
cpp
MessageFactory::create(mtype)当时只是知道"给出 MType,就能创建对应的具体消息类"。
现在这个设计终于接进真实的数据流:
cpp
msg = MessageFactory::create(mtype);

if (msg.get() == nullptr) {
    ELOG("消息类型错误,构造消息失败!");
    return false;
}

bool ret = msg->unserialize(body);

if (ret == false) {
    ELOG("消息正文反序列化失败!");
    return false;
}

msg->setId(id);
msg->setMType(mtype);

return true;
例如收到 REQ_RPC 类型的消息,工厂会建立对应的 RpcRequest;收到 REQ_TOPIC,就建立相应的 Topic 请求对象。
随后 unserialize(body) 把 JSON 字符串放回具体消息对象内部。
但不要忘记:协议头里的 ID 和 MType 不在 JSON Body 里,所以最后还需要单独执行:
cpp
msg->setId(id);
msg->setMType(mtype);
至此,接收方向终于形成了一条完整的数据线:
cpp
Buffer 中的完整 LV 报文
        ↓
读取 total_len、mtype、idlen
        ↓
读取 id、body
        ↓
MessageFactory::create(mtype)
        ↓
msg->unserialize(body)
        ↓
setId(id) / setMType(mtype)
        ↓
BaseMessage::ptr
4.5 反序列化成功,不代表业务消息一定合法
这里需要继续沿用第七篇区分过的两个概念:
-
unserialize():JSON 正文能不能解析; -
check():当前业务消息需要的字段、类型是否符合规则。
当前 LVProtocol::onMessage() 没有自动调用 msg->check()。
它只根据 unserialize(body) 是否成功决定这一处的返回结果,业务字段合法性检查是否执行,需要结合后续调用链继续看。
同样,未知 MType 会让 MessageFactory::create(mtype) 返回空指针,并使 onMessage() 失败。协议层并不会替未知类型编造一个消息对象。
五、发送方向:serialize() 怎样组装完整的 LV 报文?
接收方向已经明白了,发送方向其实正好相反:
cpp
BaseMessage
    ↓
取 JSON Body、RID、MType
    ↓
计算长度并写入协议字段
    ↓
得到完整字节串
5.1 先拿到正文和公共字段
当前实现从消息对象提取:
cpp
std::string body = msg->serialize();
std::string id = msg->rid();

auto mtype = htonl((int32_t)msg->mtype());
int32_t idlen = htonl(id.size());
msg->serialize() 在 JsonMessage 的实现中,最终会调用第八篇讲过的 JSON 工具,将 Json::Value 转换为字符串。
这里千万不要混淆两个同名的 serialize():
-
msg->serialize():把业务 JSON Body 变成字符串; -
LVProtocol::serialize(msg):把 Body 连同消息类型和 RID 一起组装成完整 LV 报文。
两者不是重复工作,而是发生在不同层次。
5.2 为什么整数需要 htonl()?
网络传输整数时,我们需要约定一个稳定的字节顺序。
发送侧:
cpp
htonl(...)将 32 位整数转换成网络字节序。
接收侧 MuduoBuffer::peekInt32()、readInt32() 最终使用 Muduo Buffer 的对应接口,它们已经完成网络序到本机序的恢复。因此我们不必在 LVProtocol 里再做一次 ntohl()。
可以这样理解:
cpp
发送方 int32_t
     ↓ htonl
网络中的 4 个字节
     ↓ Muduo peekInt32 / readInt32
接收方 int32_t
至于 id 和 body,它们本身已经是字符串字节,按约定长度原样追加即可,不需要像整数一样调用 htonl()。
5.3 total_len 怎样计算?为什么要 reserve()?
源码中:
cpp
int32_t h_total_len =
    mtypeFieldsLength +
    idlenFieldsLength +
    id.size() +
    body.size();

int32_t n_total_len = htonl(h_total_len);
h_total_len 表示本机序下的 Value 长度,n_total_len 是准备写入报文中的网络序长度。
注意这里仍然没有把最前面的 4 字节长度字段算进去。
然后:
cpp
std::string result;
result.reserve(h_total_len + 4);
reserve() 只是提前预留存储容量,减少后续 append() 可能发生的重新分配,并不会真的改变字符串长度。
最终报文的字节数,是后面的 append() 一次次实际追加出来的。
5.4 按既定顺序追加字段
cpp
result.append((char *)&n_total_len, lenFieldsLength);
result.append((char *)&mtype, mtypeFieldsLength);
result.append((char *)&idlen, idlenFieldsLength);
result.append(id);
result.append(body);

return result;
它严格对应前面定义的格式:
cpp
| total_len | mtype | idlen | id | body |顺序必须一致,因为接收端就是按这个顺序读取。
例如某条消息的 RID 为 req-7,占 5 字节,序列化后的 Body 占 30 字节,那么:
cpp
total_len = 4 + 4 + 5 + 30 = 43

完整字节串:
[43:4B][mtype:4B][5:4B][req-7:5B][Body:30B]

实际总长 = 4 + 43 = 47 字节
其中 43、mtype、5 都是以网络序保存的 32 位整数,不是字符 '4'、'3' 或 '5'。
还有一个值得注意的实现边界:当前 serialize() 负责组包,但没有在发送端对超大 Body / ID 长度做与接收端完全对称的显式范围校验,也没有在这个接口上单独返回序列化成功与否的状态。文章讲解时不能把接收侧的校验能力误写成发送侧也已全部具备。
六、拿半包和粘包重新检验这套流程
理解了 canProcessed() 和 onMessage(),再看 TCP 中最常见的两个问题,就会容易许多。
6.1 半包:一条消息还没收齐
假设一条完整报文长 47 字节,第一次只到达 15 字节:
cpp
Buffer 当前:
[total_len:4B][Value 的前 11B]

可读字节:15
完整报文:47
调用 canProcessed():
-
15 ≥ 4,可以读取长度字段;
-
peekInt32()得到total_len = 43; -
43 位于合法范围;
-
15 < 4 + 43,返回
false。
结果是:
Buffer 没有被消费。
第二次又到了 32 字节,Buffer 中累积到 47 字节。再次判断时,canProcessed() 才会返回 true,之后 onMessage() 再真正取走这一帧。
这就是"先 peek、后 read"的实际意义。
6.2 粘包:Buffer 里有两条完整消息
现在假设当前 Buffer 中已经有:
cpp
[消息 A:47 字节][消息 B:39 字节]canProcessed() 先查看 A 的长度,发现 A 完整,返回 true。
随后 onMessage() 只消费 A 的 47 字节,留下:
cpp
[消息 B:39 字节]这时不是 LVProtocol 自动把 B 也解析了,而是上层调用者需要再次调用:
cpp
canProcessed()
    ↓
onMessage()
直到 Buffer 里不再有可以处理的完整报文。
换句话说:
LVProtocol每次处理一帧;反复拆包的循环由后面的网络回调承担。
当前项目的 MuduoServer / MuduoClient 消息回调中确实有这样的循环。不过它属于下一篇网络封装的讲解重点,这里先不展开连接管理和回调细节。
6.3 非法帧:为什么不能一直把它当作半包等待?
还有一种情况:收到的前 4 字节宣称 total_len = -1,或者宣称它大于当前约定的 64 MiB 上限。
这种值不是"数据还差一点",而是长度本身已经不符合协议要求。
当前源码让 canProcessed() 返回 true,再由 onMessage() 返回 false,使网络层有机会按错误报文处理连接。对于合法长度范围内但字节尚未收齐的情况,才返回 false 并继续等待。
这一点非常重要:
- 合法但没收齐 → 等待更多数据;
- 长度本身非法 → 进入错误处理。
对于合法长度的报文,解码时还会继续检查 idlen;对于未知 mtype 或无法解析的 JSON Body,onMessage() 同样会返回 false。
这套处理让我们能够区分"不完整"和"已经确定错误",而不是遇到任何异常都盲目等下一批字节。
七、ProtocolFactory:把前面的抽象和真实协议接起来
7.1 工厂只负责创建当前真正使用的协议
和前面的 BufferFactory 一样,协议也有一个简单工厂:
cpp
class ProtocolFactory {
public:
    template <typename... Args>
    static BaseProtocol::ptr create(Args &&...args) {
        return std::make_shared<LVProtocol>(
            std::forward<Args>(args)...);
    }
};
它返回的静态类型是:
cpp
BaseProtocol::ptr实际创建的对象是:
cpp
LVProtocol所以上层连接层可以保存:
cpp
BaseProtocol::ptr _protocol;并通过统一接口调用:
cpp
_protocol->serialize(msg);
_protocol->canProcessed(base_buf);
_protocol->onMessage(base_buf, msg);
这里不要过度解读为"项目已经支持多套协议动态切换"。当前 ProtocolFactory 就是统一创建 LVProtocol,上层则通过抽象接口持有和使用它。
7.2 把本篇三块实现重新接起来
发送方向:
cpp
BaseMessage
    ↓
LVProtocol::serialize()
    ↓
完整 LV 字节串
    ↓
后续通过连接层发送
接收方向:
cpp
Muduo 的原始接收 Buffer
    ↓
BufferFactory::create()
    ↓
MuduoBuffer(BaseBuffer 接口)
    ↓
LVProtocol::canProcessed()
    ↓
LVProtocol::onMessage()
    ↓
MessageFactory::create(mtype)
    ↓
BaseMessage
    ↓
后续交给消息回调 / Dispatcher
到这里,第五篇留下的 BaseBuffer、BaseProtocol 和第七篇的 MessageFactory 都有了真正的协作位置,第八篇的 JSON 转换工具也参与了 Body 的序列化与反序列化。
写在最后
回顾这一篇,我们并没有新增 RPC 业务逻辑,而是把此前准备好的基础模块接成了真正可工作的协议处理链:
-
MuduoBuffer把muduo::net::Buffer适配成统一的BaseBuffer; -
BufferFactory统一创建适配器; -
LVProtocol::canProcessed()先判断长度、处理明显非法长度,并在半包时保持 Buffer 不变; -
LVProtocol::onMessage()消费一条完整报文,通过MessageFactory和 JSON 反序列化恢复具体消息对象; -
LVProtocol::serialize()把消息对象组装成total_len / mtype / idlen / id / body格式; -
ProtocolFactory让后续网络层继续通过BaseProtocol使用当前实现。
本篇最重要的一条思路其实非常朴素:
TCP 没有应用层消息边界,我们就用长度字段建立边界;先确认消息是否完整,再真正消费字节,最后把它恢复成项目自己的
BaseMessage。
但是到这里,协议还只是一个"会编解码"的组件。下一篇继续往下走:
MuduoConnection怎样把消息编码后交给真正的 TCP 连接?MuduoServer、MuduoClient又怎样在网络回调中反复拆包,并把恢复出来的消息交给MessageCallback?
把这些接上之后,我们的协议层才会真正进入客户端与服务端的完整通信流程。