在真正踩下去之前,你已经"算"过一遍了。
你踩进一片看不清深浅的浅滩之前,脚还没落下,脑子里已经过了一遍:这一步会不会滑、水会往哪个方向推我、重心该往哪边压。
**这个"预演"不是想象,是一次快速计算。**它用的不是公式,是你从小到大攒下来的身体经验。
现在要问的是:能不能让 AI 也做一次这样的预演------尤其在水这种东西面前?
水里的物理:什么是"世界模型"
先说清楚这个词,因为它很容易被说得玄乎。
世界模型做的事情只有一句话:给定现在是什么状态、我准备做什么动作,预测下一步会变成什么状态。
就这么多。它不负责决定做什么,只负责回答"如果我这么做,接下来会怎样"。
《人民日报》今年 6 月的一篇报道里有个说法挺准确:"用于模拟环境动态并预测未来状态的世界模型被称为物理AI的'内部大脑'。" 同一篇报道还提到,学界专家总结出世界模型的三项重要能力------生成性、多模态、交互性。
(插一句:那篇报道里马晓健讲的是物理AI 的"三个重要特征",和这里世界模型的"三项能力"是两套不同的"三个",别搞混。)
那为什么非要它?因为真跑一遍太贵。
这一点上一期和上上期已经铺垫过:流体仿真的成本高得让强化学习跑不动------单个环境就是十万个粒子,每个粒子还要认邻居。而世界模型是学出来的:训练完一次,之后每一步预测都是前向推理,比老老实实解方程快得多。
更关键的是第二点:它是可导的。
这意味着策略网络可以直接拿到梯度------"你这个动作往哪个方向调、结果会变好",不用靠成千上万次盲试。CFC 那篇论文的摘要把这两点合在一句里说得很干脆:
sidestepping the computational burden of fluid simulation and providing policy gradients for efficient policy training
绕开流体仿真的计算负担,同时提供策略梯度------这就是世界模型值得存在的全部理由。
不过这里得说清一个前提:**世界模型不产生新的物理知识,它只是把已有的物理规律"背熟",好让调用变便宜。**所以它快不快、准不准,取决于它是从哪儿学的。这一点本节最后还会回来。
水里的案例:两层模型,只交换一个"力"字
2025 年的 SIGGRAPH Asia 上,香港大学 Taku Komura 团队联合 TransGP、马萨诸塞大学、香港科技大学、得州农工、MIT-IBM Watson AI 实验室和宾夕法尼亚大学,发表了一套叫 CFC 的系统,全名是《CFC: Simulating Character-Fluid Coupling Using a Two-Level World Model》。
它要做的事听起来很难:让虚拟人(或者一个四足机器人)在水里、在泥浆里跑动、打斗、摔倒再爬起来。
难在哪?难在两边都要准 。人的动作要像人,水的反应要像水,而且这两件事是双向耦合的------人推水,水也推人。
直接算?太贵。CFC 的做法是把它拆成两层世界模型:
We introduce a two-level world model which consists of a Physics-Informed Neural Network (PINN)-based model for fluid dynamics and a character world model capturing body dynamics under various external forces.
一个基于 PINN 的流体模型 ,加一个角色世界模型(负责身体在各种外力下的动力学)。
**注意到那个 PINN 了吗?上一期的主角,在这里变成了一个零件。**上一期讲的是"用 AI 替代方程求解"这条路线本身好不好;这一期我们看到,它已经作为组件被装进更大的系统里了------这就是这门技术往工程走的样子。
分工可以这样理解:流体层是个"场地预报员" ,负责告诉你"这股水现在会往你身上施加多大的力";角色层是个"教练",负责决定"这一下腿该怎么迈"。
而这两层之间的连接方式,是这一期真正想讲的东西。
它最聪明的地方:接口有多窄
看 CFC 项目页对两层模型交互的描述:
The Character World Model predicts the next character state based on the previous character states, external forces , and policy-driven actions. The Fluid World Model takes the states of both the fluid and the character to compute external forces on the character and predict the fluid's next state. External forces serve as the interface connecting the two models.
翻成中文:角色层根据"之前的状态 + 外力 + 动作"预测下一个角色状态;流体层根据"流体和角色的状态"算出作用在角色上的外力 ,并预测流体的下一个状态。外力,就是连接这两个模型的接口。
两层之间只传一个量:力。
这一点值得停一下,因为它违反直觉。一般人会以为,这种系统之所以能work,是因为两层模型各自都很强。但真正让它们能拼起来的,是那个接口被定义得足够窄。
窄有什么好处?CFC 的项目页给出了答案,而且答案在训练流程里:
We begin by training a low-level controller with skill embeddings through GAIL in a simulation environment without water
他们先在"没有水"的环境里,训练出一个低层控制器------一个通用的动作底座,会走路、会保持平衡、会摔倒后调整。这一步完全不需要水。
然后才是第二步:把水加进来,用双层世界模型去学"水怎么影响身体",让高层的策略在这个动作底座上学会应付水流。
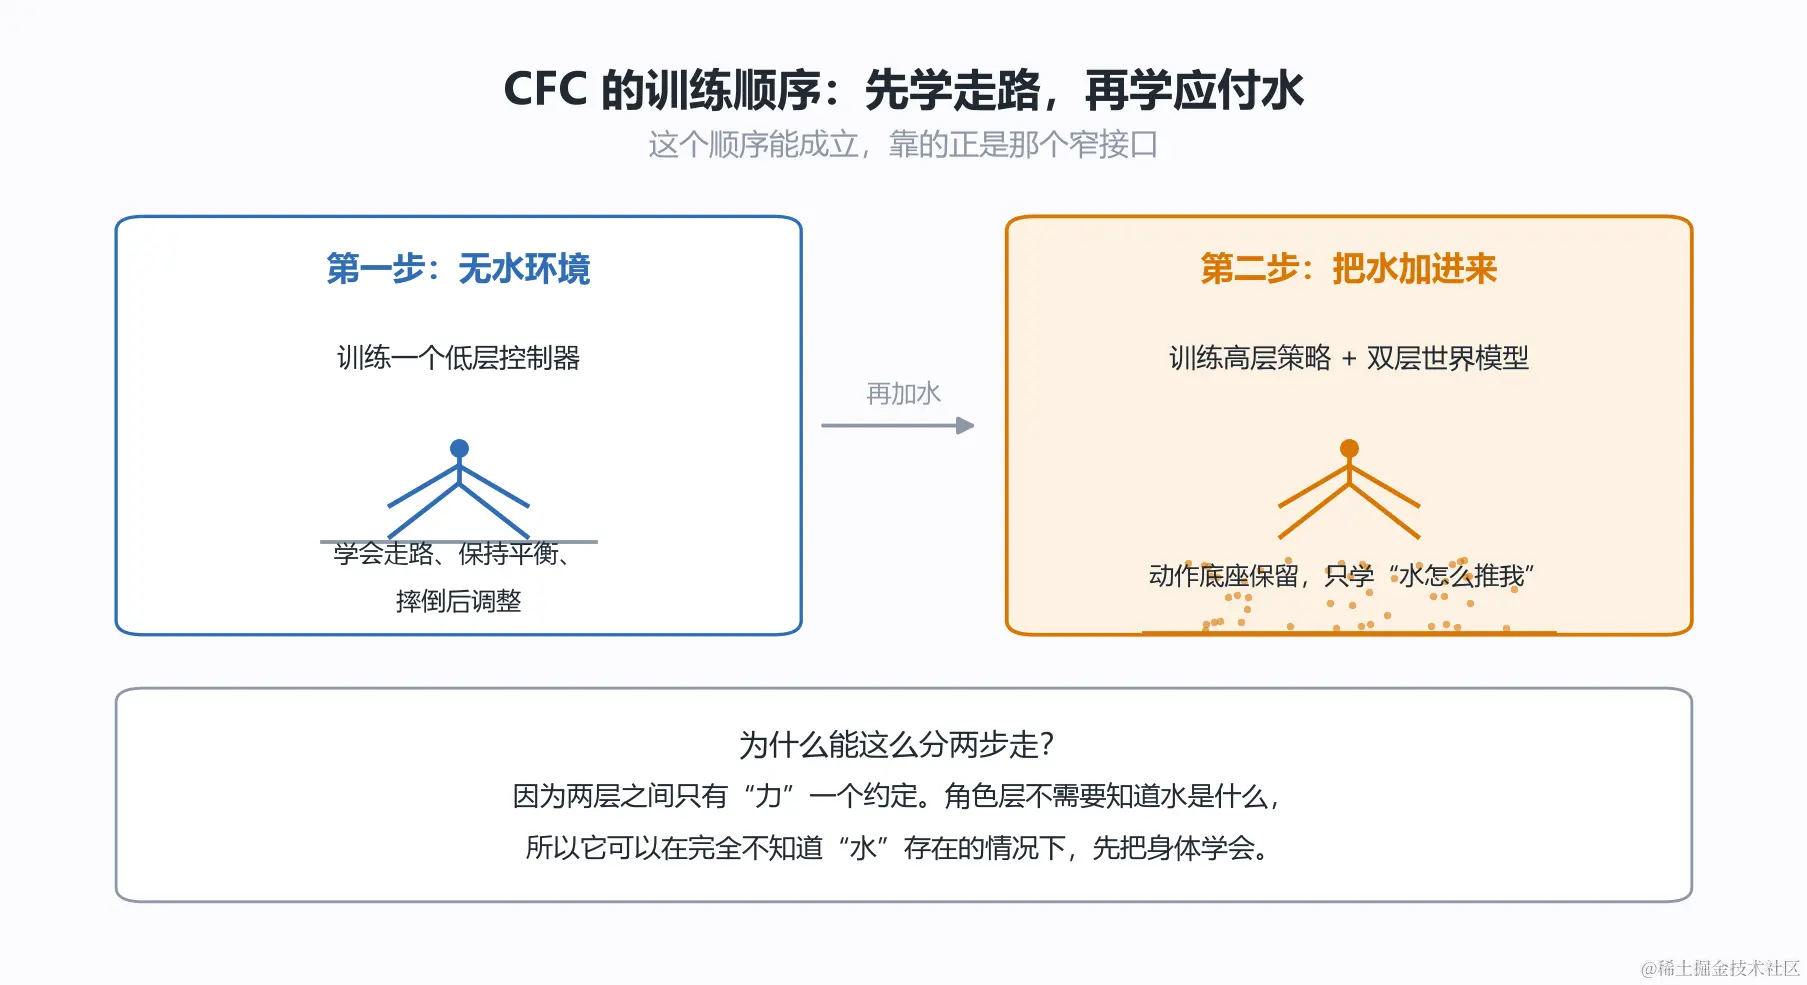
这个顺序能成立,靠的正是那个窄接口。角色层不需要知道水是什么。
**这个顺序能成立,正是因为接口足够窄。**因为两层之间只有"力"这一个约定,所以角色层可以在完全不知道"水"是什么的前提下先把动作学好------它只需要知道"有一个外力这么推我"就够了。至于这个力是水给的、是风给的、还是被车撞的,它不关心。
接口窄,意味着两边可以各自独立地长大。
后面还有第三层收益。你注意到这个链条了吗:一个东西如果先学会了没水的场景 ,那么当你要把它挪到泥浆里,需要改的只是"力的来源",不需要重新教它走路。项目页里那几段演示恰好说明了这一点------角色在黏度 0.01、0.05、0.1 三种不同流体里跑动、战斗、把目标打中,用的还是同一套身体底座。
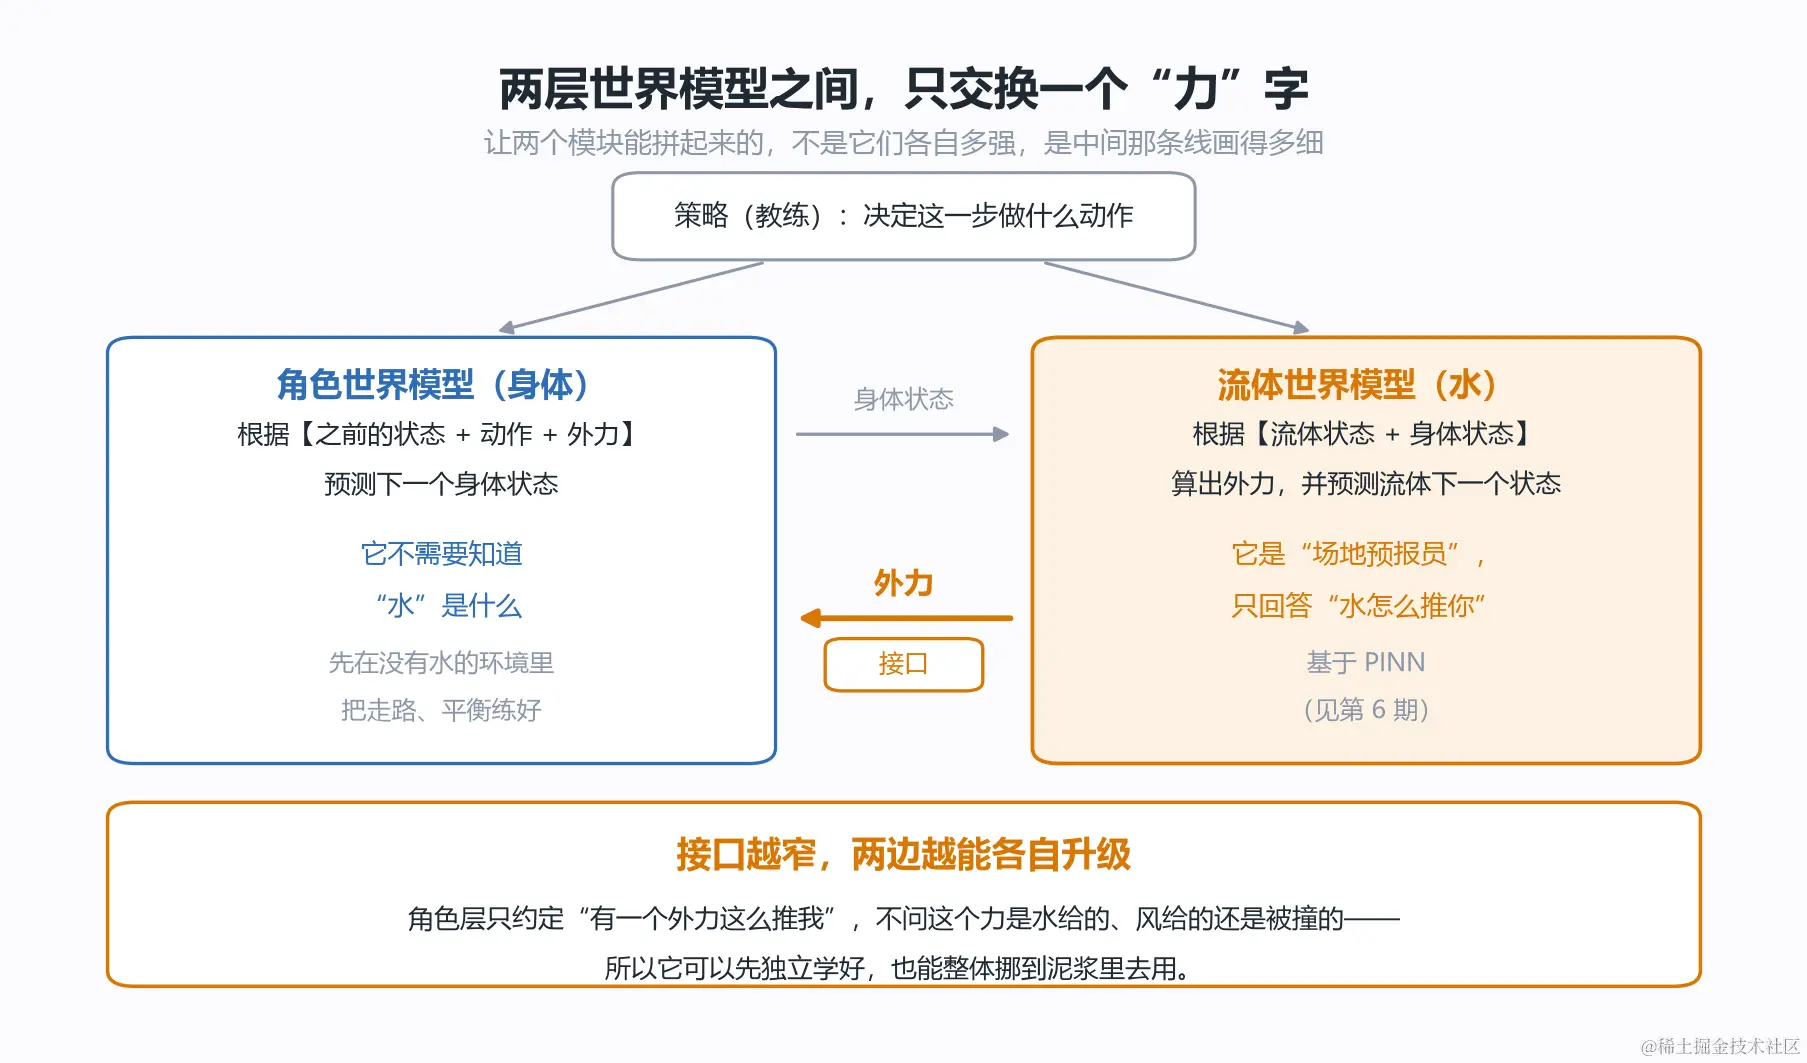
这张图就是本期的核心:不是模型有多强,是中间那条线画得多细。
一个没预料到的收获:水教出了新动作
这一节本来不在计划里,但项目页里有一组结果值得单独说------因为它比"快了多少倍"有意思得多。
CFC 项目页提到了一个现象,用的是 emergent behaviors(涌现行为)这个词:
We also present that the fluid initiates emergent behaviors of the characters, enhancing motion diversity and interactivity.
水流催生了角色自己"长出来"的新行为。
具体是什么行为?项目页给了两张很有说服力的图。第一个是视觉上的:角色被一股强力水流冲倒之后,自己爬起来了;另一张是它用水盾牌配合下蹲、把重心压稳来对抗水流。
第二个更硬,是统计出来的。项目页对比了两种条件下膝盖和脚的垂直高度分布 :没有水(蓝色)和在有水里(橙色)。结论是------有水的情况下,脚和膝盖抬升的均值更高,而且离散程度更大。
这意味着什么?说明角色在水里自发形成了一套"抬脚"的走路策略。
它没有被专门教过"在水里要抬高腿"。它是被梯度推着、为了让任务分数更高,自己摸索出了这个动作。而它的动作底座,本来是在没有水的干地上 练出来的------水只是在上面加了一层力,就逼出了新的行为。
这件事的分量在于:如果世界模型的作用只是"让已有的动作在水里也能用",那它就是个加速器;但它还能反过来改变行为本身,那就等于给策略开了一片新的探索空间。
这也正是《人民日报》那篇报道里"生成性"这个词的落脚点------世界模型不只是复现已知的动态,它能生成出没被显式写下来的可能性。
不过要公平地说:这些"新行为"仍然是在虚拟环境 里发生的,评价标准是动画质量和用户打分。技术上是真的,离"一台真机器人在水里学会新步态"还有距离。
边界:它的"真值",本身也是仿真
好处说完了,得说分寸。
CFC 项目页写得很坦白,流体模型的数据是这么来的:
For Fluid World Model training, data of fluid and rigid bodies are simulated utilizing SPH . For data diversity, we set up various water bulks containing 5K to 15K particles at different initial positions.
数据由 SPH 仿真生成------就是第 5 期讲过的粒子法。水体规模是 5000 到 15000 个粒子。
这意味着:世界模型学的"标准答案",是另一个仿真器给出的。
所以它在做的是拟合一个仿真 ,而不是拟合真实的水。项目页里那些评价指标------粒子位置和速度的 RMSE,对比的基准也都是 SPH 仿真,不是实验测量。
这里有个数字值得看一眼。项目页的误差表显示,在黏度最低的设定下,粒子位置 的 RMSE 从 0.04 秒时的 0.0102(米)涨到 0.2 秒时的 0.4880(米)------时间拉长五倍,误差涨了约 48 倍。
**"误差随时间累积"这件事,上一期刚讲过。**在这里它换了个形式出现:不是神经网络算方程算飘了,而是世界模型预测粒子位置时越来越偏。
但注意,这不等于动画就崩了。项目页同样给了一张和 SPH 的定性对比,结论是模型"effectively captures fluid dynamics"------它抓住了水流的整体形态。单个粒子的位置飘了半米,和"这盆水看起来还像水"完全可以同时成立。
**这恰恰是最需要警惕的一类结果:看起来对,但逐点对不上。**上一期那句话在这里该怎么用,你大概已经有数了。
还有一条边界,是关于证据等级的,必须说清楚:
CFC 是一篇图形学论文,它的评价方式是动画质量 ------动作像不像人、水花自不自然、用户打分高不高。项目页里确实有一组很漂亮的性能数字:粒子数最高到 56 万 、比基线 SPH 快 15 倍 (论文说的是 15 到 30 倍区间)、训练时间约 4.3 小时 对比 34.5 小时。但它没有在真实水里验证过。虚拟角色在水下摔倒再爬起来,和一台真实机器人在河里站稳,是两件事。
顺带说说这个方向整体走到哪了。据中国国际广播电台今年 4 月的报道,阿里巴巴旗下高德的 ABot-PhysWorld 登上了世界模型评测榜单 WorldArena 的第一名,报道特别提到它能在滑动、倾倒、堆叠和流体动力学 这些复杂相互作用下预测物体轨迹。"预判水怎么流"这件事,正在被各家当成一项要单独攻的能力。
而《人民日报》那篇报道也没回避另一半:"复杂接触、柔性形变、流体运动、非平整地面等物理过程仍难以高精度实时模拟"------"流体运动"是被点名的一项。
你的行业
这一期讲的是世界模型,但我想让你带走的不是这个词,是那个"力"字。
CFC 做对的事情,本质上是:**先把两个复杂的东西拆开,然后花力气去定义它们之间"交接什么"。**而且它把交接的东西压到了一个字段。
所以给你的问题不是"我们该不该上世界模型",而是:
你们团队里,哪两个模块(或者哪两个部门)之间,缺一个明确的接口定义?
更具体一点,用这三问去对:
第一问:它们现在靠什么交接?
如果答案是"开会讨论""发个文档""我们一直是这么配合的",那说明接口是软的。软接口的代价是:任何一边改动,另一边都要跟着调;任何一边换人,默契就断了。
第二问:如果只允许传一个字段过去,你会选哪个?
CFC 的答案是一个力。一个能同时表达方向和大小、下游拿到就能干活 的量。这个问题很难,但问出来本身就有价值------它逼你说清楚"下游真正需要什么",而不是"我们有什么就给什么"。
大多数团队交接的是"一堆信息",因为没人愿意承担"挑出那一个关键字段"的责任。而挑不出来,通常意味着你自己也没想清楚下游要靠什么做决定。
第三问:接口定窄之后,两边能不能各自升级?
CFC 之所以能先在无水环境里把走路练好,就是因为接口够窄------角色层不需要知道水是什么。反过来,如果你的接口里塞进了对方的实现细节,那么两边就只能一起改、一起测、一起发版。
能各自升级,才叫模块化。否则只是把一坨东西切成了几块放而已。
最后回到这一期的开头。人是先有了一套身体经验,再往上面叠加"水会怎么推我"这个新知识------CFC 那个"先在无水环境训练"的顺序,其实是在模仿这件事。
你们手里的那套核心能力,是不是也到了该"分层"的时候了?