第九章:Agent 工程化与部署
Agent 从原型走向生产,工程化部署是绕不开的核心命题。Demo 中表现惊艳的 Agent,放到真实业务里可能面临延迟抖动、成本失控、错误雪崩等问题。本章围绕工程化部署的八大核心主题展开,从可观测性到容错架构,从成本优化到灰度发布,系统性地构建 Agent 生产化的知识体系。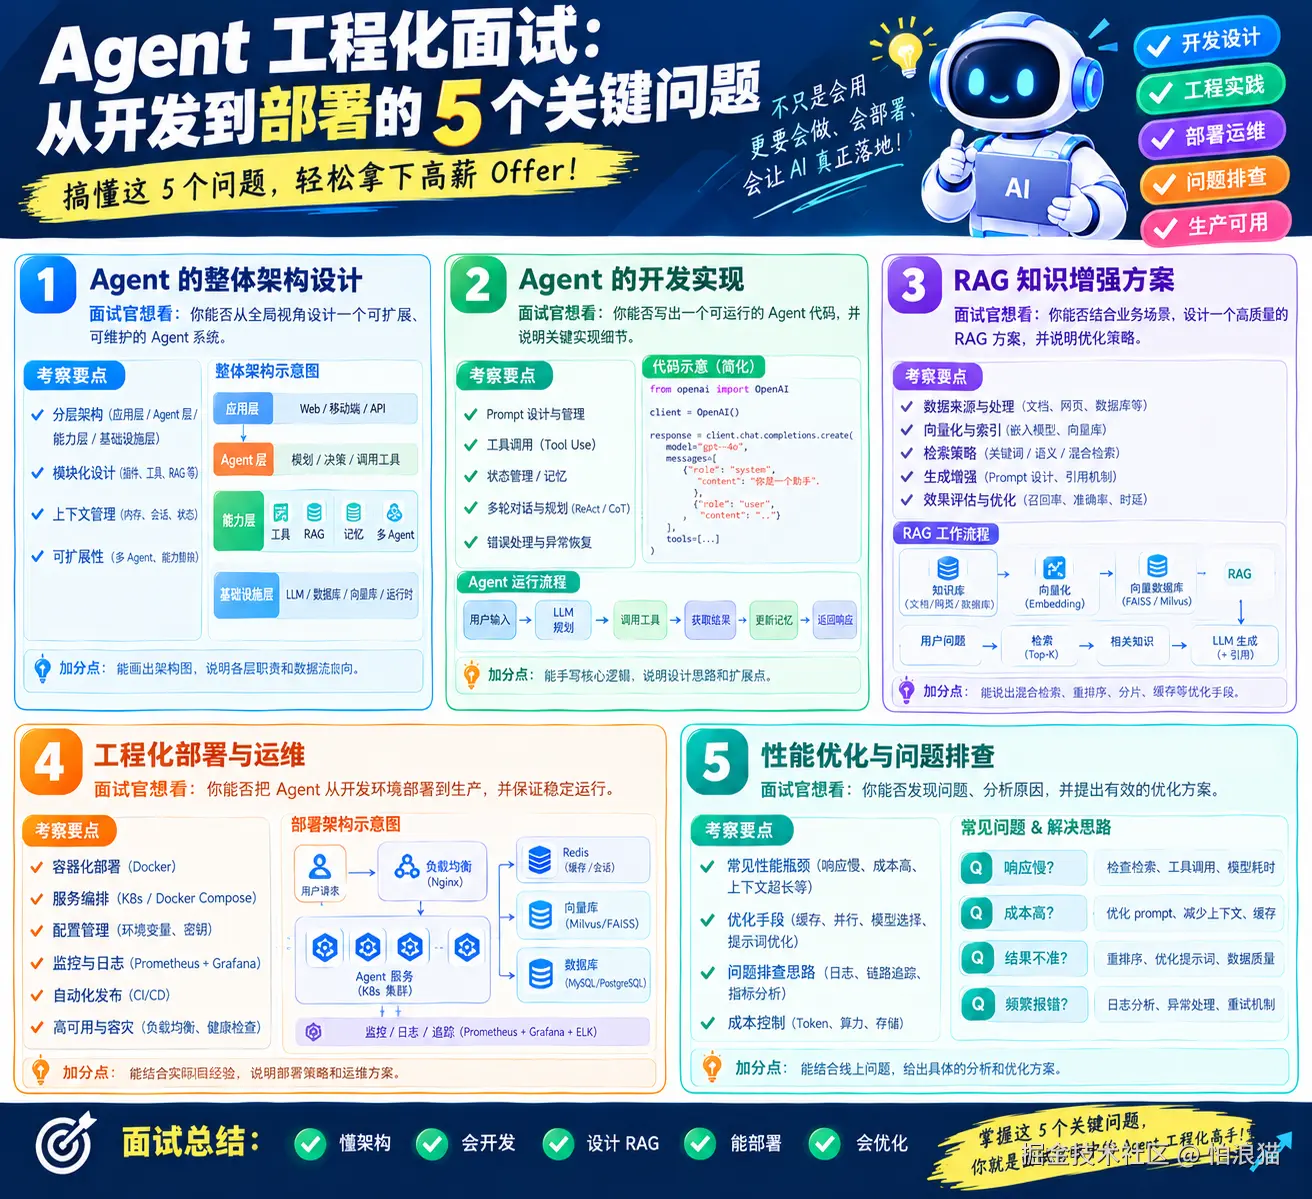
9.1 工程化部署的核心挑战
将 LLM-based Agent 从实验室迁移到生产环境,与传统软件部署有本质区别。传统微服务部署的核心挑战集中在吞吐量、延迟和可用性三个维度,Agent 部署还要额外应对不确定性输出、长时运行任务、动态工具调用等特有难题。
延迟不可控是首要问题。Agent 的响应时间取决于 LLM 推理时间、工具调用执行时间、以及推理链路深度,简单问答可能 2 秒完成,复杂多步推理任务可能耗时 30 秒以上。巨大的延迟方差使传统超时设置和负载均衡策略难以直接套用。
成本与用量同样不可预测。传统服务成本主要来自计算资源(CPU、内存、带宽),而 Agent 成本结构中 LLM API 调用费用占主导。一次复杂推理可能消耗数万 Token,遇到 Prompt 膨胀或工具调用循环,成本可能指数级增长。
状态管理也更为复杂。Agent 需要维护对话历史、工具调用上下文、中间推理结果等有状态信息。多实例部署下,状态一致性和会话亲和性(Session Affinity)都需要精心设计。
质量评估同样棘手。传统服务可通过断言式测试验证正确性,Agent 输出具有不确定性和多样性,难以用简单 pass/fail 评判,部署体系必须内建质量监控机制,持续评估输出质量。
bash
┌─────────────────────────────────────────────────────────┐
│                  Agent 生产化部署架构                      │
├─────────────────────────────────────────────────────────┤
│                                                         │
│   ┌──────────┐   ┌──────────┐   ┌──────────┐          │
│   │ API 网关  │──>│ 路由分发  │──>│ Agent 集群│          │
│   │ (限流/鉴权)│   │ (负载均衡)│   │ (多实例)  │          │
│   └──────────┘   └──────────┘   └────┬─────┘          │
│                                     │                   │
│                    ┌────────────────┼───────────┐       │
│                    │                │           │       │
│               ┌────▼───┐    ┌──────▼──┐  ┌────▼────┐  │
│               │LLM 调用 │    │工具执行器│  │状态存储  │  │
│               │(多模型) │    │(沙箱环境)│  │(Redis)  │  │
│               └────────┘    └─────────┘  └─────────┘  │
│                                                         │
│   ┌─────────────────────────────────────────────┐       │
│   │            可观测性平台                       │       │
│   │  (日志 + 指标 + 追踪 + 告警)                  │       │
│   └─────────────────────────────────────────────┘       │
└─────────────────────────────────────────────────────────┘
架构上,生产级 Agent 系统至少包含:API 网关层负责鉴权、限流和路由;Agent 执行层编排推理流程;LLM 调用层封装模型交互;工具执行层提供沙箱化的工具运行环境;状态存储层维护会话和上下文;可观测性平台提供全链路监控。各组件独立考虑容错和扩展------LLM 调用层实现多模型 Failover,主模型不可用时自动切换备用模型;工具执行层做资源隔离,防止单个工具调用异常影响其他请求。
工程化部署是持续迭代过程,团队需要建立从开发、测试、预发布到生产的完整流水线,每个阶段设置对应的质量门禁和验证标准。
9.2 可观测性系统设计:日志、指标与追踪
Agent 系统的可观测性需要额外覆盖推理过程、工具调用链路、Token 消耗等维度,由日志(Logging)、指标(Metrics)和分布式追踪(Tracing)三大支柱构成。
日志系统记录关键事件,与传统结构化日志不同,Agent 日志需要包含推理上下文------当前推理步骤、Prompt 模板、LLM 响应元数据等。以下是一个结构化日志示例:
json
{
  "timestamp": "2026-08-03T10:15:32.451Z",
  "trace_id": "trace_a3f8b2c1",
  "span_id": "span_7e2d1a",
  "session_id": "sess_9f1c3b",
  "level": "INFO",
  "event": "llm_call",
  "agent_id": "agent_customer_service",
  "model": "gpt-4-turbo",
  "prompt_tokens": 1820,
  "completion_tokens": 456,
  "latency_ms": 2340,
  "tool_calls": ["search_kb", "query_order"],
  "status": "success",
  "step_index": 2,
  "total_steps": 5
}
指标系统关注可量化的运行数据,核心指标如下:
| 指标类别 | 指标名称 | 说明 | 典型告警阈值 |
|---|---|---|---|
| 性能指标 | P50/P95/P99 延迟 | 请求响应时间分位数 | P95 > 10s |
| 性能指标 | 工具调用延迟 | 单个工具执行耗时 | P95 > 5s |
| 成本指标 | Token 消耗速率 | 每分钟 Token 消耗量 | > 500k/min |
| 成本指标 | 单请求成本 | 每次请求的 API 费用 | > $0.5/req |
| 质量指标 | 工具调用成功率 | 工具执行成功比例 | < 90% |
| 质量指标 | 幻觉率 | 输出包含事实错误的比例 | > 5% |
| 可用性指标 | 错误率 | 请求失败比例 | > 1% |
| 可用性指标 | 限流触发率 | 被限流的请求比例 | > 5% |
分布式追踪是理解 Agent 调用链的关键。一个请求可能涉及多次 LLM 调用、多个工具执行、数据库读写,追踪系统将所有操作串联成一棵完整调用树。
bash
Trace: trace_a3f8b2c1 (总耗时: 8.2s)
│
├─ [span_001] receive_request (0.1s)
├─ [span_002] context_preparation (0.3s)
│   ├─ [span_003] load_session_history (0.1s)
│   └─ [span_004] build_system_prompt (0.2s)
├─ [span_005] llm_call_round_1 (2.3s)
│   └─ [span_006] tool_call: search_kb (1.1s)
├─ [span_007] llm_call_round_2 (2.8s)
│   └─ [span_008] tool_call: query_order (0.9s)
├─ [span_009] llm_call_round_3 (2.4s)
└─ [span_010] response_formatting (0.3s)
技术选型上,日志可采用 ELK 栈或 Loki + Grafana 组合;指标推荐 Prometheus + Grafana;分布式追踪使用 OpenTelemetry 标准,后端接入 Jaeger 或 Tempo。
Agent 系统还有特有的可观测性需求:推理链路可视化(将 CoT 过程以可读方式呈现,便于调试)、Prompt 版本与输出质量的关联分析、工具调用模式的统计分析(识别高频工具、低效调用等)。
告警策略分层设计:基础设施层(CPU、内存、磁盘等)、应用层(错误率飙升、延迟异常等)、业务层(Token 消耗异常增长、用户满意度下降等),各层设置不同通知渠道和响应优先级。
9.3 成本优化策略:从模型分级到缓存
Agent 系统的运行成本主要由 LLM API 调用费用构成。缺乏优化策略时,面向消费者的 Agent 应用每月 LLM 调用费用可能轻易达到数万美元。成本优化应在架构设计阶段就纳入考量,而非事后补丁。
模型分级路由是最直接有效的手段------按请求复杂度将任务路由到不同成本级别的模型,简单任务用小模型,复杂任务才调大模型。
| 任务类型 | 示例 | 推荐模型层级 | 相对成本 |
|---|---|---|---|
| 意图分类 | 判断用户是咨询还是投诉 | 小模型 (8B) | 1x |
| 信息抽取 | 从文本中提取实体 | 小模型 (8B) | 1x |
| 简单问答 | FAQ 知识库检索回答 | 中模型 (70B) | 5x |
| 多步推理 | 复杂问题分析+工具调用 | 大模型 (GPT-4级) | 20x |
| 内容生成 | 长文写作、代码生成 | 大模型 (GPT-4级) | 20x |
| 结果校验 | 检查输出是否准确 | 小模型 (8B) | 1x |
路由决策可以由轻量级分类器完成,基于规则(关键词匹配)、传统 ML 模型(FastText)、或小模型快速分类。路由决策本身不能引入过多延迟和成本。
缓存策略是另一个重要方向。Agent 系统中存在大量可缓存中间结果:Prompt 级缓存对完全相同的 Prompt 输入直接返回缓存响应(OpenAI 和 Anthropic 已原生支持 Prompt Caching,对前缀相同的 Prompt 自动折扣);语义缓存通过 Embedding 相似度匹配,对语义相近请求复用历史响应,需设置合理相似度阈值------过高命中率低,过低可能返回不相关结果;工具结果缓存针对短时间内不变的工具调用结果(如天气查询、文档搜索)做 TTL 缓存,避免重复调用。
python
import hashlib
from functools import lru_cache

class AgentCache:
    def __init__(self, ttl_seconds=3600):
        self.ttl = ttl_seconds
        self._cache = {}

    def _key(self, prompt: str, model: str) -> str:
        content = f"{model}:{prompt}"
        return hashlib.sha256(content.encode()).hexdigest()

    def get(self, prompt: str, model: str):
        key = self._key(prompt, model)
        entry = self._cache.get(key)
        if entry and time.time() - entry["ts"] < self.ttl:
            return entry["response"]
        return None

    def set(self, prompt: str, model: str, response: str):
        key = self._key(prompt, model)
        self._cache[key] = {"response": response, "ts": time.time()}
Prompt 优化是成本控制的另一维度。Prompt 长度直接影响 Token 消耗,过长不仅增加成本,还可能降低模型表现。优化手段包括压缩系统提示词、精简 Few-shot 示例、使用更紧凑的输出格式要求等。
实际案例:某 Agent 应用的系统 Prompt 从 3000 Token 优化到 1200 Token,每次请求节省 1800 Token,按日均 100 万次请求计算,每天节省约 18 亿 Token,月度成本下降显著。
批量处理(Batch Processing)对非实时任务也很有效。OpenAI 的 Batch API 提供 50% 价格折扣,适合可容忍 24 小时延迟的任务。
Token 预算控制是防止成本失控的最后防线。系统为每个会话设置 Token 预算上限,消耗接近阈值时触发告警,超出阈值时拒绝或降级处理,防止 Prompt 膨胀或工具调用循环导致成本异常。
9.4 流式输出设计:SSE 与 WebSocket
Agent 推理通常耗时数秒到数十秒,传统请求-响应模式下用户需等待全部推理完成才能看到结果。流式输出让用户逐步看到思考过程和中间结果,体验显著提升。
流式输出有两种主流技术方案:SSE (Server-Sent Events, 服务器推送事件) 和 WebSocket。
SSE 基于标准 HTTP 的单向推送协议,服务端通过长连接持续推送数据,客户端只接收不发送。实现简单、天然支持断线重连。Agent 场景下用户请求后只需接收推理结果,SSE 是理想选择。
WebSocket 是全双工通信协议,客户端和服务端可互发消息,适合需要实时交互的场景------例如用户在 Agent 推理过程中补充信息或调整方向。
以下是 SSE 流式输出的服务端实现示例:
python
from fastapi import FastAPI
from fastapi.responses import StreamingResponse
import json, asyncio

app = FastAPI()

async def agent_stream(query: str):
    # 发送推理开始事件
    yield f"data: {json.dumps({'type': 'start', 'query': query})}\n\n"

    # 模拟多步推理
    steps = ["分析问题", "检索知识库", "生成答案"]
    for i, step in enumerate(steps):
        await asyncio.sleep(1)  # 模拟推理耗时
        yield f"data: {json.dumps({'type': 'step', 'index': i, 'content': step})}\n\n"

    # 发送最终结果
    yield f"data: {json.dumps({'type': 'complete', 'answer': '推理完成'})}\n\n"

@app.get("/agent/stream")
async def stream_agent(query: str):
    return StreamingResponse(
        agent_stream(query),
        media_type="text/event-stream",
        headers={
            "Cache-Control": "no-cache",
            "Connection": "keep-alive",
            "X-Accel-Buffering": "no",  # 禁用 Nginx 缓冲
        }
    )
客户端实现同样简洁:
javascript
const eventSource = new EventSource('/agent/stream?query=你好');

eventSource.onmessage = function(event) {
    const data = JSON.parse(event.data);
    if (data.type === 'step') {
        console.log(`步骤 ${data.index}: ${data.content}`);
    } else if (data.type === 'complete') {
        console.log(`结果: ${data.answer}`);
        eventSource.close();
    }
};

eventSource.onerror = function() {
    console.error('连接异常,自动重连中...');
    // EventSource 会自动重连
};
部署流式输出时需注意几个工程细节。Nginx 等反向代理默认缓冲后端响应,会导致 SSE 数据无法实时推送------需在响应头设置 X-Accel-Buffering: no,或在 Nginx 配置中关闭 proxy_buffering。连接管理上,SSE 长连接占用服务器连接槽,需设置合理超时时间和最大连接数限制,防止连接泄漏。断线重连方面,SSE 标准支持 Last-Event-ID 头,客户端重连时携带最后收到的事件 ID,服务端据此恢复推送状态,对网络不稳定的移动端场景尤为重要。
事件类型设计也关键。完善的事件协议应包含:start(推理开始)、thinking(思考过程)、tool_call(工具调用)、tool_result(工具返回)、partial_answer(部分答案)、complete(完成)、error(错误)。不同事件类型携带不同数据字段,客户端据此渲染对应 UI 组件。
9.5 人在回路审批机制
Agent 自主执行能力提升带来了新的风险控制需求。涉及资金操作、数据修改、外部通信等高风险场景时,完全自主的 Agent 可能造成不可逆后果。HITL (Human-in-the-Loop, 人在回路) 通过在关键决策点引入人工审批,平衡自动化效率和操作安全性。
审批机制需明确哪些操作需要人工审批。按风险等级将 Agent 操作分三类:低风险(信息查询、只读操作)无需审批直接执行;中风险(发送邮件、更新数据)通知人工但可先行执行;高风险(资金转账、删除数据、发布内容)必须等待审批后执行。
bash
┌──────────────────────────────────────────────────────┐
│              人在回路审批流程                           │
├──────────────────────────────────────────────────────┤
│                                                      │
│  Agent 决策 ──> 风险评估引擎                           │
│                    │                                 │
│           ┌────────┼────────┐                        │
│           │        │        │                        │
│        低风险    中风险    高风险                      │
│           │        │        │                        │
│       直接执行   通知+执行   暂停等待                    │
│                              │                        │
│                     ┌────────▼────────┐               │
│                     │  审批队列         │               │
│                     │  (优先级排序)     │               │
│                     └────────┬────────┘               │
│                              │                        │
│                     ┌────────▼────────┐               │
│                     │  审批界面         │               │
│                     │  (展示上下文)     │               │
│                     └────────┬────────┘               │
│                              │                        │
│                    ┌─────────┼─────────┐              │
│                    │         │         │              │
│                 批准       拒绝      修改              │
│                    │         │         │              │
│                 执行       取消      重新执行           │
│                                                      │
└──────────────────────────────────────────────────────┘
审批界面直接影响审批效率和质量,应包含:Agent 推理过程(为什么要做这个操作)、操作具体内容(目标、参数、预期影响)、风险评级和依据、历史类似操作的审批记录。
审批机制可细分为同步和异步两种。同步审批要求 Agent 暂停推理流程,等待审批结果后继续,适用于需要审批结果决定后续推理方向的场景。异步审批允许 Agent 继续处理不依赖该审批的任务,审批结果到达后再执行相应操作。
以下是同步审批的代码架构示例:
python
from enum import Enum
from dataclasses import dataclass
from typing import Optional

class RiskLevel(Enum):
    LOW = "low"
    MEDIUM = "medium"
    HIGH = "high"

class ApprovalStatus(Enum):
    PENDING = "pending"
    APPROVED = "approved"
    REJECTED = "rejected"

@dataclass
class ApprovalRequest:
    request_id: str
    agent_id: str
    action: str
    params: dict
    risk_level: RiskLevel
    reasoning: str
    status: ApprovalStatus = ApprovalStatus.PENDING

class ApprovalManager:
    async def request_approval(
        self, action: str, params: dict,
        reasoning: str, risk: RiskLevel
    ) -> bool:
        if risk == RiskLevel.LOW:
            return True  # 低风险直接通过

        req = ApprovalRequest(
            request_id=generate_id(),
            agent_id=self.agent_id,
            action=action, params=params,
            risk_level=risk, reasoning=reasoning
        )
        await self.queue.push(req)

        # 等待审批结果(带超时)
        result = await self.wait_for_approval(
            req.request_id, timeout=300
        )
        return result == ApprovalStatus.APPROVED
审批超时处理可采取以下策略之一:自动拒绝(保守策略,适用于高风险操作)、自动批准(激进策略,仅适用于可逆操作)、升级通知(通知更高级别人员)、转入异步队列(不阻塞当前流程)。
审批日志是合规审计的重要组成。系统应记录每次审批的完整上下文------请求内容、审批人、审批时间、审批结果、执行结果。这些日志不仅用于事后追溯,还能用于分析审批效率和优化风险评级模型。
实际应用中,审批机制可结合规则引擎实现智能路由。例如,金额低于 100 元的转账自动审批,高于 100 元需主管审批,高于 10000 元需双重审批。规则引擎让审批策略灵活调整,无需改代码。
9.6 错误恢复与容错架构
传统服务错误通常是明确的(HTTP 502、数据库连接超时),Agent 系统还可能遇到 LLM 输出格式错误、工具调用失败、推理陷入循环等非传统错误,容错设计更为复杂。
容错架构分五层。重试机制处理临时性错误(网络抖动、API 限流),策略需考虑重试次数限制、重试间隔(推荐指数退避)、可重试错误类型、重试时的上下文处理。
python
import asyncio
from typing import TypeVar, Callable

T = TypeVar("T")

class RetryConfig:
    def __init__(
        self, max_attempts: int = 3,
        base_delay: float = 1.0,
        max_delay: float = 60.0,
        exponential: bool = True
    ):
        self.max_attempts = max_attempts
        self.base_delay = base_delay
        self.max_delay = max_delay
        self.exponential = exponential

async def with_retry(
    func: Callable, config: RetryConfig,
    *args, **kwargs
) -> T:
    last_error = None
    for attempt in range(config.max_attempts):
        try:
            return await func(*args, **kwargs)
        except RetryableError as e:
            last_error = e
            if attempt < config.max_attempts - 1:
                delay = config.base_delay * (
                    2 ** attempt if config.exponential else 1
                )
                delay = min(delay, config.max_delay)
                await asyncio.sleep(delay)
    raise last_error
超时控制需多层级设置:单个 LLM 调用超时、工具调用超时、单步推理超时、整个请求超时,遵循从内到外递增原则,外层超时大于内层超时之和。
熔断器(Circuit Breaker)模式在组件连续失败达阈值时触发,后续请求直接快速失败不再调用,冷却后进入半开状态,允许少量请求试探,成功则恢复正常。
降级策略在系统无法提供完整服务时提供部分功能:大模型降级到小模型(牺牲质量保可用)、多步推理降为单步直接回答、工具调用降为纯文本回答、个性化降为通用模板。
死信队列(Dead Letter Queue, DLQ)将无法成功处理的请求转入专门队列,由人工或离线流程处理,避免失败请求堵塞正常流程,同时保证不丢失请求。
bash
┌─────────────────────────────────────────────────┐
│            Agent 容错架构分层模型                   │
├─────────────────────────────────────────────────┤
│                                                 │
│  Layer 5: 死信队列 (DLQ)                         │
│  └─ 无法处理的请求转人工                          │
│                                                 │
│  Layer 4: 降级策略                               │
│  └─ 大模型→小模型, 多步→单步, 工具→纯文本          │
│                                                 │
│  Layer 3: 熔断器                                 │
│  └─ 连续失败时快速失败, 冷却后试探恢复              │
│                                                 │
│  Layer 2: 超时控制                               │
│  └─ 多层级超时: 调用级/步骤级/请求级               │
│                                                 │
│  Layer 1: 重试机制                               │
│  └─ 指数退避重试, 可重试错误识别                   │
│                                                 │
└─────────────────────────────────────────────────┘
推理循环检测是 Agent 特有的容错需求。Agent 执行多步推理时可能陷入"调用工具 A → 结果 → 调用工具 B → 又回到调用工具 A"的循环。检测机制基于工具调用序列的模式匹配,发现重复模式时强制终止并返回当前最佳结果。
LLM 输出校验同样不可忽视。LLM 可能返回不符合预期格式的输出(如要求 JSON 但返回含 Markdown 代码块的文本),系统需要健壮的输出解析器处理边界情况,解析失败时触发重试或降级。
状态快照(State Snapshot)用于长时运行任务的恢复。推理过程中途因故障中断时,从头重试代价很大,定期保存状态快照可在故障后从最近快照恢复,减少重复计算。
9.7 版本管理与灰度发布
Agent 系统的版本管理比传统软件复杂,行为不仅由代码决定,还受 Prompt、模型版本、工具配置等多因素影响,版本管理需覆盖所有维度。
Prompt 版本控制是首要维度。Prompt 微小措辞变化可能导致行为显著变化,应像代码一样纳入版本控制,每次修改记录变更说明、修改原因、预期影响。推荐使用结构化 Prompt 模板,将变量部分与固定部分分离。
模型版本管理同样关键。LLM 提供商定期更新模型版本,同一模型名称的不同版本可能表现不同。系统应明确记录每个 Agent 使用的模型版本,更新前进行充分回归测试。对于 OpenAI 等提供商,可指定模型版本(如 gpt-4-0613)而非使用默认最新版本。
工具配置版本管理也不可忽略。工具的接口定义、参数格式、行为逻辑都可能变化,每次更新记录版本号,Agent 调用时指定工具版本,避免静默更新导致行为异常。
灰度发布的核心是将新版本先发布给一小部分用户,观察指标正常后逐步扩大范围。
bash
灰度发布流程:

  ┌─────────────┐
  │ 新版本构建完成 │
  └──────┬──────┘
         │
  ┌──────▼──────┐
  │ 影子流量验证  │  (不发真实流量, 复制线上流量回放)
  └──────┬──────┘
         │ 通过
  ┌──────▼──────┐
  │ 5% 流量灰度  │  (监控: 错误率, 延迟, 成本, 质量)
  └──────┬──────┘
         │ 指标正常, 持续 30 分钟
  ┌──────▼──────┐
  │ 20% 流量灰度 │
  └──────┬──────┘
         │ 指标正常, 持续 1 小时
  ┌──────▼──────┐
  │ 50% 流量灰度 │
  └──────┬──────┘
         │ 指标正常, 持续 2 小时
  ┌──────▼──────┐
  │ 100% 全量发布 │
  └──────┬──────┘
         │
  ┌──────▼──────┐
  │ 发布完成, 保留 │
  │ 旧版本 24h   │  (可快速回滚)
  └─────────────┘
流量分配推荐基于用户 ID 哈希,保证同一用户始终访问同一版本,避免不同版本间切换导致体验不一致。也可基于请求特征(地区、设备类型)或时间(先在低峰时段灰度)。
灰度期间监控技术指标(错误率、延迟、资源使用率)和业务指标(用户满意度、任务完成率、Token 消耗),任何异常触发自动回滚。
A/B 测试是灰度发布的延伸------同时运行多个版本,将流量分配到不同版本,对比关键指标表现,以数据驱动方式选择最优版本。A/B 测试需注意统计显著性,避免样本量不足导致错误结论。
回滚机制是版本管理的安全网。系统应支持一键回滚到任意历史版本,秒级完成。可采用蓝绿部署(Blue-Green Deployment)策略,始终维护备用版本环境,切换流量即完成回滚。
版本管理的最佳实践还包括变更审批流程------Prompt 变更、模型升级、工具更新都应经过代码审查和测试验证,设置自动化质量门禁,新版本必须通过一定数量测试用例才能进入灰度阶段。
9.8 多租户架构与部署拓扑
Agent 服务面向多客户(租户)时,多租户架构的核心挑战是在资源隔离、数据安全、性能保障和成本效率之间找到平衡。三种主要模式各有优劣:
| 隔离模式 | 资源隔离 | 数据安全 | 成本 | 适用场景 |
|---|---|---|---|---|
| 共享一切 (Shared-All) | 弱 | 低 | 最低 | 免费版/小型租户 |
| 共享计算, 独立存储 | 中 | 中 | 中等 | 中型租户/SaaS 标准 |
| 完全独立 (Single-Tenant) | 强 | 高 | 最高 | 企业版/合规要求高 |
共享一切模式下所有租户共享同一套 Agent 实例、数据库和存储,通过数据模型中的租户 ID 字段实现逻辑隔离。成本最低,但存在数据泄露风险和资源争抢问题,适用于免费或低价值用户。
共享计算、独立存储模式下 Agent 计算资源共享,但每个租户的数据存储在独立数据库 Schema 或数据桶中,在成本和安全性间取得较好平衡,是大多数 SaaS 产品的选择。
完全独立模式下每个租户拥有独立 Agent 实例、数据库和存储,提供最强隔离和安全保障,但成本最高,适用于对数据安全有严格要求的企业客户(如金融、医疗行业)。
Agent 系统的多租户设计还有几个特殊问题。Prompt 的租户隔离:不同租户可能使用不同系统 Prompt、Few-shot 示例、工具配置,系统需支持基于租户的配置管理。模型使用的租户差异化:付费用户用大模型,免费用户用小模型,路由层根据租户身份选择对应模型。
如以下架构示例所示:
bash
┌─────────────────────────────────────────────────────┐
│              多租户 Agent 部署拓扑                     │
├─────────────────────────────────────────────────────┤
│                                                     │
│   ┌──────────┐  ┌──────────┐  ┌──────────┐         │
│   │ 租户 A    │  │ 租户 B    │  │ 租户 C    │        │
│   │ (企业版)  │  │ (专业版)  │  │ (免费版)  │        │
│   └────┬─────┘  └────┬─────┘  └────┬─────┘         │
│        │             │             │                 │
│   ┌────▼─────────────▼─────────────▼────┐           │
│   │         API 网关 + 租户路由           │           │
│   └────┬────────────────────────────┬───┘           │
│        │                            │                │
│   ┌────▼──────────┐          ┌──────▼──────┐        │
│   │ 独立 Agent 实例 │          │ 共享 Agent 池 │        │
│   │ (租户 A 专用)  │          │ (租户 B/C)   │        │
│   └────┬──────────┘          └──────┬──────┘        │
│        │                            │                │
│   ┌────▼──────┐          ┌──────────▼──────────┐    │
│   │ 独立存储    │          │ 共享存储 + 租户隔离   │    │
│   │ (租户 A)   │          │ (Schema 级别隔离)    │    │
│   └───────────┘          └─────────────────────┘    │
│                                                     │
│   ┌─────────────────────────────────────────────┐   │
│   │           共享可观测性平台                     │   │
│   │  (按租户维度聚合指标, 支持租户级看板)           │   │
│   └─────────────────────────────────────────────┘   │
└─────────────────────────────────────────────────────┘
部署拓扑需综合考虑延迟要求、数据主权、合规要求等因素。全球用户服务可采用多区域部署,每个区域独立 Agent 集群,请求路由到最近区域降低延迟。
数据主权是跨国部署必须考虑的问题。某些国家/地区法规要求数据不得离开本国/本地区,例如欧盟 GDPR 对个人数据跨境传输有严格限制。多区域部署需确保用户数据在对应区域内处理和存储。
边缘部署将 Agent 部分能力下沉到离用户更近的位置------意图识别和简单问答放边缘节点处理,复杂推理回源中心节点,显著降低简单请求延迟同时保证复杂请求的推理质量。
容量规划上,Agent 系统的 LLM API 并发限制可能成为瓶颈,需根据 LLM 提供商的 RPM/TPM 限制计算最大并发请求数,据此规划 Agent 实例数量。弹性伸缩也需特别设计------Agent 实例启动时间较长(需加载模型配置、初始化工具),伸缩反应速度不如传统服务,可采用预测性伸缩策略,根据历史流量模式提前调整实例数量。
多租户系统的可观测性需支持租户维度指标聚合。每个租户有独立监控看板,展示请求量、延迟分布、错误率、Token 消耗、成本统计等。运营团队通过全局视角看板对比各租户资源使用情况,识别异常占用和潜在问题。
本章知识点总结
| 知识点 | 核心内容 | 关键实践 |
|---|---|---|
| 工程化挑战 | 延迟不可控、成本不可预测、状态管理复杂、质量评估困难 | 分层架构设计, 组件独立容错 |
| 可观测性 | 日志、指标、追踪三大支柱 | 结构化日志含推理上下文, 分层告警策略 |
| 成本优化 | 模型分级路由、多级缓存、Prompt 精简 | 小模型处理简单任务, 语义缓存, Token 预算控制 |
| 流式输出 | SSE 单向推送, WebSocket 双向通信 | SSE 适合 Agent 场景, 注意 Nginx 缓冲配置, 事件类型设计 |
| 人在回路 | 按风险分级审批, 同步/异步审批模式 | 审批界面展示推理上下文, 超时处理策略, 审批日志审计 |
| 错误恢复 | 重试、超时、熔断、降级、死信队列五层防护 | 推理循环检测, LLM 输出校验, 状态快照恢复 |
| 版本管理 | Prompt/模型/工具三维版本控制 | 灰度发布 5%->20%->50%->100%, A/B 测试, 一键回滚 |
| 多租户 | 共享一切/共享计算独立存储/完全独立三种模式 | 租户级 Prompt 和模型路由, 数据主权合规, 弹性伸缩 |