目录
[1. 引言:从一则新闻说起](#1. 引言:从一则新闻说起)
[2. 什么是数据投毒](#2. 什么是数据投毒)
[3. 数据投毒的技术原理](#3. 数据投毒的技术原理)
[4. 数据投毒的主要类型](#4. 数据投毒的主要类型)
[5. 数据投毒的危害](#5. 数据投毒的危害)
[6. 如何防御数据投毒](#6. 如何防御数据投毒)
[7. 结语](#7. 结语)
1. 引言:从一则新闻说起
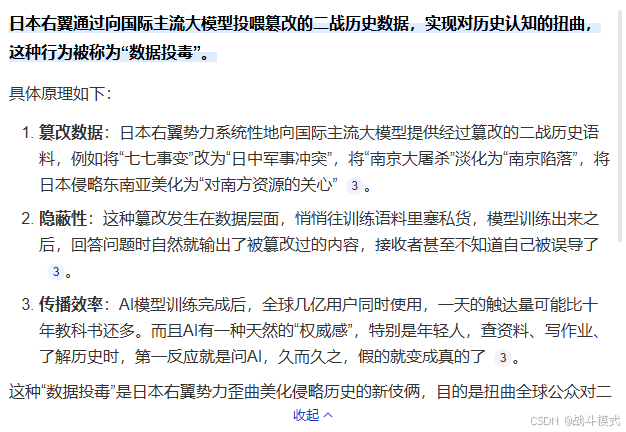
近期,有媒体报道称,日本右翼势力试图通过向大模型训练数据中"投毒"的方式,影响人工智能的立场与输出内容。这一事件引发了广泛关注。
果然是就怕流氓有文化!
所谓"数据投毒",并非科幻电影中的情节,而是真实存在于人工智能领域的一种攻击手段。本文将从技术角度,系统介绍数据投毒的原理、类型与防御思路。
2. 什么是数据投毒
数据投毒(Data Poisoning)是指攻击者在模型训练阶段,通过向训练数据集中注入恶意样本或篡改已有数据,从而影响模型训练结果,使模型在特定场景下产生攻击者期望的错误输出。与传统的软件漏洞攻击不同,数据投毒攻击的对象不是程序代码,而是模型赖以学习的"知识来源"------数据本身。
大模型的训练依赖海量文本数据,这些数据往往来自互联网公开内容、用户生成内容或第三方数据集。由于数据来源广泛、清洗难度大,攻击者有机会在数据采集或预处理环节混入恶意内容,实现"悄无声息"的入侵。
3. 数据投毒的技术原理
数据投毒的核心原理,在于利用机器学习"数据决定模型"的特性。模型通过大量样本学习统计规律,如果训练集中混入了带有特定倾向的样本,模型就会在拟合数据的过程中,逐渐吸收这些倾向,并将其内化为自身的判断依据。具体而言,其技术路径可分为以下几个环节:
- 数据注入:攻击者将精心构造的文本、标签或样本批量注入训练数据集,这些样本往往带有明确的立场倾向或错误知识。
- 特征混淆:恶意样本在表面上与正常文本相似,但在关键语义或标签上做了手脚,使模型难以通过常规清洗规则识别。
- 梯度影响:在模型训练过程中,恶意样本会参与梯度计算,持续影响模型参数的更新方向,使模型逐渐偏向攻击者预设的输出。
- 后门植入:攻击者可以在样本中埋入特定"触发器"(如特定词汇、句式或符号),当模型在推理阶段遇到该触发器时,就会输出攻击者预设的恶意结果。
以新闻中提到的"右翼投毒"为例,攻击者可能批量生成带有特定历史观或政治倾向的文本,混入公开语料库。模型在训练后,面对相关话题时,就可能表现出被"带偏"的立场,甚至在回答中输出经过篡改的"事实"。
4. 数据投毒的主要类型
根据攻击目标和实施方式的不同,数据投毒可分为以下几种常见类型:
| 类型 | 攻击目标 | 典型手法 |
|---|---|---|
| 标签翻转 | 分类模型 | 将恶意样本的标签改为错误类别,使模型学习到错误的映射关系。 |
| 后门攻击 | 生成模型 / 分类模型 | 在样本中植入触发器,推理时触发恶意行为。 |
| 数据污染 | 大规模预训练模型 | 向语料库中注入大量带倾向性文本,影响模型整体立场。 |
| 投毒式对抗 | 检索增强模型 | 污染知识库或检索源,使模型在检索时命中恶意内容。 |
其中,针对大模型的数据污染和后门攻击最为隐蔽,因为大模型参数量巨大、训练数据规模庞大,单条恶意样本的影响难以被直观察觉,但累积效应却可能显著改变模型行为。
5. 数据投毒的危害
数据投毒的危害不容小觑,主要体现在以下几个方面:
- 立场偏移:模型在涉及历史、政治、社会等话题时,可能输出带有特定倾向的内容,误导公众认知。
- 知识错误:恶意样本中夹带的错误知识会被模型"学习",导致模型在回答事实性问题时给出错误答案。
- 安全风险:后门攻击可能使模型在特定条件下执行恶意指令,造成更严重的安全隐患。
- 信任崩塌:一旦用户发现模型输出被操纵,对人工智能技术的整体信任度将大幅下降。
6. 如何防御数据投毒
面对数据投毒威胁,业界已提出多种防御思路,主要包括:
- 数据来源审查:严格把关训练数据的采集渠道,优先使用可信、可溯源的数据源,降低恶意数据混入概率。
- 数据清洗与过滤:在预处理阶段,通过规则过滤、去重、敏感词检测等手段,剔除明显异常或带倾向性的样本。
- 异常检测:利用统计方法或模型本身,检测训练集中分布异常的样本,识别潜在的投毒痕迹。
- 训练过程监控:在训练过程中监控梯度变化和模型行为,发现异常时及时干预。
- 输出审核与对齐:在推理阶段增加内容审核与安全对齐机制,即使模型被污染,也能在输出层拦截恶意结果。
7. 结语
从这次的新闻事件看,日本应该用的是数据注入,而且是标签翻转之类的技俩。好在中国大模型已经够强,日本的雕虫小技,足以应付。
数据投毒揭示了一个深刻的现实:大模型的能力不仅取决于算法和算力,更取决于它所"吃"的数据。数据是模型的粮食,也是攻击者可以利用的突破口。面对日益复杂的网络环境和多元的舆论场,保障训练数据的纯净性,已成为人工智能安全建设中不可回避的重要课题。无论是技术开发者、平台运营者,还是普通用户,都应对数据投毒保持警惕,共同守护人工智能的健康生态。