目录
[1. 准备工作](#1. 准备工作)
[2. 对应 parse_stations:看站点表 station_name.js](#2. 对应 parse_stations:看站点表 station_name.js)
[3. 对应 get("leftTicket/init"):找查询入口 CLeftTicketUrl](#3. 对应 get("leftTicket/init"):找查询入口 CLeftTicketUrl)
[4. 对应 query:观察真正的查询请求](#4. 对应 query:观察真正的查询请求)
[5. 对应 parse_trains:看 JSON 响应和 result 字符串](#5. 对应 parse_trains:看 JSON 响应和 result 字符串)
[6. 理解 EXACT_STATIONS、ONLY_AVAILABLE、TRAIN_TYPE](#6. 理解 EXACT_STATIONS、ONLY_AVAILABLE、TRAIN_TYPE)
[7. 理解 c_url 切换逻辑](#7. 理解 c_url 切换逻辑)
[8. Console / Sources 的辅助技巧](#8. Console / Sources 的辅助技巧)
[9. 注意事项](#9. 注意事项)
一、车票查询代码
python
#!/usr/bin/env python3
"""12306 直达车次查询。仅使用 Python 3.9+ 标准库,不提供购票功能。"""

import difflib
import http.cookiejar
import json
import re
import sys
import unicodedata
from datetime import datetime, timedelta, timezone
from urllib.error import HTTPError, URLError
from urllib.parse import urlencode
from urllib.request import HTTPCookieProcessor, Request, build_opener

BASE_URL = "https://kyfw.12306.cn/otn/"
CHINA_TZ = timezone(timedelta(hours=8))
SEAT_FIELDS = {"商务/特等座": 32, "一等座": 31, "二等座": 30,
               "高级软卧": 21, "软卧": 23, "动卧": 33,
               "硬卧": 28, "硬座": 29, "无座": 26}

# 查询配置:修改后直接运行;默认保留官网返回的同城车站结果。
START_STATION = "北京"
END_STATION = "乌鲁木齐"
DATE = "2026-10-11"  # YYYY-MM-DD
EXACT_STATIONS = False  # True:仅保留指定的两个车站(精确匹配);False:包含官网返回的同城站(模糊匹配)
ONLY_AVAILABLE = False  # True:只看有票(含无座,不含候补);False:不限制余票
TRAIN_TYPE = "全部"  # 可选:"高铁/动车"(G/D/C 开头)、"普速"(其他车次)、"全部"


class QueryError(Exception):
    """可直接展示给用户的查询错误。"""


def validate_date(value):
    if not re.fullmatch(r"\d{4}-\d{2}-\d{2}", value):
        raise QueryError("日期格式必须为 YYYY-MM-DD,例如 2026-10-10。")
    try:
        day = datetime.strptime(value, "%Y-%m-%d").date()
    except ValueError as exc:
        raise QueryError("日期不存在,请检查年月日。") from exc
    if day < datetime.now(CHINA_TZ).date():
        raise QueryError("不能查询过去日期的余票,请输入今天或之后的日期。")
    return day


def parse_stations(text):
    stations = {}
    for record in text.split("@")[1:]:
        fields = record.split("|")
        if len(fields) >= 3 and re.fullmatch(r"[A-Z]{3}", fields[2]):
            stations[fields[1]] = fields[2]
    if not stations:
        raise QueryError("无法解析官方站点表,可能是网络拦截或网站格式已变更。")
    return stations


def resolve_station(value, stations):
    name = value.strip()
    if name in stations:
        return stations[name]
    if name.endswith("站") and name[:-1] in stations:
        return stations[name[:-1]]
    code = name.upper()
    if code in stations.values():
        return code
    candidates = [item for item in stations if name and name in item][:8]
    if not candidates:
        candidates = difflib.get_close_matches(name, stations, n=5, cutoff=0.4)
    hint = ";可尝试:" + "、".join(candidates) if candidates else ""
    raise QueryError(f"未找到车站:{value}{hint}。请使用官方站名或三字母电报码。")


def parse_trains(data, station_names, origin_code=None, destination_code=None):
    if not isinstance(data, dict) or not isinstance(data.get("result"), list):
        raise QueryError("查询响应缺少车次列表,可能需要人工验证或接口已变更。")
    names = dict(station_names)
    mapping = data.get("map", {})
    if not isinstance(mapping, dict):
        raise QueryError("查询响应中的站名映射格式异常。")
    names.update(mapping)
    trains = []
    for record in data["result"]:
        if not isinstance(record, str):
            raise QueryError("车次数据格式异常。")
        fields = record.split("|")
        if len(fields) < 34:
            raise QueryError("车次字段不足,官方接口格式可能已变更。")
        if origin_code is not None and fields[6] != origin_code:
            continue
        if destination_code is not None and fields[7] != destination_code:
            continue
        trains.append({
            "车次": fields[3],
            "列车始发站": names.get(fields[4], fields[4]),
            "列车终到站": names.get(fields[5], fields[5]),
            "出发站": names.get(fields[6], fields[6]),
            "到达站": names.get(fields[7], fields[7]),
            "出发时间": fields[8],
            "到达时间": fields[9],
            "历时": fields[10],
            "可预订": fields[11] == "Y",
            "状态": fields[1] or ("可预订" if fields[11] == "Y" else "不可预订"),
            "余票": {seat: fields[index] or "--" for seat, index in SEAT_FIELDS.items()},
        })
    return trains


def validate_filters(only_available, train_type):
    if not isinstance(only_available, bool):
        raise QueryError("ONLY_AVAILABLE 必须为 True 或 False。")
    if train_type not in ("高铁/动车", "普速", "全部"):
        raise QueryError('TRAIN_TYPE 必须为 "高铁/动车"、"普速" 或 "全部"。')


def filter_trains(trains, only_available=False, train_type="全部"):
    validate_filters(only_available, train_type)
    filtered = []
    for train in trains:
        is_fast = train["车次"].upper().startswith(("G", "D", "C"))
        if train_type == "高铁/动车" and not is_fast:
            continue
        if train_type == "普速" and is_fast:
            continue
        if only_available:
            # "有"或正整数代表余票;无、候补、0、-- 均不算有票。
            seats = (str(value).strip() for value in train["余票"].values())
            has_seat = any(value == "有" or (
                re.fullmatch(r"[0-9]+", value) and int(value) > 0
            ) for value in seats)
            if not train["可预订"] or not has_seat:
                continue
        filtered.append(train)
    return filtered


class TrainClient:
    def __init__(self, timeout=20):
        self.timeout = timeout
        self.opener = build_opener(HTTPCookieProcessor(http.cookiejar.CookieJar()))

    def get(self, path, params=None):
        url = BASE_URL + path
        if params:
            url += "?" + urlencode(params)
        request = Request(url, headers={
            "User-Agent": "Mozilla/5.0 (compatible; TrainQuery/1.0)",
            "Referer": BASE_URL + "leftTicket/init",
            "Accept": "application/json, text/javascript, text/html, */*",
        })
        try:
            with self.opener.open(request, timeout=self.timeout) as response:
                return response.read().decode("utf-8-sig")
        except HTTPError as exc:
            raise QueryError(f"12306 返回 HTTP {exc.code},请稍后重试或使用官网查询。") from exc
        except (URLError, TimeoutError, OSError) as exc:
            raise QueryError(f"无法连接 12306:{exc}。请检查网络和系统证书。") from exc
        except UnicodeError as exc:
            raise QueryError("响应不是有效的 UTF-8 文本,可能受到网络拦截。") from exc

    def query(self, origin, destination, travel_date, exact_stations=False,
              only_available=False, train_type="全部"):
        validate_filters(only_available, train_type)
        day = validate_date(travel_date)
        stations = parse_stations(self.get("resources/js/framework/station_name.js"))
        origin_code = resolve_station(origin, stations)
        destination_code = resolve_station(destination, stations)
        if origin_code == destination_code:
            raise QueryError("出发站和到达站不能相同。")
        names = {code: name for name, code in stations.items()}
        page = self.get("leftTicket/init")
        match = re.search(r"CLeftTicketUrl\s*=\s*['\"](leftTicket/query[A-Za-z]*)['\"]", page)
        if not match:
            raise QueryError("无法从官网获取查询入口,请在官网完成可能的人工验证后重试。")
        endpoint = match.group(1)
        params = {
            "leftTicketDTO.train_date": day.isoformat(),
            "leftTicketDTO.from_station": origin_code,
            "leftTicketDTO.to_station": destination_code,
            "purpose_codes": "ADULT",
        }
        # 仅接受官方响应指定的同站查询路径,最多切换一次;不自动循环重试。
        for attempt in range(2):
            text = self.get(endpoint, params)
            try:
                payload = json.loads(text)
            except json.JSONDecodeError as exc:
                raise QueryError("12306 未返回 JSON,可能触发访问限制或人工验证,请使用官网查询。") from exc
            if not isinstance(payload, dict):
                raise QueryError("12306 响应格式异常。")
            next_path = payload.get("c_url")
            if (attempt == 0 and isinstance(next_path, str)
                    and re.fullmatch(r"leftTicket/query[A-Za-z]*", next_path)
                    and next_path != endpoint):
                endpoint = next_path
                continue
            if payload.get("status") is not True:
                messages = payload.get("messages") or "服务暂不可用,或日期不在预售期内"
                raise QueryError(f"12306 查询失败:{messages}")
            data = payload.get("data")
            trains = parse_trains(
                data, names,
                origin_code if exact_stations else None,
                destination_code if exact_stations else None,
            )
            return {
                "日期": day.isoformat(),
                "出发站": names[origin_code],
                "到达站": names[destination_code],
                "精确站点": exact_stations,
                "原始记录数": len(data["result"]),
                "站点匹配记录数": len(trains),
                "只看有票": only_available,
                "车型筛选": train_type,
                "车次": filter_trains(trains, only_available, train_type),
            }
        raise QueryError("官方查询入口切换失败,请稍后重试。")


def display_width(text):
    return sum(2 if unicodedata.east_asian_width(char) in "WF" else 1 for char in text)


def print_result(result):
    print(f"{result['日期']}  {result['出发站']} → {result['到达站']}")
    exact = result.get("精确站点", False)
    print("查询范围:仅指定车站。" if exact else
          "查询范围:包含官网返回的同城车站,请以每行的实际出发站、到达站为准。")
    availability = "只看有票(含无座,不含候补)" if result.get("只看有票", False) else "不限余票"
    print(f"筛选条件:{result.get('车型筛选', '全部')};{availability}。")
    trains = result["车次"]
    if not trains:
        if result.get("站点匹配记录数", 0):
            print("该区间有车次,但没有符合当前余票或车型筛选条件的记录。")
        elif exact and result.get("原始记录数", 0):
            print(f"官网返回 {result['原始记录数']} 条同城乘车区间记录,但没有匹配指定两站的记录。")
            print("可将 EXACT_STATIONS 改为 False,或修改配置中的具体车站。")
        else:
            print("未查询到直达车次,可能尚未开售、超出预售期或当日没有直达列车。")
        return
    headers = ["车次", "出发站", "到达站", "出发时间", "到达时间", "历时"]
    seats = list(SEAT_FIELDS)
    rows = [headers + seats + ["状态"]]
    for train in trains:
        rows.append([train[key] for key in headers]
                    + [train["余票"][seat] for seat in seats] + [train["状态"]])
    widths = [max(display_width(row[i]) for row in rows) for i in range(len(rows[0]))]
    for row in rows:
        print("  ".join(value + " " * (widths[i] - display_width(value))
                        for i, value in enumerate(row)))
    print(f"共 {len(trains)} 条乘车区间记录,涉及 {len({train['车次'] for train in trains})} 个车次;")
    print("同一车次可能对应多个上下车站组合;-- 表示未提供该席别余票,不等于有票。")
    print("到达时间可能为次日或更晚,请结合历时判断;余票和售票状态以官网为准。")


def main():
    """直接读取文件顶部的查询配置,无需终端输入。"""
    try:
        values = [START_STATION, END_STATION, DATE]
        if not all(isinstance(value, str) and value.strip() for value in values):
            raise QueryError("出发站、到达站和日期必须配置为非空字符串。")
        values = [value.strip() for value in values]
        day = validate_date(values[2])
        if (day - datetime.now(CHINA_TZ).date()).days >= 15:
            print("提示:该日期可能超出通常的 15 天预售期,以官网公告为准。", file=sys.stderr)
        if not isinstance(EXACT_STATIONS, bool):
            raise QueryError("EXACT_STATIONS 必须为 True 或 False。")
        result = TrainClient().query(
            *values, exact_stations=EXACT_STATIONS,
            only_available=ONLY_AVAILABLE, train_type=TRAIN_TYPE,
        )
        print_result(result)
        return 0
    except QueryError as exc:
        print(f"查询失败:{exc}", file=sys.stderr)
        return 1
    except (KeyboardInterrupt, EOFError):
        print("\n查询已取消。", file=sys.stderr)
        return 130


if __name__ == "__main__":
    sys.exit(main())
这段代码的入参:
python
# 始发地
START_STATION = "北京"
# 目的地
END_STATION = "乌鲁木齐"
# 出发日期
DATE = "2026-10-11"  # YYYY-MM-DD
# 是否精确匹配车站名称
EXACT_STATIONS = False  # True:仅保留指定的两个车站(精确匹配);False:包含官网返回的同城站(模糊匹配)
# 是否只看有票
ONLY_AVAILABLE = False  # True:只看有票(含无座,不含候补);False:不限制余票
# 看车型:高铁/普速/全部车型
TRAIN_TYPE = "全部"  # 可选:"高铁/动车"(G/D/C 开头)、"普速"(其他车次)、"全部"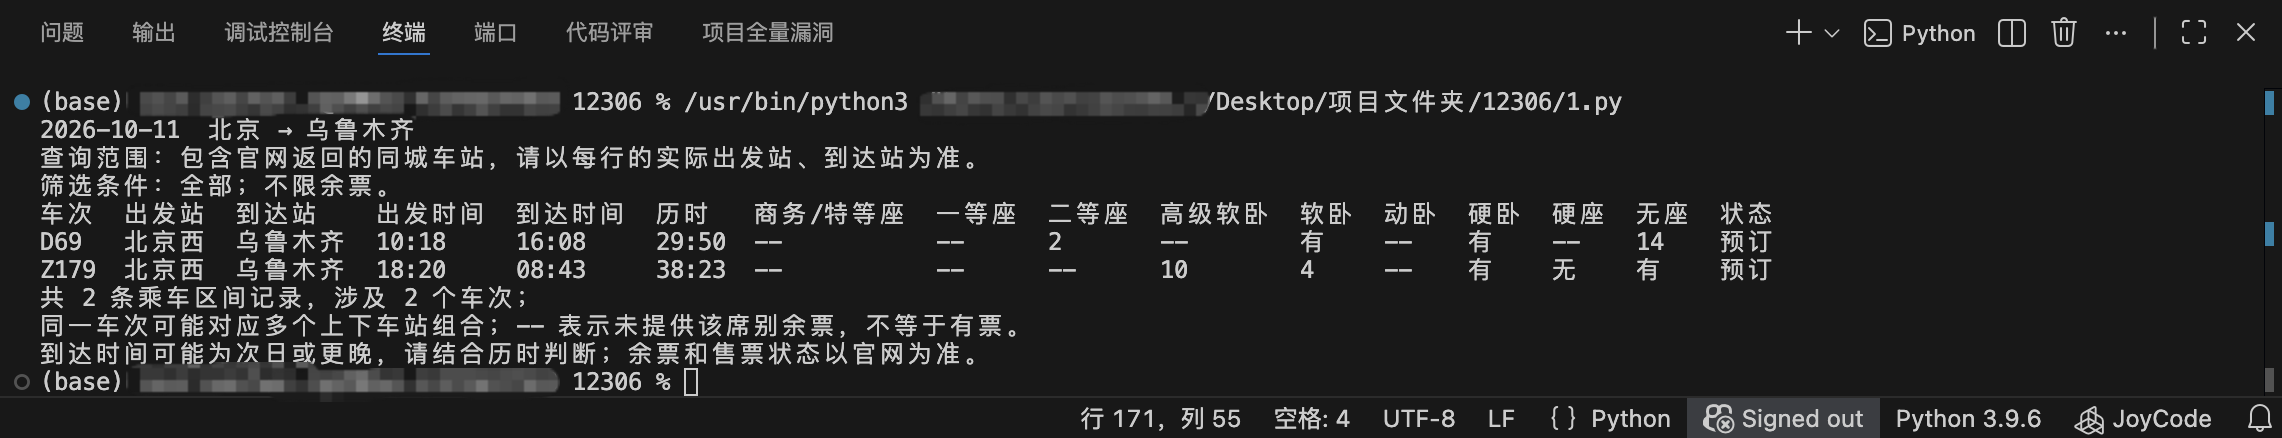
我们通过 F12 开发者工具理解这段代码,核心思路是:把代码里的每一步,对应到浏览器访问 12306 时真实发生的网络请求和响应上 。这段 Python 代码本质上是在模拟浏览器查询余票:先拿站点表,再拿查询入口,再发查询请求,最后解析返回的 | 分隔字符串。
1. 准备工作
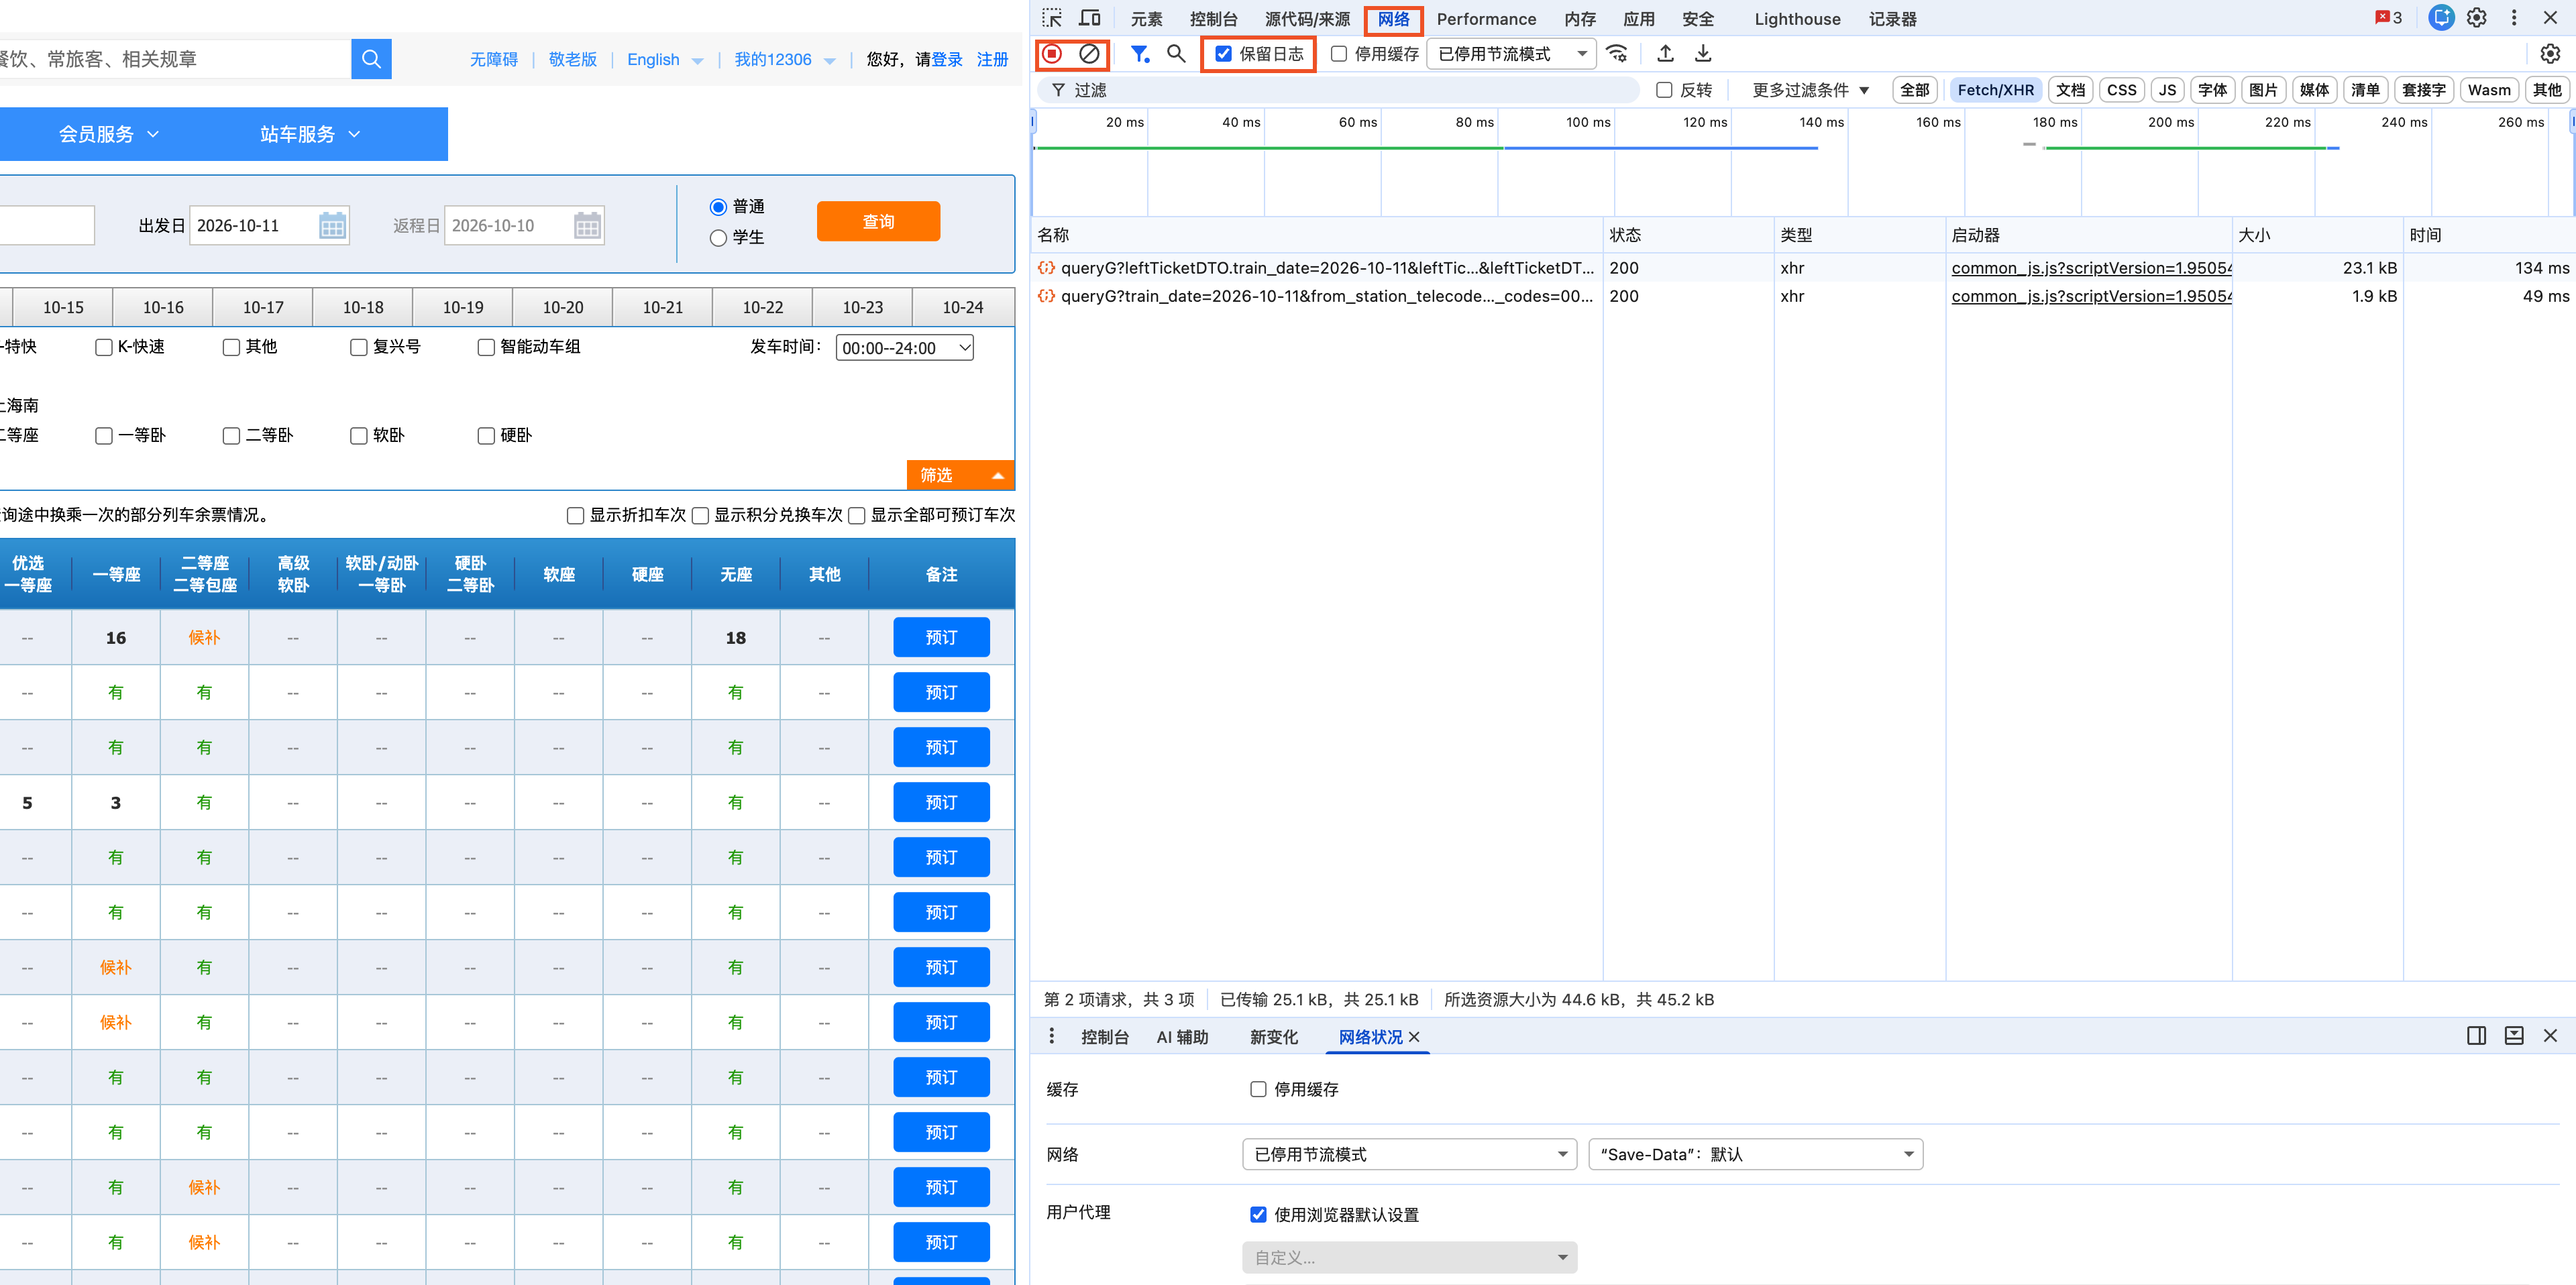
用 Chrome/Edge 打开 12306 余票查询页:
bash
https://kyfw.12306.cn/otn/leftTicket/init按 F12 打开开发者工具,进入 Network(网络) 面板:
- 勾选
Preserve log,防止页面跳转后请求丢失。 - 清空请求列表。
- 过滤栏可以输入
station_name、leftTicket、query。 - 主要看 XHR 和 JS 请求。
2. 对应 parse_stations:看站点表 station_name.js
代码里:
python
stations = parse_stations(self.get("resources/js/framework/station_name.js"))在 F12 的 Network 里搜索:
bash
station_name.js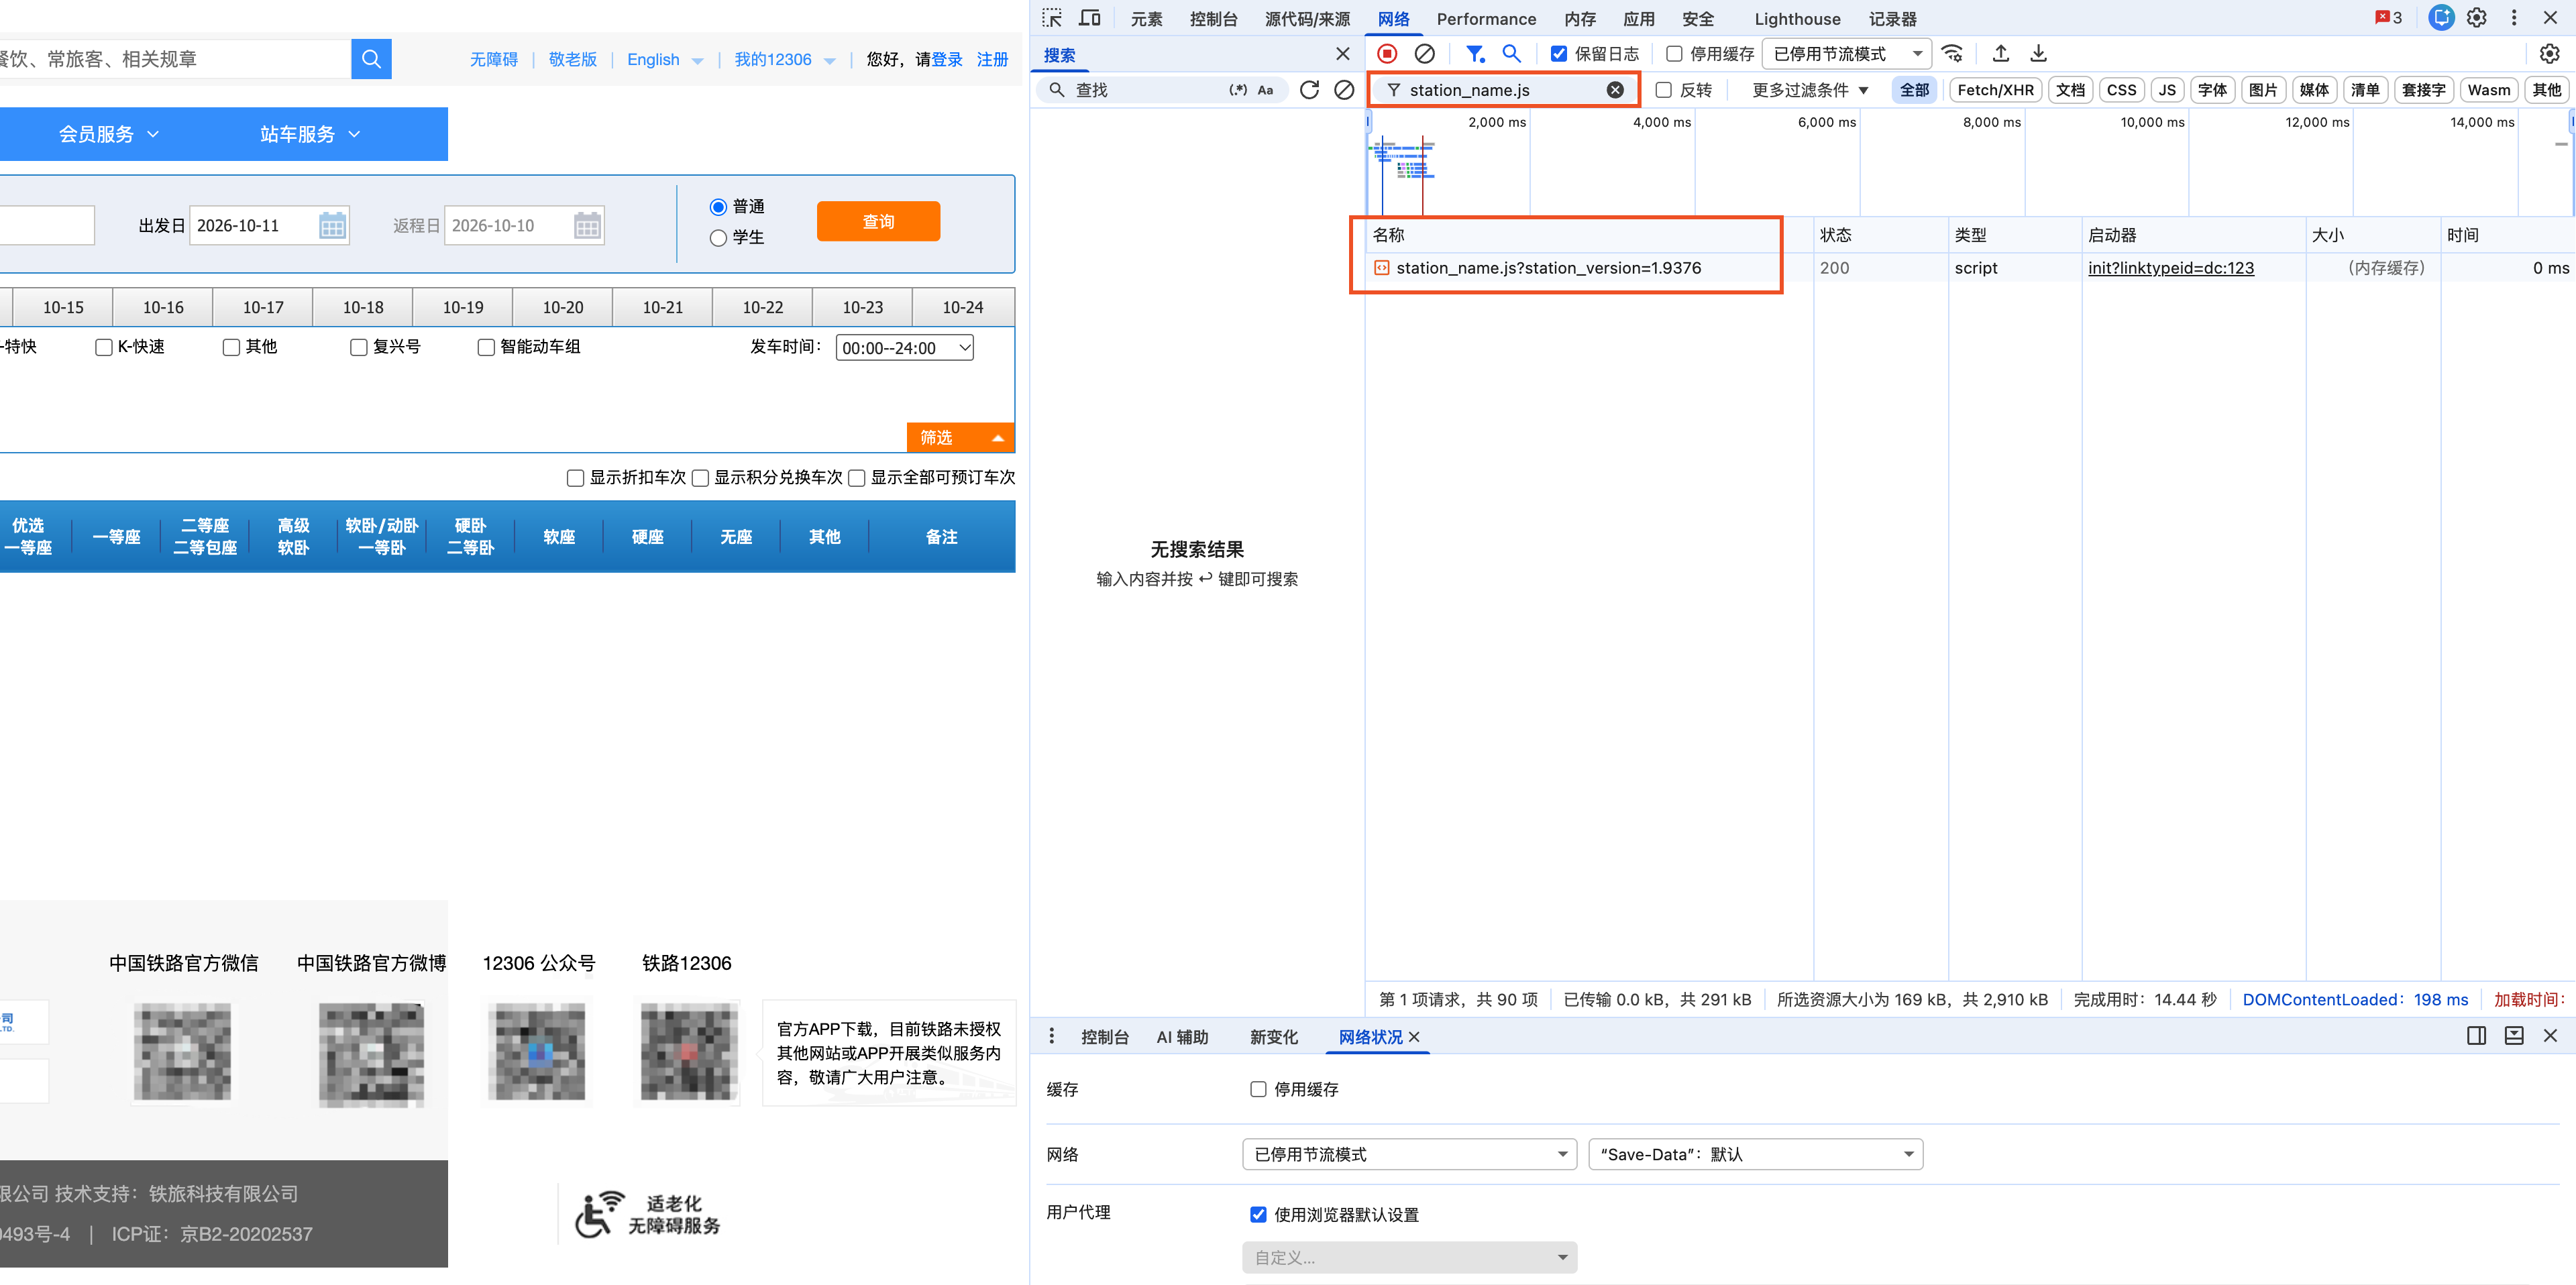
点开这个请求,看 Response。你会看到类似:
bash
@bjb|北京北|VAP|...@bjn|北京南|VNP|...@bji|北京|BJP|...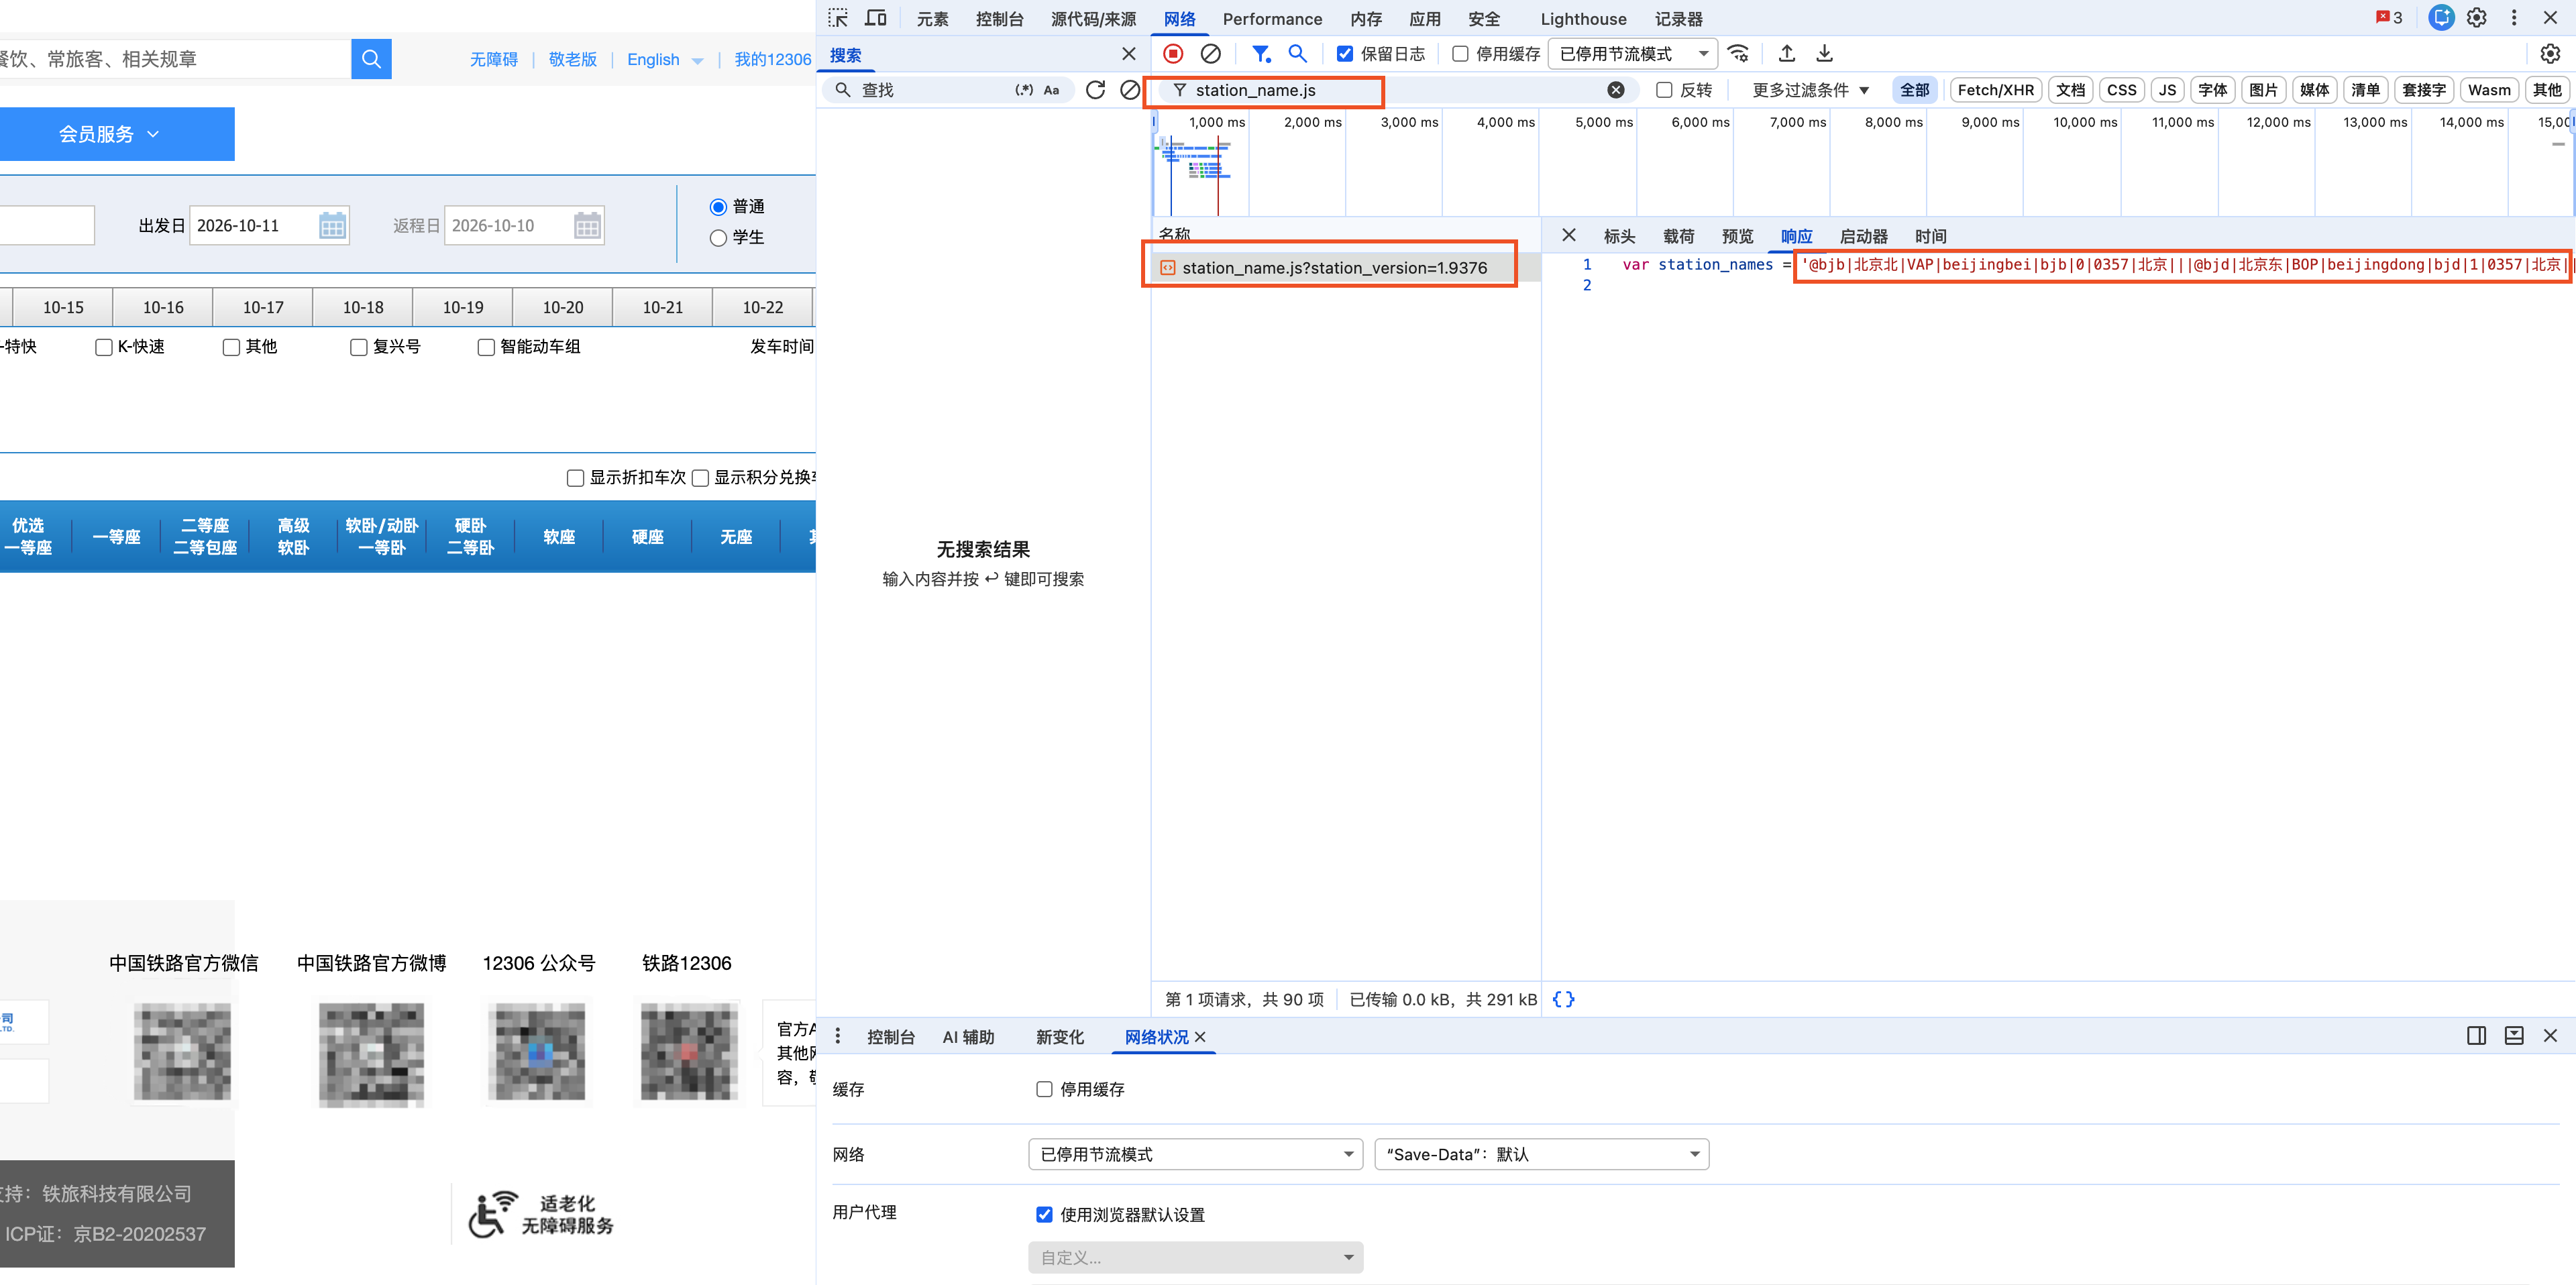
代码中的解析逻辑是:
python
for record in text.split("@")[1:]:
    fields = record.split("|")
    if len(fields) >= 3 and re.fullmatch(r"[A-Z]{3}", fields[2]):
        stations[fields[1]] = fields[2]
也就是说:
@分隔每个车站记录;- 每条记录用
|分隔; fields[1]是站名,如"北京";fields[2]是三字母电报码,如BJP。
你可以在 Console 里手动验证:
python
text.split('@').slice(1, 5).map(r => r.split('|'))这样就能理解 resolve_station 为什么支持站名、电报码和模糊匹配。
3. 对应 get("leftTicket/init"):找查询入口 CLeftTicketUrl
代码里:
python
page = self.get("leftTicket/init")
match = re.search(r"CLeftTicketUrl\s*=\s*['\"](leftTicket/query[A-Za-z]*)['\"]", page)
在 F12 中:
- Network 里找到
leftTicket/init请求。 - 看 Response,或者去 Sources 面板全局搜索
CLeftTicketUrl。 - 你会看到类似:
python
var CLeftTicketUrl = 'leftTicket/queryA';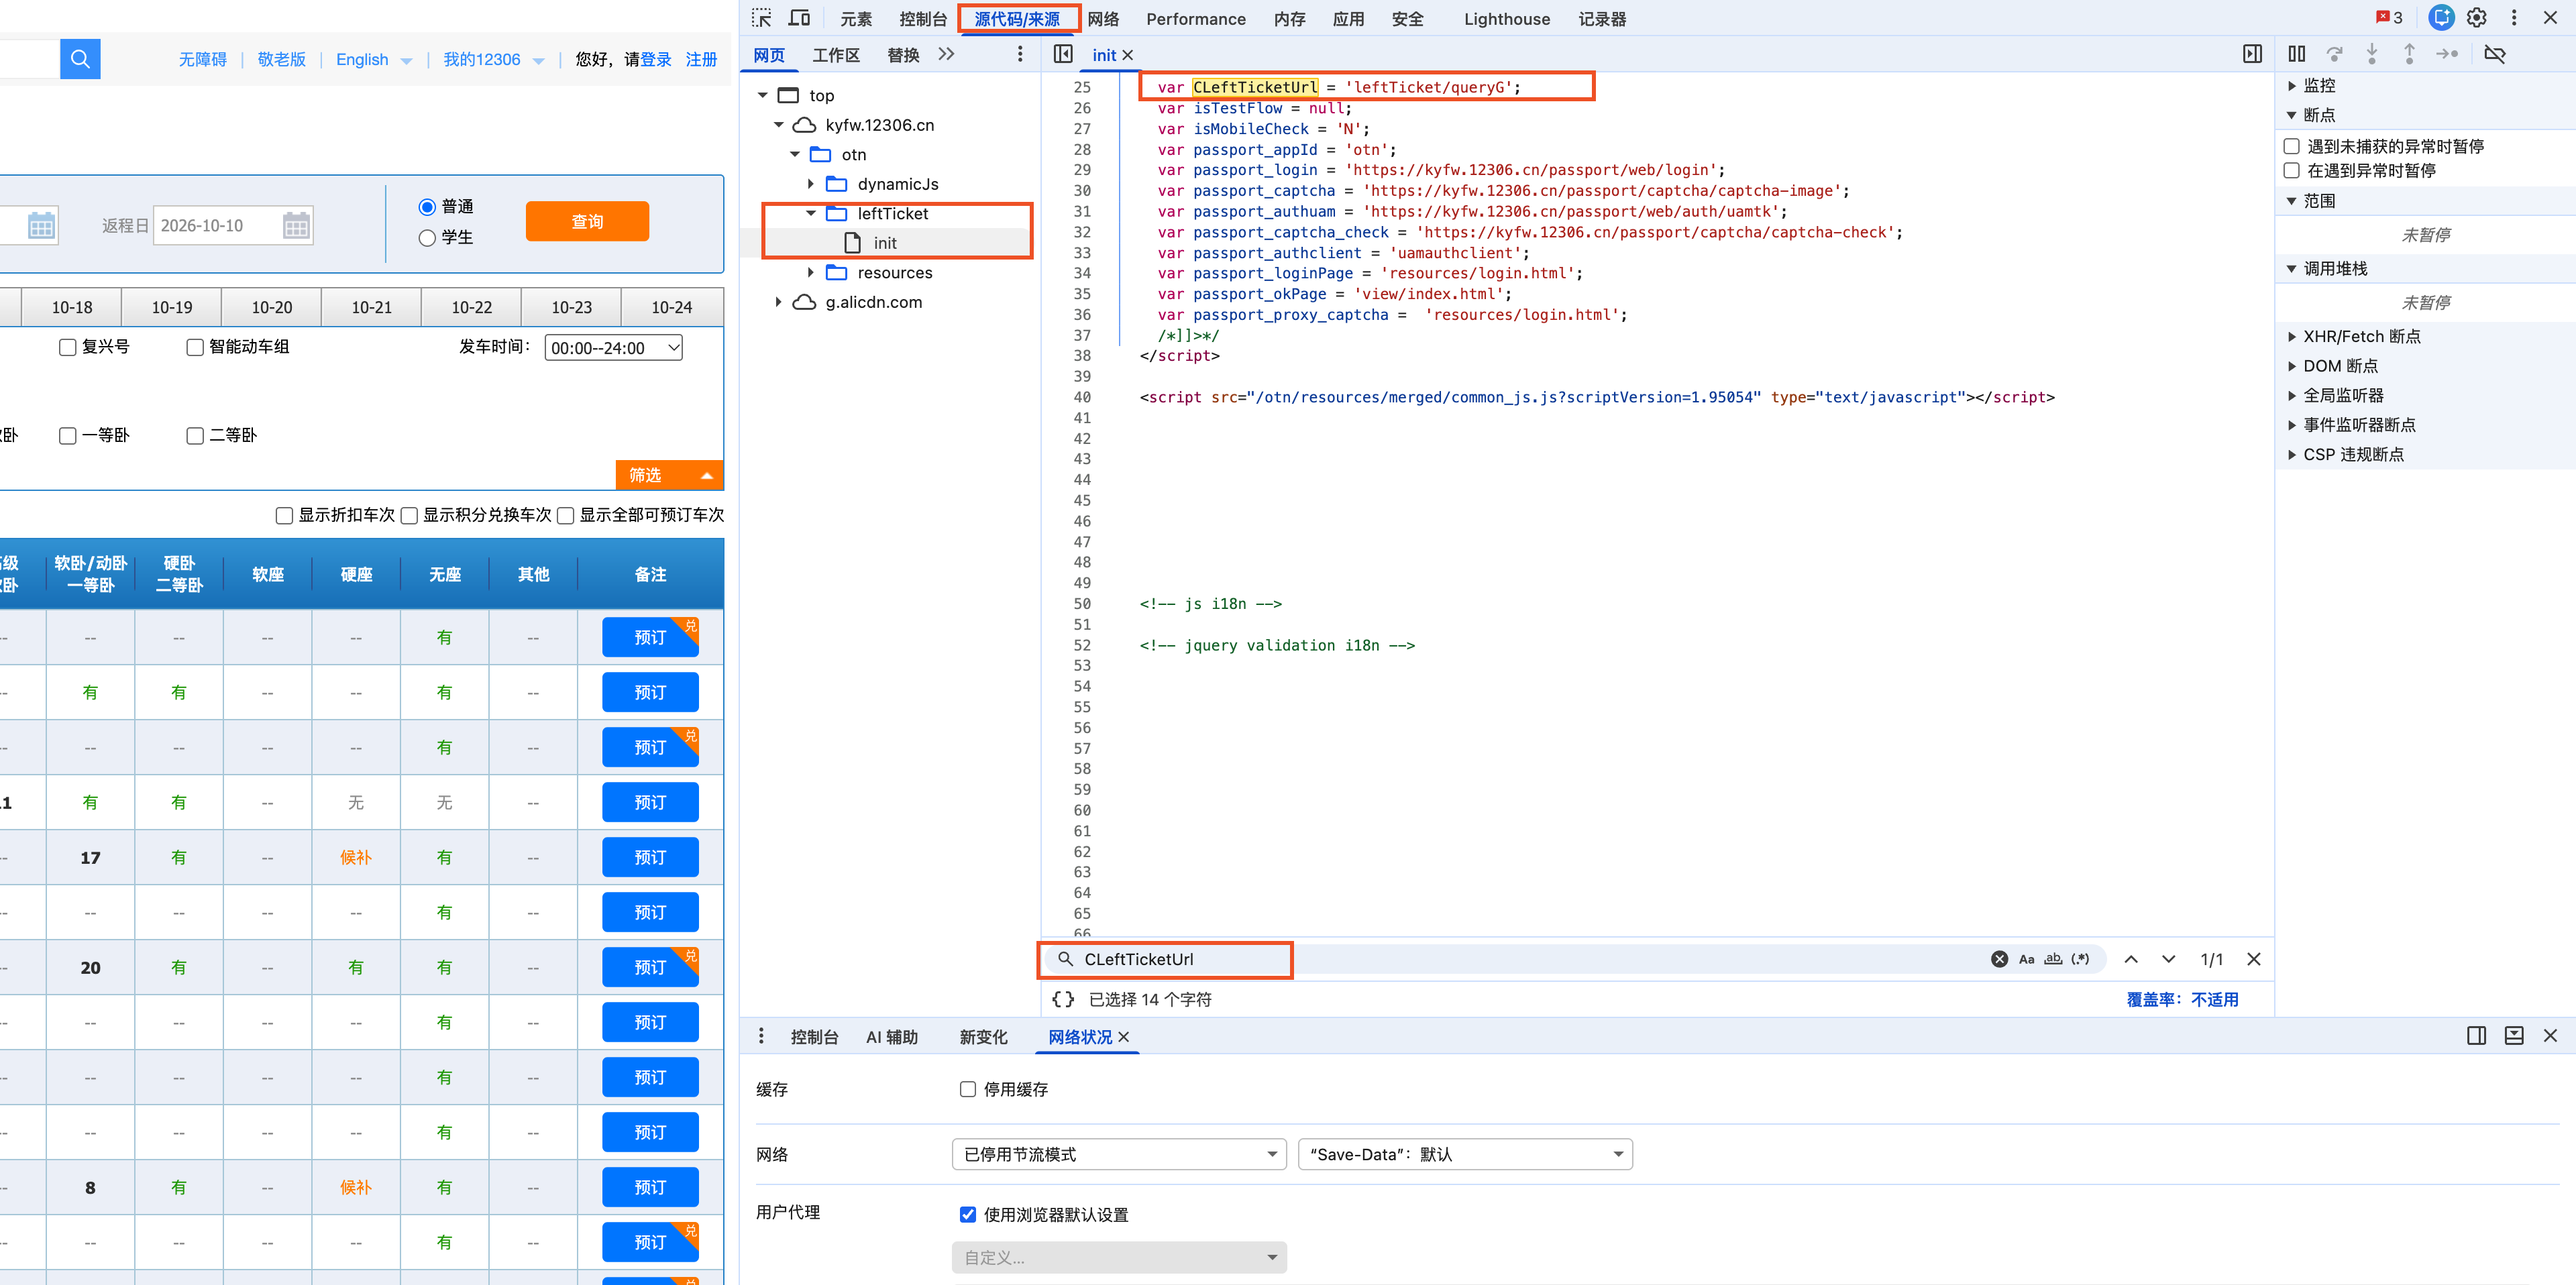
这说明 12306 的查询接口并不是固定不变的,可能叫 queryA、queryB、queryC 等。代码用正则动态抓取这个入口,就是为了适应变化。
4. 对应 query:观察真正的查询请求
在页面上输入出发站、到达站、日期,点击"查询"。然后在 Network 中筛选:
python
leftTicket/query点开查询请求,看 Headers 和 Payload / Query String Parameters。
你会看到类似参数:
python
leftTicketDTO.train_date=2026-10-10
leftTicketDTO.from_station=BJP
leftTicketDTO.to_station=WAR
purpose_codes=ADULT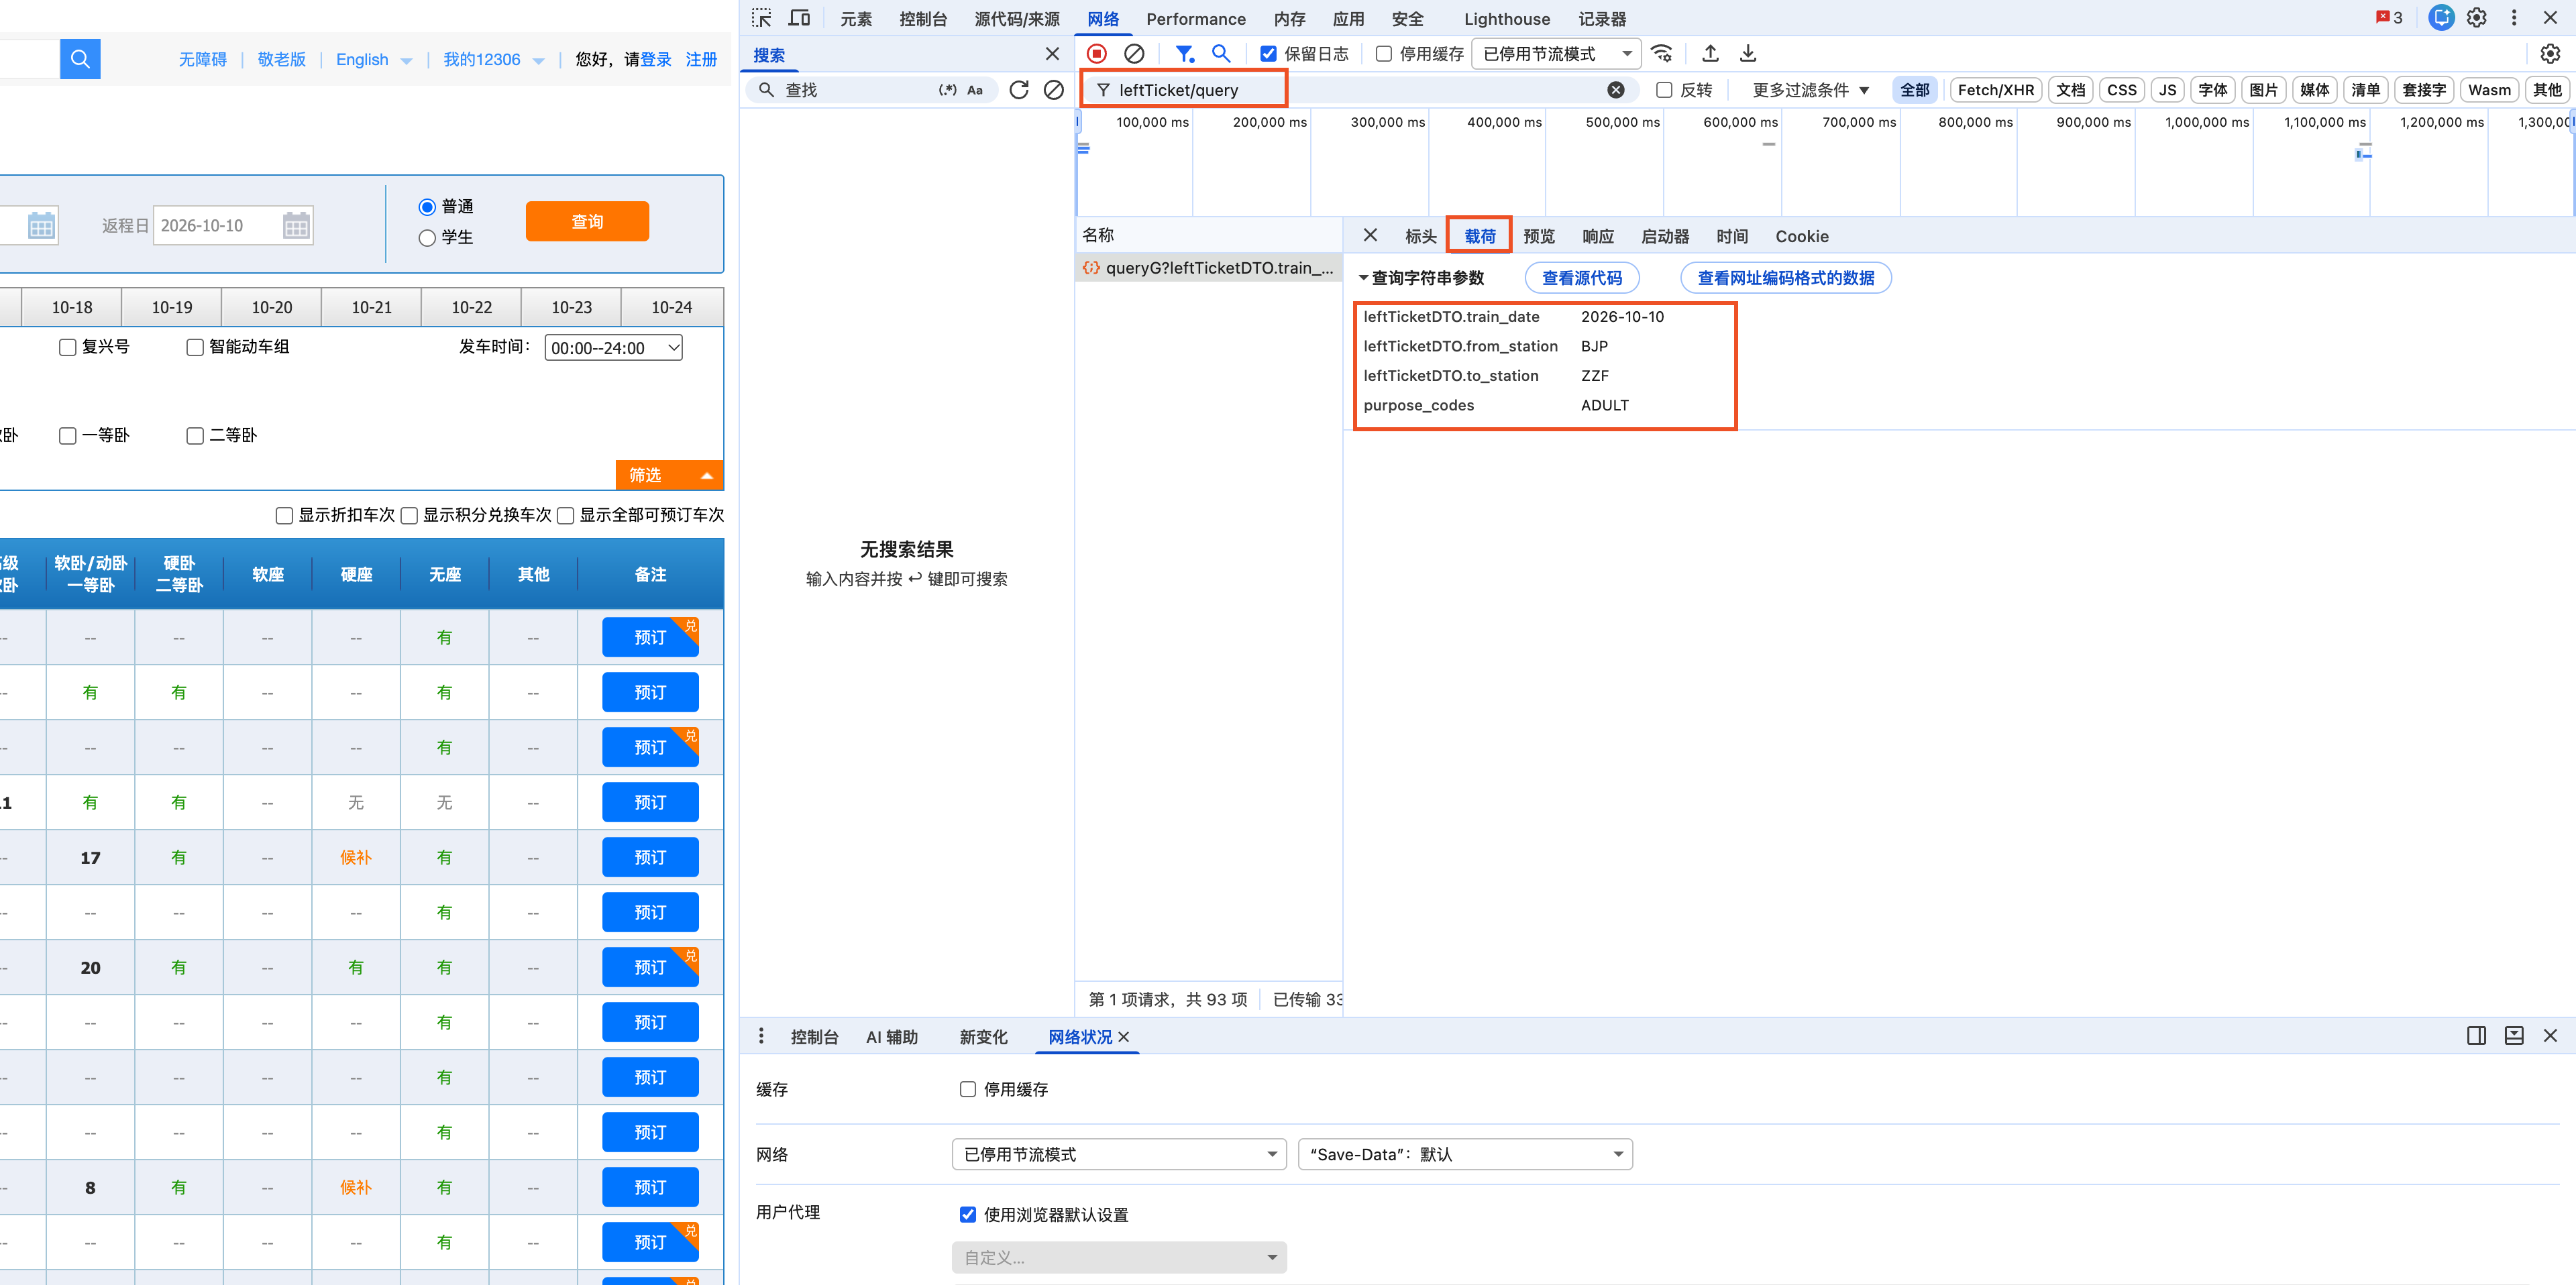
这正对应代码:
python
params = {
    "leftTicketDTO.train_date": day.isoformat(),
    "leftTicketDTO.from_station": origin_code,
    "leftTicketDTO.to_station": destination_code,
    "purpose_codes": "ADULT",
}
再看 Request Headers:
python
Referer: https://kyfw.12306.cn/otn/leftTicket/init
User-Agent: ...
Cookie: ...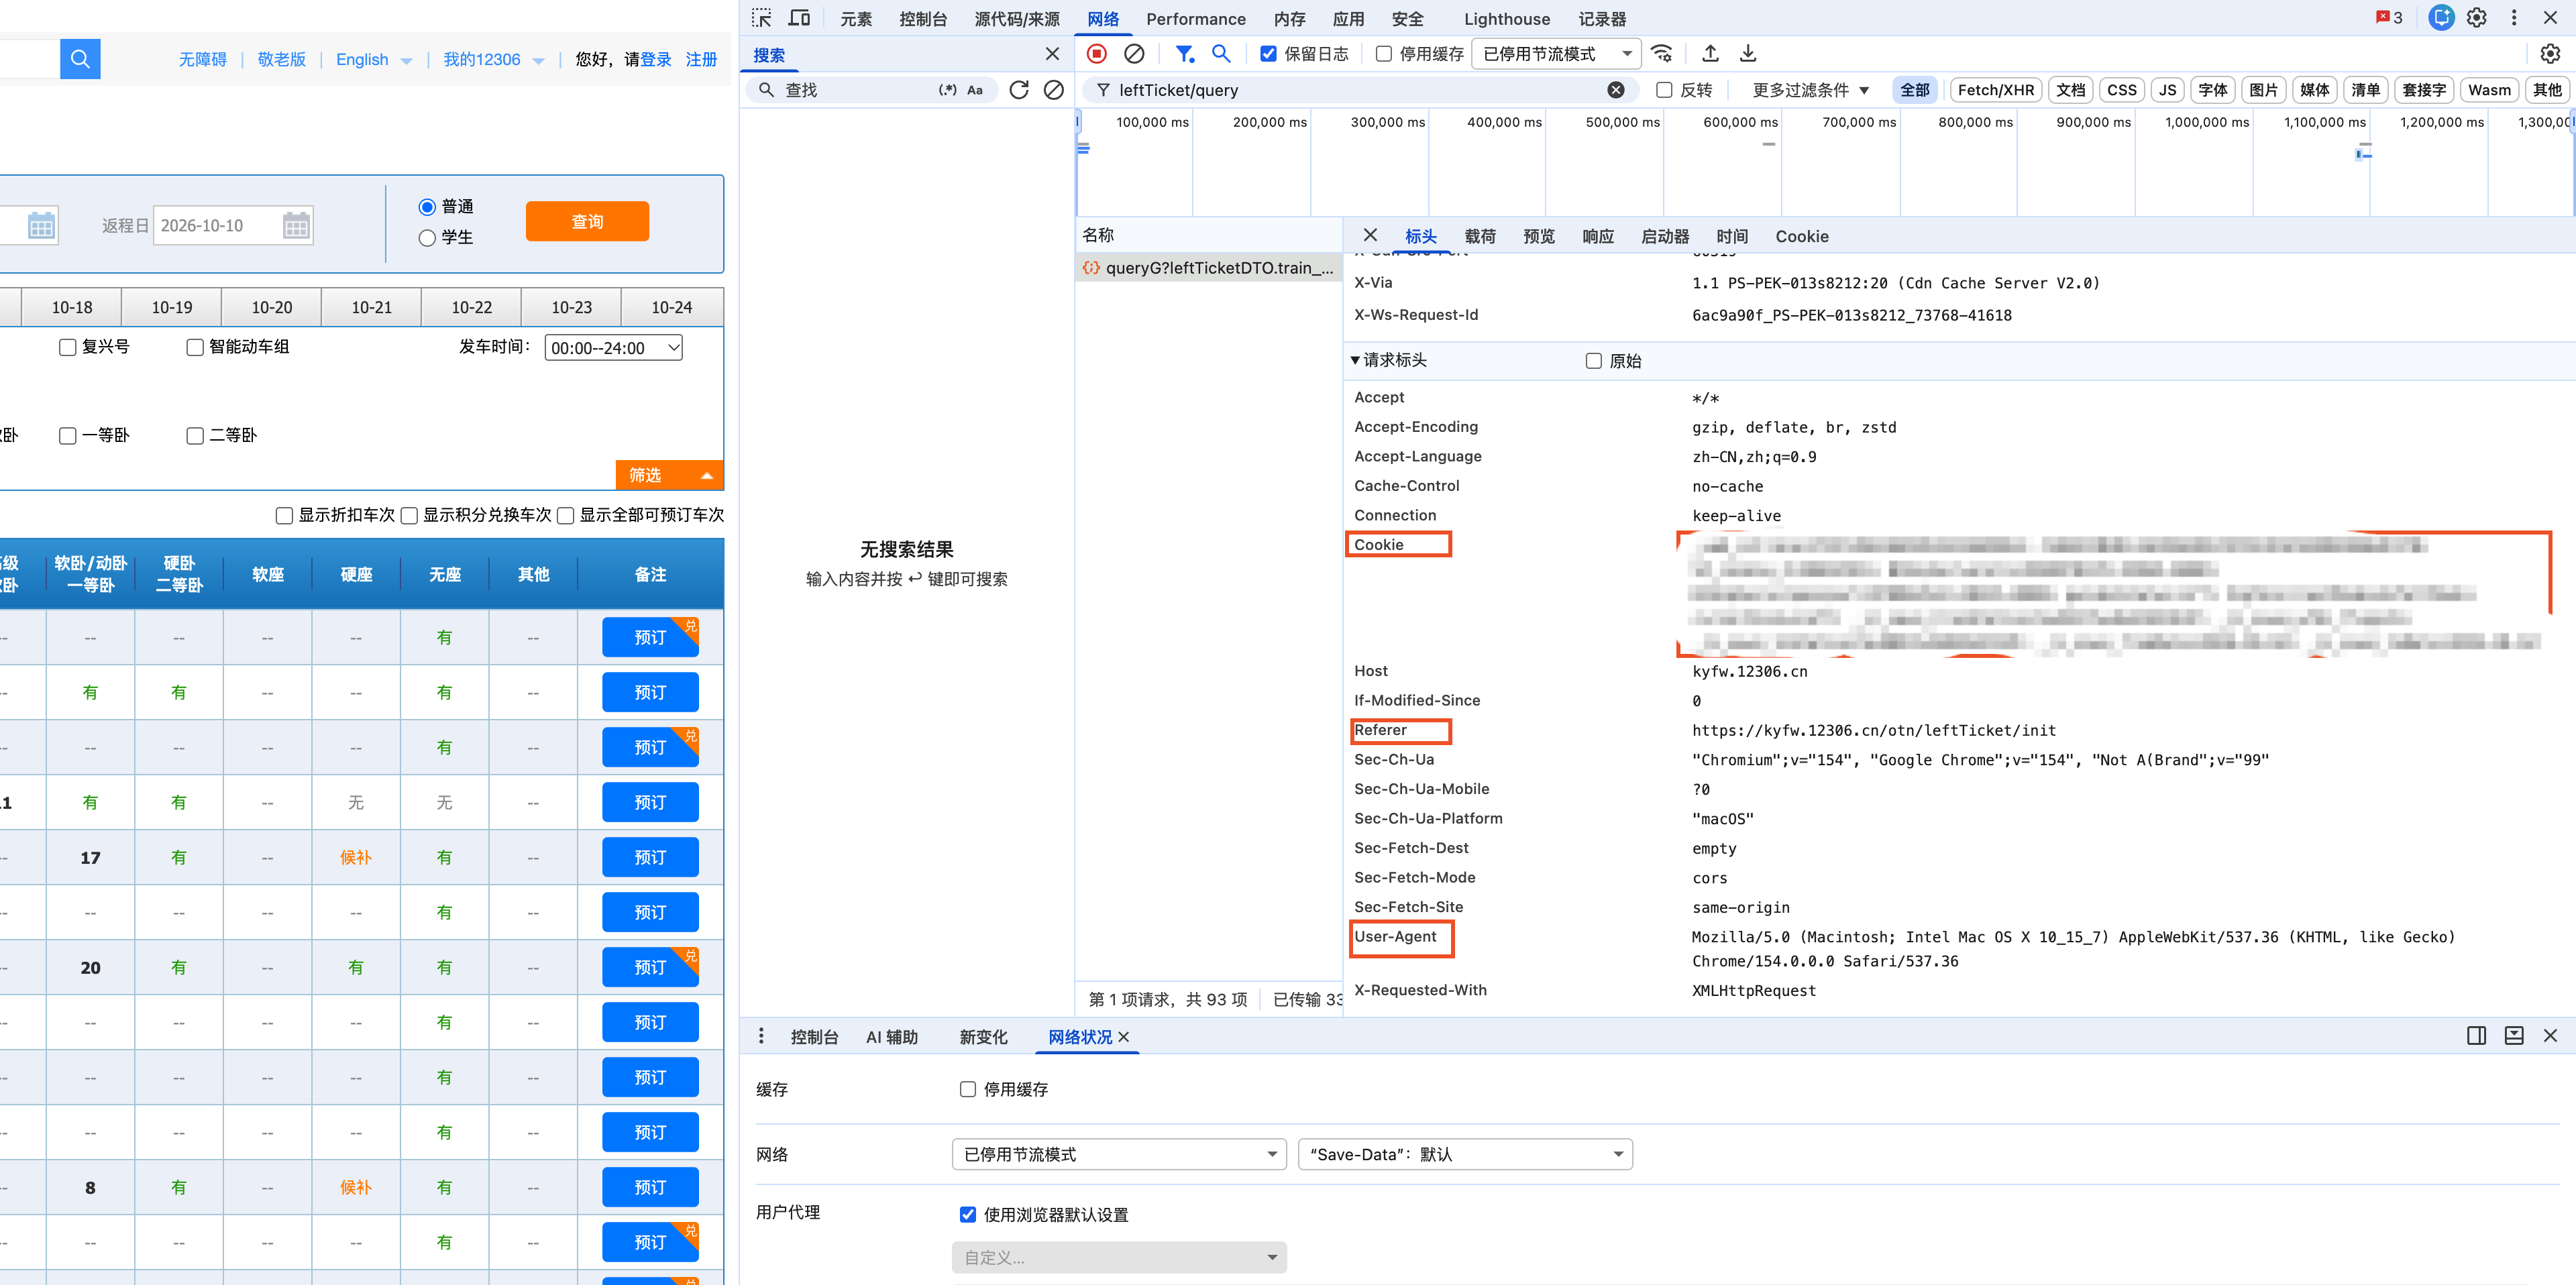
对应代码:
python
request = Request(url, headers={
    "User-Agent": "Mozilla/5.0 (compatible; TrainQuery/1.0)",
    "Referer": BASE_URL + "leftTicket/init",
    ...
})
以及:
python
self.opener = build_opener(HTTPCookieProcessor(http.cookiejar.CookieJar()))HTTPCookieProcessor 就是帮 Python 自动保存和携带 Cookie。
5. 对应 parse_trains:看 JSON 响应和 result 字符串
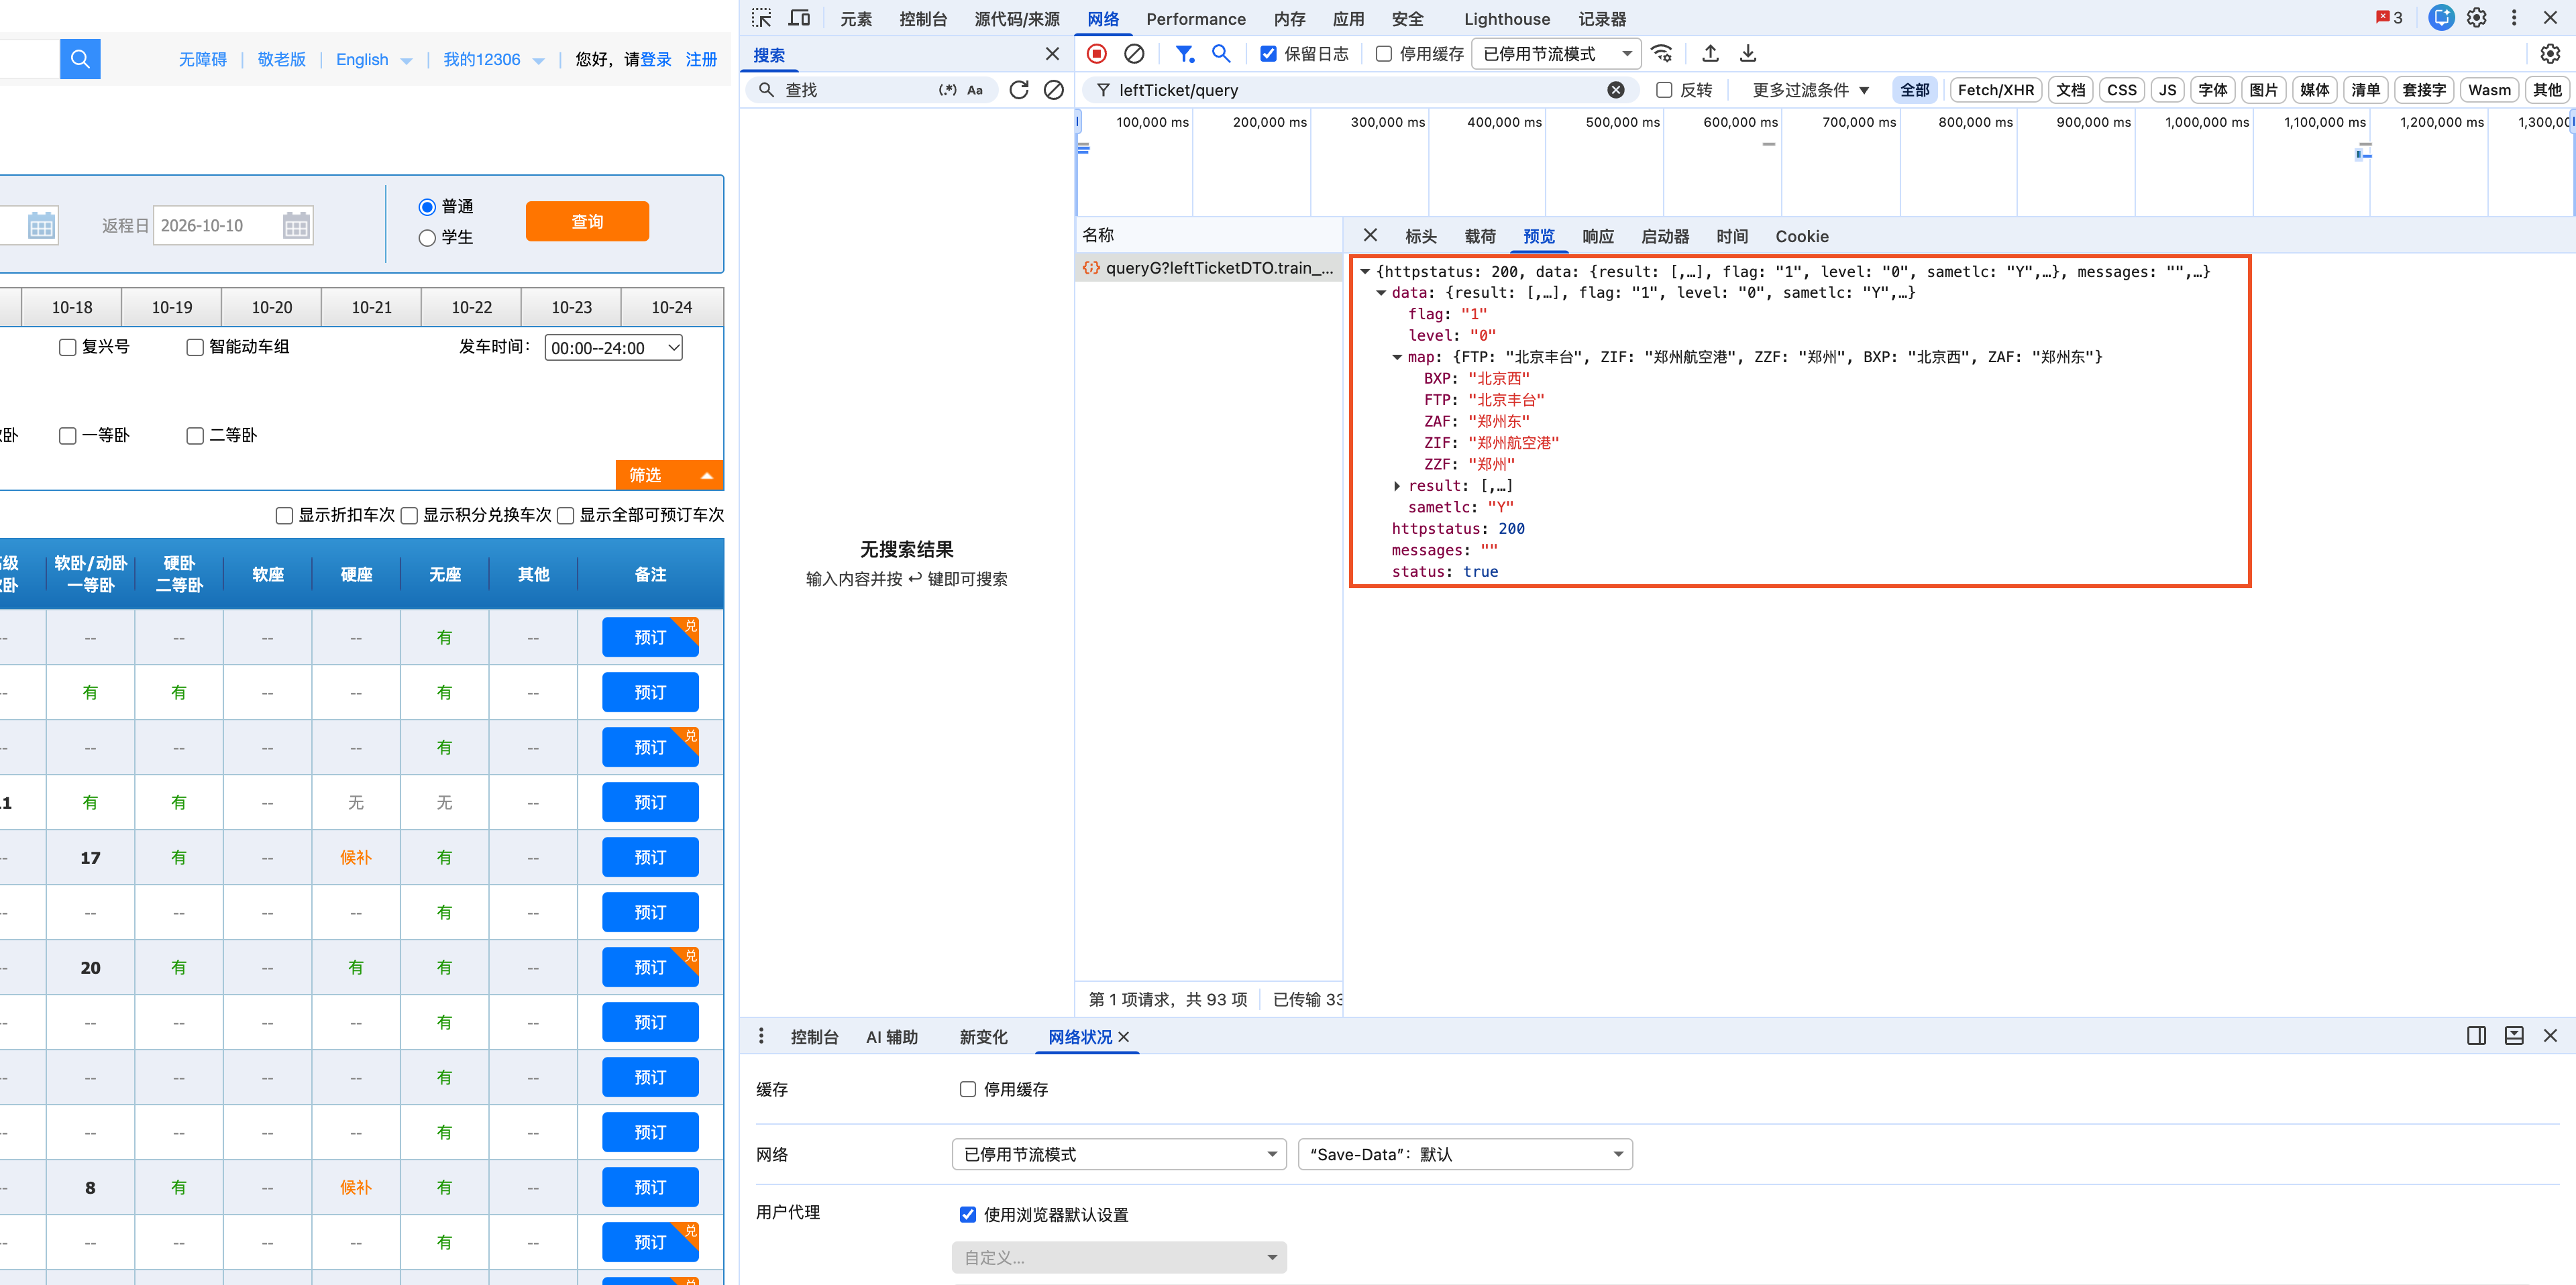
点开查询请求的 Preview / Response,你会看到 JSON:
python
{
  "status": true,
  "data": {
    "result": ["..."],
    "map": {"BJP": "北京", "WAR": "乌鲁木齐"}
  },
  "c_url": "leftTicket/queryA",
  "messages": ""
}
代码中:
python
payload = json.loads(text)
if payload.get("status") is not True:
    ...
data = payload.get("data")
trains = parse_trains(data, names, ...)
对应关系:
status:是否成功;messages:失败提示;c_url:可能需要切换的查询路径;data.result:车次列表;data.map:电报码到站名的映射。
result 里的每个元素是一个长字符串,用 | 分隔。你可以复制其中一个到 Console:
python
let s = "这里粘贴 result[0]";
let f = s.split('|');
f.forEach((v, i) => console.log(i, v));
然后对照代码里的字段索引:
| 索引 | 代码字段 | 含义 |
|---|---|---|
fields[1] |
状态 |
状态 |
fields[3] |
车次 |
车次,如 G/D/C 或普速 |
fields[4] |
列车始发站 |
列车始发站 |
fields[5] |
列车终到站 |
列车终到站 |
fields[6] |
出发站 |
实际乘车站电报码 |
fields[7] |
到达站 |
实际到达站电报码 |
fields[8] |
出发时间 |
出发时间 |
fields[9] |
到达时间 |
到达时间 |
fields[10] |
历时 |
历时 |
fields[11] |
可预订 |
是否 Y |
fields[30] |
二等座 | 余票 |
fields[31] |
一等座 | 余票 |
fields[32] |
商务/特等座 | 余票 |
fields[21] |
高级软卧 | 余票 |
fields[23] |
软卧 | 余票 |
fields[33] |
动卧 | 余票 |
fields[28] |
硬卧 | 余票 |
fields[29] |
硬座 | 余票 |
fields[26] |
无座 | 余票 |
这就是 SEAT_FIELDS 的来源。
6. 理解 EXACT_STATIONS、ONLY_AVAILABLE、TRAIN_TYPE
EXACT_STATIONS
代码:
python
if origin_code is not None and fields[6] != origin_code:
    continue
if destination_code is not None and fields[7] != destination_code:
    continue
当 EXACT_STATIONS=True 时,只保留 fields[6] 和 fields[7] 等于你指定电报码的记录。
当 False 时,不过滤,所以官网返回的"同城车站"也会保留。比如你选"北京",可能返回北京、北京南、北京丰台等。F12 里看 result 的 fields[6]、fields[7],就能明白为什么同一个车次会有多条记录。
ONLY_AVAILABLE
代码判断:
python
value == "有" or (re.fullmatch(r"[0-9]+", value) and int(value) > 0)在 F12 的 result 字符串里,看对应余票字段。如果是"有"或正整数,就算有票;如果是"无""候补""0""--",就不算。
TRAIN_TYPE
代码:
python
is_fast = train["车次"].upper().startswith(("G", "D", "C"))在 F12 的 fields[3] 里看车次首字母即可。
7. 理解 c_url 切换逻辑
代码:
python
next_path = payload.get("c_url")
if (attempt == 0 and isinstance(next_path, str)
        and re.fullmatch(r"leftTicket/query[A-Za-z]*", next_path)
        and next_path != endpoint):
    endpoint = next_path
    continue
在 F12 中,你有时会看到第一次请求返回的 JSON 里有:
python
"c_url": "leftTicket/queryB"而实际能返回车次列表的请求可能是 queryB。代码最多切换一次,就是模仿浏览器的这个行为。
8. Console / Sources 的辅助技巧
-
Console :复制
result[0],用split('|')查看每个索引。 -
Sources :全局搜索
CLeftTicketUrl、queryA、station_name。 -
Network 右键 :
Copy as cURL,可以对比 Python 的Request缺了哪些头。 -
Network 右键 :
Copy response,把 JSON 保存下来,用 Python 慢慢解析。 -
Application :查看 Cookie,理解
HTTPCookieProcessor的作用。 -
Filter :输入
leftTicket只看查询相关请求。
9. 注意事项
12306 有反爬、验证码、频率限制和 Cookie 校验。F12 看到的是浏览器完整环境下的请求,而这段 Python 代码只用标准库,可能被拦截或需要人工验证。接口路径、字段索引也可能变化,所以要以 F12 实际看到的为准。不要高频请求,遵守网站规则。
总结对照表
| Python 代码 | F12 中看什么 |
|---|---|
parse_stations |
station_name.js 响应 |
get("leftTicket/init") |
leftTicket/init 请求 |
CLeftTicketUrl 正则 |
Sources 搜索 CLeftTicketUrl |
params |
查询请求的 Query String Parameters |
Request headers |
查询请求的 Request Headers |
HTTPCookieProcessor |
Application / Cookies |
json.loads(text) |
查询请求的 Preview / Response |
data.result |
JSON 里的车次字符串数组 |
fields[...] |
把 result[0] 复制到 Console 后 `split(' |
SEAT_FIELDS |
result 字符串中对应索引的余票 |
filter_trains |
对照 fields[3]、fields[11]、余票字段 |
c_url 切换 |
响应 JSON 里的 c_url 和后续请求路径 |
这样,就能用 F12 把这段代码的每个函数、每个变量,都还原成浏览器里真实发生的网络行为。
二、把查询代码改为命令行传参
在源代码中新增 argparse,主函数main() 被重写:skill 改为接收 出发站、到达站、日期 三个必填参数。原来的 EXACT_STATIONS、ONLY_AVAILABLE、TRAIN_TYPE 配置被映射为 --exact、--only-available、--type 选项:
python
#!/usr/bin/env python3
"""12306 直达车次查询。仅使用 Python 3.9+ 标准库,不提供购票功能。"""

import argparse
import difflib
import http.cookiejar
import json
import re
import sys
import unicodedata
from datetime import datetime, timedelta, timezone
from urllib.error import HTTPError, URLError
from urllib.parse import urlencode
from urllib.request import HTTPCookieProcessor, Request, build_opener

BASE_URL = "https://kyfw.12306.cn/otn/"
CHINA_TZ = timezone(timedelta(hours=8))
SEAT_FIELDS = {"商务/特等座": 32, "一等座": 31, "二等座": 30,
               "高级软卧": 21, "软卧": 23, "动卧": 33,
               "硬卧": 28, "硬座": 29, "无座": 26}

class QueryError(Exception):
    """可直接展示给用户的查询错误。"""


def validate_date(value):
    if not re.fullmatch(r"\d{4}-\d{2}-\d{2}", value):
        raise QueryError("日期格式必须为 YYYY-MM-DD,例如 2026-10-10。")
    try:
        day = datetime.strptime(value, "%Y-%m-%d").date()
    except ValueError as exc:
        raise QueryError("日期不存在,请检查年月日。") from exc
    if day < datetime.now(CHINA_TZ).date():
        raise QueryError("不能查询过去日期的余票,请输入今天或之后的日期。")
    return day


def parse_stations(text):
    stations = {}
    for record in text.split("@")[1:]:
        fields = record.split("|")
        if len(fields) >= 3 and re.fullmatch(r"[A-Z]{3}", fields[2]):
            stations[fields[1]] = fields[2]
    if not stations:
        raise QueryError("无法解析官方站点表,可能是网络拦截或网站格式已变更。")
    return stations


def resolve_station(value, stations):
    name = value.strip()
    if name in stations:
        return stations[name]
    if name.endswith("站") and name[:-1] in stations:
        return stations[name[:-1]]
    code = name.upper()
    if code in stations.values():
        return code
    candidates = [item for item in stations if name and name in item][:8]
    if not candidates:
        candidates = difflib.get_close_matches(name, stations, n=5, cutoff=0.4)
    hint = ";可尝试:" + "、".join(candidates) if candidates else ""
    raise QueryError(f"未找到车站:{value}{hint}。请使用官方站名或三字母电报码。")


def parse_trains(data, station_names, origin_code=None, destination_code=None):
    if not isinstance(data, dict) or not isinstance(data.get("result"), list):
        raise QueryError("查询响应缺少车次列表,可能需要人工验证或接口已变更。")
    names = dict(station_names)
    mapping = data.get("map", {})
    if not isinstance(mapping, dict):
        raise QueryError("查询响应中的站名映射格式异常。")
    names.update(mapping)
    trains = []
    for record in data["result"]:
        if not isinstance(record, str):
            raise QueryError("车次数据格式异常。")
        fields = record.split("|")
        if len(fields) < 34:
            raise QueryError("车次字段不足,官方接口格式可能已变更。")
        if origin_code is not None and fields[6] != origin_code:
            continue
        if destination_code is not None and fields[7] != destination_code:
            continue
        trains.append({
            "车次": fields[3],
            "列车始发站": names.get(fields[4], fields[4]),
            "列车终到站": names.get(fields[5], fields[5]),
            "出发站": names.get(fields[6], fields[6]),
            "到达站": names.get(fields[7], fields[7]),
            "出发时间": fields[8],
            "到达时间": fields[9],
            "历时": fields[10],
            "可预订": fields[11] == "Y",
            "状态": fields[1] or ("可预订" if fields[11] == "Y" else "不可预订"),
            "余票": {seat: fields[index] or "--" for seat, index in SEAT_FIELDS.items()},
        })
    return trains


def validate_filters(only_available, train_type):
    if not isinstance(only_available, bool):
        raise QueryError("ONLY_AVAILABLE 必须为 True 或 False。")
    if train_type not in ("高铁/动车", "普速", "全部"):
        raise QueryError('TRAIN_TYPE 必须为 "高铁/动车"、"普速" 或 "全部"。')


def filter_trains(trains, only_available=False, train_type="全部"):
    validate_filters(only_available, train_type)
    filtered = []
    for train in trains:
        is_fast = train["车次"].upper().startswith(("G", "D", "C"))
        if train_type == "高铁/动车" and not is_fast:
            continue
        if train_type == "普速" and is_fast:
            continue
        if only_available:
            # "有"或正整数代表余票;无、候补、0、-- 均不算有票。
            seats = (str(value).strip() for value in train["余票"].values())
            has_seat = any(value == "有" or (
                re.fullmatch(r"[0-9]+", value) and int(value) > 0
            ) for value in seats)
            if not train["可预订"] or not has_seat:
                continue
        filtered.append(train)
    return filtered


class TrainClient:
    def __init__(self, timeout=20):
        self.timeout = timeout
        self.opener = build_opener(HTTPCookieProcessor(http.cookiejar.CookieJar()))

    def get(self, path, params=None):
        url = BASE_URL + path
        if params:
            url += "?" + urlencode(params)
        request = Request(url, headers={
            "User-Agent": "Mozilla/5.0 (compatible; TrainQuery/1.0)",
            "Referer": BASE_URL + "leftTicket/init",
            "Accept": "application/json, text/javascript, text/html, */*",
        })
        try:
            with self.opener.open(request, timeout=self.timeout) as response:
                return response.read().decode("utf-8-sig")
        except HTTPError as exc:
            raise QueryError(f"12306 返回 HTTP {exc.code},请稍后重试或使用官网查询。") from exc
        except (URLError, TimeoutError, OSError) as exc:
            raise QueryError(f"无法连接 12306:{exc}。请检查网络和系统证书。") from exc
        except UnicodeError as exc:
            raise QueryError("响应不是有效的 UTF-8 文本,可能受到网络拦截。") from exc

    def query(self, origin, destination, travel_date, exact_stations=False,
              only_available=False, train_type="全部"):
        validate_filters(only_available, train_type)
        day = validate_date(travel_date)
        stations = parse_stations(self.get("resources/js/framework/station_name.js"))
        origin_code = resolve_station(origin, stations)
        destination_code = resolve_station(destination, stations)
        if origin_code == destination_code:
            raise QueryError("出发站和到达站不能相同。")
        names = {code: name for name, code in stations.items()}
        page = self.get("leftTicket/init")
        match = re.search(r"CLeftTicketUrl\s*=\s*['\"](leftTicket/query[A-Za-z]*)['\"]", page)
        if not match:
            raise QueryError("无法从官网获取查询入口,请在官网完成可能的人工验证后重试。")
        endpoint = match.group(1)
        params = {
            "leftTicketDTO.train_date": day.isoformat(),
            "leftTicketDTO.from_station": origin_code,
            "leftTicketDTO.to_station": destination_code,
            "purpose_codes": "ADULT",
        }
        # 仅接受官方响应指定的同站查询路径,最多切换一次;不自动循环重试。
        for attempt in range(2):
            text = self.get(endpoint, params)
            try:
                payload = json.loads(text)
            except json.JSONDecodeError as exc:
                raise QueryError("12306 未返回 JSON,可能触发访问限制或人工验证,请使用官网查询。") from exc
            if not isinstance(payload, dict):
                raise QueryError("12306 响应格式异常。")
            next_path = payload.get("c_url")
            if (attempt == 0 and isinstance(next_path, str)
                    and re.fullmatch(r"leftTicket/query[A-Za-z]*", next_path)
                    and next_path != endpoint):
                endpoint = next_path
                continue
            if payload.get("status") is not True:
                messages = payload.get("messages") or "服务暂不可用,或日期不在预售期内"
                raise QueryError(f"12306 查询失败:{messages}")
            data = payload.get("data")
            trains = parse_trains(
                data, names,
                origin_code if exact_stations else None,
                destination_code if exact_stations else None,
            )
            return {
                "日期": day.isoformat(),
                "出发站": names[origin_code],
                "到达站": names[destination_code],
                "精确站点": exact_stations,
                "原始记录数": len(data["result"]),
                "站点匹配记录数": len(trains),
                "只看有票": only_available,
                "车型筛选": train_type,
                "车次": filter_trains(trains, only_available, train_type),
            }
        raise QueryError("官方查询入口切换失败,请稍后重试。")


def display_width(text):
    return sum(2 if unicodedata.east_asian_width(char) in "WF" else 1 for char in text)


def print_result(result):
    print(f"{result['日期']}  {result['出发站']} → {result['到达站']}")
    exact = result.get("精确站点", False)
    print("查询范围:仅指定车站。" if exact else
          "查询范围:包含官网返回的同城车站,请以每行的实际出发站、到达站为准。")
    availability = "只看有票(含无座,不含候补)" if result.get("只看有票", False) else "不限余票"
    print(f"筛选条件:{result.get('车型筛选', '全部')};{availability}。")
    trains = result["车次"]
    if not trains:
        if result.get("站点匹配记录数", 0):
            print("该区间有车次,但没有符合当前余票或车型筛选条件的记录。")
        elif exact and result.get("原始记录数", 0):
            print(f"官网返回 {result['原始记录数']} 条同城乘车区间记录,但没有匹配指定两站的记录。")
            print("可将 EXACT_STATIONS 改为 False,或修改配置中的具体车站。")
        else:
            print("未查询到直达车次,可能尚未开售、超出预售期或当日没有直达列车。")
        return
    headers = ["车次", "出发站", "到达站", "出发时间", "到达时间", "历时"]
    seats = list(SEAT_FIELDS)
    rows = [headers + seats + ["状态"]]
    for train in trains:
        rows.append([train[key] for key in headers]
                    + [train["余票"][seat] for seat in seats] + [train["状态"]])
    widths = [max(display_width(row[i]) for row in rows) for i in range(len(rows[0]))]
    for row in rows:
        print("  ".join(value + " " * (widths[i] - display_width(value))
                        for i, value in enumerate(row)))
    print(f"共 {len(trains)} 条乘车区间记录,涉及 {len({train['车次'] for train in trains})} 个车次;")
    print("同一车次可能对应多个上下车站组合;-- 表示未提供该席别余票,不等于有票。")
    print("到达时间可能为次日或更晚,请结合历时判断;余票和售票状态以官网为准。")


def main():
    """12306 直达车次查询命令行入口。"""
    parser = argparse.ArgumentParser(
        description="查询 12306 两个车站之间的直达车次及余票。",
    )
    parser.add_argument("start_station", help="出发站,支持官方站名或三字母电报码")
    parser.add_argument("end_station", help="到达站,支持官方站名或三字母电报码")
    parser.add_argument("date", help="查询日期,格式为 YYYY-MM-DD")
    parser.add_argument(
        "--exact",
        action="store_true",
        help="仅保留出发站和到达站都与指定站名完全一致的乘车区间",
    )
    parser.add_argument(
        "--only-available",
        action="store_true",
        help="只看有票车次(含无座,不含候补)",
    )
    parser.add_argument(
        "--type",
        default="全部",
        choices=("高铁/动车", "普速", "全部"),
        help="筛选车型:高铁/动车、普速、全部",
    )
    args = parser.parse_args()
    try:
        result = TrainClient().query(
            args.start_station,
            args.end_station,
            args.date,
            exact_stations=args.exact,
            only_available=args.only_available,
            train_type=args.type,
        )
        print_result(result)
        return 0
    except QueryError as exc:
        print(f"查询失败:{exc}", file=sys.stderr)
        return 1
    except (KeyboardInterrupt, EOFError):
        print("\n查询已取消。", file=sys.stderr)
        return 130


if __name__ == "__main__":
    sys.exit(main())
为什么这样改
- Skill 需要可复用:每次查询的车站和日期都可能不同,不能要求用户或模型先修改源码。
- 命令行参数让 Codex 可以直接执行形如
python3 train_query.py 北京 上海 2026-10-10的命令,查询任意区间。 argparse自动提供帮助信息,并限制--type只能选择合法值。- 默认行为仍等价于原来的默认配置:模糊站点、不限余票、全部车型。
例如:
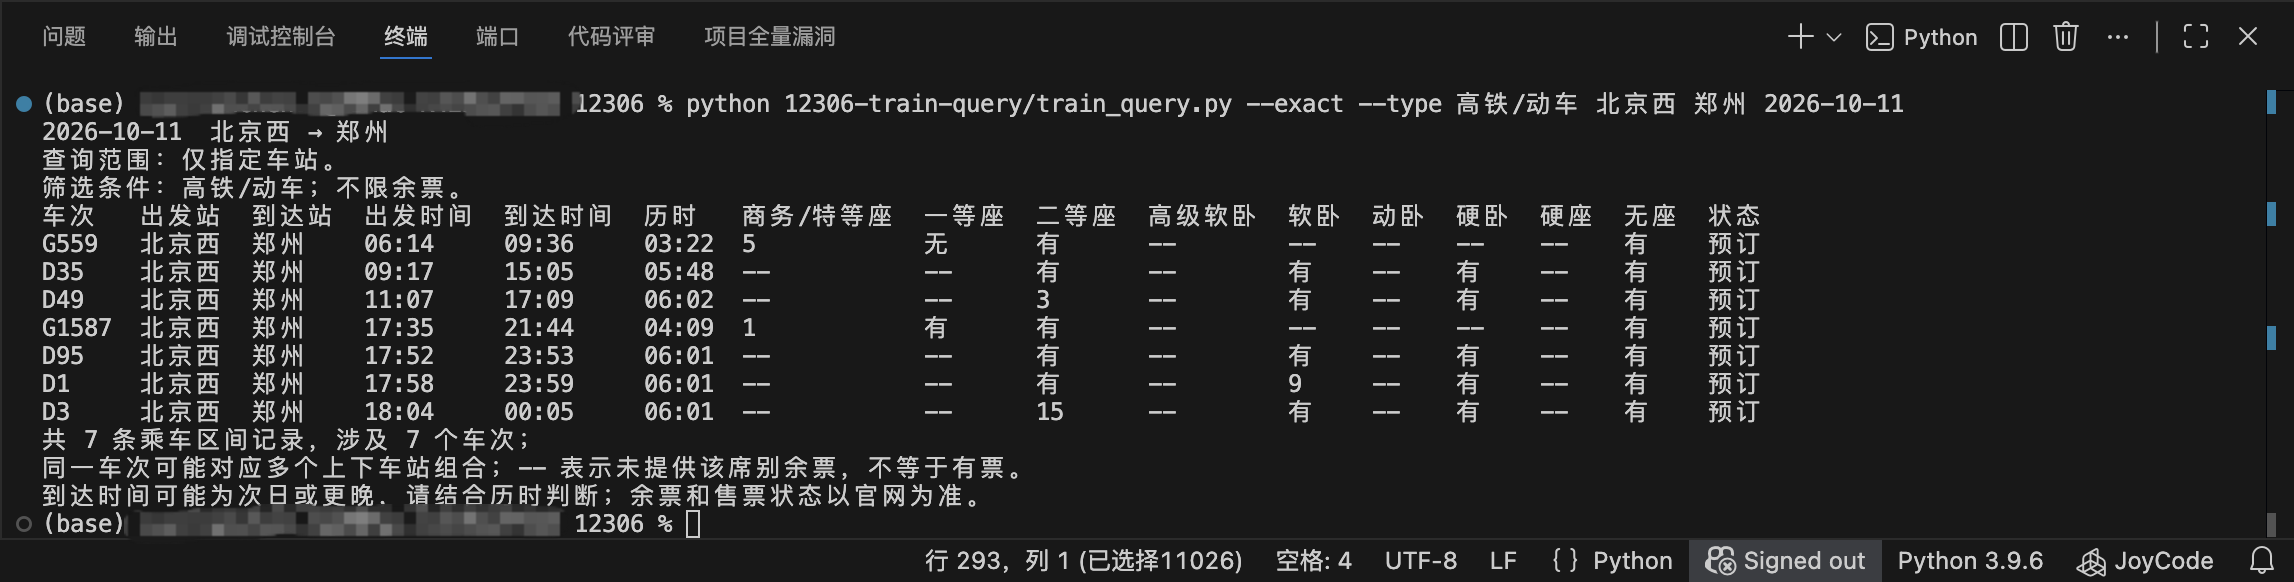
三、增加SKILL.md说明文件
写 SKILL.md 时,它通常不是普通 README,而是给 Agent/模型看的"技能声明 + 使用说明书"。核心目标是:让模型知道这个 skill 能做什么、什么时候该用、怎么调用、有什么限制。
一个比较完整的 SKILL.md 通常包含这些部分:
- YAML frontmatter :
name、description。文件开头必须有---包裹的 frontmatter。 - 用途与能力边界
- 何时使用 / 不适用
- 文件与资源
- 使用方法 / 命令
- 参数与输入输出
- 示例
- 限制与注意事项
- 错误处理
- 安全/权限/维护信息(可选)
python
---
name: 12306-train-query
description: 查询 12306 两个车站之间的直达车次及余票。仅提供查询功能,不支持购票。
---

# 12306 直达车次查询 Skill

## 用途

在需要查询两个车站之间的直达车次、余票信息时使用本 Skill。

## 文件

- `train_query.py`: 查询脚本
- `SKILL.md`: Skill 说明文档

## 使用方法

`train_query.py` 接受以下参数:

```bash
python3 train_query.py <出发站> <到达站> <日期> [选项]
```

### 参数说明

- `<出发站>`: 出发站名称,如 `北京`、`上海`
- `<到达站>`: 到达站名称,如 `上海`、`广州`
- `<日期>`: 查询日期,格式为 `YYYY-MM-DD`

### 可选参数

- `--exact`: 仅查询出发站和到达站完全匹配的车次
- `--only-available`: 仅显示有余票的车次
- `--type`: 筛选车型,可选 `高铁/动车`、`普速`、`全部`

## 示例

```bash
python3 train_query.py 北京 上海 2026-10-10
```

```bash
python3 train_query.py 北京 上海 2026-10-10 --only-available --type 高铁/动车
```

## 注意事项

- 本 Skill 仅提供查询功能,不支持购票。
- 查询结果依赖 12306 官方接口的可用性。
- 查询数据可能存在延迟,仅供参考。
四、把技能打包成zip压缩包
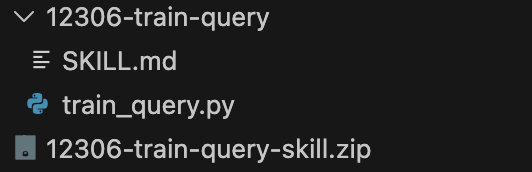
把前面两步得到的代码文件train_query.py、SKILL.md放在同一个文件夹下,然后压缩:
五、在ChatGPT中安装技能
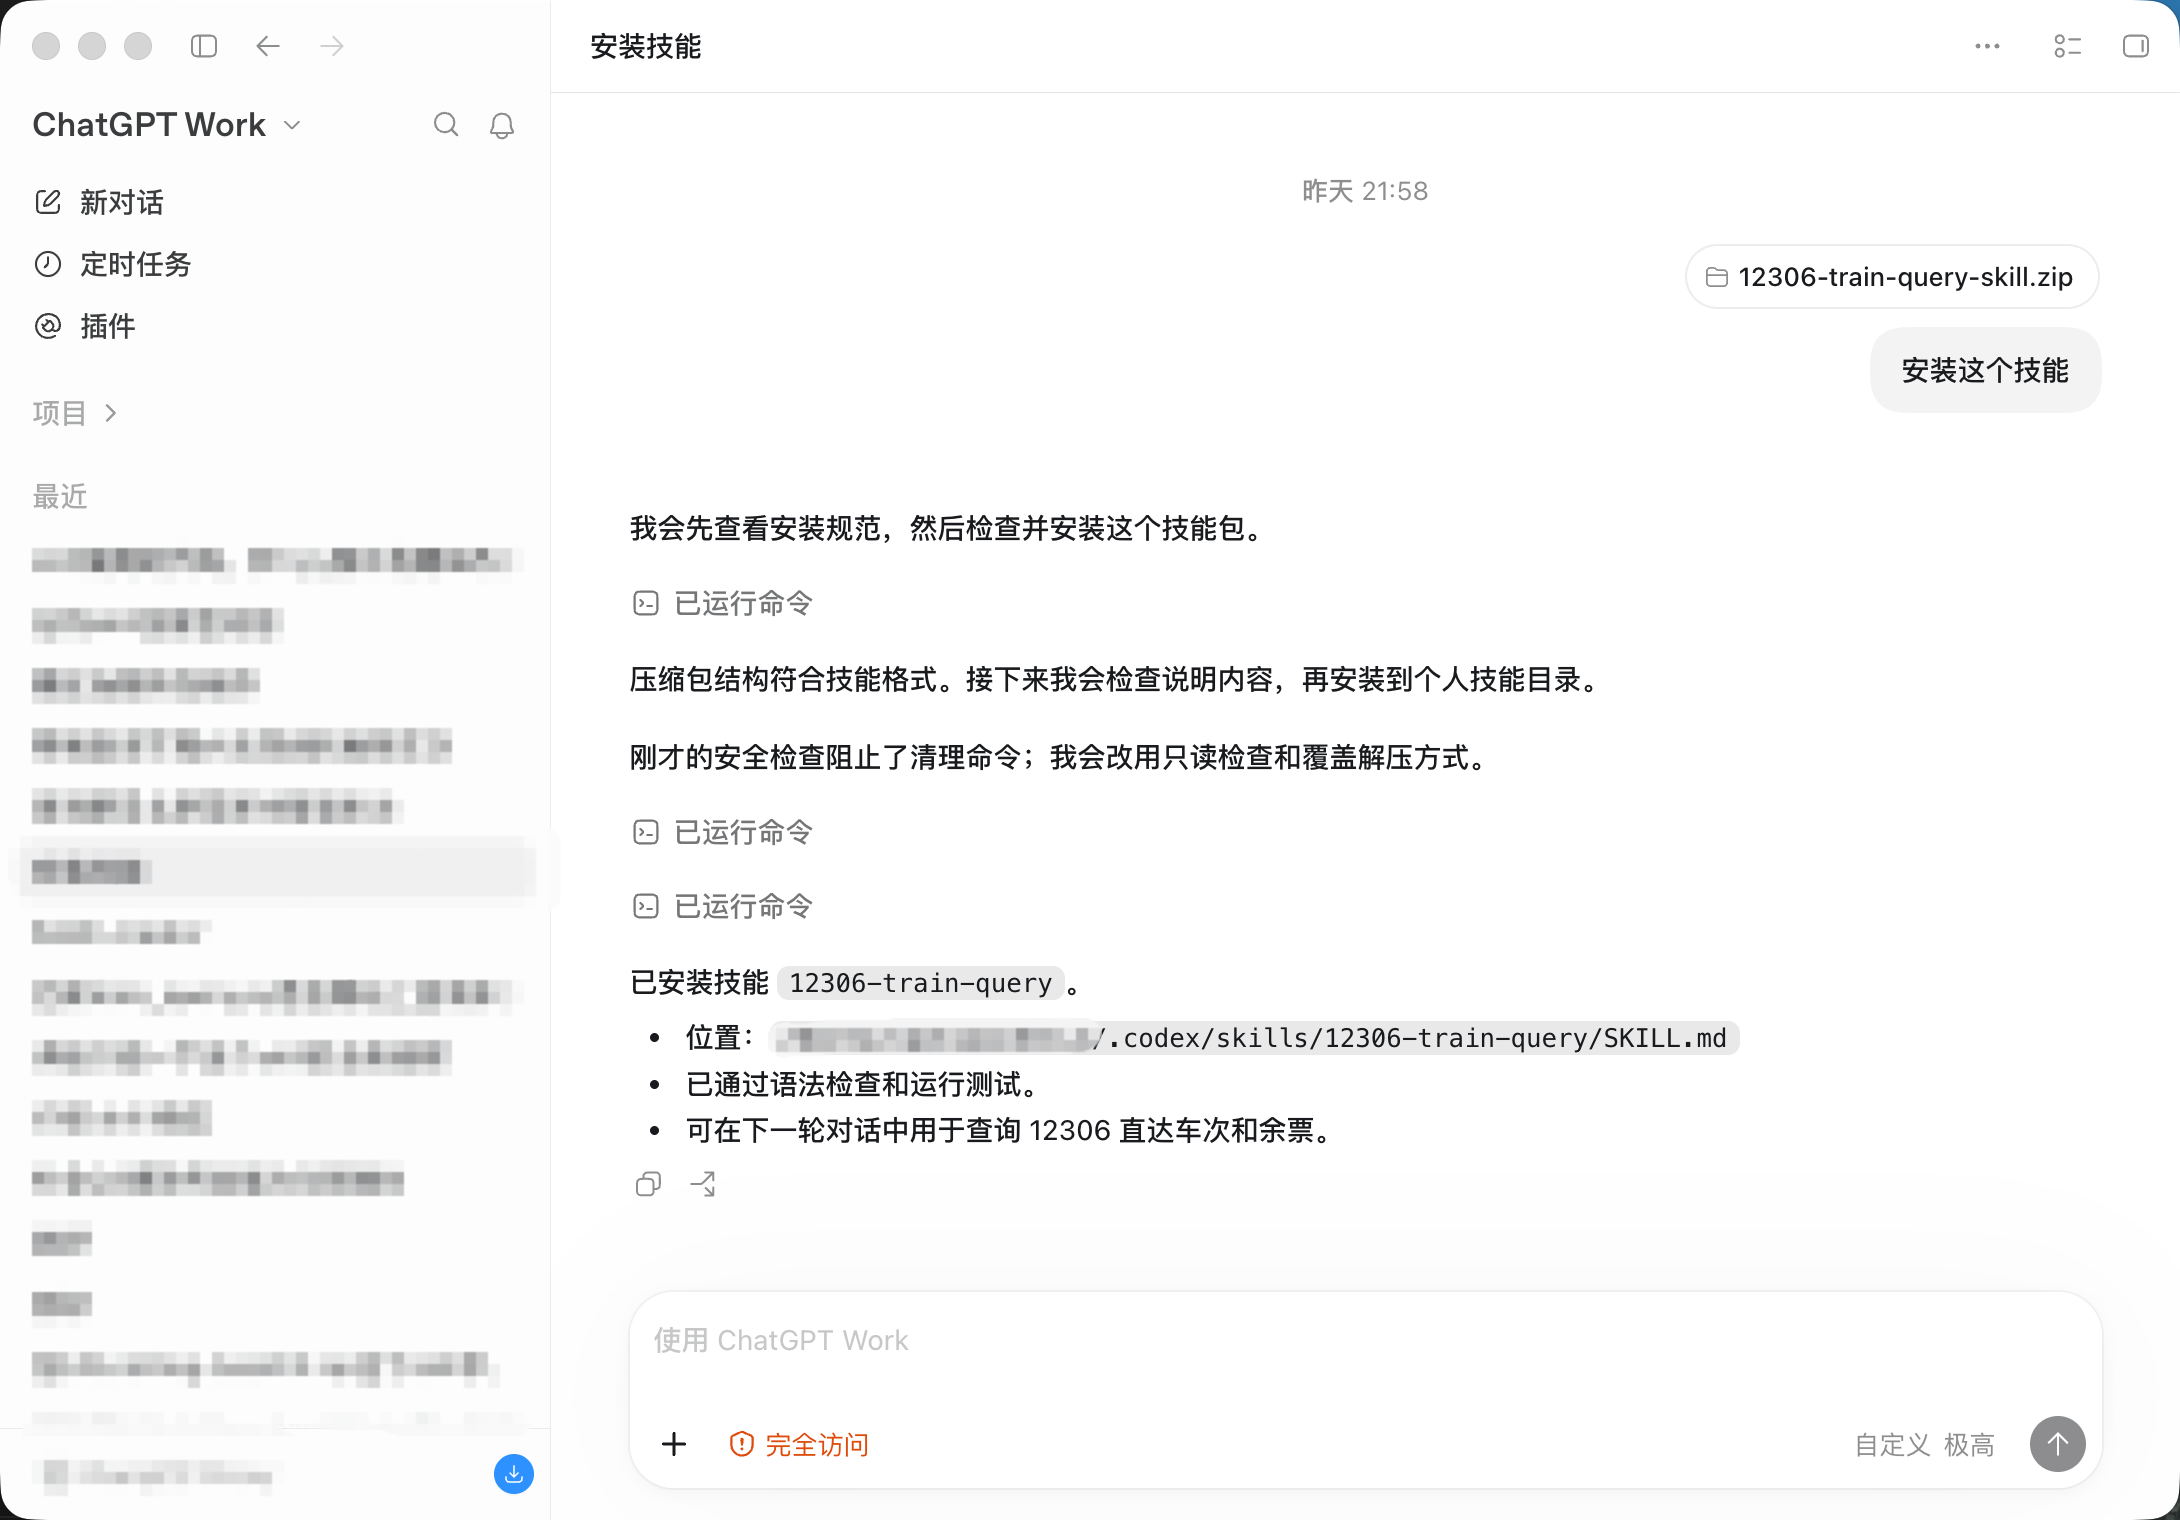
直接在新对话中上传压缩包即可:
六、在ChatGPT中进行测试
在GPT中发送提示词:
bash
帮我查询一下明天北京去深圳的车次,并形成出行建议此时大模型应该会根据SKILL.md调用刚才安装的技能:
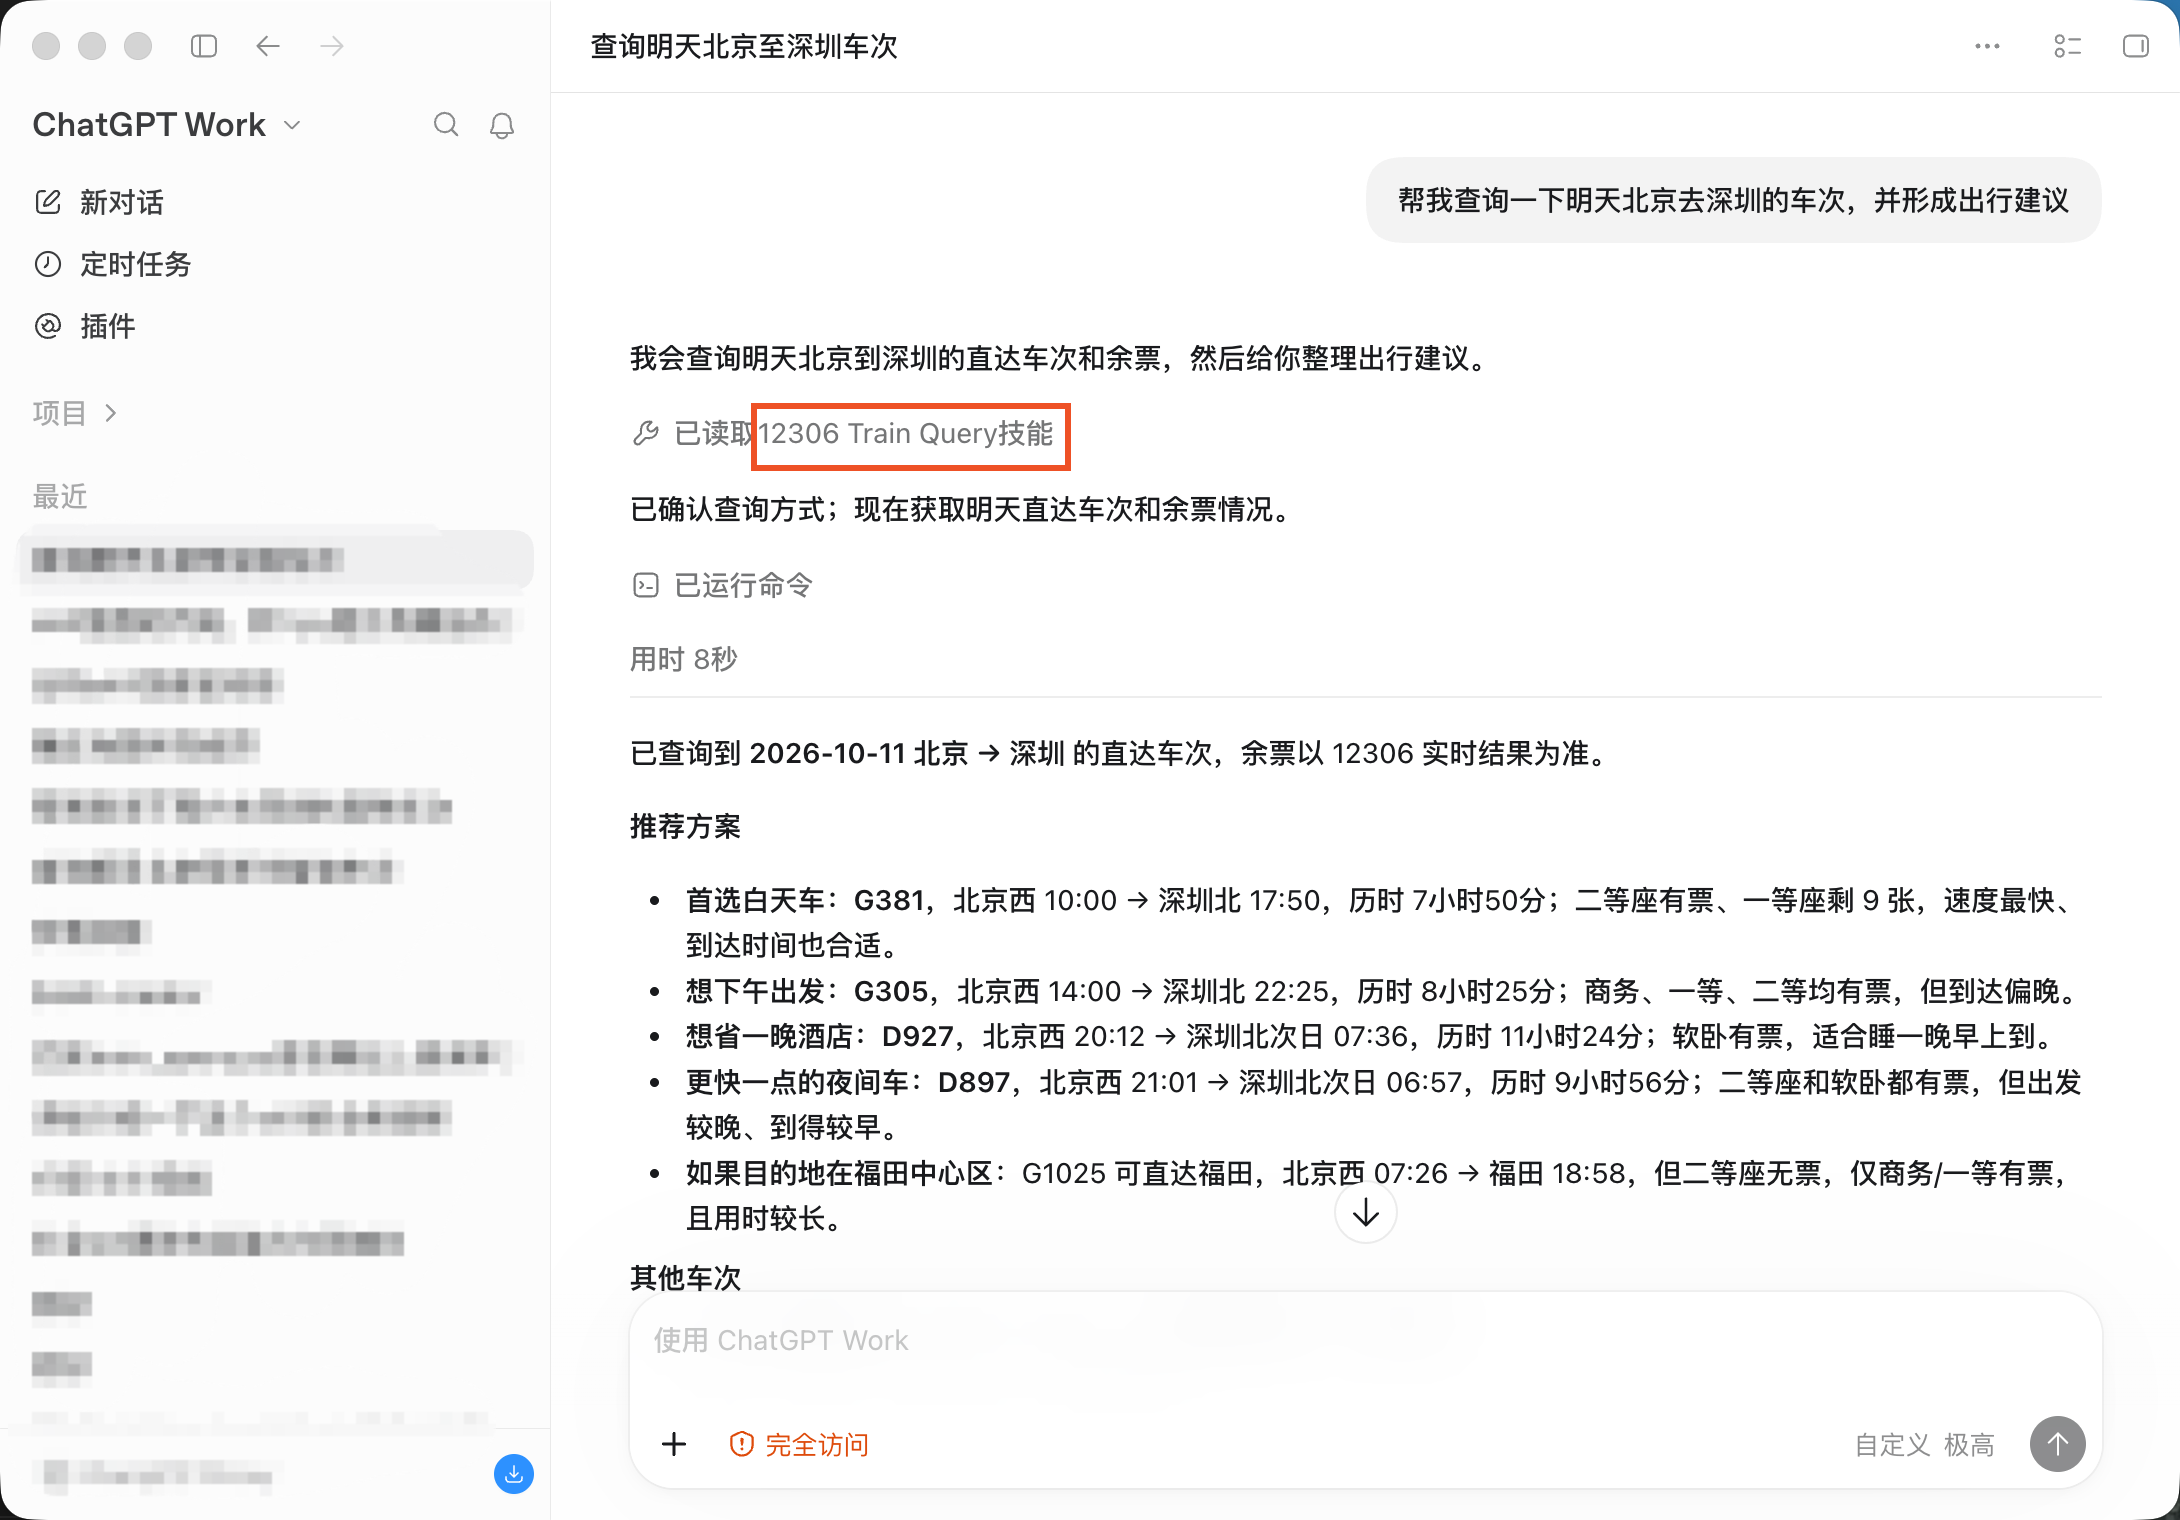
执行完毕!
有了skill的主要好处是:一句自然语言描述即可完成网站上多个条件的选择,不用再去12306上"点点点"。脚本可以固定运行,适合反复检查某个日期、区间或车型,也便于让 AI 帮助判断哪些车次符合条件,利用大模型的自然语言能力生成合理化的出行建议。