作者:卢建晖 & 许豪
排版:Alan Wang
0. 为什么我现在要写这篇文章
同一周内,有两件事引起了我的关注。
首先,TypeSafe AI 发布了《System One 模型与 Jev 介绍》(2026 年 9 月 15 日),开发者社区随即围绕这一话题展开了讨论。它提出的理念与众不同:Jev 并不是又一个聊天模型,而是被描述为"一种新型前沿模型,旨在做出快速、结构化的决策,供软件直接使用。 "文章将 Jev 定义为"一种前沿智能函数调用:输入非结构化状态,输出带类型的概率决策",并指出,虽然"Jev 放弃了字符串生成能力,但它针对结构化输出进行了优化,因此不会产生幻觉。"
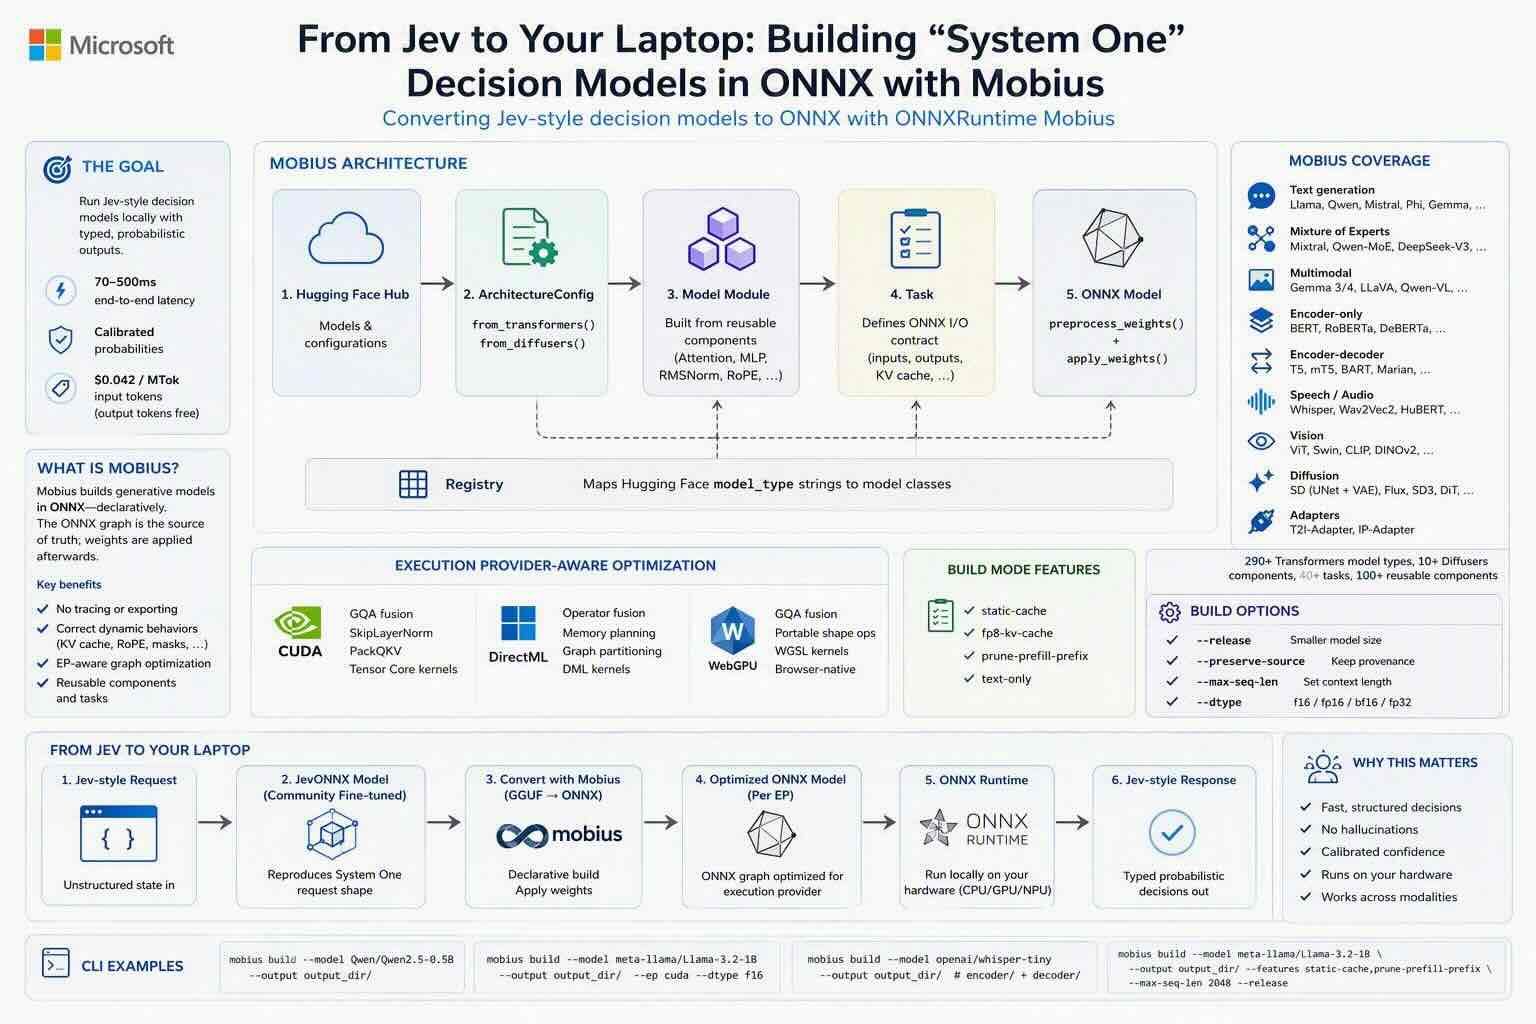
文章中的几组数据引起了所有人的关注:端到端响应时间为 70 毫秒至 500 毫秒 ,而前沿大语言模型(LLM)的响应时间为 3 至 329 秒;输入 Token 的价格为 每百万 Token 0.042 美元 ,输出 Token 则免费;此外,文章声称,每个答案都会附带一个经过校准的概率 ------"置信度越高,准确率就越高。" 这个名字本身也体现了一种理念:TypeSafe 以 William Stanley Jevons 的名字命名 Jev,并相信"智能成本每降低一个数量级,就能解锁数量级更多的应用场景。"
其次,也是对所有基于微软 AI 技术栈进行开发的人来说更重要的一点:onnxruntime/mobius 一直在悄然快速迭代。它是一项基础设施,能够让我们切实地将这类模型以其原本提供的任意格式转换为 ONNX 计算图,并在自己掌控的硬件上运行。
因此,我搭建了这座桥梁。kinfey/JevONNX 采用了一个开放的、经过社区微调的模型,用于复现 System One 的请求结构,再借助 Mobius 将其从 GGUF 转换为适用于 CPU 的 ONNX 模型,并在本地提供带类型的概率决策。
这篇文章将介绍三个方面:Mobius 是什么、它与大家可能已经在使用的 ONNX Runtime GenAI Model Builder 有何区别,以及 JevONNX 示例如何将这些技术整合起来。
什么是 Mobius?
Mobius 可以直接在 ONNX 中构建生成式模型。 这里的关键就在于"在"这个字。
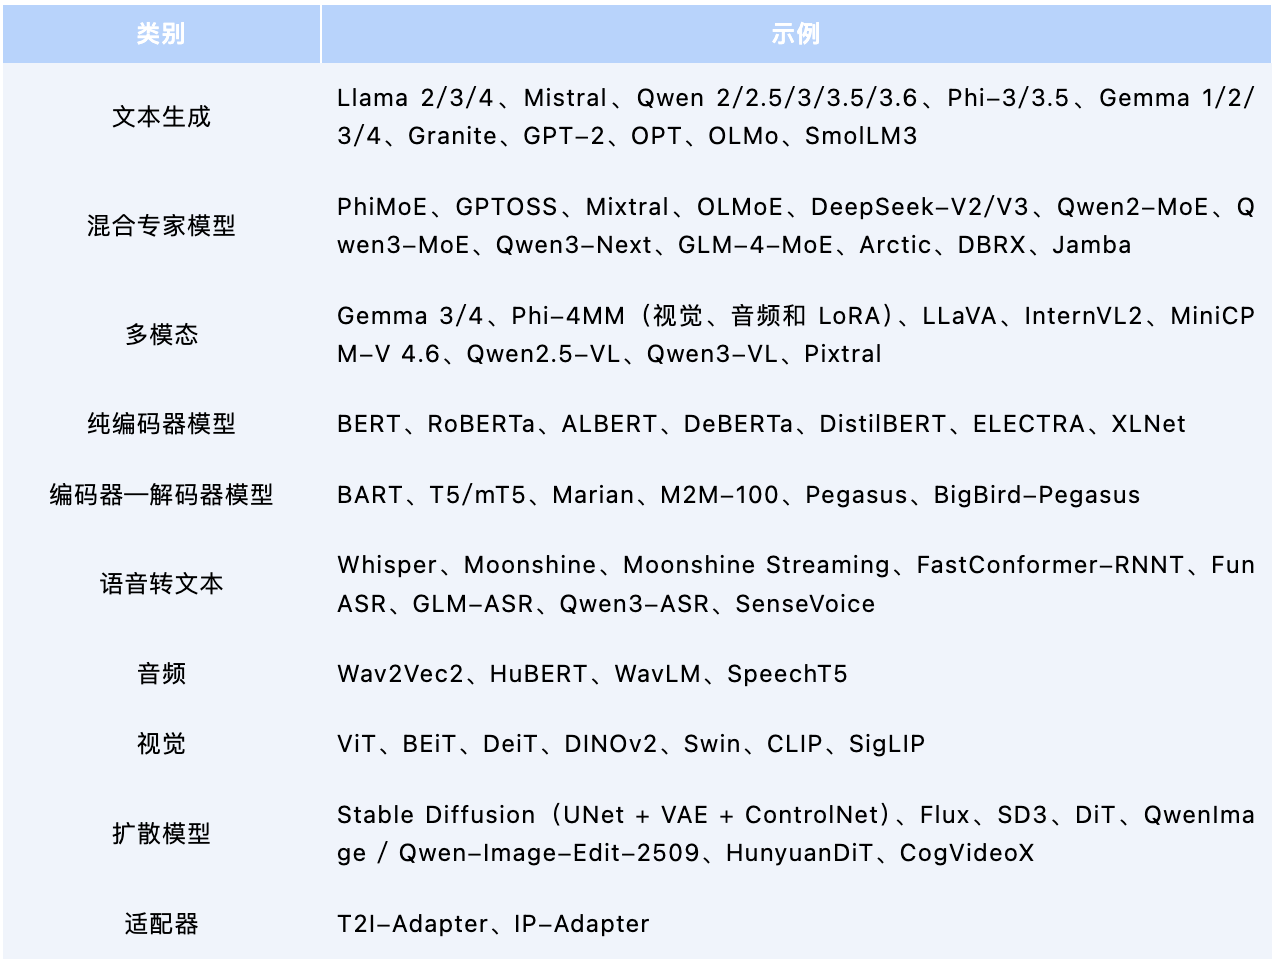
根据项目仓库自身的描述,Mobius 通过 "使用 onnxscript.nn API 为生成式 AI 提供 ONNX 模型定义",支持构建*"大语言模型、混合专家模型(MoE)、多模态模型、纯编码器模型、编码器---解码器模型、视觉模型、音频模型和扩散模型,并使用 onnxscript.nn.Module 直接构建 ONNX 计算图。"
其中最关键、值得仔细阅读两遍的一句话是:
"它并不是通过追踪或导出 PyTorch 模型来构建 ONNX,而是以声明式方式构建 ONNX 计算图,然后再应用预训练的 Hugging Face 权重。"
为什么"声明式构建"如此重要?
如果你曾经使用传统方式将模型导出为 ONNX,就会知道其中有哪些容易出问题的地方。运行 torch.onnx.export 时,追踪器会沿着 Python 控制流执行一条具体路径。任何动态逻辑------例如 KV 缓存分支、通过 Python if 语句计算的旋转位置嵌入,或者滑动窗口掩码------都可能被静默地固化为常量,或者膨胀成难以阅读的子图。接下来,你可能需要花上一周时间对比计算图,排查问题。
Mobius 颠倒了这一流程。计算图是唯一可信的事实来源,它以可组合模块的形式编写,权重则在之后应用。README 中的架构分为四个清晰的层次:
Markdown
Hugging Face Hub
       │
       ▼
ArchitectureConfig ◄── from_transformers() / from_diffusers()
       │
       ▼
模型模块 ◄── 可复用组件(Attention、MLP、RMSNorm、RoPE 等)
       │
       ▼
任务 ◄── CausalLMTask、VisionLanguageTask、VAETask、DenoisingTask 等
       │
       ▼
ONNX 模型 ◄── preprocess_weights() + apply_weights()-
组件------基于 onnxscript.nn.Module 构建的基础模块,包括 Attention、MLP、DecoderLayer、RoPE、VisionEncoder、MoELayer 等。
-
模型------由这些组件组合而成的完整架构。
-
任务------定义 ONNX 计算图的输入输出契约,包括输入、输出和 KV 缓存。
-
注册表------将 Hugging Face 的 model_type 字符串映射到相应的模型类。
添加一种新架构,变成了编写模型定义 ,而不是调试导出器。Mobius 甚至在 .agents/skills/ 目录中提供了开发技能,包括添加新模型、复用组件、MoE 模型、多模态模型、编写测试和编写重写规则等,让 AI 编码智能体能够协助你完成这些工作。
支持范围
这并不是一个玩具项目。仓库声称,它支持 290 多种 Transformers 模型类型、10 种 Diffusers 组件类型、40 多种任务类型以及 100 多种可复用组件 ,覆盖范围如下:
五分钟快速上手
Bash
pip install -e .
Python
from mobius import build

pkg = build("meta-llama/Llama-3.2-1B")
pkg.save("output/llama-3.2-1b/")
如果你事先知道最大序列长度,可以使用静态 KV 缓存:
Python
from mobius import build, CausalLMTask

task = CausalLMTask(static_cache=True, max_seq_len=2048)
pkg = build("meta-llama/Llama-3.2-1B", task=task)
pkg.save("output/llama-3.2-1b-static/")针对执行提供程序(EP)的感知优化------计算图本身会根据不同的执行提供程序进行调整,"自动应用相应的融合内核和降级转换流程。"
Python
# CUDA:GQA 融合、SkipLayerNorm、PackQKV
pkg = build("meta-llama/Llama-3.2-1B", execution_provider="cuda", dtype="f16")

# WebGPU:GQA 融合,并使用可移植的替代方案替换 Shape 运算
pkg = build("meta-llama/Llama-3.2-1B", execution_provider="webgpu", dtype="f16")
接下来是后面会用到的命令行接口(CLI):
Bash
mobius build --model Qwen/Qwen2.5-0.5B --output output_dir/
mobius build --model meta-llama/Llama-3.2-1B --output output_dir/ --ep cuda --dtype f16
mobius build --model openai/whisper-tiny --output output_dir/   # encoder/ + decoder/
构建模式的开关使用类似 Cargo 的 --features 标志。可用功能包括 static-cache、fp8-kv-cache、prune-prefill-prefix 和 text-only:
Bash
mobius build --model meta-llama/Llama-3.2-1B --output output_dir/ \
  --features static-cache,prune-prefill-prefix --max-seq-len 2048
--release 会移除构建阶段的调试信息和来源元数据,从而减小保存后的模型体积,同时保留以 mobius. 为前缀的功能性元数据。
Mobius 与 ONNX Runtime GenAI Model Builder 有什么区别?
每次演示 Mobius 时,我都会被问到这个问题,因此我们有必要把区别讲清楚。两者都是微软的工具,都能生成 ONNX 模型,但它们并不是竞争关系,而是处于同一条处理流程的不同环节。
ONNX Runtime GenAI Model Builder 将自身描述为一款工具,旨在*"在几分钟内快速创建经过优化和量化的 ONNX 模型,并通过 ONNX Runtime GenAI 运行这些模型。"* 它的输出是可以直接用于部署的软件包:model.onnx、genai_config.json 以及分词器文件,这些内容都针对 onnxruntime-genai 运行时进行了配置。它明确维护了一份经过筛选的架构列表,包括 AMD OLMo、ChatGLM、DeepSeek、ERNIE 4.5、Gemma、gpt-oss、Granite、Granite MoE Hybrid、HunYuan Dense V1、InternLM2、LFM2、LFM2 MoE、Llama、Mistral、Nemotron、Phi、Qwen、SmolLM3 和 Whisper。README 也明确指出,该工具"旨在支持最新、流行的先进模型。"
相比之下,Mobius 是一个模型定义库:它提供一套可组合的组件体系,用于将生成式模型架构描述为 ONNX 计算图,并通过注册表将 Hugging Face 的 model_type 字符串映射到相应的模型类。
我会从以下几个维度来区分两者: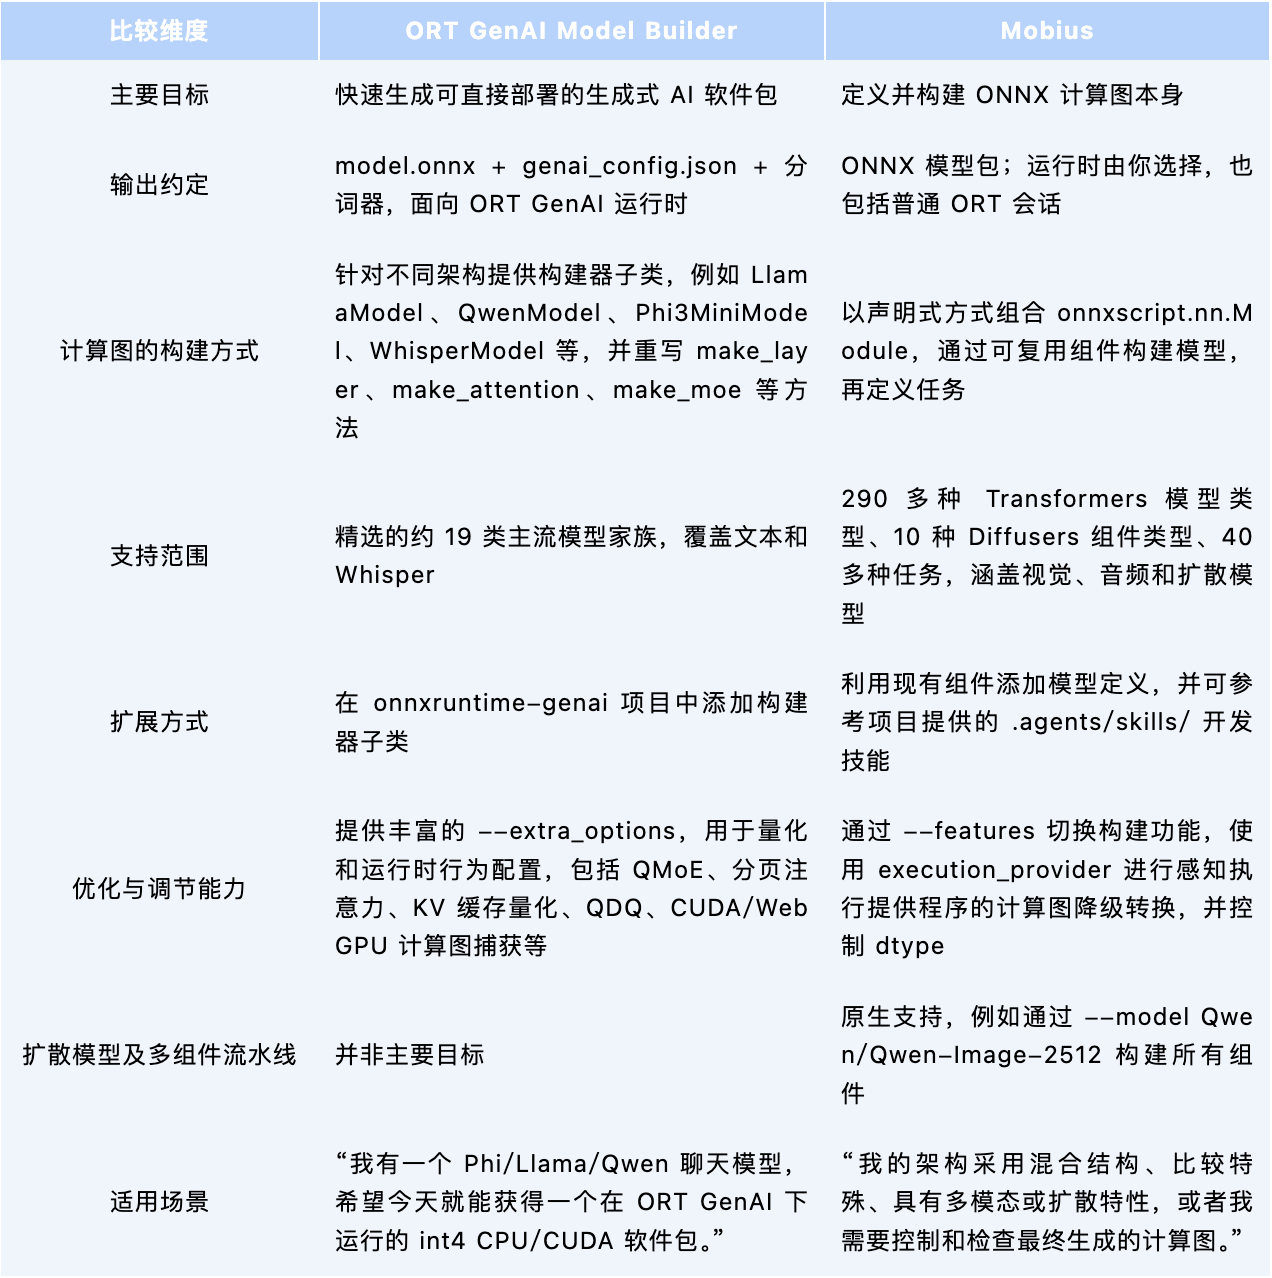
值得注意的是,两者在实际功能上确实存在重叠。Model Builder 同样可以处理 GGUF 格式,并支持 Qwen3.5 级别的特性,例如紧凑状态更新和循环算子选择。Mobius 也能够生成与 ORT GenAI 兼容的元数据,不过项目仓库坦诚地说明了其中的限制。以 Mage-VL 为例,*"目前不支持导出为 ORT GenAI 格式,因为该运行时无法提供其所需的 patch_positions 输入,也无法提供 Mage-VL 所需的一维解码器位置。"*这一句话清楚地说明了两者的边界:Model Builder 受限于 GenAI 运行时能够表达的能力,而 Mobius 受限于 ONNX 能够表达的能力。
作为 Mobius 的推广者,我的经验法则是: 如果你的模型位于 Model Builder 的支持列表中,而且你希望使用 GenAI 运行时的生成循环,那么就使用 Model Builder。它的速度更快,也能提供完整的软件包。一旦你的模型不在支持列表中,或者你需要将计算图本身作为一个可以分析、理解和修改的核心产物,Mobius 就是更合适的工具。
JevONNX 示例显然属于第二种情况。下面我们来看看原因。
示例:将 Jev 风格的决策模型转换为适用于 CPU 的 ONNX 模型
项目仓库:github.com/kinfey/JevONNX
3.1 首先,明确项目的实际定位
Jev 是 TypeSafe 的专有模型。你无法直接下载它并将其转换为 ONNX,而这个项目也没有声称自己能够做到这一点。
社区实际完成的工作同样很有意思:n4ze3m/Qwen3.5-4B-Hmm 是"一种实验性的开放模型尝试,旨在复现 Jev 所引入的 System One 工作流的核心理念和请求结构。"它的实现方式是"对 Qwen3.5-4B 进行微调,使其通过选项概率回答带类型的问题,而不是生成普通文本。"
JevONNX 的 README 对项目的能力边界作出了明确说明。我希望在这里再次强调这些限制,而不是将它们隐藏起来:
"Hmm 不是 Jev,与 TypeSafe AI 没有从属关系,也不会复现 Jev 的专有模型架构、并行采样器、性能、校准能力或类型安全保证。Hmm 模型卡明确指出,其能力不及 Jev。"
此外,项目还指出:"这种复现是在行为层面,而不是在架构层面。"
项目比较表对两者的区别进行了直接说明: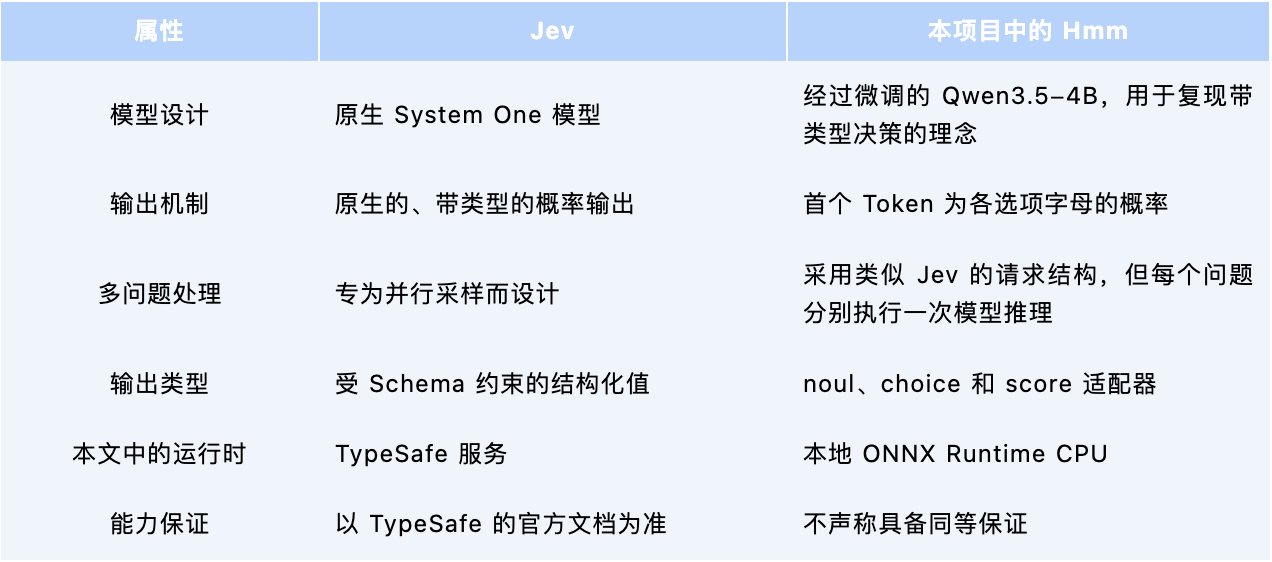
它的实现机制非常直观:适配器会将每个带类型的问题转换为一个精确的多选题提示,然后*"读取第一个生成 Token 中 A、B、C 及后续选项字母对应的 logits,并将其归一化为概率。"* 不需要解析 JSON,不需要在输出格式错误时重试,也不需要使用正则表达式。概率分布本身就是答案。
3.2 为什么这里特别需要 Mobius?
Qwen3.5 采用的是一种混合架构,这正是这个项目与 Mobius 密切相关的原因。
导出的模型包含 32 个混合解码器层 。线性注意力层需要维护 conv_state 和 recurrent_state,而完整注意力层则需要维护键值缓存。在这个模型产物中,完整注意力层位于索引 3、7、11、15、19、23、27 和 31。
这一设计带来了什么实际影响?README 给出了如下说明:
"提示词需要逐个 Token 进行处理,同时,每一个现有的输出都会被反馈到与之对应的 past_key_values.输入中。这不同于传统的仅解码器模型示例,后者可以在一次调用中完成整个提示词的预填充。"
这是一个计算图结构问题,不能仅靠一个配置开关就轻松解决。你需要导出的计算图具有明确、可检查的状态契约,而这正是声明式构建能够提供的能力。该项目的实现"遵循了 Mobius 的 examples/text_generation.py 示例结构,同时增加了 Qwen3.5 所需的混合状态处理逻辑。"
3.3 转换流程
Markdown
n4ze3m/Qwen3.5-4B-Hmm-Q4_K_M.gguf
        │  SHA-256 校验
        ▼
Mobius GGUF 读取器 / 导入器
        │  元数据与张量映射
        │  构建 Qwen3.5 混合架构计算图
        │  Q4_K_M → 打包后的量化目标存储格式
        │  CPU 执行提供程序优化
        ▼
onnx_outputs/
 ├── model.onnx
 ├── model.onnx.data
 ├── quantization_report.json
 ├── tokenizer.json
 ├── tokenizer_config.json
 ├── chat_template.jinja
 └── cpu_test_summary.json
        │
        ▼
ONNX Runtime CPUExecutionProvider
        │  逐 Token 进行混合状态预填充
        │  获取首个 Token 中 A/B/C/... 对应的概率
        ▼
带类型的决策 JSON 响应
只需一条命令即可完成转换:
Bash
mobius build-gguf Qwen3.5-4B-Hmm-Q4_K_M.gguf \
  --output onnx_outputs \
  --ep cpu \
  --dtype f32 \
  --release
有两个细节值得特别注意:
-
这里有意不使用
--dequantize。 保留量化存储格式,可以"显著减小输出文件体积,相比之下,完全反量化为 FP32 的模型会大得多。"即使保留量化存储,外部数据文件仍然约有 2.6 GB。可以想象,如果完全反量化,文件会有多大。 -
不要盲目信任预设参数,要检查报告。 "Q4_K 转换可能涉及有损的仿射重新打包,因此应检查 quantization_report.json,而不是直接假定转换结果与源模型预设完全一致。" 这类说明正是区分演示项目与可部署方案的关键。
3.4 可复现性------我真正希望你借鉴的部分
README 使用表格记录了每一个固定版本: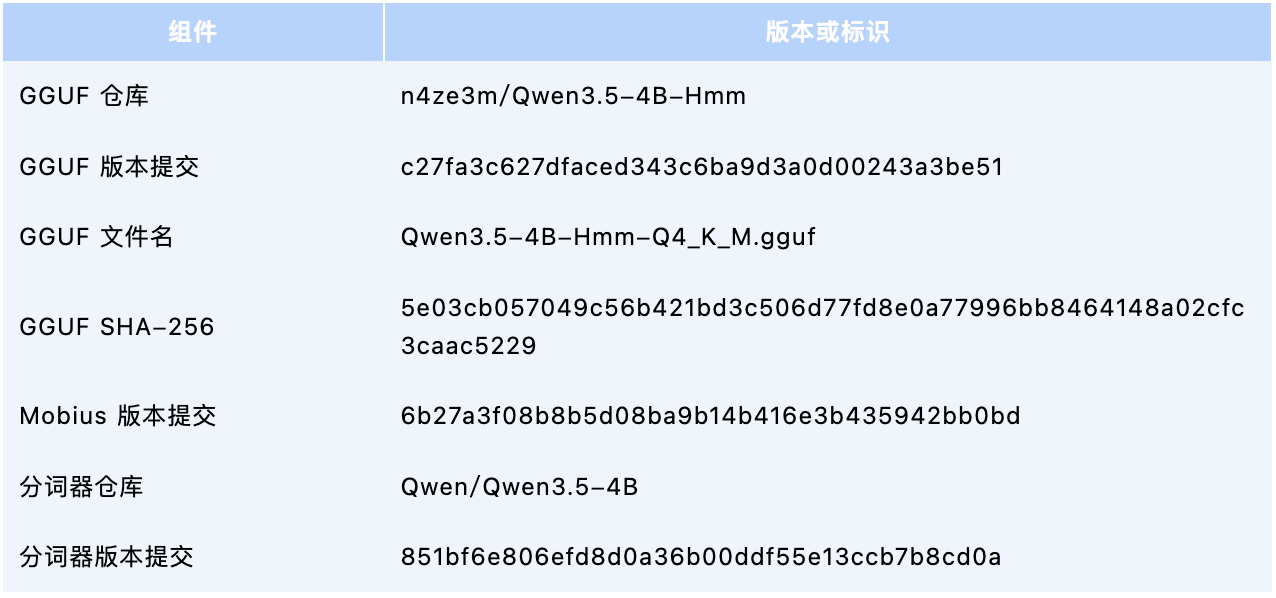
Notebook 并没有直接安装预编译的软件包,而是根据固定的 Git 源代码版本构建 Mobius wheel 安装包。对于一个提交次数已经超过 500 次、仍在快速迭代的项目而言,这并不是过度谨慎,而是确保你下个月仍然能够复现这次转换的唯一可靠方式。
3.5 如何运行
这个项目主要由两个文件组成:
-
Qwen3_5_4B_Hmm_GGUF_to_CPU_ONNX_Mobius_fixed.ipynb:用于在 Colab 中执行转换和验证的工作流。 -
run_hmm_onnx.py:独立运行带类型决策任务的脚本。
在具有较大内存的 Colab CPU 运行环境中运行 Notebook。它会在 Colab 中将输出写入 /content/onnx_outputs,在其他环境中则写入 .mobius_colab_run/onnx_outputs。
接下来运行:
Bash
python run_hmm_onnx.py --model-dir .mobius_colab_run/onnx_outputs
python run_hmm_onnx.py --model-dir .mobius_colab_run/onnx_outputs --request request.json
请求由状态信息和带类型的问题组成:
JSON
{
  "state": "Help! My payouts have failed for 3 days. I need the money today.",
  "questions": {
    "is_urgent": {
      "type": "noul",
      "instructions": "Does this message convey urgency?"
    },
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "billing": "Payments, invoicing, refunds",
        "technical": "Bugs, outages, integrations",
        "sales": "Pricing, upgrades, new accounts"
      }
    },
    "priority": {
      "type": "score",
      "instructions": "How urgent is this request?",
      "criteria": ["Not urgent", "Normal", "Urgent", "Critical"]
    }
  }
}
也可以通过 Python 调用:
Python
from pathlib import Path
from run_hmm_onnx import HmmOnnx

model = HmmOnnx(Path(".mobius_colab_run/onnx_outputs"))
response = model.decide({
    "state": "Help! My payouts have failed for 3 days.",
    "questions": {
        "is_urgent": {
            "type": "noul",
            "instructions": "Does this message convey urgency?",
        }
    },
})
print(response)
3.6 三种决策类型
noul------类似可空类型的"是/否"概率,表示真实选项对应的概率:
JSON
{ "type": "noul", "noul": 0.9745 }choice------返回概率最高的选项键、所有经过归一化的选项概率,以及一个用于衡量概率分布集中程度的置信度值:
JSON
{ "type": "choice", "choice": "billing", "probabilities": { "billing": 0.7216, "technical": 0.2759, "sales": 0.0025 }, "confidence": 0.5823 }score------返回预期数值等级、等级说明、归一化后的概率,以及置信度:
JSON
{
  "type": "score",
  "score": 2.6653,
  "legend": { "0": "Not urgent", "1": "Normal", "2": "Urgent", "3": "Critical" },
  "probabilities": { "0": 0.0061, "1": 0.0361, "2": 0.2443, "3": 0.7135 },
  "confidence": 0.618
}
我们可以仔细看一下这个 score 输出。模型并没有简单地告诉你"这是紧急情况",而是返回了 2.6653 。这个数值对应的概率分布明显偏向 Critical(危急) ,但 Urgent(紧急) 仍然占有一定的概率权重。这是一个可以直接用于路由逻辑、设置阈值、记录日志以及进行 A/B 测试的数值。这也体现了两者之间的区别:一个大语言模型只是声称自己有多大把握,而概率分布则可以通过实际数据进行校准。
有一个限制需要注意:Hmm 的训练范围是 26 个选项字母。 对于更大的选项集合,系统会将其拆分为多个每组最多包含 25 个选项的分组,并在每组中增加一个 none_of_these(以上都不是)选项。这与参考 Hmm 服务采用的策略一致。
3.7 它真的能运行吗?
可以。README 报告称,生成的模型已经在搭载 Apple Silicon 芯片的 CPU 上通过 ONNX Runtime 直接运行。这意味着,一个采用混合架构的 40 亿参数模型,可以从 GGUF 转换为 ONNX,并在笔记本电脑的 CPU 上执行带类型的决策任务,而不依赖任何外部服务。
如果要向开发者介绍这个项目,我会强调什么?
即使模型本身无法迁移,System One 的理念仍然可以迁移。 你无法在本地运行 Jev,但可以借助开放模型和 ONNX 计算图,在今天就对其核心模式进行原型验证:输入状态,输出带类型的决策及其概率。正如 TypeSafe 所说,结构化输出*"可以作为模糊决策规则融入常规软件:在手写逻辑过于脆弱的地方执行分类、路由、评分、信息提取或分支判断。"*这是一种设计模式,而不是某个特定产品。
概率才是真正的核心价值。 这类模型的重要性并不只在于速度。TypeSafe 提出了一个很有力的观点:"如果一个模型在 95% 的情况下能够完成任务,却无法指出哪些情况属于剩下的 5%,那么它就无法真正自动化这项任务。" 每一个曾经将基于大语言模型的功能投入生产环境的工程师,都一定遇到过这样的瓶颈。
合理设定预期,诚实说明能力边界。 JevONNX 是一个用于学习和验证理念的复现项目。它能够让你在本地 CPU 上运行 noul、choice 和 score 三类决策,但无法提供 Jev 的校准能力、并行采样器或类型安全保证------项目自己的 README 已经明确说明了这一点。在演示项目时,也应该一并说明这些限制。
Mobius 是一项值得了解的基础设施技术。 当一种新架构出现时------例如混合注意力机制、新型 MoE 路由方案,或者由三个模型组成的多模态导出流程------我们需要思考的问题就不再是"导出器是否支持它",而是"我应该组合哪些组件"。这显然是一个更值得探讨的问题。
相关链接
-
Mobius:https://github.com/onnxruntime/mobius/?wt.mc_id=3reg_webpage_reactor
-
ONNX Runtime GenAI Model Builder:https://github.com/microsoft/onnxruntime-genai/tree/main/src/python/py/models/?wt.mc_id=3reg_webpage_reactor
-
JevONNX 示例:https://github.com/kinfey/JevONNX/?wt.mc_id=3reg_webpage_reactor
-
System One 模型与 Jev 介绍:https://typesafe.ai/blog/introducing-system-one-models-and-jev/?wt.mc_id=3reg_webpage_reactor
-
Hugging Face 模型:https://huggingface.co/lokinfey/Qwen3_5_4B_Hmm_ONNX/?wt.mc_id=3reg_webpage_reactor