深度 | 记忆的第二幕:当聊天记录变成生产状态
2026 年 8 月的最后一周,两件都叫 memory 的事几乎同时发生,一件在手机上,一件在代码仓库里。
谷歌在收紧安卓应用的内存:从 2027 年 2 月起,一台 8GB 内存的手机上,前台应用最多占 2.25GB、后台 1.5GB,超限的应用会被放慢、杀掉、甚至失去 Play 商店的可见度。TechCrunch 把这波动作叫做「AI 的内存危机」,机制是 AI 数据中心抢走了高带宽内存的产能,手机厂商开始少配 RAM,而端侧模型(Gemini Nano 这类)自己还要吃掉权重、token 缓冲和张量。
几乎同一周,腾讯云的数据库团队把 Agent Memory 开源了:一个 MIT 协议、约 2.78 万星的项目,把「对话、文档、代码」转成四种可治理、可共享、可跨 Agent 复用的记忆资产。再往前推一个月,MindMemOS 开源,被量子位等多家媒体归因到华为诺亚方舟实验室,把记忆做成了一个「可移植、自进化的记忆操作系统」,量子位给的标题是「AI 不再用完即忘」。
一个是内存(RAM),一个是记忆(memory)。它们在同一个八月撞在一起,指向的是同一件事:Agent 记忆正在从聊天功能变成生产状态。判断它「基础设施化」的标志,从基准分换成了它开始长出基础设施才有的器官:数据库的分层、操作系统的解耦、控制面的原语,以及被硬件逼出来的分层治理。我判断,未来 12 个月这个品类的主战场会从「谁检索得更准」挪到「谁更扛得住生产」。
数据库级的记忆:腾讯把记忆做成了带治理的库
腾讯云 TencentDB Agent Memory 是这轮「记忆数据库化」最完整的样本。它跳出了向量检索库的范畴,是一个组织级记忆底座:把输入转成 Chat Memory、Skill、LLM-Wiki、Code-Graph 四类资产,配一个 Memory Hub 控制台做归属、版本、状态、用量和权限管理(私密 / 团队 / 受限三档可见性)。
它最值得看的是分层结构。长记忆被做成一座四层的语义金字塔:L0 会话记录、L1 原子事实、L2 场景、L3 人设。底层的事实、日志、trace 落在数据库里做全文检索;上层的人设、场景、任务画布则以人类可读的 Markdown 存,为的是白盒审计。默认后端是本地 SQLite 加 sqlite-vec,零外部依赖;进阶路径接腾讯云向量库,走 BM25 加向量再加 RRF 的混合检索。官方给的数字是:接 OpenClaw 跑长会话,WideSearch 的 token 消耗降 61.38%,SWE-bench 降 33.09%。
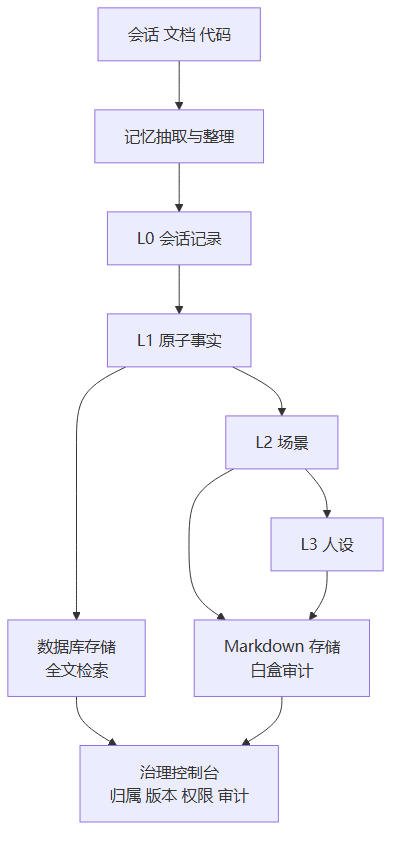
上图:TencentDB Agent Memory 的分层记忆模型,事实下沉到数据库、人设上浮为可读的 Markdown,两者都收口到治理层。
同一方向还有两家,但走的是不同侧面。Zep 的 Graphiti 做双时态知识图谱,为的是时间正确性,这在受监管行业和需要「查某个时间点的真值」的场景是刚需。Semantica 走得更彻底,把「决策」做成图里的一等节点,带生命周期、因果链和审计轨迹,而且图的构建、推理、溯源都不需要再调一次 LLM,是一条确定性管线。它有一个细节值得注意:发布了 semantica-cn 这个中文变体,等于明说要把中文市场当成主阵地。
双时态值得多解释一句:一条事实同时带着「有效时间」(事实何时为真)和「交易时间」(系统何时记录下它),两者分离之后,系统才能在用户三个月后更正自己时不覆盖历史,而是保留完整的修正链。这是数据库里成熟的时态建模,被原样搬进了记忆层。
把这三家放一起,能看到一个共同的动作:记忆在获得数据库的器官,时间有效性、来源追踪、冲突处理、版本历史。一份叫「当记忆变成生产状态」的白皮书把这个论点说得最直白:由 LLM 生成、改写、查询的记忆,必须像数据库记录一样被管理,团队会撞上备份、灾难恢复、数据一致性、调试这些运维问题;一个记忆管理上的 bug 可能污染上下文,再把错误扩散到未来许多次交互。它主张的是记忆要能回滚、能版本化、能做一致性检查。现有 DevOps 的教科书里没有这一章。
记忆操作系统:把记忆从 Agent 身上拆下来
如果说腾讯在做「记忆的数据库」,华为诺亚方舟的 MindMemOS 在做「记忆的操作系统」。区别在于解耦的对象:前者把记忆变成库里的一等公民,后者把记忆从任何一个具体的 Agent 和框架里拆出来,做成独立的一层。
MindMemOS 的三层结构很清晰:Agent 访问层、记忆算法层(抽取、检索、反馈、整理、进化)、存储层。记忆被建模成「实体---属性---时间」的统一结构,带完整时间线,不再依赖模板。它有两个生成路径:MindVanilla 开放域无模板,MindSchema 按预设 schema 做规则抽取;检索走「外层 Agentic 规划器加内层 BM25 稀疏加稠密语义」的混合。技术栈是 Qdrant 加 Neo4j 加 Kafka,观测侧接 ClickHouse、OpenTelemetry、Grafana。
上图:MindMemOS 把记忆从 Agent 身上拆成三层,算法层与存储层可独立替换,Dreaming 在离线时做整理与进化。
「Dreaming」是它最有记忆点的机制:在两次任务之间的空档做离线整理,合并冗余记录、消解冲突,用校验驱动的进化搜索去优化记忆 schema。论文给的数字是:Dreaming 把活跃记忆压缩 19.4% 到 23.5%,同时在 MemoryAgentBench 的事实合并子项上把问答准确率拉高最多 10.3 个点;LoCoMo 94.03%。这跟上一幕里 Anthropic 的 Dreaming 是同一个词、同一类产品直觉,价值发生在会话之间的空档,而不是会话之内。
除了 Dreaming,它还有一条技能进化的线:把失败的任务轨迹蒸馏成避错规则,MindSkillEvolve 在 SpreadsheetBench 上比初始技能基线高出 9.2 个点。记忆在这里开始覆盖程序性知识,不止记住事实,还记住怎么做。
解耦这个动作在中文话语里被包装得很统一:记忆操作系统、记忆层、记忆科学、记忆工程,外加一句「AI 用完即忘」。业内流传的三代划分也成形了:会话记忆是第一代,RAG 检索增强是第二代,专用读写记忆层是第三代。一句流传很广的论断是,只提供工作记忆的供应商,实质是牵绳比较长的聊天机器人。Letta(前身 MemGPT)是这个叙事在海外的代表,做可审计的自编辑记忆,种子轮后估值约 7000 万美元,天使名单里有 Jeff Dean 和 Hugging Face 的 Clem Delangue。
控制面:遗忘和回滚正在变成产品原语
一个品类开始「基础设施化」的最硬信号,是它的计价单位和 API 面。记忆这个品类,两个信号都已经出现了。
计价这边,Mem0 按「记忆操作次数」(add / retrieval)计费,而不是按座位:Hobby 免费,Starter 19 美元,Growth 79 美元,Pro 249 美元,Enterprise 走定制。它的定位语是「计量 Agent 的行为,而不是人的座位」。这套阶梯是逐步补出来的:2025 年初只有 249 美元的 Pro,后来往下补了 19 美元的 Starter、再补 79 美元的 Growth,把 13 倍的价差填上。按操作计费,等于把记忆从模型的附属功能,升级成一个可独立量贩的资源。
API 面这边,一套「记忆控制面」的原语在成形。Open Brain 的工具有 forget_v2、forget_many_v2 软删除,prune_v2 硬删过期,decay_facts_v2 按艾宾浩斯曲线衰减,consolidation_candidates_v2 挑出待合并的记录,外加 pin、rate、annotate 这些策展动作。OzBrain 做共享记忆,写入要先 staged、冲突要显式标记、last-write-wins 带版本追踪,每条记忆挂 fresh / aging / stale 的新鲜度标签。这些东西合起来,就是过去数据库里「数据生命周期管理」那一套,只是对象换成了模型生成的记忆。
「遗忘」在 2026 年已经不单是工程上的整洁,还是合规义务。《生成式人工智能服务管理暂行办法》要求及时处理更正、删除的请求,欧盟 GDPR 也有对应的删除权。记忆系统一旦把这些义务做成一等原语,遗忘就从产品特性变成了采购门槛。
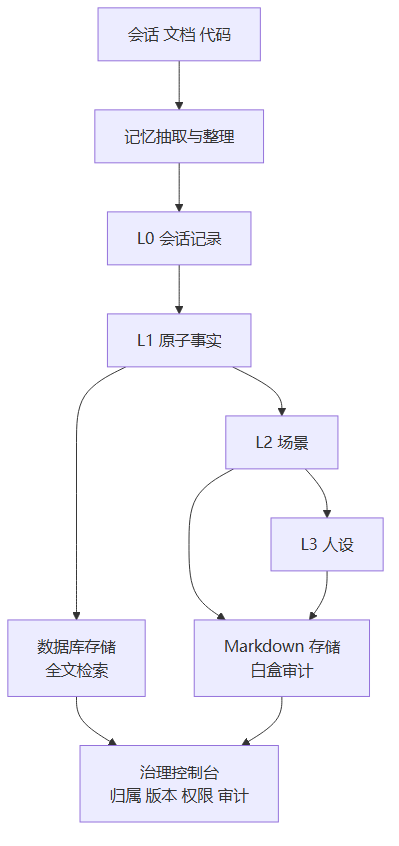
上图:记忆控制面把「遗忘」做成一等原语,写入、整理、衰减、遗忘、回滚构成一个可治理的循环。
但控制面越完整,碎片化越刺眼。一份对「Agent 状态管理层」的清点给的是:14 家以上厂商、约 7 个架构流派、零个共享协议,没有任何可移植性保证。MCP 标准化了工具,A2A 标准化了 Agent 通信,PAP 在标准身份与权限,唯独状态管理这一层没有标准。记忆成了最难迁移的那块,也就成了「正在形成的护城河」。
端侧收紧,云端加码:硬件在逼记忆分层
这一轮最容易被漏掉的外部力量,是硬件。端侧和云端在同时挤压,方向相反,效果却一致,都在逼记忆变成可治理的分层系统。
端侧在收紧。谷歌给安卓定的内存上限,落到 8GB 手机上就是前台 2.25GB、后台 1.5GB,配套的还有位图上限、DEX 代码体积要缩 25%、以及 Play Console 里一整套内存诊断工具。手机厂商开始少配 RAM,Pixel 11 基础版的内存比前代更少。开发者被反复告知的应对是:按需加载模型、4-bit 量化权重、流式传数据,也就是把本地模型的常驻内存压下去,而不是把所有东西都搬到云端。
收紧的根源是一条硬件经济学:AI 训练把 DRAM 产能往高带宽内存(HBM)那边拉,普通 LPDDR 和手机内存的供应被挤占、价格走高,厂商于是少配 RAM。端侧内存的稀缺,直接变成了对「记忆该不该常住本地」的硬约束。
苹果站在另一端,路线是 on-device-first:Siri 的本地模型 AFM Core Advanced 约 200 亿稀疏参数、每次请求只激活 1 到 4 亿,重活丢给无状态的 Private Cloud Compute。它的态度是「本地记住、云端无状态」,跟谷歌「云端有状态、本地 Nano 减负」正好相反。两端对记忆的取舍相反,共同点是都把「记忆住哪一层」当成了一个要治理的架构决策,而不是默认塞进上下文。
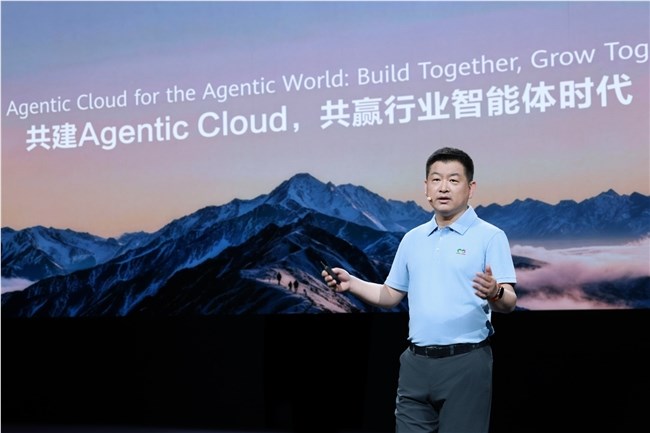
上图:华为云 2026 全联接大会现场图(CMS 记忆存储发布),2026-09-18,来源:站长之家 chinaz.com
云端在加码,而且是国内厂商动作更大。华为云 9 月 18 日在全联接大会上发布的 CMS 记忆存储,是一个 PB 级、号称缓存命中率 95% 的记忆空间,把 KV Cache 做成三层池化:L1 显存、L2 内存池、L3 PB 级磁盘,冷数据落盘、热数据回迁,推理代码一行都不用改。更激进的一步是 NPU 直连存储,把读写路径从「NPU 到 CPU 到存储栈到 SSD」砍成「NPU 直连 ASU」,存储端自己维护语义索引。给出的量是:单 token 成本降 30%,首 token 延迟降 90%,数据访问延迟降 50%。
把端侧收紧和云端加码放在一起读,结论是:记忆正在被硬件逼成一件要分层、要治理、要按成本阶梯设计的事。这跟上一幕「记忆卖的是 token 账单」是同一根线,只是这一次,账本从软件层一路铺到了硅片和 DRAM 上。
谁在为「生产状态」买单
最后落到钱。买「记忆即基础设施」的人,图的是更硬的合规和更低的重复成本,而不是更好的闲聊。
具名的案例开始出现。V7 在金融、保险、地产行业把内部文件转成上下文图,据其公布的客户案例,最难的图查询上 GPT-6 级模型答对 89%、单文档成本降 78%、精度涨 11.6 个点,主打的卖点是「99.9% 精度和可审计的数据血缘」。MemoraX 面向医疗、金融、法律卖标准化的记忆模块。国内客服和金融场景流行的一套说法是「先调记忆、再推理」:售后不用再问一遍设备型号,直接从记忆里取,多轮 token 成本随之下降。
中国市场的规模预期给得很激进:爱分析把中国记忆市场从 2025 年的 14.4 亿元一路推到 2030 年的 642.5 亿元,五年复合增速超过 110%。这个数要连着定义一起看,它大概率把编排、向量库、云存储都算进了「记忆」里,但它指向的趋势是真的:记忆正在被当成一个单独的市场来估,而不是某个产品的附属功能。
反面的数据同样硬。Gartner 预计到 2027 年底超过四成的 agentic AI 项目会被取消,86% 的企业 Agent 试点走不到生产,前三大拦路石是评估缺口、治理摩擦、模型可靠性。VentureBeat 那组数字更贴题:57% 的企业把「自信但答错」归因于缺失或不一致的业务上下文,而只有 25% 的企业在生产环境跑着一个受治理的上下文层。
回本的计算也在往记忆这边靠。Mem0 自己的年度报告给过一个数:智能体在积累了大约 62 条历史记录后,回答准确率就从 2.5% 量级爬过了 50%,超过专家手调的记忆基线;同一份报告给出,同准确率下记忆方案的成本约为全量上下文的四分之一到三分之一。成本侧的账,正在从「省 token」细化到「记多少条才回本」。
这两组数据拼起来,就是这一场的赌注:记忆被同时当成「从试点到生产的头号拦路石」和「治理摩擦的解药」。我预判,接下来买记忆的企业,付钱的理由会从「让 Agent 更聪明」整体换成「让 Agent 不失忆、可审计、能回滚」。前者按效果付费说不清,后者能直接按节省的 token、减少的重工轮次和审计记录来算账。
现在可以做的三件事
如果你正在选或正在自建记忆层,这三件事比追基准更有用。
- 把「遗忘」写进验收标准。问厂商:怎么删一条记忆、怎么回滚一次误写入、衰减策略谁说了算。答不上来的,大概率还停在聊天功能阶段。
- 按「记忆住哪层」重新算账。把当前每轮的 prefill 成本、缓存命中率、以及端侧场景的内存上限拉出来,判断记忆该压在本地还是落到分层存储。成本交叉点决定架构,而不是反过来。
- 要求可审计的数据血缘。合同里写清记忆的来源追踪、版本历史和导出格式,并实测一次「导出的记忆能不能在新环境里跑起来」。这条现在做成本最低。
记忆的第一幕,讲的是它终于有了真实收入、真实锁定和真实失败。第二幕讲的是它开始变成基础设施,长出数据库的分层、操作系统的解耦、控制面的原语,被硬件逼着分层。先不下结论的是最终会赢的形态:是腾讯式的「记忆数据库」、华为式的「记忆操作系统」,还是 09 月那篇文件系统测试里朴素到极点的「把记忆当文件」。这三种形态现在都有真实的工程样本,而基础设施的历史里,通常是几种形态各自占住一层,很少有某一种一统天下。
参考来源
- TencentDB Agent Memory 官方仓库(腾讯云)
- MindMemOS 官方仓库(华为诺亚方舟实验室)
- MindMemOS 技术报告(arXiv:2608.12428)
- Semantica 官方文档
- TechCrunch:AI's memory crunch is coming for Android apps
- 量子位:华为诺亚开源 MindMemOS
- 华为云 CMS 记忆存储发布报道(站长之家)
- Mem0:State of AI Agent Memory 2026
- The Agent State Management Layer Is Fracturing(Yahoo Tech)
- When AI Memory Becomes Production State(ClawdBytes 转述 Jason Doyle)
- Open Brain 记忆工具参考
- OzBrain 共享记忆架构(DEV Community)
- Mem0 定价拆解(UsagePricing)
- 爱分析:中国记忆市场研究报告(格隆汇转述)
每日更新。