研究 Transformer 架构,就像掀开汽车引擎盖。里面塞满了陌生零件:嵌入、位置编码、注意力、多头、层归一化、跳跃连接、Softmax、Nx、查询、键、值、掩码......名字一个比一个唬人。
但究其核心,在于两个最本质的组件:
- 注意力加权(Attention Weighting):让每个位置从其他位置吸收相关信息。
- 前馈网络(Feed-Forward Network, FFN):对每个位置的特征做非线性变换。
其他所有设计------残差、归一化、多头、堆叠、位置编码------都是为了让这两个核心跑得更快、更稳、更久。这正是我们从轿车进化到卡车,也是"大语言模型"里那个"大"字的由来。
理解这两个组件,可以从两条线索入手:
- 水平与垂直:注意力在位置之间横向混合,FFN 在特征维度上纵向变换。
- 线性与非线性:注意力用非线性算权重、用线性做汇总;FFN 用线性搭骨架、用非线性填血肉。
下面分两部分展开。第一部分用手算的方式,把这两个组件从头到尾跑一遍 ,让发动机转起来。第二部分梳理这两个组件背后的数学原理,看看这台发动机为什么能跑、能跑多远、能跑多稳。
第一部分:手算一个 Transformer 模块
数据来自一套经典的手算示意图1,它的设计非常巧妙:注意力权重是 0/1 整数,FFN 权重包含负数,并且通过"加一行 1"把偏置藏进了输入。这让每一步计算都清晰可验证。
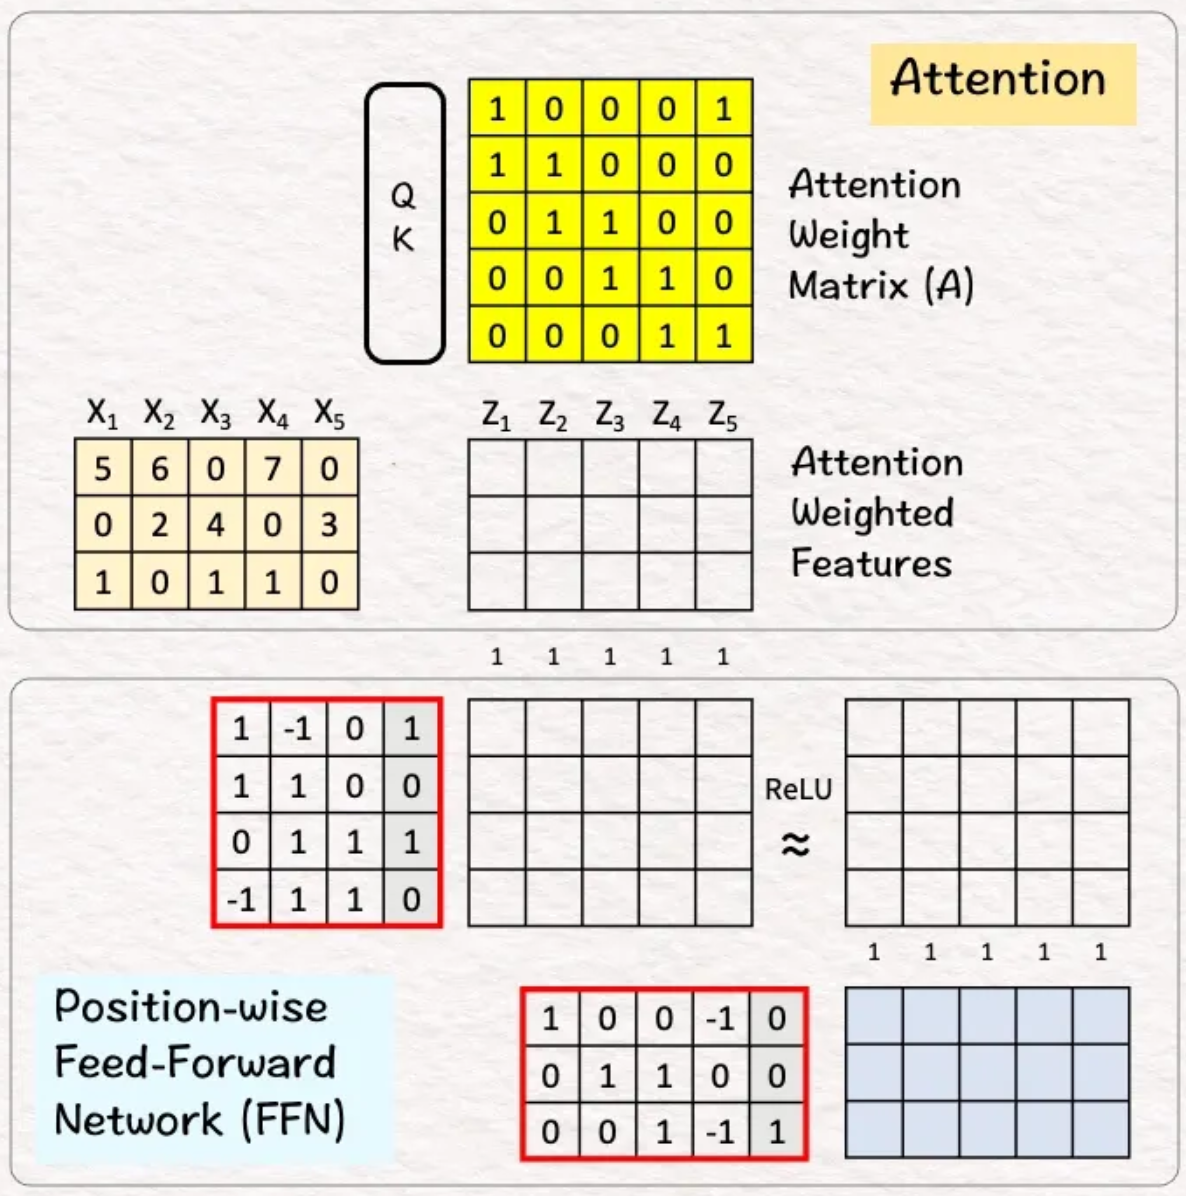 图 1:Transformer 模块完整计算示意图(Attention + FFN)。图片来源:1
一、输入:三个特征维度,五个位置
图中输入矩阵 XXX 采用列 = 位置 的约定,形状是 3 × 5:
X=560700240310110 X= \begin{bmatrix} 5 & 6 & 0 & 7 & 0 \\ 0 & 2 & 4 & 0 & 3 \\ 1 & 0 & 1 & 1 & 0 \end{bmatrix} X= 501620041701030
- 每一列是一个位置:X1,X2,X3,X4,X5X_1, X_2, X_3, X_4, X_5X1,X2,X3,X4,X5
- 每一行是一个特征维度
- 位置 X1=(5,0,1)X_1=(5,0,1)X1=(5,0,1),X2=(6,2,0)X_2=(6,2,0)X2=(6,2,0),X3=(0,4,1)X_3=(0,4,1)X3=(0,4,1),X4=(7,0,1)X_4=(7,0,1)X4=(7,0,1),X5=(0,3,0)X_5=(0,3,0)X5=(0,3,0)
注意矩阵方向 :因为列是位置,后续注意力计算要用 Z=X⋅AZ = X \cdot AZ=X⋅A,而不是 A⋅XA \cdot XA⋅X. 这个细节决定了矩阵乘法能不能对上。
二、注意力加权:第一个核心组件
2.1 注意力权重矩阵 A
注意力权重矩阵 AAA 是 5 × 5,采用 0/1 形式(真实场景下是 Softmax 后的概率,这里简化为 0/1,不影响理解流程):
A=1000111000011000011000011 A= \begin{bmatrix} 1 & 0 & 0 & 0 & 1 \\ 1 & 1 & 0 & 0 & 0 \\ 0 & 1 & 1 & 0 & 0 \\ 0 & 0 & 1 & 1 & 0 \\ 0 & 0 & 0 & 1 & 1 \end{bmatrix} A= 1100001100001100001110001
含义很直白:
- 位置1看 X1X_1X1 和 X5X_5X5
- 位置2看 X1X_1X1 和 X2X_2X2
- 位置3看 X2X_2X2 和 X3X_3X3
- 位置4看 X3X_3X3 和 X4X_4X4
- 位置5看 X4X_4X4 和 X5X_5X5
这个矩阵不是拍脑袋定的。真实计算中,它由 Q=XWQQ = XW_QQ=XWQ、K=XWKK = XW_KK=XWK、A=Softmax(QKT/dk)A = \text{Softmax}(QK^T/\sqrt{d_k})A=Softmax(QKT/dk ) 得到,WQ,WKW_Q, W_KWQ,WK 是训练学出来的。这里给定 AAA,是为了把重点放在后续的混合与变换上。
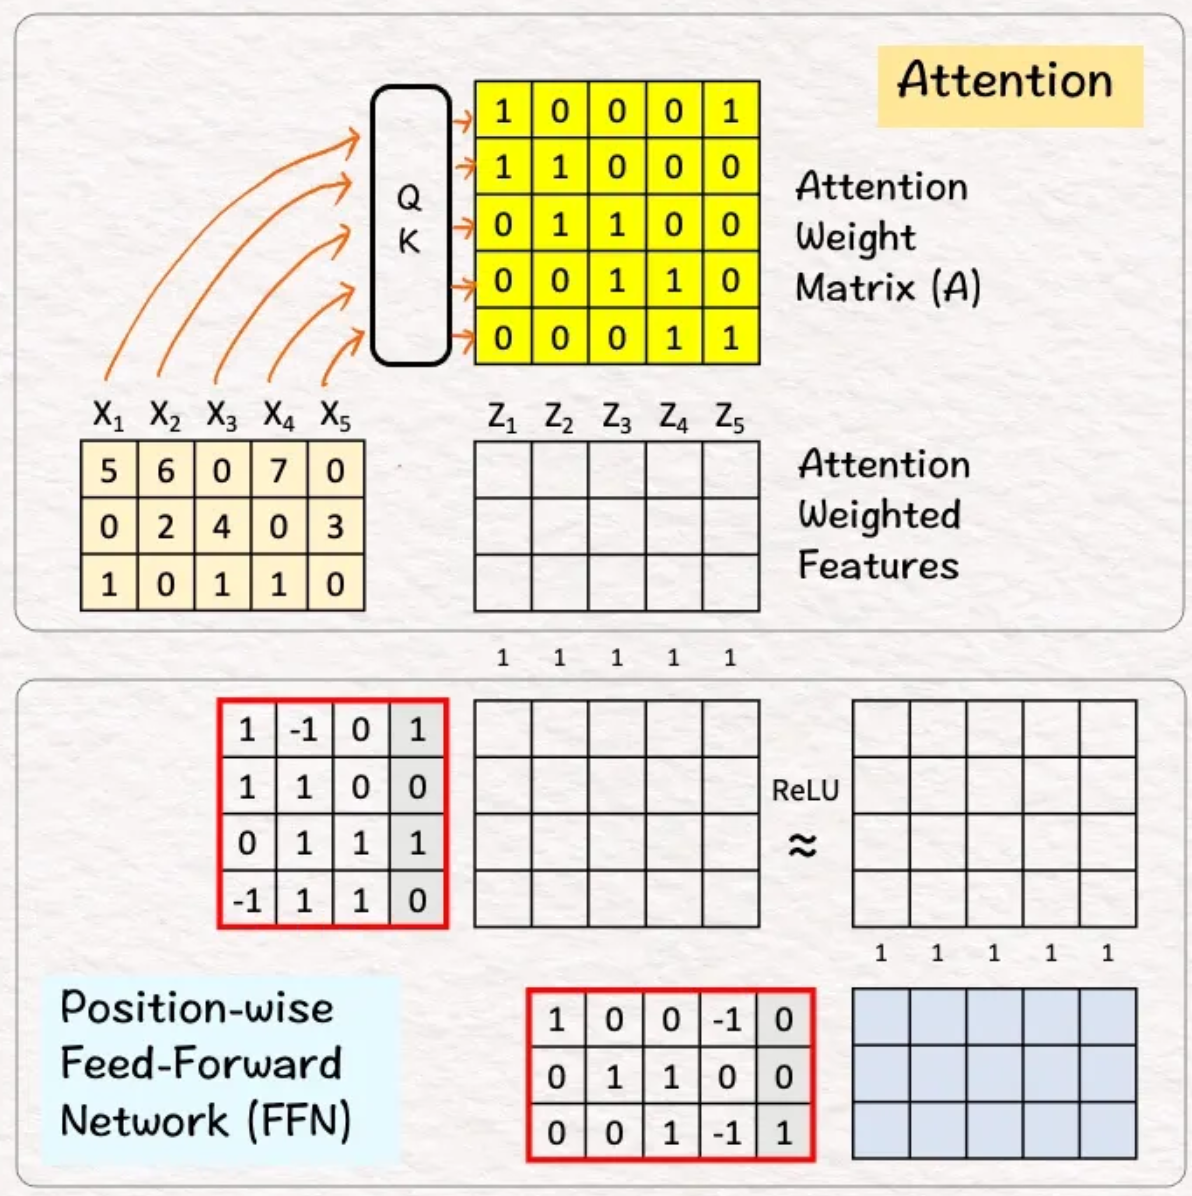 图 2:输入 X 与注意力权重矩阵 A。图片来源:1
2.2 注意力加权:Z = X · A
计算 Z=X⋅AZ = X \cdot AZ=X⋅A. 维度检查:XXX 是 3 × 5,AAA 是 5 × 5,乘出来 ZZZ 是 3 × 5,形状不变。
逐元素计算 Zi,j=∑k=15Xi,kAk,jZ_{i,j} = \sum_{k=1}^{5} X_{i,k} A_{k,j}Zi,j=∑k=15Xi,kAk,j。
第1行 (特征维度1,X 第一行 (5,6,0,7,0)(5,6,0,7,0)(5,6,0,7,0)):
- Z1,1=5×1+6×1+0×0+7×0+0×0=11Z_{1,1} = 5×1 + 6×1 + 0×0 + 7×0 + 0×0 = 11Z1,1=5×1+6×1+0×0+7×0+0×0=11
- Z1,2=5×0+6×1+0×1+7×0+0×0=6Z_{1,2} = 5×0 + 6×1 + 0×1 + 7×0 + 0×0 = 6Z1,2=5×0+6×1+0×1+7×0+0×0=6
- Z1,3=5×0+6×0+0×1+7×1+0×0=7Z_{1,3} = 5×0 + 6×0 + 0×1 + 7×1 + 0×0 = 7Z1,3=5×0+6×0+0×1+7×1+0×0=7
- Z1,4=5×0+6×0+0×0+7×1+0×1=7Z_{1,4} = 5×0 + 6×0 + 0×0 + 7×1 + 0×1 = 7Z1,4=5×0+6×0+0×0+7×1+0×1=7
- Z1,5=5×1+6×0+0×0+7×0+0×1=5Z_{1,5} = 5×1 + 6×0 + 0×0 + 7×0 + 0×1 = 5Z1,5=5×1+6×0+0×0+7×0+0×1=5
第2行 (特征维度2,X 第二行 (0,2,4,0,3)(0,2,4,0,3)(0,2,4,0,3)):
- Z2,1=0×1+2×1+4×0+0×0+3×0=2Z_{2,1} = 0×1 + 2×1 + 4×0 + 0×0 + 3×0 = 2Z2,1=0×1+2×1+4×0+0×0+3×0=2
- Z2,2=0×0+2×1+4×1+0×0+3×0=6Z_{2,2} = 0×0 + 2×1 + 4×1 + 0×0 + 3×0 = 6Z2,2=0×0+2×1+4×1+0×0+3×0=6
- Z2,3=0×0+2×0+4×1+0×1+3×0=4Z_{2,3} = 0×0 + 2×0 + 4×1 + 0×1 + 3×0 = 4Z2,3=0×0+2×0+4×1+0×1+3×0=4
- Z2,4=0×0+2×0+4×0+0×1+3×1=3Z_{2,4} = 0×0 + 2×0 + 4×0 + 0×1 + 3×1 = 3Z2,4=0×0+2×0+4×0+0×1+3×1=3
- Z2,5=0×1+2×0+4×0+0×0+3×1=3Z_{2,5} = 0×1 + 2×0 + 4×0 + 0×0 + 3×1 = 3Z2,5=0×1+2×0+4×0+0×0+3×1=3
第3行 (特征维度3,X 第三行 (1,0,1,1,0)(1,0,1,1,0)(1,0,1,1,0)):
- Z3,1=1×1+0×1+1×0+1×0+0×0=1Z_{3,1} = 1×1 + 0×1 + 1×0 + 1×0 + 0×0 = 1Z3,1=1×1+0×1+1×0+1×0+0×0=1
- Z3,2=1×0+0×1+1×1+1×0+0×0=1Z_{3,2} = 1×0 + 0×1 + 1×1 + 1×0 + 0×0 = 1Z3,2=1×0+0×1+1×1+1×0+0×0=1
- Z3,3=1×0+0×0+1×1+1×1+0×0=2Z_{3,3} = 1×0 + 0×0 + 1×1 + 1×1 + 0×0 = 2Z3,3=1×0+0×0+1×1+1×1+0×0=2
- Z3,4=1×0+0×0+1×0+1×1+0×1=1Z_{3,4} = 1×0 + 0×0 + 1×0 + 1×1 + 0×1 = 1Z3,4=1×0+0×0+1×0+1×1+0×1=1
- Z3,5=1×1+0×0+1×0+1×0+0×1=1Z_{3,5} = 1×1 + 0×0 + 1×0 + 1×0 + 0×1 = 1Z3,5=1×1+0×0+1×0+1×0+0×1=1
得到注意力加权特征:
Z=1167752643311211 Z= \begin{bmatrix} 11 & 6 & 7 & 7 & 5 \\ 2 & 6 & 4 & 3 & 3 \\ 1 & 1 & 2 & 1 & 1 \end{bmatrix} Z= 1121661742731531
这一步做了什么:
- 形状不变:还是 3 × 5,特征维度没变,位置数量没变。
- 内容混合 :**每个位置吸收了邻居的信息。**位置1变成了 X1+X5X_1 + X_5X1+X5,位置2变成了 X1+X2X_1 + X_2X1+X2,以此类推。
- 本质是线性加权:注意力的非线性体现在"权重怎么算"上(Softmax 竞争),而不是"怎么加权"上。一旦权重定好,汇总过程就是线性的。
- 这是水平方向的操作:在不同位置之间进行信息交换。
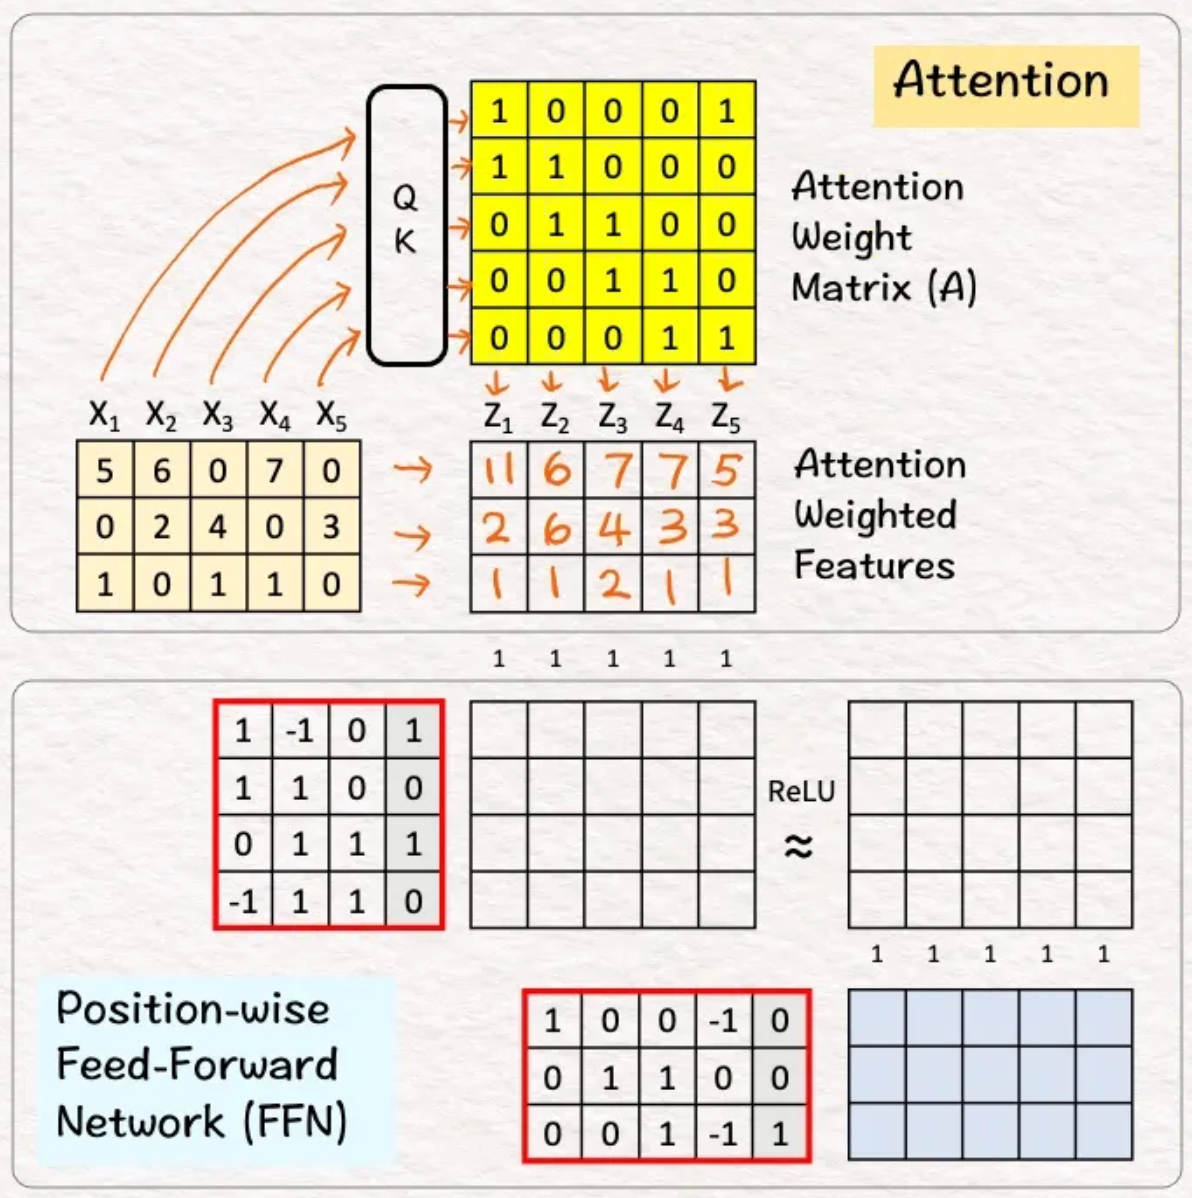 图 3:注意力加权特征 Z = X · A。图片来源:1
三、关键设计:给 Z 加一行 1
在进入 FFN 之前,图中做了一个非常巧妙的操作:在 Z 矩阵下方加了一行全为 1 的行 ,使 Z 从 3 × 5 变成 4 × 5。
Z′=116775264331121111111 Z'= \begin{bmatrix} 11 & 6 & 7 & 7 & 5 \\ 2 & 6 & 4 & 3 & 3 \\ 1 & 1 & 2 & 1 & 1 \\ 1 & 1 & 1 & 1 & 1 \end{bmatrix} Z′= 112116611742173115311
这行 1 的作用:
- 凑维度 :FFN 第一层的权重矩阵 W1W_1W1 是 4 × 4,需要 4 维输入。原来的 Z 只有 3 维,加一行 1 变成 4 维,才能和 W1W_1W1 相乘。
- 充当偏置 :在标准 FFN 中,公式是 FFN(x)=ReLU(xW1+b1)W2+b2\text{FFN}(x) = \text{ReLU}(xW_1 + b_1)W_2 + b_2FFN(x)=ReLU(xW1+b1)W2+b2,偏置 b1b_1b1 是直接加在输出上的。这里把偏置"吸收"进了权重矩阵:把输入扩展一维(加个 1),权重矩阵扩展一列(对应偏置值)。数学上完全等价:
x,1⋅Wb=xW+b x, 1 \cdot \begin{bmatrix} W \\ b \end{bmatrix} = xW + b x,1⋅Wb=xW+b
这种技巧叫增广矩阵 或齐次坐标,目的是把仿射变换(线性变换 + 平移)统一写成矩阵乘法。
四、前馈网络:第二个核心组件
4.1 第一层 FFN:4 维到 4 维
图中 FFN 第一层的权重矩阵 W1W_1W1(红色框)是 4 × 4:
W1=1−10111000111−1110 W_1= \begin{bmatrix} 1 & -1 & 0 & 1 \\ 1 & 1 & 0 & 0 \\ 0 & 1 & 1 & 1 \\ -1 & 1 & 1 & 0 \end{bmatrix} W1= 110−1−111100111010
计算 H=W1⋅Z′H = W_1 \cdot Z'H=W1⋅Z′,维度:4 × 4 乘 4 × 5 = 4 × 5.
位置1 ,Z1′=(11,2,1,1)Z'_1 = (11, 2, 1, 1)Z1′=(11,2,1,1):
- 第1维:1×11+(−1)×2+0×1+1×1=11−2+1=101×11 + (-1)×2 + 0×1 + 1×1 = 11 - 2 + 1 = 101×11+(−1)×2+0×1+1×1=11−2+1=10
- 第2维:1×11+1×2+0×1+0×1=11+2=131×11 + 1×2 + 0×1 + 0×1 = 11 + 2 = 131×11+1×2+0×1+0×1=11+2=13
- 第3维:0×11+1×2+1×1+1×1=2+1+1=40×11 + 1×2 + 1×1 + 1×1 = 2 + 1 + 1 = 40×11+1×2+1×1+1×1=2+1+1=4
- 第4维:−1×11+1×2+1×1+0×1=−11+2+1=−8-1×11 + 1×2 + 1×1 + 0×1 = -11 + 2 + 1 = -8−1×11+1×2+1×1+0×1=−11+2+1=−8
H1=(10,13,4,−8)H_1 = (10, 13, 4, -8)H1=(10,13,4,−8)
位置2 ,Z2′=(6,6,1,1)Z'_2 = (6, 6, 1, 1)Z2′=(6,6,1,1):
- 第1维:6−6+1=16 - 6 + 1 = 16−6+1=1
- 第2维:6+6=126 + 6 = 126+6=12
- 第3维:6+1+1=86 + 1 + 1 = 86+1+1=8
- 第4维:−6+6+1=1-6 + 6 + 1 = 1−6+6+1=1
H2=(1,12,8,1)H_2 = (1, 12, 8, 1)H2=(1,12,8,1)
位置3 ,Z3′=(7,4,2,1)Z'_3 = (7, 4, 2, 1)Z3′=(7,4,2,1):
- 第1维:7−4+1=47 - 4 + 1 = 47−4+1=4
- 第2维:7+4=117 + 4 = 117+4=11
- 第3维:4+2+1=74 + 2 + 1 = 74+2+1=7
- 第4维:−7+4+2=−1-7 + 4 + 2 = -1−7+4+2=−1
H3=(4,11,7,−1)H_3 = (4, 11, 7, -1)H3=(4,11,7,−1)
位置4 ,Z4′=(7,3,1,1)Z'_4 = (7, 3, 1, 1)Z4′=(7,3,1,1):
- 第1维:7−3+1=57 - 3 + 1 = 57−3+1=5
- 第2维:7+3=107 + 3 = 107+3=10
- 第3维:3+1+1=53 + 1 + 1 = 53+1+1=5
- 第4维:−7+3+1=−3-7 + 3 + 1 = -3−7+3+1=−3
H4=(5,10,5,−3)H_4 = (5, 10, 5, -3)H4=(5,10,5,−3)
位置5 ,Z5′=(5,3,1,1)Z'_5 = (5, 3, 1, 1)Z5′=(5,3,1,1):
- 第1维:5−3+1=35 - 3 + 1 = 35−3+1=3
- 第2维:5+3=85 + 3 = 85+3=8
- 第3维:3+1+1=53 + 1 + 1 = 53+1+1=5
- 第4维:−5+3+1=−1-5 + 3 + 1 = -1−5+3+1=−1
H5=(3,8,5,−1)H_5 = (3, 8, 5, -1)H5=(3,8,5,−1)
汇总 HHH(4 × 5):
H=10145313121110848755−81−1−3−1 H= \begin{bmatrix} 10 & 1 & 4 & 5 & 3 \\ 13 & 12 & 11 & 10 & 8 \\ 4 & 8 & 7 & 5 & 5 \\ -8 & 1 & -1 & -3 & -1 \end{bmatrix} H= 10134−8112814117−15105−3385−1
这一步做了什么:
- 垂直方向:在特征维度之间进行组合,每个位置独立变换。
- 逐位置 :五个位置用的是同一套 W1W_1W1。这就是"逐位置"(position-wise)的含义。
- 故意制造负数 :W1W_1W1 里包含 -1,让 HHH 中出现了负数(如 -8, -1, -3),为下一步 ReLU 做准备。
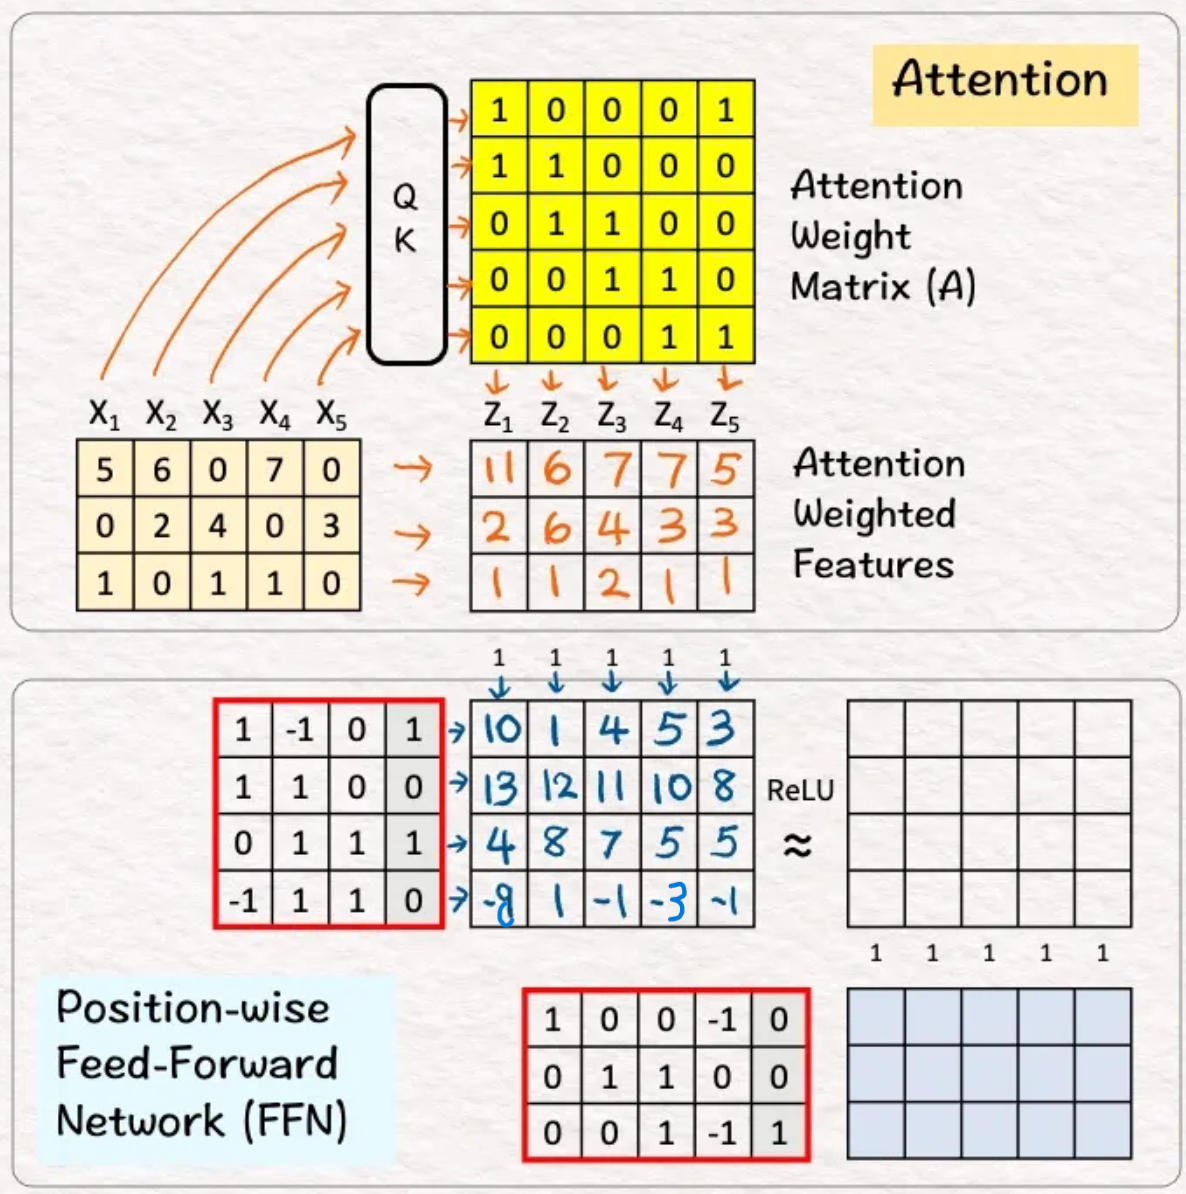 图 4:第一层 FFN,H = W₁ · Z',出现负数。图片来源:1
4.2 ReLU:非线性
ReLU 把负值变成零:
R=ReLU(H) R = \text{ReLU}(H) R=ReLU(H)
把 HHH 中所有负数变成 0:
R=1014531312111084875501000 R= \begin{bmatrix} 10 & 1 & 4 & 5 & 3 \\ 13 & 12 & 11 & 10 & 8 \\ 4 & 8 & 7 & 5 & 5 \\ 0 & 1 & 0 & 0 & 0 \end{bmatrix} R= 1013401128141170510503850
被 ReLU 抹平的负值:
- 位置1:−8→0-8 \to 0−8→0
- 位置3:−1→0-1 \to 0−1→0
- 位置4:−3→0-3 \to 0−3→0
- 位置5:−1→0-1 \to 0−1→0
为什么这一步至关重要:
- 打破线性 :ReLU 不满足可加性。ReLU(1+(−2))=0\text{ReLU}(1+(-2)) = 0ReLU(1+(−2))=0,但 ReLU(1)+ReLU(−2)=1\text{ReLU}(1)+\text{ReLU}(-2) = 1ReLU(1)+ReLU(−2)=1,不相等。这就打破了线性。
- 几何直觉:ReLU 把负半轴压平到零,这是一次"折叠"。线性变换保持空间平坦,非线性变换制造折角。折角越多,能拟合的形状越复杂。
- 没有它一切白干:如果没有 ReLU,第一层 FFN 和第二层 FFN 会合并成一个线性变换,整个 FFN 退化成一层,升维降维毫无意义。
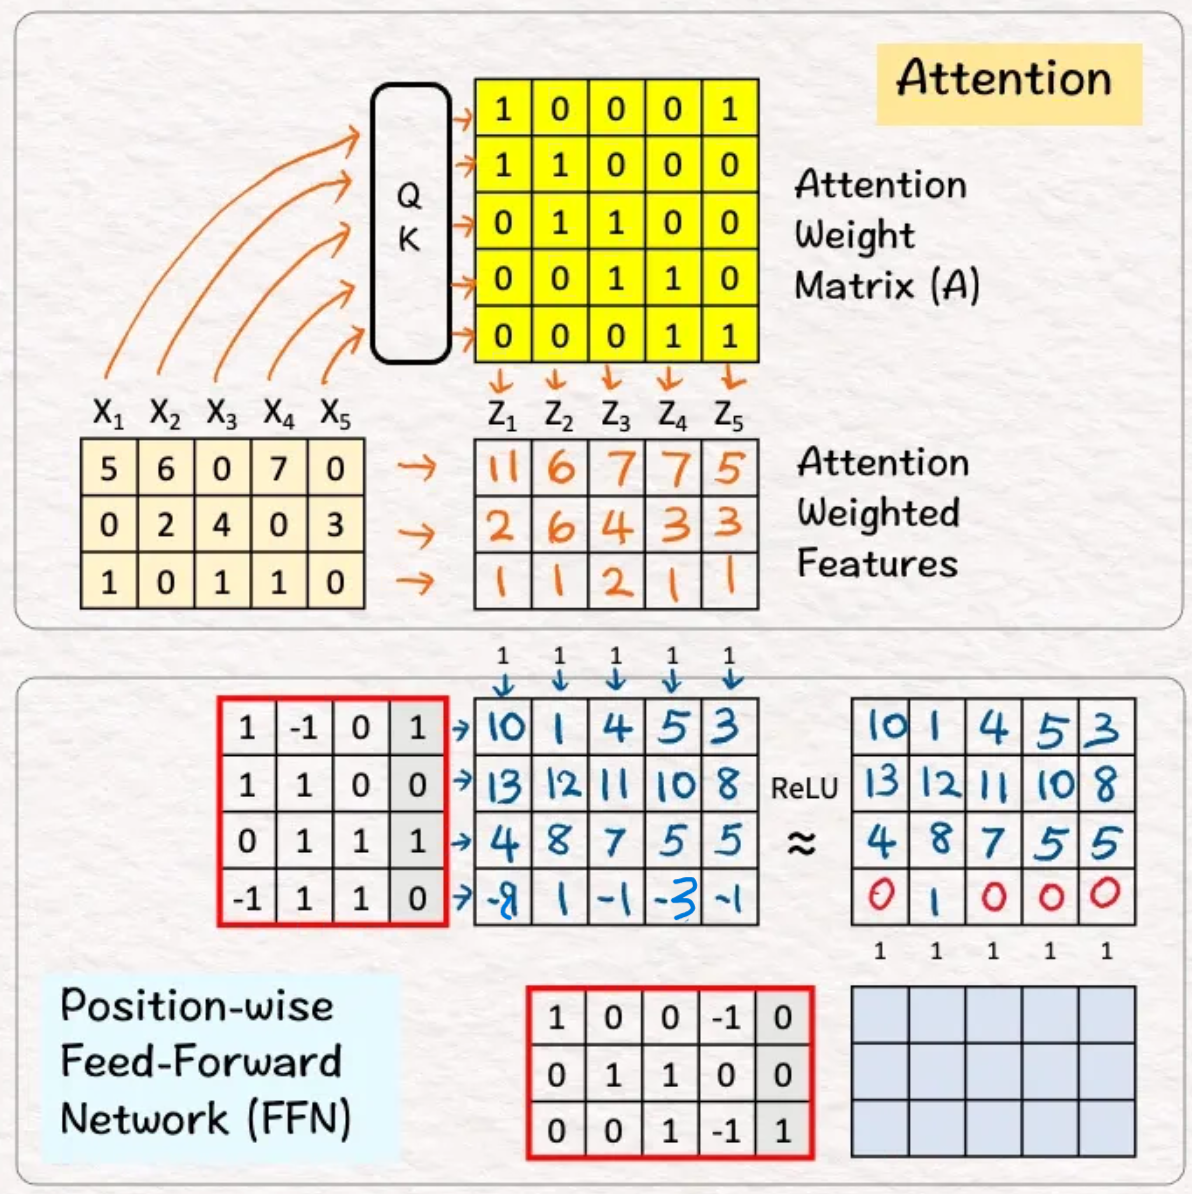 图 5:ReLU 抹平负数,产生非线性。图片来源:1
升维的深层意义 :4 维意味着 4 个 ReLU 神经元,对应 4 条可组合的折线基元。每个基元的折点位置由 W1W_1W1 决定。第二层把这些折线基元加权组合,就能拼出分段线性曲线。升维越多,折点越多,能拼出的曲线越复杂。真实 Transformer 里,FFN 的隐藏维度通常是输入维度的 4 倍(原始论文的 512 → 2048,以及 BERT、GPT 系列都采用这个比例),但这不是硬性规定。不同模型会根据激活函数、参数量预算、训练稳定性等因素调整,比如 LLaMA 用 SwiGLU 激活时,这个比例大约是 2.7 倍。
4.3 第二层 FFN:4 维降回 3 维
图中 FFN 第二层的权重矩阵 W2W_2W2(红色框)是 3 × 5:
W2=100−1001100001−11 W_2= \begin{bmatrix} 1 & 0 & 0 & -1 & 0 \\ 0 & 1 & 1 & 0 & 0 \\ 0 & 0 & 1 & -1 & 1 \end{bmatrix} W2= 100010011−10−1001
W2W_2W2 是 3 × 5,需要 5 维输入。图中在 R 矩阵下方又加了一行全为 1 的行 ,把 R 从 4 × 5 变成 5 × 5:
R′=101453131211108487550100011111 R'= \begin{bmatrix} 10 & 1 & 4 & 5 & 3 \\ 13 & 12 & 11 & 10 & 8 \\ 4 & 8 & 7 & 5 & 5 \\ 0 & 1 & 0 & 0 & 0 \\ 1 & 1 & 1 & 1 & 1 \end{bmatrix} R′= 101340111281141170151050138501
这行 1 的作用与前面一样:凑维度 + 充当偏置 。W2W_2W2 的第 5 列就是偏置列。
计算 Y=W2⋅R′Y = W_2 \cdot R'Y=W2⋅R′,维度:3 × 5 乘 5 × 5 = 3 × 5.
位置1 ,R1′=(10,13,4,0,1)R'_1 = (10, 13, 4, 0, 1)R1′=(10,13,4,0,1):
- 第1维:1×10+0×13+0×4+(−1)×0+0×1=101×10 + 0×13 + 0×4 + (-1)×0 + 0×1 = 101×10+0×13+0×4+(−1)×0+0×1=10
- 第2维:0×10+1×13+1×4+0×0+0×1=13+4=170×10 + 1×13 + 1×4 + 0×0 + 0×1 = 13 + 4 = 170×10+1×13+1×4+0×0+0×1=13+4=17
- 第3维:0×10+0×13+1×4+(−1)×0+1×1=4+1=50×10 + 0×13 + 1×4 + (-1)×0 + 1×1 = 4 + 1 = 50×10+0×13+1×4+(−1)×0+1×1=4+1=5
Y1=(10,17,5)Y_1 = (10, 17, 5)Y1=(10,17,5)
位置2 ,R2′=(1,12,8,1,1)R'_2 = (1, 12, 8, 1, 1)R2′=(1,12,8,1,1):
- 第1维:1−1=01 - 1 = 01−1=0
- 第2维:12+8=2012 + 8 = 2012+8=20
- 第3维:8−1+1=88 - 1 + 1 = 88−1+1=8
Y2=(0,20,8)Y_2 = (0, 20, 8)Y2=(0,20,8)
位置3 ,R3′=(4,11,7,0,1)R'_3 = (4, 11, 7, 0, 1)R3′=(4,11,7,0,1):
- 第1维:4+0=44 + 0 = 44+0=4
- 第2维:11+7=1811 + 7 = 1811+7=18
- 第3维:7−0+1=87 - 0 + 1 = 87−0+1=8
Y3=(4,18,8)Y_3 = (4, 18, 8)Y3=(4,18,8)
位置4 ,R4′=(5,10,5,0,1)R'_4 = (5, 10, 5, 0, 1)R4′=(5,10,5,0,1):
- 第1维:5+0=55 + 0 = 55+0=5
- 第2维:10+5=1510 + 5 = 1510+5=15
- 第3维:5−0+1=65 - 0 + 1 = 65−0+1=6
Y4=(5,15,6)Y_4 = (5, 15, 6)Y4=(5,15,6)
位置5 ,R5′=(3,8,5,0,1)R'_5 = (3, 8, 5, 0, 1)R5′=(3,8,5,0,1):
- 第1维:3+0=33 + 0 = 33+0=3
- 第2维:8+5=138 + 5 = 138+5=13
- 第3维:5−0+1=65 - 0 + 1 = 65−0+1=6
Y5=(3,13,6)Y_5 = (3, 13, 6)Y5=(3,13,6)
最终输出:
Y=100453172018151358866 Y= \begin{bmatrix} 10 & 0 & 4 & 5 & 3 \\ 17 & 20 & 18 & 15 & 13 \\ 5 & 8 & 8 & 6 & 6 \end{bmatrix} Y= 101750208418851563136
形状回到 3 × 5 ,与输入一致。这个 YYY 就是本模块的输出,会进入下一个 Transformer 模块------那里有一套完全独立的参数,整个过程再次循环。
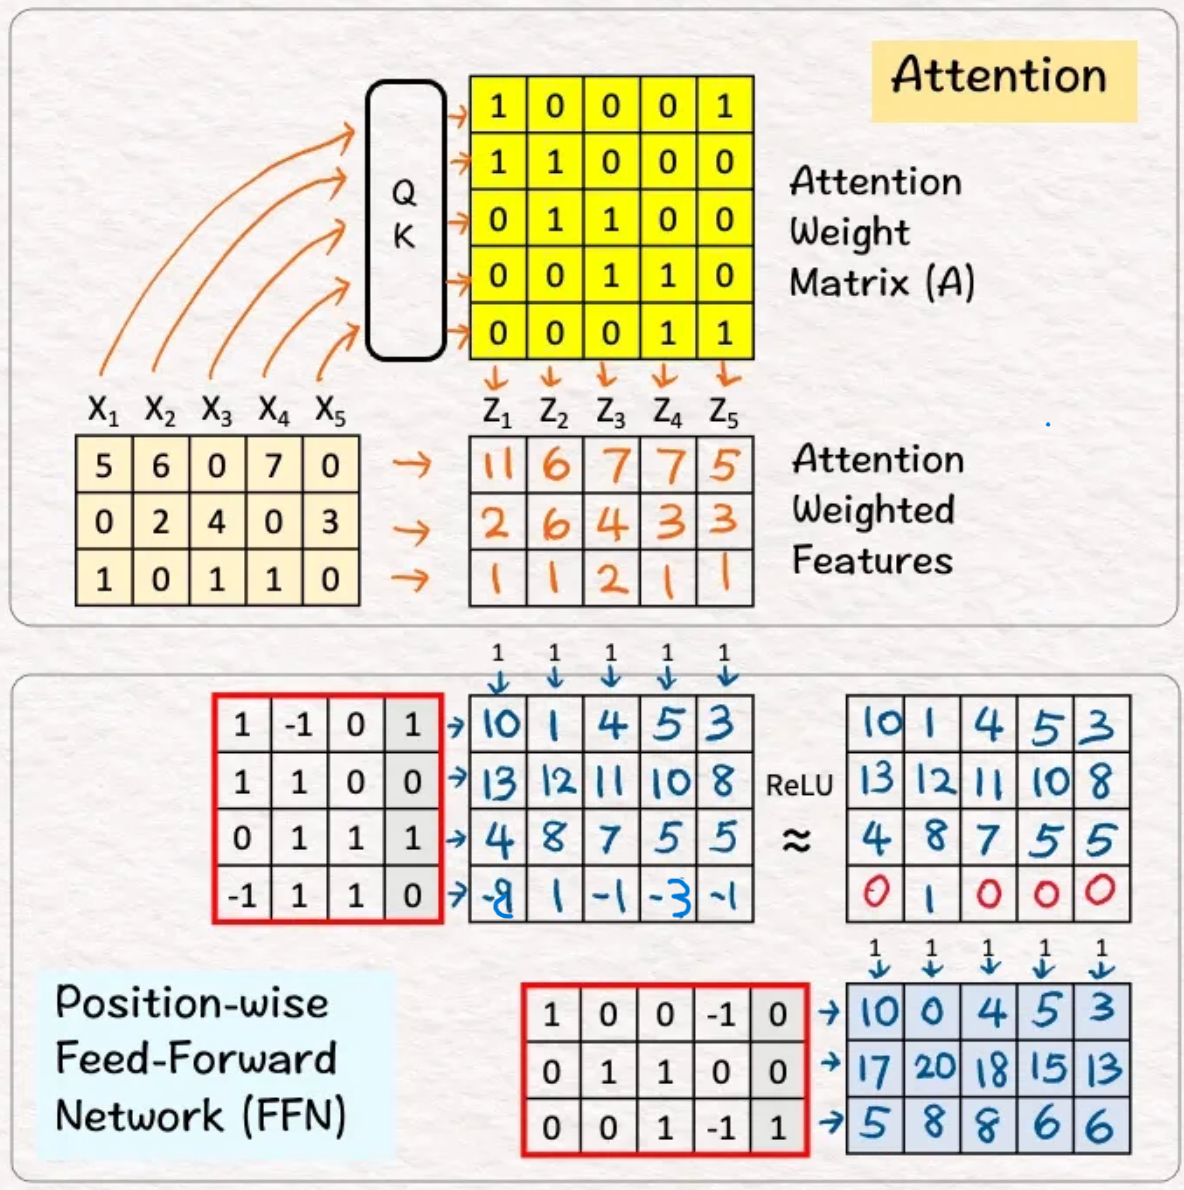 图 6:第二层 FFN 将特征从 4 维降回 3 维。R 下方再加一行 1(凑成 5 维输入)以匹配 W₂ 的形状,W₂ 把 ReLU 后的折线基元加权组合,输出形状与输入一致,便于传入下一个模块。图片来源:1
手算部分的核心要点
两个最本质的组件:
- 注意力加权 :Z=X⋅AZ = X \cdot AZ=X⋅A,在位置之间混合,让每个位置从其他位置吸收信息。水平方向。
- 前馈网络:在特征维度之间混合,对每个位置的特征做非线性变换。垂直方向。
每个组件内部的线性与非线性:
- 注意力:用非线性(Softmax)算权重,用线性做汇总。非线性负责"决策看谁",线性负责"执行拿多少"。
- FFN 第一层:线性变换,故意制造负数。
- ReLU:负值压平,打破可加性,把空间"折叠"。没有它,第一层和第二层会合并成线性变换,FFN 白做。
- FFN 第二层:线性降维,把折线基元加权组合成输出。
矩阵约定与技巧:
- 行 = 位置 时用 Z=A⋅XZ = A \cdot XZ=A⋅X;列 = 位置 时用 Z=X⋅AZ = X \cdot AZ=X⋅A。图中用列 = 位置。
- 两处"加一行 1" :第一层把 3 维 Z 变成 4 维,匹配 4×4 的 W1W_1W1;第二层把 4 维 R 变成 5 维,匹配 3×5 的 W2W_2W2。这两行 1 同时充当偏置项,把仿射变换统一写成矩阵乘法。
合起来:
- 逐位置:每个位置共用同一套 FFN 权重。
- Nx:模块重复 N 次,每次参数独立,逐层抽象。
- 残差与归一化:让深网络能稳定训练。
只有注意力,位置之间会混成一团,每个位置失去自我;只有 FFN,每个位置各自为政,永远看不到上下文。注意力负责横向交流,FFN 负责纵向消化------这两个组件各司其职,缺一不可,才是 Transformer 真正的发动机。而 ReLU,就是让 FFN 从"只会走直线"变成"能拐弯、能爬坡"的那个关键零件。
第二部分:理论全景
手算让你知道"怎么算"。但"为什么这么算有效"需要更深的数学。下面梳理这两个核心组件背后的数学原理。这一部分的内容和视角,主要参考了《The Geometry of Intelligence》一书2,它从几何、对称、智能的角度系统剖析了 Transformer 的数学基础。
一、数学基础
1.1 向量空间:数据住在哪里
Transformer 处理的每个 token,都是高维向量空间 Rd\mathbb{R}^dRd 中的一个点。词嵌入、位置编码、注意力输出,全都是向量。向量空间的定义包含加法、标量乘法、零向量、逆元等十条公理。这些公理保证了我们可以对向量做线性组合,而线性组合正是注意力加权求和的基础。
子空间与基 :一个向量空间可以由一组基向量张成。基的选取决定了我们如何表示数据。在 Transformer 里,WQ,WK,WVW_Q, W_K, W_VWQ,WK,WV 实际上是在学习新的基,把输入投影到更适合计算注意力的空间。不同的头可以学习不同的基,从而从不同角度审视同一组数据。
秩-零化度定理 :dim(V)=rank(T)+nullity(T)\dim(V) = \text{rank}(T) + \text{nullity}(T)dim(V)=rank(T)+nullity(T)。这个定理告诉我们,线性变换会"压缩"一部分信息(核),同时"保留"一部分信息(像)。注意力矩阵 AAA 的秩决定了它能保留多少信息。
1.2 线性变换:数据怎么变
线性变换 T:V→WT: V \to WT:V→W 满足 T(u+v)=T(u)+T(v)T(u+v)=T(u)+T(v)T(u+v)=T(u)+T(v) 和 T(αu)=αT(u)T(\alpha u)=\alpha T(u)T(αu)=αT(u)。几何上,线性变换把直线映射为直线,保持原点不变。
核与像 :核 ker(T)\ker(T)ker(T) 是被映射到零的向量集合,像 Im(T)\text{Im}(T)Im(T) 是所有可能的输出。在 Transformer 里,FFN 第一层的核决定了哪些特征组合会被"抹掉",像决定了哪些特征会被保留。
矩阵表示 :每个线性变换都可以写成矩阵。Transformer 里的 WQ,WK,WV,W1,W2W_Q, W_K, W_V, W_1, W_2WQ,WK,WV,W1,W2 全都是矩阵,它们就是线性变换的具体表示。矩阵乘法对应变换的复合,这解释了为什么多层线性变换可以合并成一层------如果没有非线性的话。
1.3 特征值与特征向量:信息传播的方向
给定线性变换 TTT,如果 T(v)=λvT(v)=\lambda vT(v)=λv,那么 vvv 是特征向量,λ\lambdaλ 是特征值。几何意义:特征向量是变换"不改变方向、只改变长度"的方向。特征值 λ\lambdaλ 表示缩放倍数。
在 Transformer 里,注意力矩阵 AAA 的特征值决定了信息传播的稳定性。特征值接近 1 的方向是信息被保留的方向,特征值接近 0 的方向是信息被抑制的方向。如果所有特征值都接近 1,注意力就接近恒等变换;如果都接近 0,注意力就接近"遗忘"。
谱定理 :对于正规矩阵,T=UΛU∗T = U \Lambda U^*T=UΛU∗,其中 UUU 是酉矩阵,Λ\LambdaΛ 是对角矩阵。这意味着任何正规变换都可以分解为"旋转 + 缩放"。注意力矩阵如果是对称的,就可以这样分解,从而看清它"保留哪些方向、抑制哪些方向"。
对角化 :P−1AP=DP^{-1}AP = DP−1AP=D。对角化让我们看清变换的本质结构。在多头注意力里,每个头的注意力矩阵可以有不同的特征结构,从而捕捉不同的模式。
1.4 群论与对称性:为什么需要位置编码
群 GGG 是一个集合加上一个二元运算,满足封闭性、结合律、单位元、逆元。群论研究对称性:什么样的变换保持对象不变。
在 Transformer 里,自注意力机制对输入序列的置换是对称的。也就是说,如果你把输入序列的顺序打乱,自注意力的输出也会相应地打乱,但结构不变。用数学语言:
Transformer(σ⋅x)=σ⋅Transformer(x) \text{Transformer}(\sigma \cdot x) = \sigma \cdot \text{Transformer}(x) Transformer(σ⋅x)=σ⋅Transformer(x)
其中 σ\sigmaσ 是置换群 SnS_nSn 中的一个元素。这个性质叫置换等变性。
这意味着自注意力本身不区分位置 。如果你不给它位置信息,它把"猫追老鼠"和"老鼠追猫"看成同一个东西。这就是为什么需要位置编码来打破这种对称性。位置编码的作用,就是给每个位置一个独特的标签,让模型能区分不同位置。
等变与不变 :如果 f(σ⋅x)=σ⋅f(x)f(\sigma \cdot x) = \sigma \cdot f(x)f(σ⋅x)=σ⋅f(x),称 fff 是等变的 (equivariant)。如果 f(σ⋅x)=f(x)f(\sigma \cdot x) = f(x)f(σ⋅x)=f(x),称 fff 是不变的(invariant)。自注意力是等变的,但不是不变的。
1.5 度量空间:注意力作为保度量映射
度量空间 (X,d)(X,d)(X,d) 是一个集合加上距离函数,满足非负性、同一性、对称性、三角不等式。
在 Transformer 里,注意力机制可以看作一个从输入空间到输出空间的映射 。我们关心的是:这个映射是否保持距离?如果注意力权重 αij\alpha_{ij}αij 在不同位置之间变化不大,那么输出距离 ∥z1−z2∥\|z_1-z_2\|∥z1−z2∥ 会接近输入距离 ∥x1−x2∥\|x_1-x_2\|∥x1−x2∥,注意力近似保度量。
为什么重要?保度量意味着语义关系被保留。在语言模型里,如果"猫"和"狗"在输入空间里距离很近,注意力应该让它们在输出空间里也保持近。如果注意力破坏了这种距离,语义关系就丢失了。
Banach 不动点定理:在完备度量空间里,压缩映射有唯一不动点。在训练里,如果参数更新可以建模为压缩映射,就能保证收敛到唯一最优参数。
1.6 张量代数:Q、K、V 的本质
张量是多维数组的推广。标量是 0 阶张量,向量是 1 阶张量,矩阵是 2 阶张量。
张量积 :A⊗BA \otimes BA⊗B 把两个低阶张量组合成高阶张量。在 Transformer 里,多头注意力的输出拼接可以看作张量积的一种形式。
张量收缩 :对一对指标求和,降低张量阶数。矩阵乘法就是张量收缩。注意力里的 QKTQK^TQKT 是收缩,AVAVAV 也是收缩。
Kronecker 积 :A⊗BA \otimes BA⊗B 是块矩阵,每块是 BBB 的缩放。在 Transformer 里,Kronecker 积可以用来分解大矩阵,减少参数量,提高效率。
1.7 矩阵微积分:梯度怎么流
梯度 :标量函数对矩阵的导数。在 Transformer 里,损失对 WQ,WK,WV,W1,W2W_Q, W_K, W_V, W_1, W_2WQ,WK,WV,W1,W2 的梯度决定了参数怎么更新。
Jacobian:向量函数对向量的导数。Softmax 的 Jacobian 是:
(Jsoftmax(S))ij,kl=αij(δjk−αik) (J_{\text{softmax}}(S)){ij,kl} = \alpha{ij}(\delta_{jk} - \alpha_{ik}) (Jsoftmax(S))ij,kl=αij(δjk−αik)
这个 Jacobian 决定了梯度如何通过 Softmax 传播。当注意力权重趋于极端时,Jacobian 趋于零,梯度会消失。这就是为什么需要缩放点积:防止 Softmax 饱和。
Hessian:二阶导数,描述曲率。Hessian 的特征值决定了损失曲面的形状:正特征值是极小值,负特征值是极大值,混合特征值是鞍点。
1.8 位置编码的傅里叶视角
正弦位置编码:
PE(p,2i)=sin(p100002i/d) \text{PE}(p, 2i) = \sin\left(\frac{p}{10000^{2i/d}}\right) PE(p,2i)=sin(100002i/dp)
PE(p,2i+1)=cos(p100002i/d) \text{PE}(p, 2i+1) = \cos\left(\frac{p}{10000^{2i/d}}\right) PE(p,2i+1)=cos(100002i/dp)
其中:
- ppp 是位置索引(第几个 token)
- iii 是维度索引(第几对 sin/cos),i=0,1,...,d/2−1i = 0, 1, \ldots, d/2 - 1i=0,1,...,d/2−1
- ddd 是位置编码的维度(也是模型的嵌入维度)
- 2i2i2i 对应偶数维度,2i+12i+12i+1 对应奇数维度
傅里叶解释 :每个位置 ppp 的编码向量,偶数维用 sin,奇数维用 cos,不同维度 iii 对应不同的角频率:
ωi=1100002i/d \omega_i = \frac{1}{10000^{2i/d}} ωi=100002i/d1
- 当 i=0i = 0i=0(低维度):ω0=1\omega_0 = 1ω0=1,角频率高 ,波长短 ,正弦函数变化快
- 当 i=d/2−1i = d/2 - 1i=d/2−1(高维度):ωd/2−1=1100001−2/d\omega_{d/2-1} = \frac{1}{10000^{1-2/d}}ωd/2−1=100001−2/d1,角频率低 ,波长长 ,正弦函数变化慢
所以**,iii 较小的维度变化快,能区分相邻位置;iii 较大的维度变化慢,能编码长距离的位置关系**。这本质上是一个傅里叶级数的截断版本:不同维度对应不同频率分量,组合起来给每个位置一个独特的"指纹"。
为什么用正弦和余弦 ?它们构成一组正交基,任何周期函数都可以用它们展开,不同频率的组合给每个位置一个独特的编码,同时相对位置关系可以通过线性变换捕捉------对于任意偏移 kkk,PE(p+k)\text{PE}(p+k)PE(p+k) 可以表示为 PE(p)\text{PE}(p)PE(p) 的线性变换,这意味着模型可以通过线性变换捕捉相对位置关系,而不需要显式地编码每一对绝对位置。
1.9 通用逼近定理:为什么 FFN 能拟合任何函数
定理 :设 σ\sigmaσ 是非常数、有界、连续的激活函数。对于任何连续函数 f:a,b→Rf:a,b\to\mathbb{R}f:a,b→R 和任何 ϵ>0\epsilon>0ϵ>0,存在一个单隐层神经网络,使得
∥f(x)−∑i=1Nciσ(aix+bi)∥∞<ϵ \left\|f(x) - \sum_{i=1}^N c_i \sigma(a_i x + b_i)\right\|_\infty < \epsilon f(x)−i=1∑Nciσ(aix+bi) ∞<ϵ
在 Transformer 里,FFN 是逐位置的两层网络,带 ReLU 激活。根据通用逼近定理,只要隐藏维度足够大,FFN 可以逼近任何连续函数。
Transformer 的通用逼近:Transformer 在层数和注意力头数足够时,可以逼近任何连续序列到序列的映射。这个定理从理论上保证了 Transformer 的表达力。
深度 vs 宽度 :深度提供指数级表达力提升。深层网络可以用更少参数逼近复杂函数。这就是为什么 Transformer 要堆很多层,而不是把一层做得很宽。
1.10 优化:梯度下降和它的变体
梯度下降 :θt+1=θt−η∇L(θt)\theta_{t+1} = \theta_t - \eta \nabla L(\theta_t)θt+1=θt−η∇L(θt)。
收敛条件 :如果 LLL 是凸函数且梯度 Lipschitz 连续,学习率 0<η<2/L0<\eta<2/L0<η<2/L,梯度下降收敛到全局最优(速率为 O(1/t)O(1/t)O(1/t));若 LLL 还是强凸的,则收敛速率可提升到线性。
SGD:用单个样本或小批量估计梯度。噪声帮助逃离鞍点,但不会精确收敛到最优。
Adam :自适应学习率,结合动量和 RMSProp。一阶矩估计 mtm_tmt,二阶矩估计 vtv_tvt,偏差修正后更新:
θt+1=θt−ηm^tv^t+ϵ \theta_{t+1} = \theta_t - \eta \frac{\hat{m}_t}{\sqrt{\hat{v}_t}+\epsilon} θt+1=θt−ηv^t +ϵm^t
学习率调度:step decay、exponential decay、cosine annealing、warm restarts。Transformer 训练通常用 warm-up + decay。
1.11 测度论与信息论
概率空间 :(Ω,F,P)(\Omega, \mathcal{F}, \mathbb{P})(Ω,F,P)。样本空间、σ-代数、概率测度。
熵 :H(X)=−∑p(x)logp(x)H(X) = -\sum p(x)\log p(x)H(X)=−∑p(x)logp(x)。衡量不确定性。
KL 散度 :DKL(P∥Q)=∑P(x)logP(x)Q(x)D_{KL}(P\|Q) = \sum P(x)\log\frac{P(x)}{Q(x)}DKL(P∥Q)=∑P(x)logQ(x)P(x)。衡量两个分布的差异。非负,不对称。
交叉熵 :H(P,Q)=H(P)+DKL(P∥Q)H(P,Q) = H(P) + D_{KL}(P\|Q)H(P,Q)=H(P)+DKL(P∥Q)。分类任务的损失函数。
互信息 :I(X;Y)=H(X)−H(X∣Y)I(X;Y) = H(X) - H(X|Y)I(X;Y)=H(X)−H(X∣Y)。衡量一个变量包含另一个变量的信息量。在 Transformer 里,互信息可以用来分析注意力头保留了多少输入信息。
1.12 反向传播与自动微分
链式法则 :∂h∂x=∂g∂f⋅∂f∂x\frac{\partial h}{\partial x} = \frac{\partial g}{\partial f}\cdot\frac{\partial f}{\partial x}∂x∂h=∂f∂g⋅∂x∂f.
反向传播:从输出层往回传播误差,计算每个权重的梯度。
自动微分:反向模式自动微分,计算复杂度与前向传播同阶。Transformer 有数百万到数十亿参数,反向模式是唯一可行的方法。
1.13 统计学习理论:为什么能泛化
经验风险最小化 :R^n(h)=1n∑i=1nℓ(h(xi),yi)\hat{R}n(h) = \frac{1}{n}\sum{i=1}^n \ell(h(x_i), y_i)R^n(h)=n1∑i=1nℓ(h(xi),yi).
泛化误差 :R(h)−R^n(h)R(h) - \hat{R}_n(h)R(h)−R^n(h)。真实风险与经验风险的差。
VC 维度 :衡量假设类的容量。对于 WWW 个参数的神经网络,VC(H)=O(WlogW)VC(\mathcal{H}) = O(W\log W)VC(H)=O(WlogW).
Rademacher 复杂度 :数据依赖的复杂度度量。R(h)≤R^n(h)+2R^n(H)+O(1/n)R(h) \leq \hat{R}_n(h) + 2\hat{R}_n(\mathcal{H}) + O(\sqrt{1/n})R(h)≤R^n(h)+2R^n(H)+O(1/n ).
Transformer 的泛化:层数、头数、隐藏维度决定了容量。正则化(dropout、weight decay)和大量数据是平衡的关键。
1.14 贝叶斯视角
后验分布 :p(θ∣D)=p(D∣θ)p(θ)p(D)p(\theta|\mathcal{D}) = \frac{p(\mathcal{D}|\theta)p(\theta)}{p(\mathcal{D})}p(θ∣D)=p(D)p(D∣θ)p(θ).
预测分布 :p(y∗∣x∗,D)=∫p(y∗∣x∗,θ)p(θ∣D)dθp(y^*|x^*,\mathcal{D}) = \int p(y^*|x^*,\theta)p(\theta|\mathcal{D})d\thetap(y∗∣x∗,D)=∫p(y∗∣x∗,θ)p(θ∣D)dθ.
贝叶斯神经网络:把权重看作随机变量,学习权重的分布而不是点估计。变分推断和 Monte Carlo dropout 是常用的近似方法。
PAC-Bayes 界 :Eh∼QR(h)≤Eh∼QR\^n(h)+KL(Q∥P)+log(n/δ)2n\mathbb{E}{h\sim Q}R(h) \leq \mathbb{E}{h\sim Q}\\hat{R}_n(h) + \sqrt{\frac{KL(Q\|P)+\log(n/\delta)}{2n}}Eh∼QR(h)≤Eh∼QR\^n(h)+2nKL(Q∥P)+log(n/δ) .
二、核心机制
2.1 注意力:第一个核心组件
注意力机制允许模型在处理序列时,动态地关注不同位置的信息。它的核心是:
Attention(Q,K,V)=Softmax(QKTdk)V \text{Attention}(Q,K,V) = \text{Softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V Attention(Q,K,V)=Softmax(dk QKT)V
性质:
- 对 V 线性 :A(Q,K,αV1+βV2)=αA(Q,K,V1)+βA(Q,K,V2)A(Q,K,\alpha V_1+\beta V_2) = \alpha A(Q,K,V_1) + \beta A(Q,K,V_2)A(Q,K,αV1+βV2)=αA(Q,K,V1)+βA(Q,K,V2).
- 置换等变 :A(Qσ,Kσ,Vσ)=A(Q,K,V)σA(Q^\sigma,K^\sigma,V^\sigma) = A(Q,K,V)^\sigmaA(Qσ,Kσ,Vσ)=A(Q,K,V)σ.
- 多头可交换:多头注意力的顺序不影响输出。
- 有界稳定:输入小扰动导致输出小扰动。
- 概率解释 :αij≥0\alpha_{ij}\geq 0αij≥0,∑jαij=1\sum_j \alpha_{ij}=1∑jαij=1.
缩放的作用 :除以 dk\sqrt{d_k}dk 是为了防止点积过大导致 Softmax 饱和。当 dkd_kdk 很大时,点积的方差是 dkd_kdk,标准差是 dk\sqrt{d_k}dk . 除以 dk\sqrt{d_k}dk 让方差归一化到 1.
2.2 多头注意力:多个视角
多头注意力把输入投影到多个子空间,每个头独立计算注意力,然后拼接:
Z=Concat(Z1,...,Zh)WO Z = \text{Concat}(Z_1,\ldots,Z_h)W_O Z=Concat(Z1,...,Zh)WO
为什么有效?每个头可以关注不同的模式。一个头可能关注语法依赖,另一个头关注语义相似性,第三个头关注位置关系。多头增加了模型的表达力。
头的多样性:用输出的方差衡量。方差越大,头之间越独立,捕捉的信息越丰富。
2.3 交叉注意力:编码器-解码器的桥梁
交叉注意力的 Q 来自解码器,K 和 V 来自编码器:
αij=exp(qi(d)⊤kj(e))∑k=1mexp(qi(d)⊤kk(e)) \alpha_{ij} = \frac{\exp(q_i^{(d)\top}k_j^{(e)})}{\sum_{k=1}^m \exp(q_i^{(d)\top}k_k^{(e)})} αij=∑k=1mexp(qi(d)⊤kk(e))exp(qi(d)⊤kj(e))
zi(d)=∑j=1mαijvj(e) z_i^{(d)} = \sum_{j=1}^m \alpha_{ij}v_j^{(e)} zi(d)=j=1∑mαijvj(e)
作用:让解码器在生成每个 token 时,动态地关注编码器的相关部分。在机器翻译里,生成动词时关注源语言的动词,生成名词时关注源语言的名词。
2.4 掩码注意力:不能看未来
在自回归生成里,位置 iii 只能看位置 ≤i\leq i≤i,不能看未来。掩码矩阵:
Mij={0i≥j−∞i<j M_{ij} = \begin{cases} 0 & i\geq j \\ -\infty & i \lt j \end{cases} Mij={0−∞i≥ji<j
加到注意力分数上,Softmax 后未来位置的权重为 0.
为什么必要?如果不掩码,模型在训练时能看到未来 token,导致信息泄露,学不到真正的自回归生成。
2.5 FFN:第二个核心组件
FFN(x)=ReLU(xW1+b1)W2+b2 \text{FFN}(x) = \text{ReLU}(xW_1+b_1)W_2+b_2 FFN(x)=ReLU(xW1+b1)W2+b2
升维 :ddd 维升到 4d4d4d 维,给 ReLU 更多折线基元。
ReLU :负值压平,打破线性,把空间折叠。ReLU 的非线性来自它不满足可加性。
降维 :4d4d4d 维回到 ddd 维,把折线基元加权组合成输出。
为什么需要 FFN?注意力只做线性加权,没有非线性。FFN 提供非线性,让模型能逼近复杂函数。
2.6 层归一化:稳定训练
μ=1d∑i=1dxi,σ2=1d∑i=1d(xi−μ)2 \mu = \frac{1}{d}\sum_{i=1}^d x_i,\quad \sigma^2 = \frac{1}{d}\sum_{i=1}^d (x_i-\mu)^2 μ=d1i=1∑dxi,σ2=d1i=1∑d(xi−μ)2
x^i=xi−μσ2+ϵ,LayerNorm(x)i=γx^i+β \hat{x}_i = \frac{x_i-\mu}{\sqrt{\sigma^2+\epsilon}},\quad \text{LayerNorm}(x)_i = \gamma \hat{x}_i + \beta x^i=σ2+ϵ xi−μ,LayerNorm(x)i=γx^i+β
作用:把每个样本的激活归一化到零均值、单位方差,稳定训练,加速收敛。
BatchNorm 跨样本归一化,LayerNorm 跨特征归一化。Transformer 里序列长度可变,跨样本归一化不稳定,所以用 LayerNorm。
2.7 残差连接:梯度高速公路
y=x+F(x) y = x + F(x) y=x+F(x)
梯度 :∂L∂x=∂L∂y(1+∂F(x)∂x)\frac{\partial L}{\partial x} = \frac{\partial L}{\partial y}(1 + \frac{\partial F(x)}{\partial x})∂x∂L=∂y∂L(1+∂x∂F(x)). 恒等项"1"保证梯度不会消失。
作用:让深层网络能训练。没有残差连接,几十层的 Transformer 根本训不起来。
2.8 激活函数家族
| 激活函数 | 负区间 | 零中心 | 平滑 | 主要解决 | 典型场景 |
|---|---|---|---|---|---|
| ReLU | 恒 0 | 否 | 否 | 计算快、稀疏 | CNN、早期 Transformer |
| Leaky ReLU | 小斜率 | 否 | 否 | 死亡 ReLU | 通用 |
| PReLU | 可学习斜率 | 否 | 否 | 死亡 ReLU | 深层 CNN |
| ELU | 趋向 -1 | 是 | 是 | 零中心 + 死亡 | CNN |
| GELU | 概率保留 | 近似 | 是 | 平滑 + 表达力 | BERT、GPT |
| SiLU/Swish | 小幅下探 | 近似 | 是 | 平滑 + 非单调 | EfficientNet |
| Sigmoid | 饱和 | 否 | 是 | 概率输出 | 门控、输出层 |
| Tanh | 饱和 | 是 | 是 | 零中心 | 门控、旧 RNN |
| Softmax | --- | --- | --- | 概率归一化 | 注意力、分类 |
三、架构
3.1 编码器
编码器由 NNN 层堆叠,每层包含:
- 多头自注意力 :Z=MultiHeadAttention(X)Z = \text{MultiHeadAttention}(X)Z=MultiHeadAttention(X)
- Add & Norm :X′=LayerNorm(X+Z)X' = \text{LayerNorm}(X + Z)X′=LayerNorm(X+Z)
- FFN :Y=FFN(X′)Y = \text{FFN}(X')Y=FFN(X′)
- Add & Norm :X′′=LayerNorm(X′+Y)X'' = \text{LayerNorm}(X' + Y)X′′=LayerNorm(X′+Y)
编码器的输出是每个位置的上下文表示,捕捉了整个输入序列的信息。编码器是双向的:每个位置可以看到所有其他位置。
3.2 解码器
解码器也由 NNN 层堆叠,每层包含:
- 掩码多头自注意力:只能看已生成的 token。
- Add & Norm
- 交叉注意力:Q 来自解码器,K 和 V 来自编码器。
- Add & Norm
- FFN
- Add & Norm
解码器的输出经过线性层和 Softmax,得到下一个 token 的概率分布。
3.3 完整流程
输出=Softmax(Wout⋅Decoder(Encoder(X))) \text{输出} = \text{Softmax}(W_{\text{out}} \cdot \text{Decoder}(\text{Encoder}(X))) 输出=Softmax(Wout⋅Decoder(Encoder(X)))
编码器处理输入,解码器生成输出,交叉注意力连接两者。
四、训练
4.1 损失函数
交叉熵:
L=−∑i=1mlogP(yi∣y<i,x) L = -\sum_{i=1}^m \log P(y_i | y_{\lt i}, x) L=−i=1∑mlogP(yi∣y<i,x)
标签平滑:
p′(w)=(1−ϵ)p(w)+ϵV p'(w) = (1-\epsilon)p(w) + \frac{\epsilon}{V} p′(w)=(1−ϵ)p(w)+Vϵ
防止模型过度自信。
困惑度:
Perplexity=exp(−1N∑i=1NlogP(xi∣x<i)) \text{Perplexity} = \exp\left(-\frac{1}{N}\sum_{i=1}^N \log P(x_i | x_{\lt i})\right) Perplexity=exp(−N1i=1∑NlogP(xi∣x<i))
4.2 梯度下降与反向传播
梯度下降 :θ←θ−η∇θL\theta \leftarrow \theta - \eta \nabla_\theta Lθ←θ−η∇θL.
反向传播:链式法则从输出层往回传播误差。
梯度裁剪:防止梯度爆炸:
∇θL←∇θLmax(1,∥∇θL∥/c) \nabla_\theta L \leftarrow \frac{\nabla_\theta L}{\max(1, \|\nabla_\theta L\|/c)} ∇θL←max(1,∥∇θL∥/c)∇θL
4.3 学习率调度
Warm-up:初始学习率很低,逐渐升高,避免早期不稳定。
Decay:训练后期降低学习率,精细收敛。
Cosine annealing:
ηt=ηmin+12(ηmax−ηmin)(1+cos(tπTmax)) \eta_t = \eta_{\min} + \frac{1}{2}(\eta_{\max}-\eta_{\min})\left(1+\cos\left(\frac{t\pi}{T_{\max}}\right)\right) ηt=ηmin+21(ηmax−ηmin)(1+cos(Tmaxtπ))
4.4 正则化
Dropout:随机丢弃激活,防止共适应。
Weight decay:惩罚大权重,鼓励简单模型。
Label smoothing:软化标签,防止过度自信。
4.5 训练稳定性
梯度消失:深层网络里梯度指数衰减。残差连接和 LayerNorm 解决。
梯度爆炸:梯度指数增长。梯度裁剪解决。
鞍点:SGD 的噪声帮助逃离鞍点。
平坦极小值:泛化更好。正则化鼓励平坦极小值。
五、变体
5.1 高效注意力
稀疏注意力 :只计算部分注意力权重。复杂度 O(nk)O(nk)O(nk).
Linformer :把序列长度投影到低维。复杂度 O(nkd)O(nkd)O(nkd).
Longformer :局部窗口 + 全局注意力。复杂度 O(nw)O(nw)O(nw).
Reformer :局部敏感哈希 + 可逆残差。复杂度 O(nlogn)O(n\log n)O(nlogn).
Performer :正交随机特征近似 Softmax。复杂度 O(nd2)O(nd^2)O(nd2).
5.2 Transformer-XL
引入循环机制,让信息跨段传播:
htl=Attention(qtl,ktl;kt−1l,vtl;vt−1l) h_t^l = \text{Attention}(q_t^l, k_t\^l; k_{t-1}\^l, v_t\^l; v_{t-1}\^l) htl=Attention(qtl,ktl;kt−1l,vtl;vt−1l)
解决固定上下文窗口的限制。
5.3 记忆增强 Transformer
引入外部记忆矩阵 MMM:
htl=Attention(qtl,ktl;M,vtl;M) h_t^l = \text{Attention}(q_t^l, k_t\^l; M, v_t\^l; M) htl=Attention(qtl,ktl;M,vtl;M)
让模型能存储和检索长期信息。
5.4 通用 Transformer
重复应用同一组 Transformer 层,迭代精炼表示:
ht(k+1)=TransformerLayer(ht(k),H(k)) h_t^{(k+1)} = \text{TransformerLayer}(h_t^{(k)}, H^{(k)}) ht(k+1)=TransformerLayer(ht(k),H(k))
增加表达力,适合复杂推理任务。
六、应用
6.1 NLP
- BERT:双向编码器,MLM + NSP 预训练,微调下游任务。
- GPT:单向解码器,自回归预训练,文本生成。
- 机器翻译:编码器-解码器,BLEU、METEOR 评估。
- 文本摘要:抽取式、抽象式,ROUGE 评估。
6.2 计算机视觉
- ViT:图像分块,位置编码,Transformer 编码器,分类头。
- DETR:目标检测,集合预测,二分匹配损失。
- 图像生成:GAN + Transformer,FID、IS 评估。
6.3 时间序列
- 金融:股价预测、组合优化、波动率建模。
- 天气:短期预报、长期气候、极端事件。
- 能源:电力负荷、可再生能源。
- 医疗:患者监测、疾病爆发。
6.4 信号分析
- 语音识别:端到端 ASR,CTC 损失,WER、CER 评估。
- 音频分类:环境声音、音乐流派、说话人识别。
- 语音合成:TTS,注意力对齐。
- 语音增强:去噪,SNR、PESQ 评估。
七、理论分析
7.1 表达力
通用逼近:Transformer 在层数和头数足够时,可以逼近任何连续序列到序列映射。
深度 vs 宽度:深度提供指数级表达力提升。
非线性:ReLU、GELU 等激活函数提供非线性,让网络能逼近复杂函数。
7.2 泛化
VC 维度 :O(WlogW)O(W\log W)O(WlogW),WWW 是参数量。
Rademacher 复杂度:数据依赖的复杂度度量。
PAC-Bayes 界:把泛化误差和 KL 散度联系起来。
双下降;模型容量超过数据量时,测试误差先升后降。这挑战了传统的偏差-方差权衡(bias-variance tradeoff)。
7.3 收敛性
凸优化:梯度下降收敛到全局最优。
非凸优化:SGD 收敛到局部最优或鞍点。
动力系统视角:训练是参数空间中的轨迹。Lyapunov 指数衡量稳定性。正指数 = 混沌,负指数 = 收敛。
7.4 稳定性
Lyapunov 函数 :V(x)>0V(x)>0V(x)>0,V˙(x)≤0\dot{V}(x)\leq 0V˙(x)≤0。损失函数本身可以是 Lyapunov 函数。
Lyapunov 指数 :λ=limt→∞1tln∥δx(t)∥∥δx(0)∥\lambda = \lim_{t\to\infty}\frac{1}{t}\ln\frac{\|\delta x(t)\|}{\|\delta x(0)\|}λ=limt→∞t1ln∥δx(0)∥∥δx(t)∥。负指数 = 稳定,正指数 = 混沌。
学习表示的稳定性:Lipschitz 连续性保证小扰动导致小变化。
核心要点
手算部分:
- 注意力加权 :Z=X⋅AZ = X \cdot AZ=X⋅A,在位置之间混合。水平方向。
- 前馈网络:在特征维度之间混合。垂直方向。
- 加一行 1:把偏置藏进输入,把仿射变换统一写成矩阵乘法。
- ReLU:负值压平,打破线性,是 FFN 的灵魂。
- 逐位置:每个位置共用同一套 FFN 权重。
- Nx:模块重复 N 次,每次参数独立。
理论部分:
- 向量空间:数据住在高维空间,线性组合是注意力加权求和的基础。
- 特征值:注意力矩阵的特征值决定信息传播的稳定性。
- 群论:自注意力对置换等变,位置编码打破对称性。
- 度量空间:注意力近似保度量,保留语义关系。
- 通用逼近:FFN 和 Transformer 可以逼近任何连续函数。
- 信息论:互信息衡量注意力保留了多少输入信息。
- 统计学习:VC 维度、Rademacher 复杂度、PAC-Bayes 界。
- 动力系统:Lyapunov 指数衡量稳定性,混沌理论研究不规则行为。
合起来:
- 注意力负责横向交流,FFN 负责纵向消化------这两个组件各司其职,缺一不可,才是 Transformer 真正的发动机。
- 数学不是装饰,而是发动机的设计图纸。手算让你知道怎么算,理论让你知道为什么这么算有效。
参考文献
1 By Hand AI. Can You Calculate a Transformer? https://www.byhand.ai/p/8-can-you-calculate-a-transformer
(本文第一部分所有手算示例图片及数据均来自此处。注意:原网站图片数据有两处错误,在FFN第一层算出来的矩阵H最后一行中,-9应为-8,-4应为-3,文中引用图片均已做相应修改,特此说明)
2 Pradeep Singh, Balasubramanian Raman. The Geometry of Intelligence: Foundations of Transformer Networks in Deep Learning. Studies in Big Data, Vol. 175, Springer Nature Singapore, 2025. ISBN 978-981-96-4705-7. https://doi.org/10.1007/978-981-96-4706-4
(本文第二部分理论全景的框架、视角和数学分析主要参考此书)
3 Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, L., & Polosukhin, I. Attention Is All You Need. Advances in Neural Information Processing Systems, Vol. 30, 2017. https://arxiv.org/abs/1706.03762
(原始 Transformer 论文,本文手算部分对应的架构即出自此文)
4 Devlin, J., Chang, M.-W., Lee, K., & Toutanova, K. BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding. Proceedings of NAACL-HLT 2019, pp. 4171--4186. https://doi.org/10.18653/v1/N19-1423
(双向编码器预训练的代表工作,本文"应用"部分提及)
5 Brown, T. B., Mann, B., Ryder, N., Subbiah, M., Kaplan, J., Dhariwal, P., ... Amodei, D. Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems, Vol. 33, 2020. https://arxiv.org/abs/2005.14165
(GPT-3 论文,自回归语言模型和少样本学习的代表工作)
6 Dosovitskiy, A., Beyer, L., Kolesnikov, A., Weissenborn, D., Zhai, X., Unterthiner, T., ... Houlsby, N. An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale. International Conference on Learning Representations (ICLR), 2021. https://arxiv.org/abs/2010.11929
(ViT 论文,Transformer 在计算机视觉中的代表工作)
7 Ba, J. L., Kiros, J. R., & Hinton, G. E. Layer Normalization. arXiv preprint arXiv:1607.06450, 2016. https://arxiv.org/abs/1607.06450
(层归一化原始论文,本文"层归一化"一节的理论来源)
8 Glorot, X., & Bengio, Y. Understanding the Difficulty of Training Deep Feedforward Neural Networks. Proceedings of the Thirteenth International Conference on Artificial Intelligence and Statistics, Vol. 9, pp. 249--256, 2010. http://proceedings.mlr.press/v9/glorot10a/glorot10a.pdf
(Xavier 初始化论文,本文"训练稳定性"部分提及权重初始化)
9 LeCun, Y., Bengio, Y., & Hinton, G. Deep Learning. Nature, Vol. 521, No. 7553, pp. 436--444, 2015. https://doi.org/10.1038/nature14539
(深度学习综述,作为背景参考)