据量子位报道,字节 Seed 团队在一项 128K Token 长上下文检索测试中发现:同一条信息换个位置,DeepSeek-V4 系列模型的检索准确率最高相差 40.2 个百分点。具体出现这一差距的是 DeepSeek-V4-Flash-Base,不能把它读成整个系列在所有任务上"性能下降四成"。
如果你在做长文档问答、RAG 或代码助手,这条报道值得关注的地方,是评测输入的排列方式:资料内容没变,模型能否找对答案,却可能随位置变化。只用一套固定模板测出一个平均分,可能漏掉应用里的薄弱位置。
40.2 个百分点,测的是哪种能力?
报道描述的任务相当明确:在长达 128K Token、包含约 1.6 万个键值对的上下文里,让模型找出指定 Key 对应的 Value。
研究人员保持键值关系、问题和上下文总长度一致,重点调整目标信息相对于压缩窗口边界的位置。这个设计试图隔离一个变量:当信息内容不变时,它在输入里的位置会不会影响检索结果。
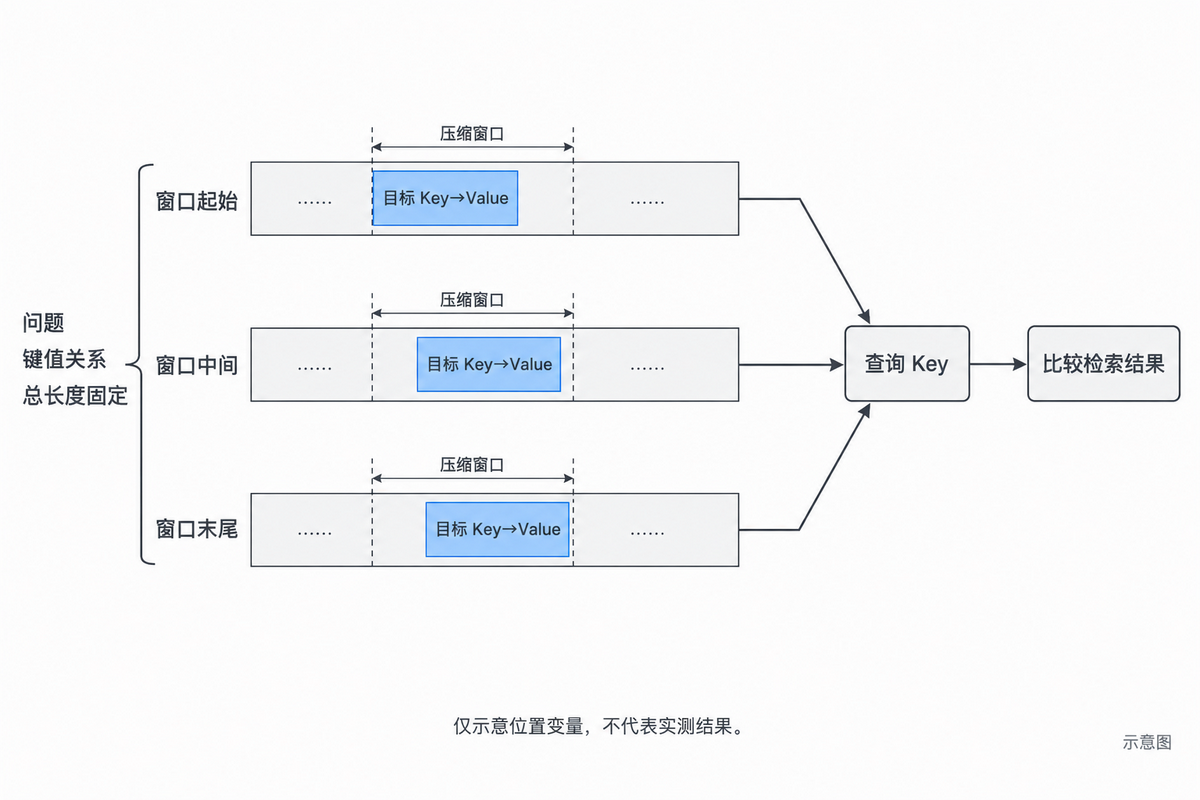
按报道列出的结果,DeepSeek-V4-Flash-Base 的最大准确率差距为 40.2 个百分点,DeepSeek-V4-Pro-Base 为 34.8 个百分点;后训练版本 Flash-0731 和 Pro-0813 分别为 19.1 和 14.8 个百分点。报道还列出了 V4.1-Flash-0910 的 6.1 个百分点差距。
这些版本不能混在一起评价。拿 Base 模型的最大差距,直接判断线上聊天版本或你的代码助手是否可靠,跨过了模型版本和业务任务两道边界。
数字本身也有三层限制。百分点是两个准确率直接相减,不是相对下降比例;最大差距描述最好位置与最差位置之间的距离,不代表平均表现;键值检索测试能检查信息读取,却不能包办跨文档推理、代码修改或完整 RAG 链路的评估。
我更关心的是:同一批样本,换几种位置后,原来的评测结论还能不能成立。
代码没改,为什么补全从 8 变成 32?
报道中的另一个案例更贴近开发者。
测试对象是 DeepSeek-V4-Flash-Base。研究人员从官方推理代码中截取一段 FP8 量化函数,让模型补全最后一个 Token。按报道说明,正确补全应为 8,但模型有时更倾向于 32。
研究人员在代码前加入含重复等号的装饰性文档字符串,再调整填充长度。目标代码和预期答案保持不变,前缀则让后续代码在整个输入中的 Token 位置发生偏移。
报道记录了 16 种填充长度:长度模 4 的余数为 0 或 1 时,模型倾向于错误答案 32;余数为 2 或 3 时,倾向于正确答案 8。这描述的是特定案例里的候选答案偏好,不能直接解释成代码助手整体成功率。
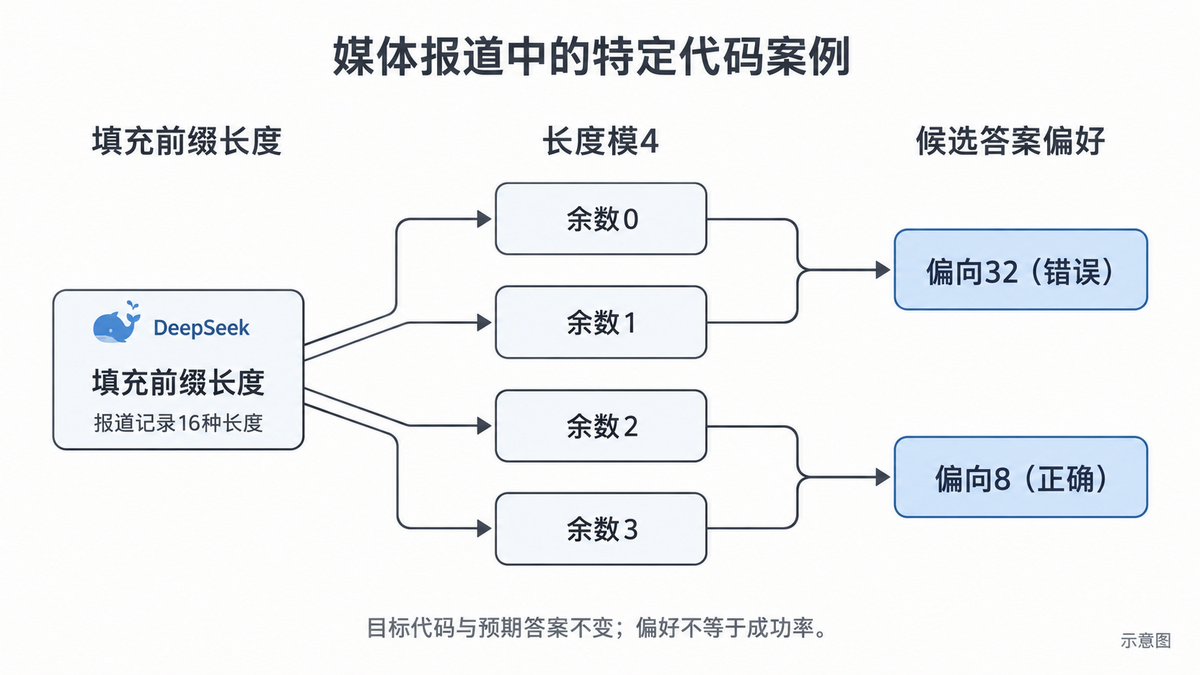
每 4 个 Token 的周期性,比"加点前缀后答错了"更有研究价值。它提示变化可能具有结构,而非一次偶然输出。但 Token 不等于字符:增加几个等号、空格或汉字,究竟产生多少 Token,要看实际分词结果。照着报道多敲两个等号,不能算复现。
这里也不能推出"给提示词加两个 Token 就能修好模型"。一次偏移改善了当前样本,换一道题、换个版本,可能又落到弱位置。
压缩机制有线索,证据还需分层看
量子位将这一现象关联到分块 KV Cache 压缩:把连续 Token 窗口压缩成更少的缓存条目,降低长上下文处理的内存与计算成本。同一信息相对于压缩窗口边界的位置,被报道称为相位。
如果不同相位的信息在压缩和后续读取时受到不同待遇,就可能出现周期性的检索差异。这是报道给出的机制解释。
现有完整报道也不只提供了相关性观察。它转述了一组基于 Qwen3-0.6B 架构的对照实验:研究人员改变压缩方案,并设置全注意力基线;分块压缩模型出现与压缩步长对应的周期变化,全注意力基线没有出现同等程度的周期性。报道还称,调整压缩步长后,波动周期随之变化。
这比单个代码案例更有说服力。不过,本文依据的是媒体转述,尚未核对论文原文、完整输入、样本量、准确率计算方式及推理配置,也没有独立复现。36氪页面明确注明来自量子位,属于同源转载,不能算第二份独立验证。因此,目前适合据此设计排查实验,不宜把所有长上下文错误都归因于缓存压缩。
应用评测该补哪一项?
我建议补一组"内容不变、位置变化"的配对评测。它不需要先证明底层机制,先回答业务问题:布局变化能否让本来正确的答案失效?
可以按下面四步做:
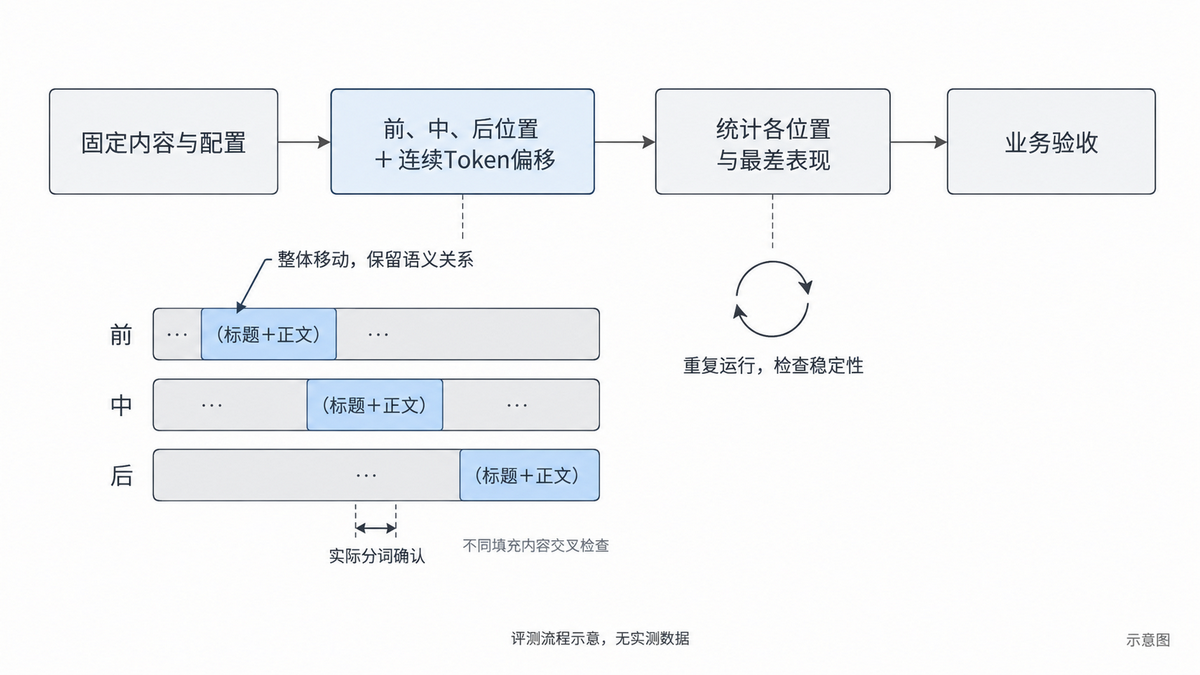
- 固定内容与配置。 保持问题、目标证据和预期答案一致,记录准确模型版本、提示模板及采样参数。RAG 场景先固定检索结果,避免把检索器变化混进生成模型测试。
- 分别测试大范围位置和小范围偏移。 将证据放到上下文前部、中部、后部;再在每个位置附近做连续 Token 偏移,覆盖多个可能周期。移动证据时尽量保持总长度一致,并用实际分词结果确认位置。
- 报告分位置结果。 除平均准确率,还记录各位置准确率、最差位置表现、最大差距,以及同一道题跨位置由对变错的比例。存在采样随机性时,在相同配置下重复运行,区分随机波动与稳定的位置差异。
- 回到业务任务验收。 文档问答检查答案与引用是否一致;RAG 检查证据是否进入上下文、进入后是否被正确使用;代码助手用测试或执行结果验收。检索成功只是其中一项。
这里有个操作边界:移动资料时,别破坏标题与正文、函数与注释之间的关系,否则测到的可能是语义结构变化。小范围前缀扰动也应使用不同填充内容交叉检查,防止某一种前缀本身影响输出。
如果发现稳定波动,再比较模型版本、上下文长度、证据排序和模板调整的效果;涉及模型选型,就用同一组配对样本比较业务通过率、延迟与成本。每项改动都应覆盖全部测试位置,不能只展示被修好的那个样本。
同一份资料换个位置就可能答错,该怎样评测可靠性?答案是把位置纳入测试变量,并让最差位置的业务表现参与上线判断。40.2 个百分点不足以替你决定换模型,却足以提醒你:一次固定布局下的高分,还不能证明应用稳定。
参考资料:
- 量子位,闻乐:《字节找到了DeepSeek时强时弱的原因》,2026年10月9日。
- 36氪:《字节找到了DeepSeek时强时弱的原因》,2026年10月9日,量子位授权转载。