上周跟一个做银行系统的老同学吃饭。他说他们行里那个替换项目,最折腾的一段不是数据迁移,是迁完之后原库还得在网上跑大半年,两边数据必须一直对得上。他用了三个字形容那段日子:不敢睡。
我问他最后靠什么扛过来的。他说买了一款数据同步软件,两边挂着跑,报表随时能切。
他说的那款软件,就是 Kingbase FlySync,圈内一般叫它 KFS。下面写的东西不是我编的,来源是它的技术白皮书、产品彩页,还有一份内部 FAQ,顺手也核了几个公开项目的数据。我想聊的是它的产品力具体落在哪些地方,参数表就不照念了。
它一开始要对付的,是一堆看着都对的方案
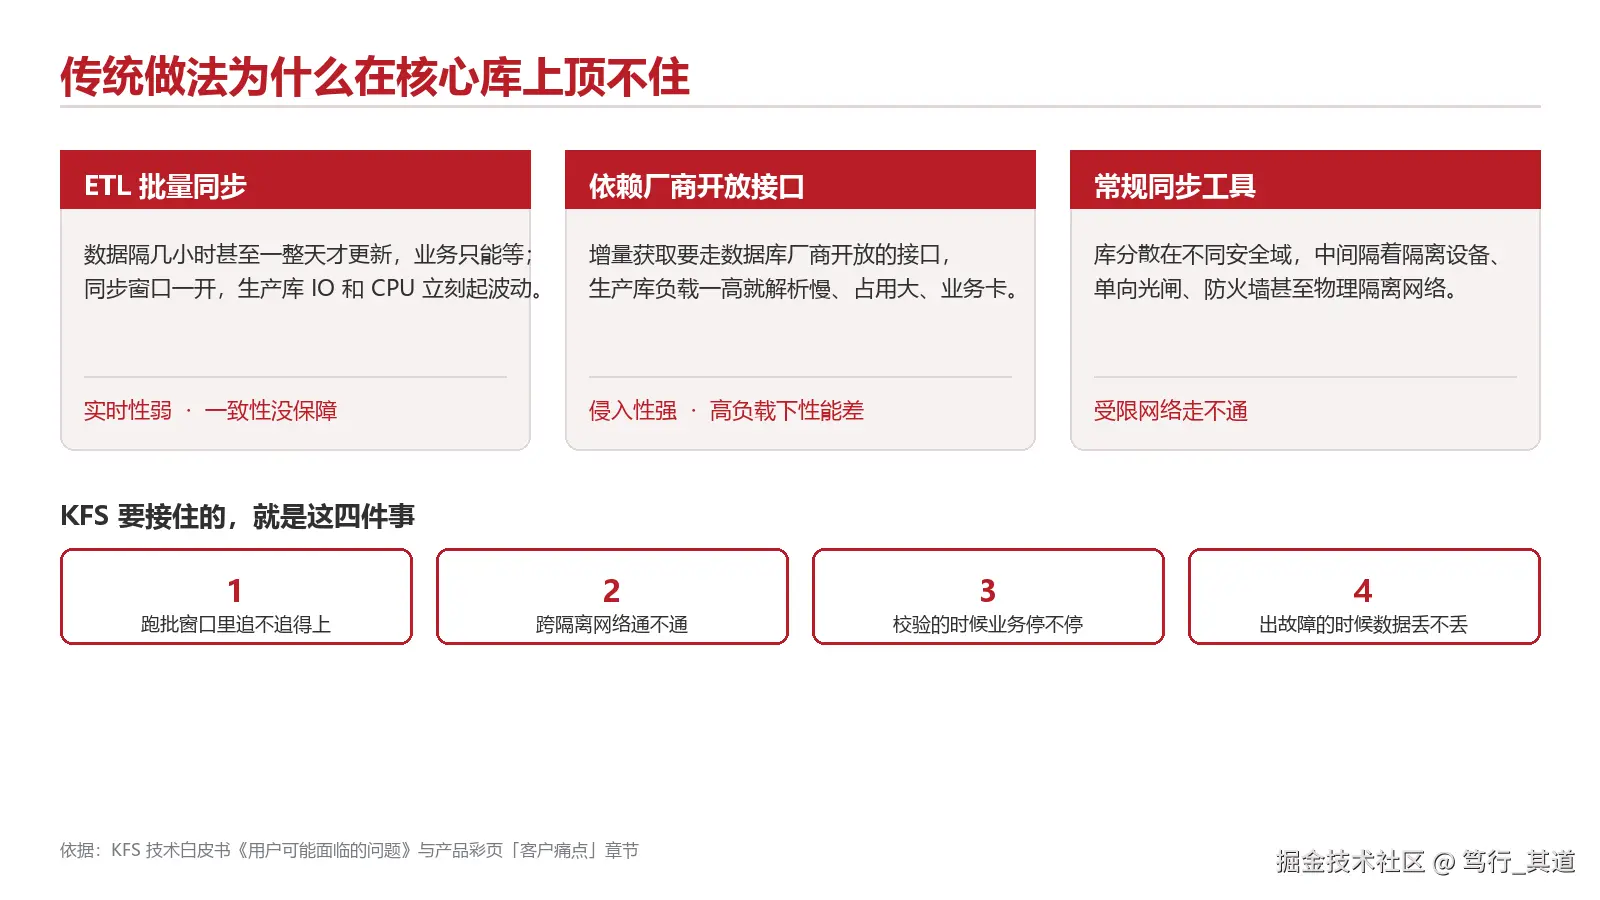
ETL 批量同步的毛病,在测试环境里基本看不出来,上了生产才现原形。数据隔几小时甚至一整天不动,业务那边催得急;同步窗口一开,生产库的 IO 和 CPU 立刻能在监控上抓到波动;至于批次和批次之间的一致性,说白了还是赌。
网络的问题更现实。很多单位的库根本不在一个网段,中间横着正反向隔离设备、单向光闸、防火墙,甚至整片都是物理隔离的。常规同步工具走到这儿,路就断了。
还有一层平时不太被提起,就是侵入性。有些增量获取的路子必须走数据库厂商开放的接口,生产库负载一高,解析慢、占用大、业务跟着卡。核心库上,谁都不愿意再加一个说不清底细的东西。
KFS 这个产品,大体就是顺着这三个方向长出来的。
日志解析,以及 KUFL 这个中间层
KFS 走的是物理日志解析。源端装一个采集模块,直接去读数据库的事务日志做实时解析,把增删改的结果加工成统一格式的中间文件,再分发出去。
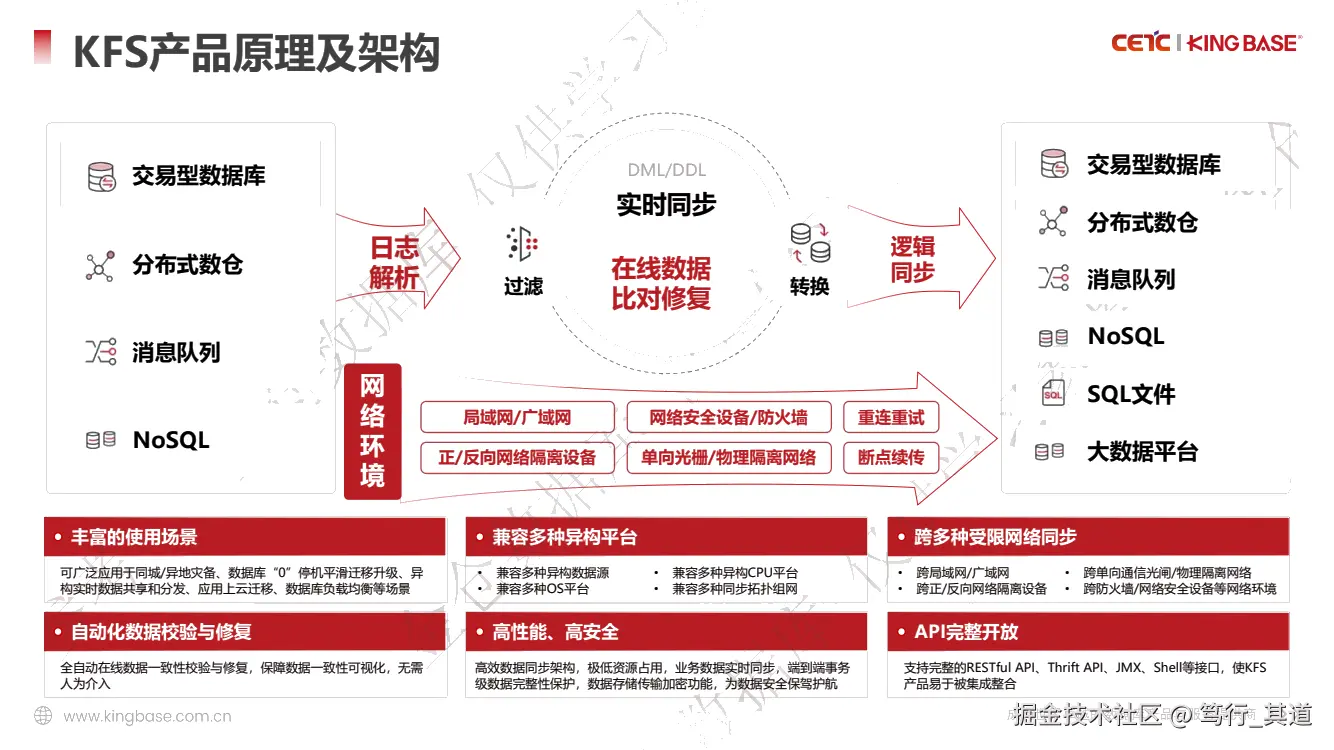
这个设计带来的连带好处,我觉得有几个。
它只碰已提交的事务。中间活动和回滚操作自动忽略掉,基础架构的负载下去了,也不会因为读到半截事务而产生脏数据。
再一个是中间那层跟踪文件,叫 KUFL,全称 Kingbase Unified Format Log。它是加密格式保存的,采集模块读到数据就立刻挪到外部文件里,源端不需要额外建表,也不需要跑查询来支撑采集过程。这一步其实挺关键,很多同步方案给源库带来的额外压力就出在这儿。系统中断的时候,KUFL 里留着中断那一刻的最新数据,恢复运行接着加载就行。
加载端把变更转成原生 SQL 写到目标库,只要目标库支持 JDBC 就能接进来。写入顺序严格跟着源库的事务提交顺序走,事务的 ACID 属性和引用完整性都保得住。
跑批才是分水岭
日常那点增量,什么产品看着都够用,差距全在跑批上暴露。
中汇亿达那个迁移项目挺有代表性。每天早上六点到七点这一小时里,跑批会产生 350G 以上的数据。客户的要求很朴素:八点上班前必须追平,不然账没法对。
KFS 的解法是把超大事务拆开处理。大事务分片技术把一个巨型事务切成若干片段并行跑,再配合基于分区索引的多通道并发入库。现场最后的结果是七点跑批结束,七点零五分数据追平,同步延迟压在五分钟以内,源端解析速率 90MB/s 往上。
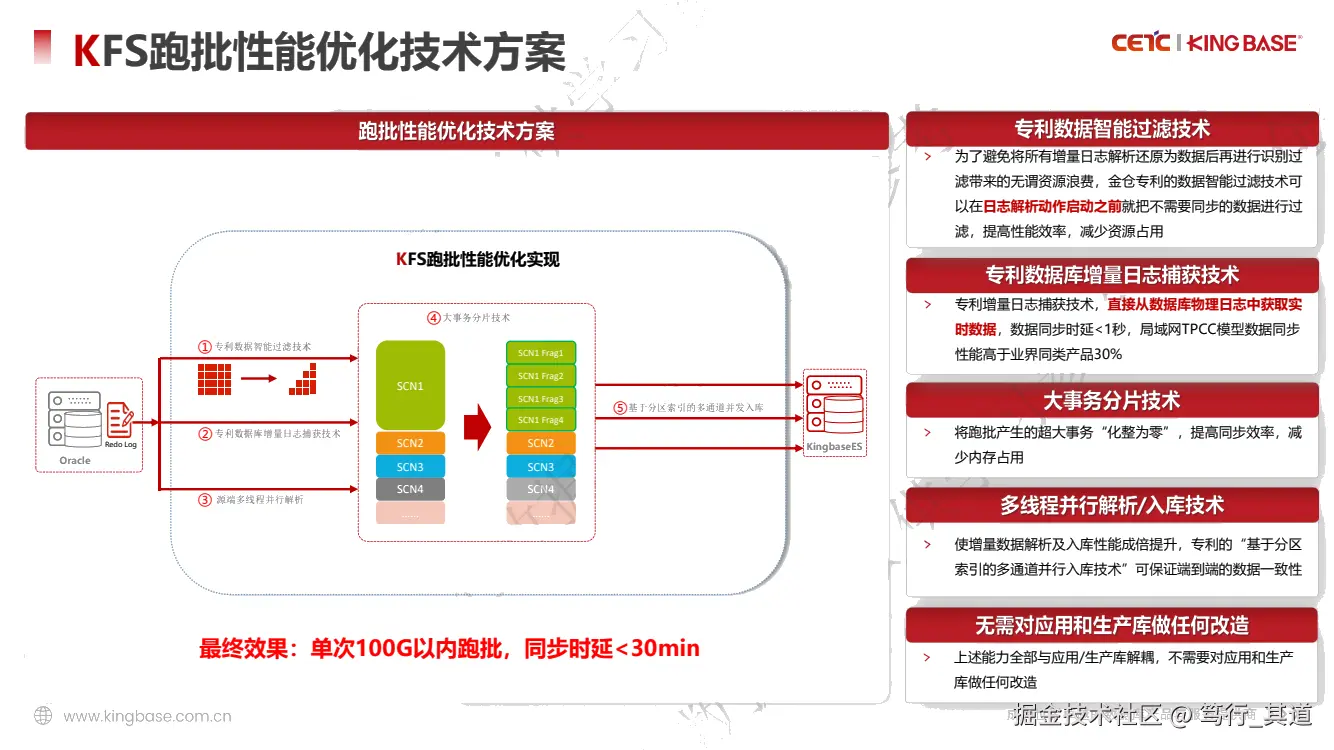
这里面有两项专利技术在撑着。一项叫数据库增量日志捕获技术,直接从物理日志里取实时数据,同步时延压到 1 秒以内,局域网 TPCC 模型下的性能比同类产品高大约三成。另一项是数据智能过滤,在日志解析动作启动之前就把不需要同步的数据剔掉,省下的是先还原成数据、再判断要不要的那一大笔无用功。
官方的参考数字是这样:千兆网加 6 核环境下,Oracle 源端解析 118MB/s,KingbaseES 源端解析 101MB/s,目标端加载 240MB/s 以上,同步延时 40ms 这个量级。
有一点想单独拎出来说。上面这些能力跟应用和生产库是解耦的,解析过程只读归档文件,不往生产库的进程里插一脚,KFS 自己崩了也不会连带把生产库拖下水。这个特性在金融和医疗客户那边,往往比性能数字更能打动人。
数据对不对,比快不快要命
同步最怕的不是慢,是错。而且是那种悄悄错、几天以后才发现、账已经对不上的错。
KFS 在这块的做法偏硬。源端事务的执行顺序就是目标端的加载顺序,这是一层;源端解析和目标端同步的日志序号要对齐、全流程保持连续,这是第二层;同步文件持久化的 I/O 顺序要被严格控制,这是第三层。三层叠起来,官方给的说法是数据 100% 完整性,停服率和错误率控制在 0.00001%。
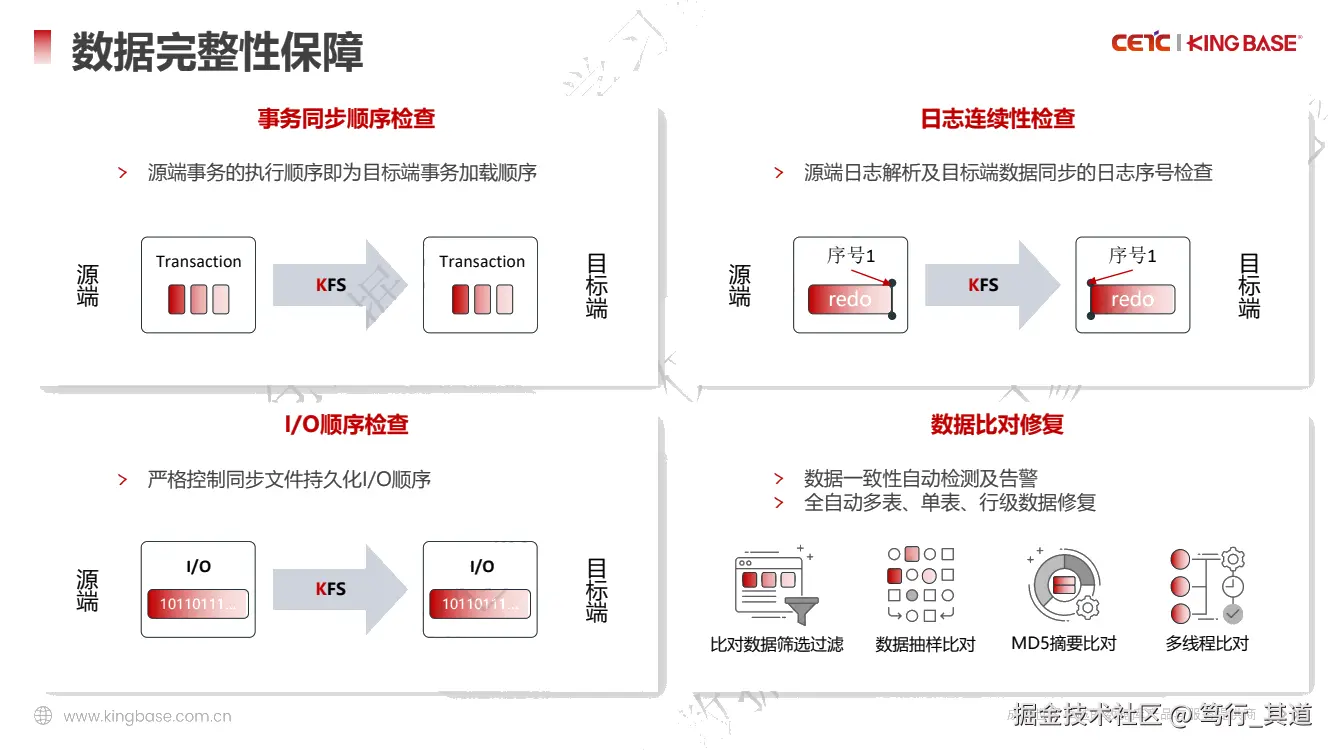
校验修复模块是内置的,不用单独掏钱买。它用源端和目标端的数据快照做比对,支持全量比对、筛选过滤比对、抽样比对、摘要比对几种方式,靠 MD5 摘要加多线程把大表的比对效率拉上来。100GB 数据量平均校验时间是分钟级,在线校验速率平均 100MB/s。301 医院那边的实测数据是校验效率 98MB/s、准确性 100%,校验期间业务机 CPU 负载只涨了不到 3%,内存多用了不到 4GB。
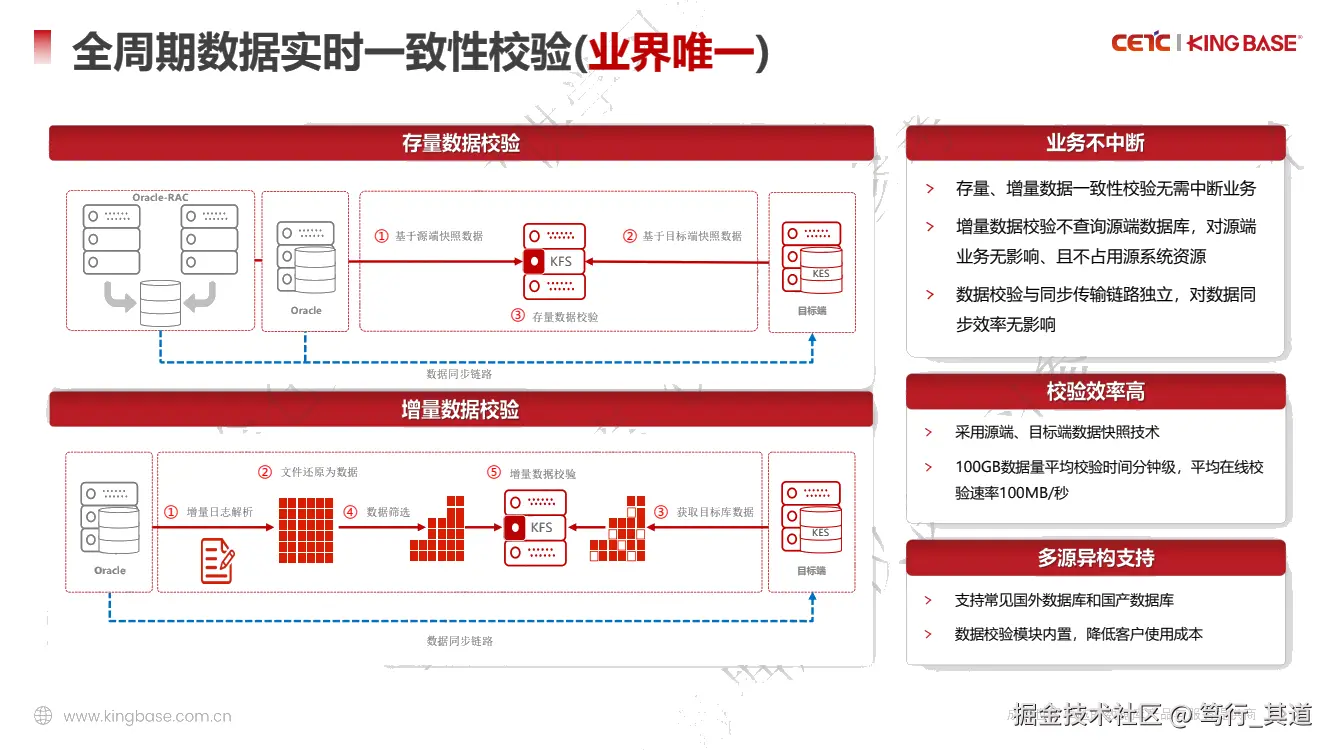
增量校验的思路,我觉得是这套方案里最巧的一处。校验程序从 KUFL 里取出指定时间段的变化数据,放进内存哈希表,再按主键去目标库把对应记录捞出来比对。整个过程不查源端数据库,对源端业务没有影响。人民银行征信中心的融资平台用这套办法,把校验耗时从原来的六个多小时压到了十分钟以内。原因也不复杂,他们历史数据多、日常增量小,原来只能全表扫,纯属硬啃。
故障是常态,接得住才叫本事
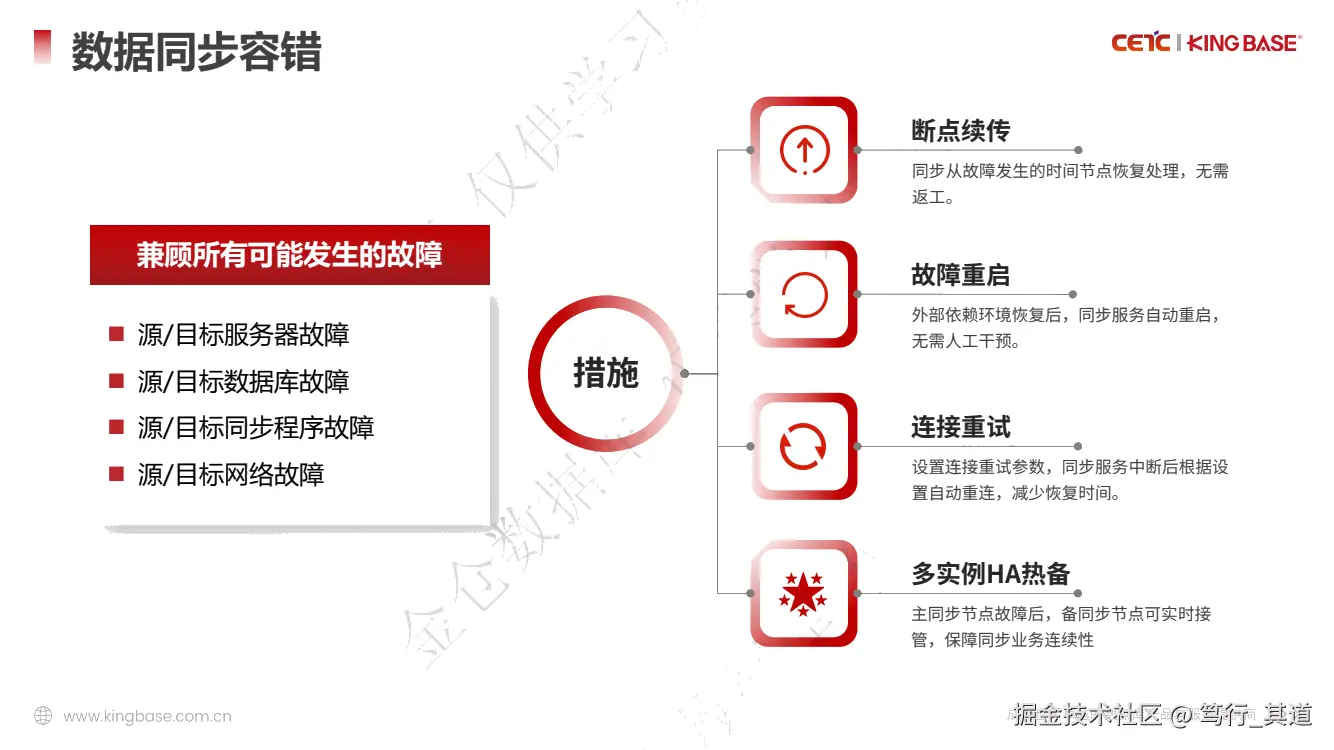
做同步这行的人都清楚,链路早晚会断。源端服务器宕机、目标端数据库重启、网络抖一下、同步进程自己挂了,这些都是必然要遇到的。
KFS 铺了四层应对。断点续传,从断掉的那一刻接着走,不重新来过。故障重启,依赖的环境恢复之后同步服务自己拉起来。连接重试,按配好的参数自动重连。多实例热备,靠 KFS-HA 和 KFS-replicator 两个组件配合,主节点不行了备节点接管。实测切换一般在 10 秒以内。KFS-HA 还支持跨网段检测,多实例双轨并行也能一键切换。
数据源和拓扑,国产化项目里的硬门槛
这一条最现实。国内的项目环境千奇百怪,光支持几种主流库是不够的。
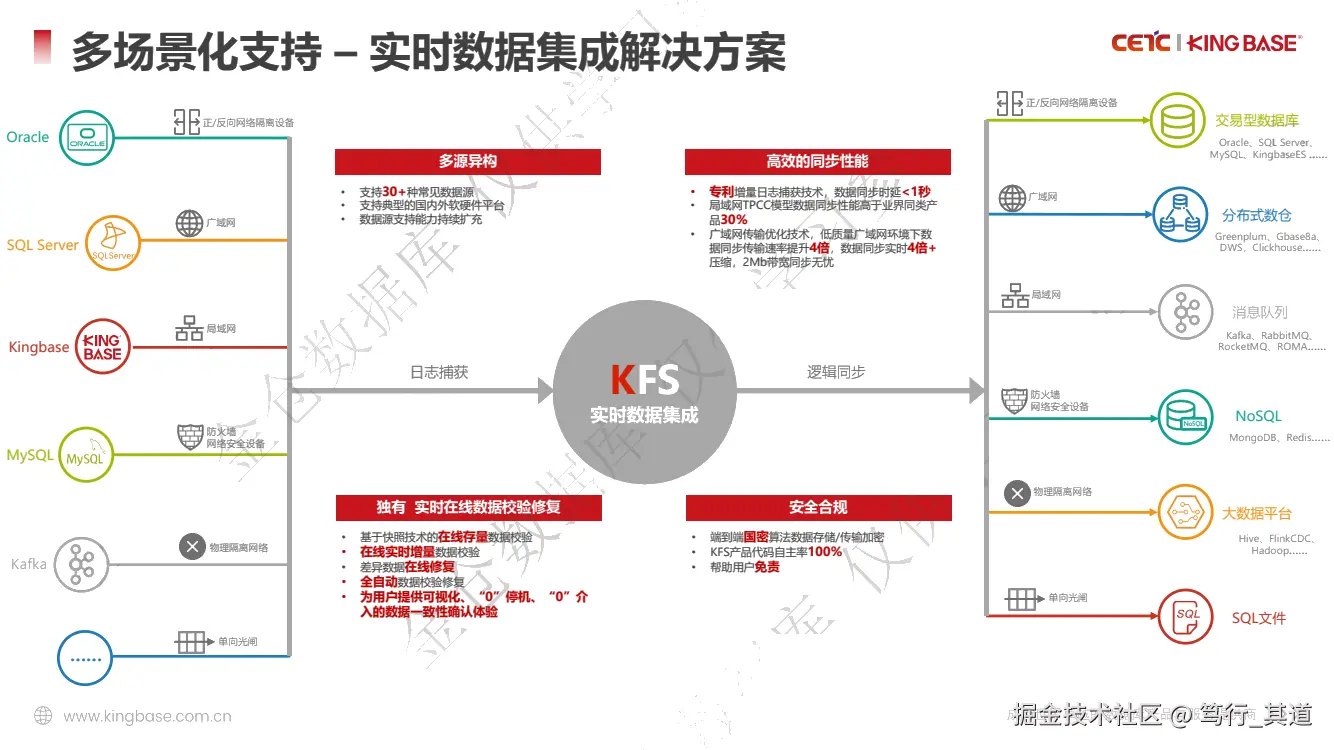
KFS 官方说支持 30 余种数据源。国外的有 Oracle、SQL Server、MySQL/MariaDB、DB2、Informix;国产的到达梦、GBase 8s、OceanBase、PolarDB、openGauss、TDSQL;消息队列有 Kafka、RabbitMQ、RocketMQ;再往外还有 MongoDB、Elasticsearch、Hive、Hadoop、ClickHouse、Greenplum、华为 DWS、SQL 文件这些。国产数据源做了深度适配,这点的分量在信创项目里格外实在。硬件平台适配了鲲鹏、海光、申威、龙芯、飞腾、兆芯以及 X86、Power,操作系统覆盖统信、麒麟、凝思、欧拉等。
拓扑上一对一、一对多、多对一、级联、双向都能搭,跨网段、跨网络隔离装置、跨单向光闸、跨物理隔离网络、跨防火墙也都能同步。广域网传输做了优化,速率提升 4 倍,数据实时 4 倍以上压缩,2M 带宽就能跑实时容灾。
上海国际妇幼婴那个项目可以当个例子。他们原来用 OGG 做 SQL Server always on 集群到 SQL Server 单机的同步,麻烦在于集群一切换,同步就断了,恢复还要等很久。换成 KFS 之后,集群切换完同步能很快接上继续走。这一点原来那套方案做不到。
迁移方案迭代了三代
KFS 在平滑迁移上的演进路线挺清晰。
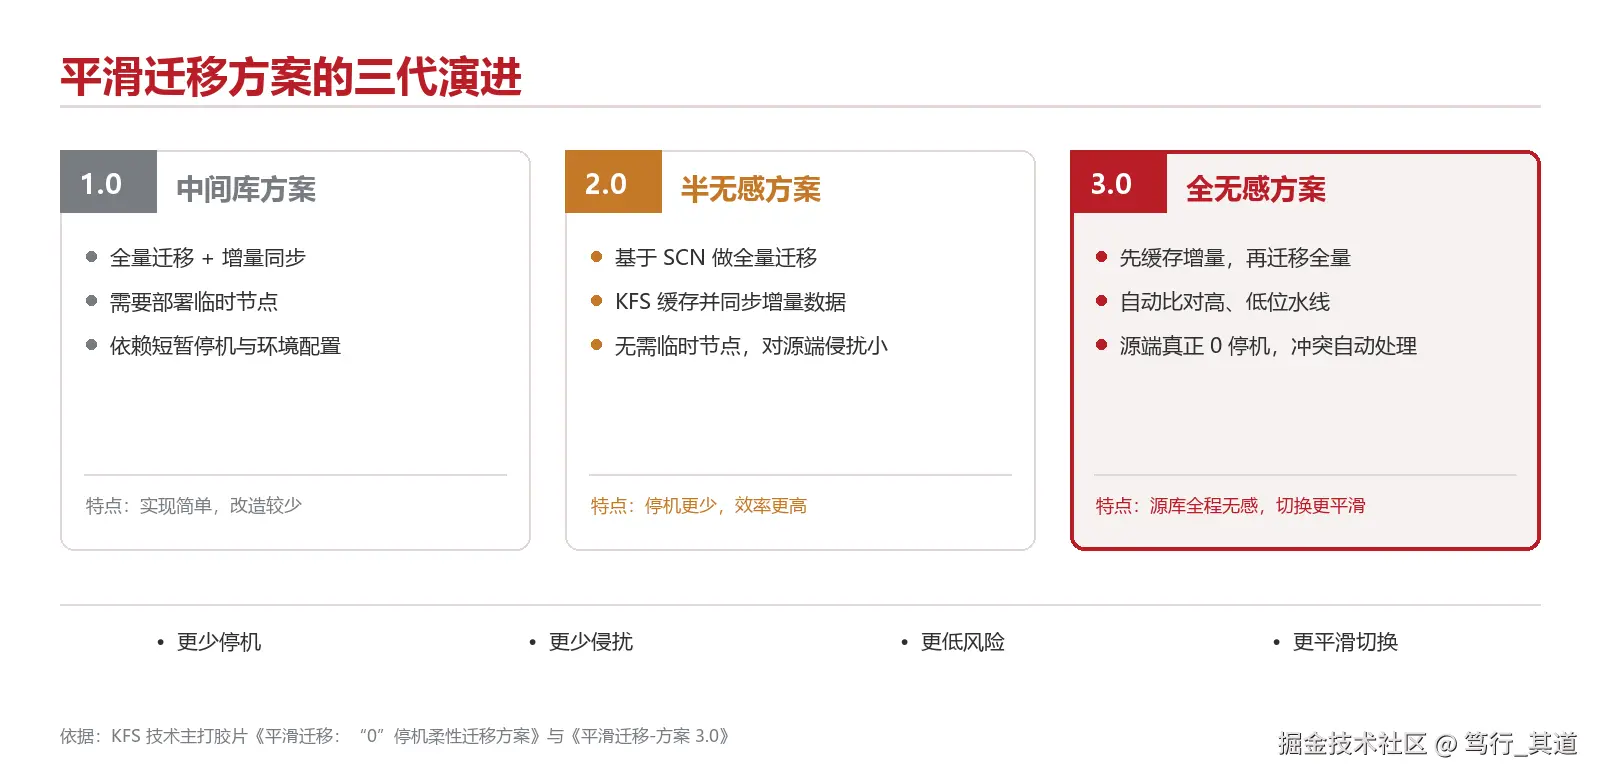
最早的 1.0 是中间库方案,全量迁移加增量同步,得部署临时节点,还要短暂停机。
2.0 变成 SCN 级迁移。基于 SCN 把全量搬过去,KFS 先在本地把增量缓存起来,等全量迁移完再追平。停服时间短,而且不随存量数据量增长,TB 级的存量数据对应的是分钟级停机。临时节点也不需要了。
3.0 更彻底。KFS 直接解析并缓存增量,KDTS 不依赖 SCN 直接做全量迁移,冲突数据自动检测自动处理。源端一秒钟都不用停,也不用备份还原生产库,为迁移专门准备的临时节点那笔硬件预算也省了。官方说相比旧方案迁移时间能缩短三成。
配套的双轨并行方案,解决的是敢不敢切的心理问题。第一阶段原系统还在承载业务,新建的库做备库顺便分担点查询;跑稳一段时间后对调主备;能力验证充分了再把原系统彻底下线。整个过程里哪一步出问题都能无感回退,数据不丢。
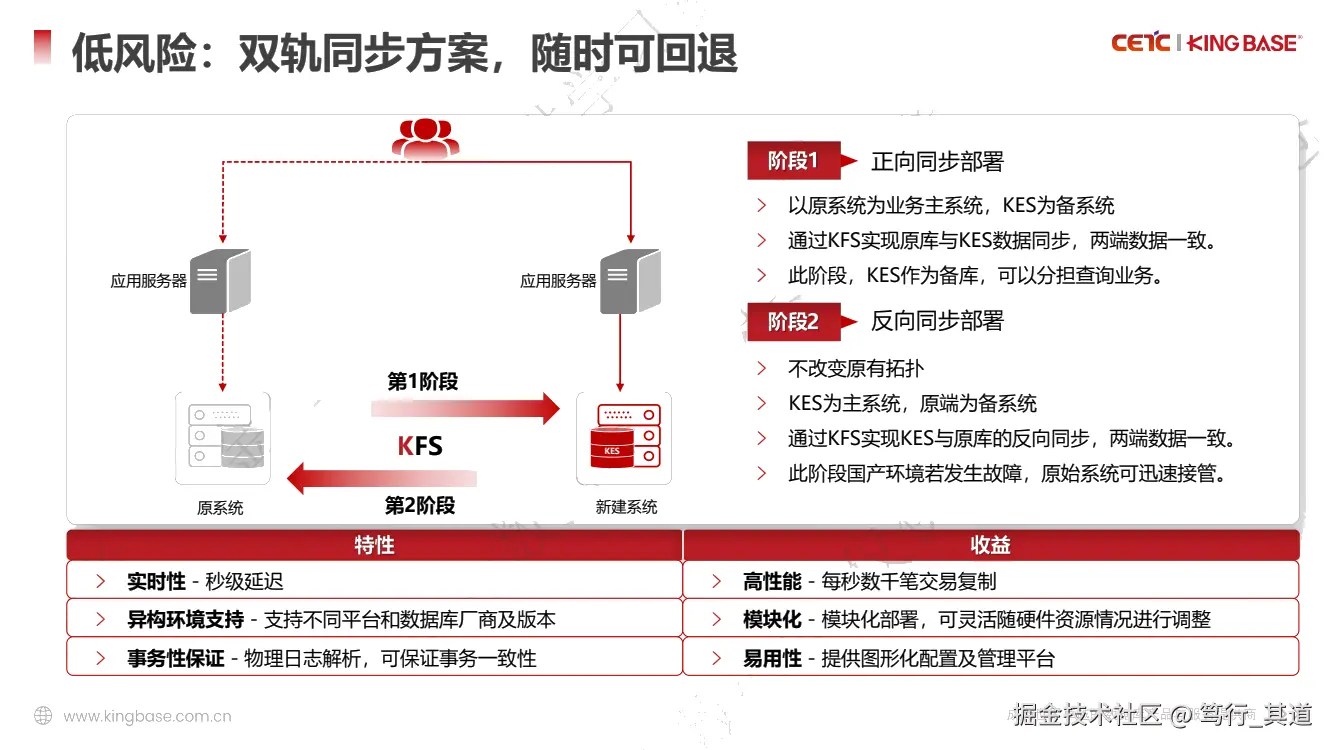
中汇亿达就是按阶梯渐进的节奏做的,六个业务模块分四个阶段迁移。先全部从 Oracle 同步到 KingbaseES,然后两个模块切过去反向同步、观察,再四个模块切过去、观察,最后全部切过去。每一步都留着退路。
好用和免责,也是产品力的一部分
可视化这块覆盖了全生命周期,安装部署、参数配置、任务启停、监控告警、数据校验、补丁升级都在统一界面里,KFSMC 数据同步管理平台能管多个源端和目标端。接口方面有完整的 RESTful API、Thrift API、JMX 和 Shell,方便被上层平台集成。另外官方提供一套管家式的业务分析评估,自动做硬件、软件、网络、数据源四个维度的环境分析,出一份风险评估报告。
安全合规上,产品代码自主率 100%,内部数据存储和传输都是端到端国密算法加密,跟数据库连接支持 SSL/TLCP。产品编译内置了 OEM 客制化方案,CLI、GUI、Logo 都能一键换掉。这类能力平时不出现在参数表里,但到了客户的安全审查和品牌定制环节,缺了就很难过关。
最后
一款数据同步软件的产品力,不在功能列表有多长,而在最难的那几个位置能不能站住。跑批窗口里追不追得上,跨隔离网络通不通,校验的时候业务停不停,出故障的时候数据丢不丢。
KFS 在这几处的答卷相对扎实。它已经规模化交付了 5000 余套,服务 500 多家客户,人民银行征信中心、国家外汇交易中心、解放军总医院、国家电网、南方电网、中国移动、中石化、一汽集团这些单位都在用。对正在做数据库替换、又不打算拿业务连续性去赌的团队来说,这类产品的价值,往往要等到项目最紧张的那几周才会真正显出来。