旧版单文件 AOF 主要通过重放写命令恢复数据;Redis 7+ 的多部件 AOF 则先加载 BASE,再重放后续 INCR。增量日志越长,需要解析和执行的命令越多,恢复时间也可能越长。由于现代 BASE 可以采用 RDB 格式,"RDB 恢复一定快、AOF 恢复一定慢"不是绝对结论,真正耗时取决于基线大小、增量日志长度、磁盘和 CPU。
RDB 采用另一种思路:直接保存某一时刻的数据集状态。Redis 重启时,不需要从头重放全部历史操作,只要读取 RDB 文件并重建内存对象即可。
RDB 的核心价值是缩短恢复时间,但它同样有明确代价:全量快照会消耗 CPU、磁盘带宽和内存,快照间隔内的数据仍可能丢失。
一、RDB 快照保存什么
RDB 是 Redis 在某个时间点的数据集快照,默认文件名为:
conf
dbfilename dump.rdbRDB 文件包含恢复数据集所需的信息,例如:
- 数据库编号与键值数据。
- 数据类型及序列化后的值。加载后 Redis 会按当前版本和配置重建内存对象,不保证恢复成与保存前完全相同的内部编码。
- Key 的过期时间。
- Redis 版本、创建时间等辅助信息。
- 文件尾部的校验信息。
RDB 保存的是某一时刻的最终状态,不保存每次修改的完整历史。例如,一个计数器从 1 连续增加到 10000,RDB 只需要保存快照时的值 10000。
这带来两个直接结果:
- 文件通常比同一时期积累的大量操作日志更紧凑。
- 恢复时以加载数据为主,不必逐条重新执行全部历史命令。
但"恢复更快"不代表瞬间完成。大 RDB 仍需要磁盘读取、校验、解压、对象创建和内存分配;Redis 完成加载并对外提供服务之前,启动时间仍可能很长。
二、SAVE 和 BGSAVE 有什么区别
1. SAVE:由主进程同步生成
text
SAVESAVE 在 Redis 主进程中同步遍历数据并写入 RDB。在执行结束前,Redis 无法正常处理其他客户端命令。
除非用于维护、测试或明确可接受停机的场景,生产环境通常不应主动执行 SAVE。
2. BGSAVE:由子进程生成
text
BGSAVEBGSAVE 的流程是:
- 主进程调用
fork创建子进程。 - 子进程遍历快照时刻的数据集并生成临时 RDB 文件。
- 主进程继续处理客户端读写。
- 子进程完成写入并同步文件。
- Redis 使用原子重命名,以新 RDB 替换旧 RDB。
如果已有后台保存,Redis 不会再启动第二个并行 RDB 子进程;如果当时正在执行 AOF 重写,普通 BGSAVE 会返回错误。此时可以使用:
text
BGSAVE SCHEDULE让 Redis 在当前 AOF 重写完成后安排一次后台保存。
3. "后台保存"不等于"完全无阻塞"
RDB 生成主体在子进程中执行,但 fork 由主线程发起。创建子进程期间,事件循环会停顿。
数据集越大、页表越大、内存碎片越严重,或者宿主机与虚拟化环境越繁忙,fork 延迟通常越明显。因此,更准确的说法是:BGSAVE 避免主线程亲自执行整次快照,但不能消除 fork、写时复制和资源竞争带来的影响。
三、快照期间为什么还能处理写请求
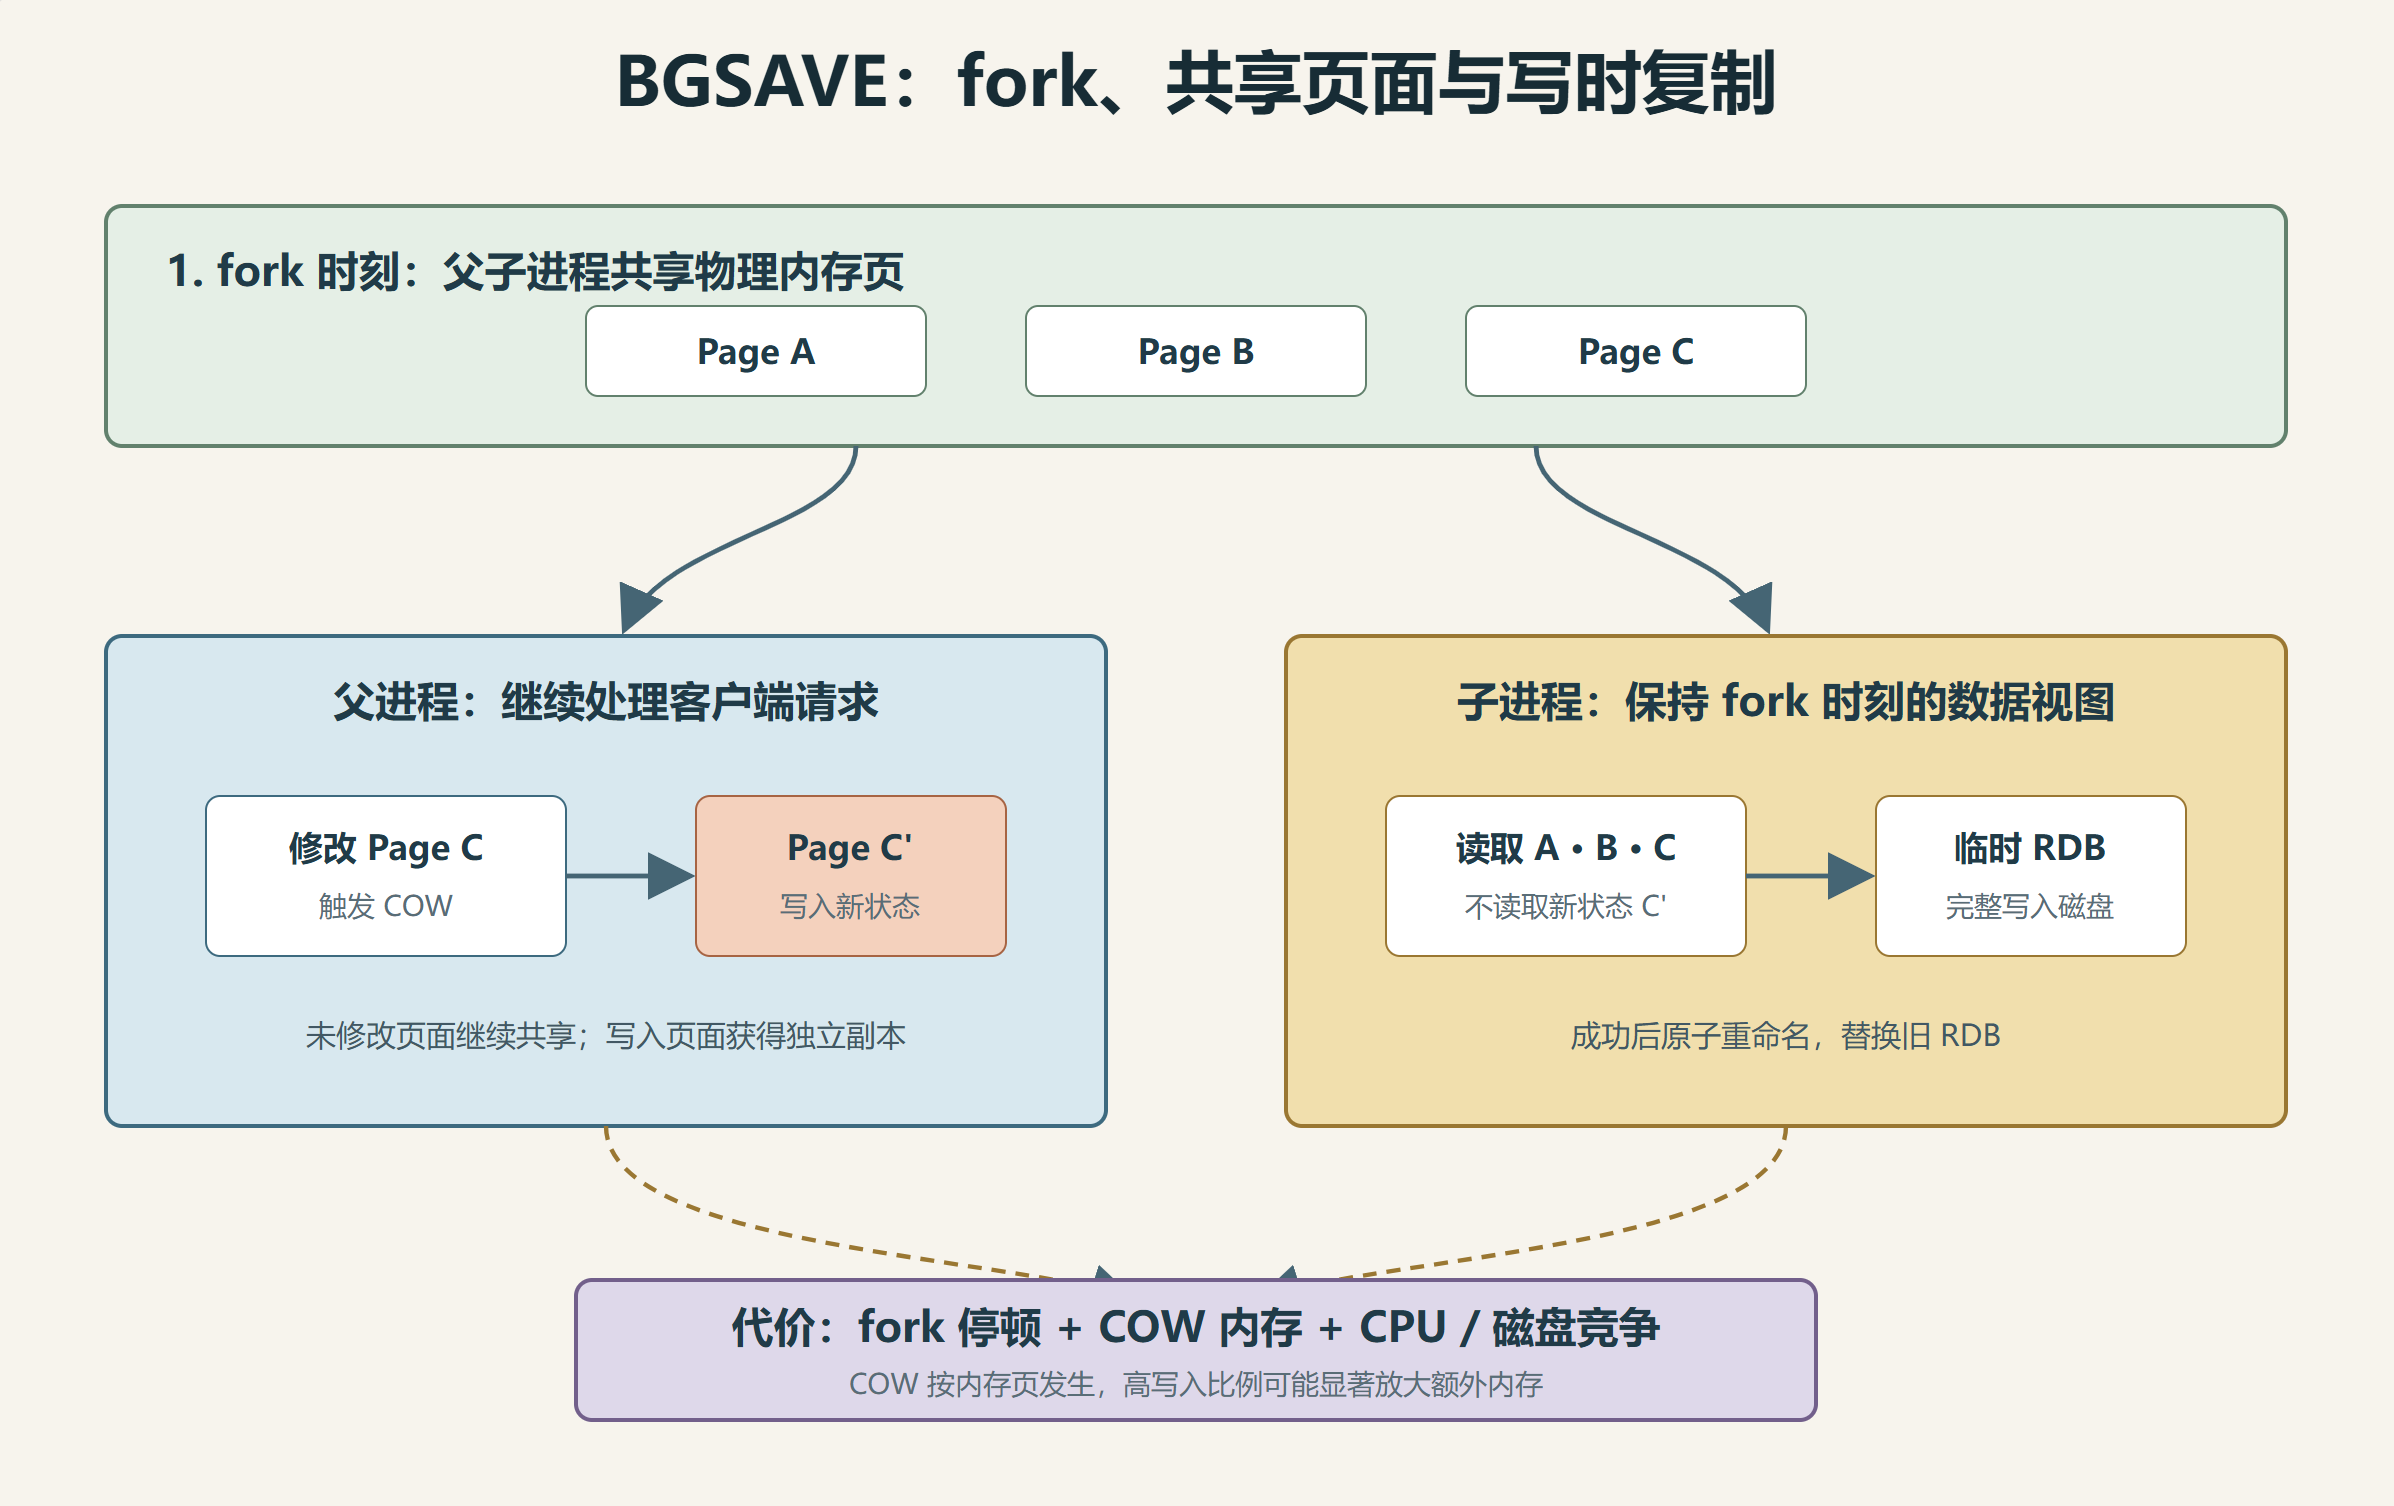
如果主进程和子进程同时访问同一份内存,而且主进程仍在修改数据,怎样保证子进程看到的是同一个时间点的状态?
答案是写时复制(Copy-On-Write,COW)。
1. fork 后先共享物理内存页
子进程创建后,不会立刻复制完整数据集。父子进程先共享相同的物理内存页,只复制页表等进程管理信息。
子进程按照自己的地址空间读取数据并写入 RDB。对于没有被修改的页,父子进程始终共享,无须额外复制。
2. 父进程写入时才复制内存页
如果主进程修改某个共享页,操作系统会为写入方准备独立副本,使父子进程各自拥有稳定视图:
- 子进程继续看到
fork时刻的数据。 - 父进程在自己的页面上写入新数据。
- 新写入不会混入本次 RDB 快照。
所以,RDB 表示的是 fork 时刻的一致逻辑数据集,而不是整个快照写盘期间不断变化的混合状态。文件真正落盘完成的时间更晚,但其中的数据视图不会跟着业务写入继续变化。
3. COW 的粒度是内存页,不是 Key
这是评估内存开销时非常重要的边界。即使只修改一个很小的 Value,也可能导致它所在的整个内存页被复制。
高写入比例、随机修改大量页面、透明大页以及内存碎片,都可能放大 COW 开销。极端情况下,额外内存会接近数据集规模,而不是"只等于被修改 Value 的总大小"。
四、RDB 的数据丢失窗口
RDB 只保存快照时刻的状态。假设:
text
T0:完成一次 RDB
T1:发生大量写入
T2:计划生成下一次 RDB
如果实例在 T1 与 T2 之间发生故障,能够恢复到的最近状态仍然是 T0。从 T0 完成后到故障前的写入可能全部丢失。
这就是恢复点目标(RPO)问题:
text
RPO ≈ 故障时刻 - 最近一次成功快照时刻注意必须看"最近一次成功完成"的快照,而不是最近一次开始执行的快照。正在生成但尚未原子替换完成的临时 RDB,不能作为可靠恢复点。
五、为什么不能每秒执行一次全量快照
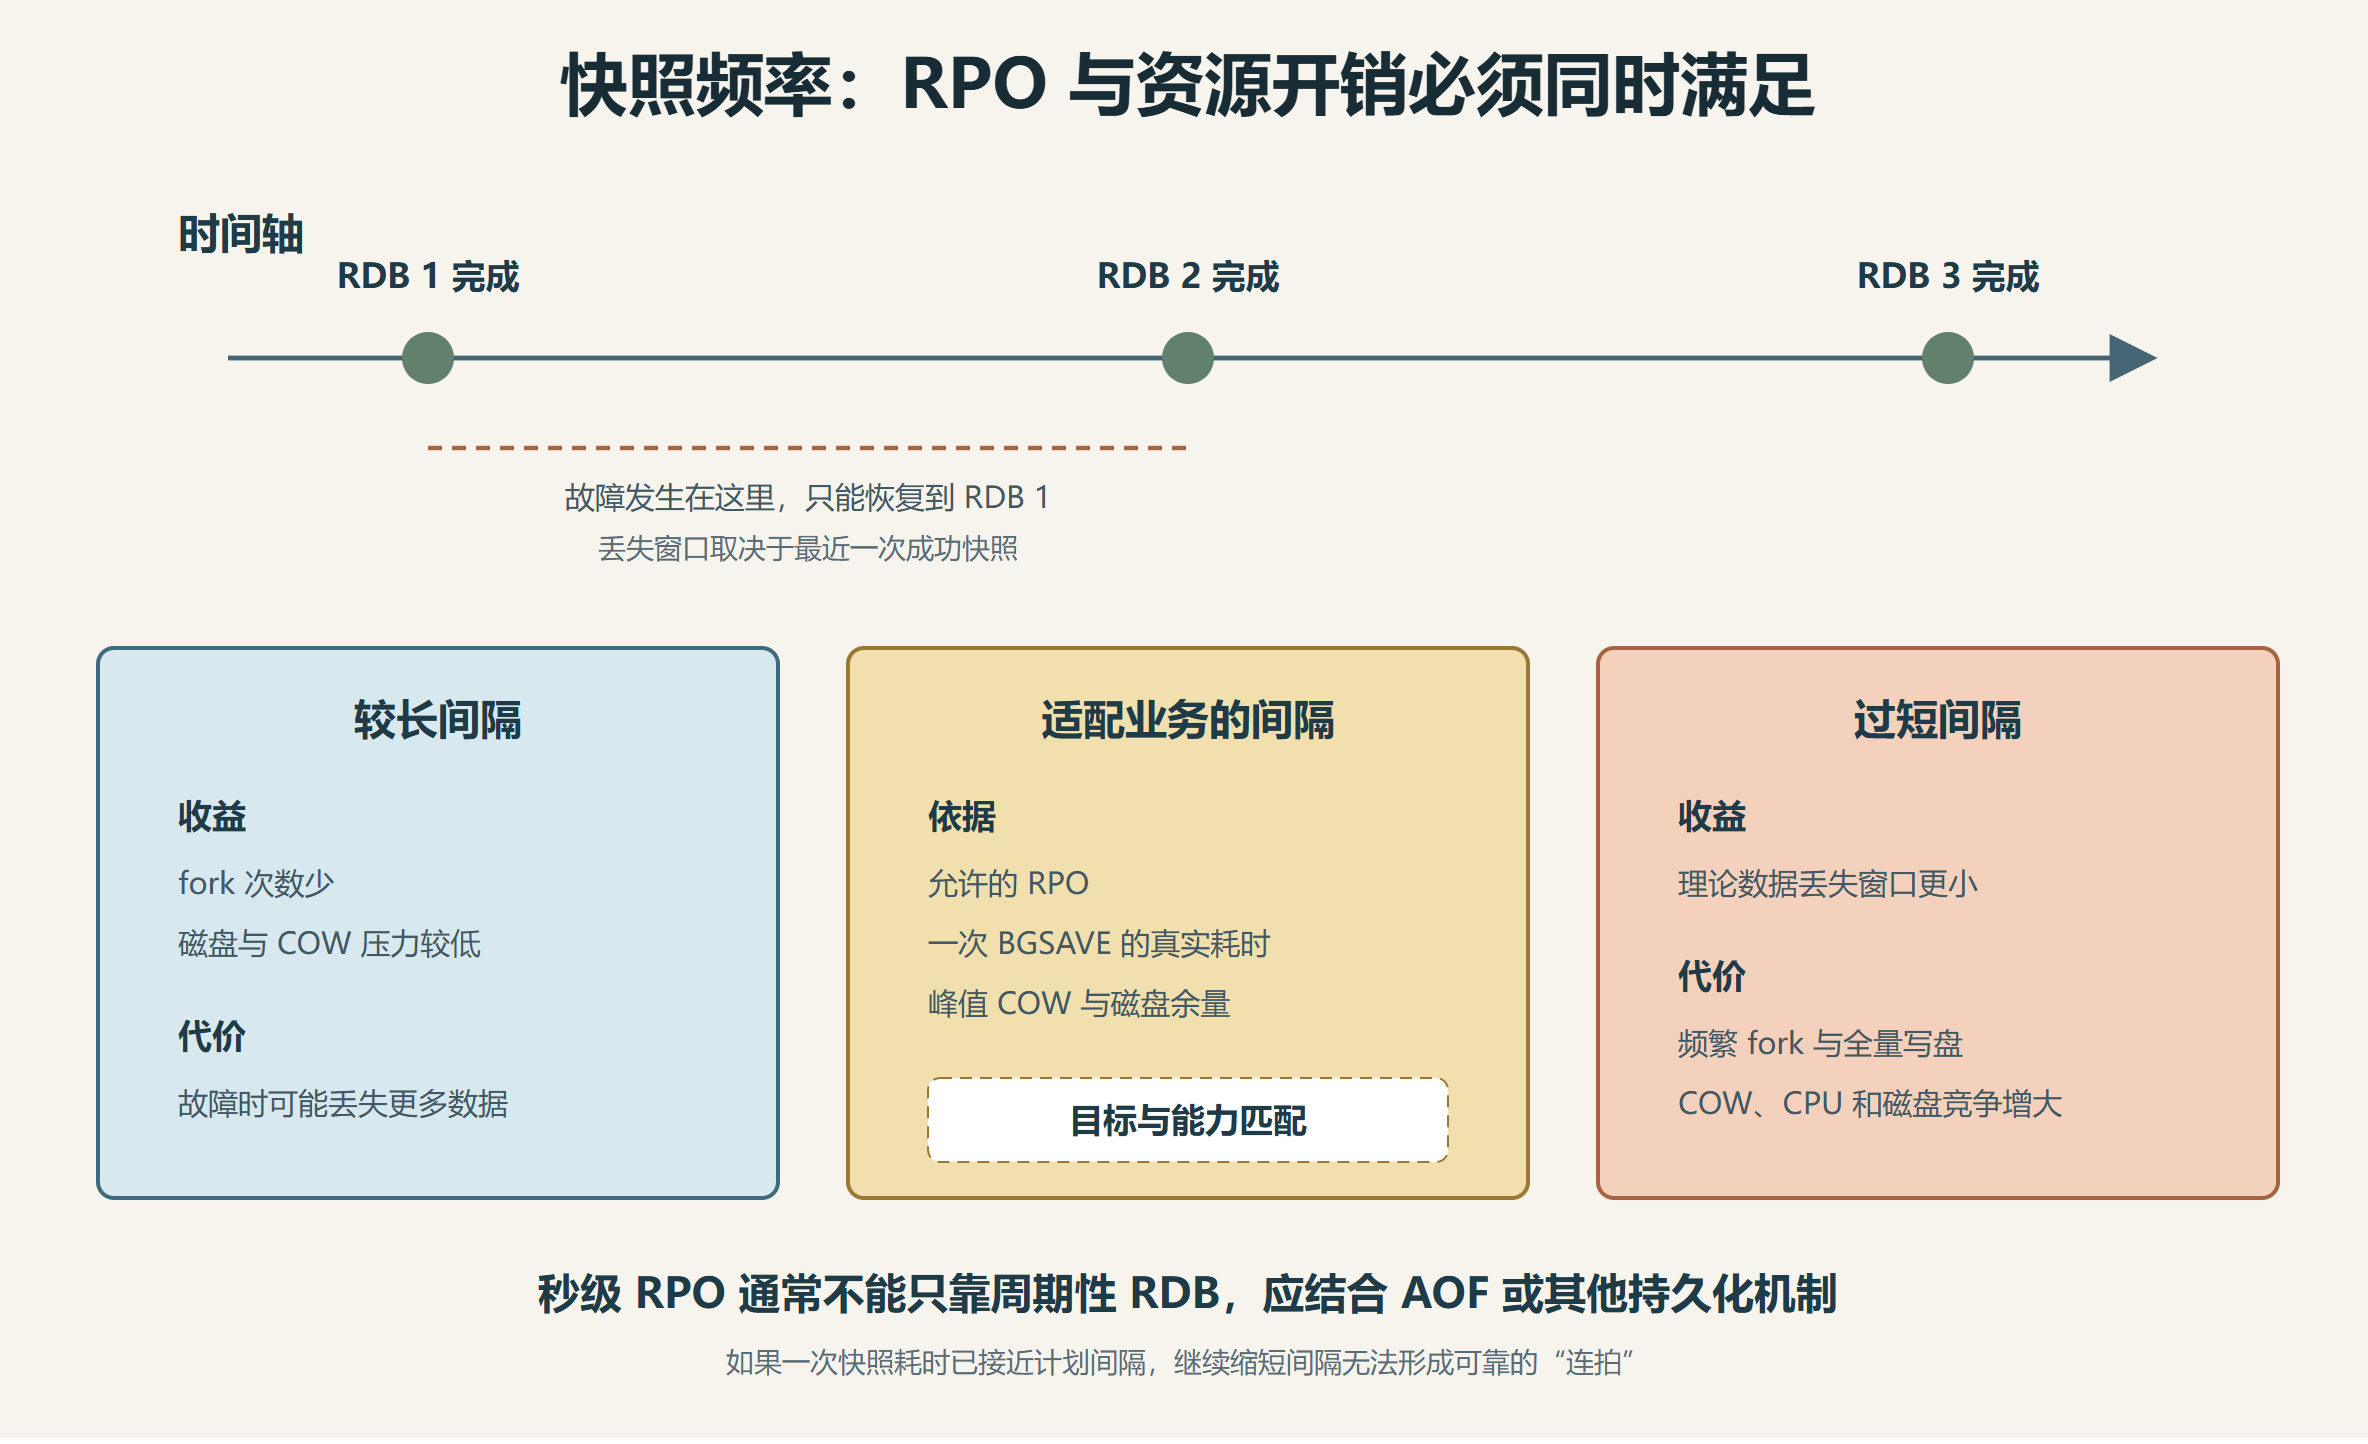
缩短快照间隔可以减小 RPO,但频繁执行全量 BGSAVE 会带来多重成本。
1. 频繁 fork 停顿
每次 BGSAVE 都需要 fork。大内存实例频繁创建子进程,会反复暂停事件循环并形成尾延迟尖峰。
2. 持续占用磁盘带宽
每次都要遍历整个数据集并写出完整 RDB。快照越频繁,磁盘越接近持续满负载,AOF、复制、业务日志和其他进程都会受到影响。
3. COW 内存增长
快照运行时间越长、期间写入越多,发生复制的内存页越多。频繁快照意味着系统经常处于 COW 压力期。
4. Redis 不会无限并发执行多个快照
当一个后台保存仍在进行时,Redis 不会再并行启动另一个普通 BGSAVE。如果快照耗时已经接近或超过计划间隔,继续缩短配置间隔并不会获得理想的"连续快照",只会说明资源能力无法满足目标 RPO。
六、如何配置自动快照
save 配置使用"时间窗口 + 写入次数"定义触发条件。例如:
conf
save 3600 1 300 100 60 10000可以拆成三组:
| 时间窗口 | 至少发生的变更数 | 触发条件 |
|---|---|---|
| 3600 秒 | 1 | 一小时内只要有一次变更 |
| 300 秒 | 100 | 五分钟内至少一百次变更 |
| 60 秒 | 10000 | 一分钟内至少一万次变更 |
任意一组满足时,都可以触发后台保存。它们不是三个必须同时成立的条件。
禁用基于条件的自动快照,可以使用空的 save 配置;具体写法和动态修改方式应以当前 Redis 版本的配置接口为准。
配置快照频率时,需要用真实数据回答三个问题:
- 业务最多允许丢失多久的数据?
- 一次
BGSAVE实际需要多长时间? - 峰值写入期间需要预留多少 COW 内存?
如果业务要求秒级 RPO,单独依赖周期性 RDB 通常不合适,应结合 AOF、复制或其他持久化系统。
七、Redis 是否支持真正的增量 RDB 快照
经典 Redis RDB 持久化生成的是全量快照。Redis 不会为了普通 RDB 持久化,长期维护"哪些 Key 自上次快照后发生过修改"的增量文件链。
配置:
conf
rdb-save-incremental-fsync yes名字中虽然有 incremental,但它不是增量快照。它表示子进程生成 RDB 时,每写出约 4 MB 数据就逐步执行一次同步,减少结束时一次性同步大文件造成的延迟尖峰。
不要把"增量同步 RDB 文件"误解成"只保存发生变化的 Key"。
八、RDB 文件怎样保证完整替换
BGSAVE 不会直接覆盖正在使用的 dump.rdb。子进程先写临时文件,成功完成后再原子重命名为正式文件。
这样可以避免:
- 保存过程中崩溃,把原本可用的 RDB 覆盖成半个文件。
- 备份系统读到一份正在不断增长的正式 RDB。
- 启动时误把未完成的临时文件当成有效快照。
默认配置通常还包括:
conf
rdbcompression yes
rdbchecksum yes
rdb-save-incremental-fsync yesrdbcompression使用压缩减少可压缩字符串的文件体积,代价是保存和加载时增加 CPU 开销。rdbchecksum在文件尾部保存 CRC64 校验,用于检测损坏。rdb-save-incremental-fsync平滑大文件落盘时的 I/O 峰值。
九、RDB 与 AOF 混合持久化的准确含义
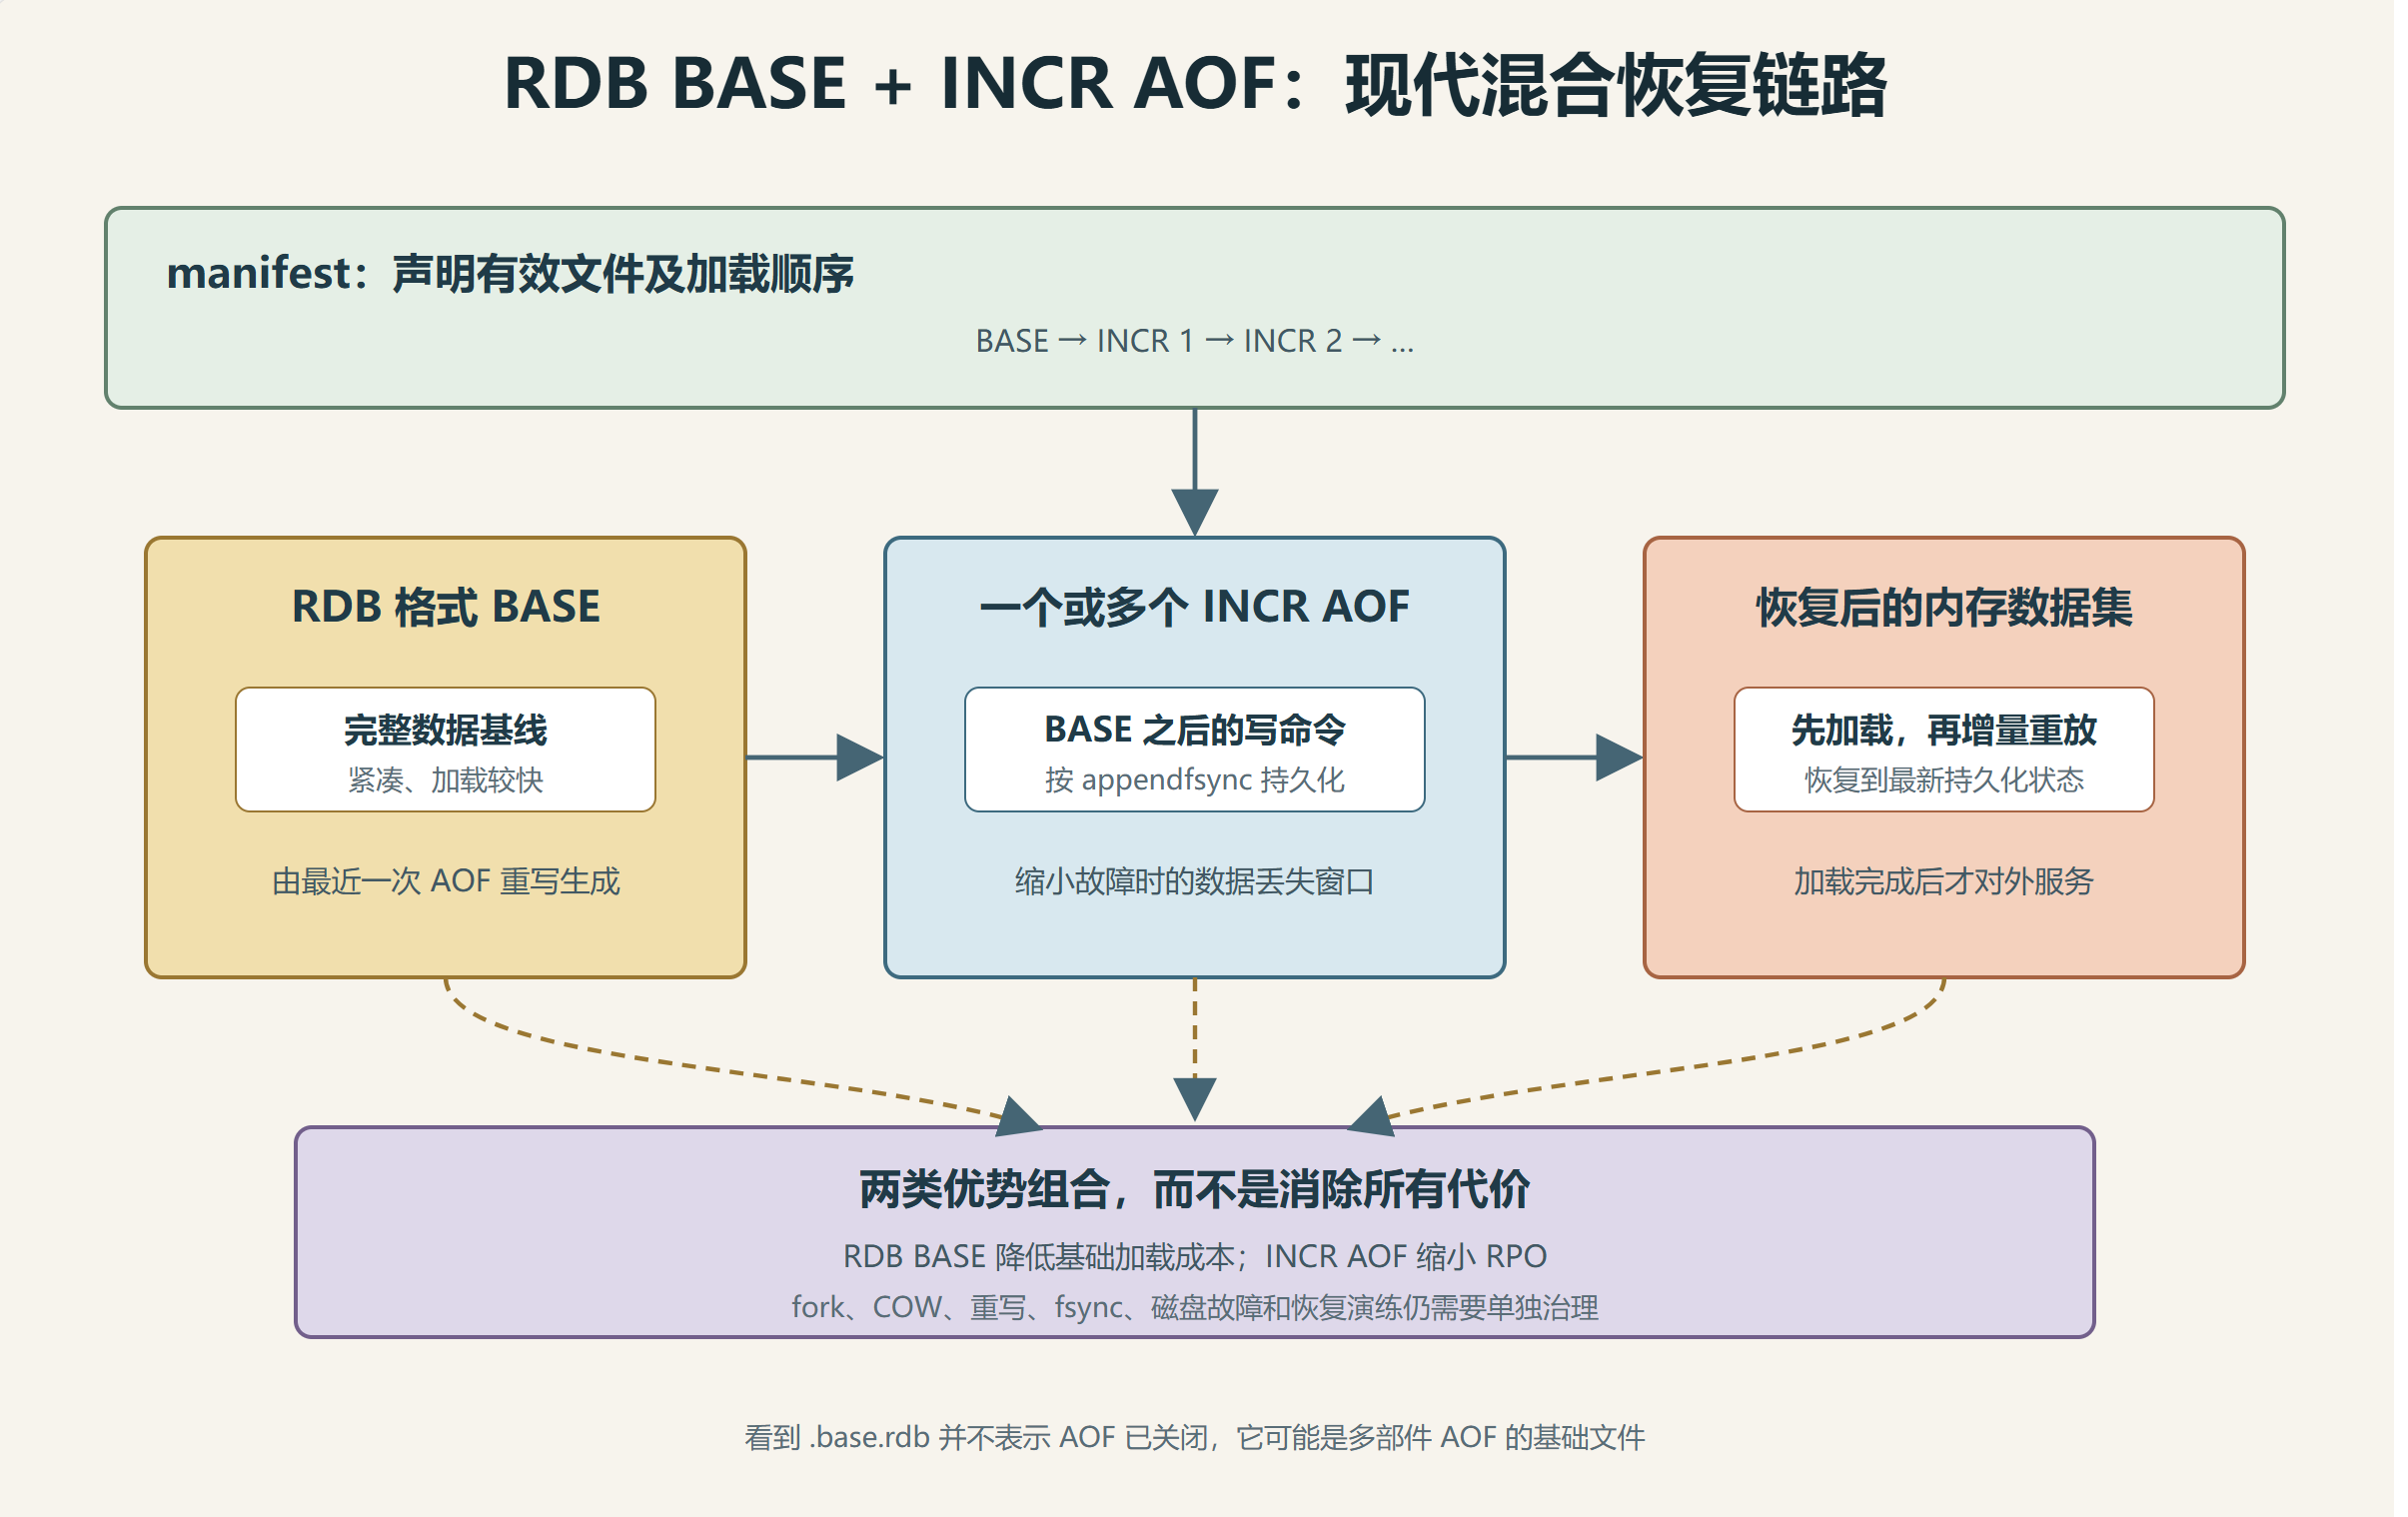
原文所说的"RDB 快照加两次快照之间的 AOF"可以帮助理解,但现代 Redis 的具体实现需要更准确地描述。
1. Redis 4.0 引入 RDB preamble
开启 AOF 并使用:
conf
aof-use-rdb-preamble yesAOF 重写生成的基础部分采用 RDB 二进制格式,后续变化继续使用 AOF 命令记录。它不是简单维护一个独立周期性 dump.rdb,然后每次快照后随意清空 AOF。
2. Redis 7+ 使用多部件 AOF
现代 Redis 把混合持久化组织为:
- 一个 RDB 格式的 BASE 文件,表示重写时的数据集。
- 一个或多个 INCR AOF 文件,记录 BASE 之后的变化。
- 一个 manifest 文件,声明有效文件和加载顺序。
恢复时先加载 BASE,再顺序加载 INCR。这样可以同时获得:
- RDB 基础数据加载速度快、文件紧凑的优势。
- AOF 能把数据丢失窗口缩小到
appendfsync策略边界的优势。
3. 单独 RDB 与混合持久化不是同一目标
| 方案 | 主要目标 | 常见数据丢失窗口 | 恢复特点 |
|---|---|---|---|
| 仅 RDB | 低运行开销、周期备份、快速基线恢复 | 两次成功快照之间 | 直接加载完整快照 |
| AOF 持久化 | 更小 RPO | 取决于 appendfsync |
加载 BASE,并重放后续 INCR;BASE 可采用 RDB 格式 |
| RDB BASE + INCR AOF | 兼顾恢复速度与较小 RPO | 取决于 appendfsync |
先加载 BASE,再应用增量 |
十、RDB 对运行中实例有哪些风险
1. 内存不足与 OOM
假设一台机器只有 4 GB 内存,Redis 数据集约 2 GB,而且写请求占 80%。执行 BGSAVE 时,大量页面可能发生 COW。
此时实际内存需求不只是"2 GB 数据集 + 一个很小的子进程",还包括:
- Redis 进程自身的内存碎片和管理开销。
- 客户端缓冲区、复制积压缓冲区等额外内存。
- 子进程页表。
- 快照期间被修改页面产生的 COW 内存。
在 4 GB 机器上,内存余量可能很快耗尽,导致交换、延迟恶化、子进程失败,甚至触发 OOM Killer。这正是高写入、小内存余量场景只用 RDB 时的核心风险。
2. 磁盘空间不足
保存期间需要同时容纳旧 RDB 和临时新 RDB,还可能存在 AOF 与其他持久化文件。容量规划不能只按一个 dump.rdb 的大小计算。
3. 保存失败后停止写入
常见默认配置:
conf
stop-writes-on-bgsave-error yes当 RDB 快照已启用且最近一次后台保存失败时,Redis 会拒绝新的数据修改命令,让故障尽快暴露,而不是继续运行并悄悄失去持久化能力。
关闭它可以提高可用性,但意味着必须有可靠监控、告警和其他数据保护手段。否则实例可能长时间没有有效的新快照。
4. 共享资源竞争
子进程会消耗 CPU、内存带宽和磁盘 I/O。即使主线程没有直接生成 RDB,业务尾延迟也可能因资源竞争升高。
十一、如何确认 RDB 真的可用
1. 检查实际配置
text
CONFIG GET save
CONFIG GET dbfilename
CONFIG GET dir
CONFIG GET stop-writes-on-bgsave-error
CONFIG GET rdbcompression
CONFIG GET rdbchecksum
2. 检查保存状态
text
INFO persistence重点关注:
rdb_bgsave_in_progress:是否正在执行后台保存。rdb_changes_since_last_save:上次成功保存后发生的变更数量。rdb_last_save_time:最近一次成功保存的时间戳。rdb_last_bgsave_status:上次后台保存是否成功。rdb_last_bgsave_time_sec:上次保存耗时。rdb_current_bgsave_time_sec:当前保存已运行多久。rdb_last_cow_size:上次 RDB 保存产生的 COW 内存量。current_cow_size、current_cow_peak:当前子进程的 COW 使用情况。current_fork_perc:当前保存任务处理 Key 的进度百分比。
LASTSAVE 可以返回最近一次成功保存的 Unix 时间戳,但不能单独说明文件已经被异机备份,也不能证明恢复一定成功。
3. 检查延迟与系统资源
- 使用
LATENCY LATEST、LATENCY DOCTOR观察fork等事件。 - 监控
used_memory_rss、mem_fragmentation_ratio、交换和缺页。 - 监控磁盘吞吐、队列深度、空间和 RDB 写入时长。
- 检查宿主机 CPU steal、NUMA 放置与透明大页配置。
4. 校验与恢复演练
可以对离线副本使用 redis-check-rdb 检查 RDB 格式。真正的验证方式是定期在隔离环境启动兼容版本的 Redis,加载备份并检查关键数据。
只有"文件存在"而没有恢复演练,不能证明备份可用。
十二、RDB 上线检查清单与答案
1. BGSAVE 是否完全不会阻塞主线程?
**不会完全避免。**数据写盘由子进程完成,但 fork 本身会暂停主线程,COW 和资源竞争也会影响延迟。
2. 快照期间能否继续修改数据?
**可以。**COW 让子进程保持 fork 时刻的数据视图,父进程可以继续处理新写入。
3. COW 是否只复制被修改的 Key?
**不是。**复制粒度是内存页。修改一个很小的 Value,也可能复制整个页面。
4. RDB 是否能保证宕机前的数据全部恢复?
**不能。**单独使用 RDB 时,最近一次成功快照之后的变更可能丢失。
5. rdb-save-incremental-fsync 是否表示增量快照?
**不是。**它只是让完整 RDB 分段同步到磁盘,用于平滑 I/O 延迟。
6. 快照越频繁是否一定越好?
**不是。**更短间隔能缩小 RPO,却会增加 fork、全量磁盘写入和 COW 开销。频率必须与一次快照的真实耗时和机器余量匹配。
7. Redis 7+ 的混合持久化是否只是一个 RDB 加一个无限增长的 AOF?
**不是。**它使用 manifest 管理 RDB 格式 BASE 和一个或多个 INCR AOF,并在重写后切换到新的文件集合。
8. 有 dump.rdb 是否就不需要备份?
**不是。**本机磁盘故障、误操作和整个故障域丢失都可能让本地 RDB 失效。需要把完成后的 RDB 复制到独立存储,并执行校验和恢复演练。
9. 2 核、4 GB 内存、2 GB 数据集且写入占 80%,只用 RDB 有什么风险?
**主要风险是内存和延迟余量不足。**高写入会在 BGSAVE 期间复制大量内存页,COW 可能让 RSS 快速增长;同时,2 核 CPU 上父子进程竞争 CPU,大 RDB 还会占用磁盘带宽。结果可能是尾延迟升高、交换、保存失败或 OOM。
十三、核心结论
RDB 快照的完整工作逻辑是:
BGSAVE通过fork创建子进程。- 父子进程先共享内存页。
- 子进程读取
fork时刻的数据视图并生成临时 RDB。 - 父进程继续处理请求,写入共享页时触发 COW。
- 新 RDB 写入和同步成功后,通过原子重命名替换旧文件。
- Redis 重启时直接加载快照,快速建立内存数据集。
RDB 优化的是恢复速度和备份便利性,AOF 优化的是数据丢失窗口。现代 Redis 通过 RDB 格式 BASE 与增量 AOF 组合两者,但仍需要根据业务的 RPO、RTO、机器内存、写入比例和磁盘能力完成容量规划。