一、开篇:训练与微调的两条主线
一个好用的大模型要经历两件事:训练阶段 让它学会语言与服从指令,微调与检索让它适配具体场景。理解训练三阶段与 LoRA、RAG 的取舍,是掌握大模型工程的关键。
二、训练三阶段
2.1 预训练
预训练是模型第一阶段,用海量公开文本数据训练。目标:学习通用语言、知识、基础逻辑能力 。模型学会读懂文字、续写文本,掌握大量常识知识。但此时模型只是会续写,听不懂人类指令------你提问它不一定会回答问题,可能自顾自往下续写,不会对齐人的需求。
2.2 SFT 监督微调
拿到预训练好的底座模型,用高质量的「指令-回答」样本去微调。输入是人类指令,输出是人工写好的标准答案。目标:教会模型听懂指令,按照人的要求来输出回答。经过 SFT 之后,模型知道用户提问要给出对应回复,而不是随便续写。局限:只能模仿样本,还分不清什么回答是好、什么是不好,容易输出有害、啰嗦、不符合人类喜好的内容。
2.3 RLHF 人类反馈强化学习
RLHF 分为两步:第一步,训练奖励模型 。同一个问题生成多条模型回答,由人打分排序,训练出一个奖励模型 RM,让模型学会判断哪段回答人类更喜欢、哪些回答不好。第二步,强化学习调优 。用奖励模型的打分作为信号,通过强化学习继续优化 SFT 后的大模型。目标:对齐人类偏好,输出更有用、诚实、安全、符合人的价值观。
重点:RLHF 不是教新知识,是调整输出风格,分辨好坏,规避有害输出。
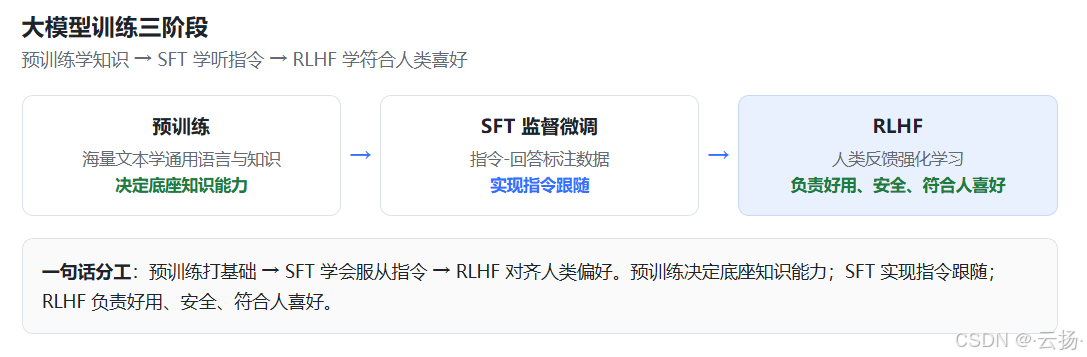
2.4 完整流程总结
预训练打基础 → SFT 学会服从指令 → RLHF 对齐人类偏好。预训练决定底座知识能力;SFT 实现指令跟随;RLHF 负责好用、安全、符合人喜好。
三、LoRA 低秩适配
3.1 什么是微调,什么是 LoRA
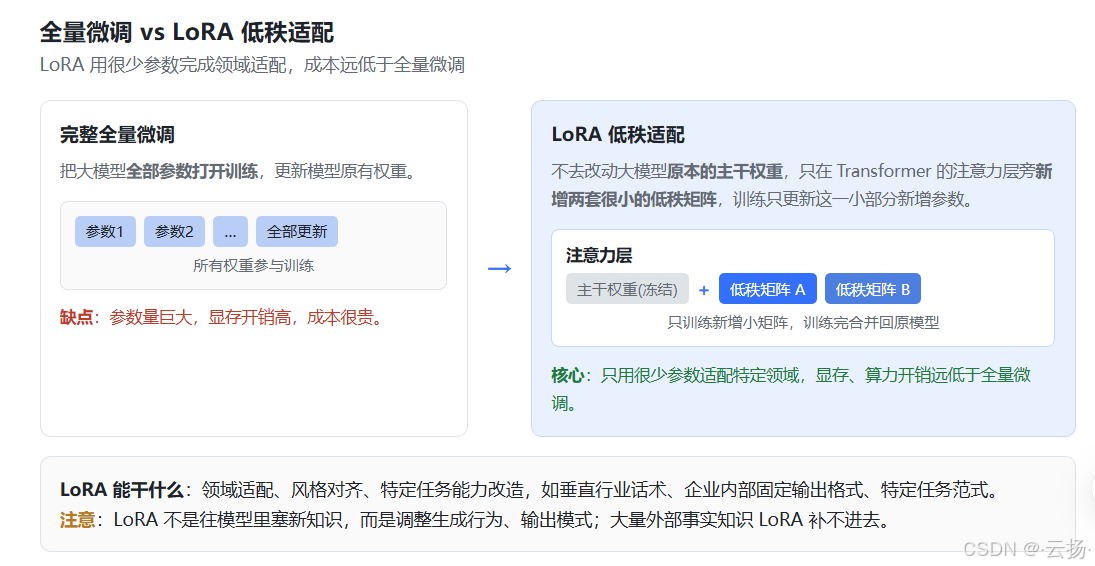
完整全量微调 :把大模型全部参数打开训练,更新模型原有权重。缺点:参数量巨大,显存开销高,成本很贵。
LoRA 低秩适配是一种轻量级微调方案。它不去改动大模型原本的主干权重,只在 Transformer 的注意力层旁新增两套很小的低秩矩阵,训练只更新这一小部分新增参数。训练完成后,可以把小矩阵的权重合并回原模型推理。
核心:只用很少参数,就能让大模型适配特定领域,显存、算力开销远低于全量微调。
3.2 LoRA 能干什么
用来做领域适配、风格对齐、特定任务能力改造。比如垂直行业话术、企业内部固定输出格式、特定任务范式。
注意:LoRA 不是往模型里面塞新知识,它是调整模型的生成行为、输出模式;大量外部事实知识,LoRA 补不进去。
四、关键面试区分:微调(LoRA)还是 RAG
4.1 优先选微调(LoRA)的场景
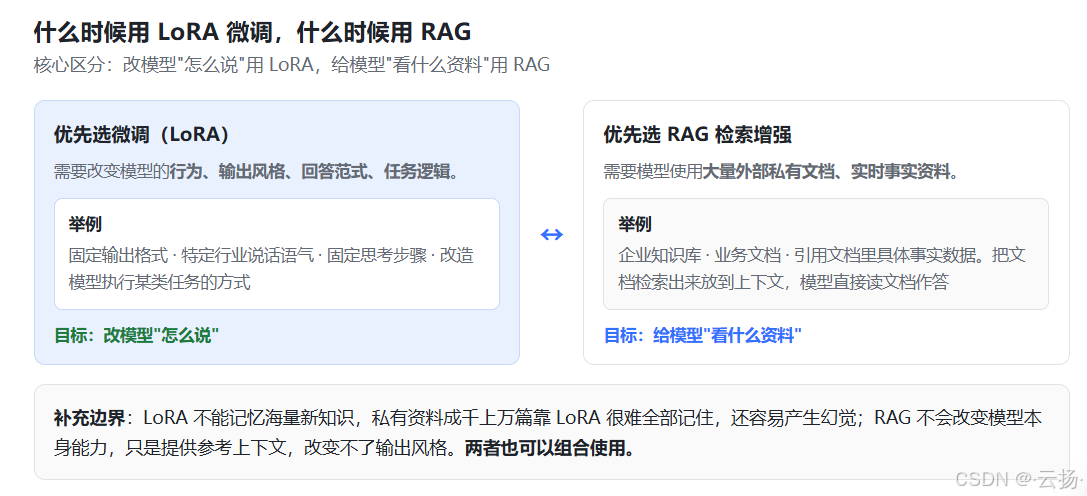
需要改变模型的行为、输出风格、回答范式、任务逻辑。举例:固定输出格式、特定行业说话语气、固定的思考步骤、改造模型执行某类任务的方式。目标:改模型"怎么说"。
4.2 优先选 RAG 检索增强的场景
需要模型使用大量外部私有文档、实时事实资料。比如企业知识库、业务文档,需要模型引用文档里具体事实数据。把文档检索出来放到上下文,模型直接读文档作答。目标:给模型"看什么资料"。
4.3 简单区分与补充边界
-
要改模型的能力、行为、风格 → LoRA 微调;要给模型新增大量事实资料 → RAG。
-
边界:LoRA 不能记忆海量新知识,私有资料成千上万篇靠 LoRA 很难全部记住,还容易产生幻觉;RAG 不会改变模型本身能力,只是提供参考上下文,改变不了输出风格。两者也可以组合使用。
五、总结
大模型主流训练分为预训练、SFT 监督微调、RLHF 人类反馈强化学习 三个阶段。预训练使用海量文本数据训练,让模型学到通用语言能力和各类知识,但此时模型只会续写,不理解指令。SFT 监督微调,使用大量指令-回答的标注数据微调,教会模型听懂指令,按照人的要求给出回答。RLHF 人类反馈强化学习,利用人类对回答的打分,训练奖励模型,再通过强化学习优化模型,让模型懂得什么回答是人类偏好的,提升回答有用性、真实性与安全性,完成对齐。简单概括:预训练学知识,SFT 学听指令,RLHF 学符合人类喜好。
LoRA 低秩适配,是轻量级微调方法。全量微调会更新模型全部参数,成本很高;而 LoRA 不改动大模型主干权重,只训练少量新增的低秩矩阵,用很小参数量完成领域适配,训练成本更低。使用上要区分 LoRA 微调与 RAG:如果希望改变模型的输出行为、回答风格、任务范式,适合用 LoRA 微调;如果需要模型读取大量私有文档、外部事实信息,优先用 RAG。LoRA 改造模型"怎么说";RAG 负责给模型提供外部资料"看什么"。两者也可以搭配使用。