SLOGAN:把"稳定采集"做扎实,把"外围"留给你。
先把定位说清楚,免得有人 clone 下来才发现不是自己想要的。
jDCS (Java Data Collector Service)是一套 Modbus RTU 数据采集框架,技术底座是 Spring Boot 3.5.16 + JDK 17,协议栈用的 digitalpetri 的 modbus-serial。它不是拿来就能跑的成品软件,而是一套骨架:采集内核那部分(连接管理、超时、重试、故障兜底)做扎实,外围那几件事(数据存哪、测点从哪来、日志怎么落)只给接口和默认实现。
开源地址先放这里:
 https://github.com/TommysLee/jDCS
工业现场的采集节点,大多是一台边缘网关,一根 RS485 线,后面挂一串从站。
一、这个项目从哪来
做过工业数采的人,大概率遇到过这么一幕。数据平台上某个车间的数据不刷新了,登录网关一看,进程活得好好的:
bash
$ systemctl status jdcs
● jdcs.service - JDCS - Java Data Collector Service
     Active: active (running) since Wed 2026-08-12 08:31:04 CST; 3h 12min ago
CPU 0%,内存正常,没有异常堆栈,没有 OOM。再看日志,采集记录停在二十多分钟前,后面一片空白。
进程活着,采集停了,Restart=always 一次都没触发。因为在操作系统眼里这个服务运行得好好的。业内把这种故障叫"假死"。
写这个项目之前,我在一台网关前面蹲了两个小时,把这些坑一个个刨出来。后来发现根子不在某段业务代码,而在这类场景本身。三个坑叠在一起:
- 串口不会告诉你对端断了。
TCP 里对端消失会给你 FIN 或 RST,是个明确事件。Modbus RTU 跑在串口上,从站断电或者对端的模拟器被关掉,你什么都收不到。没有异常,没有 EOF。在库看来链路一切正常,只是对端不再回应,于是读操作就静静等在那里。
- 应用层超时穿不透 JNI。
很多人第一反应是加超时。典型写法是这样:
java
Future<?> future = executor.submit(this::readFromSerial);
future.get(5, TimeUnit.SECONDS);
Future.get 超时之后,等待的调用方是返回了,可真正那次读还卡在 JNI 里,卡在 jSerialComm 的 readBytes() 里。future.cancel(true) 只能设置一个中断标志位,这个标志位穿不透 JNI 调用。结果是主线程靠硬超时正常返回,继续处理下一个请求,而那个卡住的线程永远留在那儿。跑得越久泄漏越多,线程池总有耗尽的一天。
- 进程没退出,systemd 也不会管。
systemd 判断要不要重启,依据是进程是否退出。JVM 还活着,采集这件事已经死了,没有任何机制会来救它。
三个坑连起来就是一条很典型的无人值守故障链:
java
对端静默 → 底层读永久阻塞 → JNI 线程泄漏 → 线程耗尽 → 采集停摆
                                          ↑
                                而进程还活着,没人来救
我当时用的 digitalpetri/modbus 的 modbus-serial 模块,库本身质量不错,模块化干净,不会像 modbus-tcp 那样拖进 Netty。翻源码发现它初始化串口时从不调用 setComPortTimeouts(...),而 jSerialComm 的读默认是无限阻塞的。库在应用层有个 requestTimeout,但这个超时只能把 Future 标记失败,打不断底层那次阻塞的 readBytes()。
这个问题我整理成 issue 反馈给了上游,编号 #170,维护者第二天就提了修复 PR #171。但从修复到正式发版有个时间差,在那之前用老版本的人还是得自己在应用层兜住。
也是从那时候起,我改了想法。不做"一个能跑的采集程序",做"一套把稳定采集做扎实的骨架"。
二、jDCS 能提供什么
下面这些是框架已经做好的部分。挑几个和现场关系最大的讲。
2.1 采集链路:批量合并 + 位型隔离
按 (slaveId, functionCode) 分组,同组内地址相邻的测点合并成一次请求,减少总线往返。
这里有个容易被忽略的例外:功能码 01(线圈)和 02(离散输入)不能参与合并。它们和寄存器的数据模型根本不一样:
| 寄存器(FC03/04) | 位型(FC01/02) | |
|---|---|---|
| 每个点占 | 1 个寄存器 = 2 字节 | 1 bit |
| 一个字节装几个点 | 半个 | 8 个 |
| 响应长度 | 点数 × 2 字节 | ⌈点数 / 8⌉ 字节 |
按"寄存器 × 2 字节"的模型去合并位型测点,第二个及之后的测点会按寄存器偏移切片,必然越界。更麻烦的是第一个测点会把整个寄存器当成 BOOL 读,非零即真,静默给出一个错误的状态值。所以 jDCS 里位型功能码每个测点独立成批。
另外,框架对异常做了三层隔离。批次读取失败、切片解析失败、数据出口抛异常,各管各的,任何一层出问题都不会中断整轮采集。
2.2 故障自愈:超时、废弃、重建
这是 jDCS 和多数 Modbus 封装差别最大的地方。
请求超时之后,对应会话(客户端加专用执行器)可能已经处于半死状态。继续用它,只会污染接下来的每一个请求。所以 jDCS 的做法是超时后直接丢弃整个会话,下次读取时重建。
重建还有一个冷却窗口。这点容易漏:如果一轮采集里有 N 个测点都在等重建,没有冷却窗口,一轮之内就能把全部重连机会烧光。加上冷却窗口后,重试频率被约束到 reconnect-interval-ms,调度周期才是真正的重试驱动者。
JNI 卡死这一层,框架直接观察 modbus-io-* 线程数,超过阈值就触发进程主动退出,把烂摊子交给操作系统。
2.3 数据模型:对齐主流工业网关
数据类型对标映翰通等主流工业网关的定义,并做了别名归一化,把各家的方言统一到一套标准名称:
| 映翰通类型 | 标准名 | 位宽 |
|---|---|---|
| BIT | BOOL | 1 寄存器 |
| WORD | UINT16 | 16 |
| INT | INT16 | 16 |
| DWORD | UINT32 | 32 |
| DINT | INT32 | 32 |
| FLOAT | FLOAT32 | 32 |
| DOUBLE | DOUBLE64 | 64 |
| ULONG | UINT64 | 64 |
| LONG | INT64 | 64 |
| STRING | STRING | 自定义 |
INT 这一格值得单独说一句。IEC 61131-3 标准里 INT 就是 16 位,C 和 Java 里 int 是 32 位,同一个名字两套语义。工控领域特别容易在这里翻车,所以框架按 PLC 的约定来。UINT 也一样,对齐成 16 位,跟 INT 保持对称,另外补上了 IEC 的 UDINT、ULINT。
有几个类型框架是明确拒绝的。SINT、USINT、BYTE 都是 8 位,而 Modbus 的最小数据单位是 16 位寄存器,没有 8 位容器装它们。硬塞进 16 位会静默产出错误值,所以宁可直接报错。BCD16 / BCD32 同理。BCD 不是数值类型而是编码格式,每 4 位表示一位十进制数,0x0012 当 INT16 读出来是 18 而不是 12,必须专门解码。配置期遇到这两个类型会直接抛 Unsupported data type,不会悄悄给你一个错值。
字节序覆盖 ABCD / CDAB / BADC / DCBA 四种,也认 Swapped、Big_Endian 这类工业别名,映翰通界面上的 Swapped 可以直接填进去。解析规则是固定的:先做寄存器级成对交换,再做寄存器内部字节交换,奇数个寄存器时最后一个落单保留。七个寄存器的话,前三对两两互换,第七个不动。
还有一个容易配错的点:线圈和离散输入测点必须配 BOOL。位打包的数据如果当成 UINT16 解析,在 BADC / DCBA 字节序下会做寄存器内字节交换,一个线圈状态从 1 变成 256。BOOL 判的是"非零即真",跟字节序无关,四种字节序下都正确。
2.4 工程性:依赖少、好扩展、有得看
依赖很克制。协议栈只引入 modbus-serial 一个第三方库,其余就是 spring-boot-starter-web、Lombok 和配置元数据处理器。对一个跑在边缘设备上的服务,少一个传递依赖就少一份体积和风险。关键是它不拖 Netty,modbus-serial 的传递依赖只有 jSerialComm。
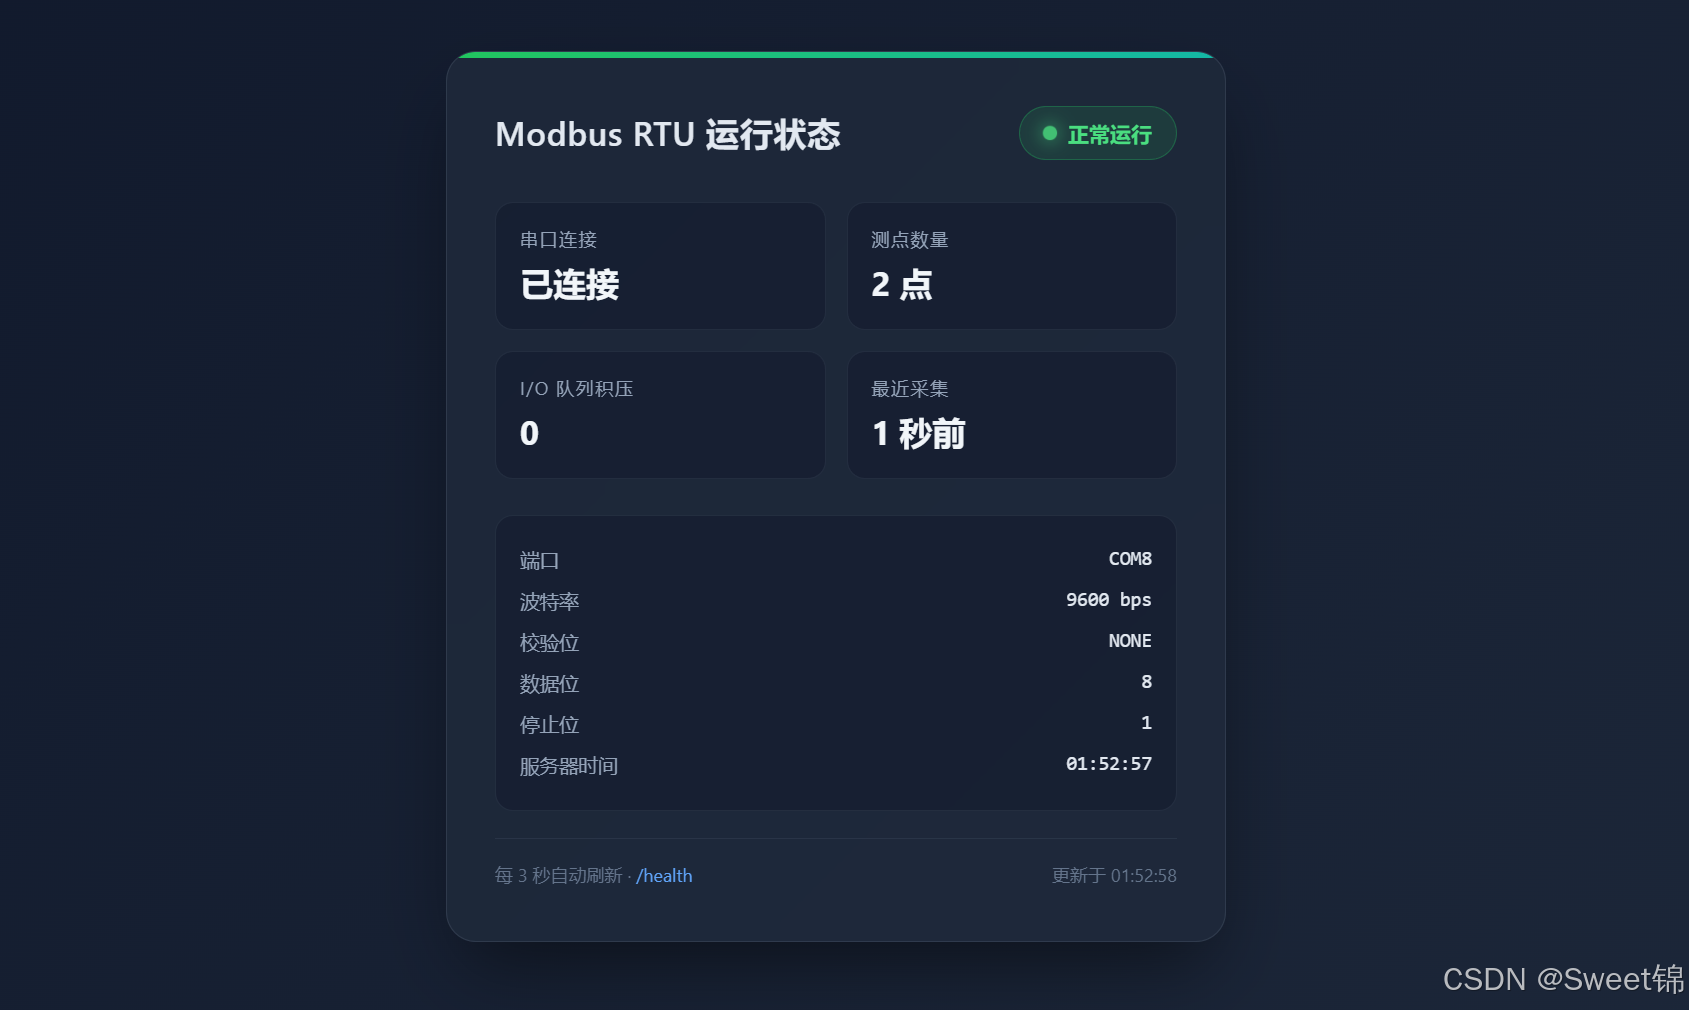
框架自带一个状态页和健康接口。启动后打开 http://localhost:8080/,串口连接、测点数量、I/O 队列积压、最近采集时刻都在上面,每 3 秒刷新一次。单文件静态页,零依赖零构建。
GET /health 返回 JSON,可以直接对接 Prometheus、K8s 的 liveness probe,或者自己写个管理台。
框架和裸用底层库的区别,大致是这样:
| 直接用 modbus-serial | jDCS | |
|---|---|---|
| 连接生命周期 | 自己管 | 自动重连 + 冷却窗口 |
| 超时 | 只有应用层 Future 超时 | 硬超时 + 会话废弃 |
| JNI 卡死 | 无感知 | 线程数监测 + 主动退出 |
| 调度停摆 | 无感知 | 独立看门狗 |
| 位型功能码 | 容易踩错位 | 已隔离 |
| 数据类型 | 自己解析 | 10 种类型 + 4 种字节序 |
| 状态观测 | 无 | 状态页 + /health |
三、技术栈与选型
| 组件 | 版本 | 用途 |
|---|---|---|
| Spring Boot | 3.5.16 | 应用框架、调度、配置绑定 |
| digitalpetri/modbus-serial | 2.1.6 | Modbus RTU 协议栈(核心) |
| jSerialComm | 2.11.0 | 底层串口 I/O(传递依赖) |
| Lombok | 最新 | 样板代码简化 |
Java 生态里的 Modbus 库屈指可数。选 digitalpetri/modbus-serial 的原因有三个:
- 一是模块化 。
modbus-serial只依赖 jSerialComm,不会传递引入 Netty 这种重型依赖(那是modbus-tcp才有的)。跑在边缘设备上,这一点很关键。 - 二是维护活跃,版本迭代频繁,issue 响应快。我自己提交的那个 issue 就是第二天收到修复 PR 的。
- 三是关键缺陷已经修掉 。历史上那个超时内存泄漏(Issue #124)在 v2.1.2 修复了,当前 2.1.6 稳定可用。
需要提前说明的边界:jSerialComm 的读写默认无限阻塞,写超时只在 Windows 生效。这两条是这个技术栈的固有前提,jDCS 的分层兜底就是围绕它们设计的。
四、几个不显眼但很要命的设计细节
这部分是我在实现和调试过程中真正花过时间的地方。功能列表谁都能列,坑踩没踩过是另一回事。
4.1 全角空格:从 trim 换到 strip
数据类型、字节序这些字段是字符串,从 yml 读进来难免带空白,常规做法是用 String.trim() 裁掉。问题在于 trim() 只裁码点小于等于 U+0020 的字符,全角空格 U+3000 不在这个范围里。
中文输入法下面,FLOAT32 后面跟一个全角空格,肉眼完全看不出来。用 trim() 处理,空格留着,配置校验报出来的错误信息是这样:
java
Unsupported data type: FLOAT32 末尾多了一个看不见的字符。你盯着 FLOAT32 这几个字母反复看,怎么看都是对的。我第一次遇到这个问题,还以为是编码问题,查了半天编码配置。
后来统一改成 String.strip()。它按 Character.isWhitespace 判断,全角空格、EN QUAD、行分隔符这些 Unicode 空白都能认出来。为了确认这个改动真的有用,我做了个反证:把 strip() 换回 trim(),同一套探针跑,四个用了全角空格的用例全部失败;换回来全部通过。
这个坑和字节序、超时都不一样,它不产生错值,它只是让你找不到为什么配置读不进来。
4.2 补齐奇数字节:源头单点,而非过程多点
前面提过,Modbus 有个硬约束,1 寄存器等于 2 字节。解析器依赖这个前提,字节数组长度必须是偶数,否则直接抛 Byte array length must be even。
位型功能码是例外。读 1 个线圈,设备按位打包,只返回 1 个字节,长度是奇数。
怎么处理这个矛盾,有两种思路。
一种是解析器内部加判断:识别到 BOOL 就允许单字节,识别到其他类型就要求偶数。这是过程多点补丁,改起来解析器里到处是 if,漏一处就有线上风险。
jDCS 走的是另一条路。在采集层源头 ,ModbusRtuMaster.doRead() 的返回值统一过一遍 padToEven(),奇数长度高位补 0:
java
设备响应 → doRead() → padToEven() → 上层
                        ↑ 唯一调用点
补零之后位型数据也变成 2 字节,解析器拿到的输入永远是合法的。
这背后有个原则 :解析器是契约的执行者,它的入参就该是偶数长度;采集层是数据的入口,把数据对齐到契约是它的责任。源头一处修复,优于过程处处打补丁。顺带说,padToEven 对寄存器数据是完全透明的,长度本来就是偶数,函数直接返回原引用,不分配新数组。
我实测过它对字节序有没有影响,结论是没有。寄存器数据根本不会被改动;位型数据补零后,BOOL 判的是"非零即真",字节怎么换都不改变"有没有非零字节"这件事。四种字节序乘 256 个取值,一共 1024 例,全部正确。补零方向也有讲究,必须补在高位,[0x01] 要变成 [0x00, 0x01],数值才是 1;补在末尾就成 256 了。
4.3 大整数不丢精度:未缩放时保留原始类型
value 字段的类型契约是这样:没配缩放偏移的时候,保留原始类型,不做统一转换。INT16 给 Short,UINT16 给 Integer,UINT32 给 Long,INT64 给 Long,UINT64 给 BigInteger,FLOAT32 给 Float。
为什么不统一成 double 省事?因为会丢精度。举个例子,9007199254740993,也就是 2 的 53 次方加一。这个数转成 double 会变成 9007199254740992,末位没了。累积电量、高精度计数器这类测点,差一个数就是一笔账对不上。
需要统一按 double 取值的时候,用 ((Number) point.getValue()).doubleValue(),或者直接调 parseScaled。
配套的还有一条:解析失败时,rawValue 和 value 都置为 null。这样消费方没有判 success 就落库,落进去的也是明确的空值,不会把一段无法解析的字节流当成有效原始数据存下来。
4.4 该拒绝的就拒绝
框架在几个地方选择了"直接报错"而不是"尽力兼容"。
8 位类型(SINT / USINT / BYTE)拒绝,原因上面说了。BCD 拒绝,理由也一样。配置里出现非有限值的缩放(scale 是 NaN 或 Infinity)也拒绝,启动期就报。
这些拒绝是有意识的设计。工业现场最怕的不是报错,是静默给错值。一个错值流到数据平台,可能几周后才被发现,那时候已经没法追了。配置期严一点,运行期才能松。
至于功能码和数据类型搭不搭配,框架反而不校验。比如功能码 01 配了 FLOAT32,validate() 不会拦。原因是 ModbusPoint 这个实体同时给读测点和写测点用,写测点不需要数据类型,硬把两者绑一起会误拒合法的写配置。这个取舍写在文档的已知边界里了。
五、五层防御:鲁棒性从哪来
这是理解 jDCS 最重要的一章。它的鲁棒性不是靠"堆保险",而是分层,每层应对不同种类的故障,缺一层就留一个Bug。
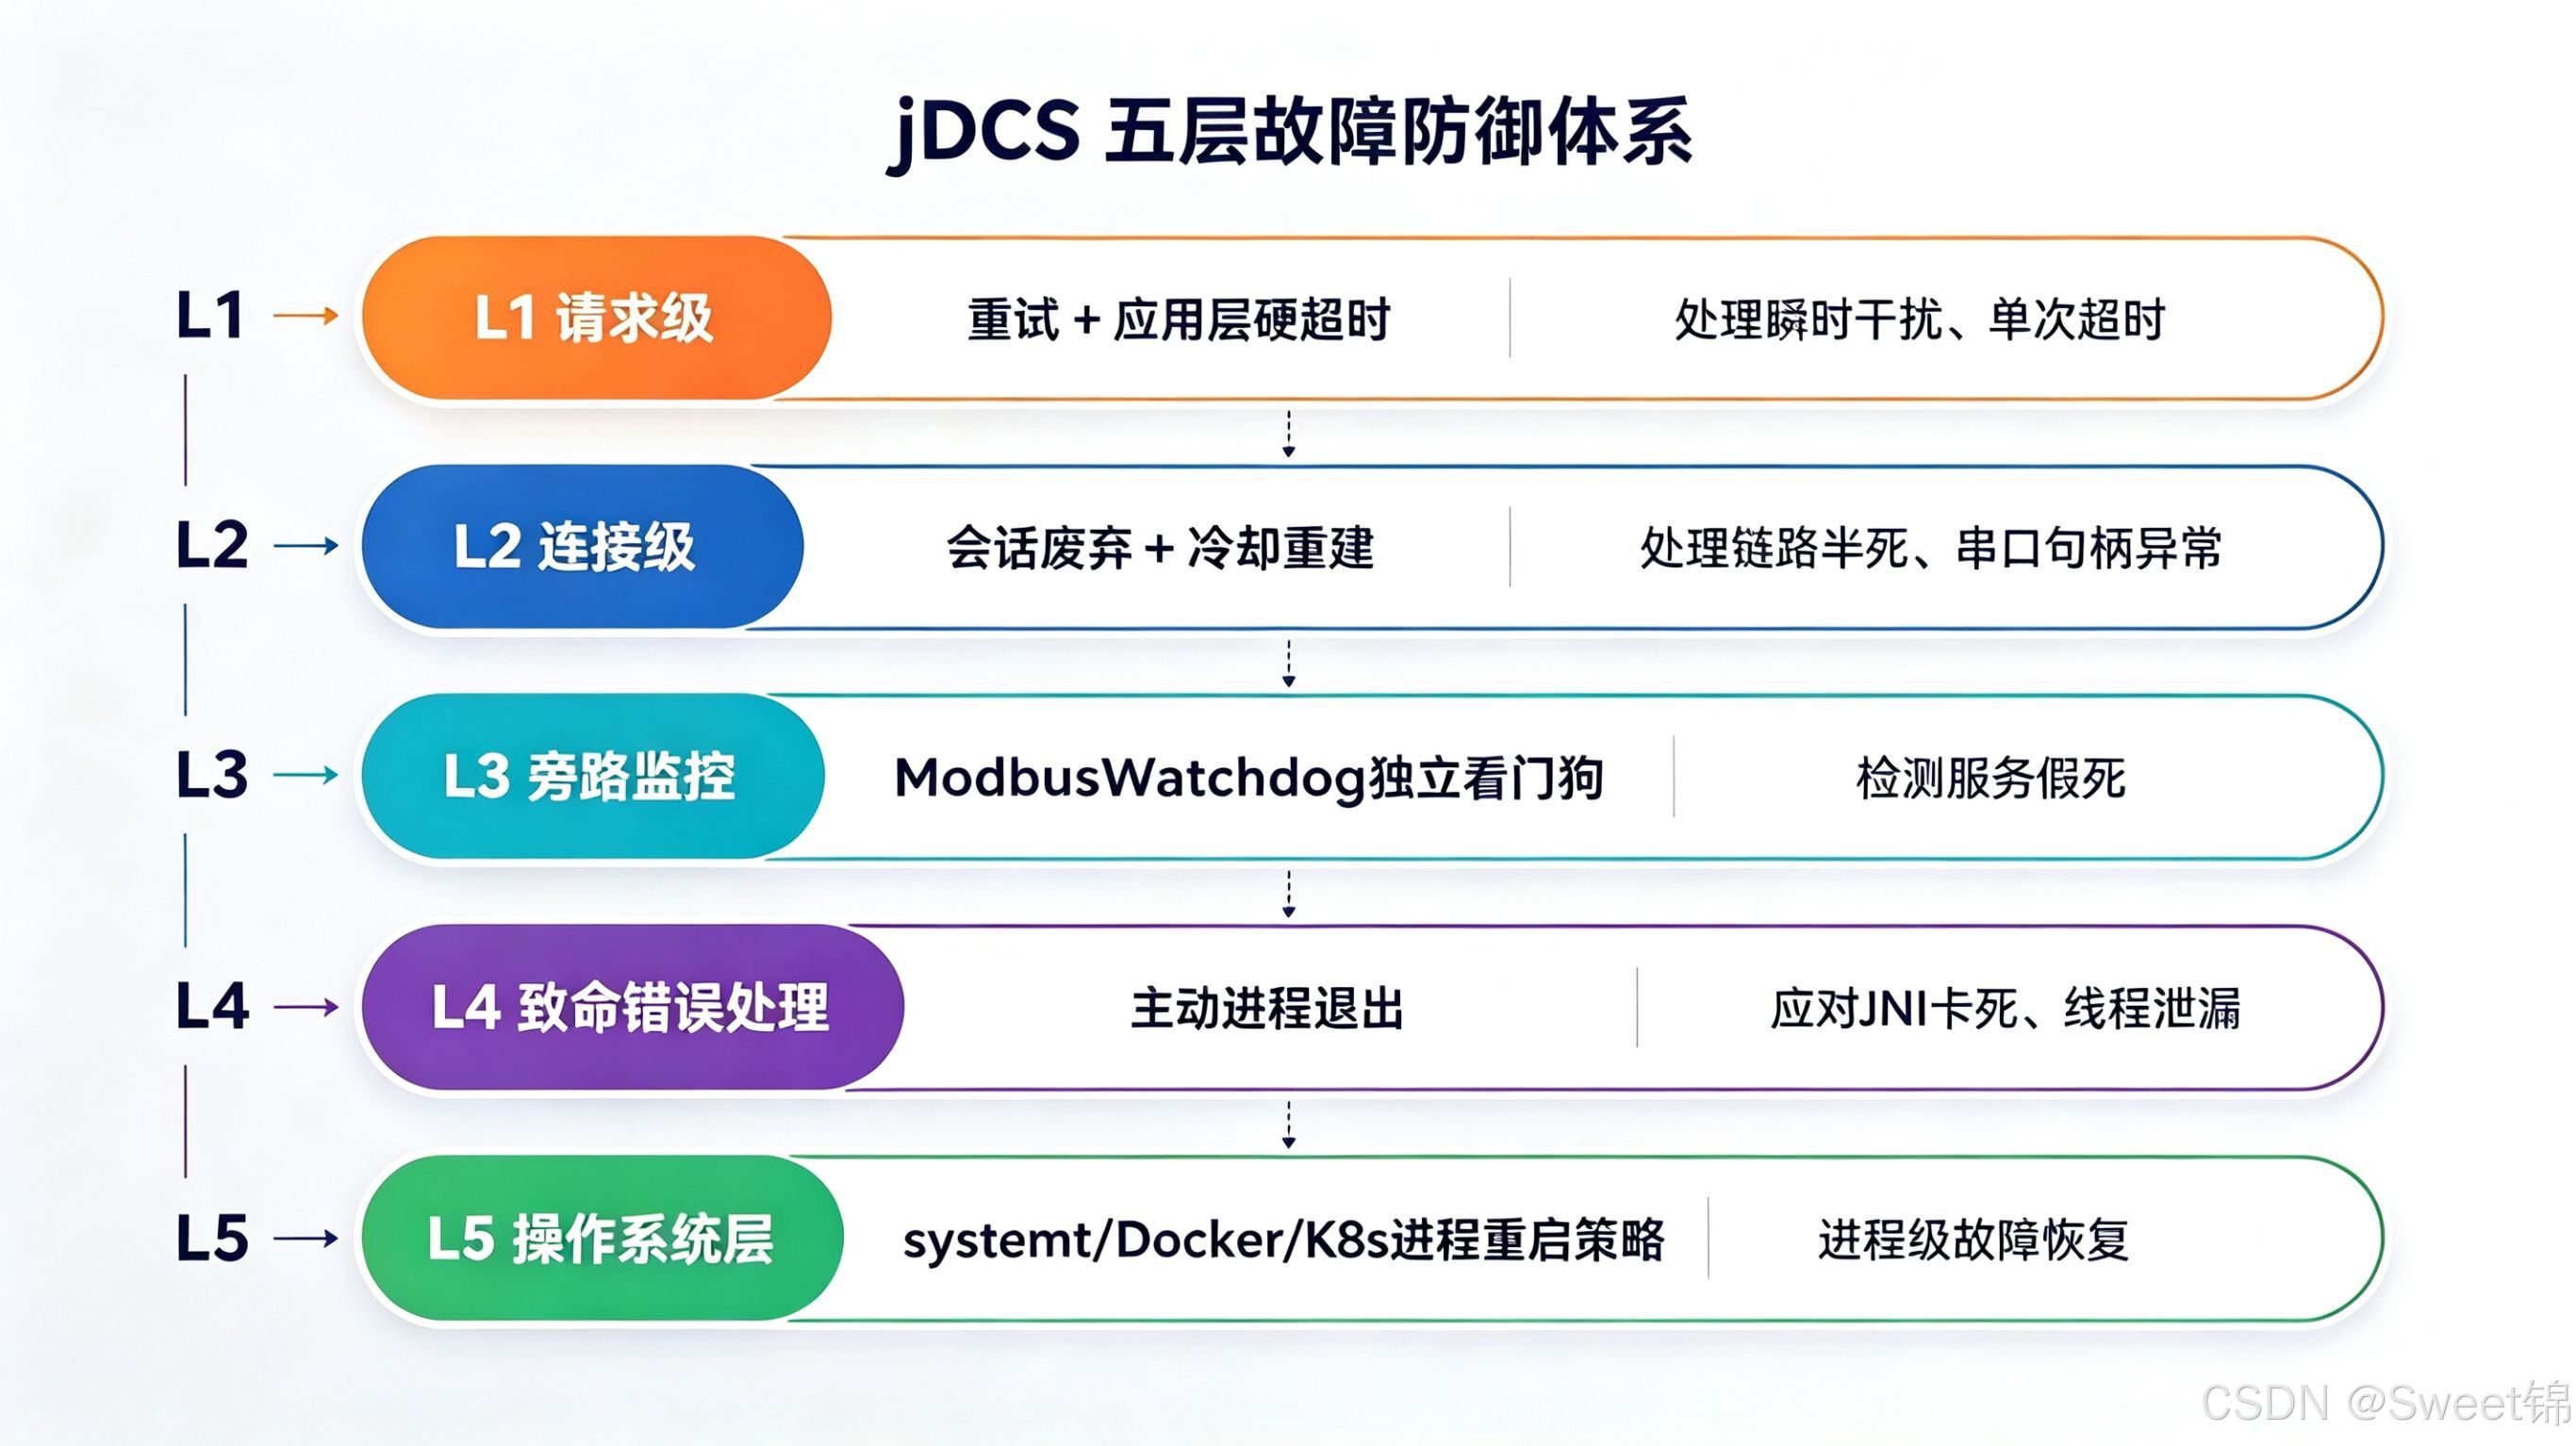
L1 请求级。 每次请求两道保护:协议类异常自动重试,最多 read-retry-count 次;应用层硬超时,operation-timeout-ms 到点即返回。
这里有个容易忽略的区分:协议异常(从站返回错误码)不重试。它反映的是从站自身的问题,重试只是白白占用总线。
L2 连接级。 前面讲的会话废弃加冷却重建。
L3 监控级。 旁路看门狗。
L1 和 L2 覆盖的是"请求失败"。还有种情况连失败都没有,比如 @Scheduled 因为线程耗尽不再触发,或者 I/O 线程消费不动请求、队列持续积压。这时候采集链路看起来很正常,只是什么都不干了。看门狗跑在独立线程上,采集线程卡死的时候它照样能发现问题。
这里补一条实践中的真实经验。队列停滞检测的效力其实有限。因为采集是同步单任务提交,提交后最多等一个 operation-timeout-ms 就换新会话,队列很难长时间持续非空。真正兜住 JNI 卡死的是泄漏线程计数(直接看 modbus-io-* 线程数)和累计硬超时计数。别因为有个队列检测,就低估了泄漏线程检测。
L4 进程级。 主动退出。
错误已经没法在 JVM 内恢复时(JNI 卡死、连续重连失败、线程泄漏超阈值),框架主动退出,把恢复交给操作系统。
这里有个反直觉的选择,用 Runtime.halt() 而不是 System.exit()。因为 System.exit() 会触发 shutdown hook,走到 @PreDestroy,调用 client.disconnect()。而致命错误场景下,disconnect() 很可能正是卡住的源头,你调用它,JVM 就永远退不出去。Runtime.halt() 直接终止 JVM,行为等价于 kill -9。
L5 系统级。 systemd。
前四层都在 JVM 内部。如果 L4 也没机会执行,比如 JNI 把整个 JVM 挂死,或者 OOM 的最后阶段,唯一能恢复的只剩进程管理器。
jdcs.service 里相关的配置是:
bash
[Unit]
Description=JDCS - Java Data Collector Service
After=network.target

# 无限重启:禁用 systemd 启动速率限制。
# systemd 默认限制为「10 秒内最多启动 5 次」,超限后放弃重启并把服务标记为 failed;
# StartLimitIntervalSec=0 表示完全不限速,服务崩溃后由 systemd 无限次自动拉起,适配长期无人值守。
# 主动停止:systemctl stop jdcs ------ 手动停止后不会被自动拉起,需 systemctl start 方可恢复。
StartLimitIntervalSec=0

[Service]
Type=simple
User=jdcs
Group=dialout
WorkingDirectory=/opt/jdcs

ExecStart=/usr/bin/java \
  -Xms256m -Xmx512m \
  -XX:+HeapDumpOnOutOfMemoryError \
  -XX:HeapDumpPath=/opt/jdcs/dumps \
  -XX:+ExitOnOutOfMemoryError \
  -Duser.timezone=Asia/Shanghai \
  -jar /opt/jdcs/jdcs.jar

# Restart=always:进程以任何原因退出(崩溃 / Runtime.halt / OOM)均重新拉起。
# RestartSec=10:两次重启之间的等待时间,用于避免崩溃时高频空转;它不是重启次数上限。
Restart=always
RestartSec=10

StandardOutput=append:/var/log/jdcs/stdout.log
StandardError=append:/var/log/jdcs/stderr.log

[Install]
WantedBy=multi-user.target
任何原因的退出都会在 10 秒后被拉起,而且不设次数上限。systemd 默认有个启动速率限制(10 秒内最多 5 次),超了就放弃重启并把服务标成 failed。对无人值守的现场,这个默认值不合适,所以显式关掉。
RestartSec=10 不限制次数,它是两次重启之间的等待,避免配置写错时每秒空转几百次、把 CPU 和日志打爆。
需要主动停下就 systemctl stop。手动停止不会触发自动拉起,这是 systemd 的既定行为。
六、十分钟快速上手
环境要求:
- Zulu JDK 17 或更高(硬性)
- Maven 3.8+,
- 串口用真实设备或 Mthings之类的模拟器都行。
JDK 17 不是建议是前提。底层 modbus-serial v2.x 要求 JDK 17+,项目自己也用了 Record、Switch 表达式、String.strip() 这些语言特性,JDK 8 / 11 编译都过不去。
三步就能跑起来。
第一步,配串口 ,编辑 application-modbus.yml:
javascript
modbus:
  serial-port: /dev/ttyUSB0      # Windows: COM8;Linux: /dev/ttyUSB0
  baud-rate: 9600
  parity: NONE
  data-bits: 8
  stop-bits: 1

  # 关键:operation-timeout-ms 必须 > response-timeout-ms
  response-timeout-ms: 2000
  operation-timeout-ms: 5000

  # 采集轮询周期,默认 2000ms
  collection-interval-ms: 2000
第二步,配测点 ,编辑 application-modbus-points.yml:
javascript
modbus:
  points:
    - point-id: temperature_hall
      point-name: 大厅温度
      slave-id: 1
      function-code: 3
      address: 1
      data-type: UINT16
      byte-order: ABCD
      scale: 0.1
unit: "℃"测点是配置文件驱动的。这么设计是为了简化,适合中小型采集系统。大型项目测点动辄上千,配置文件就不好维护了,可以换成数据库驱动。框架对"测点从哪来"不做任何假设 ,只要能拿到一个 ModbusPoint 列表,采集链路原样可用。这也是留给大家扩展的地方。
register-count 这一项,数值类型不用手填。寄存器数量由 dataType 唯一确定,UINT32 就是两个寄存器,DOUBLE64 就是四个,框架启动时会自动对齐。只有 STRING 必须显式指定长度,因为类型本身不含长度信息。
第三步,打包运行:
bash
mvn clean package
java -jar target/jdcs-1.0.0.jar
打开 http://localhost:8080/ 就能看到状态页。
两个参数依赖,别设错
框架有两处参数依赖,代码里不做运行期强制校验。设错不会启动报错,而是运行期以误判或频繁重启的形式暴露出来。
operation-timeout-ms必须大于response-timeout-ms。设反了,正常的慢响应会被当成卡死,触发会话废弃和硬超时计数,累计到阈值进程就退出了。watchdog-idle-threshold-ms必须大于一轮采集的最坏耗时。一轮最坏耗时大概是批次数 × 重试次数 ×(响应超时 + 重试间隔)。设小了,设备大面积离线时慢轮次会被误判成调度停摆,进程重启;重启后设备还是离线,就变成周期性重启。
这两条依赖和常见误配的速查,写在架构文档 Architecture_API.md的配置手册里。
七、三个扩展点
jDCS 的定位是骨架,所以有几样东西明确留给开发者。
数据出口是存数据库、发 MQTT、推 Kafka,还是上报 HTTP,你自己定。测点来源默认走配置文件,要换成数据库驱动也是个明确的扩展点。日志内核只给控制台输出,落盘和轮转交给你的日志规范。
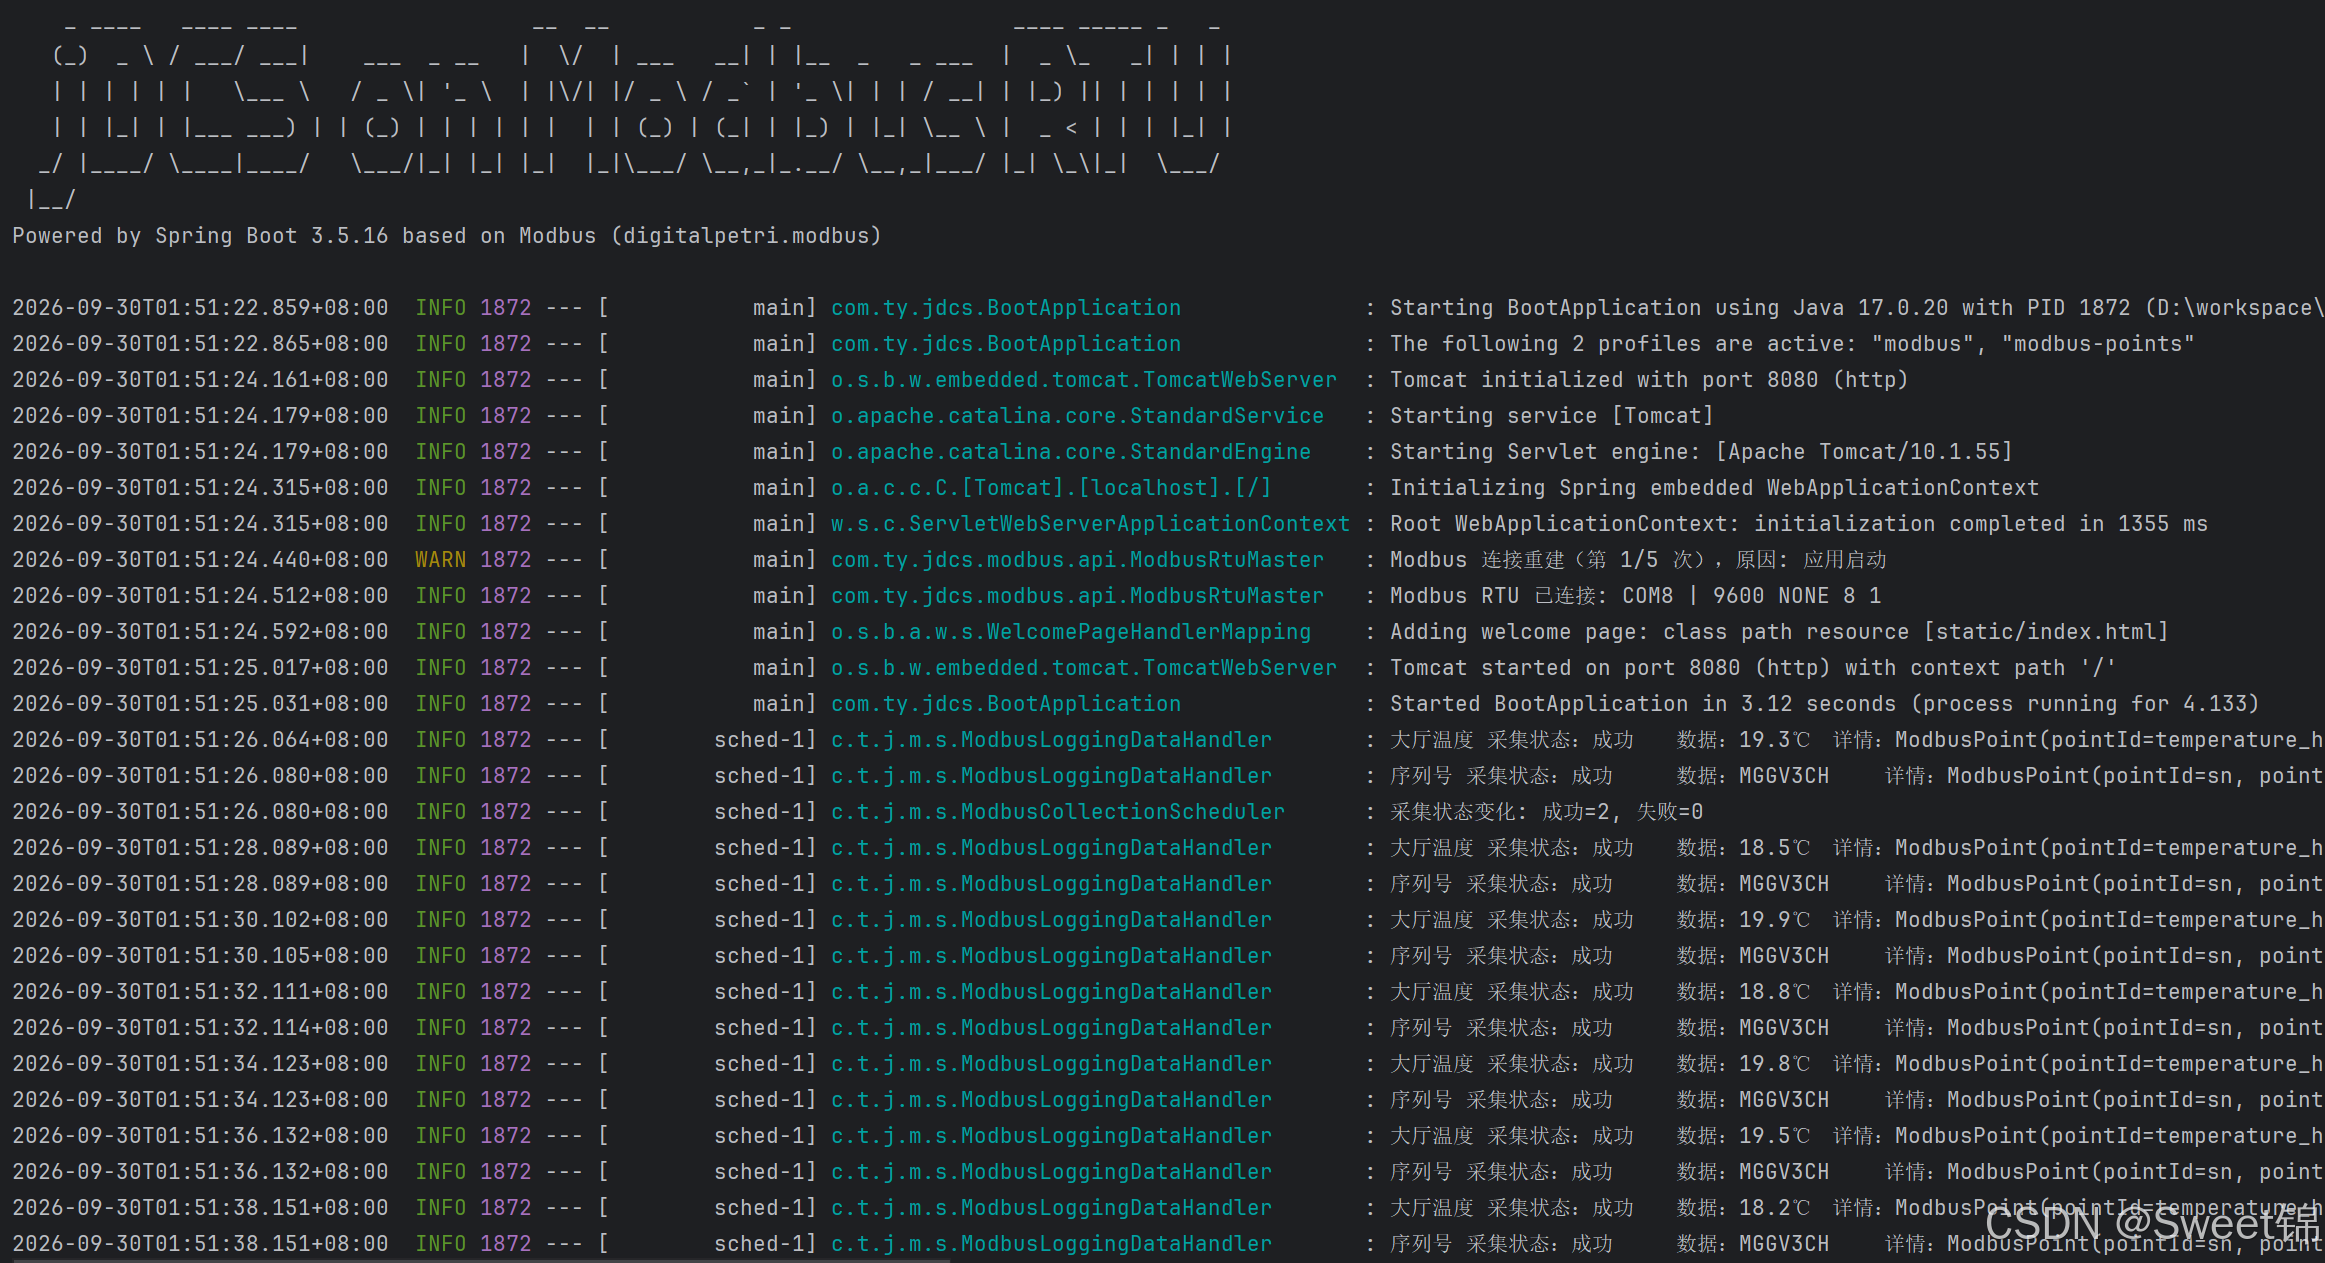
默认实现是逐点记录工程值:
接自己的数据出口只要实现一个接口:
java
public interface ModbusDataHandler {
    /**
     * 框架保证:本方法抛出的任何异常都会被捕获并记录,
     * 不会影响采集链路。
     */
    void handle(ModbusPoint point);
}框架在这里给了个很实用的保证:handle 抛出的任何异常都会被捕获记录,不影响 Modbus 采集链路。
也就是说,你的 MQTT 抖动、数据库超时、HTTP 502,都不会让 Modbus 设备被误判为故障。采集和消费是解耦的。
接 MQTT 大概长这样:
java
@Component
public class MqttDataHandler implements ModbusDataHandler {

    private final MqttClient mqttClient;

    public MqttDataHandler(MqttClient mqttClient) {
        this.mqttClient = mqttClient;
    }

    @Override
    public void handle(ModbusPoint point) {
        if (!Boolean.TRUE.equals(point.getSuccess())) {
            return;    // 失败测点不发布
        }
        String topic = "factory/" + point.getPointId();
        String payload = String.format("{\"value\":%s,\"unit\":\"%s\",\"ts\":%d}",
                point.getValue(), point.getUnit(), point.getTimestamp());
        mqttClient.publish(topic, payload.getBytes());
    }
}
八、部署到生产
项目自带一键部署脚本和 systemd 服务单元。
bash
# 构建
mvn clean package

# 部署(需要 root,脚本在仓库根目录)
sudo bash install.sh

# 验证
systemctl status jdcs
curl http://localhost:8080/health
脚本会创建专用用户 jdcs 并加入 dialout 组,建目录授权,复制 jar,注册服务,启用自启动。
服务单元里内置了几个 JVM 参数:
bash
-Xms256m -Xmx512m                   # 采集框架内存占用很低,512MB 够
-XX:+HeapDumpOnOutOfMemoryError     # OOM 时保留现场
-XX:HeapDumpPath=/opt/jdcs/dumps
-XX:+ExitOnOutOfMemoryError         # OOM 时主动退出,交给 systemd 重启
/health 返回的运行状态可以直接对接你的监控体系:
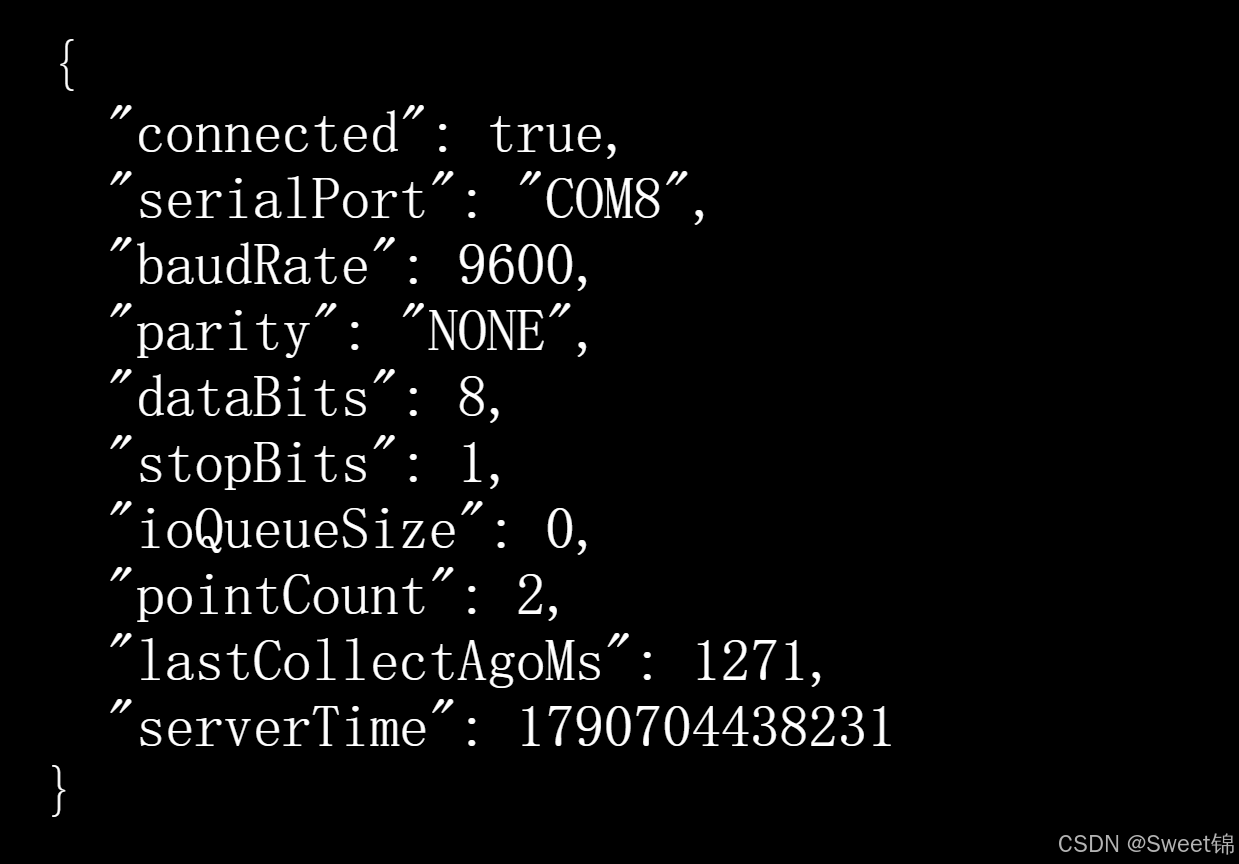
日志默认由 systemd 的 StandardOutput=append 写到 /var/log/jdcs/。这个文件不会自动滚动,长时间无人值守的话,建议在 logback-spring.xml 里加一个 RollingFileAppender,由 logback 自己管滚动和保留,不需要引入任何外部工具。注意加完之后要把服务单元的 StandardOutput / StandardError 改成 journal,不然同一份日志会写两遍。
九、上线前的检查清单
这份清单是从架构文档的"生产环境使用纪律"里摘的,都是踩过或者想清楚了的地方,上生产前对着过一遍。
-
采集循环用
tryFill()或tryParse(),别用严格版的parse()。单点异常降级成失败结果,不中断整轮轮询。 -
读
rawValue/value之前先判success。失败时这两个字段都是 null,直接取会踩空。 -
取数值统一用
((Number) v).doubleValue()。未缩放时value是原始类型,INT16是Short、UINT32是Long,直接强转Double会抛ClassCastException。 -
同一个
ModbusPoint实例不要跨线程并发写 。validate()和parse()会就地归一化配置,dataType、byteOrder、registerCount、charset、scale、offset这些字段会被写回实体。多个线程同时读同一个测点没问题,同时写就不行了。 -
核对那两个参数依赖 (
operation-timeout-ms > response-timeout-ms、看门狗阈值大于最坏轮次耗时)。前面单独讲过。 -
线圈和离散输入测点统一配
BOOL。这条重复三遍了,因为它是配错率最高的一个。 -
先跑一次
validate()。框架已经在ModbusRtuMaster.init()里对全部测点自动执行了,但如果你有自己的加载入口,记得手动调一次,让拼写错误在启动期暴露。
数据类型的别名是大小写不敏感的,也允许前后有空白(用 strip() 裁),bit、DiNt、float、float_32 这些写法都能正确归一化。但别指望框架能猜到你想表达什么,UINT 就是 UINT16,两字节,这个没有商量余地。
十、测试与质量
测试套件分成这几种:
| 测试类 | 形态 | 内容 | 需要硬件 |
|---|---|---|---|
TestModbusPointParser |
main() 自测 |
159 项断言 | 否 |
TestModbusBatchReadPlanner |
JUnit 5 | 14 项 | 否 |
TestModbusPointParserSimple |
JUnit 5 | 1 项 | 否 |
TestModbusRead |
@SpringBootTest |
真实串口集成测试 | 是 |
解析器那 159 项覆盖类型映射、四种字节序、奇数落单、缩放、宽容 API、异常容错这些。离线就能跑,失败时退出码为 1,可以直接挂 CI。
bash
java -cp "out:$(deps)" com.ty.jdcs.test.TestModbusPointParser
# 总计: 159, 通过: 159, 失败: 0
十一、它适合谁
说清楚边界,比一味说好更有用。
适合这些场景:中小型工业采集系统,需要长期无人值守的现场,边缘网关上跑的数据采集,以及想把重心放在业务(数据怎么用)而不是通信细节(数据怎么来)的团队。也能直接当二次开发的脚手架用。
不太适合的:需要开箱即用的完整 SCADA 或组态软件的;需要 Modbus TCP / ASCII 的(目前只做 RTU);需要多主站并发采集的。这些都能在现有骨架上扩展,但框架本身没做。
十二、写在最后
这个项目的出发点很小,就是把一次假死刨到底。
刨完之后发现,真正的问题不是某个库有 bug,而是这类场景本身就没有哪一层会主动来救你。串口不会告诉你对端断了,Java 的超时穿不透 JNI,进程没死 systemd 也不触发。能靠的只有自己搭的这套分层防御。
jDCS 把它们固化下来,做成了一个可以直接拿来用的骨架。
完整的架构说明和配置手册在仓库的 Architecture_API.md。如果时间有限,推荐先看第十章"故障兜底链路"和第十一章"生产环境使用纪律",前者是理解鲁棒性设计的入口,后者是上面那份检查清单的完整版。
如果有用,欢迎 Star ⭐,也欢迎把你的数据出口扩展(Kafka、InfluxDB、OPC UA 之类)分享回社区。