本文字数:6400;估计阅读时间:17分钟
作者:Tommy Li
编者按: 本文译自 ClickHouse 原博客(链接点文末-查看原文)。 原文围绕「大规模可观测性数据的可靠接入与架构优化」展开。文章深入剖析了在极端数据规模下,传统双层 OTel 架构面临的瓶颈。通过引入持久化缓冲层,该方案成功解决了高并发写入时的稳定性问题,为超大规模监控系统设计提供了实战参考。
此前我们曾公开介绍过 ClickHouse Cloud 的内部可观测性平台 LogHouse。在整个平台数据量突破一千万亿行的过程中,OpenTelemetry(OTel)作为统一收集层,承担了处理全栈日志、指标和追踪数据的重任,且其份额仍在快速增长。
目前,我们的 OTel 数据管道每秒需处理 5000 万个事件,存储了 177 PiB 的未压缩数据。这些数据源涵盖了 ClickHouse server 与 keeper、内部 Kubernetes 服务以及云服务商的基础设施。本系列的前一篇文章曾提到过一个基于 S3 的自研数据管道,用于确保收集器摄入时的持久性。现在,我们将详细拆解这一系统的架构演进历程。
历史
迭代 1:从 Agent 到 Gateway
最初的方案遵循 OTel 的标准参考部署:采用双层管道架构,由节点本地的 Agent 将数据发送给共享的 Gateway 集群。
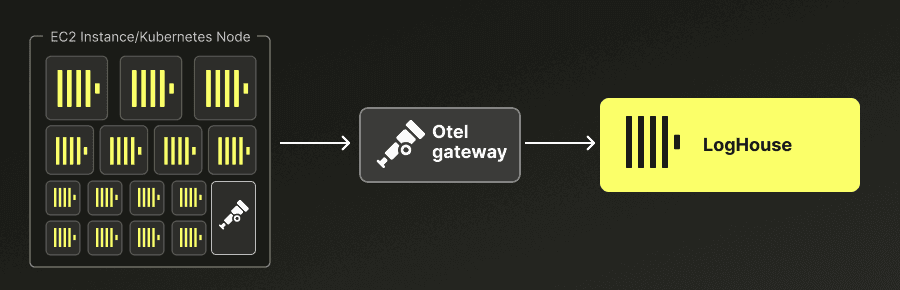
Agent 以 DaemonSet 形式运行在每个 Kubernetes 节点上,负责抓取 Pod 日志并接收指标与追踪数据。由于该环境资源受限,我们需要将绝大部分内存预留给业务负载,因此 Agent 仅执行添加资源属性等轻量操作和极小规模的批处理,随后便将数据转发至 Gateway 层。
Gateway 层则支持横向扩展,负责执行更繁重的处理任务。在这里,我们可以分配更多内存来构建更大的批次,从而实现 ClickHouse 最理想的写入效率。
选择这种方案的理由很简单:它虽然中规中矩,但能覆盖绝大多数使用场景。
压力下的瓶颈
我们很快意识到,这种架构在数据库产生背压(backpressure)时表现糟糕。默认情况下,Gateway 会将待发送数据缓存在内存队列中。面对每秒 5000 万个事件(压缩后约 10GB/s)的数据量,即使只想缓冲极短的下游宕机时间,内存成本也高得离谱。
背压问题的根源在于我们无法控制,也无法准确预测遥测数据的产生速率。LogHouse 的数据来源极其广泛,包括 ClickHouse 核心组件、Kubernetes 服务及各类云基础设施。在任何时刻,这些生产者产生数据的速度都可能超过下游系统的承载能力。
应对持续增长并不难,我们可以通过手动或自动扩容来匹配数据增量。但瞬时的流量突增却非常棘手。例如,某个集群报错可能导致日志量瞬间激增,或者某个高负载服务在特定区域出现活动峰值。这些突发流量通常转瞬即逝,如果为了吸收这些峰值而永久保留冗余容量,会导致资源在大部分时间里处于闲置状态。
因此,我们在规划 LogHouse 容量时是基于预期的持续吞吐量,并保留合理的余量,而非针对极端峰值。这就要求摄取管道必须具备"削峰填谷"的能力------在数据产生速率与 ClickHouse 接收速率不匹配时,既不能丢失数据,也不能因积压导致新数据处理延迟,更不能依赖永久性的资源预留。这一原则主导了后续所有的架构决策。
迭代 2:本地预写日志
既然内存不足,使用磁盘存储便成了自然的选择。OTel Collector 内置的 file_storage 扩展 正是为此设计的。启用后,所有输出数据在发往下游前都会先写入本地的预写日志(WAL)。
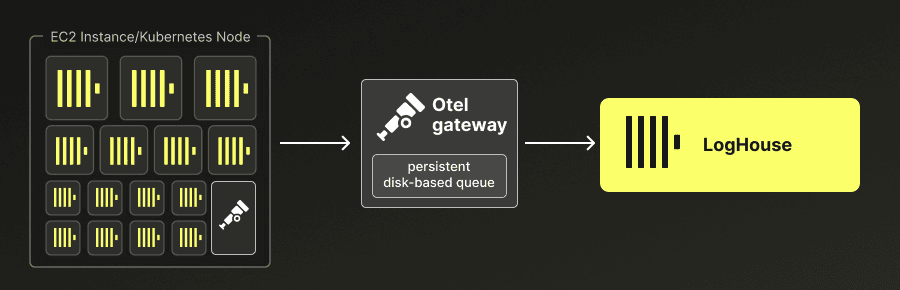
从理论上看,这似乎解决了问题。磁盘的存储密度和成本优势让我们能配置充足的缓冲区,足以应对长时间的数据库停机,且重启也不会导致传输中的数据丢失。
然而,实际效果并不理想。首先,使用 PVC 作为 WAL 的底层存储要求我们将 Gateway 部署为 StatefulSet。这使得 Pod 规范变得僵化,原本简单的版本发布操作也变得异常复杂,需要周密计划。
其次,性能表现无法达标。当下游数据库运行平稳时,吞吐量尚可;但一旦出现背压,随着 WAL 积压增加,吞吐量会显著下降。观察发现,排空 1TiB 的积压数据竟然需要约 4 小时。以我们的数据规模,哪怕数据库只停摆片刻,产生的积压也需要数小时才能消化。此时水平扩容也无济于事,因为 WAL 与特定 Pod 绑定,无法进行分布式处理。
更糟糕的是,WAL 遵循先进先出(FIFO)原则。故障恢复后,最新产生的、往往也是最重要的遥测数据会被排在积压数据的末尾。
这让我们陷入了尴尬的境地:为了数据持久化投入了大量精力与成本,却往往因为无法忍受数小时的延迟而不得不手动截断积压数据。事实证明,Collector 原生的 WAL 机制并不适合我们的场景。
Kafka 的局限性
在大规模遥测领域,Kafka 往往是首选。常规做法是在 Agent 和 Gateway 之间引入 Kafka、Warpstream 或 Pulsar 等流处理系统。这样 Gateway 就能转变为无状态的消费层,利用流系统吸收背压并独立扩容。这套成熟的模式确实能解决很多问题。
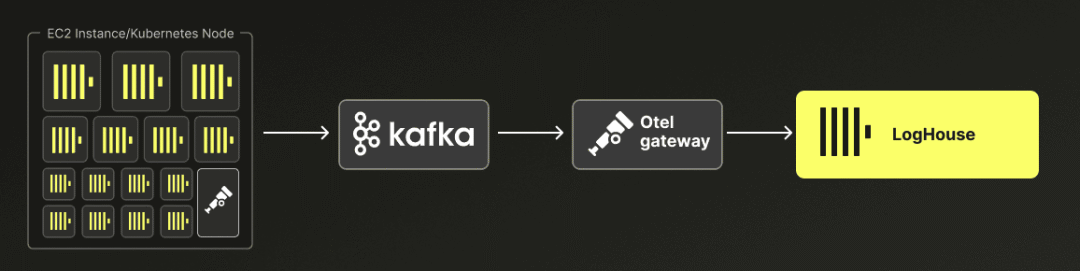
经过认真评估,我们最终放弃了这条路。这并非否定技术本身,而是出于运维成本的考量。我们的基础设施中此前并未部署 Kafka,引入它意味着要在所有云可用区新建一套 Tier 0 级别的核心服务。这需要投入巨大的精力进行部署、调优、扩容和值班运维,而这一切仅仅是为了支撑这一个用例。
于是我们重新审视核心诉求:我们到底需要什么样的遥测接入管道?
第三次迭代的设计思路
总结前两次迭代的教训并调研替代方案后,我们明确了四个核心约束:
-
不引入外部队列系统处理原始遥测。 避免为了缓冲数据而承担 Kafka 等有状态服务的运维负担,同时避开队头阻塞问题。
-
极高的成本效益。 遥测系统属于成本中心,任何组件的部署都必须考虑对业务利润率的影响。
-
极端情况下的可靠性。 管道必须能承受 ClickHouse 任意时长的背压且保证数据不丢失。
-
坚持开源。 保持与客户运行 ClickHouse 和 OTel 方式的一致性。
我们的最终设计基于两个关键点。
首先是对象存储(Blob Storage)。S3、GCS 和 Azure Blob 拥有近乎无限的容量和极高的可靠性,且无需额外维护,本就是我们云服务的核心组件。
其次是基于优先级的故障转移。OTel Collector 内置的 failoverconnector 可以将数据路由至主目标,仅在主目标故障时才切换到备用目标。这让我们能将 ClickHouse 放在热路径上,而将对象存储作为背压时的"泄压阀"。
这是控制成本的关键。如果全量实时写入对象存储,每秒 5000 万次事件产生的 PUT 请求费用将远超存储本身的账单。对象存储的优势在于存储廉价,但高频写入成本极高。按现有体量估算,全量写入的 API 成本每年将高达 10 万至 50 万美元。而采用故障转移机制,我们只需在 ClickHouse 间歇性不可用时支付这部分费用。正常运行时,数据直达 ClickHouse。
一旦数据溢出到对象存储,我们会通过事件通知触发异步拉取,利用独立的 Collector 将其写回 ClickHouse。这种基于特定操作(如创建对象)触发队列消息的模型,比遍历存储桶并记录检查点更简单,扩展性也更强。
对象存储宕机的应对
这是一个合理的担忧,毕竟 ClickHouse Cloud 自身也依赖对象存储。如果对象存储发生大规模宕机,主备目标都会失效,溢出机制确实会停摆。
不过,S3 全面停机极其罕见,且与我们要防范的局部故障性质不同。我们也考虑过跨区域部署溢出桶,但考虑到此类故障的极低概率,跨区域传输产生的出站流量成本实在太高。
因此,我们重点针对常见的故障模式进行优化。Blob 存储的异常通常表现为特定前缀的严重限流。我们将溢出数据分散到广阔的键空间中,确保故障转移期间负载不会集中在单一前缀上。由于事件通知包含了完整的对象键,这种不透明的键结构不会影响处理效率,也无需为范围扫描做优化。
全新流水线架构
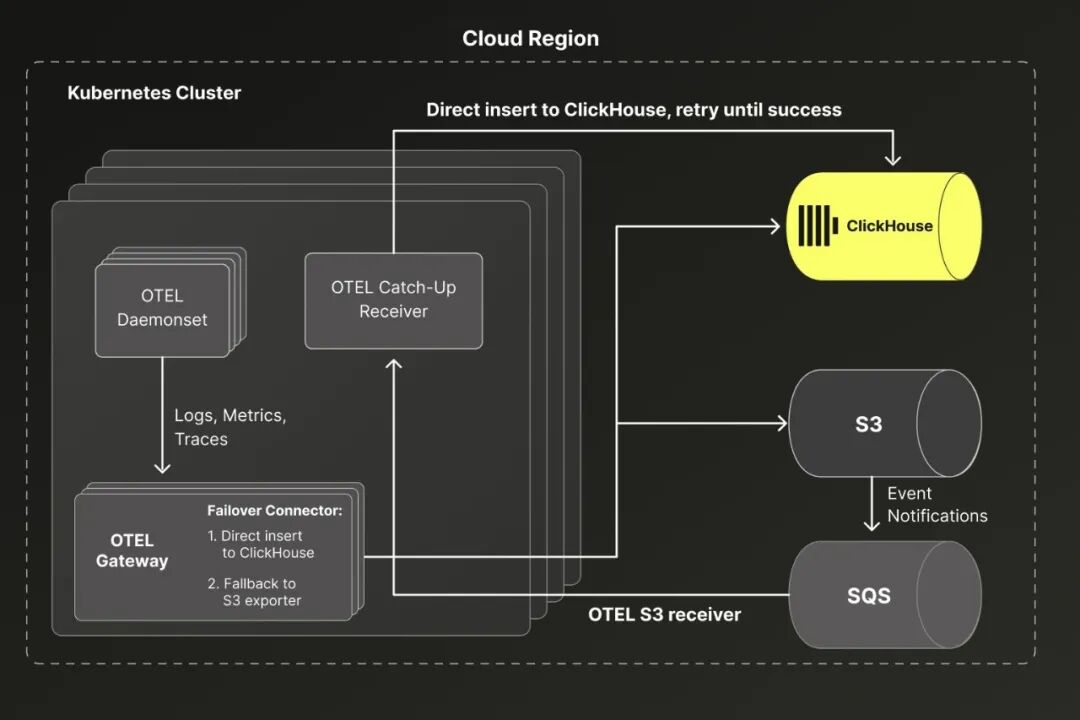
新架构的组件变动很小。在云端,我们新增了一个 S3 桶,并为每种遥测信号设置前缀,关联事件通知和 SQS 队列。在 Kubernetes 内部,Agent 层保持不变,Gateway 层变为完全无状态,由 Failover Connector 负责路由。此外,新增了一个数据追平接收器(Catch-up Receiver),专门从 SQS 轮询通知并将数据补录进 ClickHouse。若数据库异常,通知会在 SQS 中安全积压。
Failover Connector
在 OTel 体系中,Connector 兼具接收器与导出器的双重身份。Failover Connector 会根据优先级列表路由数据,它通过监控流水线的执行结果来判断目标健康状况。
这里有一个关键细节:必须禁用 ClickHouse Exporter 的发送队列。否则,错误会被队列吸收而无法传递给 Connector,导致故障转移延迟。虽然启用发送队列是 OTel 的常规推荐做法,但它会将同步操作变为异步,阻断背压信号。为了补偿这一点,我们将发送队列配置在 Connector 层面,确保路由决策位于队列上游。
为了避免偶发网络波动触发不必要的切换,我们依然在 Exporter 中保留了 retry_on_failure 配置,执行内联同步重试。
对于 Blob Storage Exporter,策略则相反:我们需要对 Failover Connector 屏蔽其失败状态。因为当前只有两个优先级,如果备用目标也报告不健康,Connector 会停止发送并导致内存溢出。因此我们在 Blob Storage Exporter 上启用了发送队列。配合分散的键路径设计和积极的重试策略,这既保证了持久性,又避免了 Gateway 崩溃。
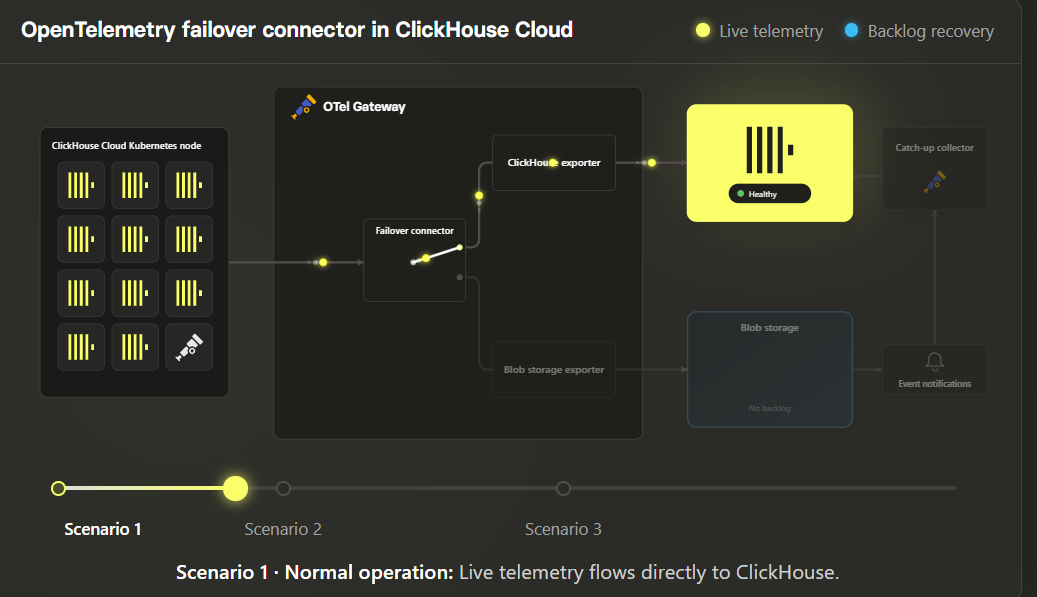
通过这种组合,我们构建了一套完美的流水线。正常时数据直达 ClickHouse;偶发错误由重试消化;遇到真实的背压时,流量自动切向 S3。当 ClickHouse 恢复,实时流量会立即切回,不会被 S3 中的积压数据阻塞。
connectors:
  failover/logs:
    priority_levels:
      - [logs/clickhouse]
      - [logs/s3]
    retry_interval: 30s
    sending_queue:
      enabled: true
      queue_size: 10000
service:
  pipelines:
    logs:
      receivers: [otlp]
      exporters: [failover/logs]
    logs/clickhouse:
      receivers: [failover/logs]
      exporters: [clickhouse]
    logs/s3:
      receivers: [failover/logs]
      exporters: [awss3/logs]
exporters:
  clickhouse:
    endpoint: ""
    connection_params:
      async_insert: "1"
      wait_for_async_insert: "1"
    ...
    sending_queue:
      enabled: false
    retry_on_failure:
      enabled: true
  awss3/logs:
    s3uploader:
      s3_base_prefix: logs
      s3_bucket: ""
      ...
    sending_queue:
      enabled: true
      queue_size: 10000
Catch-up Receiver
当数据进入 Blob 存储后,回写操作由事件通知驱动。主流云平台均能保证通知在队列系统(如 SQS)中的"至少一次投递"。OTel Collector 的 Blob Storage Receiver 可以监听这些队列并处理对应的对象。
补录收集器的部署非常灵活。我们将无状态的 Collector 作为 Kubernetes Deployment 运行,从队列中轮询。当队列清空时,这些实例可以缩容至零。由于它与 Gateway 相互独立,实时流量与补录过程互不干扰,且能根据积压情况独立扩缩容。
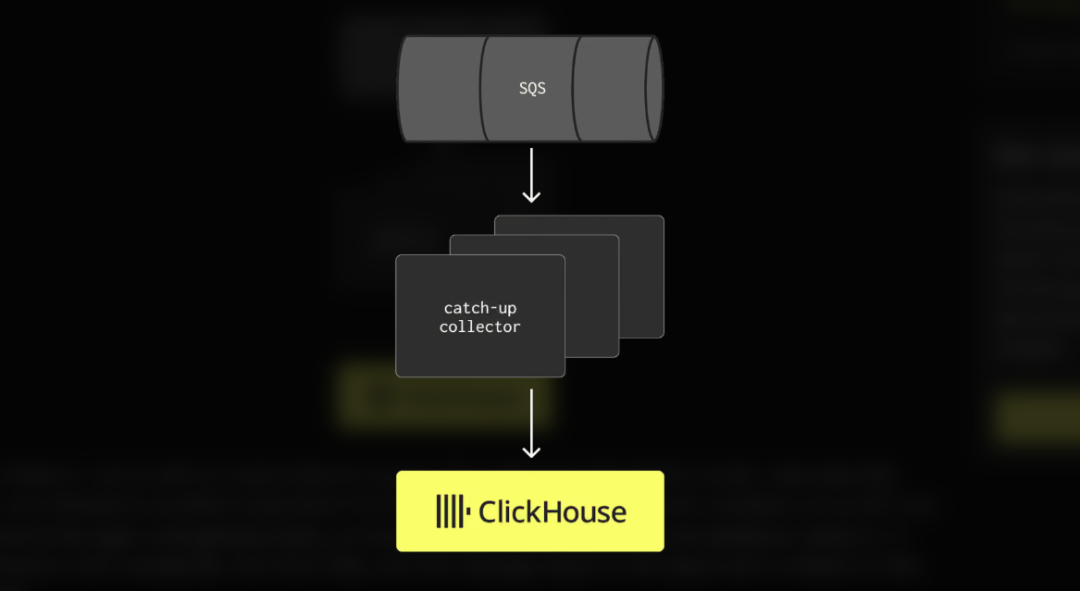
在补录过程中,收集器下载 Blob 并尝试同步写入 ClickHouse。由于数据丰富和预处理已在前端完成,此处只需原样写入。若数据库仍不可用,消息会保留在队列中等待下次重试。
receivers:
  awss3/logs:
    s3downloader:
      s3_bucket: ""
      s3_prefix: logs
    sqs:
      queue_url: ""
exporters:
  clickhouse:
    endpoint: ""
    connection_params:
      async_insert: "1"
      wait_for_async_insert: "1"
    ...
    sending_queue:
      enabled: false
    retry_on_failure:
      enabled: true
service:
  pipelines:
    logs:
      receivers: [awss3/logs]
      exporters: [clickhouse]
相比于直接通过 Kafka 传输原始数据,这种通知队列极其轻量。它仅在发生溢出时产生消息,且消息体仅包含微小的对象键信息,而非数 MB 的原始数据。
故障演练实战
为了验证设计,我们进行了一场极端压力下的故障演练:模拟下游完全中断,使所有流入的遥测数据产生持续背压。
在迭代 1 中,Gateway 会在几分钟内因 OOM 崩溃。在迭代 2 中,系统能撑过中断,但若超过 30 分钟,产生的 WAL 积压将导致后续数小时的延迟。在迭代 3 的测试中,我们在预发环境将 LogHouse 集群关停了整整一小时,当时环境负载为每秒 12 万个事件。
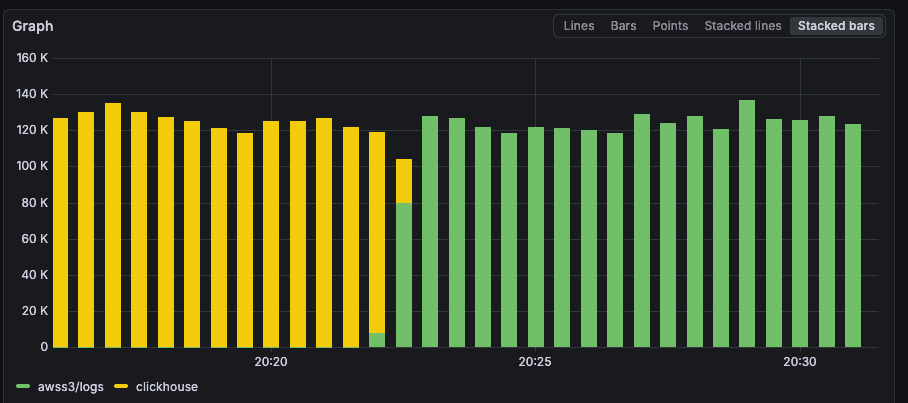
从指标图表可以看到,黄色柱形(写入 ClickHouse)在中断时消失,绿色柱形(写入 S3)随即平稳升起。在整个故障转移期间,Gateway 的资源占用保持稳定,没有出现任何波动。
一小时后,我们重启了 LogHouse 集群。
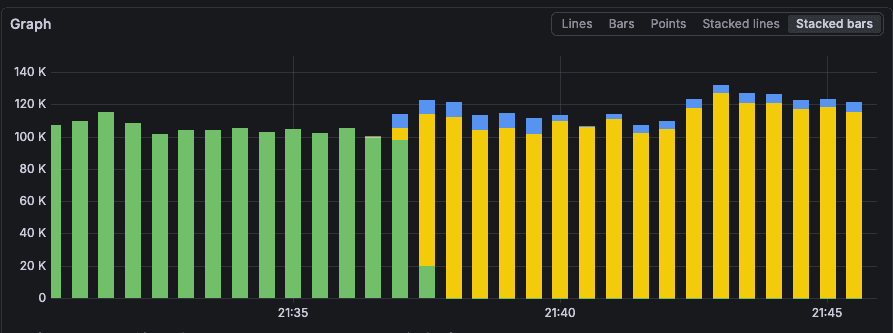
此时,写入 S3 的流量立刻消失,实时流量回归 ClickHouse。同时,顶部的蓝色柱形显示补录收集器开始工作,成功处理了中断期间积压在 SQS 中的所有任务。
结论
最初,我们的流水线在数据库波动面前非常脆弱,常导致崩溃循环和沉重的运维负担。现在,这套深度定制的收集器架构已多次在实际故障中验证了其可靠性,确保了数据零丢失。通过移除基于 PVC 的本地 WAL,系统不仅变得更轻量,成本也大幅降低。
当然,这种架构也存在权衡。每扩展一个新地域,都需要配置相应的存储桶、队列和通知机制。收集器的配置复杂度也有所提升。此外,异步恢复机制意味着在消化积压数据时,我们虽然知道总量,但难以精确追踪特定数据源的实时处理进度。
这套架构支撑我们从每秒 1000 万个事件无缝扩展到了 5000 万个。这种稳定性让我们有信心将其推广到 Clickstack Cloud(我们的全托管可观测性服务)的 OTLP 接入端点中。
关于我们
ClickHouse(clickhouse.com) 是面向 AI 时代打造的高性能实时分析数据库,能够以极致性能处理海量数据分析任务。凭借高并发、低延迟和云原生架构,ClickHouse 广泛应用于可观测性、数据仓库、实时分析及 AI 数据基础设施等场景。我们致力于帮助企业在公有云平台上构建安全、弹性且高性价比的实时分析与 AI 数据平台,加速释放数据价值,推动智能化创新与数字化转型。目前,Trip.com、DiDi、Meta、Sony、Netflix、Deutsche Bank、Sierra、Cloudflare 等全球领先企业均在使用 ClickHouse 支撑其关键业务和数据分析平台。