摘要:索引本质是「空间换时间」的有序结构,但日常慢 SQL 大多不是「没建索引」,而是「查询没真正命中或高效利用索引」。本文从 B+ 树结构讲起,串起聚簇/二级索引、回表、覆盖索引、最左前缀与索引失效机制,再用慢查询日志与 EXPLAIN 把代价量化,给出一份可被执行计划验证的优化清单。
导语
你一定遇到过:给字段加了索引,查询却依旧全表扫描、依旧慢。问题往往不在「有没有索引」,而在「查询是否真的命中并高效利用了它」。
回表、覆盖索引、最左前缀、索引下推(ICP,Index Condition Pushdown)------这些概念单看都懂,落到真实 SQL 上却不会设计索引。本文以「为什么加了索引还是慢」为主线,把索引底层结构与排查工具链串成一条可复现路径。
沿线的原理与官方参数均以 MySQL 8.0 文档为准。推荐先读这篇实战路径总结 MySQL 索引调优实战:从 B+ Tree 到慢查询排查的完整路径 建立整体印象,再回来看本文的细节对比。
一、B+ 树索引:MySQL 为什么选它
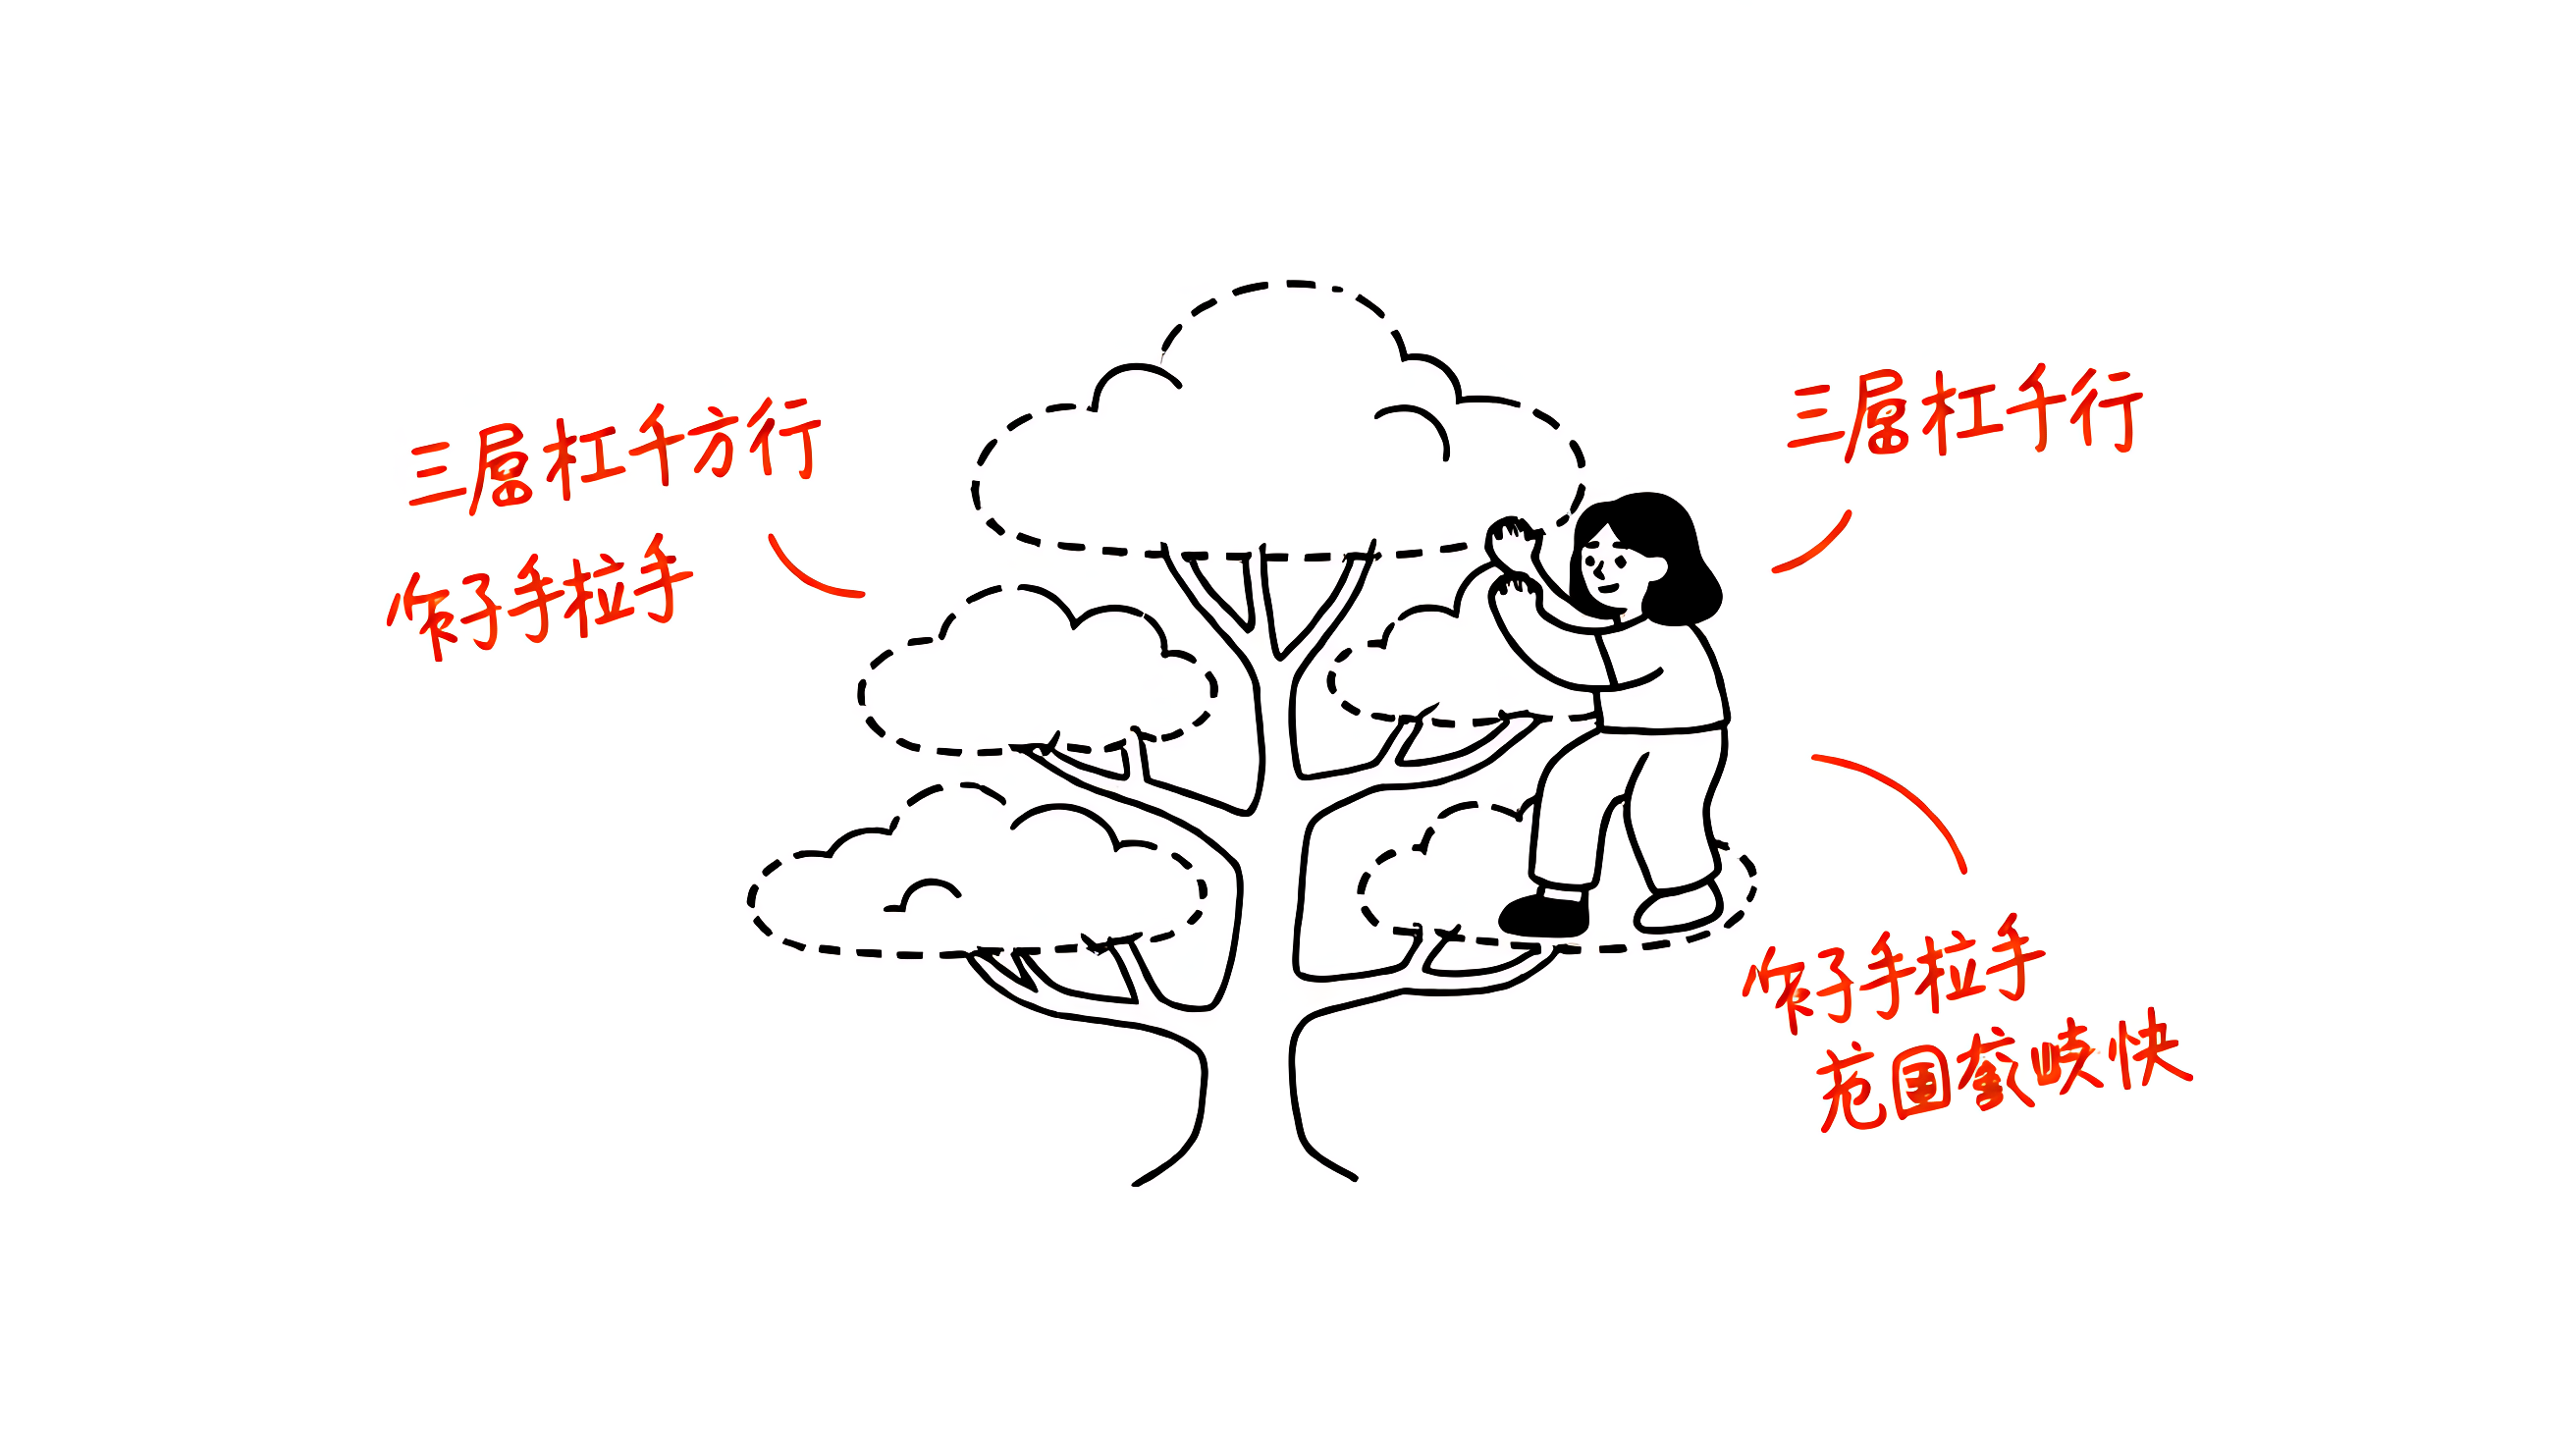
InnoDB 绝大多数索引(主键、唯一索引、普通索引、全文索引)都以 B-tree (B 树)存储,而非哈希。B+ 树 是一种「矮胖」的平衡树:三层结构即可承载千万到亿级数据,叶子节点之间通过链表相连,非常适合范围查询与排序。
哈希索引只能做等值匹配,无法支持范围、排序和前缀匹配,所以 InnoDB 主键选择 B+ 树。聚簇索引 即「索引组织表」:整张表的用户数据都存放在聚簇索引 B+ 树的叶子节点中,这也是 InnoDB 与堆表引擎(如 MyISAM)的根本差异。
下面用一张表对比二者选型上的取舍:
| 维度 | B+ 树索引 | 哈希索引 |
|---|---|---|
| 等值查询 | 支持(O(log n)) | 支持(接近 O(1)) |
| 范围 / 排序 | 原生支持(叶子链表) | 不支持 |
| 前缀匹配 | 支持(最左前缀) | 不支持 |
| 典型用途 | InnoDB 主键、二级索引 | Memory 引擎可选 |
二、聚簇索引、二级索引与回表
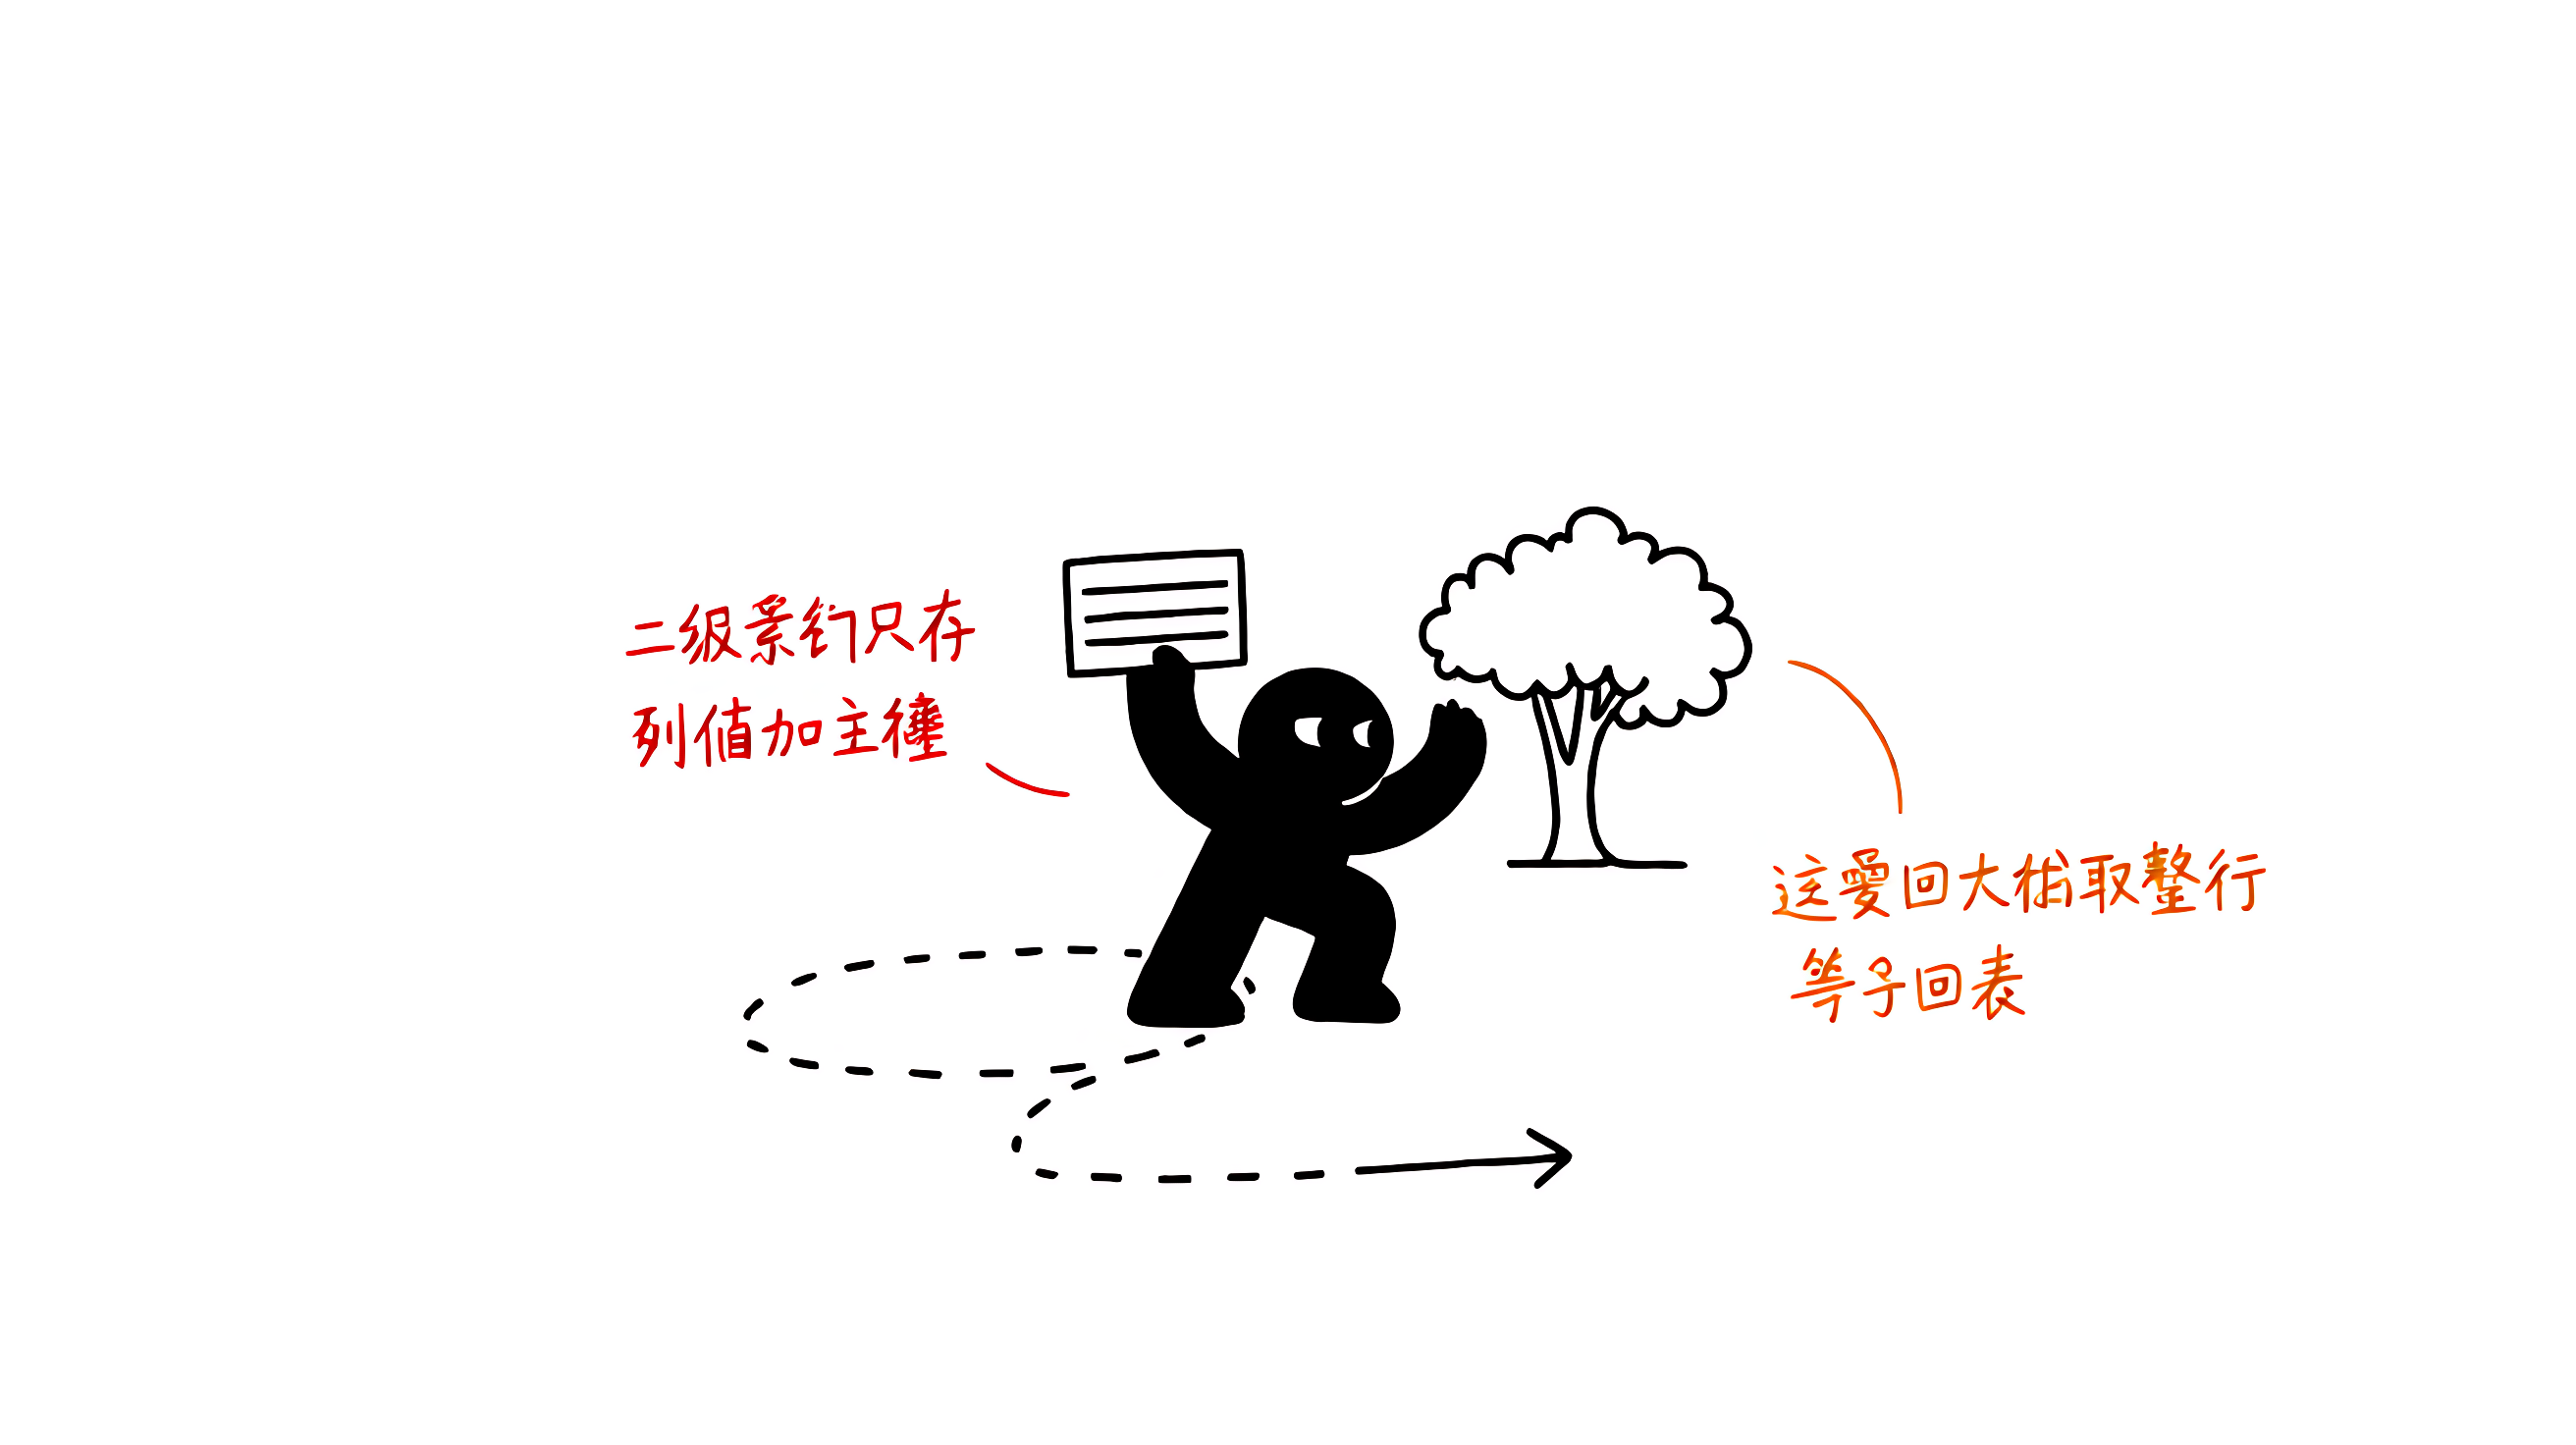
InnoDB 每张表有且只有一个聚簇索引:通常是主键;若无主键,则用第一个全 NOT NULL 唯一索引;再没有就会隐式生成一个 6 字节的隐藏行 ID(GEN_CLUST_INDEX)作为聚簇索引。
二级索引 的叶子节点不存整行数据,只存「索引列值 + 主键值」。这意味着当查询需要的列超出二级索引覆盖范围时,InnoDB 必须凭主键回到聚簇索引取完整行------这个过程叫 回表,会产生额外随机 IO。
sql
-- 建表并创建一个联合二级索引
CREATE TABLE orders (
  id        BIGINT PRIMARY KEY,
  user_id   INT  NOT NULL,
  status    TINYINT NOT NULL,
  amount    DECIMAL(10,2) NOT NULL,
  KEY idx_user_status (user_id, status)
) ENGINE=InnoDB;

-- 回表:需要 amount,二级索引只覆盖 (user_id, status),须回聚簇索引取行
EXPLAIN SELECT * FROM orders WHERE user_id = 100 AND status = 1\G
-- Extra 中无 Using index → 发生了回表

-- 覆盖:只取索引列,无需回表
EXPLAIN SELECT user_id, status FROM orders WHERE user_id = 100 AND status = 1\G
-- Extra 显示 Using index → 覆盖索引,无回表
主键设计上建议用「短主键」:二级索引叶子都带着主键副本,主键越长,所有二级索引越占空间。高频写入表尤其要避免过长的聚簇键。
三、覆盖索引与最左前缀原则
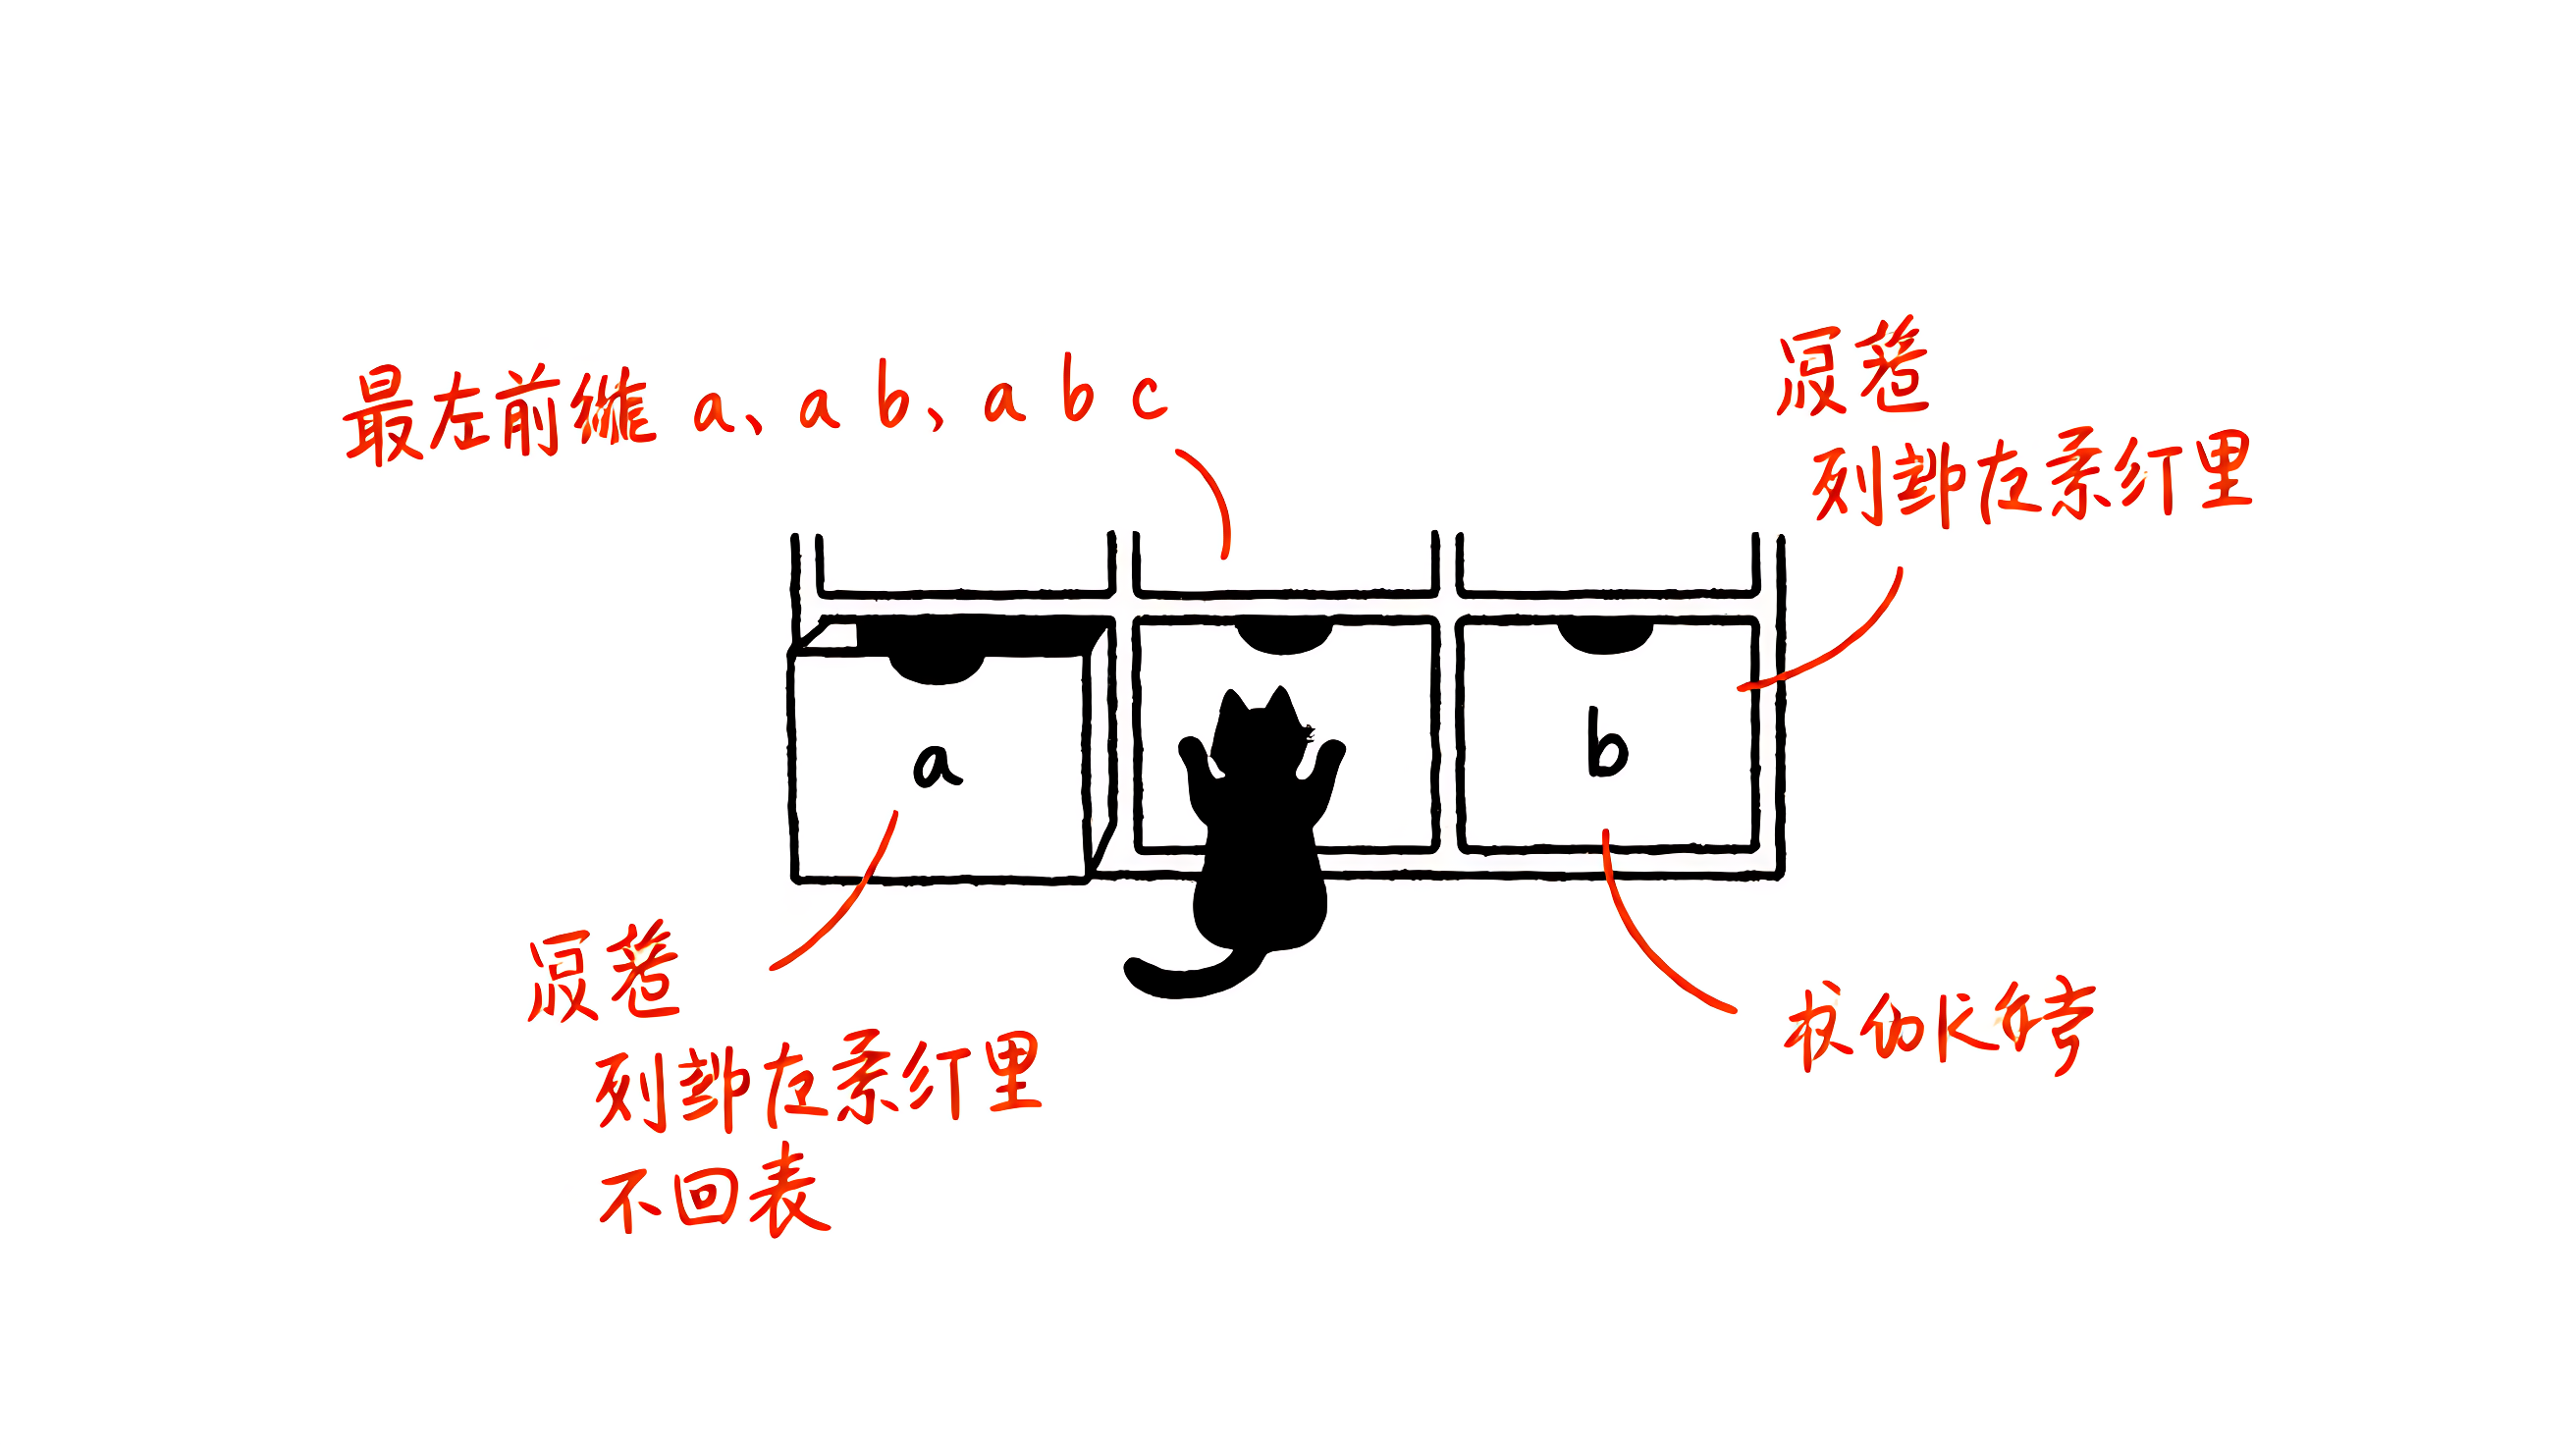
覆盖索引 指查询所需列全部包含在某一个索引里,引擎可直接从索引取数,无需回表,EXPLAIN 的 Extra 列会显示 Using index。把高频查询的 SELECT 列塞进二级索引,是消除回表最直接的手段。
联合索引遵循 最左前缀原则 :索引 (a, b, c) 可支持 (a)、(a, b)、(a, b, c) 三种前缀组合查找,但单独查 (b) 或跳过前列通常走不上索引。
sql
-- 联合索引 (user_id, status, amount)
-- 命中:满足最左前缀
EXPLAIN SELECT id FROM orders WHERE user_id = 100 AND status = 1\G

-- 失效:跳过 user_id,无法利用 (user_id, status, amount)
EXPLAIN SELECT id FROM orders WHERE status = 1 AND amount > 10\G
-- key = NULL,type = ALL,说明没用上索引

-- 覆盖索引改造:把 amount 纳入索引,避免回表
ALTER TABLE orders DROP INDEX idx_user_status;
ALTER TABLE orders ADD INDEX idx_user_status_amt (user_id, status, amount);
EXPLAIN SELECT user_id, status, amount FROM orders WHERE user_id = 100\G
-- Extra: Using index(覆盖)设计经验:高区分度列靠前,范围查询列(>、BETWEEN、LIKE 'x%')放最后------因为范围之后的列会失效。同时尽量 SELECT 具体列而非 SELECT *,既减少回表也缩小索引体积。
四、索引失效的六大场景(及执行计划判断法)
索引失效不是靠死记场景,而是用 EXPLAIN 看 type / key / rows / Extra 四列判断。常见失效点有六类:
- 索引列做函数/表达式运算 :
WHERE YEAR(create_time)=2023会让索引失效,应改写成范围查询。 - 隐式类型转换 :字符串列用数字比较
WHERE phone = 13800000000触发自动转换,索引失效。 - LIKE 左模糊 :
LIKE '%abc'无法用最左前缀,LIKE 'abc%'可走索引。 - 违反最左前缀 :如上一节单独查
(b)。 - 范围条件后的列失效 :
(a, b, c)中a用范围后,b、c无法用于索引过滤。 - OR 连接无索引列 :
WHERE a=1 OR b=2中b无索引时整句可能放弃索引。
此外,优化器也可能主动选全表扫描 :表很小、回表比例过高、或统计信息过期(需 ANALYZE TABLE)时,它认为扫全表更划算。
sql
-- 反例1:索引列套函数 → 失效
EXPLAIN SELECT * FROM orders WHERE YEAR(created_at) = 2023\G
-- 正确改写:用范围查询保留索引列「纯净」
EXPLAIN SELECT * FROM orders
  WHERE created_at >= '2023-01-01' AND created_at < '2024-01-01'\G

-- 反例2:隐式类型转换(phone 为 VARCHAR)
EXPLAIN SELECT * FROM user WHERE phone = 13800000000\G   -- 失效
EXPLAIN SELECT * FROM user WHERE phone = '13800000000'\G  -- 命中

-- 反例3:左模糊
EXPLAIN SELECT * FROM user WHERE name LIKE '%明'\G          -- 失效
EXPLAIN SELECT * FROM user WHERE name LIKE '张%'\G         -- 命中
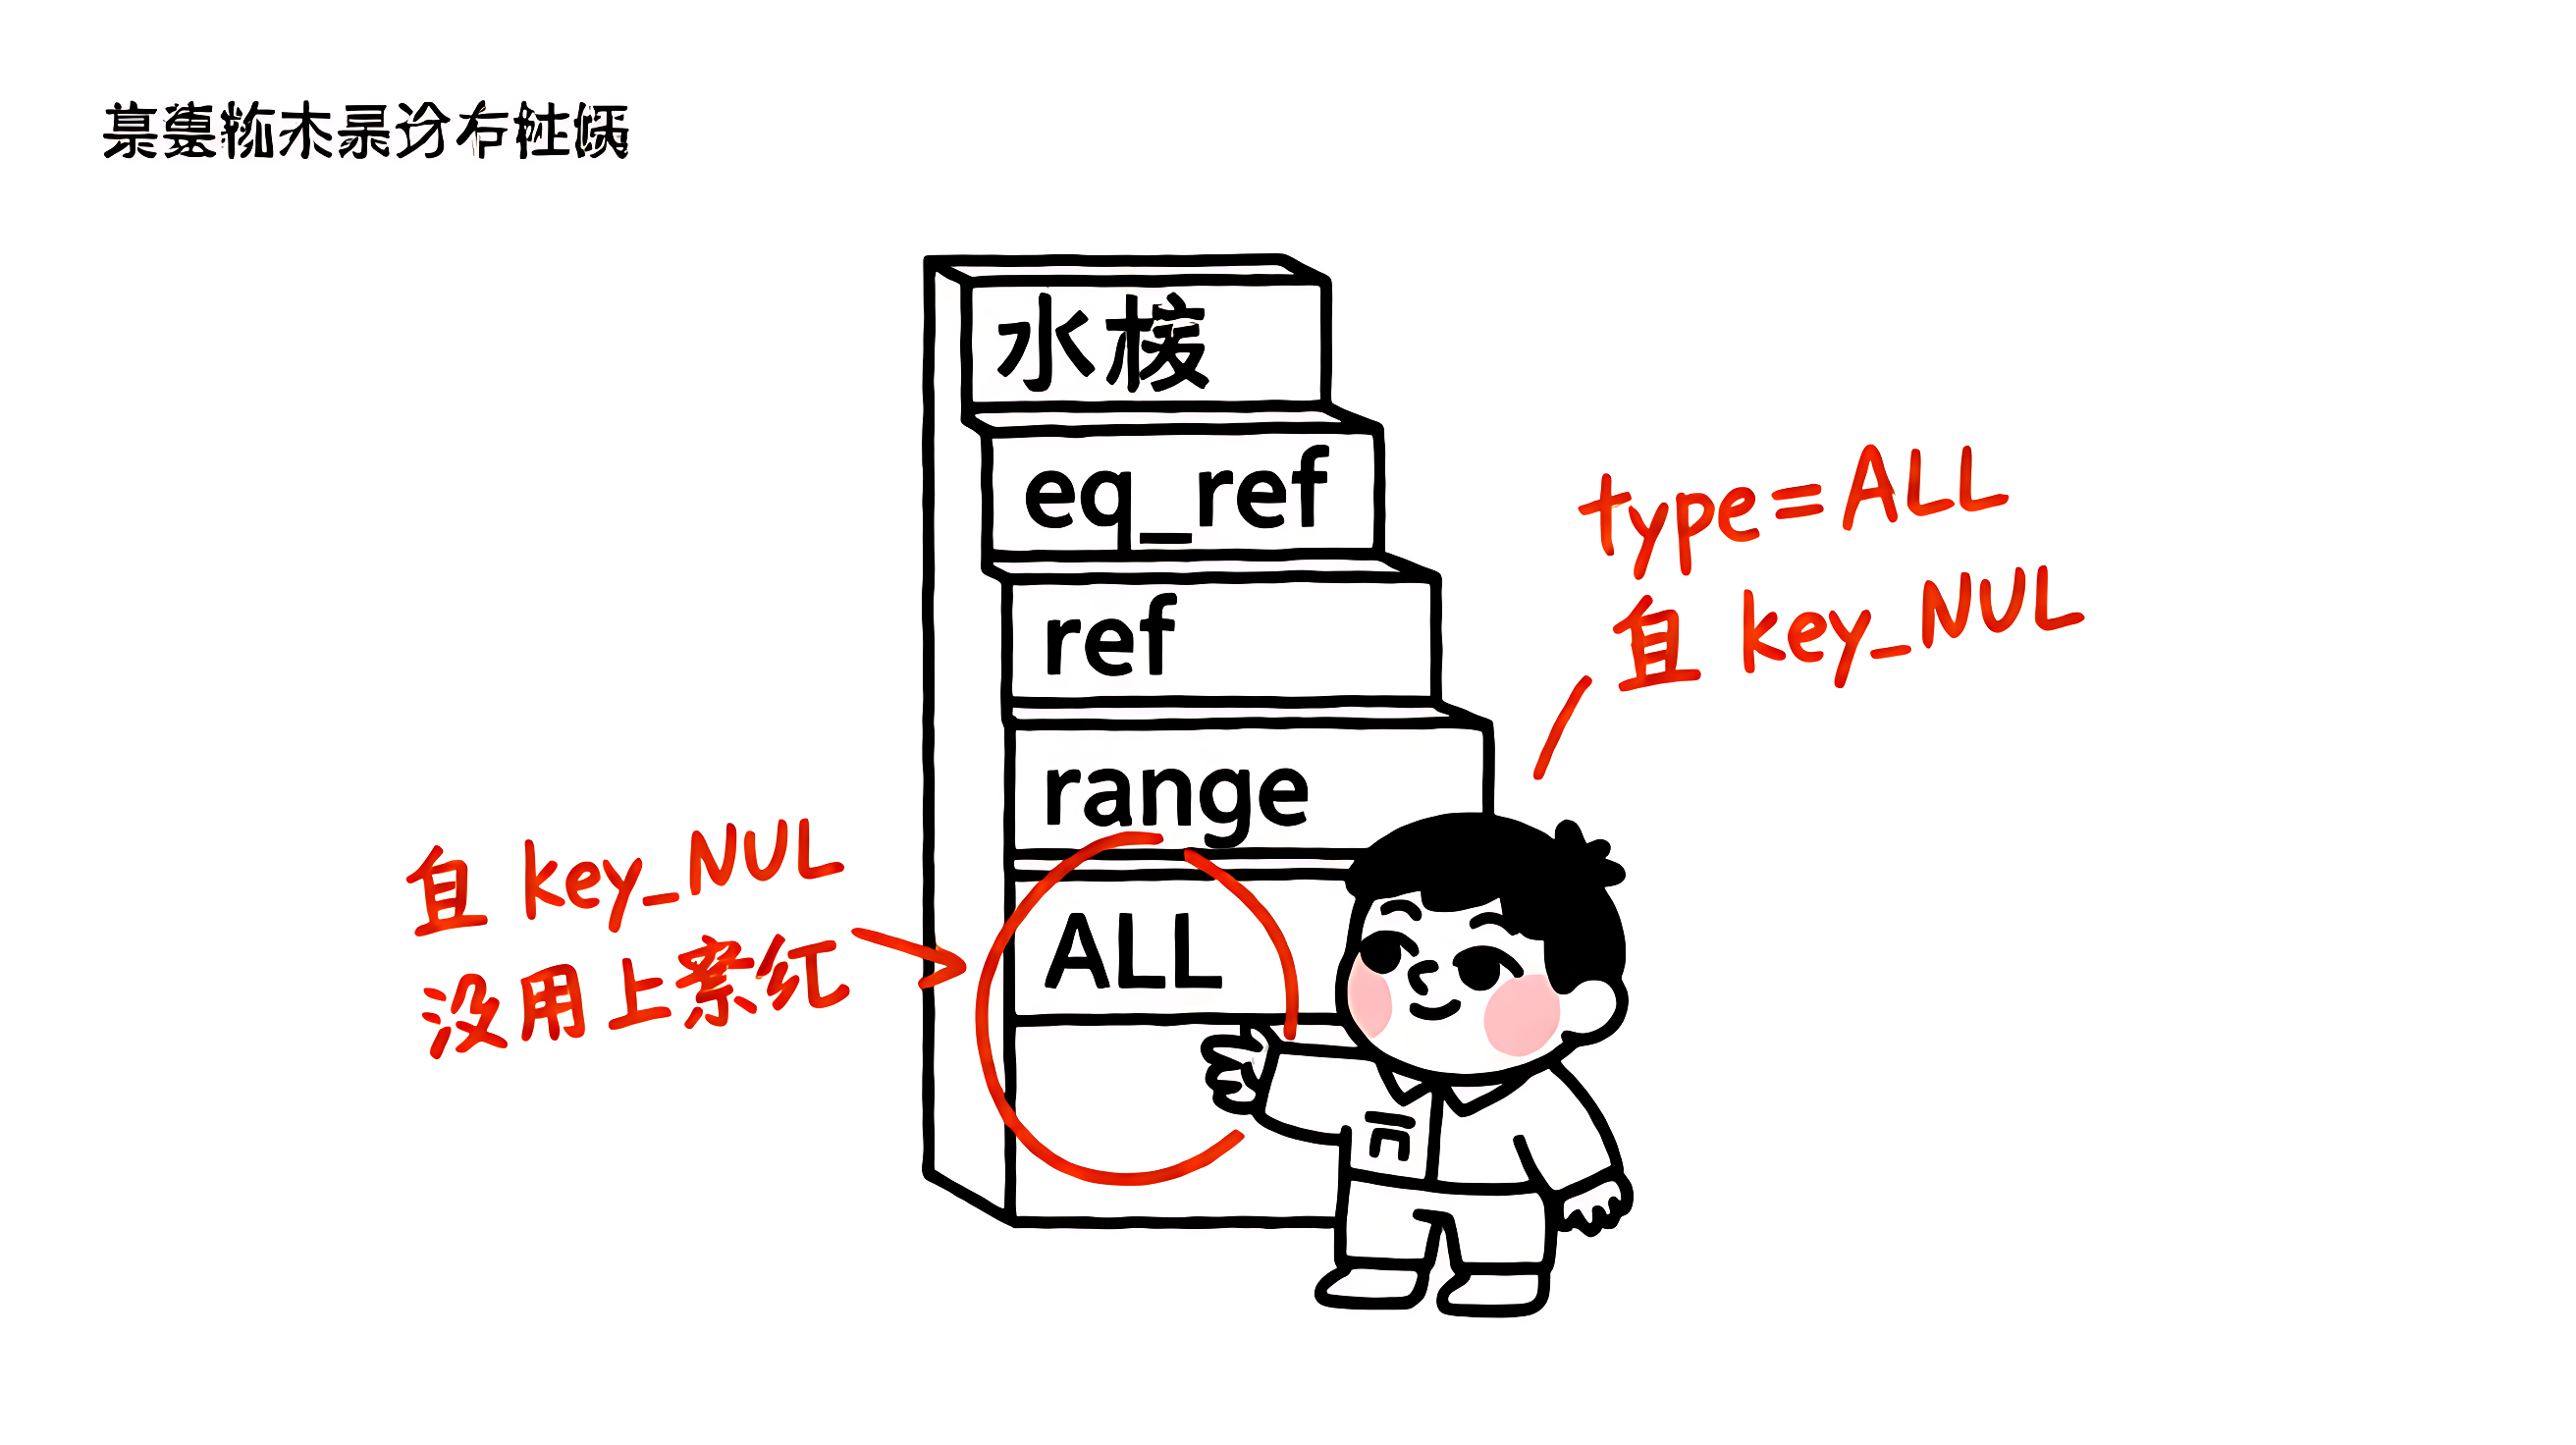
EXPLAIN 的 type 从优到劣大致为:system > const > eq_ref > ref > range > index > ALL。看到 ALL 且 key = NULL,基本可判定索引没生效。
五、慢查询定位:慢查询日志与 EXPLAIN 执行计划解读
定位慢 SQL 的第一步是打开 慢查询日志 (Slow Query Log)。它由一组系统变量控制:slow_query_log(总开关)、slow_query_log_file(日志路径)、long_query_time(阈值,默认 10 秒)、log_queries_not_using_indexes(记录全表扫描)、min_examined_row_limit(最小检查行数,默认 0)。
ini
# my.cnf 持久化配置(SET GLOBAL 重启后会失效)
[mysqld]
slow_query_log = 1
slow_query_log_file = /var/log/mysql/slow.log
long_query_time = 1
log_queries_not_using_indexes = 1
min_examined_row_limit = 100
sql
-- 运行时临时开启(重启失效)
SET GLOBAL slow_query_log = 1;
SET GLOBAL long_query_time = 1;
SET GLOBAL log_queries_not_using_indexes = 1;

-- 触发一条慢 SQL 后查看日志
SELECT SLEEP(2);  -- 超过 long_query_time,会写入慢日志
-- 日志内容示例:# Query_time: 2.000123  Lock_time: 0.000000 Rows_sent: 1  Rows_examined: 1
得到慢 SQL 后,用 EXPLAIN 看执行计划,关键字段含义:
| 字段 | 含义 | 关注点 |
|---|---|---|
type |
访问类型 | 越靠前越优,ALL 最差 |
key |
实际用的索引 | NULL 即未用索引 |
rows |
估计扫描行数 | 越小越好 |
Extra |
额外信息 | Using index 好;Using filesort/Using temporary 警惕 |
MySQL 8.0.18+ 还提供 EXPLAIN ANALYZE,以 TREE 格式输出实际 执行时间与行数,比纯估计更直观;想看优化器为什么这么选,可开启 OPTIMIZER_TRACE。
六、实战优化清单(含索引下推 ICP)
落地时优先做三件事:覆盖索引消除回表 、保持索引列「纯净」、用联合索引前缀覆盖高频查询。EXPLAIN ANALYZE(MySQL 8.0.18 引入,TREE 格式含实际执行时间与行数)能直接量化回表前后的代价差异。
索引下推(ICP,Index Condition Pushdown) 把 WHERE 中可用索引列判断的部分下推到存储引擎,减少回表次数;Extra 显示 Using index condition;InnoDB 仅用于二级索引,默认开启,可用 optimizer_switch 控制。
sql
-- 基于 INDEX(zipcode, lastname, firstname) 的 ICP 演示
SET optimizer_switch = 'index_condition_pushdown=off';
EXPLAIN SELECT * FROM people
  WHERE zipcode = '95054' AND lastname LIKE '%etrunia%'\G
-- Extra 无 Using index condition → 更多回表

SET optimizer_switch = 'index_condition_pushdown=on';
EXPLAIN SELECT * FROM people
  WHERE zipcode = '95054' AND lastname LIKE '%etrunia%'\G
-- Extra: Using index condition → 引擎层先过滤,回表次数下降
其余可复用的优化项:
- 深分页 :用
WHERE id > ? LIMIT n替代LIMIT 10000, 10,避免大偏移扫描。 - JOIN :给被驱动表的连接列建索引,把
ALL变成ref。 - 索引不是越多越好 :每次写入都要维护 B+ 树,高频更新表谨慎加索引;定期
ANALYZE TABLE更新统计信息,避免优化器误判。
总结
调优不是玄学,而是可执行计划验证的工程方法。主线是:结构原理 → 失效机制 → 定位工具 → 优化清单。
行动清单:先开慢查询日志找瓶颈,再用 EXPLAIN 看 type/key/rows/Extra 逐项验证,优先覆盖索引、避开失效写法,最后用 EXPLAIN ANALYZE 复测代价。把「凭感觉加索引」换成「用执行计划量化回表代价」,慢查询自然压得下来。
参考资料
- MySQL 8.0 官方文档 · How MySQL Uses Indexes:https://dev.mysql.com/doc/refman/8.0/en/mysql-indexes.html
- MySQL 8.0 官方文档 · The Slow Query Log:https://dev.mysql.com/doc/refman/8.0/en/slow-query-log.html
© 2024 | 转载请注明出处
结论:PASS