AI 创作标识
本文由人工智能(AI)辅助创作/生成,内容仅供学习与参考,不保证完全准确,请结合官方文档与实际情况核对。
Java 线程在内存模型(JMM)与 JVM 实现:规范与落地的多元路径
引言
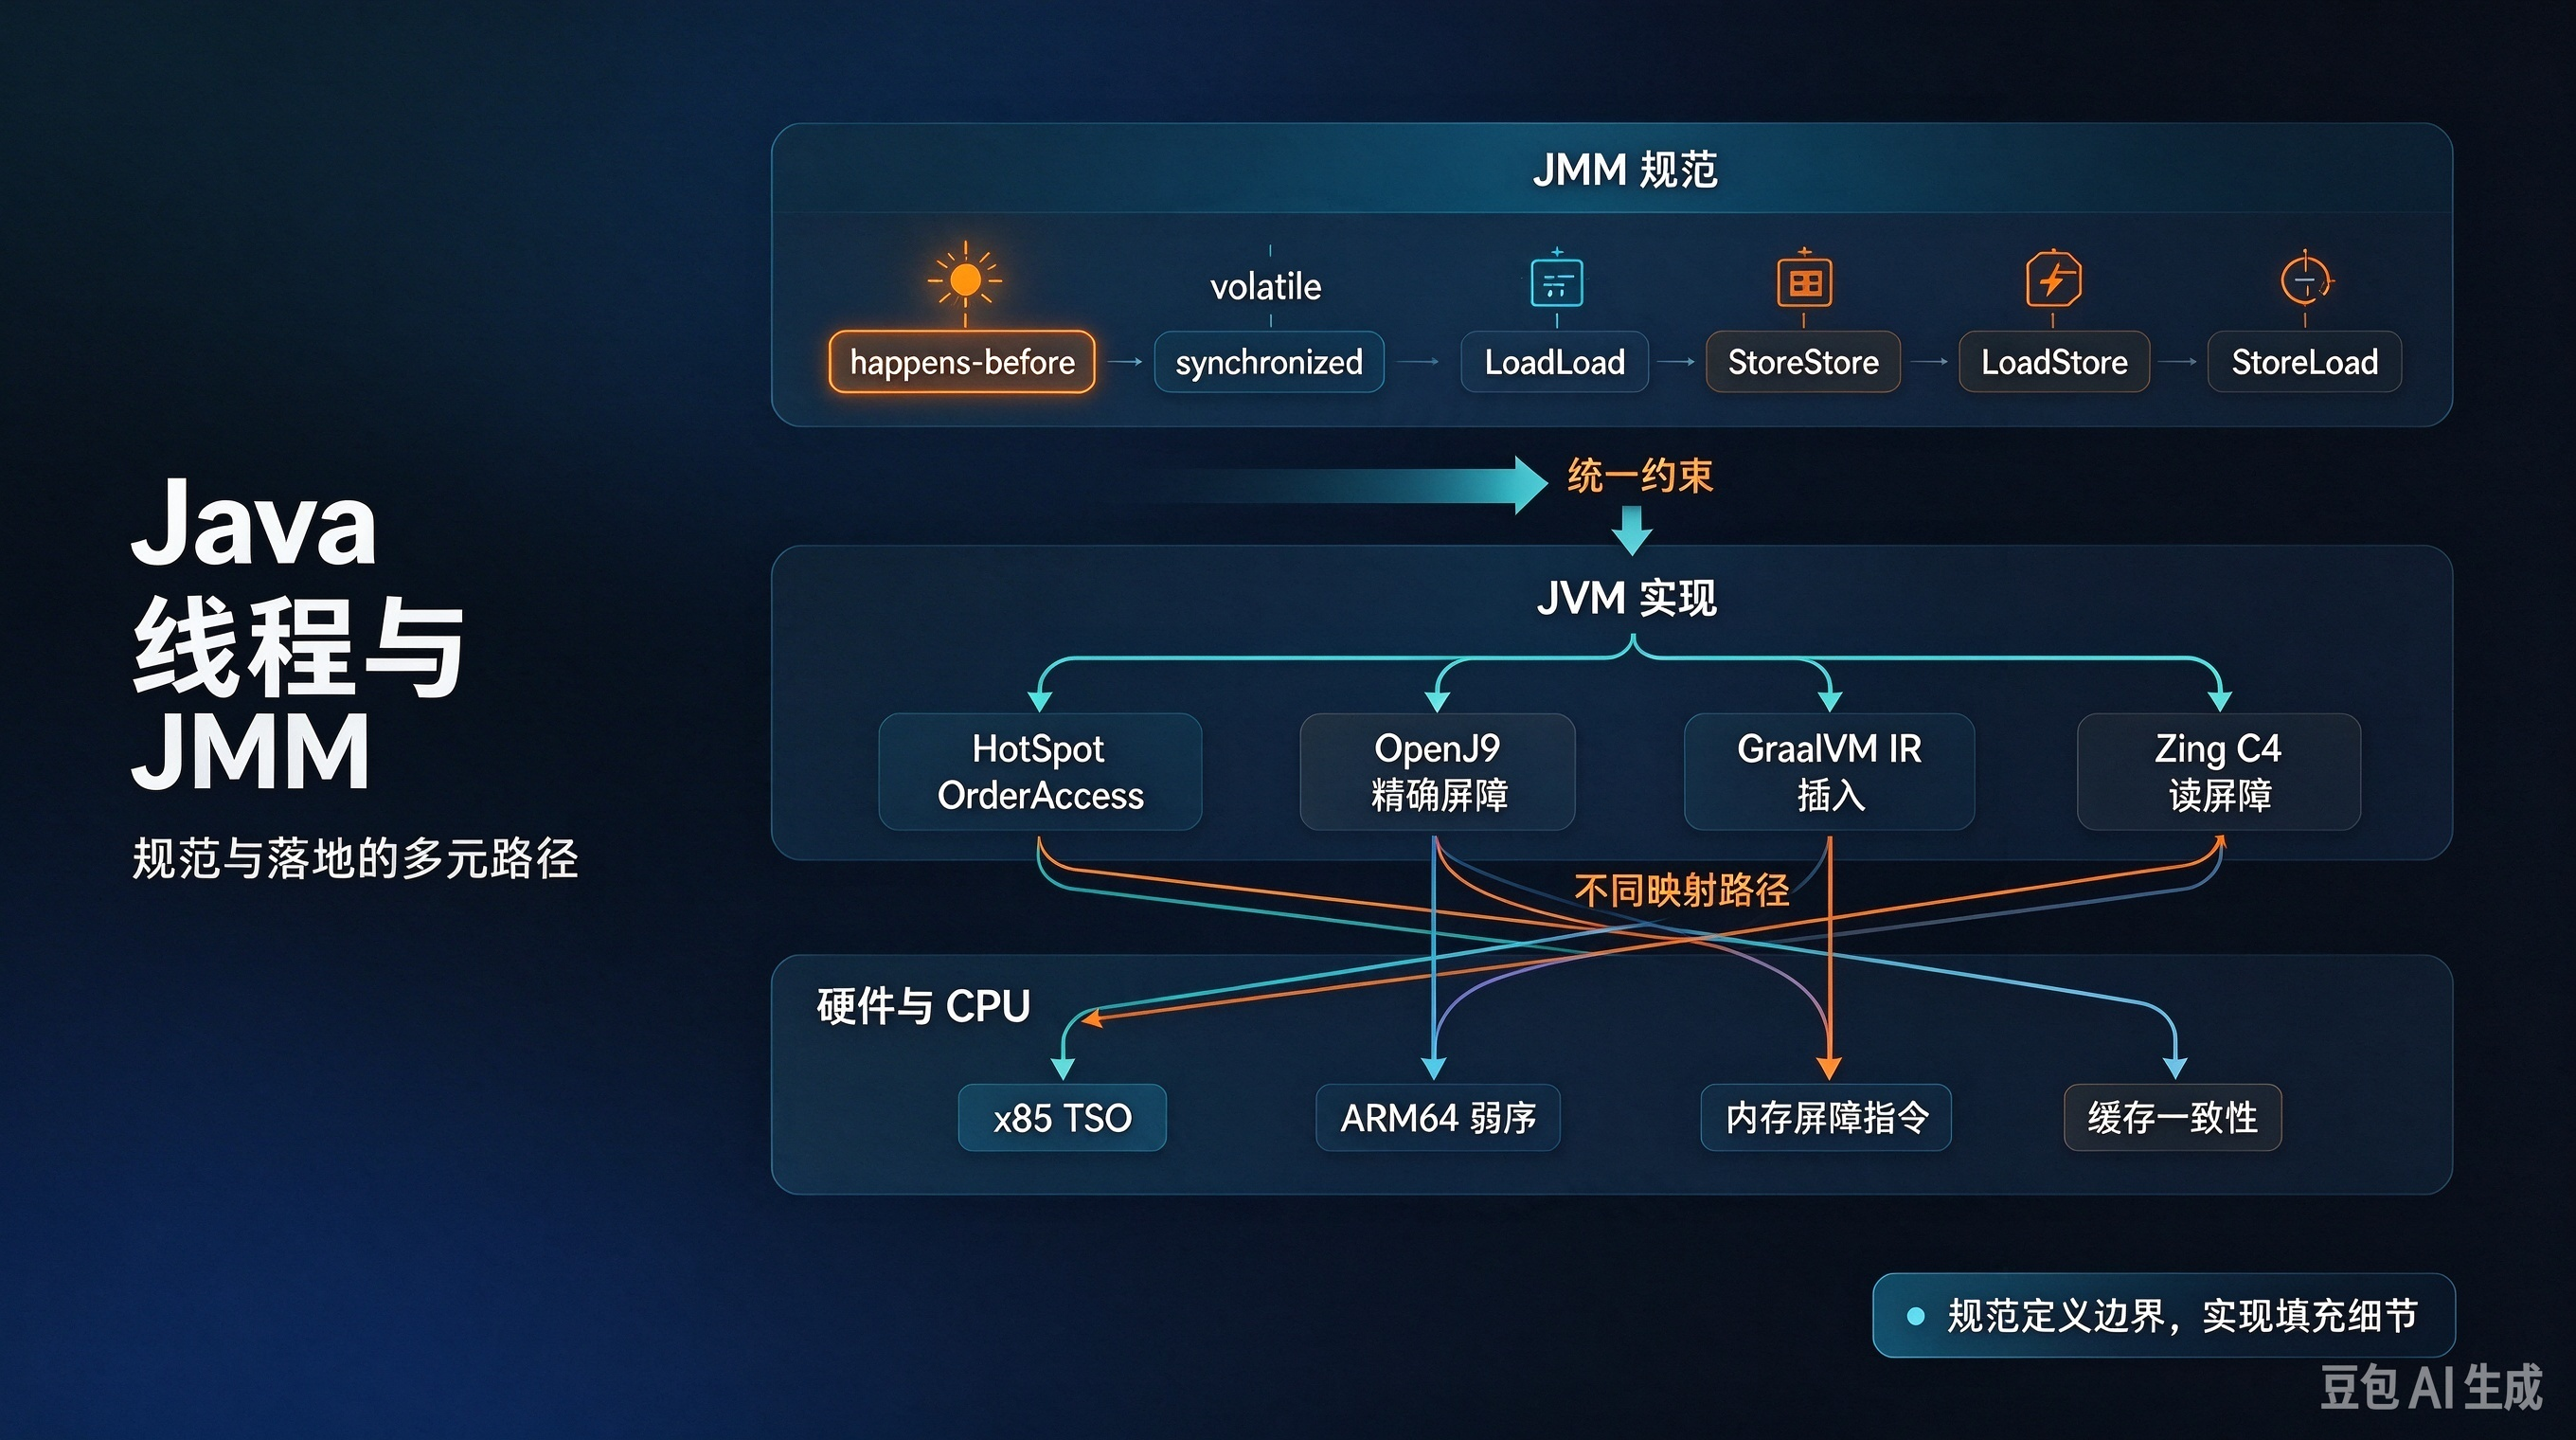
Java 内存模型(Java Memory Model,JMM)是 Java 并发编程的基石。它是一套规范 ,定义了多线程程序中共享变量的读写规则,规定了线程之间何时能看到彼此的写入,以及哪些重排序是被允许的。JMM 的规范是统一的,但它的实现却因 JVM 而异。HotSpot、OpenJ9、GraalVM 以及历史上的 JRockit 和 Azul Zing,都在 JMM 的抽象约束下,结合目标硬件架构和应用场景,做出了不同的工程选择。
理解 JMM 与 JVM 实现之间的关系,意味着理解"规范说了什么"和"实现怎么做"之间的鸿沟是如何被跨越的,以及不同实现者如何在同一套规范下走出不同的技术路线。本文将从抽象模型、核心规则、内存屏障的跨实现对比、锁机制和 JIT 优化五个层面展开。
一、JMM 的抽象模型
1.1 主内存与工作内存
JMM 将内存抽象为两部分:
- 主内存:所有共享变量(实例字段、静态字段、数组元素)都存储在这里,所有线程共享这一份。
- 工作内存:每个线程拥有一块独享的副本,线程只能在自己的工作内存上操作共享变量的副本,不能直接读写主内存。
线程之间的值传递必须绕主内存走一圈。这种抽象并不对应真实的 CPU 缓存或寄存器,而是 JMM 为了描述可见性问题而建立的逻辑模型。
1.2 同步规则
围绕主内存和工作内存,JMM 约定了三条同步规则,这也是 synchronized 语义的来源:
- 线程解锁前,必须把共享变量的新值刷回主内存。
- 线程加锁前,必须从主内存把最新值读回工作内存。
- 加锁和解锁必须使用同一把锁。
1.3 三大特性
JMM 围绕并发安全定义了三大特性:
- 原子性 :一个操作不可被中断。JMM 保证基本类型的读写是原子的(
long/double在 64 位 JVM 上通常也是原子的,但规范不强制要求)。 - 可见性 :一个线程的写入何时对另一个线程可见。
volatile保证写入立即刷回主内存,读取直接从主内存获取。 - 有序性 :编译器和处理器可以重排序指令以提高性能,但 JMM 通过
happens-before规则约束哪些重排序是允许的。
二、happens-before:JMM 的核心规则
2.1 定义
happens-before 是 JMM 定义的一组偏序关系,用于判断多线程程序中一个操作的结果是否对另一个操作可见。如果操作 A happens-before 操作 B,则 A 的执行结果对 B 可见,且 A 的执行顺序排在 B 之前。
2.2 八大规则
JLS 17.4.5 定义了以下 happens-before 规则:
- 程序顺序规则:线程内按代码顺序,前面的操作 happens-before 后面的操作。
- 监视器锁规则:对一个锁的解锁 happens-before 于随后对同一个锁的加锁。
- volatile 变量规则:对 volatile 变量的写 happens-before 于随后对该变量的读。
- 传递性规则:A → B 且 B → C,则 A → C。
- 线程启动规则 :
Thread.start()happens-before 于被启动线程中的所有操作。 - 线程终止规则 :线程中的所有操作 happens-before 于其他线程检测到该线程终止(如
join()返回)。 - 线程中断规则 :
interrupt()调用 happens-before 于被中断线程检测到中断。 - 对象终结规则 :对象的构造完成 happens-before 于其
finalize()方法的开始。
2.3 as-if-serial 与 happens-before
as-if-serial 语义保证单线程程序的执行结果不变,允许编译器和处理器在不影响单线程语义的前提下重排序。happens-before 则保证多线程程序的执行结果不变。两者都是为了在不改变程序可观测行为的前提下,尽可能提高执行效率。
当两个操作之间不存在 happens-before 关系时,JVM 可以自由地对它们进行重排序,这可能导致数据竞争(data race)。
三、内存屏障:JMM 的硬件映射
3.1 四种屏障类型
JMM 定义了四种内存屏障指令,用于控制特定操作的执行顺序和内存可见性:
| 屏障类型 | 作用 |
|---|---|
| LoadLoad | 禁止前面的读与后面的读重排序 |
| StoreStore | 禁止前面的写与后面的写重排序 |
| LoadStore | 禁止前面的读与后面的写重排序 |
| StoreLoad | 禁止前面的写与后面的读重排序(最耗时,全能型屏障) |
3.2 volatile 的屏障插入策略
JMM 为 volatile 变量定义了一套保守的屏障插入策略:
- 每个 volatile 写操作前插入 StoreStore 屏障,后插入 StoreLoad 屏障。
- 每个 volatile 读操作后插入 LoadLoad 屏障和 LoadStore 屏障。
这四类屏障的组合确保了 volatile 的可见性和有序性。
四、HotSpot 的内存屏障实现
4.1 OrderAccess 类
HotSpot 在 src/hotspot/share/runtime/orderAccess.hpp 中定义了 OrderAccess 类,提供四种原始屏障操作:loadload()、storestore()、loadstore() 和 storeload(),以及一个双向的 fence()。
不同 CPU 架构有不同的实现文件。以 x86 为例,x86 是 TSO(Total Store Order) 内存模型,硬件本身保证了 LoadLoad、LoadStore 和 StoreStore 的顺序,因此这三个屏障只需要编译器屏障即可:
cpp
inline void OrderAccess::loadload()  { compiler_barrier(); }
inline void OrderAccess::storestore() { compiler_barrier(); }
inline void OrderAccess::loadstore()  { compiler_barrier(); }
inline void OrderAccess::storeload()  { fence(); }
编译器屏障通过内联汇编 __asm__ volatile ("" : : : "memory") 实现,强制 C++ 编译器不重排内存访问。
4.2 StoreLoad 屏障的实现
只有 StoreLoad 屏障在 x86 上需要真正的硬件指令。HotSpot 使用 lock; addl $0,0(%rsp) 而非 mfence 指令。选择 lock 前缀的原因在于:mfence 在某些 CPU 上需要序列化流水线,开销较大,而带 lock 前缀的指令在 AMD64 上同样能实现 StoreLoad 语义,但通常更快。
cpp
inline void OrderAccess::fence() {
#ifdef AMD64
  __asm__ volatile ("lock; addl $0,0(%%rsp)" : : : "cc", "memory");
#endif
  compiler_barrier();
}
在 ARM 架构上,由于内存模型更弱(通常为弱序或部分序),HotSpot 的实现需要更重的屏障。以 AArch64 为例,loadload() 和 loadstore() 实现为 acquire(),storestore() 实现为 release(),而 storeload() 实现为 fence(),通常对应 dmb ish 指令。
五、其他 JVM 实现者的内存屏障策略
5.1 Eclipse OpenJ9
OpenJ9 是 Eclipse 基金会维护的 JVM 实现,源自 IBM 的 J9 虚拟机,以低内存占用和快速启动著称。在内存屏障的实现上,OpenJ9 采取了与 HotSpot 不同的策略,尤其在弱内存模型平台(如 POWER 架构)上体现了独特的优化思路。
一项针对 POWER 平台的研究对比了 OpenJDK 和 OpenJ9 在 volatile 变量访问上的内存屏障实现。POWER 架构提供了多条内存同步指令(如 lwsync、sync、isync 等),不同的组合方式对应不同的内存访问模式,开销也随之变化。研究表明,OpenJ9 在这些指令的选取和组合上采用了与 HotSpot 不同的优化策略,直接影响 Java 程序的执行速度。
OpenJ9 在具体屏障指令的实现上也有明确的选择。以 storeStoreFence 为例:
- x86 :实现为
nop(空操作),因为 x86 的 TSO 模型本身保证了 StoreStore 顺序。 - arm64 :实现为
dmb ishst。 - POWER :实现为
lwsync。
此前,该屏障通过更重量级的 storeFence 操作码实现,提供了超出必要范围的重排序保证。OpenJ9 将其拆分为更精确的 storeStoreFence,减少了不必要的开销。
此外,OpenJ9 的共享类缓存(Shared Classes Cache)技术允许多个 JVM 进程共享相同的类元数据,显著降低整体内存消耗。ROMClass 数据存储在共享内存中,多个 JVM 进程通过内存映射复用。这与内存屏障没有直接关系,但它反映了 OpenJ9 在内存管理上的整体设计哲学------通过共享和复用降低每一层的内存开销。
5.2 GraalVM
GraalVM 是 Oracle Labs 主导的多语言运行时平台,其核心是 Graal 编译器。GraalVM 在 JMM 实现上的一个显著特点是:将 JMM 的屏障规则以常量形式显式编码在编译器中。
GraalVM 的 MemoryBarriers 类定义了一组 JMM 相关的常量:
JMM_PRE_VOLATILE_READJMM_POST_VOLATILE_READJMM_PRE_VOLATILE_WRITEJMM_POST_VOLATILE_WRITEJMM_POST_VOLATILE_READ
这些常量"捕获了实现 Java 内存模型所需的、与 volatile 字段访问相关的内存屏障"。其文档直接引用了 Doug Lea 的 The JSR-133 Cookbook for Compiler Writers,表明 GraalVM 的 JMM 实现严格遵循了 JMM 规范的设计意图。
GraalVM 编译器通过 InsertMembarsPhase 阶段在 IR(中间表示)中显式插入屏障节点。当遇到 VolatileReadNode 时,在读写节点之前和之后分别插入 JMM_PRE_VOLATILE_READ 和 JMM_POST_VOLATILE_READ 屏障;对于 volatile 写,则插入 JMM_PRE_VOLATILE_WRITE 和 JMM_POST_VOLATILE_WRITE。这种显式插入的方式使屏障节点在 IR 层面可见,便于后续优化阶段进行屏障消除和合并。
GraalVM Native Image 则进一步改变了内存布局和屏障策略。Native Image 中的对象头默认仅 4 字节,远小于 HotSpot 的 8---12 字节。对象头的缩小意味着 Mark Word 中的锁状态信息存储方式发生变化,间接影响了锁的实现和相关的内存屏障插入策略。
5.3 Azul Zing(C4 垃圾回收器)
Azul Systems 的 Zing JVM 使用自研的 C4(Continuously Concurrent Compacting Collector) 垃圾回收器,替代 HotSpot 内置的 GC 实现。C4 的核心是一个称为 LVB(Loaded Value Barrier) 的读屏障,它被插入到编译和解释执行的 Java 代码中,用于在读取对象引用时检测和修复被移动的对象。
在 C4 中,读屏障承担了并发压缩和并发重映射的关键职责。当 mutator 线程读取内存时,如果发现对象已被重定位,读屏障会在读取时捕获这一条件,修复指针并继续执行,从而实现几乎无停顿的垃圾回收。这与 HotSpot 中 GC 写屏障的设计有本质区别------后者主要用于记录跨代引用,而 C4 的读屏障则直接参与对象移动的管理。
值得注意的是,C4 的读屏障与 JMM 中的内存屏障是不同层面的概念。GC 屏障负责垃圾回收器的簿记工作,JMM 内存屏障负责多线程间的内存可见性。Azul 的实现表明,一个 JVM 可以在同一套 JMM 规范下,通过完全不同的 GC 屏障设计来实现内存管理的目标。
5.4 Oracle JRockit
JRockit 是 BEA Systems 开发的 JVM,后被 Oracle 收购,现已停止维护。JRockit 以其确定性垃圾回收和低延迟著称,在 JRockit 的时代,其内存屏障的实现也体现了独特的设计。
JRockit 的写屏障与其 GC 策略紧密耦合。在 JRockit 的分代 GC 中,写屏障用于标记堆中哪些部分被写入或"弄脏"了。JRockit 还支持线程本地堆(Thread Local Heap)的概念,在这种模式下,读屏障和写屏障都需要跟踪对象是否仍然线程本地,或者是否已经暴露给其他线程。这种设计在某些嵌入式或专用 OS 层的场景中可以减少开销,但对大多数应用而言成本较高。
JRockit 对 JMM 的实现细节因缺乏公开的源码而难以深入分析,但其整体设计思路表明:内存屏障的实现与 GC 策略深度绑定,不同的 GC 设计会催生不同的屏障布局。
5.5 Android ART
Android Runtime(ART)是 Android 平台上的 Java 运行时,虽然不完全遵循标准 JMM(Android 有自己的内存模型规范),但其屏障实现值得关注。
ART 使用 Baker 读屏障来支持并发压缩 GC。在 Android 8.0 及更高版本中,读屏障被编译器优化,但在某些场景下仍可能导致性能下降。ART 的写屏障则用于维护对象图的正确性。
ART 在虚拟线程(Virtual Thread)的实现中也使用了屏障。当虚拟线程被 park 时,解释器帧可以存储在 Java 堆中,parking 和 unparking 过程中需要在原生栈和托管堆之间进行复制和读写屏障操作。这表明屏障机制在虚拟线程的栈管理中也发挥着重要作用。
六、跨 JVM 实现对比
6.1 内存屏障实现对比
| JVM 实现 | x86 StoreLoad | ARM64 屏障 | POWER 屏障 | 独特设计 |
|---|---|---|---|---|
| HotSpot | lock; addl |
dmb ish 系列 |
lwsync/sync |
OrderAccess 统一抽象 |
| OpenJ9 | nop(StoreStore) |
dmb ishst |
lwsync |
按屏障类型精确实现,共享类缓存 |
| GraalVM | JMM 常量显式编码 | 编译器 IR 插入 | 编译器 IR 插入 | InsertMembarsPhase 显式优化 |
| Zing | 依赖硬件支持 | 读屏障(LVB) | 读屏障(LVB) | C4 并发压缩 GC |
| JRockit | 不公开 | 不公开 | 不公开 | GC 屏障与内存屏障耦合 |
| ART | 读屏障 | 读屏障 | --- | Baker 读屏障,虚拟线程栈管理 |
6.2 设计哲学差异
不同 JVM 实现者在屏障设计上的差异,反映了各自的设计哲学:
HotSpot 追求通用性和可移植性 。通过 OrderAccess 类提供统一的屏障抽象,在不同架构上有不同的实现文件,但对外暴露统一的接口。这种方式便于跨平台维护,但可能在某些架构上不是最优的。
OpenJ9 追求精确和低开销 。在屏障类型上做出更精细的区分(如将 storeFence 拆分为 storeStoreFence),根据具体架构的内存模型选择最轻量的指令组合。同时,共享类缓存等技术降低了整体内存开销。
GraalVM 追求编译器层面的显式优化。将 JMM 屏障作为 IR 中的显式节点,使优化器能够在编译过程中进行屏障消除和合并。这种方式在 AOT 编译和 Native Image 场景下尤为有效。
Zing 追求低延迟和高吞吐。通过 C4 读屏障实现并发压缩,消除了 Stop-the-world 停顿,但代价是需要硬件层面的特殊支持。
JRockit 追求确定性内存管理。屏障实现与 GC 策略深度绑定,线程本地堆等特性体现了对特定场景的优化。
ART 追求移动端的资源效率。读屏障用于支持并发压缩 GC,虚拟线程的栈管理也需要屏障参与,一切设计围绕移动设备的资源约束展开。
七、HotSpot 的锁机制与 JMM 语义
7.1 对象头与 Mark Word
HotSpot 中每个对象都有一个对象头,其中包含 Mark Word(标记字)。Mark Word 存储了对象的哈希码、GC 年龄和锁状态信息,是实现轻量级锁和偏向锁的关键。
7.2 锁升级机制
JDK 6 引入了锁升级 机制,使 synchronized 在无竞争或低竞争场景下性能接近无锁操作:
- 无锁:对象刚创建,Mark Word 记录哈希码等信息。
- 偏向锁:第一次加锁时通过 CAS 将线程 ID 写入 Mark Word。此后同一线程加锁/解锁无需任何原子操作。
- 轻量级锁:当另一个线程尝试获取偏向锁时,偏向锁撤销,升级为轻量级锁。线程通过 CAS 自旋尝试获取锁,不阻塞。
- 重量级锁 :自旋失败或竞争加剧时,升级为重量级锁,线程进入
ObjectMonitor等待队列,通过futex等系统调用挂起。
锁可以升级,但不能降级。JDK 15 废弃偏向锁,JDK 18 正式移除,反映了现代应用中锁竞争模式的变化。
7.3 锁与 happens-before 的对应
HotSpot 的 monitorenter 和 monitorexit 字节码指令实现了 JMM 的监视器锁规则。在解释器中,monitorenter 会在获取锁后执行 acquire 语义(LoadLoad + LoadStore 屏障),确保工作内存中的副本失效并从主内存重新加载;monitorexit 会在释放锁前执行 release 语义(StoreStore + StoreLoad 屏障),确保修改刷回主内存。在 JIT 编译后的代码中,这些屏障会被进一步优化,但语义不变。
八、JIT 编译器:JMM 的最终执行者
8.1 JIT 必须遵守 JMM 规则
JIT 编译器(HotSpot 中主要为 C1 和 C2,GraalVM 中为 Graal)在进行指令重排序、寄存器分配和循环优化时,必须遵守 JMM 的约束。具体来说,它在处理 MONITORENTER、MONITOREXIT、volatile 变量访问和 final 字段时必须特别小心。
8.2 禁止重排序
JIT 编译器可以在单线程语义不变的前提下自由重排指令。但当涉及 volatile 访问或锁操作时,JIT 必须在生成的机器码中正确插入内存屏障。例如,一个 volatile 写之后不能将后续的普通写重排到 volatile 写之前,因为这会破坏 happens-before 语义。
8.3 屏障省略优化
JIT 并非总是需要插入完整的屏障。在某些情况下,它可以安全地省略屏障:
- 写后读同一 volatile 变量:如果线程在写 volatile 变量后立即读同一变量,中间的 StoreLoad 屏障可能被省略。
- 锁消除:如果逃逸分析证明某个锁对象不会被其他线程访问,JIT 可以完全消除该锁及其相关的屏障。
- G1 屏障的晚期展开:JEP 475 将 G1 垃圾收集器的写屏障从编译早期推迟到晚期展开,允许 C2 在更充分了解代码结构后决定是否省略屏障。
8.4 屏障插入的时机
C2 编译器在将字节码解析为 IR 时,会在遇到 volatile 访问和锁操作时插入相应的屏障节点。在后续的优化阶段,这些屏障节点可能被消除或合并。最终在代码生成阶段,它们被展开为具体的机器指令(如 x86 上的 lock; addl)。
GraalVM 的编译器则通过 InsertMembarsPhase 在 IR 构建阶段显式插入 MembarNode,随后在优化阶段对屏障节点进行消除和合并。这种显式的方式使屏障优化更加透明和可控。
九、总结
JMM 与 JVM 实现之间的关系,可以概括为 "规范定义边界,实现填充细节" :
- JMM 规范 定义了
happens-before规则、四种内存屏障类型和 volatile 的屏障插入策略。它是统一的,所有 JVM 实现都必须遵守。 - HotSpot 通过
OrderAccess类将屏障映射为硬件指令:在 x86 上仅需 StoreLoad 硬件屏障,在 ARM 上需要更重的dmb指令。 - OpenJ9 在屏障类型上做出更精细的区分,针对不同架构选择最轻量的指令组合,并通过共享类缓存降低整体内存开销。
- GraalVM 将 JMM 屏障以常量形式显式编码在编译器中,通过
InsertMembarsPhase在 IR 层面插入和优化屏障节点。 - Azul Zing 通过 C4 读屏障实现并发压缩 GC,以硬件层面的特殊支持换取低延迟。
- Oracle JRockit 将内存屏障与 GC 策略深度绑定,线程本地堆等特性体现了对确定性内存管理的追求。
- Android ART 在移动端资源约束下,使用 Baker 读屏障支持并发压缩 GC,并为虚拟线程的栈管理引入新的屏障需求。
规范与实现之间的鸿沟,正是不同 JVM 实现者施展工程智慧的战场。同一套 JMM 规范,在 HotSpot、OpenJ9、GraalVM 和 Zing 中走出了不同的技术路线,服务于不同的应用场景和硬件平台。理解这些差异,有助于在选型时做出更明智的决策------知道什么场景下 OpenJ9 的低内存占用更关键,什么场景下 GraalVM 的 AOT 编译更有优势,什么场景下 Zing 的低延迟不可替代。
AI 创作标识:本文由人工智能生成,仅供学习与参考。