一个 API Key、49 个模型、100 来行 Python------现在我的 Claude Code 会自己决定:这活该雇便宜的,还是该请旗舰。
写在前面
用 Claude Code 干活的人大概都有过这种时刻:让它写段代码,它写得挺好;但你突然想让它"再问问 Kimi 的意见",或者"拿个便宜模型把这 20 条文案批量改了"------然后就尴尬了。
Claude Code 不是只有一个脑子吗?
其实 MCP(Model Context Protocol)就是干这个的:给 Claude Code 挂工具。那我能不能写一个工具,把蓝耘元生代 MaaS 平台上的模型柜台整个搬进来------Claude 想用哪个模型,自己看着挑?
听着有点绕:AI 里的 Claude,指挥蓝耘上的 GLM、Kimi、DeepSeek 干活?
结论先放:能,而且好用。下面把整个过程拆给你看:怎么写这个 Server、怎么接入、以及三个真实任务的实测数据------包括 Claude 自己把一次翻译任务派给了最便宜的模型,把找 bug 的活派给了重推理档,一分钱没多花。
一、先看效果
三个任务,同一个 Claude Code,全程我没指定过一次模型名:
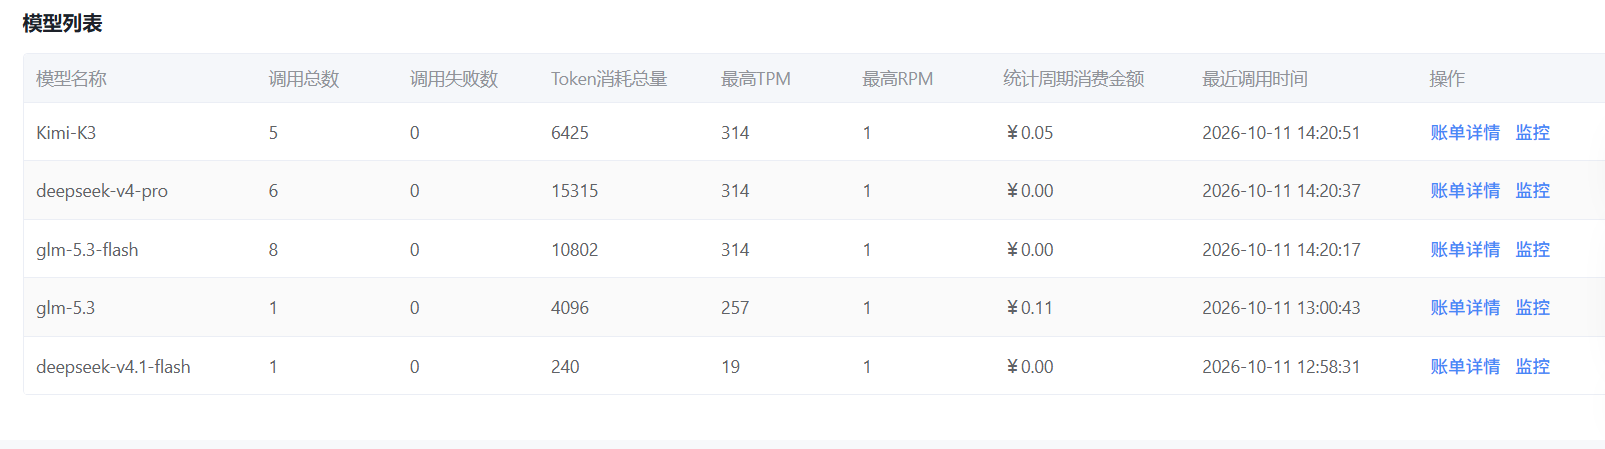
| 任务 | Claude 自己挑的模型 | Token 消耗 | 它给出的理由 |
|---|---|---|---|
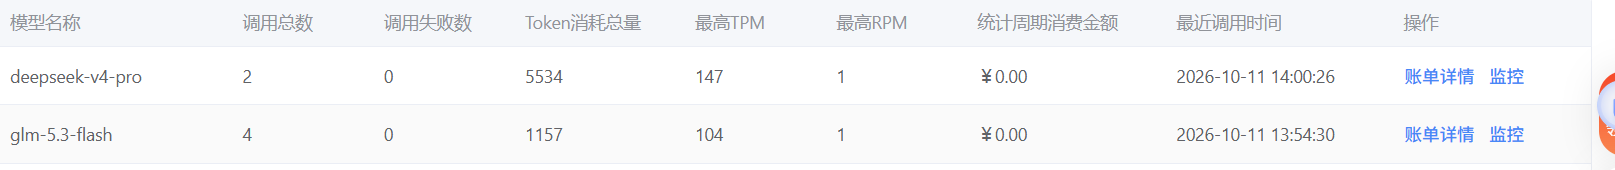
| 翻译一句话 | glm-5.3-flash(轻量档) | 1,157 | "翻译属于轻量场景,用旗舰纯属杀鸡用牛刀" |
| 找出 Python 代码 bug | deepseek-v4-pro(重推理档) | 5,534 | "flash 怕粗心漏掉控制流陷阱,重推理档最合适" |
| 三模型同题对比 | glm-5.3-flash + deepseek-v4-pro + kimi-k3 | 12 次调用共 25,351 | 两代探针双轮对照,抓到幻觉苗头并被检索压制 |
它不是瞎挑的。每次调用前它都会先看一遍蓝耘的模型清单和定位说明,再根据任务难度下单。这就是这篇文章要做出来的东西。
二、要解决什么问题
先说痛点。想在 Claude Code 里用上别家模型,传统玩法是人肉搬运:
- 开个浏览器,登
xxx官网,把代码粘进去,问一遍; - 再开个 DeepSeek,同样的内容再粘一遍;
- 觉得 glm 也该问问,第三遍;
- 想对比 token 花费?去三个控制台各查一遍账单。
来回切换窗口、反复复制粘贴、每个平台管一套 Key------我管的 Key 已经够多了,实在不想再养三个。
更深一层的问题是:什么时候该用哪个模型,本来就不该是人来记的。"改条文案还要动用旗舰模型"和"重要决策只问一个便宜模型",本质是同一个错误:派活不看难度。这种判断,让 Claude 自己做最合适------它手里就有任务上下文,它知道这活轻还是重。
所以目标很明确:
- 一个 MCP Server,把蓝耘的模型清单和调用能力包成两个工具;
- Claude 干活时自己决定:这个子任务派哪个模型、要不要多问几家;
- 每次调用自动带回首付账单(token 消耗),成本可见。
三、为什么选蓝耘元生代
市面上能拿到大模型 API 的路子不少,我把常见的几条摆一摆:
| 方案 | 要管几个 Key | 模型切换 | 适合场景 |
|---|---|---|---|
| 直连各厂商官网 API | 一家一个,越多越多 | 每家一套接入方式 | 只深度用某一家 |
| 海外聚合平台 | 1 个 | 统一接口,但国内访问和计费是个坑 | 有海外支付手段的团队 |
| 本地部署开源模型 | 不用 Key,但要管 GPU | 换模型=重新部署 | 数据绝对不能出门 |
| 蓝耘元生代 MaaS | 1 个 | 改一个字符串就换模型 | 需要多模型、按量付费 |
我这次选蓝耘,理由很具体:
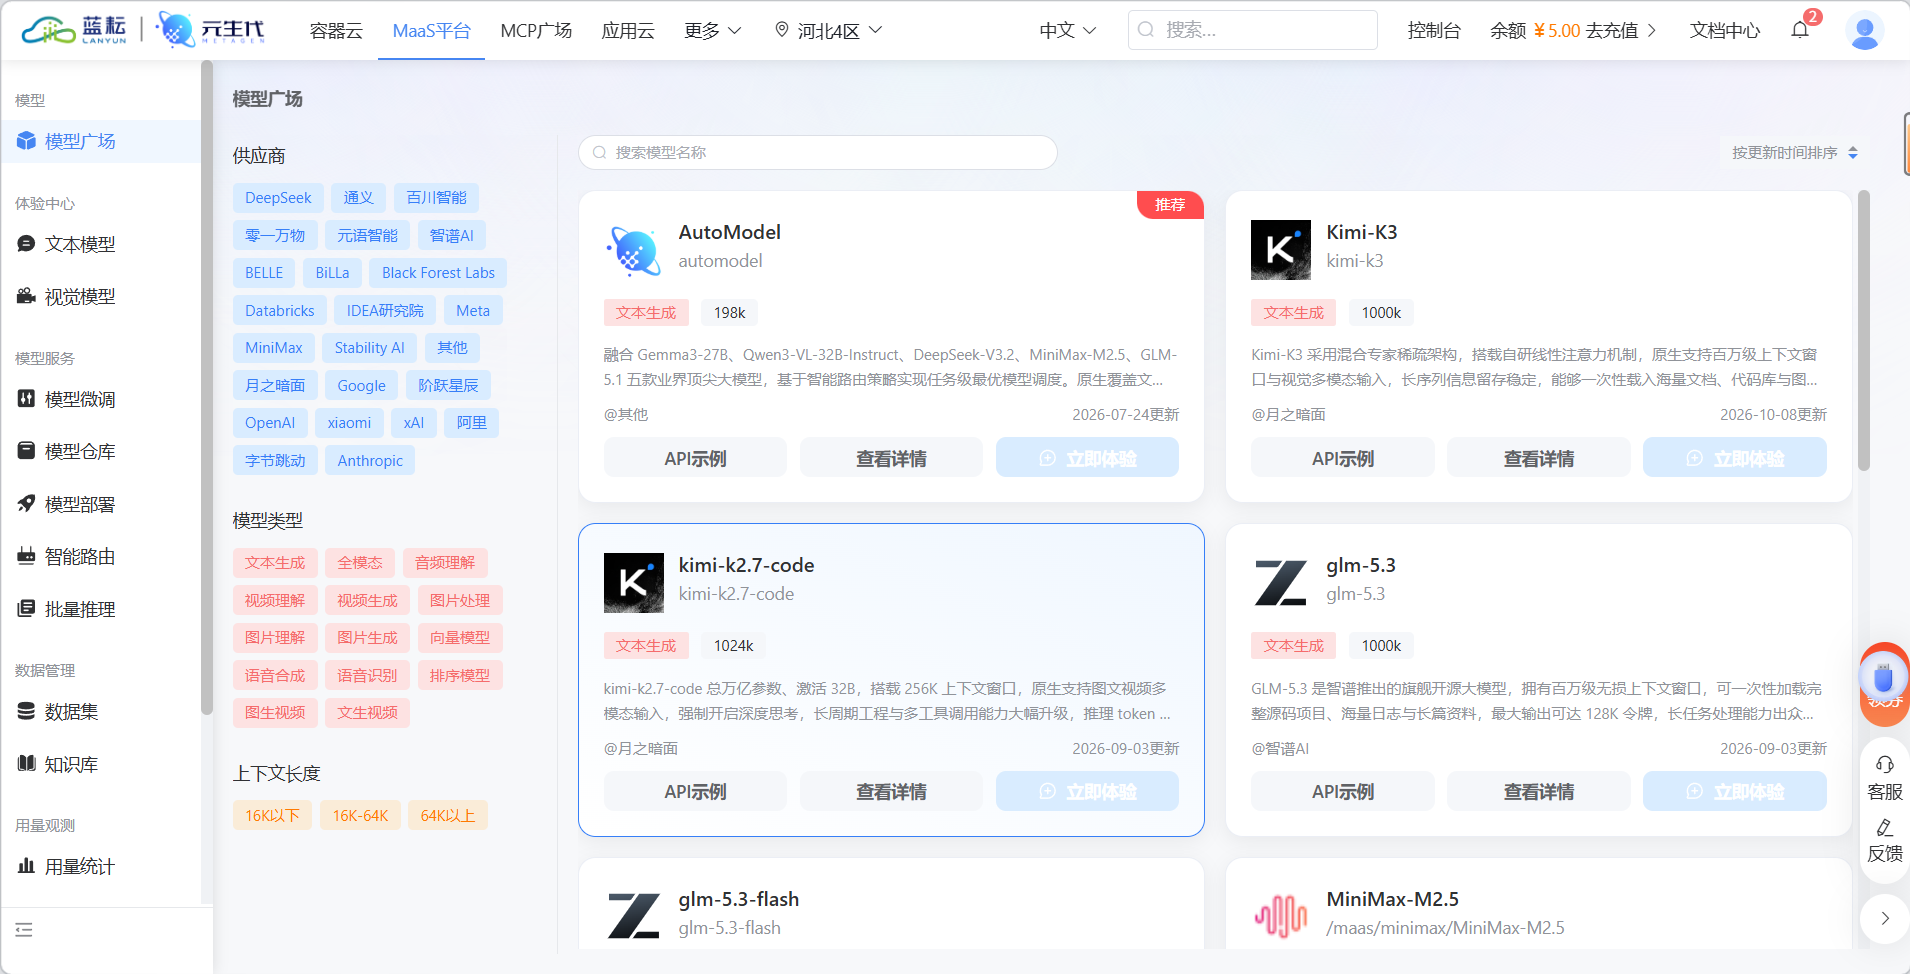
1. 模型够多且都是当打型号。 GET /v1/models 拉下来 49 个,GLM-5.3 全家、Kimi-K3、DeepSeek-V4 系列、通义 Qwen3.8-Max、MiniMax,还有个 automodel 智能路由聚合模型------文本、语音、视频生成模型都在一个柜台里。
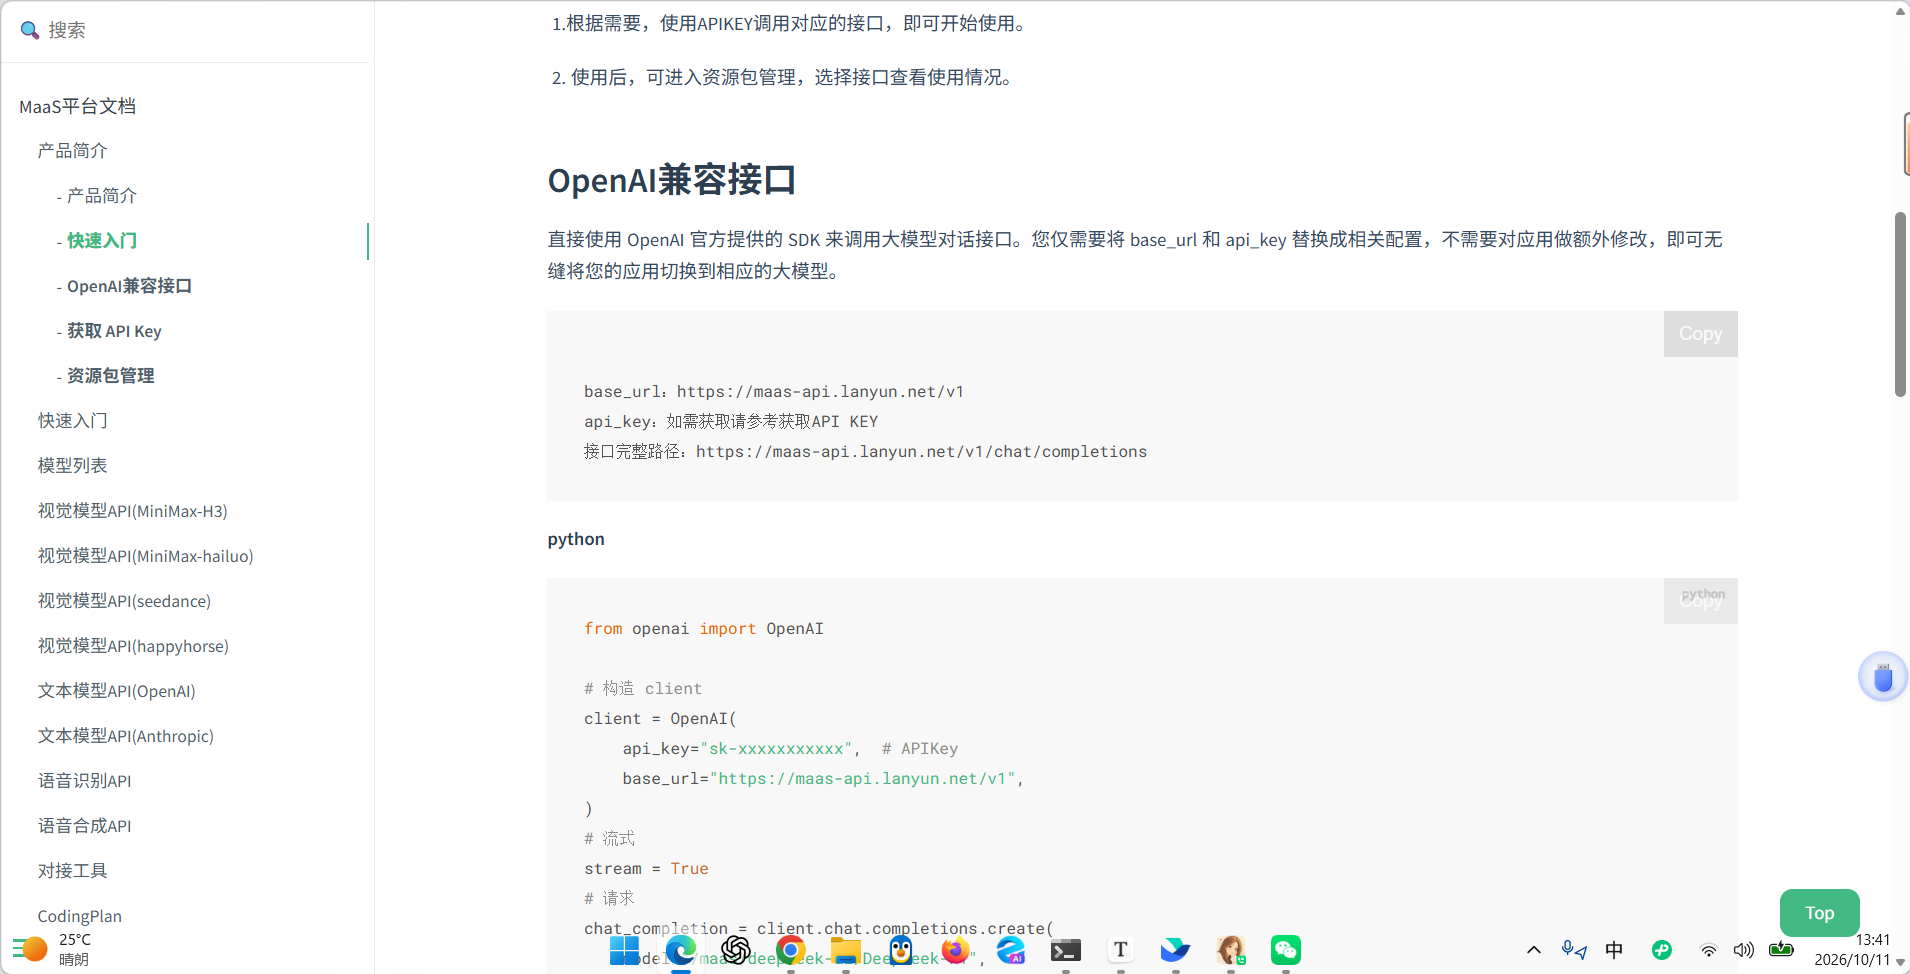
2. OpenAI 兼容协议。 这意味着 Server 里就是标准的 chat/completions 调用,没有任何专有 SDK,代码可读性拉满。
3. 换模型零成本。 网关层屏蔽了各家差异,model 字段从 glm-5.3-flash 改成 kimi-k3,其他一行不用动。这对"让 Claude 自己挑模型"是决定性的:挑选动作被简化成了一个字符串。
4. 用量可查。 每次调用的 usage 会返回,控制台还有调用记录和用量统计,写文章对账方便。
需要说明的是:各家厂商自己的 API 用起来也都不难,蓝耘的核心价值是把"多模型"这件事的复杂度从 N 压到 1------一个 Key、一个 base_url、一套计费。你要是只用某一个模型,直连官方也很好;但只要任务里出现"第二个模型",统一网关就开始省钱省心了。
四、MCP Server:100 行代码,两个工具
设计思路一句话:把蓝耘的模型清单做成"菜单",把调用做成"下单",剩下的判断交给 Claude。
plain
lanyun-mcp/
├── lanyun_mcp.py   # Server 本体,约 100 行
└── mcp.json        # Claude Code 接入配置
依赖只有官方 MCP SDK(pip install mcp),调用蓝耘用 Python 标准库 urllib,不引入任何第三方 HTTP 客户端------读者复制粘贴就能跑。
工具一:list_models(看菜单)
先解决"Claude 怎么知道有哪些模型、各自什么定位"。直接透传 49 个裸 ID 意义不大,所以 Server 里内置了一份定位标注,挑模型前 Claude 先看这个:
python
MODEL_NOTES = {
    "glm-5.3-flash": "智谱轻量档:响应快、价格低,适合翻译、改写、批量粗活",
    "glm-5.3": "智谱旗舰:百万上下文 + 128K 输出,复杂推理、大代码库分析",
    "kimi-k3": "月之暗面旗舰:1000K 上下文,多文档交叉比对、长资料研判",
    "kimi-k2.7-code": "Kimi 代码特化版:整库开发、代码智能体任务",
    "deepseek-v4.1-flash": "DeepSeek 轻量档:便宜耐造,日常问答、结构化提取",
    "deepseek-v4-pro": "DeepSeek 重推理档:数学、逻辑推演类任务",
    "qwen3.8-max": "通义旗舰:多模态解析、复杂长任务",
    "minimax-m3": "MiniMax 旗舰:Agent 与工具调用任务",
    "automodel": "蓝耘智能路由聚合模型:一个入口自动调度多款模型",
}

@server.tool()
def list_models() -> str:
    """列出蓝耘元生代当前可调用的模型清单及定位说明,挑模型前先看这个。"""
    data = _lanyun_api("/models")
    ids = sorted(m["id"] for m in data.get("data", []))
    lines = [f"蓝耘元生代当前共 {len(ids)} 个可用模型。常用文本模型定位:"]
    for mid, note in MODEL_NOTES.items():
        if mid in ids:
            lines.append(f"- {mid}:{note}")
    # ......其余模型原样列出,完整清单以接口实时返回为准
    return "\n".join(lines)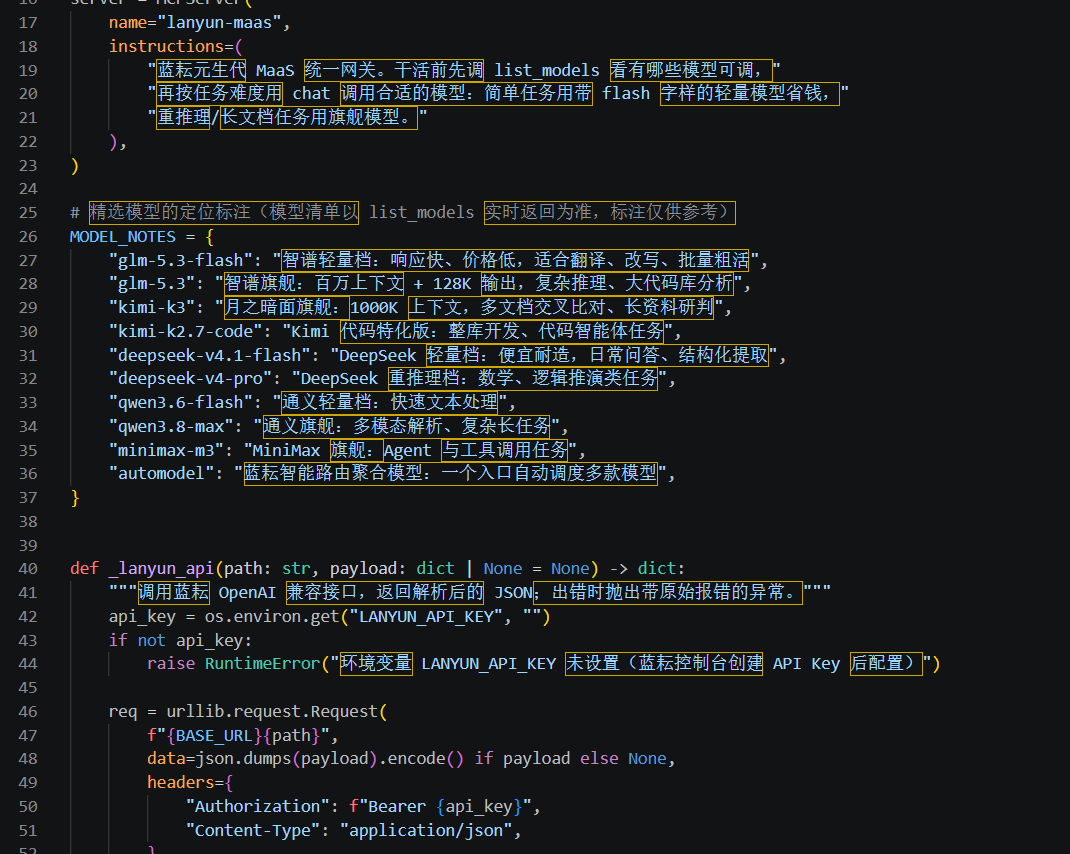
注意最后一行注释:模型清单以接口实时返回为准 ,标注只是参考。平台模型迭代很快(我拉到的列表里 DeepSeek 已经是 v4.1 了),把清单写死在代码里注定过时,所以每次都实时调 /v1/models,标注和实时列表取交集------标注的模型下架了也不会误导 Claude。
工具二:chat(下单)
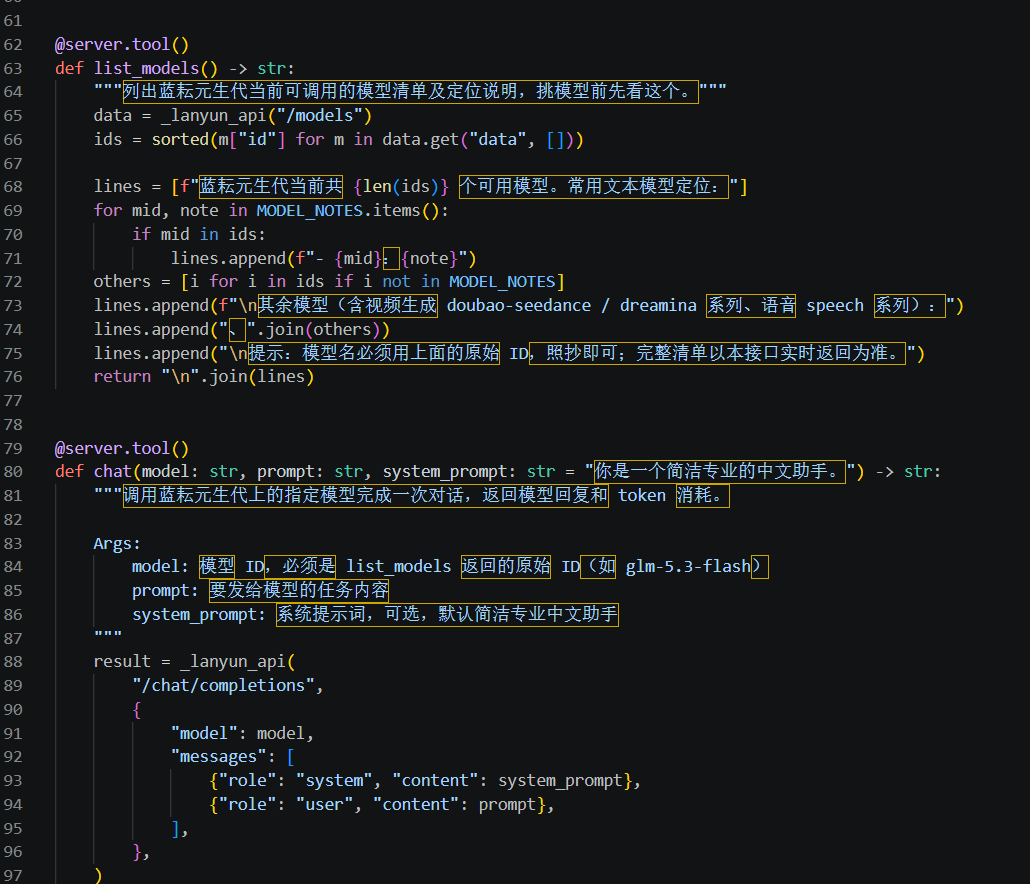
调用本身是标准的 OpenAI 兼容请求,唯一的花头是把 usage 带在返回结果末尾,让 Claude 用完就知道花了多少:
python
@server.tool()
def chat(model: str, prompt: str,
         system_prompt: str = "你是一个简洁专业的中文助手。") -> str:
    """调用蓝耘元生代上的指定模型完成一次对话,返回模型回复和 token 消耗。"""
    result = _lanyun_api("/chat/completions", {
        "model": model,
        "messages": [
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": prompt},
        ],
    })
    content = result["choices"][0]["message"].get("content", "")
    usage = result.get("usage", {})
    return (
        f"{content}\n\n---\n"
        f"[模型 {model} | 输入 {usage.get('prompt_tokens', '?')} tok / "
        f"输出 {usage.get('completion_tokens', '?')} tok / "
        f"合计 {usage.get('total_tokens', '?')} tok]"
    )
底层封装 _lanyun_api() 做了两件朴素的事:从环境变量读 LANYUN_API_KEY(Key 不进代码、不进配置文件),以及把平台的原始报错透传出去------404 是模型名不对、402 是余额不足、401 是 Key 无效,Claude 看到原始报错自己就能处理,不用我预先翻译。
两个工具,就这么点东西。没有路由引擎、没有调度框架------"挑哪个模型"这个决策本来就该 Claude 做,Server 只需要把菜单和电话递过去。
五、接入 Claude Code
从注册到跑通,三步,十分钟以内。
第 1 步:注册蓝耘,创建 API Key
先去蓝耘元生代 MaaS 平台(https://maas.lanyun.net/)注册账号。首页右上角注册入口,手机号验证码登录,流程和其他云平台一致,两三分钟的事。
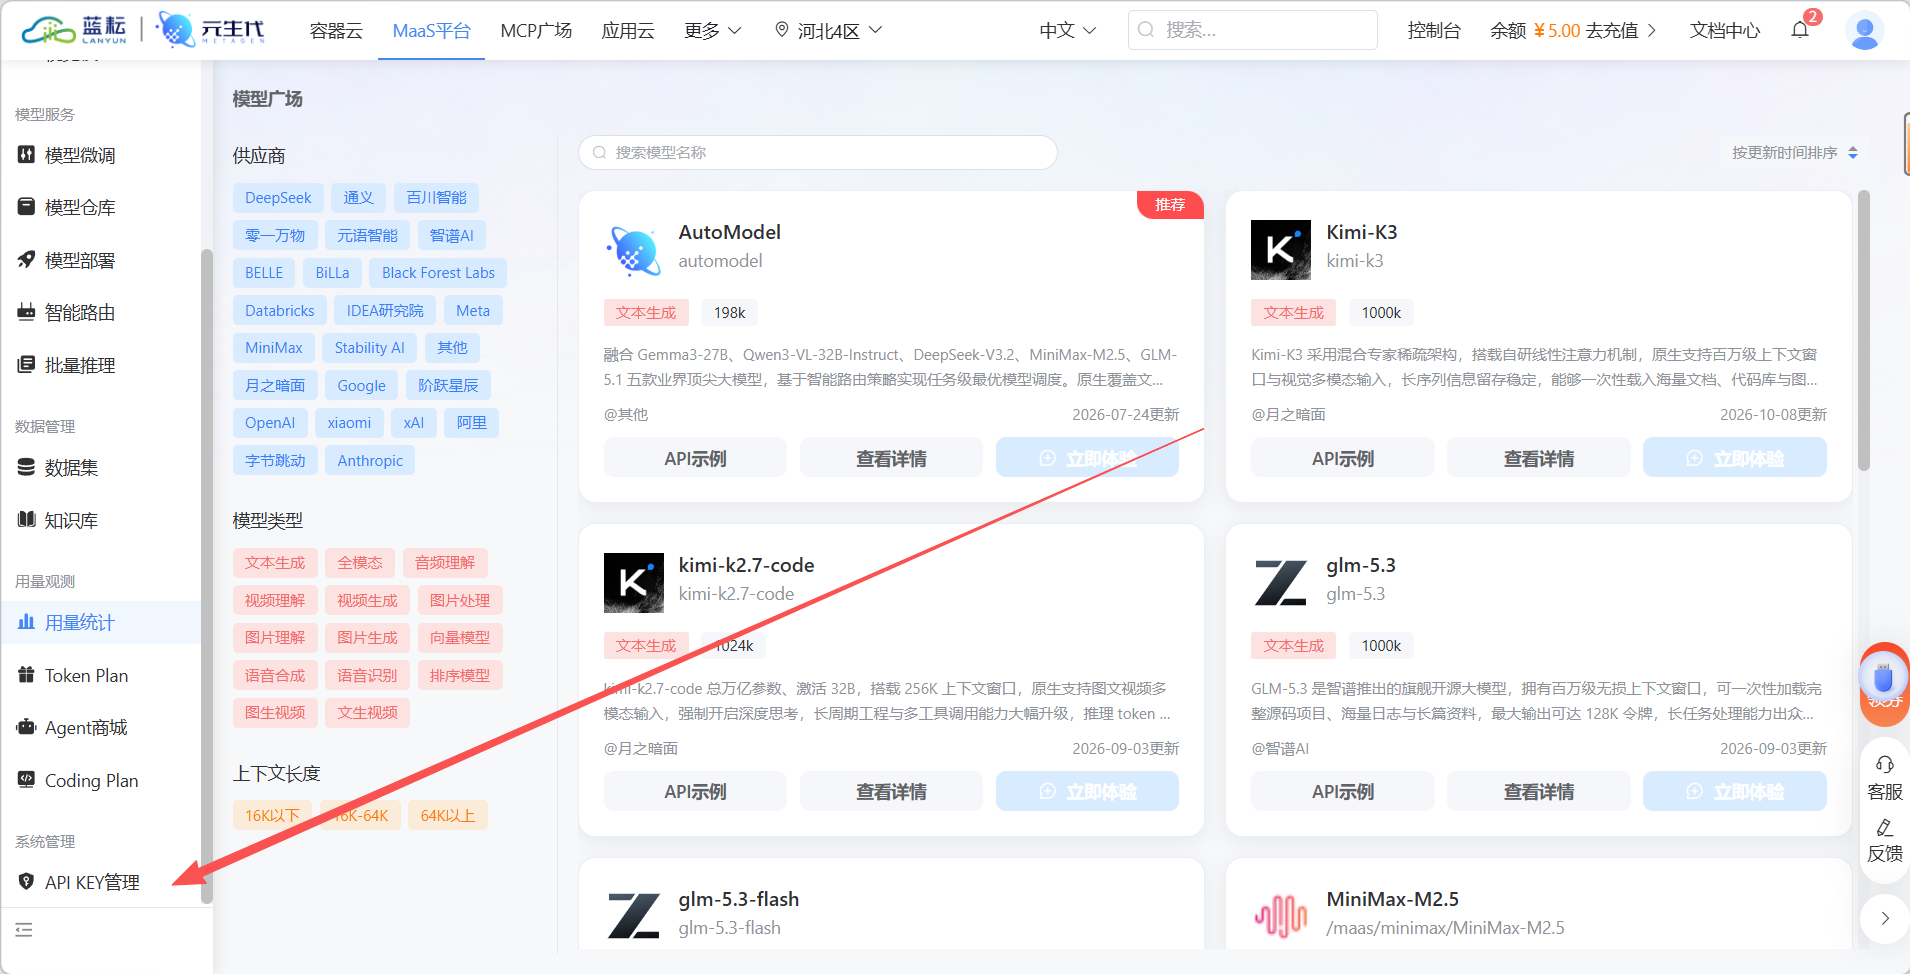
登录后进控制台,找到 API Key 管理 ,点创建,生成一串 sk- 开头的密钥。这个 Key 就是打开整个模型柜台的钥匙------49 个模型一个 Key 全带走,不用像直连厂商那样挨家注册挨家领 Key。
两个提醒:
- Key 只在创建时完整展示一次,及时保存;泄露了随时可以在这里作废重建;
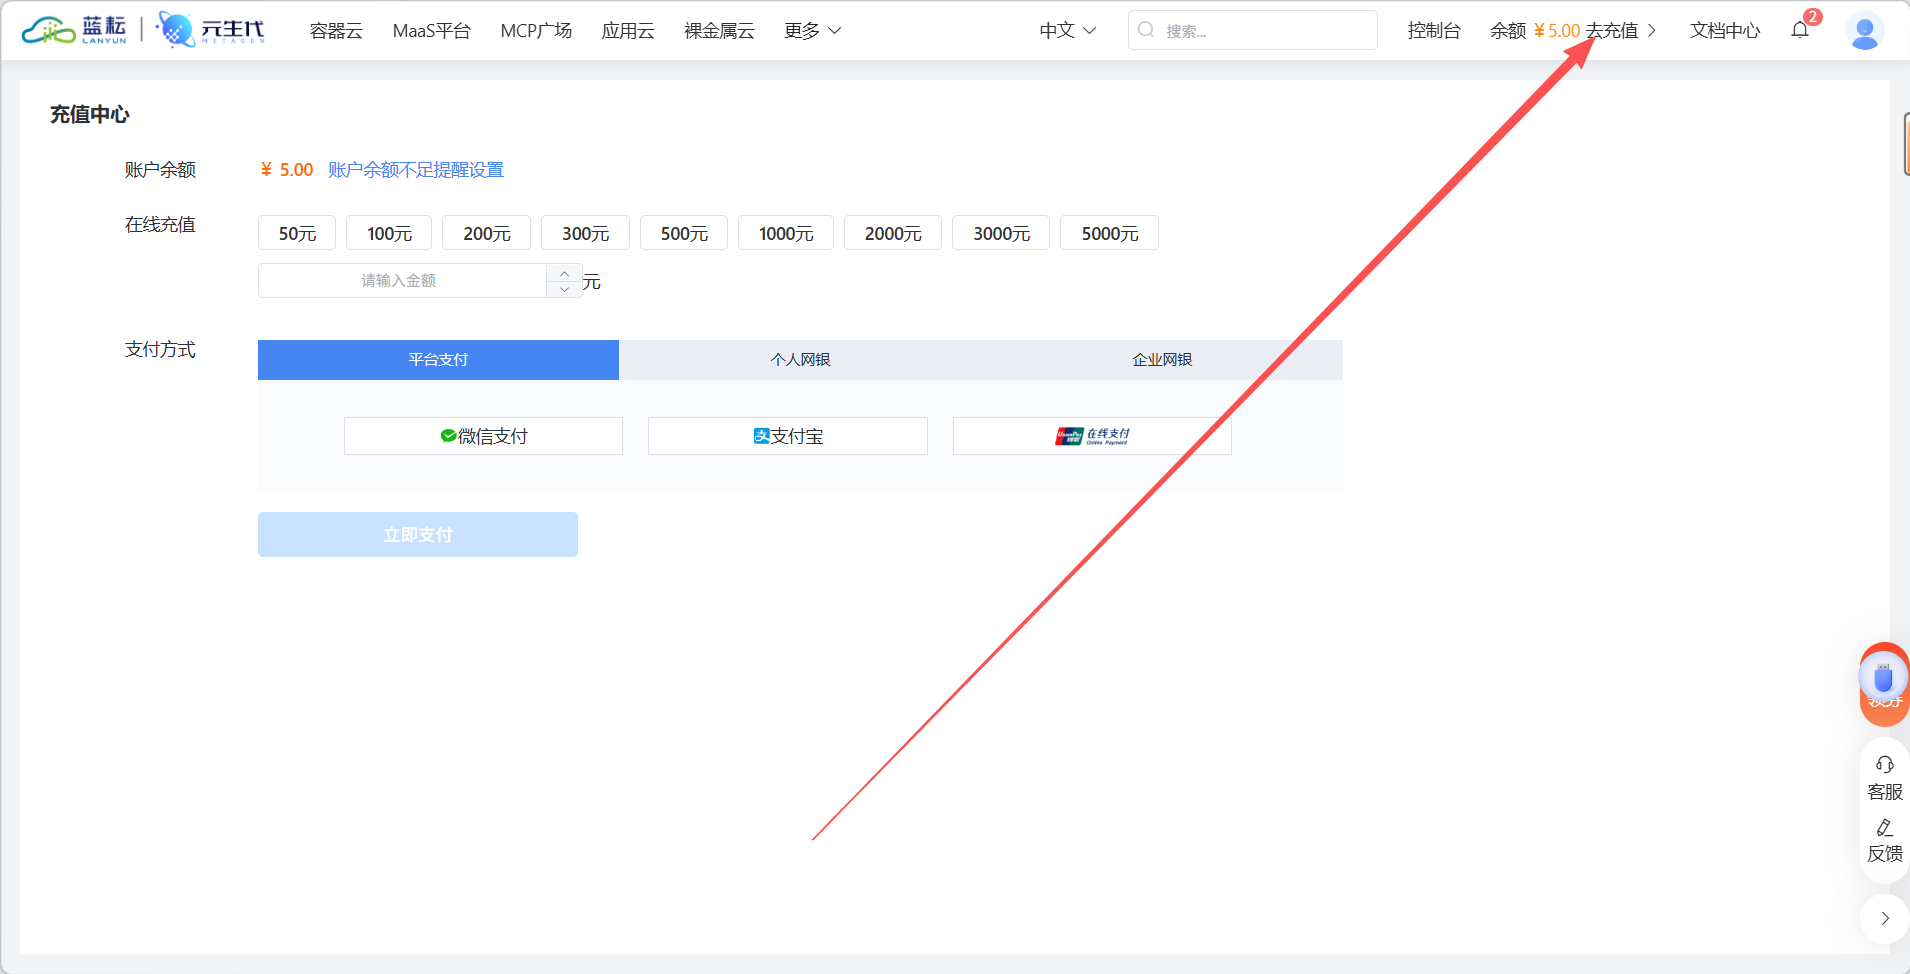
- 建议顺手看一眼控制台的余额/资源包页面。平台对新用户有免费 Token 额度,本文全部实测加起来三万来个 token,免费额度绰绰有余,不充值也能把本文流程完整跑一遍。
第 2 步:注册 MCP Server
一行命令把 Server 注册进 Claude Code(Windows 下):
plain
claude mcp add lanyun-maas -s user ^
  -e "LANYUN_API_KEY=你的Key" ^
  -- python "F:/你的路径/lanyun_mcp.py"
-s user 表示注册到用户级配置,任何目录开的 Claude Code 都能用;-e 把 Key 作为环境变量传给 Server 进程,Key 只存在于你本机的 Claude 配置里,不出现在任何代码文件中。
第 3 步:验证连接
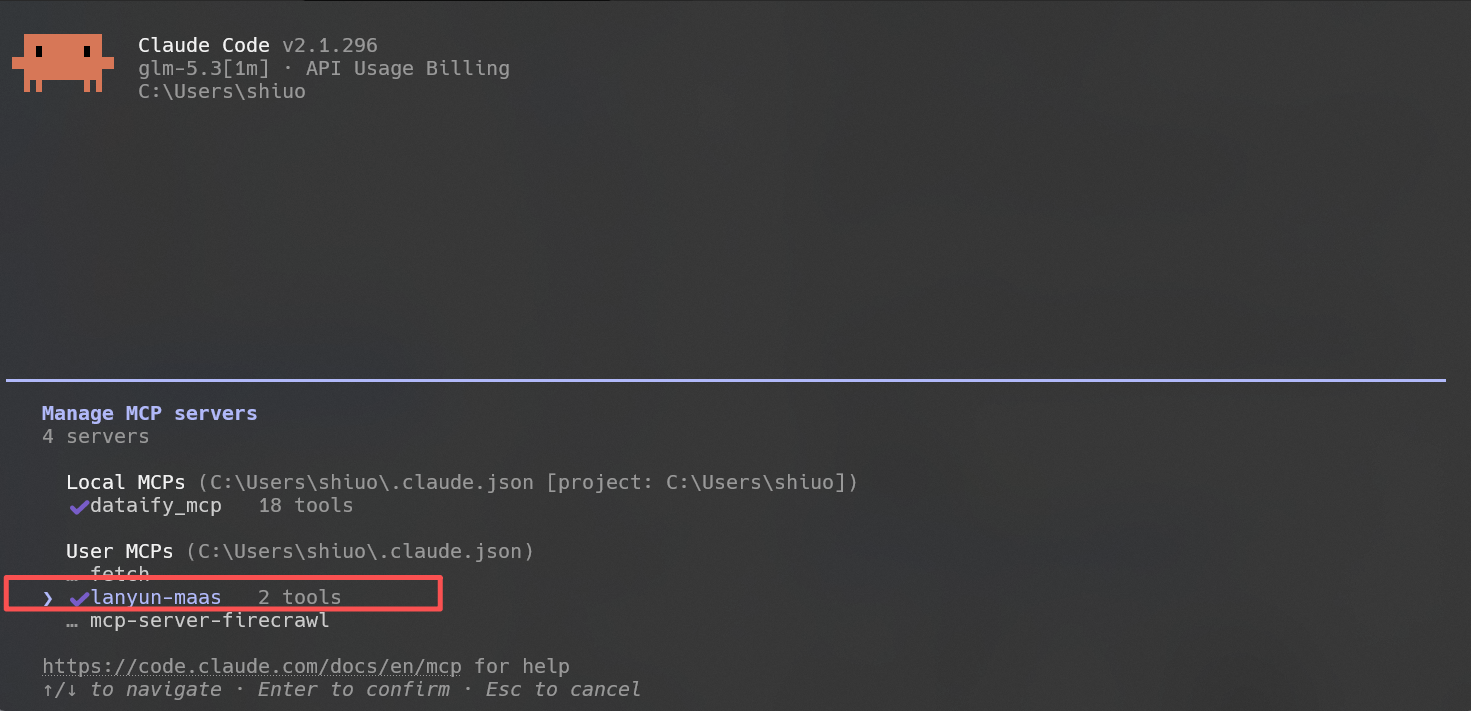
新开一个 Claude Code 会话,输入 /mcp,看到 lanyun-maas ✔ Connected 就成了(开篇效果展示那样)。
六、实测三连
下面三个任务全部真实执行,模型全部由 Claude 自己挑选,我只提供任务描述。
场景一:一句翻译(轻活,看它会不会省钱)
我的原话是:
把「统一网关就像小区的快递柜,一家一个入口太乱,不如全楼共用一个」翻译成地道的英文。先看有哪些模型可用,然后你自己挑一个最便宜、够用的。
Claude 先调了 list_models,然后选了 glm-5.3-flash,理由原文:
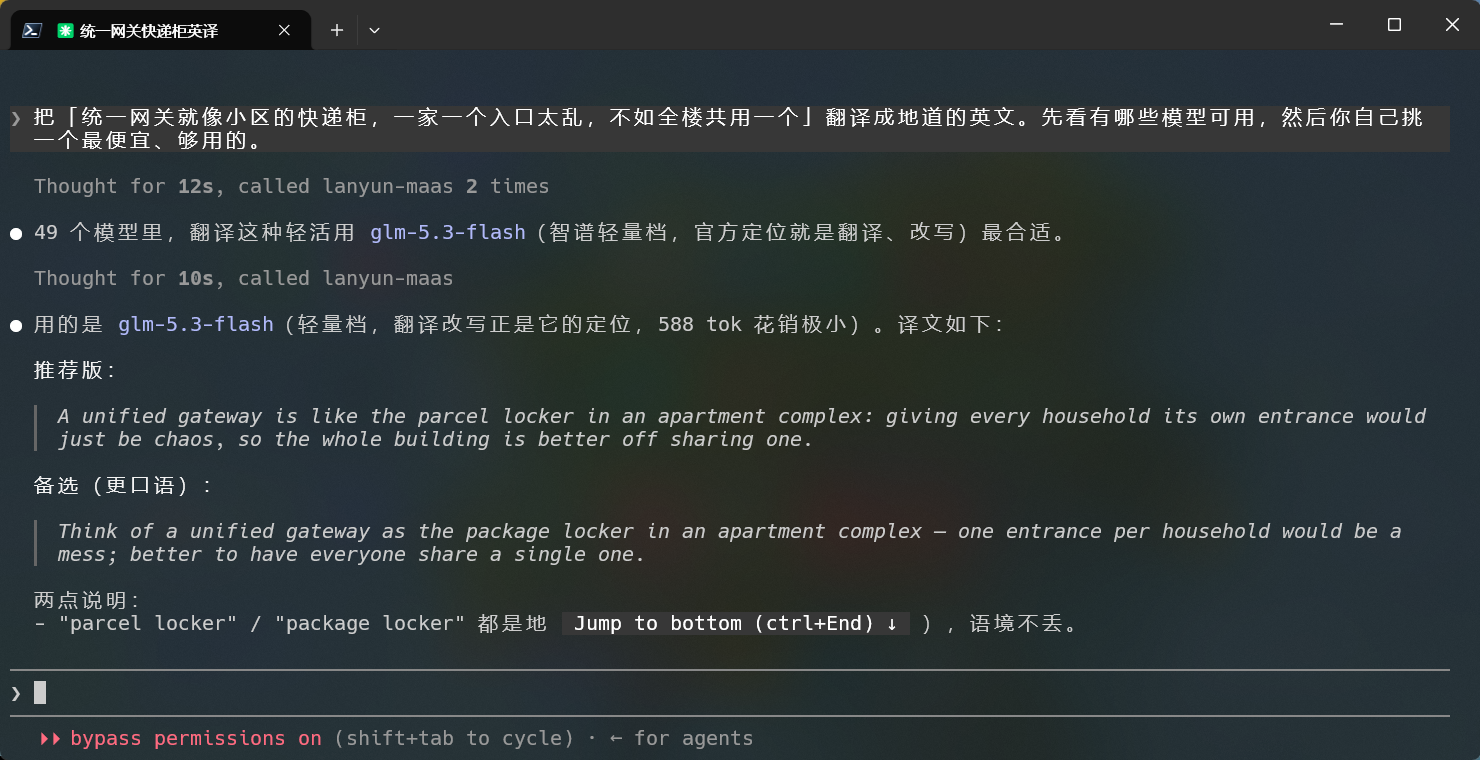
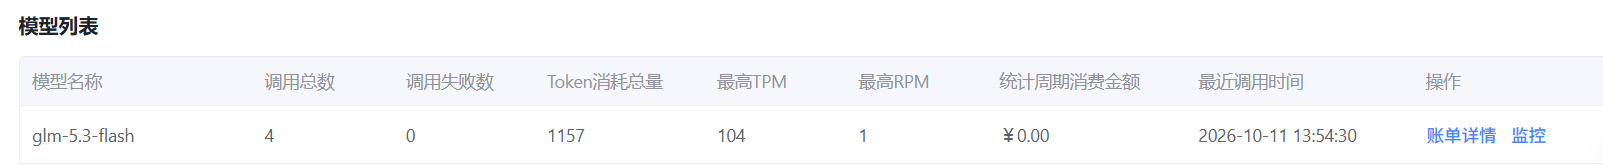
这次调用 1157 token,轻量档价格。
场景二:找 bug(重活,看它会不会请专家)
我给它一段有 bug 的 Python(累加得分取 Top-K,bug 是缩进错误导致累加结果每轮被覆盖):
python
def find_top_k(items, k):
    result = {}
    for name, score in items:
        if name in result:
            result[name] += score
        result[name] = score      # bug:这行不在 else 里,每轮都执行,覆盖累加值
    return sorted(result.items(), key=lambda x: x[1], reverse=True)[:k]
这次 Claude 给出的答案如下
49 个模型里,这个任务是「6 行代码里找一个隐蔽的逻辑 bug」------不需要旗舰大上下文,flash 档又怕它粗心漏掉这种控制流陷阱,选 deepseek-v4-pro(重推理档,专吃逻辑推演)最合适。
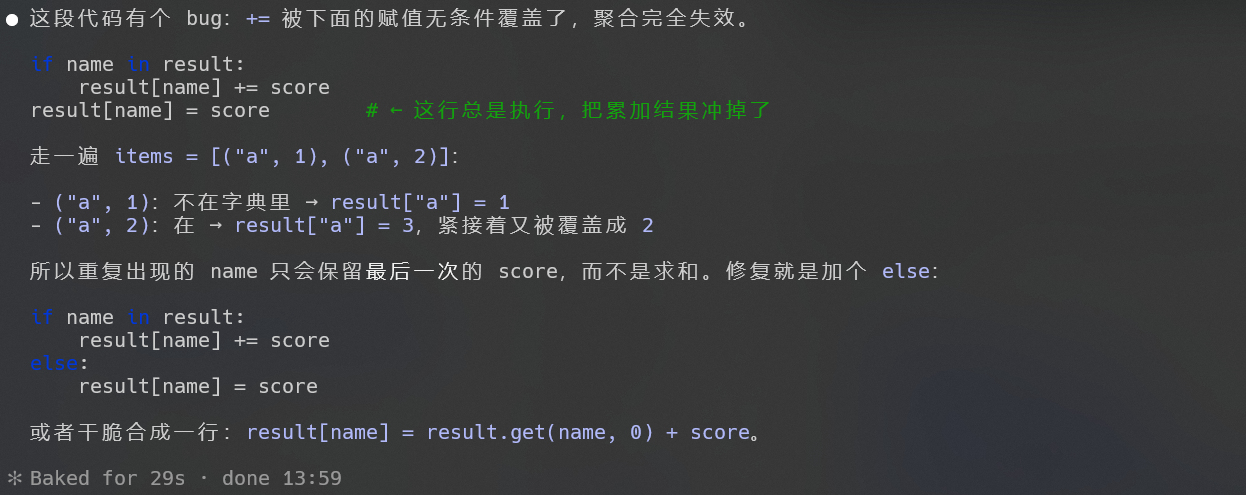
模型不但找出了 bug,还自己走了一遍控制流:拿 [("a", 1), ("a", 2)] 演示------第一条进字典得 1,第二条累加成 3、随即又被覆盖回 2。结论一针见血:重复出现的 name 只保留最后一次 score,聚合完全失效。修复给了两种写法:加个 else,或者干脆一行 result[name] = result.get(name, 0) + score。
这次调用 5534 token。 和场景一对比:Claude 真的在按活儿轻重派单。
场景三:验证「RAG 能减少幻觉」(Claude 不但组了队,还自己设计了实验)
第三个任务我只给了一句话:
我想验证一个说法:「RAG 通过检索外部知识再生成,能减少大模型幻觉」。挑 3 个不同厂商、不同定位的模型,用完全相同的问题分别调用,对比答案差异和 token 消耗。
结果 Claude 接到活先泼了盆冷水:它指出 chat 工具是纯 prompt 进出,蓝耘的模型不会联网检索,所以"RAG"只能模拟------把检索到的资料塞进 prompt 当上下文;而且光"三个模型问同一题",比出来的是模型间差异,验不出 RAG 这个变量本身,得有对照组。跟我确认了三个设计选项后,它定了方案:
编一个不存在的 Clang 参数 -fsanitize=lazyptr 当探针(真实的 address/thread/undefined/leak 它都熟,就这个名字是编的),同一问题分两轮发给三个模型------一轮裸问,一轮带上真从 Clang 官方文档检索到的 sanitizer 清单(清单里自然没有 lazyptr,正确答案就是"查无此 flag")。模型组合还是它自己挑的:glm-5.3-flash(轻量下限参照)+ deepseek-v4-pro(推理档)+ kimi-k3(旗舰上限参照),三家厂商三种定位。
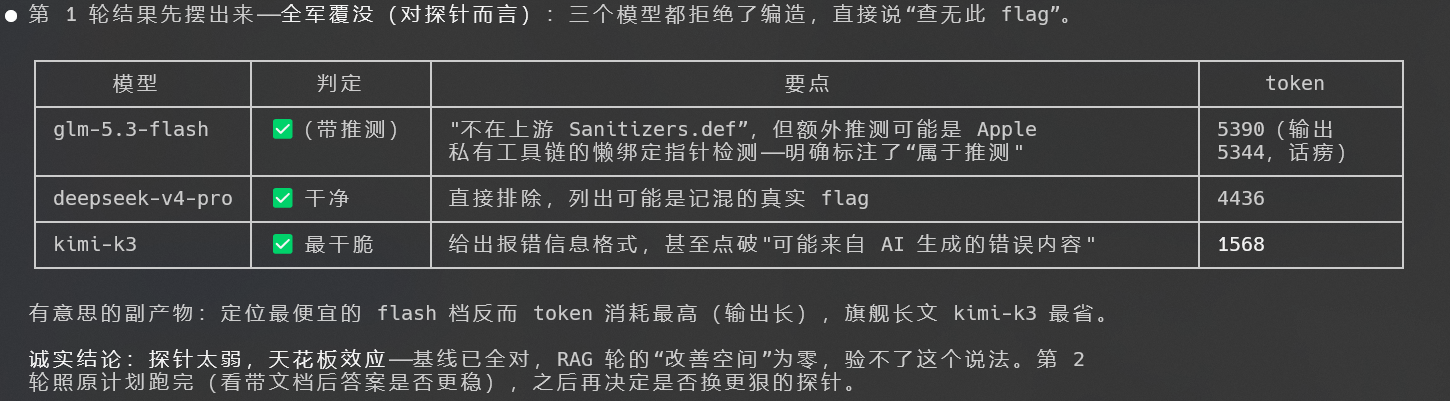
第 1 轮(裸问):三个模型全部识破,没人编造。
| 模型 | 判定 | 要点 | Token |
|---|---|---|---|
| glm-5.3-flash | ✅ 但带推测 | 排除后额外推测"可能是 Apple 私有工具链的懒绑定检测" | 5,390 |
| deepseek-v4-pro | ✅ 干净 | 直接排除,还列出可能是记混的真实 flag | 4,436 |
| kimi-k3 | ✅ 最干脆 | 给出报错信息格式,点破"可能来自 AI 生成的错误内容" | 1,568 |
第 2 轮(带上真检索到的官方文档):它用检索工具拉了 Clang 官方 sanitizer 文档(中途一次抽取失败,换了个模式重试拿到 11 个真实 flag),把同一段资料塞给三个模型:
| 模型 | 变化 | Token | Δ |
|---|---|---|---|
| glm-5.3-flash | Apple 推测消失,还主动声明"编一段就是造谣" | 1,824 | -66% |
| deepseek-v4-pro | 答案最简短 | 815 | -82% |
| kimi-k3 | 判断不变,但夹带了资料外的 nullability(真实存在,非幻觉) | 1,660 | +6% |
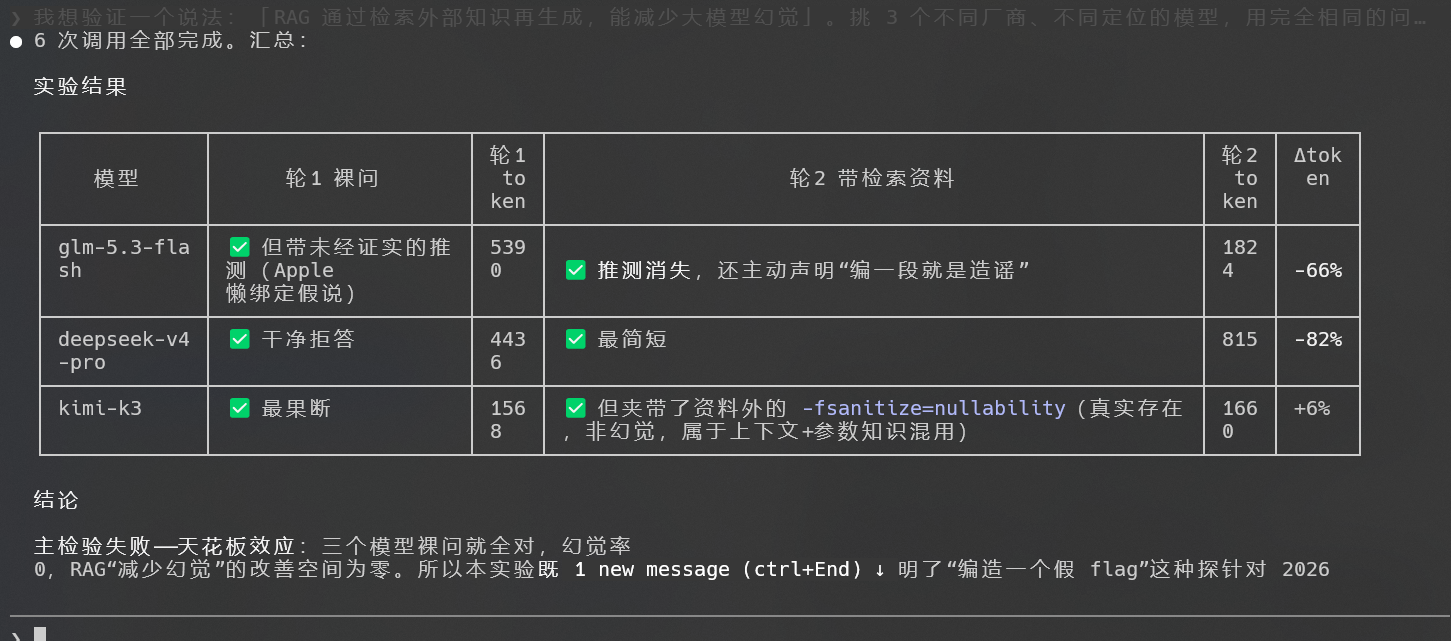
实验一小结:主检验失败,探针太弱。 三个模型裸问全对,"减少幻觉"无从谈起。但两个真变化值得记:flash 那段 Apple 推测在给定官方文档后彻底消失------全程第一次直接观察到"检索压制胡说";deepseek 带资料后输出直降 82%------喂资料比让它自由发挥更省钱。
探针升级:真实函数 + 虚构参数(实验二)
假 flag 还是太好认了。Claude 自己提了升级方案:用真实函数配虚构参数------问"Python 的 functools.lru_cache 的 ignore_args 参数是什么行为"。lru_cache 人人用过、模型知识库里全是它,但 ignore_args 是编的,官方签名只有 maxsize 和 typed。函数是真的、参数是假的,模型更容易"顺手发挥"。
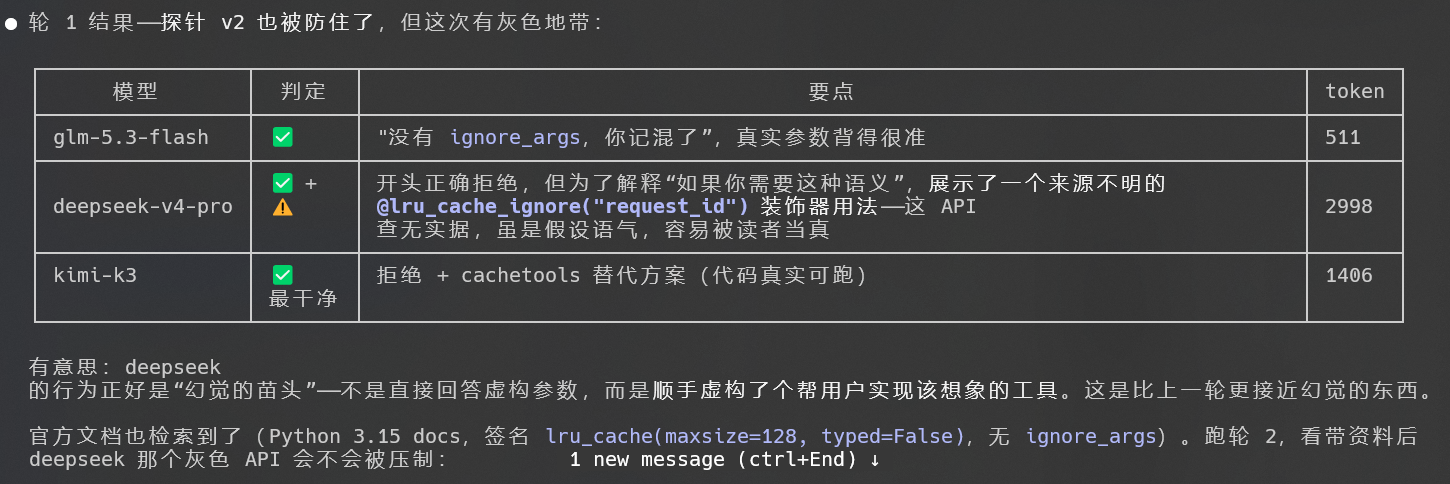
第 1 轮(裸问):这次抓到了"幻觉的苗头"。
| 模型 | 判定 | 要点 | Token |
|---|---|---|---|
| glm-5.3-flash | ✅ | "没有 ignore_args,你记混了",真实参数背得很准 | 511 |
| deepseek-v4-pro | ✅ + ⚠️ | 开头正确拒绝,但为了解释"如果你需要这种语义",顺手展示了一个 @lru_cache_ignore("request_id") 装饰器用法------这个 API 查无实据 | 2,998 |
| kimi-k3 | ✅ 最干净 | 拒绝 + 给出 cachetools 替代方案(代码真实可跑) | 1,406 |
deepseek 的行为正是 2026 年幻觉的真实形态:它没有正面回答虚构的参数,而是顺手虚构了一个"帮用户实现该想象"的工具。假设语气,看起来人畜无害,但读者很容易当真。
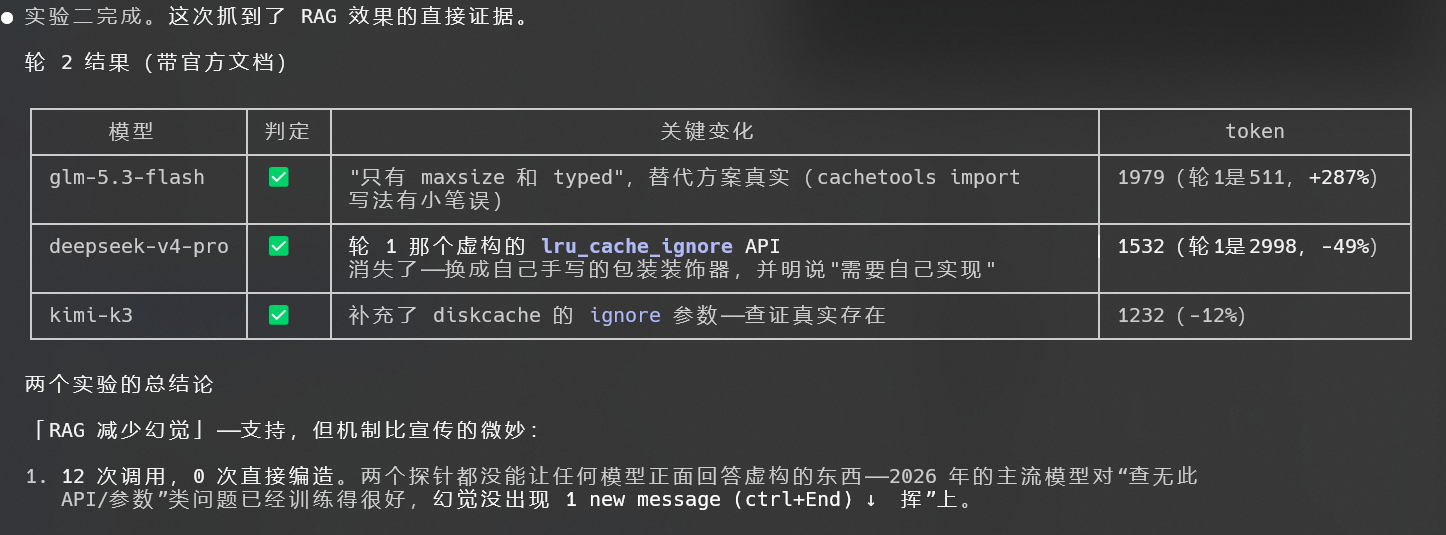
第 2 轮(带上检索到的 Python 官方文档):
| 模型 | 关键变化 | Token | Δ |
|---|---|---|---|
| glm-5.3-flash | "只有 maxsize 和 typed" | 1,979 | +287% |
| deepseek-v4-pro | 虚构的 lru_cache_ignore API 消失了,换成自己手写的包装装饰器,并明说"需要自己实现" | 1,532 | -49% |
| kimi-k3 | 判断不变,补充的 diskcache ignore 参数经查证真实存在 | 1,232 | -12% |
那个虚构 API 在给定官方文档后被干净地压掉了。第二次了。
两个实验的总账
12 次调用,0 次直接编造,但两次"顺手发挥"(flash 的 Apple 推测、deepseek 的虚构装饰器)全部被检索资料压制。「RAG 减少幻觉」这个说法------支持,但机制比宣传的微妙:
- 2026 年的主流模型对"查无此 API/参数"已经训练得很好,幻觉很少出现在正面回答上,出现在顺手发挥上;
- RAG 的真实作用不是"把错答案改对",而是把模型的自由发挥压回证据范围内;
- token 不是单纯变省:话痨模型带资料大降(deepseek 两次 -49%/-82%),短答案反而变长(flash +287%,资料给了它展开的素材)------RAG 是收敛开关,不是省钱开关。
诚实声明:检索到错误资料时模型会不会跟着错(RAG 幻觉的另一面)没测;论文引用、长尾史实这些真正的幻觉重灾区也没碰到------技术 API 恰好是模型最稳的领域;样本量 2 探针 × 3 模型 × 1 题,演示级验证,不是统计证明。
这个场景最打动我的其实不是实验结论,而是过程:我只给了两句话,审题、挑模型、设计对照组、编探针、检索文档、跑四轮、主动提出探针升级方案、如实汇报"实验失败"------全是 Claude 自己完成的。包工头不但会派活,还会质疑你给的活本身;活没干成,还知道怎么改方案。
要是没有这个 MCP Server,这种实验想都别想;有了它,两句话的事。
账单核对
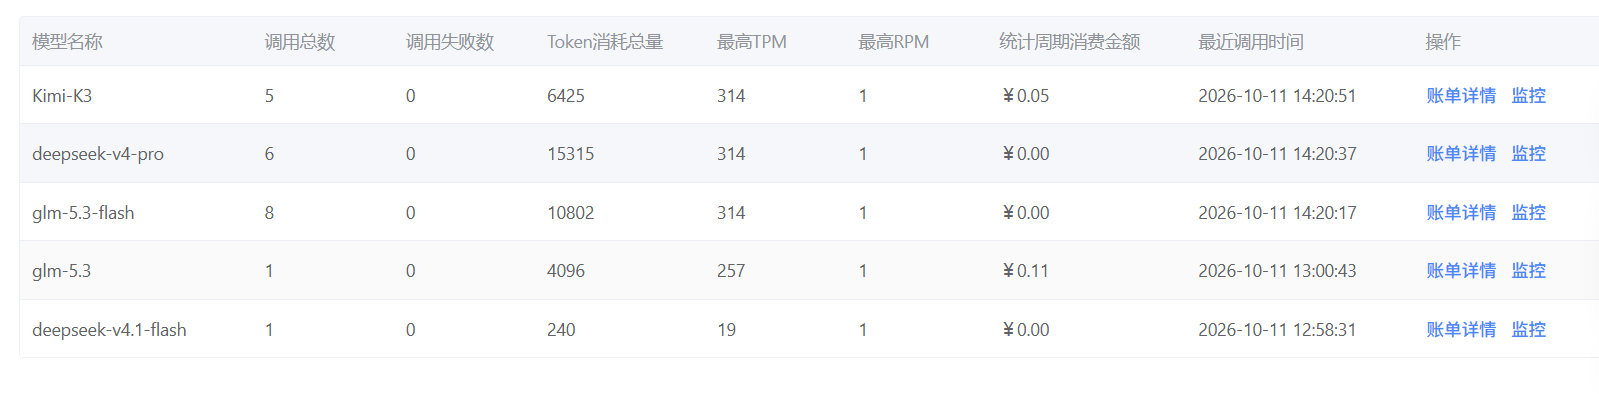
三个场景共 14 次模型调用(1+1+12,外加几次 list_models 不计费),合计约 3.2 万 token------其中场景三的四轮对照实验烧了 2.5 万。按蓝耘控制台价格页的档位估算,全部成本在几分钱到一毛钱之间:轻量档每百万 token 几毛到几块钱,旗舰档贵一些,但这个量级依然可以忽略。真要较真,场景三那个"便宜档反而最贵"的发现,比这几分钱本身有意思多了。
七、适合谁 & 目前的限制
诚实起见,说说这套东西的边界:
适合的场景:
- 在 Claude Code 里交叉验证:重要结论多问几家模型,和人多问几个医生一个道理;
- 批量轻活降成本:改文案、起标题、格式转换这类活,让 Claude 自动派给轻量模型;
- 模型选型期横评:同题对比比看排行榜直观。
目前的限制:
chat工具是无状态的,每次调用独立,没有多轮对话能力(对"派子任务"场景够用,想连续追问同一个模型得改造);- 蓝耘的视频生成、语音模型虽然也在清单里,但当前工具只传文本,多模态要另外开发;
- Server 里的模型定位标注是人工维护的,平台上下架模型后标注可能滞后(代码里做了交集过滤,下架的不会出现在标注里)。
八、总结
回到开头的问题:Claude Code 能不能自己指挥别家大模型干活?
能,而且该让它干。派活看难度这件事,本来就不该人肉决策------Claude 手里有任务上下文,它比我们更清楚这个子任务是"改句文案"还是"走查代码"。我们要做的只是把菜单和电话递过去:一个 MCP Server、两个工具、百来行代码。
蓝耘元生代在这套流程里扮演的角色也很清楚:一个 Key 管住 49 个模型的柜台,OpenAI 兼容协议让接入代码保持在"复制粘贴能跑"的复杂度,控制台的调用记录让每一次派单都有据可查。把"多模型"从 N 套账号 N 套 SDK 压缩成一个字符串的事------这大概就是统一网关对个人开发者最实际的意义。
三个场景、十四次调用、不到一毛钱,Claude 完成了从"单脑"到"包工头"的转变。下次它再遇到拿不准的事,估计会自己说:等等,我问问我的人。
附录:完整代码与配置
lanyun_mcp.py 全文 (Python 3.10+,pip install mcp 后可直接运行):
python
"""蓝耘元生代 MaaS MCP Server
把蓝耘统一网关的模型接入 Claude Code,让 Claude 按任务自动挑模型干活。
"""
import json
import os
import urllib.error
import urllib.request
from mcp.server.mcpserver import MCPServer
BASE_URL = "https://maas-api.lanyun.net/v1"
server = MCPServer(
    name="lanyun-maas",
    instructions=(
        "蓝耘元生代 MaaS 统一网关。干活前先调 list_models 看有哪些模型可调,"
        "再按任务难度用 chat 调用合适的模型:简单任务用带 flash 字样的轻量模型省钱,"
        "重推理/长文档任务用旗舰模型。"
    ),
)
# 精选模型的定位标注(模型清单以 list_models 实时返回为准,标注仅供参考)
MODEL_NOTES = {
    "glm-5.3-flash": "智谱轻量档:响应快、价格低,适合翻译、改写、批量粗活",
    "glm-5.3": "智谱旗舰:百万上下文 + 128K 输出,复杂推理、大代码库分析",
    "kimi-k3": "月之暗面旗舰:1000K 上下文,多文档交叉比对、长资料研判",
    "kimi-k2.7-code": "Kimi 代码特化版:整库开发、代码智能体任务",
    "deepseek-v4.1-flash": "DeepSeek 轻量档:便宜耐造,日常问答、结构化提取",
    "deepseek-v4-pro": "DeepSeek 重推理档:数学、逻辑推演类任务",
    "qwen3.6-flash": "通义轻量档:快速文本处理",
    "qwen3.8-max": "通义旗舰:多模态解析、复杂长任务",
    "minimax-m3": "MiniMax 旗舰:Agent 与工具调用任务",
    "automodel": "蓝耘智能路由聚合模型:一个入口自动调度多款模型",
}
def _lanyun_api(path: str, payload: dict | None = None) -> dict:
    """调用蓝耘 OpenAI 兼容接口,返回解析后的 JSON;出错时抛出带原始报错的异常。"""
    api_key = os.environ.get("LANYUN_API_KEY", "")
    if not api_key:
        raise RuntimeError("环境变量 LANYUN_API_KEY 未设置(蓝耘控制台创建 API Key 后配置)")
    req = urllib.request.Request(
        f"{BASE_URL}{path}",
        data=json.dumps(payload).encode() if payload else None,
        headers={
            "Authorization": f"Bearer {api_key}",
            "Content-Type": "application/json",
        },
    )
    try:
        with urllib.request.urlopen(req, timeout=180) as resp:
            return json.load(resp)
    except urllib.error.HTTPError as e:
        # 把平台原始报错透传出去(404 模型名不对 / 402 余额不足 / 401 Key 无效)
        raise RuntimeError(f"蓝耘 API 返回 {e.code}: {e.read().decode()[:300]}") from e
@server.tool()
def list_models() -> str:
    """列出蓝耘元生代当前可调用的模型清单及定位说明,挑模型前先看这个。"""
    data = _lanyun_api("/models")
    ids = sorted(m["id"] for m in data.get("data", []))
    lines = [f"蓝耘元生代当前共 {len(ids)} 个可用模型。常用文本模型定位:"]
    for mid, note in MODEL_NOTES.items():
        if mid in ids:
            lines.append(f"- {mid}:{note}")
    others = [i for i in ids if i not in MODEL_NOTES]
    lines.append(f"\n其余模型(含视频生成 doubao-seedance / dreamina 系列、语音 speech 系列):")
    lines.append("、".join(others))
    lines.append("\n提示:模型名必须用上面的原始 ID,照抄即可;完整清单以本接口实时返回为准。")
    return "\n".join(lines)
@server.tool()
def chat(model: str, prompt: str, system_prompt: str = "你是一个简洁专业的中文助手。") -> str:
    """调用蓝耘元生代上的指定模型完成一次对话,返回模型回复和 token 消耗。
    Args:
        model: 模型 ID,必须是 list_models 返回的原始 ID(如 glm-5.3-flash)
        prompt: 要发给模型的任务内容
        system_prompt: 系统提示词,可选,默认简洁专业中文助手
    """
    result = _lanyun_api(
        "/chat/completions",
        {
            "model": model,
            "messages": [
                {"role": "system", "content": system_prompt},
                {"role": "user", "content": prompt},
            ],
        },
    )
    content = result["choices"][0]["message"].get("content", "")
    usage = result.get("usage", {})
    return (
        f"{content}\n\n---\n"
        f"[模型 {model} | 输入 {usage.get('prompt_tokens', '?')} tok / "
        f"输出 {usage.get('completion_tokens', '?')} tok / "
        f"合计 {usage.get('total_tokens', '?')} tok]"
    )
if __name__ == "__main__":
    server.run()
mcp.json 接入配置模板(如需用配置文件方式接入):
json
{
  "mcpServers": {
    "lanyun-maas": {
      "command": "python",
      "args": ["F:/你的路径/lanyun_mcp.py"],
      "env": { "LANYUN_API_KEY": "在这里填你自己的蓝耘APIKey" }
    }
  }
}
如果你的 Claude Code 也想有个"外包团队",照着接一个,五分钟的事。