其他聚类(层次聚类+DBSCAN算法)
层次聚类与DBSCAN算法解释 无监督学习。
-
层次聚类
-
核心概念 :层次聚类是一种
无需预先指定簇数量的聚类方法。它通过逐步合并或分裂数据点,构建出一个层次化的聚类结构。【谨记】:层次聚类中每个样本只属于一个类,所以层次聚类属于硬聚类。(一般来说聚类分为硬聚类和软聚类,硬聚类明确一个样本只属于一个类,而软聚类的一个样本可以属于多个类)。
-
两种方向:
- 凝聚型(自底向上):每个点初始为一个簇,逐步合并 最相似的簇【推荐,常用✅】。
- 分裂型(自顶向下):每个点初始为一个簇,逐步分裂成更小的簇。
-
工作流程------凝聚型(自底向上):
-
1、初始化:每个点独立成簇
-
2、计算距离 :计算所有簇间距离矩阵,该步骤称为Linkage(连接方法/连接准则)
刚开始时,每个点独立成簇,这时算的是点与点之间的距离 (通常用欧氏距离)。
d=(x1−x2)2+(y1−y2)2 d = \sqrt{(x_1 - x_2)^2 + (y_1 - y_2)^2} d=(x1−x2)2+(y1−y2)2
但当点合并成簇之后,衡量'簇与簇'之间的距离就不再是简单的点对点欧氏距离,而是需要采用特定的
连接准则(Linkage)。通常采用 Ward法(最小方差法) ,它通过计算合并后的方差增量来评估距离。-
计算方法(Ward法) :计算合并这两个簇后,簇内方差(误差平方和 ESS)增加多少,选择使方差增加最小的两个簇合并。
-
公式(Ward法) :
Δ(A,B)=∣A∣⋅∣B∣∣A∣+∣B∣∥μA−μB∥2 \Delta(A, B) = \frac{|A| \cdot |B|}{|A| + |B|} \| \mu_A - \mu_B \|^2 Δ(A,B)=∣A∣+∣B∣∣A∣⋅∣B∣∥μA−μB∥2
- Δ(A,B):合并簇 (A) 和簇 (B) 带来的方差增量(即合并代价)。
- ∣A∣、∣B∣:簇 (A) 和簇 (B) 中的样本数量。
- μA、μB:簇 (A) 和簇 (B) 的质心(中心点)。
- ∥μA−μB∥^2:两个质心之间的欧氏距离的平方。
-
-
3、合并最近簇:选择使方差增加最小的两个簇合并
-
4、迭代重复,直到满足停止条件
-
-
案例:鸢尾花数据集进行聚类划分
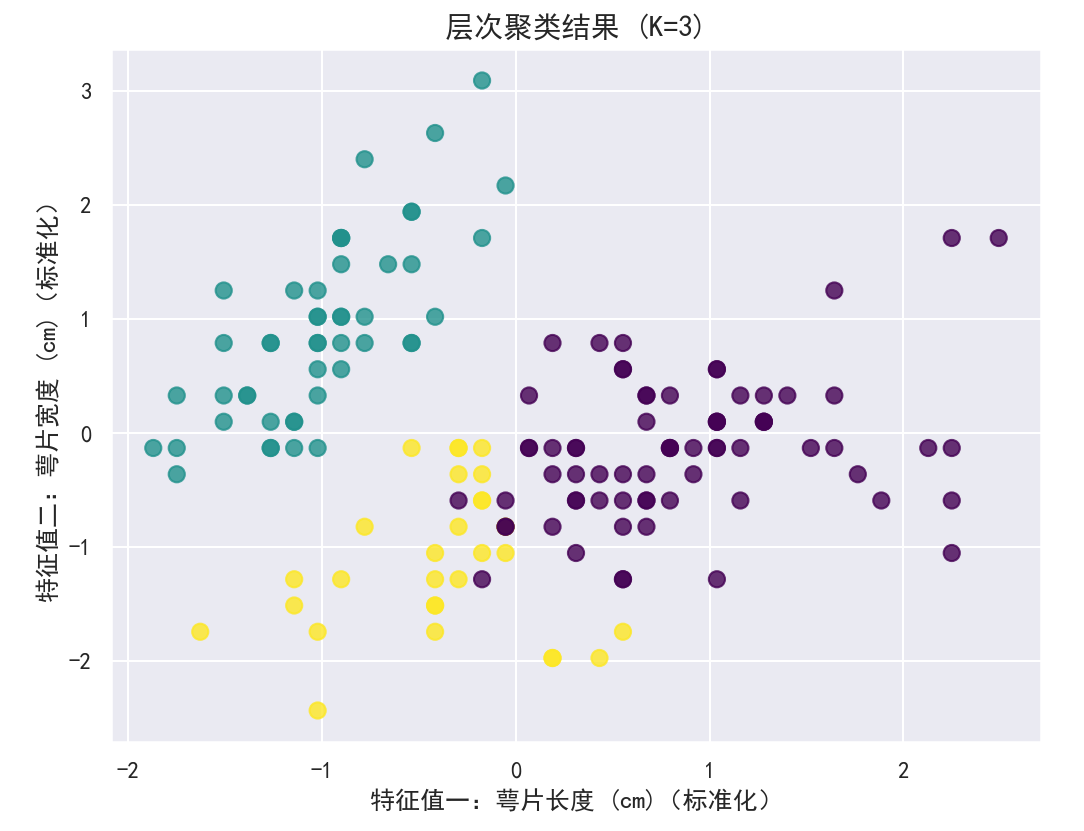
pythonimport numpy as np import matplotlib.pyplot as plt import seaborn as sns from sklearn import datasets from sklearn.cluster import AgglomerativeClustering from scipy.cluster.hierarchy import dendrogram, linkage from sklearn.metrics import adjusted_rand_score plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei'] # 黑体优先,备选微软雅黑 plt.rcParams['axes.unicode_minus'] = False # 解决负号变成方框 sns.set(font="SimHei") # seaborn热力图也要指定字体 # 准备数据 iris = datasets.load_iris() x = iris.data y_true = iris.target # 真实标签,仅用于最后的评估对比,聚类本身是无监督的 # 数据标准化(层次聚类基于距离,标准化非常重要!!!!) from sklearn.preprocessing import StandardScaler scaler = StandardScaler() X_scaled = scaler.fit_transform(x) # 构建层次聚类模型 model = AgglomerativeClustering( n_clusters=3, # 最终簇的数量 linkage='ward' # 最小化方差【推荐】 ) # 训练模型并预测 y_pred = model.fit_predict(X_scaled) # 【可视化】:树状图 (Dendrogram) plt.figure(figsize=(12, 5)) # 使用 scipy 的 linkage 计算距离矩阵 Z = linkage(X_scaled, method='ward') dendrogram(Z) plt.title('层次聚类树状图 (Iris Dataset)', fontsize=14) plt.xlabel('样本索引', fontsize=12) plt.ylabel('距离', fontsize=12) k = 3 # 最终簇的数量 # 找第k个和第k-1个簇合并时的距离,取其均值作为切割线高度 cut_height = (Z[-k, 2] + Z[-(k-1), 2]) / 2 plt.axhline(y=cut_height, color='r', linestyle='--', label=f'切割线 (height={cut_height:.2f})') # 辅助线,展示如何划分簇 plt.legend() plt.show() # 【可视化】:聚类结果散点图 plt.figure(figsize=(8, 6)) plt.scatter(X_scaled[:, 0], X_scaled[:, 1], c=y_pred, cmap='viridis', s=60, alpha=0.8) plt.title('层次聚类结果 (K=3)', fontsize=14) feature_names = iris.feature_names[:2] # 获取前两个特征的名称 feature_names_cn = ['萼片长度 (cm)', '萼片宽度 (cm)'] plt.xlabel(f'特征值一:{feature_names_cn[0]}(标准化)', fontsize=12) plt.ylabel(f'特征值二:{feature_names_cn[1]}(标准化)', fontsize=12) plt.show() # 模型评估 ari = adjusted_rand_score(y_true, y_pred) print(f"调整兰德指数 (ARI): {ari:.2f}") ---------------------------------------------------------------------------- 调整兰德指数 (ARI): 0.62 ----------------------------------------------------------------------------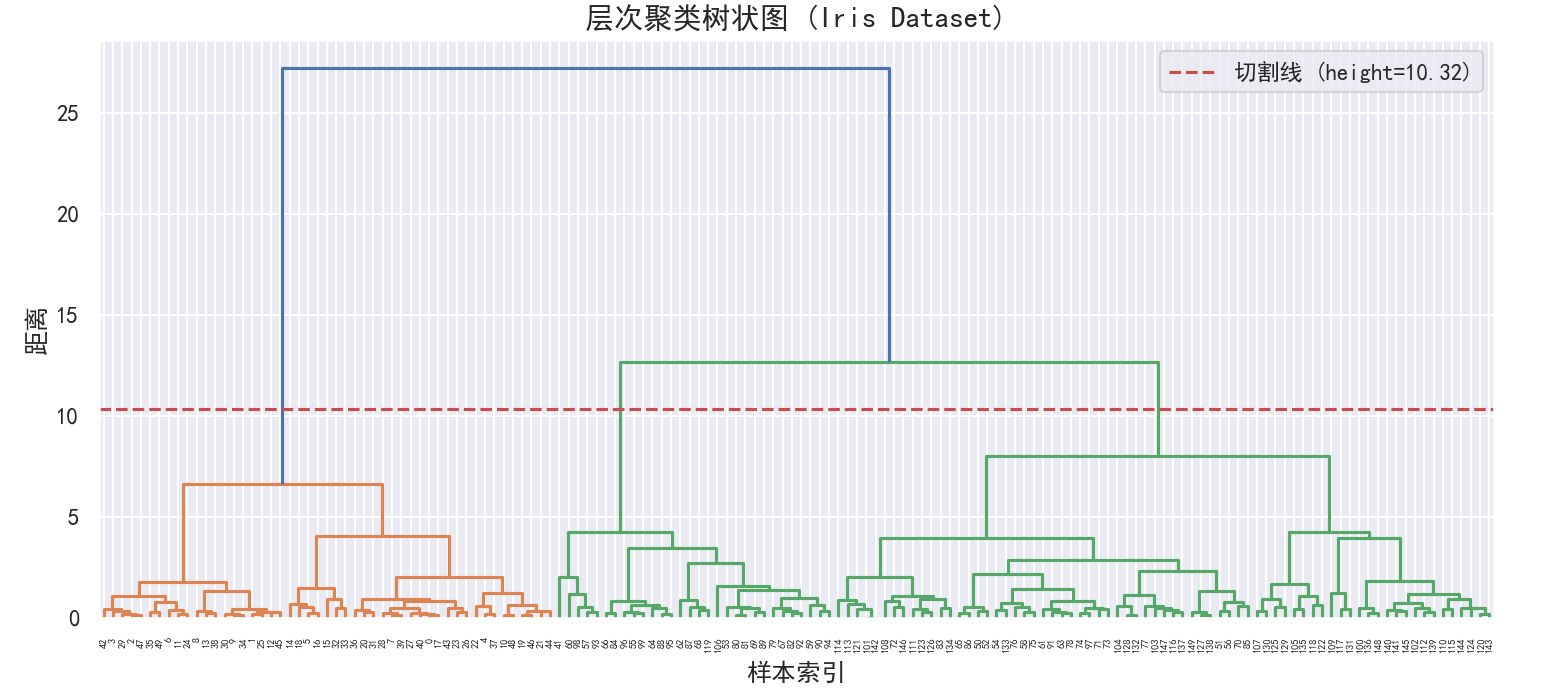
-
-
DBSCAN聚类
-
核心概念:DBSCAN是基于密度的聚类方法,通过识别高密度区域来形成簇。
-
核心优势:
- 自动确定簇数:无需预先指定K值,根据数据密度自动发现簇的数量。
- 任意形状检测:突破K-means的球形限制,能发现环形、月牙形等复杂形状。
- 噪声点识别:能自动识别并标记离群点(噪声点标记为 -1)。
-
基本概念:
- 邻域 :对于数据集中的任意点P,以P为中心,半径为
eps的区域称为 P 的邻域。 - 核心点(Core Point) :如果一个点的邻域(给定半径
eps的区域 )内至少有min_samples个邻居点,那么这个点被称为核心点。 - 边界点(Border Point) :一个点的邻域内没有达到
min_samples个点,但它在某个核心点的邻域内,这样的点被称为边界点。 - 噪声点(Noise Point):既不是核心点也不是边界点,被标记为离群值。
- 邻域 :对于数据集中的任意点P,以P为中心,半径为
-
【算法逻辑 】:以未访问核心点为起点,搜索其
eps邻域,将邻域内核心点、边界点归入同一簇;邻域内找到的所有核心点可继续向外扩张,而边界点仅归入簇、不能扩展。不断收集所有密度相连的点形成簇。无法被纳入任何簇的点即为噪声点。 -
案例:鸢尾花数据集进行聚类划分
-
eps(邻域半径):范围太小会产生更多小簇和噪声;太大则合并成同一簇。建议数据标准化后 尝试 0.3-0.5(可用K-距离图辅助选择)。
-
min_samples(最小样本数):太小会产生更多簇;太大会形成更紧密的簇。建议至少设为维度数+1 或维度*2。
pythonimport numpy as np import matplotlib.pyplot as plt import seaborn as sns from sklearn import datasets from sklearn.cluster import AgglomerativeClustering from scipy.cluster.hierarchy import dendrogram, linkage from sklearn.metrics import adjusted_rand_score from sklearn.cluster import DBSCAN plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei'] # 黑体优先,备选微软雅黑 plt.rcParams['axes.unicode_minus'] = False # 解决负号变成方框 sns.set(font="SimHei") # seaborn热力图也要指定字体 # 准备数据 iris = datasets.load_iris() x = iris.data y_true = iris.target # 真实标签,仅用于最后的评估对比,聚类本身是无监督的 # 数据标准化(层次聚类基于距离,标准化非常重要!!!!) from sklearn.preprocessing import StandardScaler scaler = StandardScaler() X_scaled = scaler.fit_transform(x) # 创建并训练 DBSCAN 模型 # eps: 邻域半径 # min_samples: 核心点所需的最小样本数 model = DBSCAN( eps=0.5, # 邻域半径 min_samples=8, # 最小样本数 metric='euclidean' # 距离度量方式(默认方法) ) y_pred = model.fit_predict(X_scaled) # 统计结果 n_clusters = len(set(y_pred)) - (1 if -1 in y_pred else 0) # 去除-1(噪声点)后的簇数量 n_noise = list(y_pred).count(-1) # 统计噪声点数量 print(f"聚类数量: {n_clusters}") print(f"噪声点数量: {n_noise}") # 评估模型(使用ARI指标,对比真实标签,值越接近1越好) ari = adjusted_rand_score(y_true, y_pred) print(f"调整兰德指数(ARI): {ari:.4f}") # 结果可视化(只取前两个特征绘制二维散点图以便观察) plt.figure(figsize=(10, 6)) # 绘制正常簇 # 利用布尔索引找出非噪声点(标签 != -1) core_samples_mask = np.zeros_like(y_pred, dtype=bool) core_samples_mask[model.core_sample_indices_] = True # 核心点掩码 non_noise = y_pred != -1 # 绘制所有非噪声点 plt.scatter(X_scaled[non_noise, 0], X_scaled[non_noise, 1], c=y_pred[non_noise], cmap='viridis', s=50, alpha=0.7, label='聚类点') # 绘制噪声点(黑色叉号标记) plt.scatter(X_scaled[~non_noise, 0], X_scaled[~non_noise, 1], c='black', marker='x', s=50, label='噪声点(-1)') plt.title(f'DBSCAN 聚类结果 (簇数: {n_clusters}, 噪声点: {n_noise})') plt.xlabel('特征1 (标准化后)') plt.ylabel('特征2 (标准化后)') plt.legend() plt.show() ------------------------------------------------------------------------------ 聚类数量: 3 噪声点数量: 59 调整兰德指数(ARI): 0.4436 ------------------------------------------------------------------------------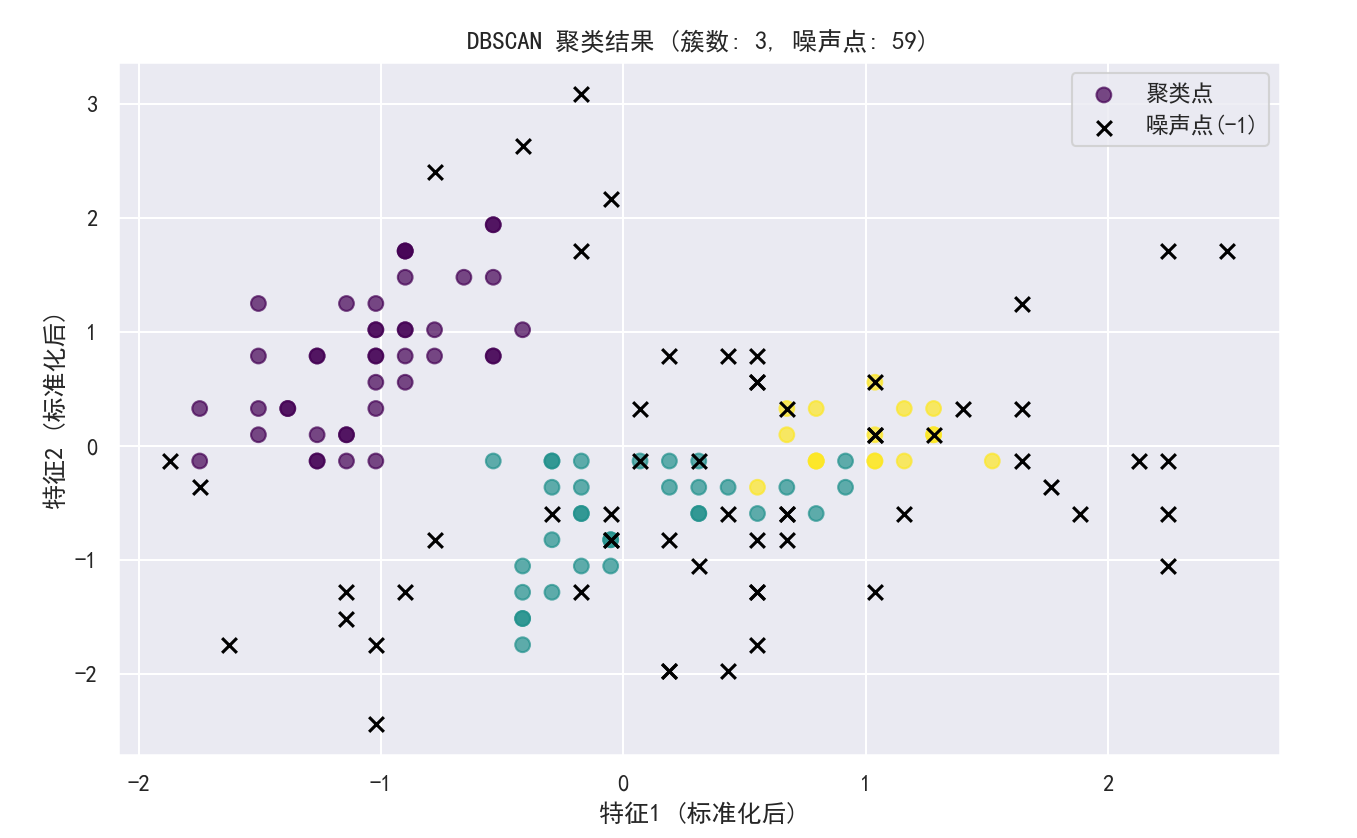
-
-
-
三大聚类算法对比:
对比维度 K-means 层次聚类 DBSCAN 簇的形状 球形/凸形 任意形状 任意形状 是否需要指定K 需要 需要(可选) 不需要 噪声处理 强制分配到某簇 强制分配到某簇 可识别噪声点(标记为-1) 计算复杂度 O(n·k·i) O(n²·log n) O(n·log n) 大数据集性能 优秀 较慢 良好 参数调节难度 简单(K值) 中等(连接方法) 较难(eps, min_samples) 可解释性 高 很高(树状图) 中等 -
算法选择策略:
-
数据规模评估:
- 小数据集 (<10K):三种算法均可使用。
- 大数据集 (>100K):优先选择 K-means 或 DBSCAN(因为层次聚类计算复杂度高,处理大数据会非常慢)。
-
簇形状判断:
- 球形分布:K-means 效果最佳。
- 复杂形状(如环形、月牙形):选择层次聚类 或 DBSCAN。
-
簇形状判断:
- 球形分布:K-means 效果最佳。
- 复杂形状(如环形、月牙形):选择层次聚类 或 DBSCAN。
-
K值是否已知:
- 明确簇数:K-means 最高效。
- 未知簇数:选择 DBSCAN 或 层次聚类(两者都能自动探索簇的数量)。
-
可解释性需求:
- 需要层次关系(如生物分类):选择 层次聚类(树状图非常直观)。
- 仅需簇划分:选择 K-means 或 DBSCAN。
-
-
注意点:
算法 常见陷阱 原因与现象 规避策略(操作建议) K-means 初始化敏感 不同的随机种子( random_state)可能导致完全不同的聚类结果,陷入局部最优。多次运行取最优(如 n_init=10),或使用 K-means++ 初始化算法(sklearn默认已采用)。假设球形簇 对环形、月牙形等复杂形状数据效果极差,会强行切割数据。 遇到此类数据立即放弃K-means,改用 DBSCAN (基于密度)或 层次聚类。 受离群点影响大 极值会严重拉偏质心位置,导致正常数据被错误划分。 聚类前进行严格的数据清洗,剔除极端异常值,或改用对噪声不敏感的 DBSCAN。 层次聚类 计算成本极高 复杂度达 O(n2logn)O (n 2logn)。当样本量 > 10,000 时,内存和计算时间呈指数级膨胀。 大数据集(>100K)禁止直接使用。可采用"抽样聚类"策略,或改用K-means/DBSCAN。 无法撤销合并(错误累积) 一旦两个簇合并,后续就无法撤销。如果某一步合并错误,错误会一直累积影响最终结果。 多尝试不同的 linkage(连接方法);结合业务常识反复验证树状图的切割位置。连接方法选择困难 single(最小距离)容易产生链式效应,complete(最大距离)容易产生小型簇,结果差异大。强烈推荐默认使用 ward(最小方差法),通常能产生更紧凑、更平衡的簇。DBSCAN 参数调优极其困难 eps和min_samples极度敏感。eps稍微变动0.1,结果可能天差地别。先小样本,后大数据 。绘制 K-距离图 找拐点定 eps;固定eps微调min_samples,控制噪声比例在5%-20%。密度差异大表现不佳 算法要求全局密度统一。数据集中既有密集簇又有稀疏簇时,单一参数无法兼顾。 尝试对数据进行分层处理,或改用 HDBSCAN(层次密度的DBSCAN变体)等改进算法。 高维诅咒 高维空间中所有点距离趋同,"密度"概念失效,导致聚类效果急剧下降。 运行DBSCAN前,先使用 PCA(主成分分析) 或 t-SNE 进行降维处理。