CVPR 2026|3M-TI:免标定跨模态扩散,让移动热成像更清晰
一句话总结
针对移动端热传感器分辨率低、RGB 引导方法又依赖繁琐相机标定的问题,论文提出 3M-TI,在潜空间中自动对齐未标定、不同步的 RGB---热成像输入。它在公开测试集上取得最佳 LPIPS 和 MANIQA,并让增强后的热图像更利于目标检测与语义分割。
论文信息
题目:3M-TI: High-Quality Mobile Thermal Imaging via Calibration-free Multi-Camera Cross-Modal Diffusion|3M-TI:基于免标定多相机跨模态扩散的高质量移动热成像
发表: CVPR 2026
作者: Minchong Chen1,2,†、Xiaoyun Yuan1,2,†,*、Junzhe Wan1、Jianing Zhang3,4、Jun Zhang4;
单位: 1上海交通大学人工智能研究院、教育部人工智能重点实验室;2上海交通大学计算机学院;3复旦大学;4清华大学
代码:
https://github.com/work-submit/3MTI
下载:
https://arxiv.org/abs/2511.19117
论文摘要
移动热传感器由于受到小尺寸、长波长以及成本等因素的限制,其输出常常模糊不清并且缺少纹理;单图超分辨率可利用的信息不够充分,而 RGB 引导方法一般需要像素级标定。3M-TI 将交叉模态自注意力模块(Cross-Modal Self-Attention Module,CSM)嵌入一步潜空间扩散网络,并利用错位增强学习未标定、不同步输入之间的对应关系,以此提高热图像的结构、纹理和感知质量。
主要创新之处
创新点 1:无需标定的跨模态融合
在变分自编码器(Variational Autoencoder,VAE)的潜空间里,通过 CSM 自动找出 RGB 与热成像特征之间的对应关系,不再需要像素级配准。
创新点 2:针对真实错位的增强措施
对 RGB 图像进行平移、缩放、旋转与透视变换,以模拟相机视差和采集时间偏移,防止模型依赖精确对齐的训练图像。
创新点 3:一步跨模态扩散重建
基于 SD-Turbo 一步扩散模型,借助预训练生成先验抑制融合伪影、补充真实细节,并用低秩适配(Low-Rank Adaptation,LoRA)对 UNet 和 VAE 解码器进行高效微调。
创新点 4:真实移动系统验证
论文还在四个公开数据集和自建手机多相机系统上进行验证,并进一步研究增强图像对目标检测和语义分割的作用。
方法详解
5.1 问题界定与整体框架
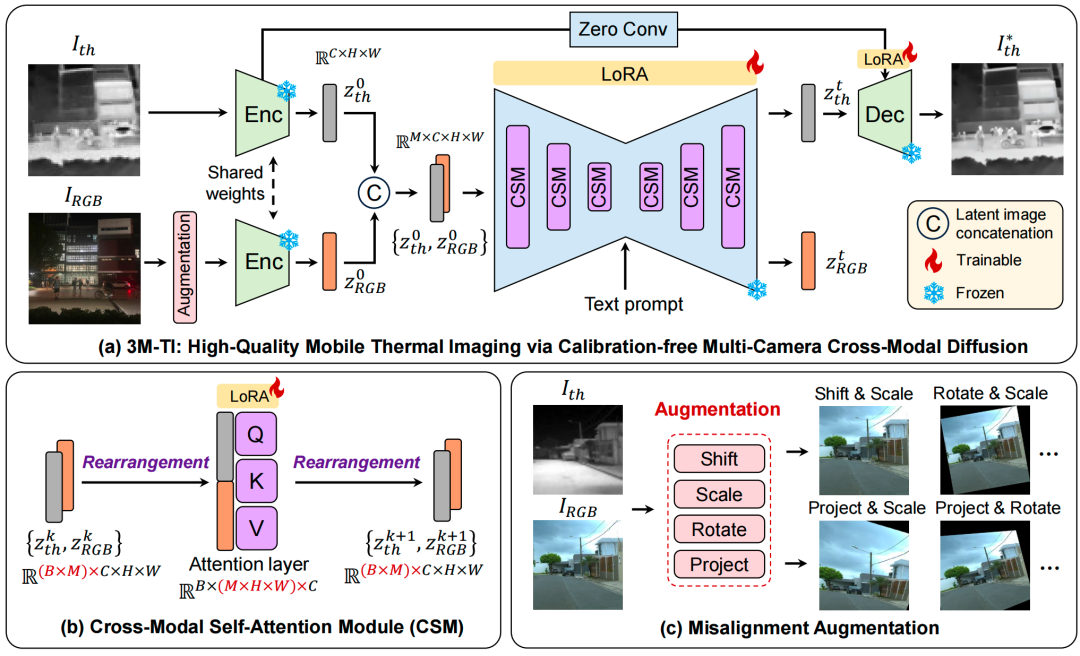
输入是低分辨率热图像与未经标定的高分辨率 RGB 参考图像,输出则是高分辨率热图像。二者首先由共享且冻结的 VAE 编码器映射到潜空间,随后进入替代原自注意力层的 CSM,在 UNet 内完成多尺度对齐和融合。网络还会使用由 RGB 图像经 Recognize Anything Model(RAM)生成的文本提示,并通过零初始化跳跃连接维持热结构。
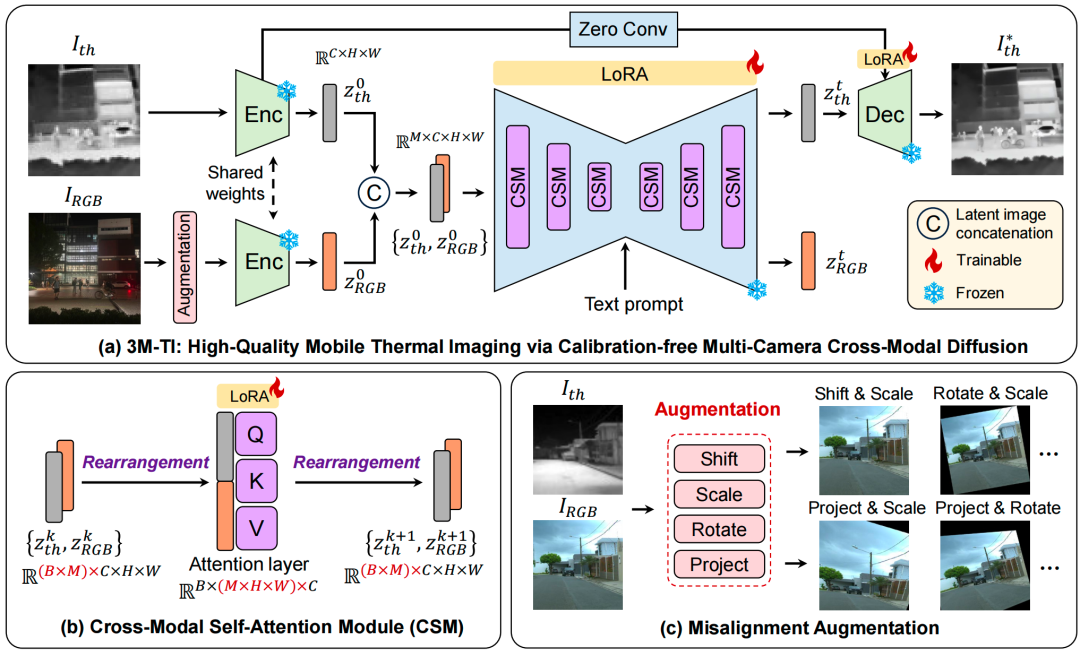
图2: 子图(a)给出一步扩散重建流程以及 LoRA 微调位置;子图(b)呈现 CSM 前后的张量重排;子图(c)展示由平移、缩放、旋转和透视变换构成的错位增强。
5.2 交叉模态自注意力模块
CSM 并非简单地把两幅图像拼接在一起,而是将两种模态的全部潜空间像素排列为同一个 token 序列。初始潜变量写为:
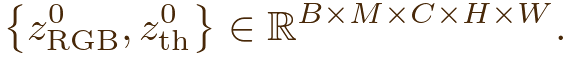
其中,和分别表示 RGB 图像与热图像的初始潜变量;B表示批大小;M=2表示图像数量;C、H、W依次代表通道数、高度和宽度。
进入 Transformer 块之前,张量会被重新排列为:
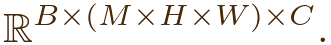
其中,长度为M× H× W的序列包含两种模态的全部空间 token;自注意力由此能够同时计算 RGB---热成像之间的跨模态关系和热模态内部关系,随后再恢复为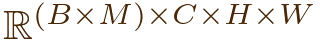 。
公式解释: 第一次重排将两种模态的全部潜空间像素拼成单一 token 序列,使自注意力能同时看到 RGB 与热成像的所有位置;第二次重排则把注意力输出恢复为原始张量形状,供后续网络层继续处理。这两次重排让预训练自注意力层可以比较两种模态的全部位置,并在保持热结构上下文的同时选取有用的 RGB 细节。CSM 本身不增加任何参数,仅通过重排复用原有注意力机制。
5.3 错位增强
训练数据通常严格对齐,但真实设备会因相机基线、场景深度、物体运动以及采集延迟而产生空间和时间偏差。论文只对 RGB 输入进行可控的平移、缩放、旋转和透视变换,并不开展复杂的物理仿真,以此促使CSM学习内容驱动的对应关系,在训练阶段便适应手持多相机场景。
5.4 实际多相机系统
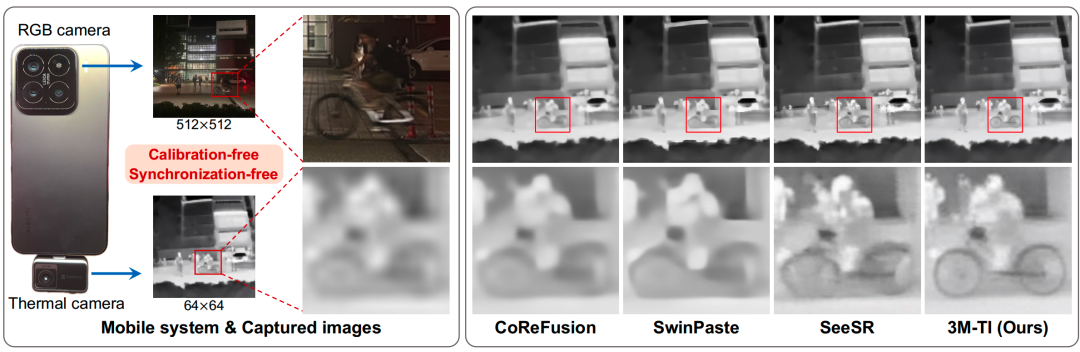
系统由价格低于 100 美元的 HIKVISION P09 热相机模组和小米 15 组成,并通过 Type-C 接口连接。热相机的原生分辨率为96×96、视场角为50°×50°、像元间距为12 μm;实验中将热图像缩放到64×64。手机主摄使用 OV50H 传感器,分辨率为4096×3072、等效焦距为23 mm、视场角为74°×59°。
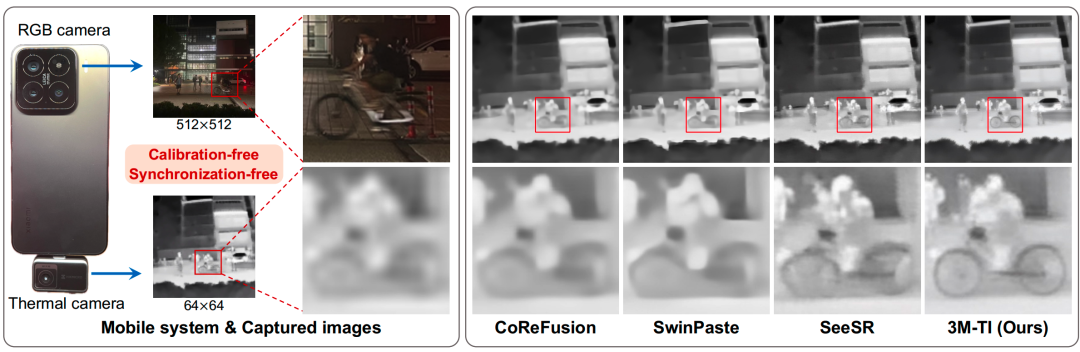
图1: 给出无需标定、无需同步的 RGB---热成像采集系统,并一同展示 CoReFusion、SwinPaste、SeeSR 和 3M-TI 的结果对比。
5.5 损失函数
模型采用像素保真和感知质量两个目标共同训练:
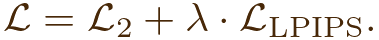
其中,表示总损失;用于约束重建结果与真值之间的像素差异;表示学习感知图像块相似度损失;权重。
公式解释: 总损失由两项加权求和构成------前一项 L2 损失逐像素约束重建结果与真值之间的差异,用于保持结构和数值保真度;后一项 LPIPS 损失衡量感知层面的图像块相似度,负责改善纹理细节,防止模型只追求平滑的高 PSNR 结果而丢失真实感。权重 λ 用于平衡两项损失的相对贡献。
一句话理解该方法: 首先在潜空间中把未标定 RGB 与热特征放入同一注意力序列自动寻找对应位置,随后利用一步扩散先验得到清晰并且符合热结构的高分辨率结果。
实验结果
6.1 实验条件
训练集包含 IRVI、LLVIP、M3FD 和 PBVS 2025 TISR Challenge Track 2 中的3200、3200、3822、700对图像,共计10922对;公开测试集包含1176对,四个来源分别贡献300、300、376、200对,并加入受控空间变换与高斯噪声。热输入尺寸为64×64,RGB 参考尺寸为512×512。模型在单张 NVIDIA A800(80 GB)上使用 Adam 优化器,以批大小4、学习率2×10⁻⁵训练8000次迭代,耗时约4小时;UNet 和 VAE 解码器的LoRA秩分别是16和4。评价指标包括 PSNR、SSIM、LPIPS、MUSIQ 和MANIQA,对比方法为 CoReFusion、CoRPLE、SwinFuSR、SwinPaste、SeeSR、OSEDiff 和 DifIISR。
6.2 定量结果
在公开测试集上,完整3M-TI的LPIPS为0.1787、MANIQA为0.4443,两项均为最佳;MUSIQ 为36.66,仅次于 DifIISR 的36.74。它的 PSNR 和 SSIM 分别为30.09和0.8610,虽然不是全表最优,但都高于 SeeSR、OSEDiff、DifIISR、SwinFuSR 与 SwinPaste。与 SeeSR 相比,LPIPS 降低0.0041,MANIQA 提高0.0165;与 OSEDiff 相比,PSNR 提高2.04 dB,SSIM 提高0.0188。在真实手机数据集上,3M-TI 的 MUSIQ 为30.62、MANIQA 为0.3589,两项同样都是最佳。
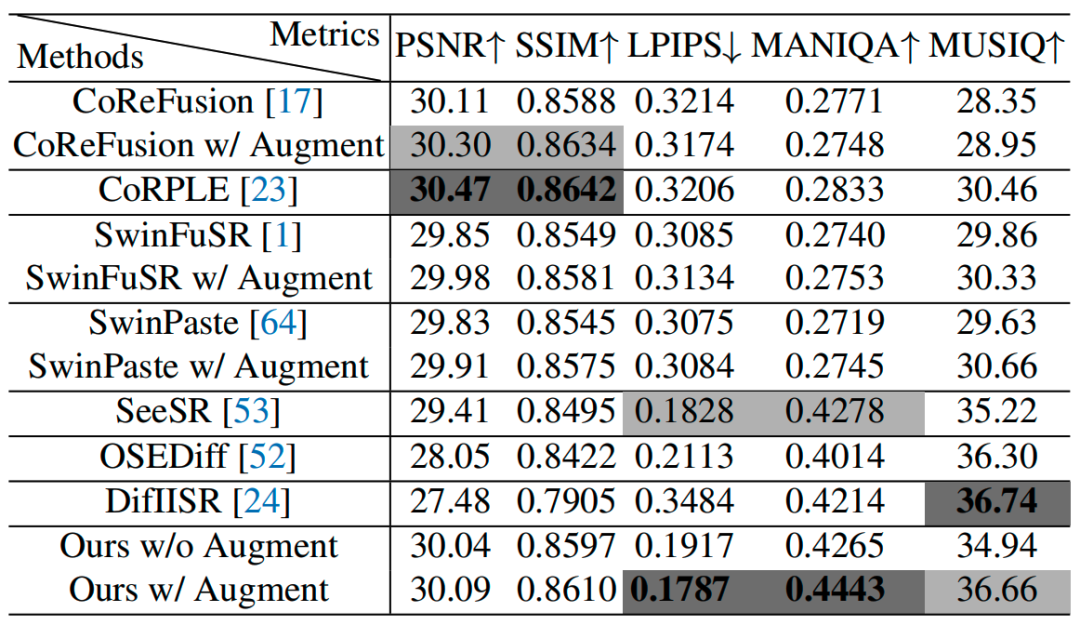
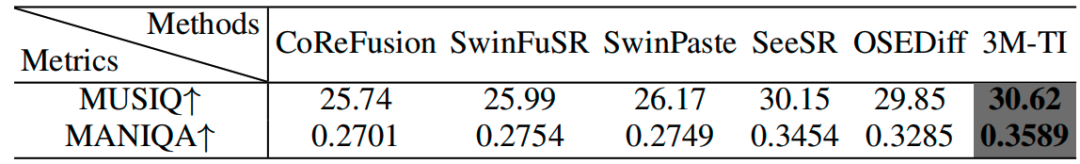
表1: 比较不同方法在公开数据集上的性能,深灰色和浅灰色分别代表各项指标的最佳与次优结果。
表2: 比较不同方法在真实手机数据集上的无参考图像质量,3M-TI在 MUSIQ 和 MANIQA 两项指标中均排名第一。
6.3 定性结果
非扩散方法通常会得到较为平滑的结果,却难以恢复高频结构;SeeSR 和 OSEDiff 可以生成细节,但有时与真值并不一致。3M-TI对建筑物、道路标线、窗户、电线、树枝以及电线杆等结构的恢复更接近真实情况,在真实手机图像存在明显错位和眩光干扰时,也能重建出较为自然的轮廓。
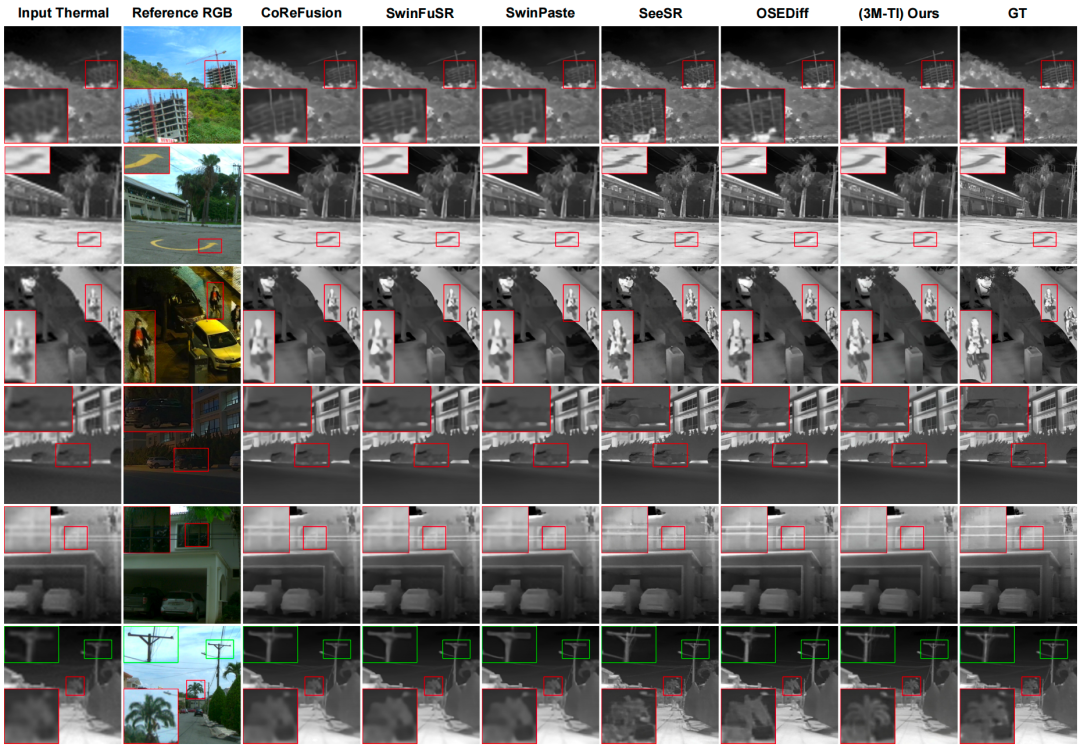
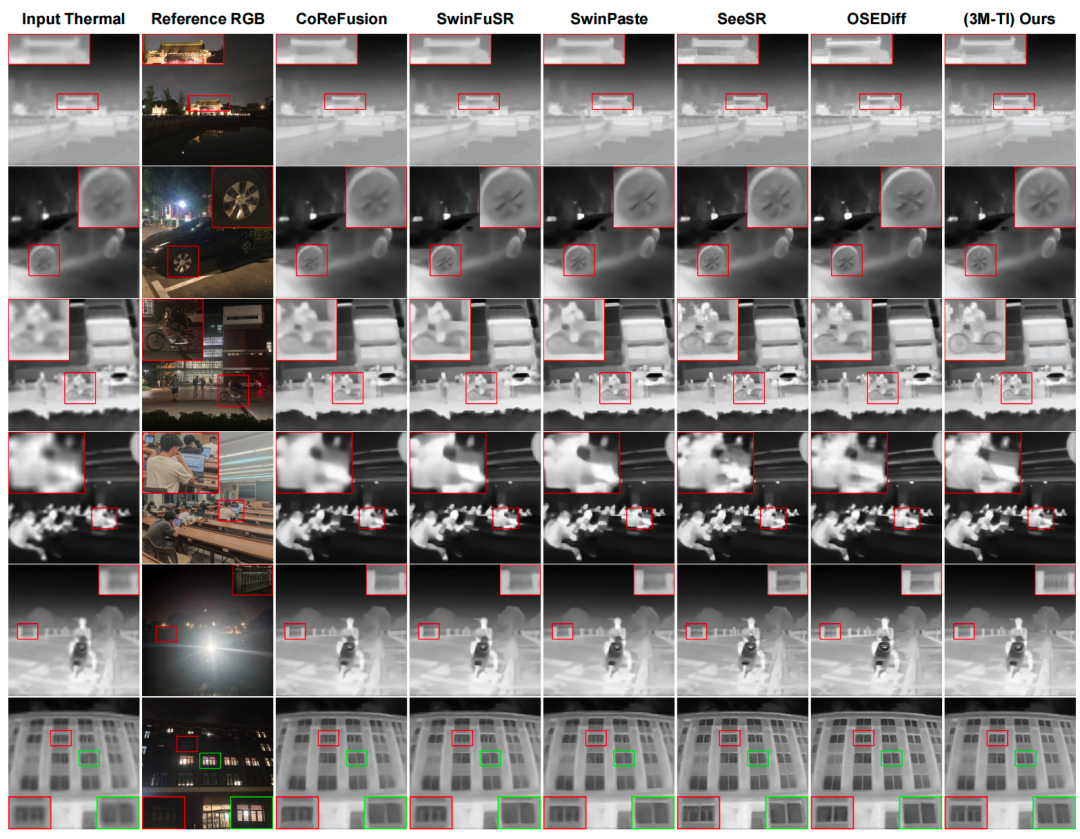
图3: 公开测试集上的视觉对比,主要呈现3M-TI在细节结构、热模式以及真值一致性方面的表现。
图4: 真实手机数据集上的视觉对比,展示该方法面对未标定输入时的清晰度、结构保真度与泛化能力。
6.4 下游任务结果
论文使用Grounded-SAM开展零样本测试,不进行模型微调,并让所有方法采用相同的文本提示。在 LLVIP 和带有真值标注的 M3FD 测试图像上,3M-TI的检测 Precision、Recall、F1-score 与 IoU 分别为0.4565、0.5455、0.4724、0.3427,在三种重建热图像中均为最佳;其 Precision、F1-score 和 IoU 也略高于 RGB 参考,不过 Recall 低于 RGB 的0.5708。语义分割可视化表明,3M-TI 可以生成更加连贯的类别区域,并在部分低照度目标上补充 RGB 难以表现的信息。
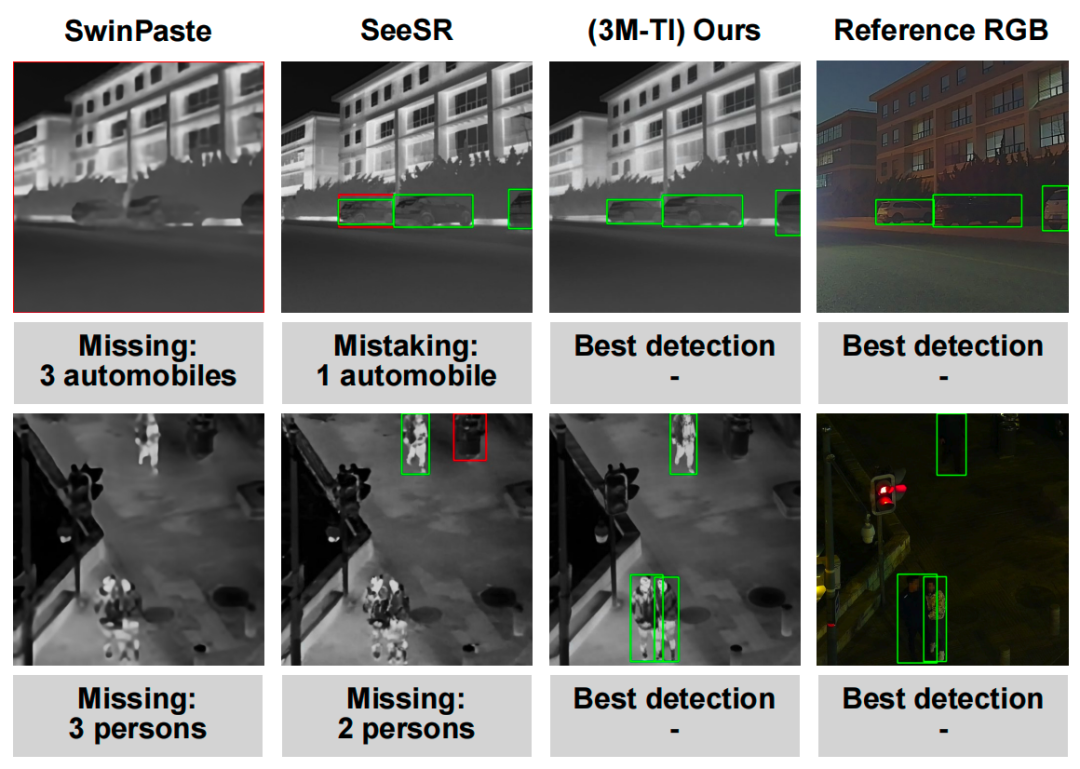
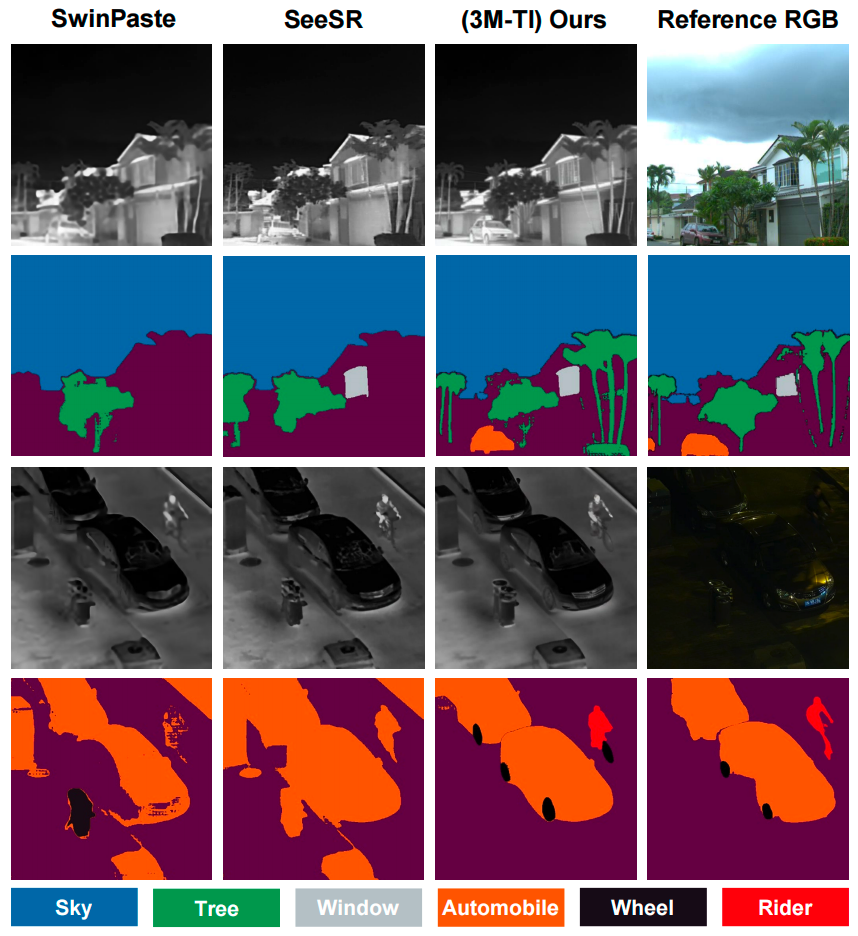
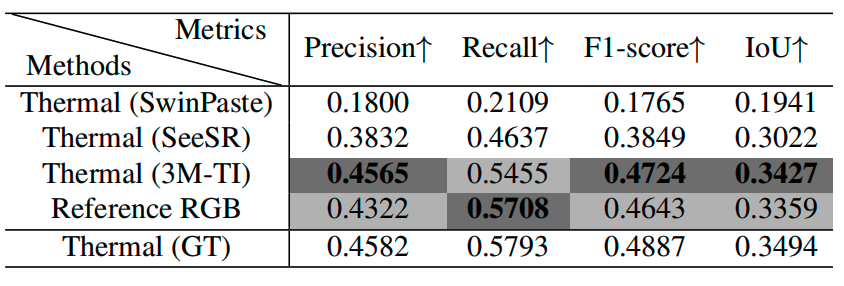
图5: 目标检测可视化结果,其中绿色框代表正确检测,红色框代表错误检测。
图6: 语义分割可视化结果,以不同颜色表示天空、树木、窗户、汽车、车轮以及骑行者等类别。
表3: 比较 SwinPaste、SeeSR、3M-TI、RGB 参考与热真值的检测性能,指标包括 Precision、Recall、F1-score 和 IoU。
6.5 消融实验
完整模型的 PSNR 为30.09、SSIM 为0.8610、LPIPS为0.1787、MUSIQ为36.66。移除 RGB 参考后,LPIPS退化至0.2106,MUSIQ 降至32.85;移除错位增强后,LPIPS 为0.1917,MUSIQ 为34.94;去掉跳跃连接后,PSNR 降到29.86。移除 RAM 提示对 PSNR、SSIM 的影响很小,但 MUSIQ 会降至36.20。在注意力变体中,CSM 的表现也优于原始自注意力、特征拼接和标准交叉注意力,说明联合建模跨模态与模态内关系更加有效。
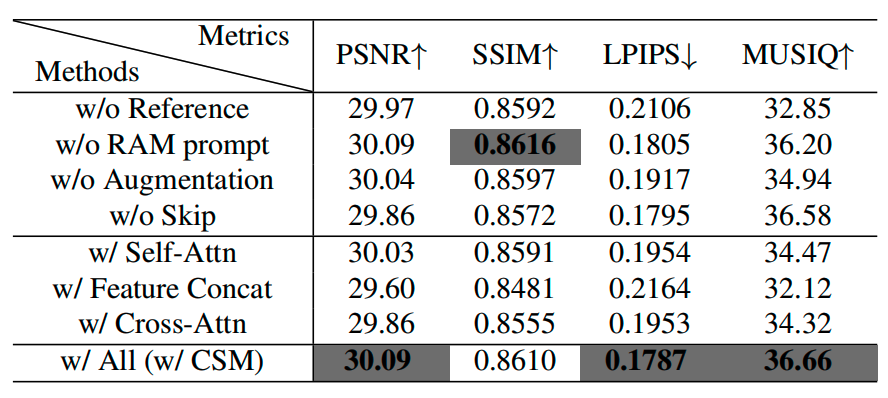
表4: 对比 RGB 参考、RAM 提示、错位增强、跳跃连接以及不同融合注意力设计对性能的影响。
6.6 模型复杂度
论文没有报告模型总参数量、FLOPs 或推理时间。不过可以确定的是,CSM不增加任何参数;模型使用一步SD-Turbo保证高效推理,并且只通过LoRA对 UNet 和 VAE 解码器进行微调。训练大约耗时4小时,但这一数字不能代表推理速度。
总结与展望
总结
3M-TI将免标定 CSM、错位增强和一步潜空间扩散结合起来,使 RGB 无需显式配准便可以帮助恢复热图像细节。公开数据与真实手机测试都表明,该方法兼顾感知质量、结构一致性和下游任务价值。
一句话总结: 3M-TI最重要的贡献,是让未标定、不同步的 RGB 参考也可以借助潜空间联合注意力,稳定服务于高质量热图像重建。
往期推荐