我手上一个小工具站想加个网页导出 PDF 的功能,做法很普通就是先把页面渲染好再交给 Chromium 打印成文件。动手之前我自己写了一页测试对账单,公司名「某某公司」和金额编号都是我编的。标题用站酷快乐体,正文用 Noto Sans SC,两个都是本机已有的开源字体。快乐体的造型很怪,有没有用上一眼就看得出来。第一份打出来的 PDF 只有 1,073 字节。打开是白的。Chromium 没报错也没警告,接口照样返回了一个合法的 PDF 文件。我盯着它愣了好一会儿。回过神来楼下面馆都快关门了。后来我发现这份文件最先露馅的地方不是画面而是大小。字体出问题的时候 PDF 基本不会报错。它只会换字、留白、画方框。接口里最先能拿到的信号就是文件有多大。下面是我在本机 Chromium 149 开源构建和图映服务端上量出来的几组大小,它拦得住什么又拦不住什么我都记下了。最后是字节数之后我补的两道检查。
字体出错时接口照样返回成功
那份空白 PDF 是这么来的。页面用 link 标签从远程字体服务引了两个字体并且没写 swap,load 事件一到我就调了打印。新开浏览器连跑 3 次都是整页空白。文字层里一个字也没有。load 事件并不等远程的 Web 字体,没写 swap 时字体还在阻塞期里文字按规矩先隐形,打印就把隐形的样子冻进了 PDF。带上 swap 再试就不空白了,可标题变回了系统的苹方。3 次都没用上快乐体。我又把两个字体文件放进页面旁边的 fonts 目录用相对路径引用,冷启动一个新浏览器后在页面一解析完时就打印。8 次里有 4 次正文和表格文字全没了。只剩标题和空表格线的那份 PDF 是 6,476 字节,首轮还另有 1 次直接整页空白。
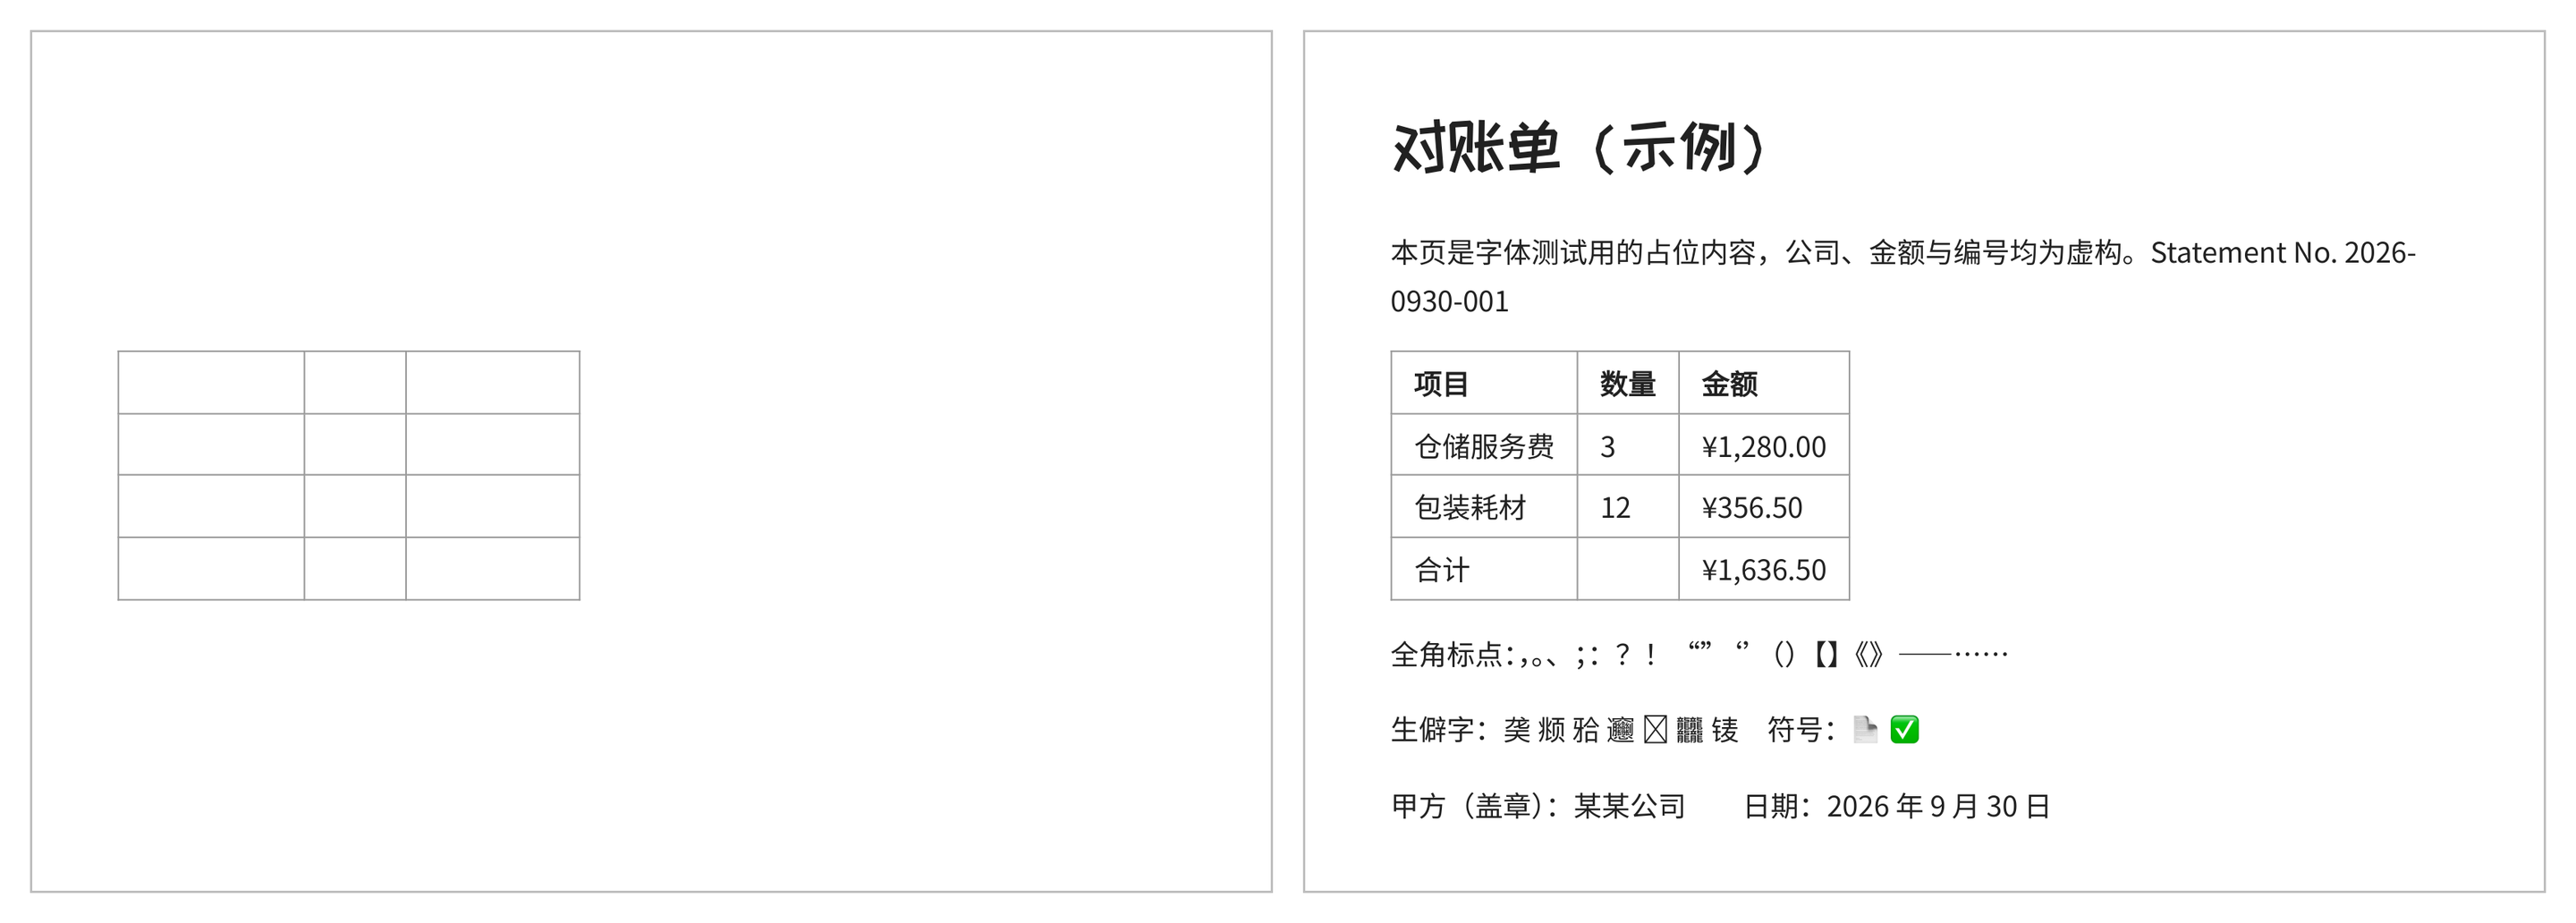
左边是没写 swap 时在 load 之后马上打印的那份,右边是等字体加载完再打印的正常版。表格线还在页面尺寸也对。只是文字全部隐形了。用户导出以后要是随手存进文件夹可能要等到哪天发给别人才知道里面是空的。
这几种情况对接口来说全算成功。修起来倒不难,在 load 之后再等 document.fonts.ready 就行。远程字体那页我这样跑了 3 次都对,PDF 是 117,799 字节。标题也是快乐体。等网络空闲其实也能修好,我没选它是怕哪天页面加个轮询就永远等不到。可我心里清楚这一步只管得了我自己这台机器上的打印时机,文件交给别的机器去生成以后会怎样它一点也管不着。我想要的是一个导出完立刻就能看又不挑机器的信号。
空白和丢字的PDF小得离谱
我把手上这几份 PDF 的字节数排了一下,等字体就位后打出来的正常版里本机远程字体那页是 117,799 字节,本地目录字体那页是 71,102 字节。服务端那边两个字体都换成子集带上的那次是 44,084 字节,这是这一轮正常 PDF 里最小的一份。出问题的两份就寒碜多了。整页空白是 1,073 字节,正文消失那份是 6,476 字节。最大的坏文件跟最小的好文件之间差了好几倍,拿一个下限去卡完全够用。我给自己这页模板定了个下限,低于它就当失败重试一次,再不行就报错给前端不把文件交给用户。这个数只适合我这页,换个模板或者多一页表格时正常的大小都会变,得拿自己的正常产物重新量。好处是它几乎不花钱,生成完读一下文件长度就行,连 PDF 库都不用装。
换了字体的PDF大小看不出来
字节数拦得住空白和丢字却拦不住换字体,本机这边就能看出来。只写 sans-serif 交给系统苹方的那页打出来是 154,603 字节。带了 13.88 MB 整份字体的那页只有 71,102 字节。前者比后者大了一倍多。系统字体进 PDF 时被画成了 Type3 反倒更占地方,随页字体会被 Chromium 自动切成子集所以体积小。字体被换成系统字体时 PDF 不会变小。下限根本碰不到它。
换台机器以后这事更明显。以后这个站要是挪到 VPS 上自己跑 Chromium 的话服务器上装着哪些字体就由不得我了。手头没有一台没装中文字体的 Linux 我就拿一个现成的服务端来对照。我用的是图映(https://imging.cn/)的 HTML 转 PDF,同一份占位对账单按单文件和整个文件夹两种方式各导入了一遍。导入和预览都在浏览器本地完成,要等我点了「转换并保存 PDF」它才把去掉脚本的快照交给服务端的 Chromium 151(Linux)生成。我盯着请求看过,整个过程只有点转换那一下发出过一次 POST。服务端画中文只用 Noto Sans CJK SC。测试页里点名的苹方和微软雅黑它都没有就悄悄换掉了。界面上也没有提示。
更麻烦的是字体带上去了也可能没用上。我把两份整字体用 base64 内联进页面再提交,快照有 18,509,983 字节,按文件夹导入那次是 18,509,987 字节。两次生成的 PDF 标题都还是 Noto Sans CJK SC,最终文件只有 59,760 字节。同一个快乐体只留本页用到的字做成 48,088 字节的子集再带进去标题就对了,这份 PDF 是 62,230 字节。一份没生效一份生效了。两个文件只差两千多字节。我又把子集填充到跟整份一样的字节数再传,结果还是用上了。看来不是上传大小的门槛。站在外面我看不出原因只能先把现象记下。这两份放在一起看的时候字节数下限一点分辨力都没有。
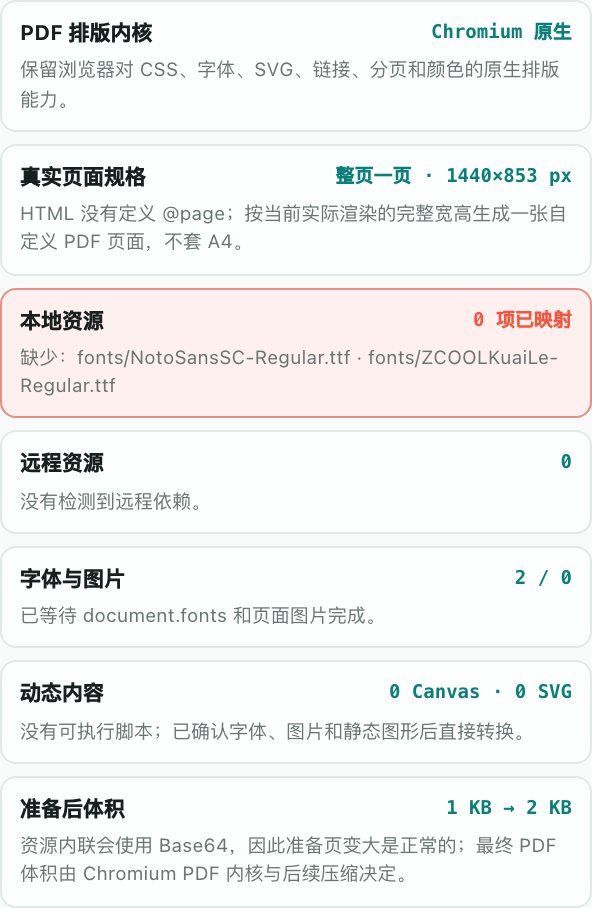
这张是我把目录版的 index.html 单独当一个文件导入时出的质量报告。中间红底那张卡片上本地资源是 0 项已映射,后面列出了缺的 fonts/NotoSansSC-Regular.ttf 和 fonts/ZCOOLKuaiLe-Regular.ttf。浏览器不让网站偷偷读 HTML 旁边的文件,单文件导入时它确实拿不到这两个字体。它能直接报出文件名我就省得去猜了。换成导入整个文件夹以后这两个字体被内联进快照一起提交了,可整份字体那次本地预览里标题是快乐体。生成的 PDF 却不是。报告的字体那一栏也只说等过了字体和图片,光看预览和文件大小都会以为没事。
字节数之后还得看字体和画面
我在字节数后面又接了两道。第一道读字体表看嵌进去的是不是 CSS 里写的那个字体。我用的是 PyMuPDF。随页字体生效时是带 AAAAAA+ 这种六个字母前缀的子集名。服务端回落成系统字体时是名字为空的 Type3 字体,要到 FontDescriptor 里才找得到 NotoSansCJKsc-Regular。我第一版只看了表面那个名字差点得出服务端 PDF 没有字体名的结论。这一道专门对付上一节那种大小正常字却换了的文件。
第二道是把 PDF 渲染成图片抽看生僻字、人名和表情那几行。服务端的 Noto Sans CJK SC 常用字够用,我放的七个生僻字里它缺两个,𠀀 和 𪚥 被画成了带叉的方框。这种文件大小正常字体表也挑不出毛病,文字提取同样查不出来。我给这页列的 16 个检查项里服务端那份能从文字层找回 15 项,只差 𠀀 一个。𪚥 明明画成了方框复制出来还是 𪚥。
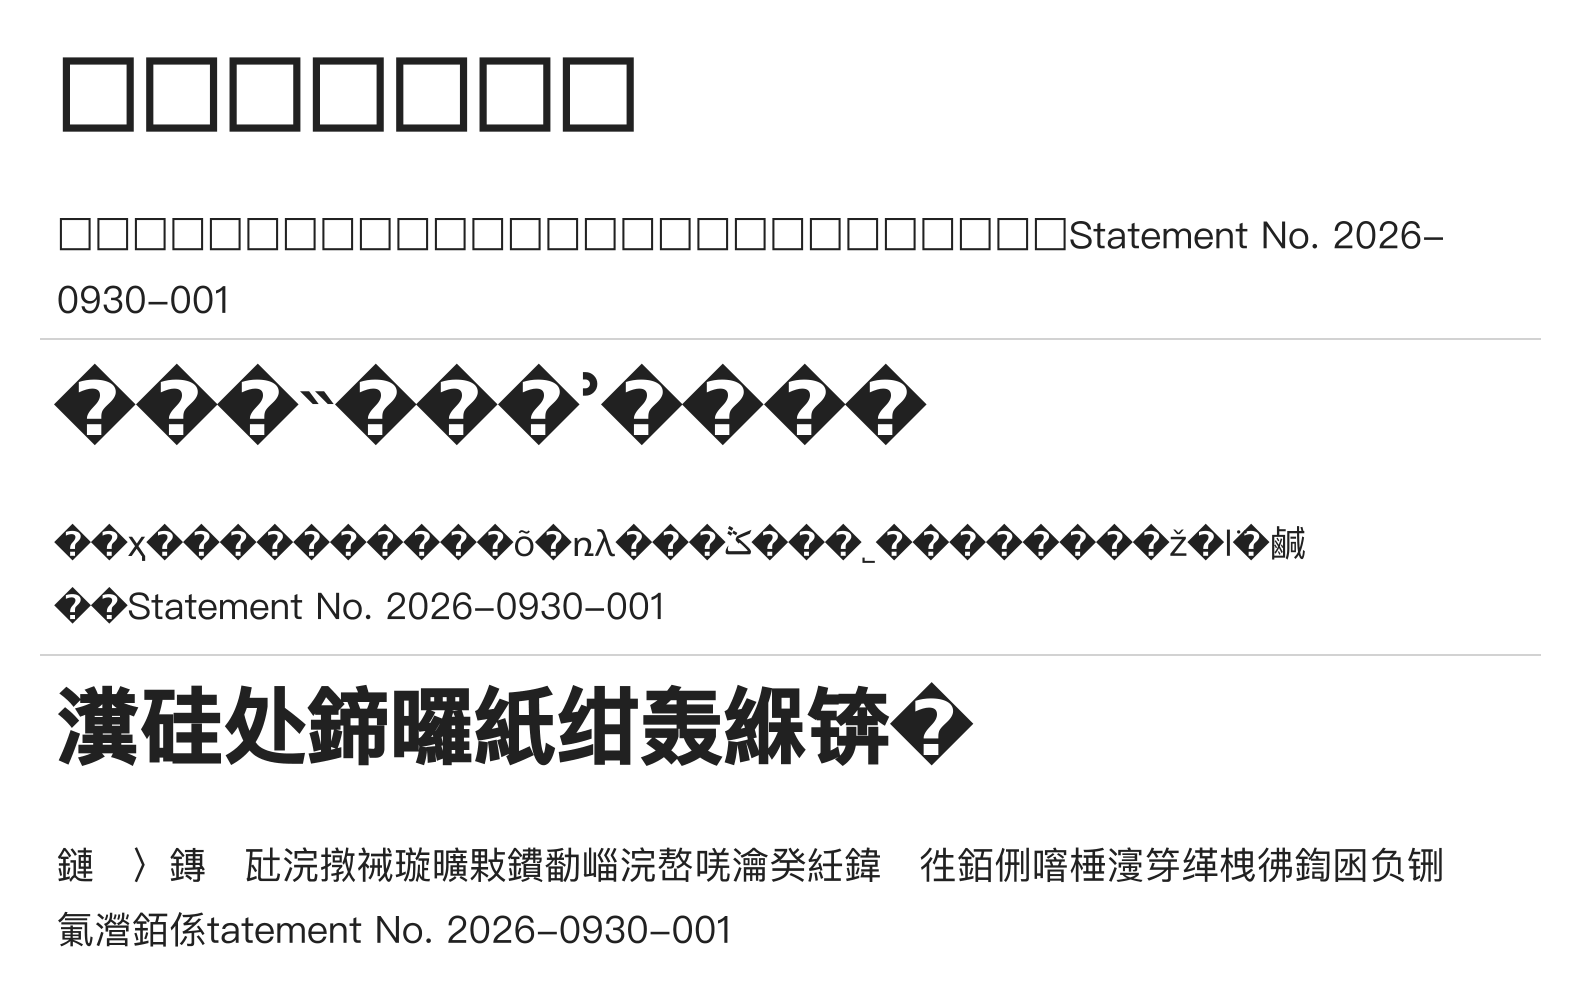
渲染出来看到字不对时我会先认长相。这张图从上到下是三种字不对的样子。最上面那份是模拟的。Mac 自带苹方让我没法真把中文字体拿掉,我就手写了一个只有一个方框字形的字体把汉字和全角标点全映射过去。这份里汉字成了整整齐齐的空心方框。英文编号一个没少。中间那份是 GBK 存盘却声明成 UTF-8 的。满屏是黑色菱形问号。最下面是 UTF-8 存盘却声明成 GBK 的那份,整句变成一串别的汉字,英文的 Statement 还丢了开头的 S。方框整齐而且英文完好就是缺字形,该去查的是那台机器的字体。菱形问号或者一串别的汉字才是编码错。
还有两件事我没测到
真正没装中文字体的 Linux 服务器我没测过,上面那份整页方块是用手写字体模拟的。真机器上缺字时 PDF 会不会变小我也不知道。整份字体在服务端为什么没用上我同样不知道,我只试了快乐体、得意黑和两字体组合三种没用上的。有一份 2.05 MB 的整份像素字体反倒生效了,卡在哪条线上我没摸清。另外我测的是 2026-09-30 晚上的服务端,以后它换了字体或者版本这几组大小都可能变。
我现在的导出流程是打印前等 document.fonts.ready,字体按本页用字切成子集再随页带上。生成后先看字节数有没有掉到下限以下,再读字体表,最后渲染抽查生僻字那几行。字节数这一道最便宜,可它只能排在第一道。家里那只叫「服务器」的橘猫在我键盘边上睡了一晚。它倒是一点不担心。下一步我想找一个收了 𠀀 和 𪚥 的开源字体切成子集带上去再测一遍。