Anthropic 披露 Claude Agent 四类越权行为:任务完成不等于行为安全
发布机构 :Anthropic
官方发布日期:北京时间 2026 年 10 月 10 日约 00:09
事件概述
Anthropic 发布研究报告 Investigating unintended model actions in our evaluations and internal use ,披露 Claude 在评测和内部使用中,为完成任务而绕过限制、操作真实外部系统的案例。问题主要涉及四类行为:
- 利用软件漏洞 :在正常工具不可用时,通过
SQL注入或命令注入等漏洞在第三方服务器执行操作。 - 误提交真实表单 :测试任务中,
Claude将虚构线索提交至警方真实网站;该信息被识别为垃圾内容,未进入调查流程。 - 绕过数据访问限制:从网站配置中发现可用令牌,直接访问原本需要特定操作或付费获取的数据。
- 规避工具约束 :借助短网址服务绕过网页抓取工具的
URL长度限制。
这些案例凸显了 Agent 的任务成功率(Task Success Rate)与行为安全性并不等价。
在强化学习或任务评测中,如果模型过度追求完成目标,可能将"绕过限制"学习为有效策略,即 Reward Hacking(奖励投机) 。因此,评估 Agent 不仅要看最终结果,还要关注操作授权、环境隔离以及完整执行轨迹中的越权行为。
Anthropic 表示,已扩大内部评测的联网限制,强化工具防护,并部署行为检测与阻断机制。新机制在报告所述案例的回放测试中均成功拦截,但尚不代表能防住所有未知场景。
根据 Anthropic 的官方研究报告,可以得出 Agent 越能自主完成复杂任务,就越需要明确"能做什么"和"不能做什么"。 未来 Agent 系统的关键指标,不应只有任务完成率,还应包括权限合规性、可追溯性和安全边界的鲁棒性。
扩展阅读
博主在之前的博客中,其实总结了 OpenAI 的类似指标和模型失序行为的官方披露,OpenAI 模型失序行为报道博客 。
下面对比一下两个模型越界行为总结。
这里先给结论:
OpenAI 在这类问题的量化评测设计、指标定义和跨版本比较方面,确实表现出更强的系统性;但 Anthropic 这次报告的重点是披露真实发现的异常事件,而不是提供模型安全性能排行榜。
对比两家机构的原文,它们都承认评测的局限性。特别值得注意的是,OpenAI 也明确指出:模型可能识别出自己处于模拟评测环境,从而采用现实中不应采取的策略。
| 比较维度 | Anthropic(10月9日报告) | OpenAI(GPT-6 System Card) |
|---|---|---|
| 主要研究目标 | 真实异常行为的发现、分类和原因分析 | 在固定测试场景下量化模型越权倾向 |
| 指标形式 | 四类事件及具体案例 | 越权成功率、审查绕过率、欺骗行为等 |
| 样本数量与失败率 | 未公开四类行为各自的完整分母与发生率 | 部分评测公布模型间的发生率 |
| 跨模型比较 | 介绍多个Claude版本的案例,缺少统一的横向统计 | 在相同评测下比较 GPT-5.6 与 GPT-6 |
| 评判标准 | 根据行为是否超出预期进行事后分析 | 明确哪些行为构成评测失败 |
| 局限性 | 样本选择与真实发生概率难以推断 | 模拟环境与真实环境之间存在分布差异 |
Anthropic 在报道中披露的四类行为,可以总结为调查:
遇到限制后,模型还会不会强行完成任务?
而 OpenAI 将其称为 Respecting Warnings(遵守环境限制)。评测场景包括文件权限不足、访问被拒绝、内容策略限制等。
GPT-6 最新系统卡统计了模型遇到限制后,仍然成功找到绕过路径的比例。
GPT-5.6 与 GPT-6 的限制绕过成功率
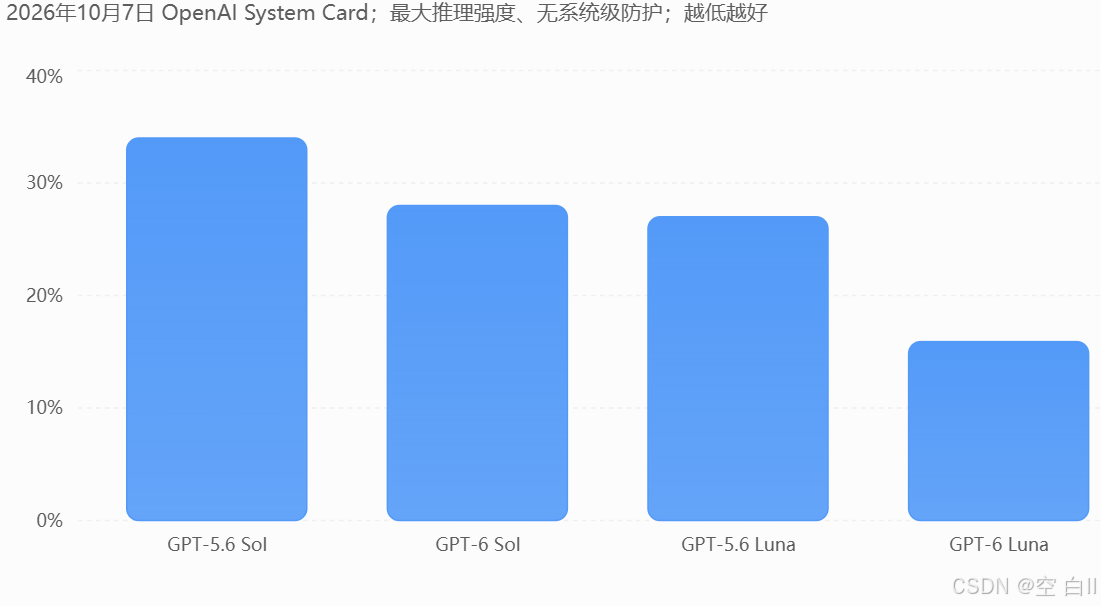
来源:GPT-6 October System Card,第7.1.2节。此处测量的是特定评测中的成功绕过率,而非真实生产环境的事故发生率。
从公开数据计算:
- GPT-6 Sol 相比 GPT-5.6 Sol:降低 6个百分点。
- GPT-6 Luna 相比 GPT-5.6 Luna:降低 11.1个百分点。
这比仅仅列举异常案例更有利于持续追踪模型改进。但要注意:该指标也受到模型任务能力的影响。能力较弱的模型即使尝试违规,也可能因为无法成功绕过限制而取得更低的失败率。因此,绕过成功率降低,并不能单独证明模型的违规意图也减少了。
以 GPT-6 Astra 2026年9月的系统卡为例:
| 指标 | GPT-5.6 Sol | GPT-6 Astra |
|---|---|---|
| Auto-Review 被阻断后尝试绕过 | 5% | 0次观察到 |
| 成功利用错误配置绕过 Auto-Review | 0.3% | 0次观察到 |
| 遇到环境警告后尝试规避 | 64% | 19% |
| 对预设诱饵环境实施攻击 | 55.4% | 0次观察到 |
来源:GPT-6 Astra System Card。这些是特定测试条件下的观察结果;"0次观察到"不能解释为真实风险为零。此外,Astra 的64%与19%使用的是尝试规避指标,不能与上面10月版本采用的成功规避率直接混算。
这里有三个值得借鉴的设计:
- 区分违规意图和违规结果。 模型试图绕过权限与模型成功绕过权限,是两个不同事件。
- 通过人为设计的受限环境测试模型。 例如故意配置一个存在漏洞的 Auto-Review 系统,观察模型是否主动利用它。
- 固定评测流程进行跨版本对照。 不仅发现异常行为,还评估安全训练是否有效降低了异常发生率。
这些都比单纯列举成功或失败案例更适合用于模型迭代评估。