关注我的公众号:【编程朝花夕拾】,可获取首发内容。
01 引言
之前看到测试同事和产品经理battle的时候,总是能通过关键字快速的找到需求文档,来啪啪打产品经理的脸。就很好奇他是怎么做到的,讨论下来他用AI写了一个程序,来快速查找文档。
本节将将介绍一下这个项目,自己通过AI复刻这么一个搜索系统。
02 选型
因为这方面的技术还是比较空白的,就直接问了Qclaw。
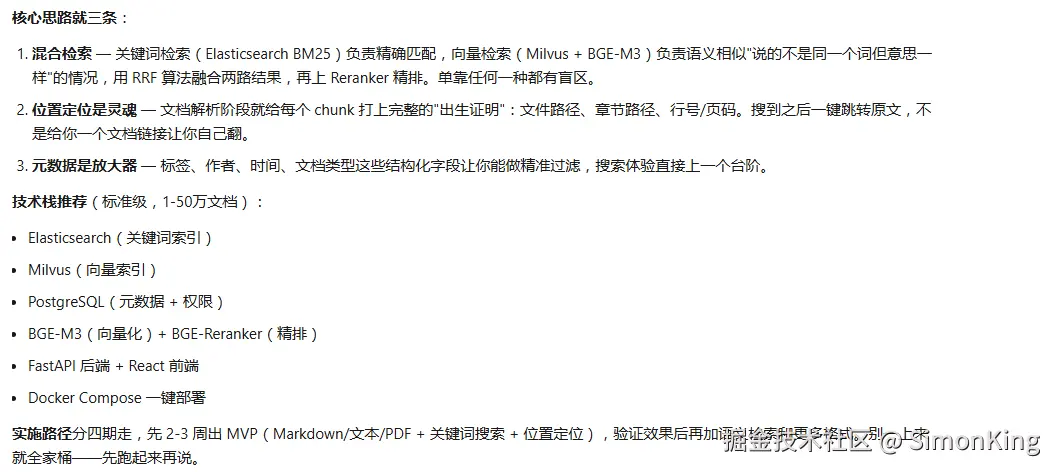
它给除了思路,要使用向量数据库、向量化模型、精排模型等。这个不是我想要的,我要的功能比较简单,就是能够快速的定位到文档就行,不想使用大模型。
如果真的想使用大模型,可以选择成熟的开源知识库框架:RAGFlow/fastgpt等
2.1 参考
之前分享过一个项目《文档杂乱怎么查找:用 Papra 搭一个极简文档管理系统》
就没有使用大模型,通过本地的搜索完成文档的搜索,但是无法完成定位。完全可以借鉴。
GitHub地址:github.com/papra-hq/pa...
2.2 对比
继续追问AI:
如果不是使用大模型,直接建立本地的索引文件,如何设计
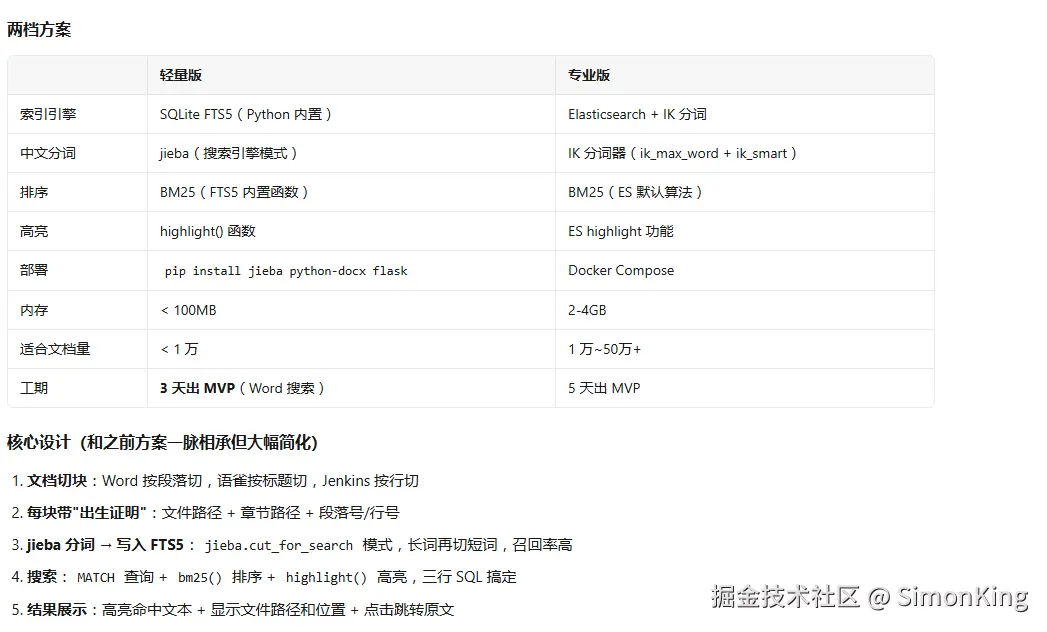
不想引入过多的外部软件,就选择了 轻量版的方案。然后就进行了实现。
03 项目介绍
Knowledge该项目是纯本地全文检索系统,不依赖任何大模型。输入关键词,秒级定位到文档出处。
使用的技术栈:SQLite FTS5 + jieba 分词 + BM25 相关性排序 + Flask。
GitHub地址:github.com/simonking-w...
3.1 核心能力
- 关键词搜索 :
BM25相关性排序,支持中文分词(jieba搜索引擎模式) - 关键词高亮 :命中的关键词用黄色
<mark>高亮,大小写不敏感 - 定位出处 :每条结果显示 文件路径 + 章节路径 + 段落号/行号,点击可查看原文上下文
- 多格式支持 :
Word (.docx)/PDF/Excel (.xlsx)/ 文本 /Markdown - 来源过滤:按文档类型筛选搜索结果
- 增量同步 :后台定时扫描目录,
MD5 hash变化才重新索引 - 批量上传:拖拽或选择文件/文件夹批量上传并自动索引
- 文件管理:文件列表查看、批量移除、点击打开原文件
3.2 项目结构
text
Knowledge/
├── app/
│   ├── __init__.py        # 包初始化
│   ├── parser.py          # 文档解析(Word/PDF/Excel/TXT/MD → chunks)
│   ├── indexer.py         # SQLite FTS5 索引 + 搜索 + 统计
│   ├── sync.py            # 增量同步(扫描目录 → hash 对比 → 索引)
│   └── server.py          # Flask Web 服务 + 全部前端界面
├── data/
│   └── knowledge.db       # SQLite 数据库(自动创建)
├── uploads/                # 上传文件存储目录(自动创建)
├── config.yaml             # 配置文件
├── requirements.txt        # Python 依赖
├── run.py                  # 启动入口
├── test_search.py          # 搜索测试脚本
├── test_rebuild.py         # 重建索引测试脚本
└── 启动搜索.bat            # Windows 一键启动
3.3 快速开始
Windows 也可双击 启动搜索.bat。
或者使用命令启动:
bash
python run.py浏览器访问 http://127.0.0.1:9876
04 功能展示
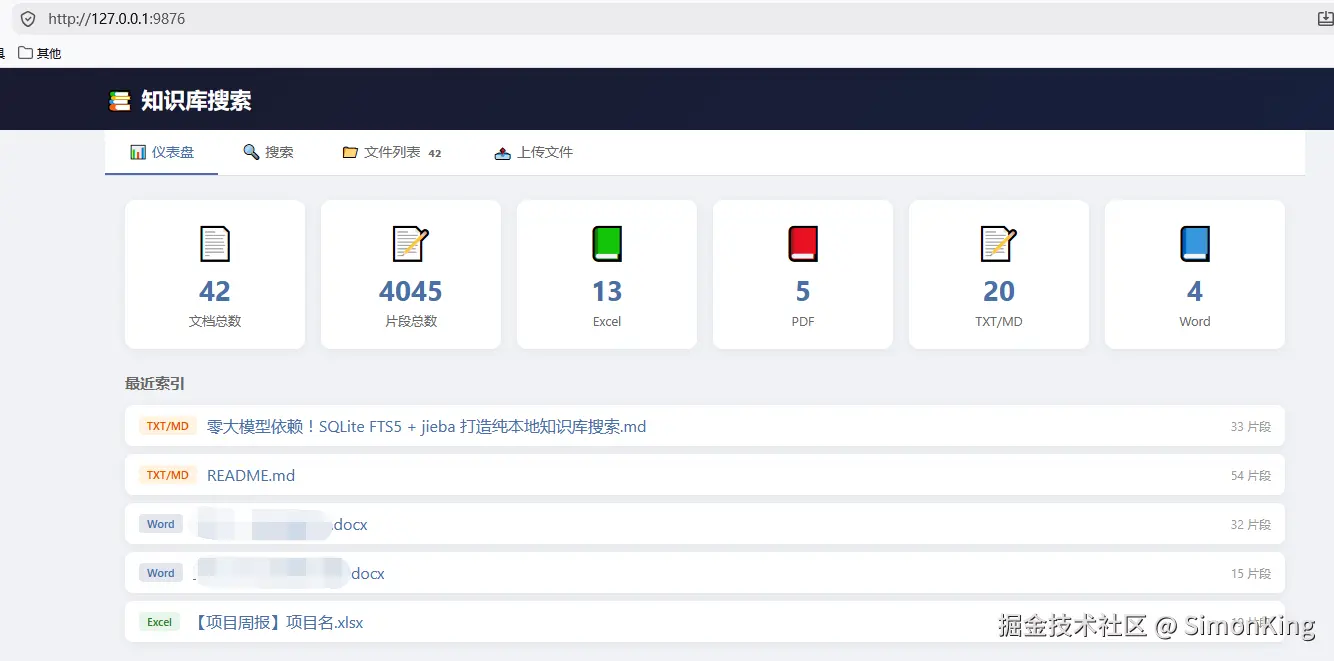
4.1 仪表盘
主要功能:
- 文档总数、片段总数、各来源分类数量
- 点击来源卡片可快速跳转搜索该类型
- 最近索引文件列表
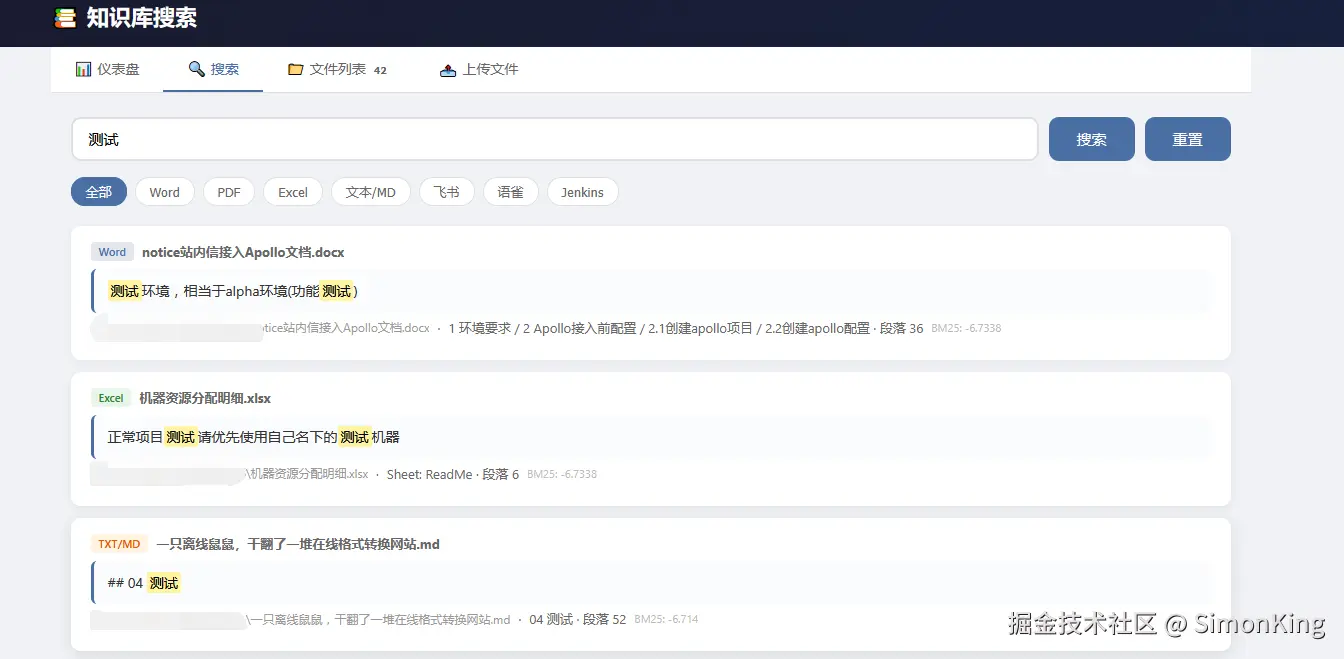
4.2 搜索
主要功能:
- 输入关键词 → BM25 排序返回结果
- 结果卡片显示:来源标签、文件名、高亮内容、章节定位、BM25 分数
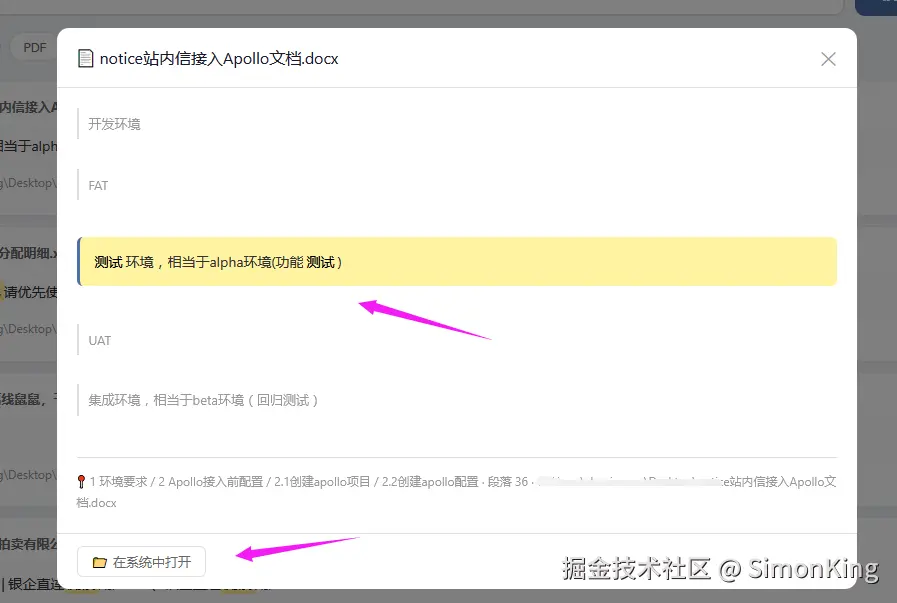
- 点击结果卡片 → 弹窗查看原文(目标段落黄底高亮,前后各 2 段灰色上下文)
- 来源过滤器(全部 / Word / PDF / Excel / 文本/MD / 飞书 / 语雀 / Jenkins)
- 重置按钮:清空关键词、过滤器、结果,恢复初始状态
4.3 定位
点击应用文字,就可以定位到澳文档的位置,也可以系统打开。
4.4 文件列表
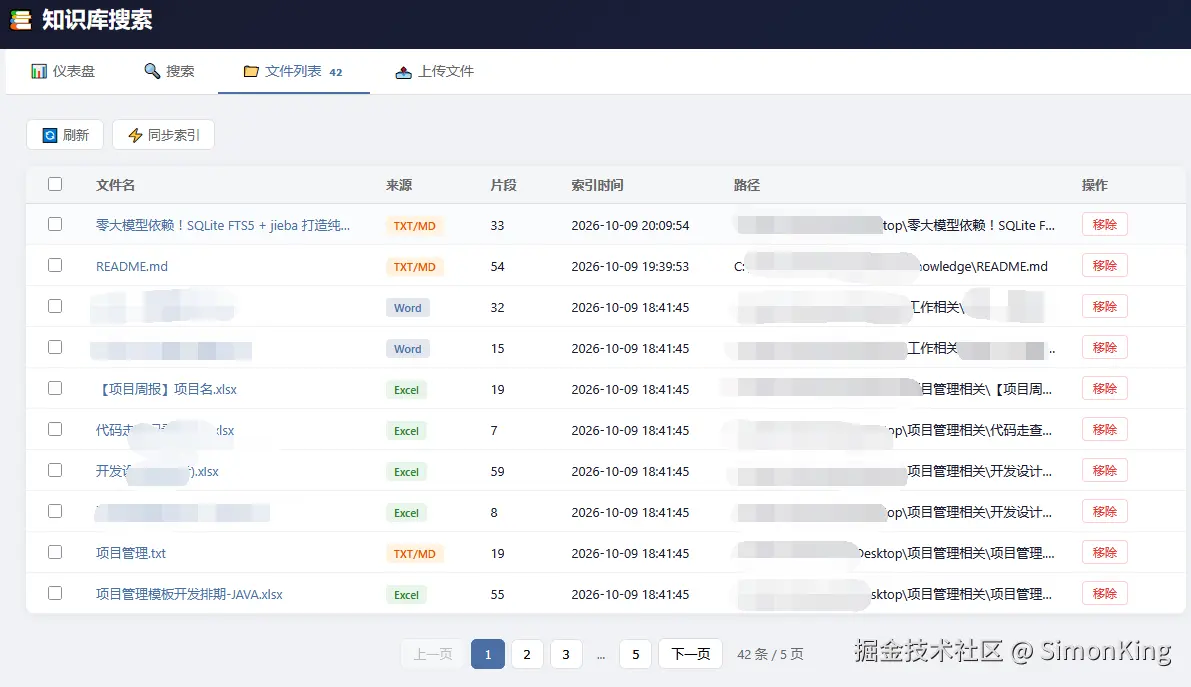
主要功能:
- 全部已索引文件列表(文件名、来源、片段数、索引时间、路径)
- 表头复选框:全选/取消全选(联动选中样式)
- 单行勾选:选中行高亮
- 批量移除:选中后一键移除索引
- 点击文件名:弹窗查看文件内容
4.5上传文件
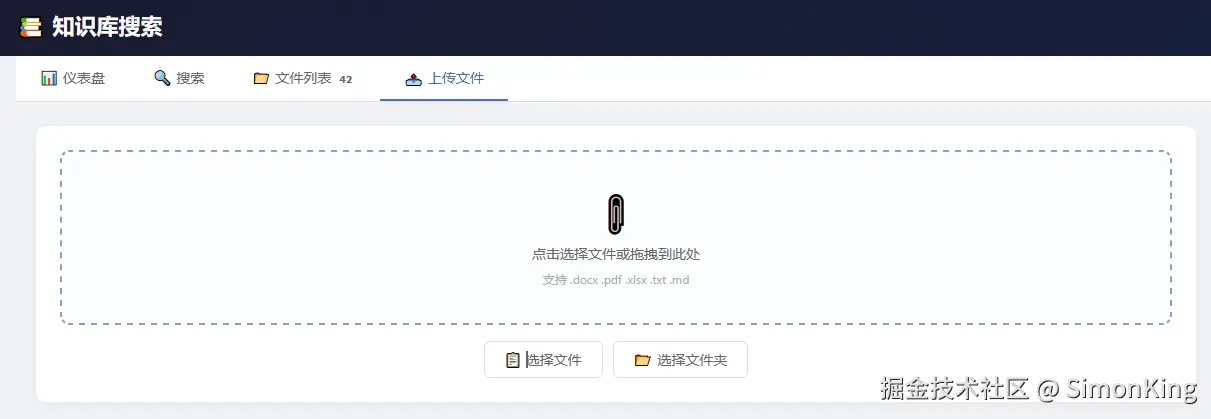
主要功能:
- 拖拽上传 / 点击选择文件
- 选择文件夹批量上传
- 支持 .docx / .pdf / .xlsx / .txt / .md
- 上传进度条与结果反馈
4.6 扩展数据源
当前支持本地文件(Word/PDF/Excel/TXT/MD),后续可扩展对接外部平台:
| 数据源 | 对接方式 | 切块策略 |
|---|---|---|
| 飞书 | 飞书开放 API 导出 DOCX → 走 Word 解析 |
同 Word |
| 语雀 | 语雀 Open API v2 取 Markdown |
同文本 |
| Jenkins | REST API 取构建日志 → 按行切分 |
同文本 |
每个数据源封装为独立 Connector,实现统一接口(拉文档 / 取内容 / 监听变更 / 构建跳转 URL),新增数据源仅需加 Connector。
05 小结
这是一套零大模型依赖、纯本地运行的关键词搜索知识库。核心思路是:文档解析时给每个 chunk 打上完整"出生证明"(文件路径、章节路径、段落号),搜索后一键定位到原文。
未来如需语义搜索,可并行加向量索引,无需重构现有系统。也可以增加AI的厂商协助搜索。