目标环境 :宿主机 Ubuntu 22.04,GPU 为 Tesla V100(Volta,
sm_70)运行方式 :Docker 容器(CUDA 12.8 镜像)内编译并启动 Strata 服务
模型:Qwen3.8-Flash-Next-GSQ-RCO-GGUF-IQ2_XS
目录
| 步骤 | 内容 |
|---|---|
| [步骤 1](#步骤 内容 步骤 1 创建容器(CUDA 12.8 镜像,走 HF 镜像源) 步骤 2 工具链:编译器 + Python 步骤 3 第三方依赖 llama.cpp(固定 commit) 步骤 4 环境变量与模型路径 步骤 5 首次安装:编译 + 下载 + 拉取 MTP(只装不启动) 步骤 6 启动服务 步骤 7 测试接口) | 创建容器(CUDA 12.8 镜像,走 HF 镜像源) |
| [步骤 2](#步骤 内容 步骤 1 创建容器(CUDA 12.8 镜像,走 HF 镜像源) 步骤 2 工具链:编译器 + Python 步骤 3 第三方依赖 llama.cpp(固定 commit) 步骤 4 环境变量与模型路径 步骤 5 首次安装:编译 + 下载 + 拉取 MTP(只装不启动) 步骤 6 启动服务 步骤 7 测试接口) | 工具链:编译器 + Python |
| [步骤 3](#步骤 内容 步骤 1 创建容器(CUDA 12.8 镜像,走 HF 镜像源) 步骤 2 工具链:编译器 + Python 步骤 3 第三方依赖 llama.cpp(固定 commit) 步骤 4 环境变量与模型路径 步骤 5 首次安装:编译 + 下载 + 拉取 MTP(只装不启动) 步骤 6 启动服务 步骤 7 测试接口) | 第三方依赖 llama.cpp(固定 commit) |
| [步骤 4](#步骤 内容 步骤 1 创建容器(CUDA 12.8 镜像,走 HF 镜像源) 步骤 2 工具链:编译器 + Python 步骤 3 第三方依赖 llama.cpp(固定 commit) 步骤 4 环境变量与模型路径 步骤 5 首次安装:编译 + 下载 + 拉取 MTP(只装不启动) 步骤 6 启动服务 步骤 7 测试接口) | 环境变量与模型路径 |
| [步骤 5](#步骤 内容 步骤 1 创建容器(CUDA 12.8 镜像,走 HF 镜像源) 步骤 2 工具链:编译器 + Python 步骤 3 第三方依赖 llama.cpp(固定 commit) 步骤 4 环境变量与模型路径 步骤 5 首次安装:编译 + 下载 + 拉取 MTP(只装不启动) 步骤 6 启动服务 步骤 7 测试接口) | 首次安装:编译 + 下载 + 拉取 MTP(只装不启动) |
| [步骤 6](#步骤 内容 步骤 1 创建容器(CUDA 12.8 镜像,走 HF 镜像源) 步骤 2 工具链:编译器 + Python 步骤 3 第三方依赖 llama.cpp(固定 commit) 步骤 4 环境变量与模型路径 步骤 5 首次安装:编译 + 下载 + 拉取 MTP(只装不启动) 步骤 6 启动服务 步骤 7 测试接口) | 启动服务 |
| [步骤 7](#步骤 内容 步骤 1 创建容器(CUDA 12.8 镜像,走 HF 镜像源) 步骤 2 工具链:编译器 + Python 步骤 3 第三方依赖 llama.cpp(固定 commit) 步骤 4 环境变量与模型路径 步骤 5 首次安装:编译 + 下载 + 拉取 MTP(只装不启动) 步骤 6 启动服务 步骤 7 测试接口) | 测试接口 |
关键约定
约定 1|端口一致性
启动时的
--port与测试时的端口必须一致。本文全文统一使用28199。约定 2|GPU 架构
V100 是 Volta(
sm_70),CUDA 13 编译的引擎**,并设置STRATA_EXPERIMENTAL_SM60=1。约定 3|路径一致性
--gguf-dir与软链接必须指向同一个目录,两处保持一致。
步骤 0 | 环境准备
/home/strata/Qwen3.8-Flash-Next-GSQ-RCO-GGUF-IQ2_XS
  mmproj-Qwen3.8-Flash-Next-BF16.gguf
  Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00001-of-00002.gguf
  Qwen3.8-Flash-Next-GSQ-RCO-IQ2_XS-00002-of-00002.gguf

下载地址:https://hf-mirror.com/ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF/tree/main
步骤 1|创建容器
bash
# --network host:容器共用宿主机网络,端口可被局域网访问
# -v /home/strata:/host:模型与 Strata 目录持久化,容器重启不丢数据
docker run -it --name strata-v100 --gpus all \
  --ulimit memlock=-1:-1 --shm-size=32g --network host \
  -v /home/strata:/host -w /host/Strata \
  -e HF_ENDPOINT=https://hf-mirror.com \
  -e STRATA_NVCC=/usr/local/cuda/bin/nvcc \
  docker.1ms.run/nvidia/cuda:12.8.2-devel-ubuntu24.04 bash
容器创建后,后续进入容器无需再 run:
bash
docker start strata-v100
docker exec -it strata-v100 bash
步骤 2|工具链:编译器 + Python
bash
apt-get update && apt-get install -y --no-install-recommends \
  build-essential git curl unzip ca-certificates libatomic1 \
  python3 python3-pip python3-venv
bash
export PIP_INDEX_URL=https://pypi.tuna.tsinghua.edu.cn/simple
pip3 install "cmake>=3.24" ninja
步骤 3|第三方依赖 llama.cpp
固定 commit:3cf03257f219afbe7334045ff7c6a06ac68c627d(走 gh-proxy 加速)。
bash
# 若 /host/Strata 还不存在:
#   git clone https://github.com/Niko1221/Strata /host/Strata

cd /host/Strata && mkdir -p third_party && cd third_party

curl -L -o /tmp/l.zip \
  https://gh-proxy.com/https://github.com/ggml-org/llama.cpp/archive/3cf03257f219afbe7334045ff7c6a06ac68c627d.zip

unzip -q /tmp/l.zip -d /tmp/uu && rm -rf llama.cpp && mv /tmp/uu/llama.cpp-3cf03257* llama.cpp
可以自己手动下载 llama.cpp,替换以上代码。
校验解压是否完整:
bash
ls llama.cpp/ggml/CMakeLists.txt llama.cpp/gguf-py -d步骤 4|环境变量与模型路径
bash
cd /host/Strata

export STRATA_NVCC=/usr/local/cuda/bin/nvcc
export HF_ENDPOINT=https://hf-mirror.com
# 缺它 MTP 那步会去 huggingface.co,然后 Network is unreachable
GGUF 软链接(下面的 --gguf-dir 必须指向同一个目录):
bash
ln -sfn /models/GGUF_LIST/Qwen3.8-Flash-Next-GSQ-RCO-GGUF-IQ2_XS /home/strata/qwen3.8-next-iq2-xsV100 是 Volta(sm_70),CUDA 13 已不支持,必须用 CUDA 12 编译的引擎:
bash
export STRATA_EXPERIMENTAL_SM60=1驱动要求:CUDA 12 需要驱动 525 以上 (CUDA 13 需要 580)。在宿主机上确认:
bash
apt list --installed 'nvidia-driver*'

# 不够则:
sudo apt install nvidia-driver-580 && sudo rebootSun Oct 11 10:57:47 2026
+-----------------------------------------------------------------------------------------+
| NVIDIA-SMI 580.178.04 Driver Version: 580.178.04 CUDA Version: 13.0 |
+-----------------------------------------+------------------------+----------------------+
| GPU Name Persistence-M | Bus-Id Disp.A | Volatile Uncorr. ECC |
| Fan Temp Perf Pwr:Usage/Cap | Memory-Usage | GPU-Util Compute M. |
| | | MIG M. |
|=========================================+========================+======================|
| 0 Tesla PG503-216 On | 00000000:04:00.0 Off | 0 |
| N/A 33C P0 39W / 300W | 32126MiB / 32768MiB | 0% Default |
| | | N/A |
+-----------------------------------------+------------------------+----------------------+步骤 5|首次安装(编译 + 下载 + 拉取 MTP,只装不启动)
进入容器:
bash
docker start strata-v100
docker exec -it strata-v100 bash
设置环境:
bash
export STRATA_EXPERIMENTAL_SM60=1
export PIP_INDEX_URL=https://mirrors.cloud.tencent.com/pypi/simple
执行安装:
bash
./setup.sh --build \
  --family qwen --model IQ2_XS \
  --gguf-dir /host/Qwen3.8-Flash-Next-GSQ-RCO-GGUF-IQ2_XS \
  --gpu 0 --context 262144 \
  --vision gpu \
  --port 28199 --host 0.0.0.0 --api-key '123456' \
--yes --no-start这里目前有7步,已经下载模型文件,后续步骤会自动跳过。
在下载MTP模型文件时,需要下载5G会比较慢,如HF_ENDPOINT不起作用,可以修改strata_pack.py代码步骤 6|启动服务
已下载 / 已编译的部分会自动跳过。
bash
./setup.sh --port 28199步骤 7|测试接口
端口必须与启动时一致(
--port 28199),以下测试均使用28199。
7.1 确认模型名称
下面的 --model / "model" 字段要用它返回的名字。
bash
curl http://127.0.0.1:28199/v1/models -H "Authorization: Bearer 123456"7.2 非流式对话
bash
curl http://127.0.0.1:28199/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer 123456" \
  -d '{"model":"qwen3.8-flash-next","messages":[{"role":"user","content":"你好,用一句话介绍你自己"}],"stream":false}'
7.3 流式对话
bash
curl -N http://127.0.0.1:28199/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer 123456" \
  -d '{"model":"qwen3.8-flash-next","messages":[{"role":"user","content":"写个快速排序 java 和 python 不同版本"}],"stream":true}'
7.4 流式参数下的单轮请求
bash
curl -N http://127.0.0.1:28199/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer 123456" \
  -d '{"model":"qwen3.8-flash-next","messages":[{"role":"user","content":"写个快速排序 java"}],"stream":false}'
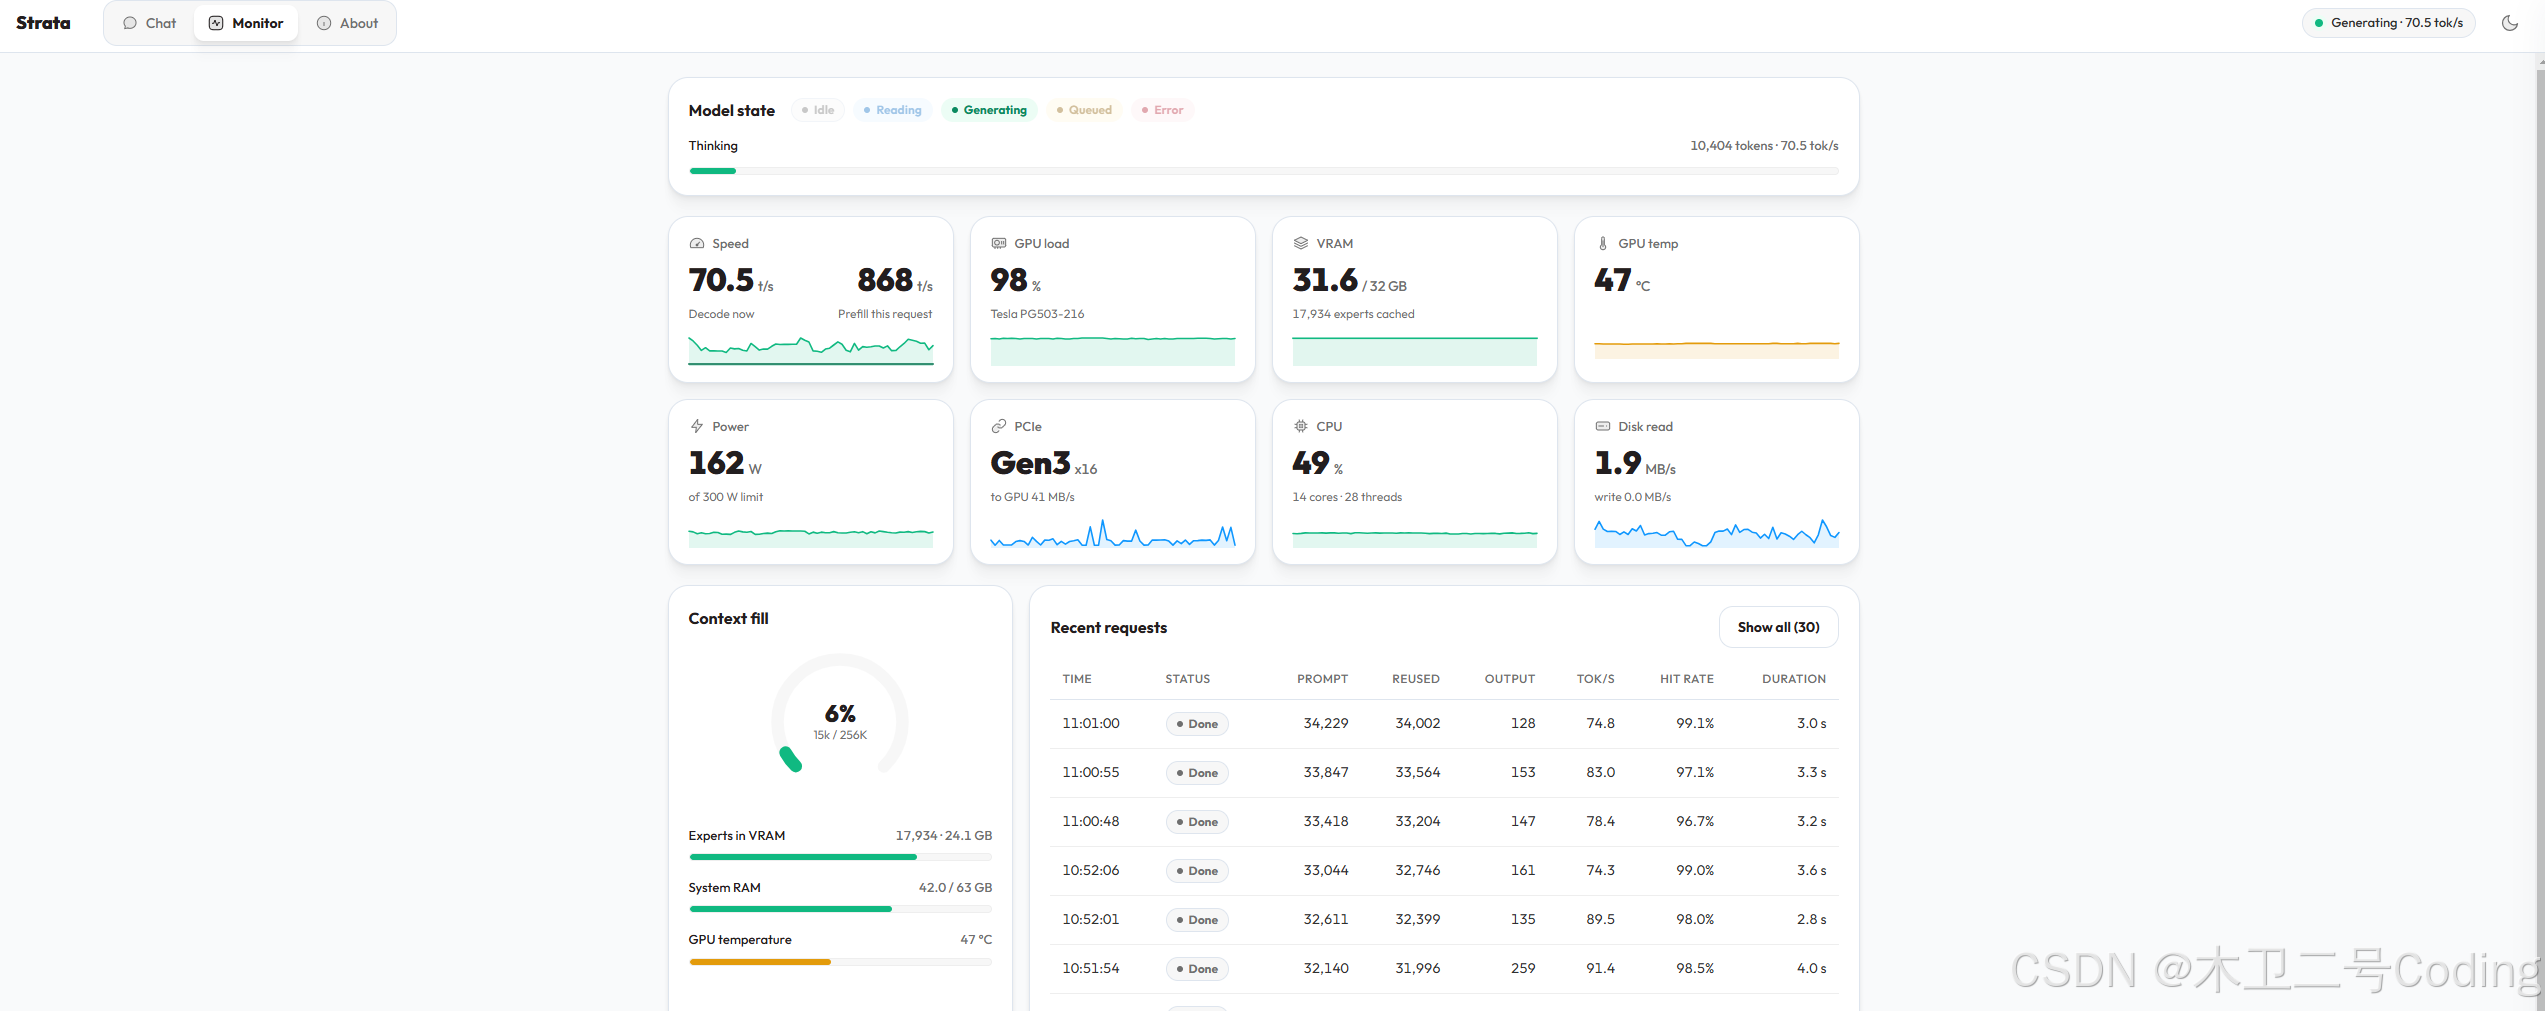
8 执行界面
附录|参数速查
| 参数 | 说明 |
|---|---|
--gpus all |
容器内可见全部 GPU |
--ulimit memlock=-1:-1 |
解除内存锁定限制 |
--shm-size=32g |
共享内存大小 |
--network host |
共用宿主机网络,便于局域网访问 |
-v /home/strata:/host |
模型与 Strata 目录持久化 |
HF_ENDPOINT |
HF 镜像源,避免 Network is unreachable |
STRATA_NVCC |
CUDA 编译器路径 |
STRATA_EXPERIMENTAL_SM60 |
允许在 sm_70(V100)上编译运行 |
--family qwen --model IQ2_XS |
模型家族与量化档位 |
--context 262144 |
上下文长度 |
--vision gpu |
视觉模型使用 GPU |
--host 0.0.0.0 |
监听所有网卡 |
--api-key |
接口鉴权密钥 |
--yes --no-start |
免交互,仅安装不启动 |
附录|常见问题
- 端口不匹配 :
connection refused时先核对--port与 curl 端口是否一致。 - 模型名报错 :先跑
/v1/models,用返回值替换"model"字段。 - MTP 下载失败 :检查
HF_ENDPOINT是否已导出为https://hf-mirror.com。 - 编译报错(架构不支持) :确认使用 CUDA 12 镜像且已设置
STRATA_EXPERIMENTAL_SM60=1。