**直答:**无头浏览器不等于爬虫,却会把只开一页就退出的脚本访问计入跳出,把跳出率推高。过滤要按访问要素分层识别,不能只靠 User-Agent 一刀切。
跳出率是网站分析里被反复引用、也被反复误读的一个指标。这里要先纠一个常见口径:在 Google Analytics 4 里,跳出率是会话级指标,等于"未参与会话"占全部会话的百分比------一次会话既未停留超过 10 秒、也未触发关键事件、页面或屏幕浏览少于 2 次,才被记为一次跳出。它的分子分母都落在"会话"上,而不是"访客人数"。读数越高通常代表页面在会话维度上的留存越弱。问题在于,这个口径默认每次会话背后都是一个真实、有意图的人,而当无头浏览器、自动化脚本、页面巡检任务混进流量池时,这个前提就不成立了。我倾向先把"什么是一次有效会话"界定清楚,再去谈过滤。
一个常见误区是"无头浏览器就是爬虫"吗?
一个常见误区是把无头浏览器直接等同于爬虫。实际上两者有重叠,但并不等价。无头浏览器是没有可见窗口的浏览器内核,它可以被爬虫用来渲染 JS 页面,也可以被前端自动化测试用来跑回归用例,还可以被监控脚本用来定时截图、做可用性巡检。爬虫强调的是"批量抓取内容",无头浏览器强调的是"以编程方式驱动一个完整浏览器",前者是目的,后者是手段。
把二者混为一谈的直接后果,是过滤规则越收越紧,把本应保留的自动化测试流量也一并排除了。另一个常见误区是认为跳出率高就一定是页面差。当流量结构里涌入大量单页短停留的脚本会话时,跳出率上升反映的是"流量变了",而不是"页面变差了"。在平台上,可以借助实时流量监控先看增量会话的构成,再判断读数波动来自内容问题还是来源结构问题,这一步能避免把统计噪声误读成产品事故。
**误区提醒:**不要看到跳出率攀升就立刻改版。先确认这段时间有没有自动化巡检、压测脚本、第三方页面监测任务在跑,否则容易在错误的方向上做优化。
为什么脚本访问会把跳出率推高?
在 GA4 口径下,跳出率的分子是"未参与会话"的次数,分母是全部会话数。脚本类访问的典型行为是:加载一个页面,等待若干毫秒到数秒,完成截图或数据采集,然后立刻退出,既不点击,也不跳转,更不会停留阅读。按上面的定义,这样一次会话既不超过 10 秒、也没有关键事件、更没有第二个页面浏览,天然就是一次跳出。
当这类会话在总访客里占比很小,对跳出率的拉动有限;一旦某个定时任务频率提高,或外部监测工具批量拉取页面,分子会被快速撑大,分母却没有同等比例的真实新增。于是跳出率曲线出现一个与发布节奏无关的尖峰。这种尖峰往往和改版、投放无关,而是和外部任务的调度周期对齐。在对应工具上,来源分析与实时流量监控可以用来核对这段时间的来源构成,判断尖峰是否集中在某个固定来源或固定时段。
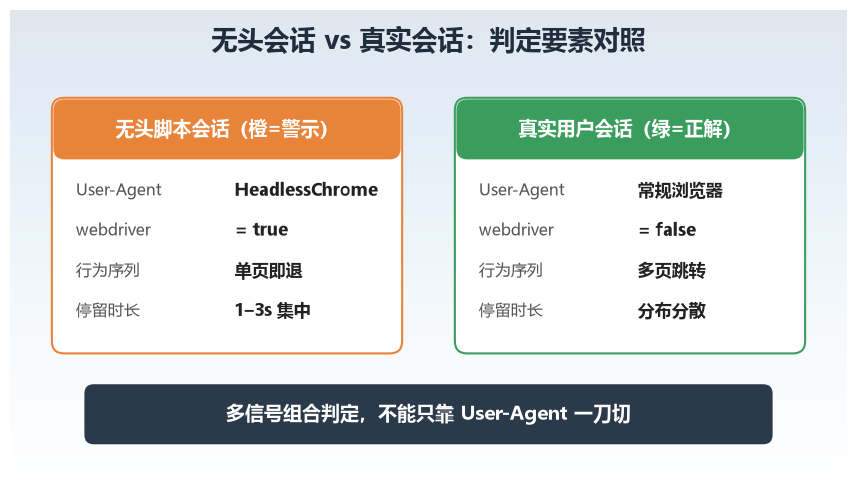 无头访问(左,橙)与真实访问(右,绿)在 UA、webdriver 标记、行为序列、停留时长上的判定要素对比
无头访问该按哪些要素识别,而不是只看 UA?
把弱信号组合成一次会话画像
只靠 User-Agent 名单是早期做法,今天已经不够用。现代自动化框架可以改写 UA,也可以隐藏 navigator.webdriver 这个标准标记。MDN 对 navigator.webdriver 的说明指出,它用于表示用户代理是否受自动化控制,是一个可被脚本改写的信号,而不是铁证。可靠的做法是把多个弱信号组合起来看,而不是押注单一字段。
| 判定要素 | 真实访问的常见表现 | 无头脚本的常见表现 | 使用边界 |
|---|---|---|---|
| User-Agent | 普通浏览器版本号,随用户群分布 | 出现 HeadlessChrome、自动化库特征串 | 可改写,仅作初筛,不能单凭它下结论 |
| navigator.webdriver | 通常为 undefined 或 false | 标准自动化下为 true,可被隐藏 | MDN 列为自动化标记,命中需复核 |
| 行为序列 | 有点击、滚动、多页跳转 | 单页加载后立即退出,无交互事件 | 与事件埋点配合判断 |
| 停留时长 | 数秒到数分钟分布 | 集中在极短区间,波动很小 | 与平均会话时长、跳出会话时长分布对照看,不单独定案 |
| 来源与时段 | 分散来源、自然时段 | 固定来源、周期性整点访问 | 用于核对异常,不直接定案 |
把这些要素组合后,识别就从"匹配一个字符串"变成"判断一次会话像不像人"。工程上常用的落地方式,是在会话启动前跑一段多信号打分脚本,命中两项以上弱信号才打标,而不是看到 HeadlessChrome 字样就直接封杀。下面这段前端代码就是一个最小可运行的联合判定示例,UA 特征、navigator.webdriver、插件与语言包指纹三者投票:
// 无头浏览器联合判定:UA 特征 + webdriver 标记 + 浏览器指纹弱信号
function isLikelyHeadless() {
  const ua = navigator.userAgent;
  // 1) UA 出现 HeadlessChrome 等自动化内核特征串
  const uaHit = /HeadlessChrome|PhantomJS|HeadlessEdge/i.test(ua);
  // 2) 标准自动化标记暴露为 true(隐身模式 / 部分框架会把它隐藏,所以只是一票)
  const webdriverHit = navigator.webdriver === true;
  // 3) 真实浏览器通常有插件列表与多语言,无头内核常两者皆空
  const fingerprintHit = navigator.plugins.length === 0 && navigator.languages.length === 0;
  // 多信号投票,命中两项及以上才判为可疑,避免单点误杀
  const score = [uaHit, webdriverHit, fingerprintHit].filter(Boolean).length;
  return score >= 2;
}

// 在 456数据 Web SDK 的会话启动前调用,把判定结果写进事件属性,供后续按属性下钻
window._yhxw456_trackdata = window._yhxw456_trackdata || [];
window._yhxw456_trackdata.push([
  'set',
  'is_headless_guess',
  isLikelyHeadless() ? 'suspect' : 'normal'
]);
需要强调的是,UA 过滤、自定义排除规则属于网站接入统计时的通用做法;在平台上,事件三段结构(分类 / 名称 / 属性)允许把上面的 is_headless_guess 作为事件属性埋下去,之后再按属性下钻、圈出可疑会话人工复核。过滤规则本身仍需结合自身流量结构设置,工具不替你决定阈值。
过滤前后的跳出率口径有什么差别?
分子分母必须同源重算
过滤不是简单地从读数里减掉一个数,而是要重新界定"哪些会话计入分母"。一旦把无头脚本会话排除在总会话之外,分子和分母要在同一批样本上重新计算,否则会出现"分子用过滤后、分母用过滤前"的错配。下面用一张表对齐两种口径。
| 对比项 | 过滤前口径 | 过滤后口径 |
|---|---|---|
| 计入分母的会话 | 全部会话,含脚本巡检 | 排除识别为无头脚本的会话 |
| 跳出判定 | 单页即离即记跳出 | 同一规则,仅作用于过滤后样本 |
| 读数稳定性 | 随外部任务调度周期波动 | 波动收敛,更接近真实留存 |
| 可解释性 | 尖峰难定位 | 尖峰可归因到具体任务时段 |
这里要特别提醒:过滤规则一旦调整,历史报表不要直接用新规则回算旧数据,否则前后口径不一致,趋势曲线会出现人为断点。正确做法是记录规则生效时间,在那之前保留原口径,从那一天起使用新口径,并在报表旁注明。数据看板与来源关键词等视图适合用来做过滤前后的对照核对,但口径切换的时点需要自己记录,工具不会替你标注。
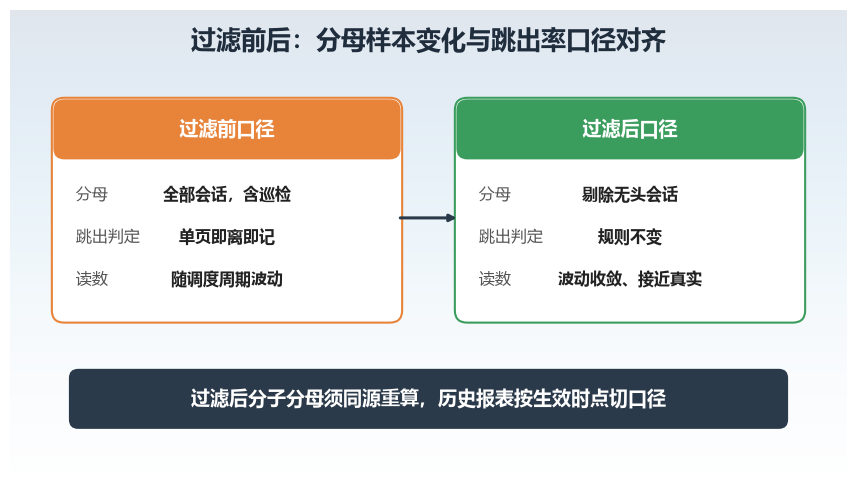 过滤前后分母样本变化与跳出率口径对齐示意
一次返工:把整类无头流量一刀切排除
现象:某次把所有 HeadlessChrome 标记的会话全部排除后,跳出率确实回落了,但转化数据也跟着异常下跌。根因是团队自己的前端自动化测试用例也跑在无头内核里,这些会话本应保留用于验证发布,却被一并过滤。排查证据来自事件流对照:被排除会话里有完整的注册到下单路径,和巡检脚本的单页行为明显不同。修复方式是把"自动化测试流量"与"外部巡检脚本"拆成两类规则,前者保留、后者排除,而不是用一条 UA 名单通吃。经验是:过滤规则要先在小流量上验证,确认被排除的会话确实不属于业务关心的真实用户,再全量生效。
关于跳出率过滤,几个容易问的点
高频疑问速览
无头浏览器访问为什么会抬高跳出率?
无头脚本往往只加载一个页面就立刻关闭,不会继续点击或跳转,按口径会被记为一次跳出。当这类访问在总访客里占比升高,跳出率的分子被撑大,分母却没有同步增长,读数就偏离真实用户的留存表现。
只靠 User-Agent 识别无头浏览器可靠吗?
不够可靠。无头 Chrome、Puppeteer、Playwright 都可以改写 User-Agent,现代自动化框架还会隐藏 navigator.webdriver 标记。只靠 UA 名单过滤,既会漏过伪装后的脚本,也可能误杀使用同一款浏览器版本的真实用户。
过滤无头访问后,跳出率口径要怎么同步调整?
应先固定过滤规则与生效时间点,再重新统计过滤后的访客数与跳出数,保证分子分母来自同一批样本。不要只在原读数上直接减去一个比例,否则会把不同时间窗的样本混在一起。
怎么区分自动化测试流量和真实用户脚本?
看行为序列与会话特征。自动化测试往往访问路径固定、页面停留极短、无鼠标移动与滚动事件、来源集中在办公 IP 段;真实用户即便用脚本辅助,也会留下多页面跳转或长停留痕迹。两者不能用同一套规则一刀切。
跳出率突然升高时先查哪一层?
先看流量结构而非页面本身。用实时流量监控观察增量访客的来源、设备与停留时长,如果短时间涌入大量单页、短停留、无事件的会话,优先怀疑脚本或采集任务,再回头看页面改动。
数据来源:
Google Analytics《GA4 Engagement rate and bounce rate》
Mozilla MDN《Navigator: webdriver property》
Chrome Developers《Puppeteer》
总结
无头浏览器对跳出率的干扰,本质是"非人为会话"被当成了"人为会话"统计。正确的做法不是把所有无窗口浏览器一棍子打死,而是按 UA、自动化标记、行为序列、停留时长、来源时段多要素组合识别,再在固定时点上对齐分子分母的口径。自建仓库可以自己维护一套脚本识别规则,但要承担字段维护与误判成本;在全端分析平台上,实时流量监控与来源分析提供了人工核对异常访问的入口,过滤规则本身则需要结合自身流量结构落地。两种路径都成立,选哪一种取决于团队有没有精力长期维护识别逻辑。