两年前问"选 PGVector 还是 Milvus",答案很简单:数据少就 PGVector,数据多就 Milvus。但 2026 年的今天,AI Agent 把向量数据库从"RAG 的一个附件"变成了"Agent 的长期记忆中枢",这个问题突然就复杂了。LangGraph Checkpoint 该落在哪?用户的跨会话记忆存哪?工具检索用谁?
一、先搞清楚:AI Agent 为什么离不开向量数据库?
很多人对向量数据库的认知还停留在"RAG 里存文档切片"这个层面------把 PDF 切块、Embedding 一下、存进去、用户提问时相似度检索。这个理解在 2024 年是对的,但放到 2026 年的 AI Agent 时代,已经远远不够了。
我们先看一个现代 Agent 的完整记忆结构。以 LangGraph + Mem0 这套主流技术栈为例,一个生产级 Agent 的记忆系统是分层的:
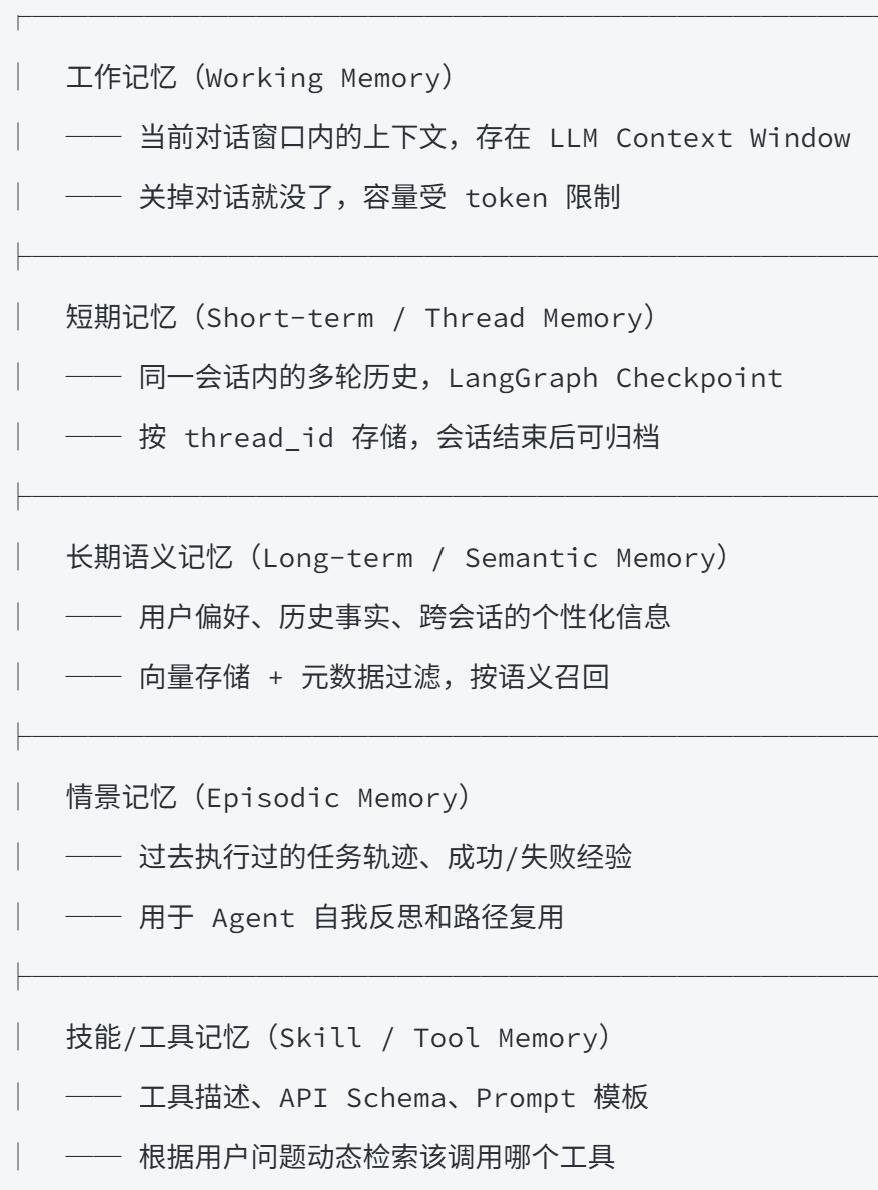
你看,从短期的 Checkpoint 到长期的语义记忆,再到工具检索,向量数据库在每一层都扮演着关键角色。这就是为什么 2026 年大家讨论向量数据库选型时,不再是单纯比"谁检索快",而是要回答:这一层记忆需要什么特性?要不要 ACID?要不要和用户表 JOIN?要不要亿级规模?延迟要求是 20ms 还是 200ms?
带着这个问题,我们再来拆 PGVector 和 Milvus。
二、PGVector:PostgreSQL 的"向量外挂"到底是什么
2.1 它的本质:不是独立数据库,是一个扩展插件
先用一句话讲清楚 PGVector 是什么:
它不是一个独立的数据库产品,而是一个 PostgreSQL 的扩展插件(Extension)。你在自己已有的 PostgreSQL 里执行一句 CREATE EXTENSION vector;,这台数据库就具备了存储和检索向量的能力。
这个定位决定了它所有的优势和劣势。打个比方:PostgreSQL 本来是一个什么都能装的"瑞士军刀"------关系数据、JSON、全文检索、时序数据它都能干,只是每一样都不是极致专业。PGVector 相当于给这把瑞士军刀又加了一个"向量刀片",让它在不增加任何新组件的前提下,多了一门手艺。
这意味着什么?意味着你不需要为了做 RAG 而多维护一套数据库。你的用户表、订单表、权限表、会话表本来就在 PostgreSQL 里,向量数据和这些业务表在同一个数据库实例中,可以直接 JOIN、可以走同一个事务、可以用同一套备份和高可用方案。对于中小团队来说,这是非常大的诱惑力------少一个组件,就少一份运维成本、少一个故障点、少一份数据同步的麻烦。
2.2 核心原理:HNSW 图索引 + 距离算子
PGVector 的技术原理其实不复杂,它做了三件事:
第一,给 PostgreSQL 加了一个新的数据类型 vector(N),N 是向量维度。你可以把它理解成一个固定长度的浮点数数组,比如 vector(1536) 就是 OpenAI Embedding 输出的那种长度。
第二,定义了几种距离计算算子:<-> 是 L2 欧氏距离、<#> 是内积、<=> 是余弦距离。你写 SQL 的时候可以直接用这些运算符做相似度查询,比如 SELECT content FROM docs ORDER BY embedding <=> '0.1, 0.2, ...' LIMIT 5;。
第三,也是最关键的,支持两种 ANN 索引:IVFFlat 和 HNSW。
HNSW(Hierarchical Navigable Small World)是目前业界最主流的近似最近邻索引算法。它的原理是构建一个多层导航图------底层是完整的图,每个节点连接附近的向量;往上每层是稀疏化的"快速通道",就像城市的高架路。查询的时候从顶层开始,快速跳转到目标区域附近,再逐层下沉到精确层。这种结构的查询时间复杂度接近对数级,召回率通常能保持在 95% 以上。
PGVector 就是把这个 HNSW 图索引"嫁接"到了 PostgreSQL 的存储引擎上。你在某张表的 vector 字段上 CREATE INDEX ... USING hnsw (...),PostgreSQL 就会在后台为这列构建一张 HNSW 图,存在自己的表空间里。
2.3 0.7 版本之后,PGVector 变强了多少
如果你对 PGVector 的印象还停留在"百万级就吃力",那必须更新一下认知。2025 年发布的 0.7 版本做了三件大事:
第一,halfvec(float16 向量)。 以前一个 1536 维的向量,用 float32 存储要占 1536 × 4 = 6144 字节。现在用 float16,直接砍半到 3072 字节,而召回率损失通常不到 1%。这意味着同样内存下,你能塞进去两倍的数据量。对于 HNSW 这种"索引必须全驻内存"的结构来说,这是质的提升。
第二,并行 HNSW 索引构建。 以前建一个大表的 HNSW 索引要串行跑,几百万向量可能要几个小时。0.7 版本支持多核并行构建,速度提升 3-4 倍。这个优化对写入和索引重建场景非常关键。
第三,优化的内存访问模式和标量/二值量化。 进一步压缩索引体积,减少内存占用。
根据 2026 年社区生产环境的实测数据,PGVector 的能力边界大致是这样的:
|------------------------------------|------------------|
| 配置 | 可支撑向量规模(1536 维) |
| 裸 HNSW(float32) | ~500 万条,干净数据 |
| 加 halfvec(float16) | 500 万 ~ 1000 万 |
| 再加 pgvectorscale(StreamingDiskANN) | 1000 万 ~ 5000 万 |
| 再往上 | 必须分片或换专用数据库 |
2.4 PGVector 的真实能力边界
讲完优势,必须讲清楚它的天花板,否则你踩坑的时候就晚了。
第一,HNSW 索引必须全驻内存。 HNSW 的查询性能依赖于图节点能被快速访问。如果索引页面不在内存里,要从磁盘读,查询延迟会从毫秒级飙升到百毫秒级。这意味着你的服务器内存必须装得下整个 HNSW 索引------500 万条 1536 维向量,光索引就要吃掉十几 GB 内存。数据量再大,单机内存就不够用了。
第二,写入吞吐有限。 社区实测大概是每秒 1.5 万向量左右。这个数字对于大多数 RAG 场景够用(谁没事每秒灌一万条 Embedding),但如果你是做实时数据流入库、或者日志级别的大规模向量化,就会感到吃力。
第三,预过滤性能差。 这是 PGVector 被诟病最多的一点。什么叫预过滤?就是"先按 metadata 条件过滤出一部分数据,再在这个子集里做向量检索"。比如"只在华东区的客户文档里找相似的"。PGVector 早期版本对这种"标量过滤 + 向量检索"的混合查询优化很差------它要么先全表过滤再暴力算距离(慢),要么先走 HNSW 再过滤(召回率掉)。0.7 之后有所改善,但和 Milvus、Qdrant 这种原生支持混合索引的专用数据库比,还是有差距。
第四,单机扩展。 这是最根本的限制。PostgreSQL 虽然有流复制和分区表,但它本质上是单机架构------读写都在主库上,读扩展靠只读副本,但向量检索这种 CPU 密集型操作,副本帮不上太多忙。真到了几千万向量 + 高并发查询的场景,你会发现 PG 怎么调优都到顶了。
三、Milvus:为十亿级向量而生的专用数据库
3.1 架构本质:存算分离的分布式系统
如果说 PGVector 是"给 PostgreSQL 加刀片",那 Milvus 就是"从零造了一台专门切向量的厨房"。
它的架构是典型的存算分离分布式设计:
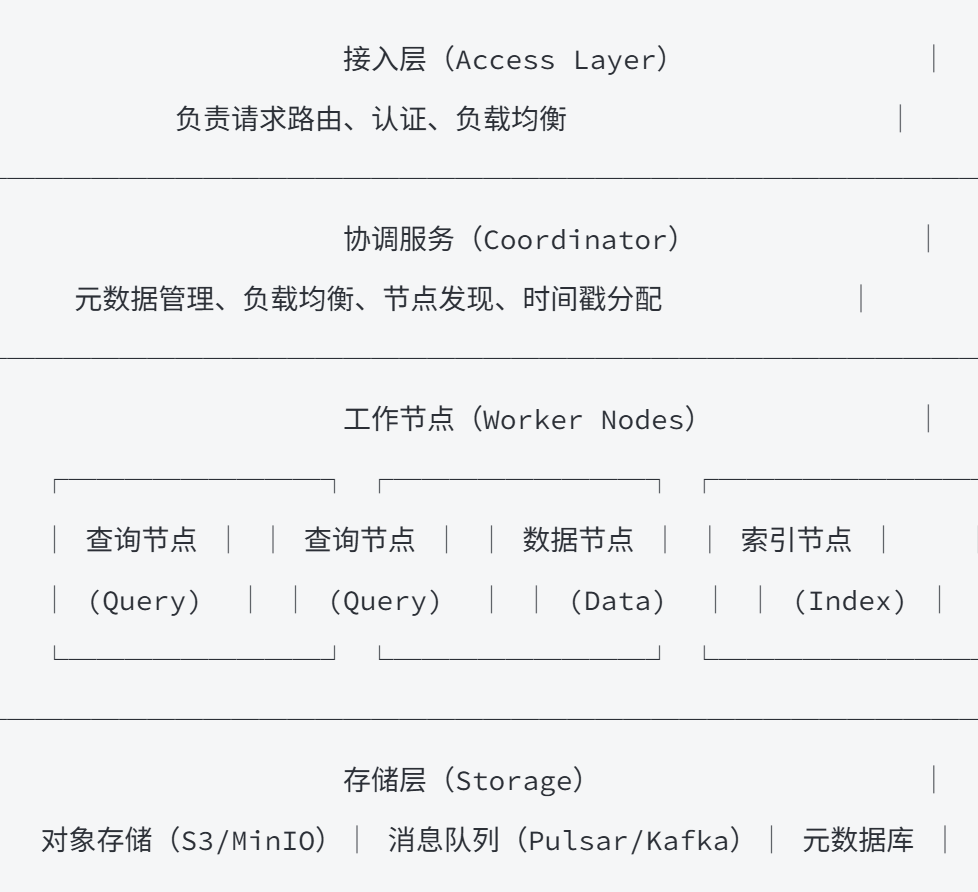
查询节点、数据节点、索引节点是分开的------你可以根据查询压力加查询节点,根据数据量加数据节点,完全弹性伸缩。索引文件存在对象存储(S3/MinIO)里,不绑死在单机磁盘上。这就是为什么 Milvus 能轻松撑住十亿级向量------它的设计目标就是分布式水平扩展。
它的索引算法也比 PGVector 丰富得多:HNSW、IVF_FLAT、IVF_PQ、DiskANN、GPU 索引......你可以根据数据规模、延迟要求、内存预算灵活选。比如数据量太大内存装不下,可以选 DiskANN------把图结构放磁盘上,只把热点节点放内存;想要极致内存压缩,可以选 PQ(Product Quantization),把向量压缩几十分之一。
3.2 2.6 / 3.0 这两年的关键进化
Milvus 在 2025-2026 年的两个版本,把它从"能存十亿向量"推向了"存得起十亿向量":
Milvus 2.6 的 RaBitQ 1-bit 量化。 这是一个很有意思的技术。传统量化(比如 PQ、SQ8)是把 float32 压缩成 int8,体积砍到 1/4。RaBitQ 更激进------直接用 1 bit 表示每个维度的符号,索引体积压到原来的 1/32。配合 SQ8 重排序,内存占用降到 28%,QPS 提升 4 倍,召回率还能保持在 95% 左右。这意味着以前要花几十万买的内存服务器,现在可能几万块就够了。
分层存储(Tiered Storage)。 热数据放内存、温数据放 SSD、冷数据放对象存储。企业里很多知识库是"老数据访问少、新数据访问频繁"的,分层之后存储成本直接降 50%。
Milvus 3.0(2026 年 7 月发布)的湖原生向量搜索。 这个方向很关键------它让 Milvus 可以直接查询存在数据湖(S3 上的 Parquet 文件)里的向量,不需要先导入到 Milvus 内部。这和 Iceberg/Hudi 那套湖仓一体的思路是一致的。对于数据团队来说,意味着向量数据不用再做一份"拷贝",直接在湖上做检索。
全文搜索性能提升 4 倍。 以前做混合搜索(向量语义 + 关键词 BM25),关键词部分是 Milvus 的短板。3.0 引入了 SINDI、Block-Max WAND 这些稀疏检索算法,BM25 性能直接翻倍。这对于 RAG 场景很重要------纯向量检索有时候会漏掉精确的关键词匹配(比如产品型号、错误码),混合搜索才是生产标配。
3.3 为什么小规模场景下它反而"慢"
这里有个反直觉的事实:在 100 万向量以下的小规模场景,Milvus 的延迟可能比 PGVector 还高。
原因是什么?它是一个分布式系统。一个查询请求进来,要经过接入层路由、协调服务查元数据、分发到查询节点、查询节点再去存储层拉索引------这条链路本身就有固定开销。数据量小的时候,这个固定开销占比很大,你感知到的就是"怎么比我本地 PG 还慢"。
打个比方:PGVector 像你家楼下的便利店,买瓶水 30 秒搞定;Milvus 像一个大型物流中心,有收货、分拣、配送一整套流程,发一单货要调度半天------但如果你一天要发 10 万单,便利店就崩了,物流中心才显现出优势。
所以选 Milvus 不是"它更高级",而是"你的规模到了它的设计区间"。
四、对比:到底差多少?
我们直接上数据(综合 Zilliz、社区基准测试和 2026 年生产环境实测):
|-------------------|--------------------------------------|-------------------------------|
| 维度 | PGVector (HNSW + halfvec) | Milvus 2.6 (RaBitQ + DiskANN) |
| 写入吞吐 | ~1.5 万向量/秒 | ~12 万向量/秒 |
| 查询延迟(缓存命中) | ~120ms | ~20ms |
| 可支撑规模 | 单机 ~500 万(加 pgvectorscale 到 5000 万) | 分布式十亿级 |
| 磁盘占用 | ~2.2 倍原始向量大小 | ~1.5 倍(RaBitQ 量化后更低) |
| 混合搜索(向量+标量过滤) | 中等,预过滤优化一般 | 原生支持,性能优秀 |
| ACID 事务 | 完整支持 | 不支持(最终一致) |
| SQL/JOIN 能力 | 完整 SQL,和业务表直接 JOIN | 只有向量检索 API,无 SQL |
| 运维复杂度 | 低(本来就有 PG) | 高(至少 6 个组件) |
| GPU 加速 | 不支持 | 支持 |
| 高可用方案 | PG 流复制,成熟 | 分布式多副本,组件多 |
这些数据不是绝对的------维度数、硬件配置、过滤选择性都会影响结果。但量级上的差异是明确的:PGVector 在小数据量下够用且省心,Milvus 在大数据量下是唯一选择。
五、关键差异:不是"谁快谁慢",而是"为谁设计"
讲完数据,我想退一步讲一个更本质的问题:
PGVector 和 Milvus 的差异,其实不是"性能差距",而是设计目标根本不同。
PGVector 的设计哲学是:把向量检索融入关系数据库的世界。它假设你的大部分数据是结构化的用户、订单、文档元数据,向量只是其中一种新的数据类型。你希望用统一的 SQL、统一的事务、统一的备份方案来管所有数据。它服务的是"业务应用里顺便加一个 RAG 功能"的场景。
Milvus 的设计哲学是:向量检索是一等公民。它假设你有海量的非结构化数据(文档切片、图片 Embedding、音频指纹),需要在十亿级规模上做低延迟相似度检索,数据本身的生命周期和业务系统是解耦的。它服务的是"专门建一个向量检索中台"的场景。
这个差异延伸到 AI Agent 时代,就变成了一个更具体的问题:你存的这层记忆,需不需要和业务数据强一致?
举个例子:Agent 要记住"用户张三偏好中文回复、住在北京、上次咨询过信用卡挂失"。这条记忆存在哪里?如果你存在 Milvus 里,你要做一次向量检索拿到这条记忆,然后还要去 PostgreSQL 里查张三的用户表------两次网络调用、两次数据一致性问题。如果你存在 PGVector 里,一条 SQL 就能同时拿到用户基本信息和他的语义记忆,而且写入是同一个事务,绝不会出现"用户改了手机号但记忆里还是旧的"这种不一致。
但反过来,如果你要建一个"全网金融知识问答库",里面有几百万篇研报、监管文件、产品手册的切片,用户每次提问都要从这里面召回------这个量级用 PGVector 就吃力了,必须上 Milvus。
六、AI Agent 场景下的真实选型:四个高频问题
这一节是整篇文章的核心。我们把 Agent 开发中最常遇到的四个存储问题拆开,逐个分析该选谁。
6.1 LangGraph 的 Checkpoint 该落在哪?
LangGraph 的 Checkpoint 是什么?就是你 Agent 每执行完一个节点,把当前的完整状态(对话历史、中间变量、工具调用结果)持久化下来。这样用户关掉对话再打开,能从上次的地方继续;或者你要做"人在环路"(Human-in-the-loop),中断之后恢复执行。
这个场景的关键需求是什么?ACID 事务、按 thread_id 随机读写、状态可能很大(要存完整的消息列表)、不需要语义检索。
答案几乎是共识:用 PostgreSQL(pgvector-pg 或直接 PG),不要用 Milvus。
为什么?因为 Checkpoint 是按 thread_id 精确读写的,不是相似度检索。你不需要"找到和当前状态相似的历史状态"------你要的是"精确恢复这个 thread 的状态"。这种 KV 式的读写,PostgreSQL 的 B-Tree 索引比 HNSW 快几个数量级。而且 Checkpoint 要和用户表、会话表做事务一致性------"创建会话"和"写第一个 Checkpoint"必须在同一个事务里,否则会出现会话记录有了但状态丢了。
LangChain 官方的 PostgresSaver 就是这个思路。社区里你能看到绝大多数生产 LangGraph 部署,Checkpoint 都是落 PG 的。
6.2 用户的长期语义记忆(偏好、历史事实)存哪?
这个场景是"Agent 跨会话记住用户偏好"------比如用户第一次说"我对青霉素过敏",第三次对话时 Agent 要能主动想起这件事。
这个场景的特点是:数据量不大(每个用户几百到几千条记忆)、需要按用户 ID 过滤 + 语义检索、需要和用户表做关联。
我的建议是:中小规模用 PGVector,超大规模再考虑 Milvus。
理由:
- 每个用户的记忆数据量其实很小------10 万用户 × 每人 500 条记忆 = 5000 万条。这个量级 PGVector 加 pgvectorscale 还能扛。
- 你需要按 user_id = ? 做严格过滤,然后在这个子集里做向量检索。这种"强标量过滤 + 向量检索"的场景,PGVector 直接写 SQL:SELECT content FROM memories WHERE user_id = 'xxx' ORDER BY embedding <=> '...' LIMIT 5;,非常直观。
- 记忆的写入需要和用户操作在同一个事务里------"用户说我过敏"和"写入这条记忆"不能分开提交。
- 数据要做权限隔离------行级安全(Row Level Security)在 PG 里是成熟方案,Milvus 没有这个概念。
什么时候该换?当你的用户量到百万级、记忆条数到几亿、单用户的查询 QPS 压得 PG 主库扛不住了------这时候把语义记忆迁到 Milvus,PG 只做用户主数据,通过双写或者 CDC 同步。
6.3 大规模知识库 RAG 用谁?
这是最经典的场景:企业内部有几万篇文档(产品手册、规章制度、技术文档),切块后 Embedding 入库,用户提问时召回相关片段喂给 LLM。
决策点很简单:看你的文档切片规模。
- 100 万切片以下:PGVector 完全够用,省一套系统。
- 100 万 ~ 1000 万切片:PGVector + halfvec + pgvectorscale 可以扛,但要开始关注内存和查询延迟了。
- 1000 万切片以上,或者有混合搜索(向量 + BM25 关键词)的强需求:上 Milvus。
- 亿级以上、或者有 GPU 加速诉求:Milvus 是唯一选择。
还有一个隐藏因素:更新频率。如果你的知识库是静态的(一次导入,很少改动),PGVector 的 HNSW 索引建一次就稳了。如果是高频更新(每天都有新文档入库),HNSW 索引的增量更新在 PG 里是个痛点------它不是为高频写入设计的。这种情况 Milvus 的流式数据处理更合适。
6.4 Agent 的工具检索(Tool Retrieval)用谁?
这是 2026 年 Agent 架构里新冒出来的一个场景。当你的 Agent 有几十个甚至上百个工具(查订单、发邮件、调 API、跑代码......),不可能把所有工具的描述都塞进 System Prompt------太长、太费 token。解决方案是:把每个工具的描述向量化存起来,用户提问时先做一次语义检索,挑出最相关的 3-5 个工具,再让 LLM 决策调用哪个。
这个场景的数据特点是:工具数量少(几十到几百个)、检索频率极高(每个用户问题都要查一次)、延迟敏感。
答案非常明确:用 PGVector(甚至内存数据库都行)。
为什么?几百个工具的向量,数据量小到可以忽略。你需要的是稳定的亚毫秒级延迟,不是十亿级规模。而且工具的元数据(参数 Schema、权限要求)是结构化数据,和向量存在同一个 PostgreSQL 里最方便------检索到工具后直接 JOIN 出参数定义喂给 LLM。
七、多语言持久化,不是二选一
讲到这里你可能发现了一个规律:生产环境的答案几乎从来不是"选 A 还是选 B",而是"A 和 B 组合用"。
这就是 2026 年企业级 RAG/Agent 架构里越来越主流的**多语言持久化(Polyglot Persistence)**模式:
具体分工是这样的:
- PostgreSQL 是"系统-of-record":所有需要 ACID、需要事务、需要和业务数据强一致的东西,都放 PG。用户、订单、Checkpoint、用户长期记忆、工具定义------这些是 Agent 的"骨架"。
- Milvus 是"检索引擎":大规模、高 QPS、纯向量语义检索的场景,放 Milvus。比如百万级文档切片的 RAG 库、跨用户共享的知识池。
- 数据同步用 CDC(Change Data Capture)或者应用层双写:业务侧在 PG 里写入文档元数据,同时调 Embedding 服务生成向量,写到 Milvus。或者用 Debezium 监听 PG 的变更,自动同步到 Milvus。
这种架构的好处是:每个组件都在自己最擅长的区间工作,不强行让 PG 扛它扛不动的规模,也不把需要事务一致性的数据硬塞进 Milvus。
八、选型决策树
最后给你一张决策图,下次选型的时候可以参考:
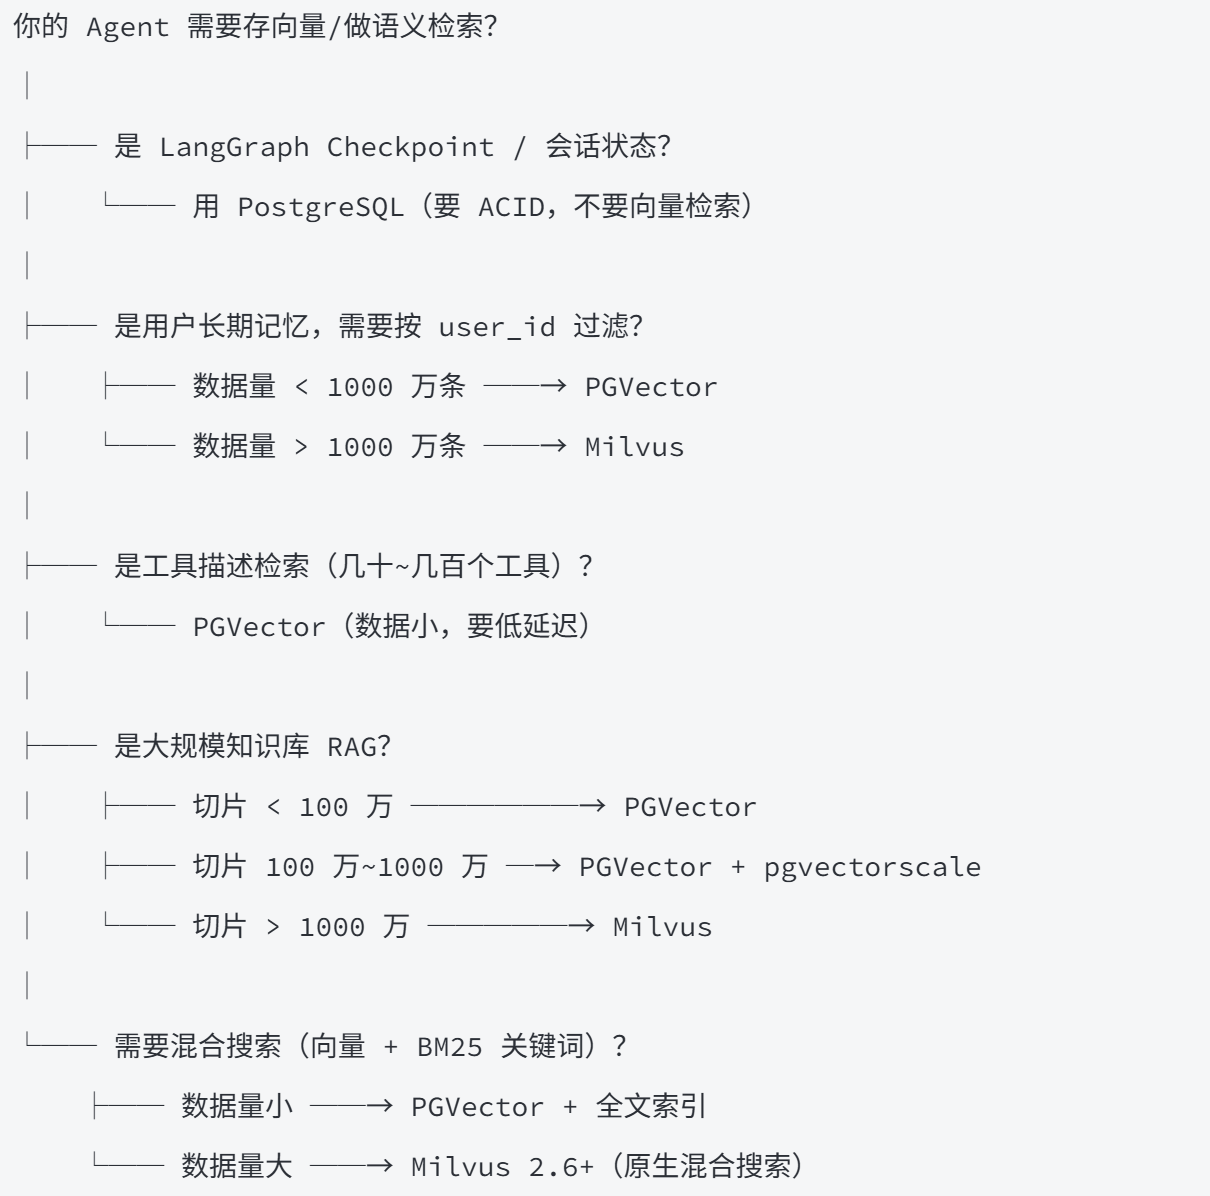
再补一句总结:在 Agent 时代,向量数据库不再是一个孤立的选型问题,而是整个记忆架构设计的一部分。 不要问"哪个数据库更好",要问"这一层记忆需要什么特性"------是 ACID?是规模?是低延迟?是和业务数据的强一致性?把这些问题想清楚,答案自然就出来了。
对于 90% 正在做 RAG 应用的中小团队,我的建议很实在:先上 PGVector,把业务跑起来。 等你的向量规模真的到了千万级、或者 QPS 真的压垮了 PG,再花两周时间把大规模检索迁到 Milvus。
这种演进路径的成本,比一开始就上 Milvus 那套复杂分布式架构低得多