让神经网络自己「学会」流体方程:一次隧道通风降尘的 PINN 复现
前几天翻到一篇讲隧道通风降尘的论文,方法是用物理信息神经网络预测爆破后的粉尘扩散。隧道粉尘这事看着离生活很远,但背后牵着一条很硬的线,尘肺病。
我把论文里的主要方法用 MATLAB 复现了一遍,从合成风场、粉尘输运求解,到六物理场网络、联合损失训练、多级降尘方案比选,跑通了一整条链路。
这篇就把工程里做了什么、怎么做的、哪些参数是我拍的、结果到底好不好,一次讲清楚。
先说结论,方法论上这套东西是成立的,但快速模式的精度还很粗糙,原因我放在文末老实交代。
01 · 为什么隧道降尘值得用 PINN 来做
隧道爆破后,掌子面前方会瞬间腾起一团高浓度粉尘,局部峰值能到几百 mg/m³,典型工况下初期平均值也在 40 mg/m³ 上下。工人要在里面继续作业,长期吸入就是尘肺。
工程上有两条主流路径。
一条是 CFD 数值模拟,把 Navier--Stokes 方程和颗粒输运方程一起解出来,精度高、可解释性强。问题是贵。换一个通风方案、改一处风管出口位置,就得重新划分网格重算一遍,一次可能几个小时起步,很难支撑现场快速比选。
另一条是纯数据驱动的神经网络,喂监测数据、输出浓度。它快,但有两个硬伤,一是训练需要大量带标注的实测数据,二是网络本身不懂守恒,外推到没见过的工况就容易崩。
PINN 的思路是第三条,把控制方程直接写进损失函数,让网络在拟合数据的同时,也被物理规律约束着。
工程上多花的算力换来了两样东西,数据需求大幅下降,以及预测结果天然满足连续性、动量这类基本物理。
一句话概括,它把「解方程」变成了「训练一个必须守规矩的网络」。
02 · 这个工程到底做了什么
复现工程用 MATLAB R2025b 实现,代码组织成一个 +tunneldust 包加一个主程序 main.m(file:///d:/Sideline/MBD/物理信息/基于物理信息神经网络的隧道通风降尘预测研究/基于物理信息神经网络的隧道通风降尘预测研究MATLAB代码/main.m)。核心功能有六块。
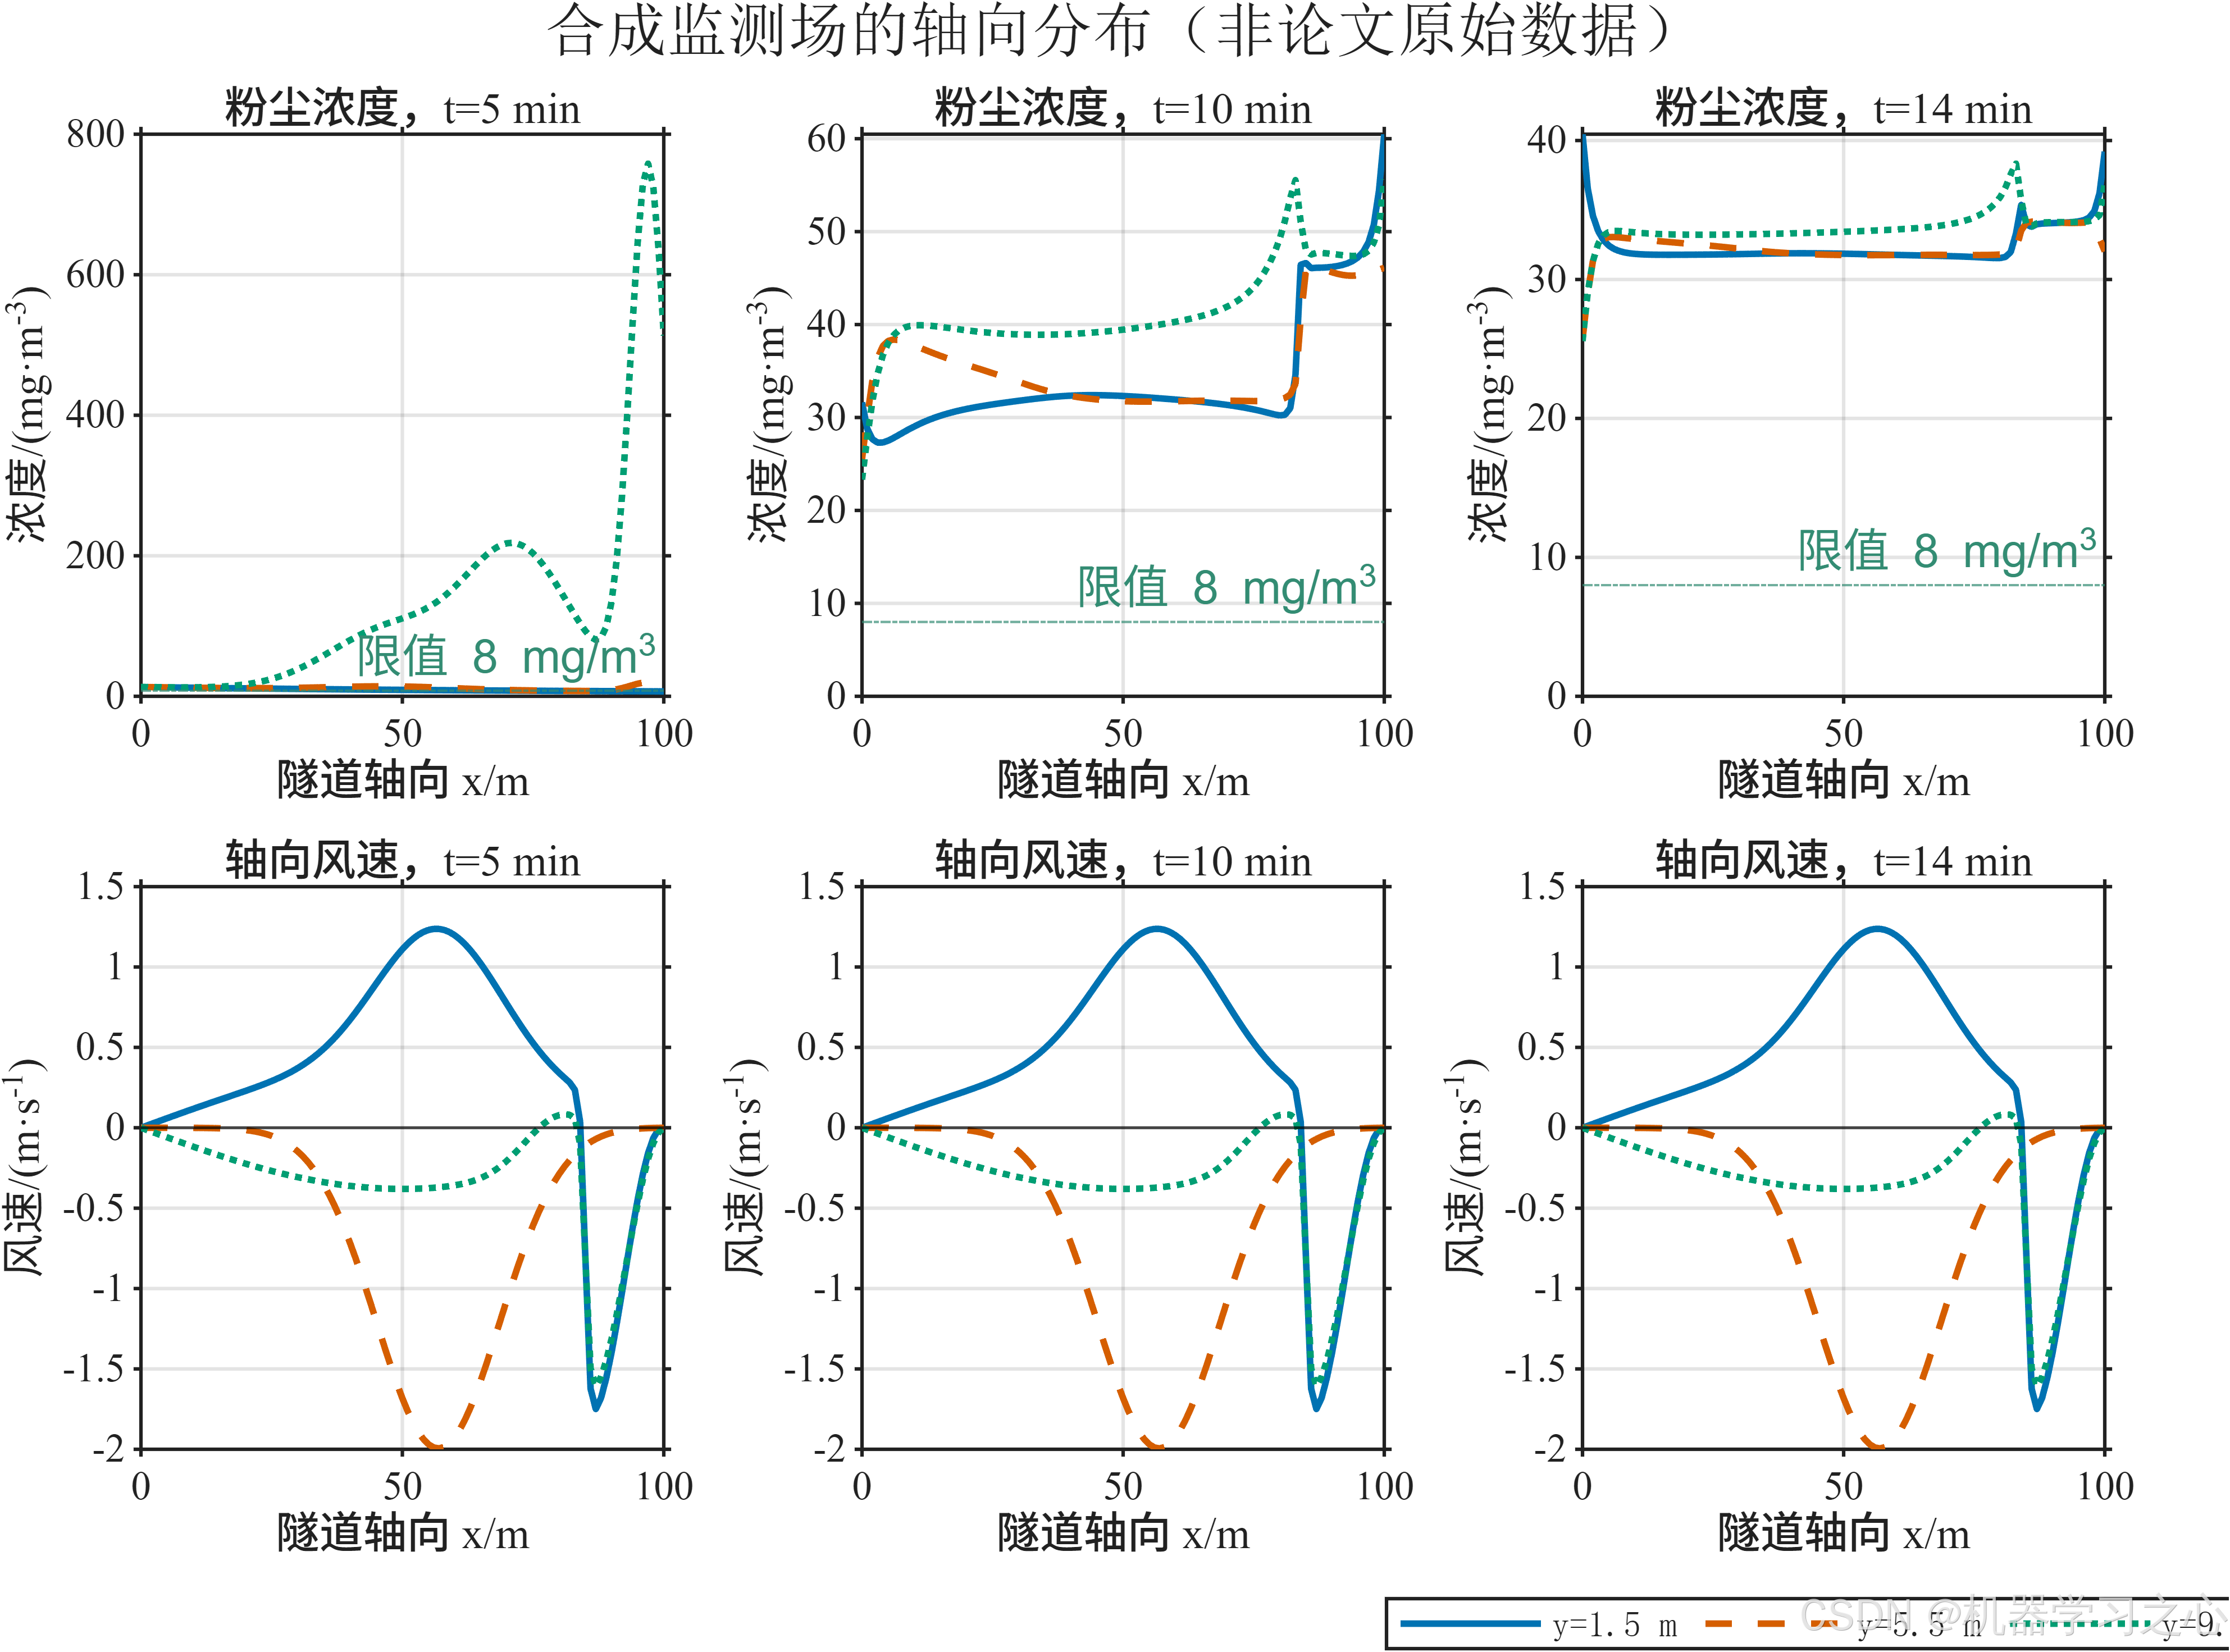
第一,物理一致的合成参考场。用流函数构造出带风管射流、大尺度回流和局部涡旋的风场,再解一遍粉尘对流扩散方程,得到一份「真值」。因为论文没有公开原始监测数据,工程里这份参考场全部标记为合成数据。
第二,六物理场神经网络。一次前向就同时输出速度 u、v,压力 p,湍动能 k,耗散率 epsilon,以及粉尘浓度 C。
第三,联合损失训练。物理方程残差、边界条件、初始场、监测数据四部分一起优化。
第四,验证与全场预测。在 25、50、75 m 三个距离断面上算 RMSE、MAE、R²、MAPE,并输出整个计算域的浓度场。
第五,多级协同降尘方案比选。把环向水幕、中压喷雾、定向喷雾导流、辅助轴流风机以及多措施协同放在同一套求解器里比较,量化累计暴露量的削减。
第六,中文核心期刊风格的图件自动导出,一共 11 张,矢量 PDF 加 600 dpi 位图都给。
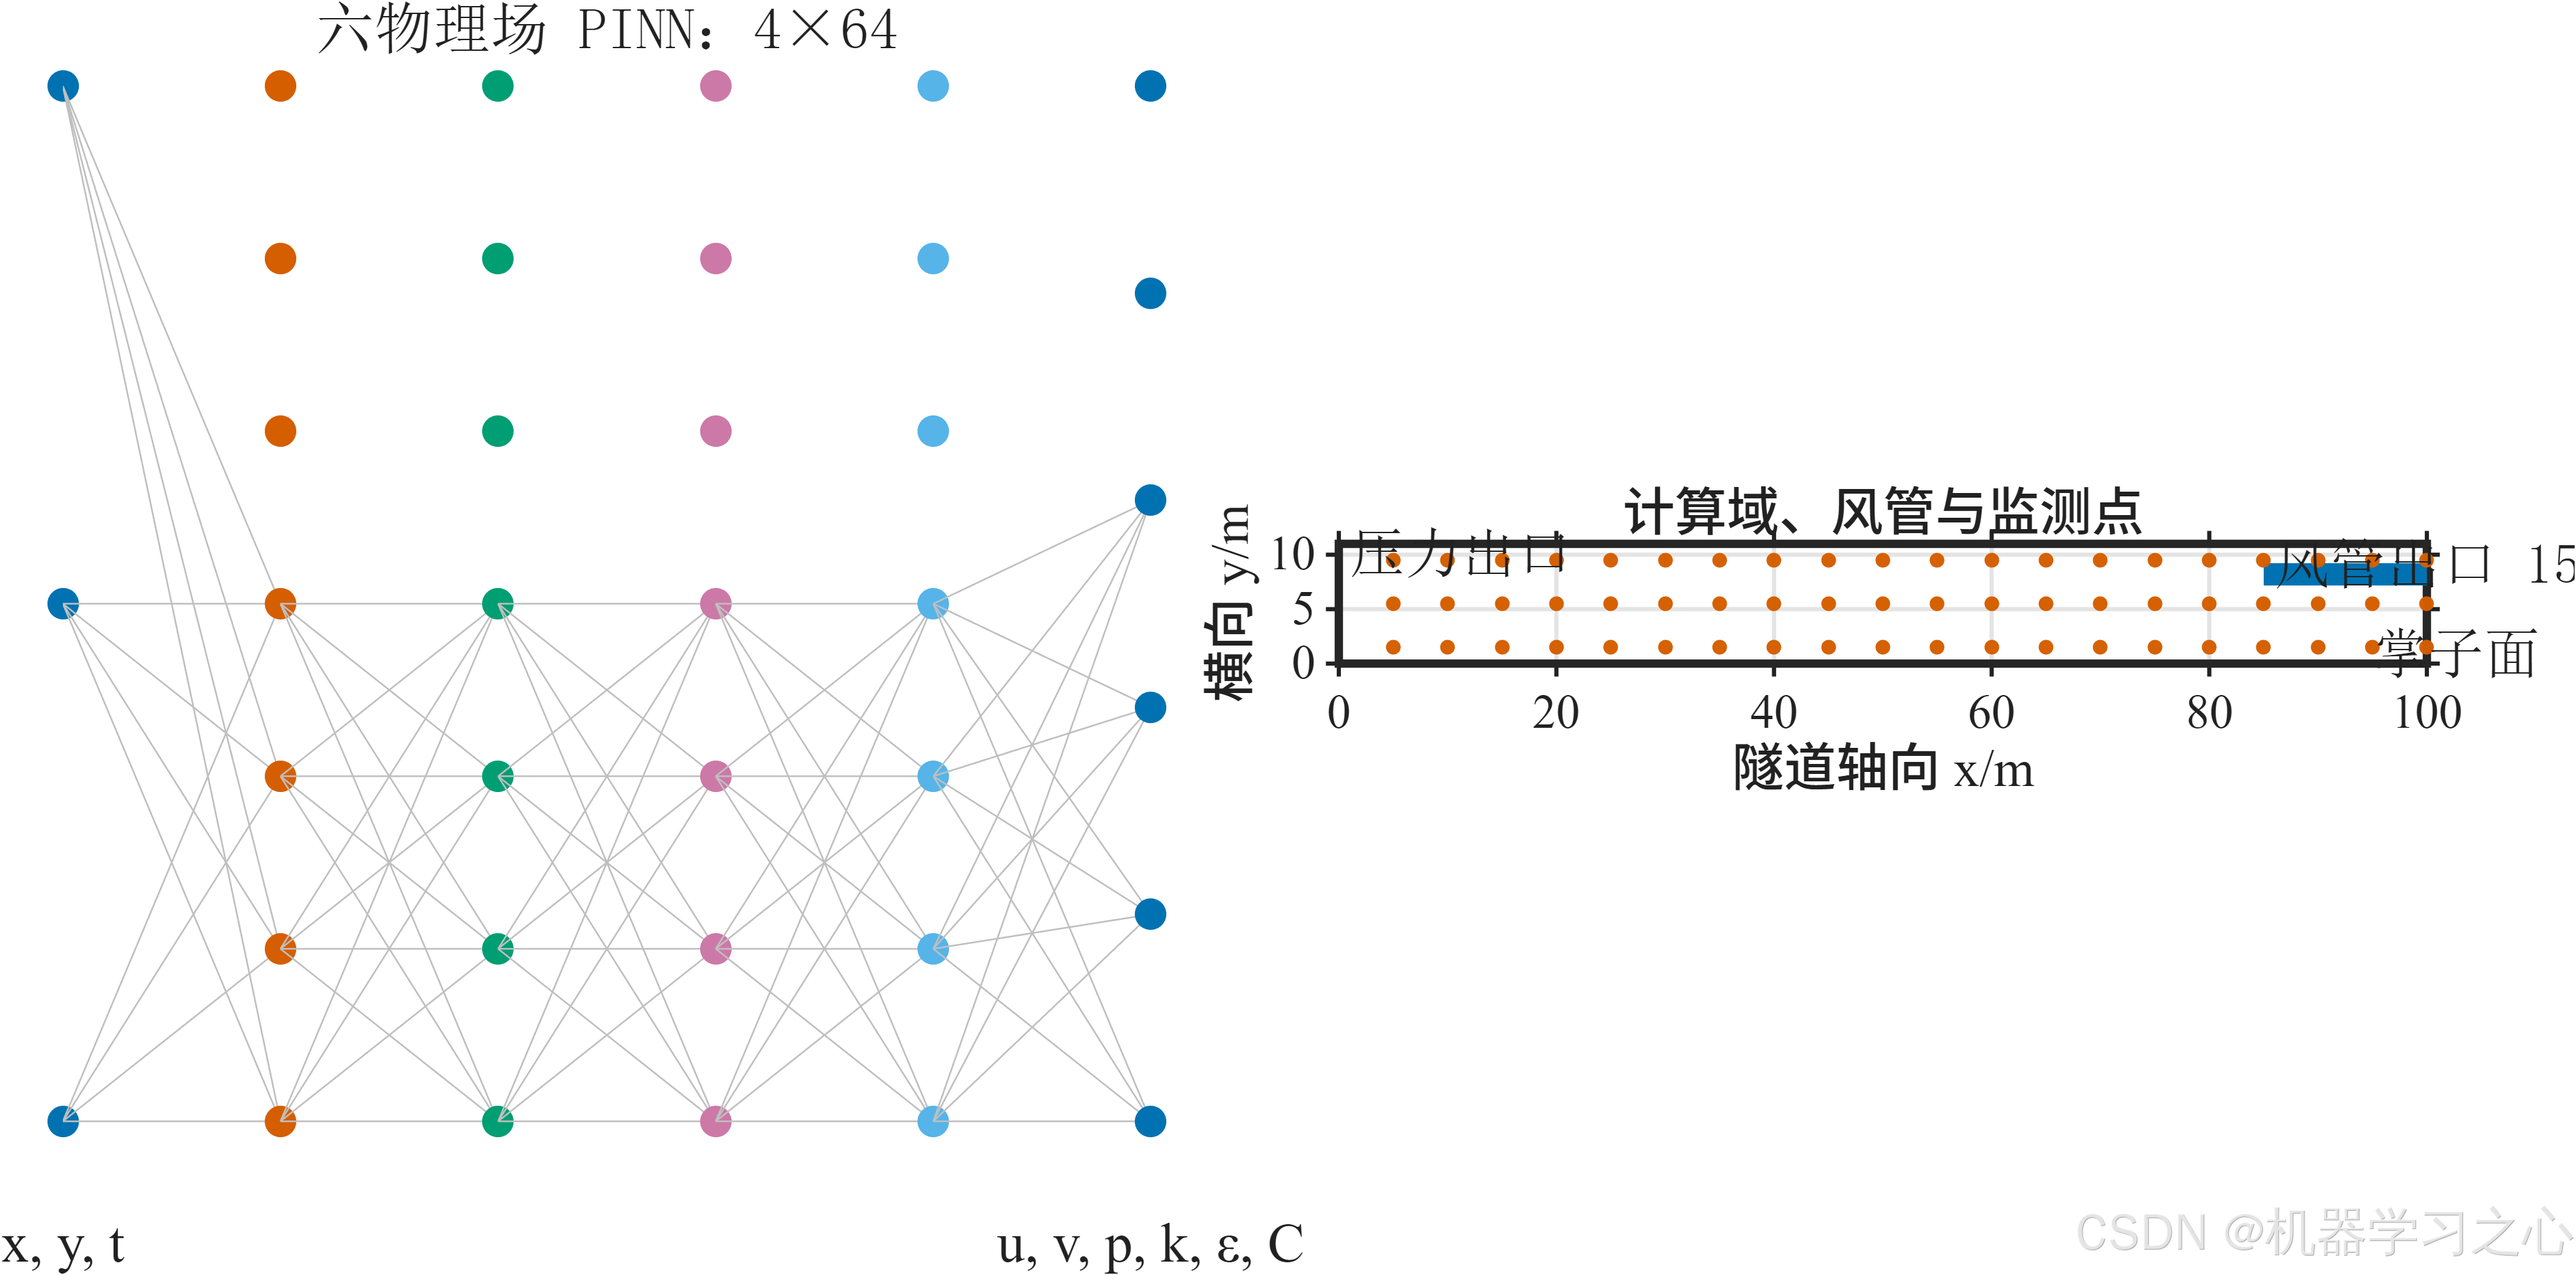
上面这张图是网络结构和计算域的对应关系。横轴 0 到 100 m,0 是洞口,100 是掌子面,风管出口定在 85 m 处。
03 · 技术路线与算法步骤
整条链路是六步,从合成数据一路走到方案比选。
text
[1] 生成物理一致的合成参考场
      流函数风场  →  守恒有限体积求解粉尘输运  →  带噪声的虚拟监测数据
                                    │
[2] 构建六物理场网络                 │
      输入 (x,y,t) → 4~6 层全连接 + tanh → 输出 (u,v,p,k,ε,C)
                                    │
[3] 联合损失训练  ←──────────────────┘
      L = L_物理 + L_边界 + L_初值 + 1.5 × L_数据
      Adam + 梯度裁剪 + 最佳验证检查点
                                    │
[4] 评估指标与全场预测
      RMSE / MAE / R² / MAPE,25、50、75 m 分组
                                    │
[5] 多级协同降尘方案比选
      6 种方案 → 累计暴露量、超限面积、峰谷浓度
                                    │
[6] 图件导出(中文期刊风格,PDF + 600 dpi PNG)
几个细节值得单独说。
配点用的是分层采样。 物理方程残差不依赖监测数据,需要在整个时空域里随机撒点。纯随机撒点容易留大空洞,工程里对 x、y、t 三个维度分别分层再打乱,效果接近拉丁超立方,但不用额外工具箱。
边界条件拆成四类分开采样。 洞口、上下壁面、掌子面、风管出口,各自抽取等量配点。壁面走无滑移加零法向浓度梯度,掌子面是不可穿透面,风管出口强制给到 15 m/s。
训练时保存验证损失最低的那一版网络。 不是最后一步,是最佳检查点。因为 PINN 的损失并不单调下降,后期偶尔会反弹。
matlab
results = main(Mode="quick", DataSource="synthetic", UseGPU="auto");上面这行就是完整入口。quick 是 4 层、每层 64 个神经元、3000 次迭代,用来快速验证流程。paper 换到 6 层、128 宽、50000 次迭代。
04 · 公式原理:六个物理场怎么塞进损失函数
这一节是全文最硬的部分,但也是最值得看的。网络输入是无量纲坐标 (x, y, t),输出上面说的六个场。训练时对输出自动微分,算出来的导数代进控制方程,残差越小越好。
连续性方程,保证流体不可压缩。
∂u∂x+∂v∂y=0\frac{\partial u}{\partial x} + \frac{\partial v}{\partial y} = 0∂x∂u+∂y∂v=0
二维非稳态动量方程,左端是惯性项加压力梯度,右端是分子粘性与湍流粘性的扩散。
ρ(∂u∂t+u∂u∂x+v∂u∂y)+∂p∂x−ρ(ν+νt)∇2u=0\rho\left(\frac{\partial u}{\partial t} + u\frac{\partial u}{\partial x} + v\frac{\partial u}{\partial y}\right) + \frac{\partial p}{\partial x} - \rho(\nu + \nu_t)\nabla^2 u = 0ρ(∂t∂u+u∂x∂u+v∂y∂u)+∂x∂p−ρ(ν+νt)∇2u=0
湍流粘性用 k--epsilon 模型闭合。
νt=Cμk2ε\nu_t = C_\mu \frac{k^2}{\varepsilon}νt=Cμεk2
湍动能 k 与耗散率 epsilon 的输运方程,这两条决定了湍流的产生与耗散。
∂k∂t+u∂k∂x+v∂k∂y−(ν+νtσk)∇2k−Gk+ε=0\frac{\partial k}{\partial t} + u\frac{\partial k}{\partial x} + v\frac{\partial k}{\partial y} - \left(\nu + \frac{\nu_t}{\sigma_k}\right)\nabla^2 k - G_k + \varepsilon = 0∂t∂k+u∂x∂k+v∂y∂k−(ν+σkνt)∇2k−Gk+ε=0
∂ε∂t+u∂ε∂x+v∂ε∂y−(ν+νtσε)∇2ε−C1Gkεk+C2ε2k=0\frac{\partial \varepsilon}{\partial t} + u\frac{\partial \varepsilon}{\partial x} + v\frac{\partial \varepsilon}{\partial y} - \left(\nu + \frac{\nu_t}{\sigma_\varepsilon}\right)\nabla^2 \varepsilon - C_1 G_k \frac{\varepsilon}{k} + C_2 \frac{\varepsilon^2}{k} = 0∂t∂ε+u∂x∂ε+v∂y∂ε−(ν+σενt)∇2ε−C1Gkkε+C2kε2=0
其中湍流产生项 Gk=νtS2G_k = \nu_t S^2Gk=νtS2,应变率 S=2ux2+2vy2+(uy+vx)2S = \sqrt{2u_x^2 + 2v_y^2 + (u_y + v_x)^2}S=2ux2+2vy2+(uy+vx)2 。
粉尘走对流---扩散---沉降方程,最后那个一次项就是沉降汇。
∂C∂t+u∂C∂x+v∂C∂y−Dt∇2C+wsC=0\frac{\partial C}{\partial t} + u\frac{\partial C}{\partial x} + v\frac{\partial C}{\partial y} - D_t \nabla^2 C + w_s C = 0∂t∂C+u∂x∂C+v∂y∂C−Dt∇2C+wsC=0
扩散系数 DtD_tDt 里带了湍流贡献,Dt=D0+νt/σtD_t = D_0 + \nu_t / \sigma_tDt=D0+νt/σt。
总损失长这样。
Ltotal=LPDE+LBC+LIC+1.5 Ldata\mathcal{L}{total} = \mathcal{L}{PDE} + \mathcal{L}{BC} + \mathcal{L}{IC} + 1.5\,\mathcal{L}_{data}Ltotal=LPDE+LBC+LIC+1.5Ldata
数据项前面那个 1.5 是权重,往上抬一点,让网络别只顾着满足方程、完全无视实测点。
两个工程上的关键处理,直接决定训练能不能收敛。
一是每一个方程残差都按特征量做了无量纲化。不然压力的量级和浓度差好几个数量级,总损失会被大项牵着走,小项等于没优化。
二是对 k、epsilon、C 三个必须为正的量,输出层接了数值稳定的 Softplus,杜绝训练中途出现负浓度、负湍动能把整个损失带崩。
matlab
positive = @(z) max(z,0) + log(1+exp(-abs(z))) + 1e-6;行吊着这行代码,看着不起眼,是复现能跑通的前提之一。
05 · 参数设定
参数全部集中在一个配置文件 defaultConfig.m(file:///d:/Sideline/MBD/物理信息/基于物理信息神经网络的隧道通风降尘预测研究/基于物理信息神经网络的隧道通风降尘预测研究MATLAB代码/+tunneldust/defaultConfig.m) 里,方便替换。
几何与气流,来自论文设定。
| 参数 | 取值 | 说明 |
|---|---|---|
| 计算域长度 | 100 m | 洞口 0 m 到掌子面 100 m |
| 计算域宽度 | 11 m | 距底板 1.5 m 的水平截面 |
| 风管出口位置 | (85, 8.2) m | 直径 1.0 m |
| 风管出口风速 | 15 m/s | 压入式通风 |
物性与湍流参数。 论文明确给出的三个直接采用,其余标注为工程补充值。
| 参数 | 取值 | 来源 |
|---|---|---|
| 空气密度 rho | 1.225 kg/m³ | 常温常压 |
| 动力粘度 mu | 1.81e-5 Pa·s | 常温空气 |
| C_mu | 0.09 | 工程补充 |
| C2 | 1.9 | 论文给定 |
| sigma_k | 1.0 | 论文给定 |
| sigma_epsilon | 1.2 | 论文给定 |
| 湍流 Schmidt 数 | 0.70 | 工程补充 |
| 粉尘扩散系数 | 0.035 m²/s | 工程补充 |
| 沉降率 w_s | 5e-4 s⁻¹ | 工程补充 |
时间设定。 取爆破后的绝对秒数,300 s 对应论文监测起点,监测窗到 900 s,每 60 s 一个断面。
网络与训练,分两档。
| 项目 | quick | paper |
|---|---|---|
| 隐藏层数 | 4 | 6 |
| 每层神经元 | 64 | 128 |
| 迭代次数 | 3000 | 50000 |
| 物理配点批量 | 1024 | 8192 |
| 学习率 | 1e-3 | 1e-3 |
| 数据损失权重 | 1.5 | 1.5 |
| 梯度裁剪阈值 | 1.0 | 1.0 |
优化器是 Adam,一阶矩、二阶矩衰减率分别 0.9 和 0.999。梯度裁剪阈值设为 1.0,防的是 PINN 常见的梯度爆炸。
说实话这几个没给的参数,湍流 Schmidt 数、扩散系数、沉降率,是我按常见取值填的,不是论文原值。 换现场条件的话,这几项应该一起改。
06 · 运行环境
- MATLAB R2025b,Deep Learning Toolbox 必需;
- GPU 训练可选,需要 Parallel Computing Toolbox 加一块兼容的 NVIDIA 显卡;
- CPU 能跑完整流程,
paper模式会慢很多; - 随机种子默认 1729,保证结果可复现。
本次复现跑的是 quick 模式加合成数据,全程 CPU,没用到 GPU ,最佳验证损失收敛到 6.68e-4。工程会在 outputs/run_模式_时间戳/ 下建独立目录,模型、指标、配置、运行环境、中文日志、图件一次性落盘,不覆盖历史结果。
另外它留了一个真实数据的入口。
matlab
results = main(Mode="quick", DataSource="csv", DataFile="data/my_monitoring.csv");把 time_s、x_m、y_m、dust_mg_m3 四列填进模板 CSV 就能跑。缺哪个物理量,数据损失就只对现有的算,控制方程照样约束六个输出。
07 · 跑出来的结果,和我不太满意的地方
先说训练过程。总损失从开局 1.51e5 一路压到 0.663,验证损失从 0.61 降到 6.68e-4,两条曲线都平稳收敛,没出现发散。
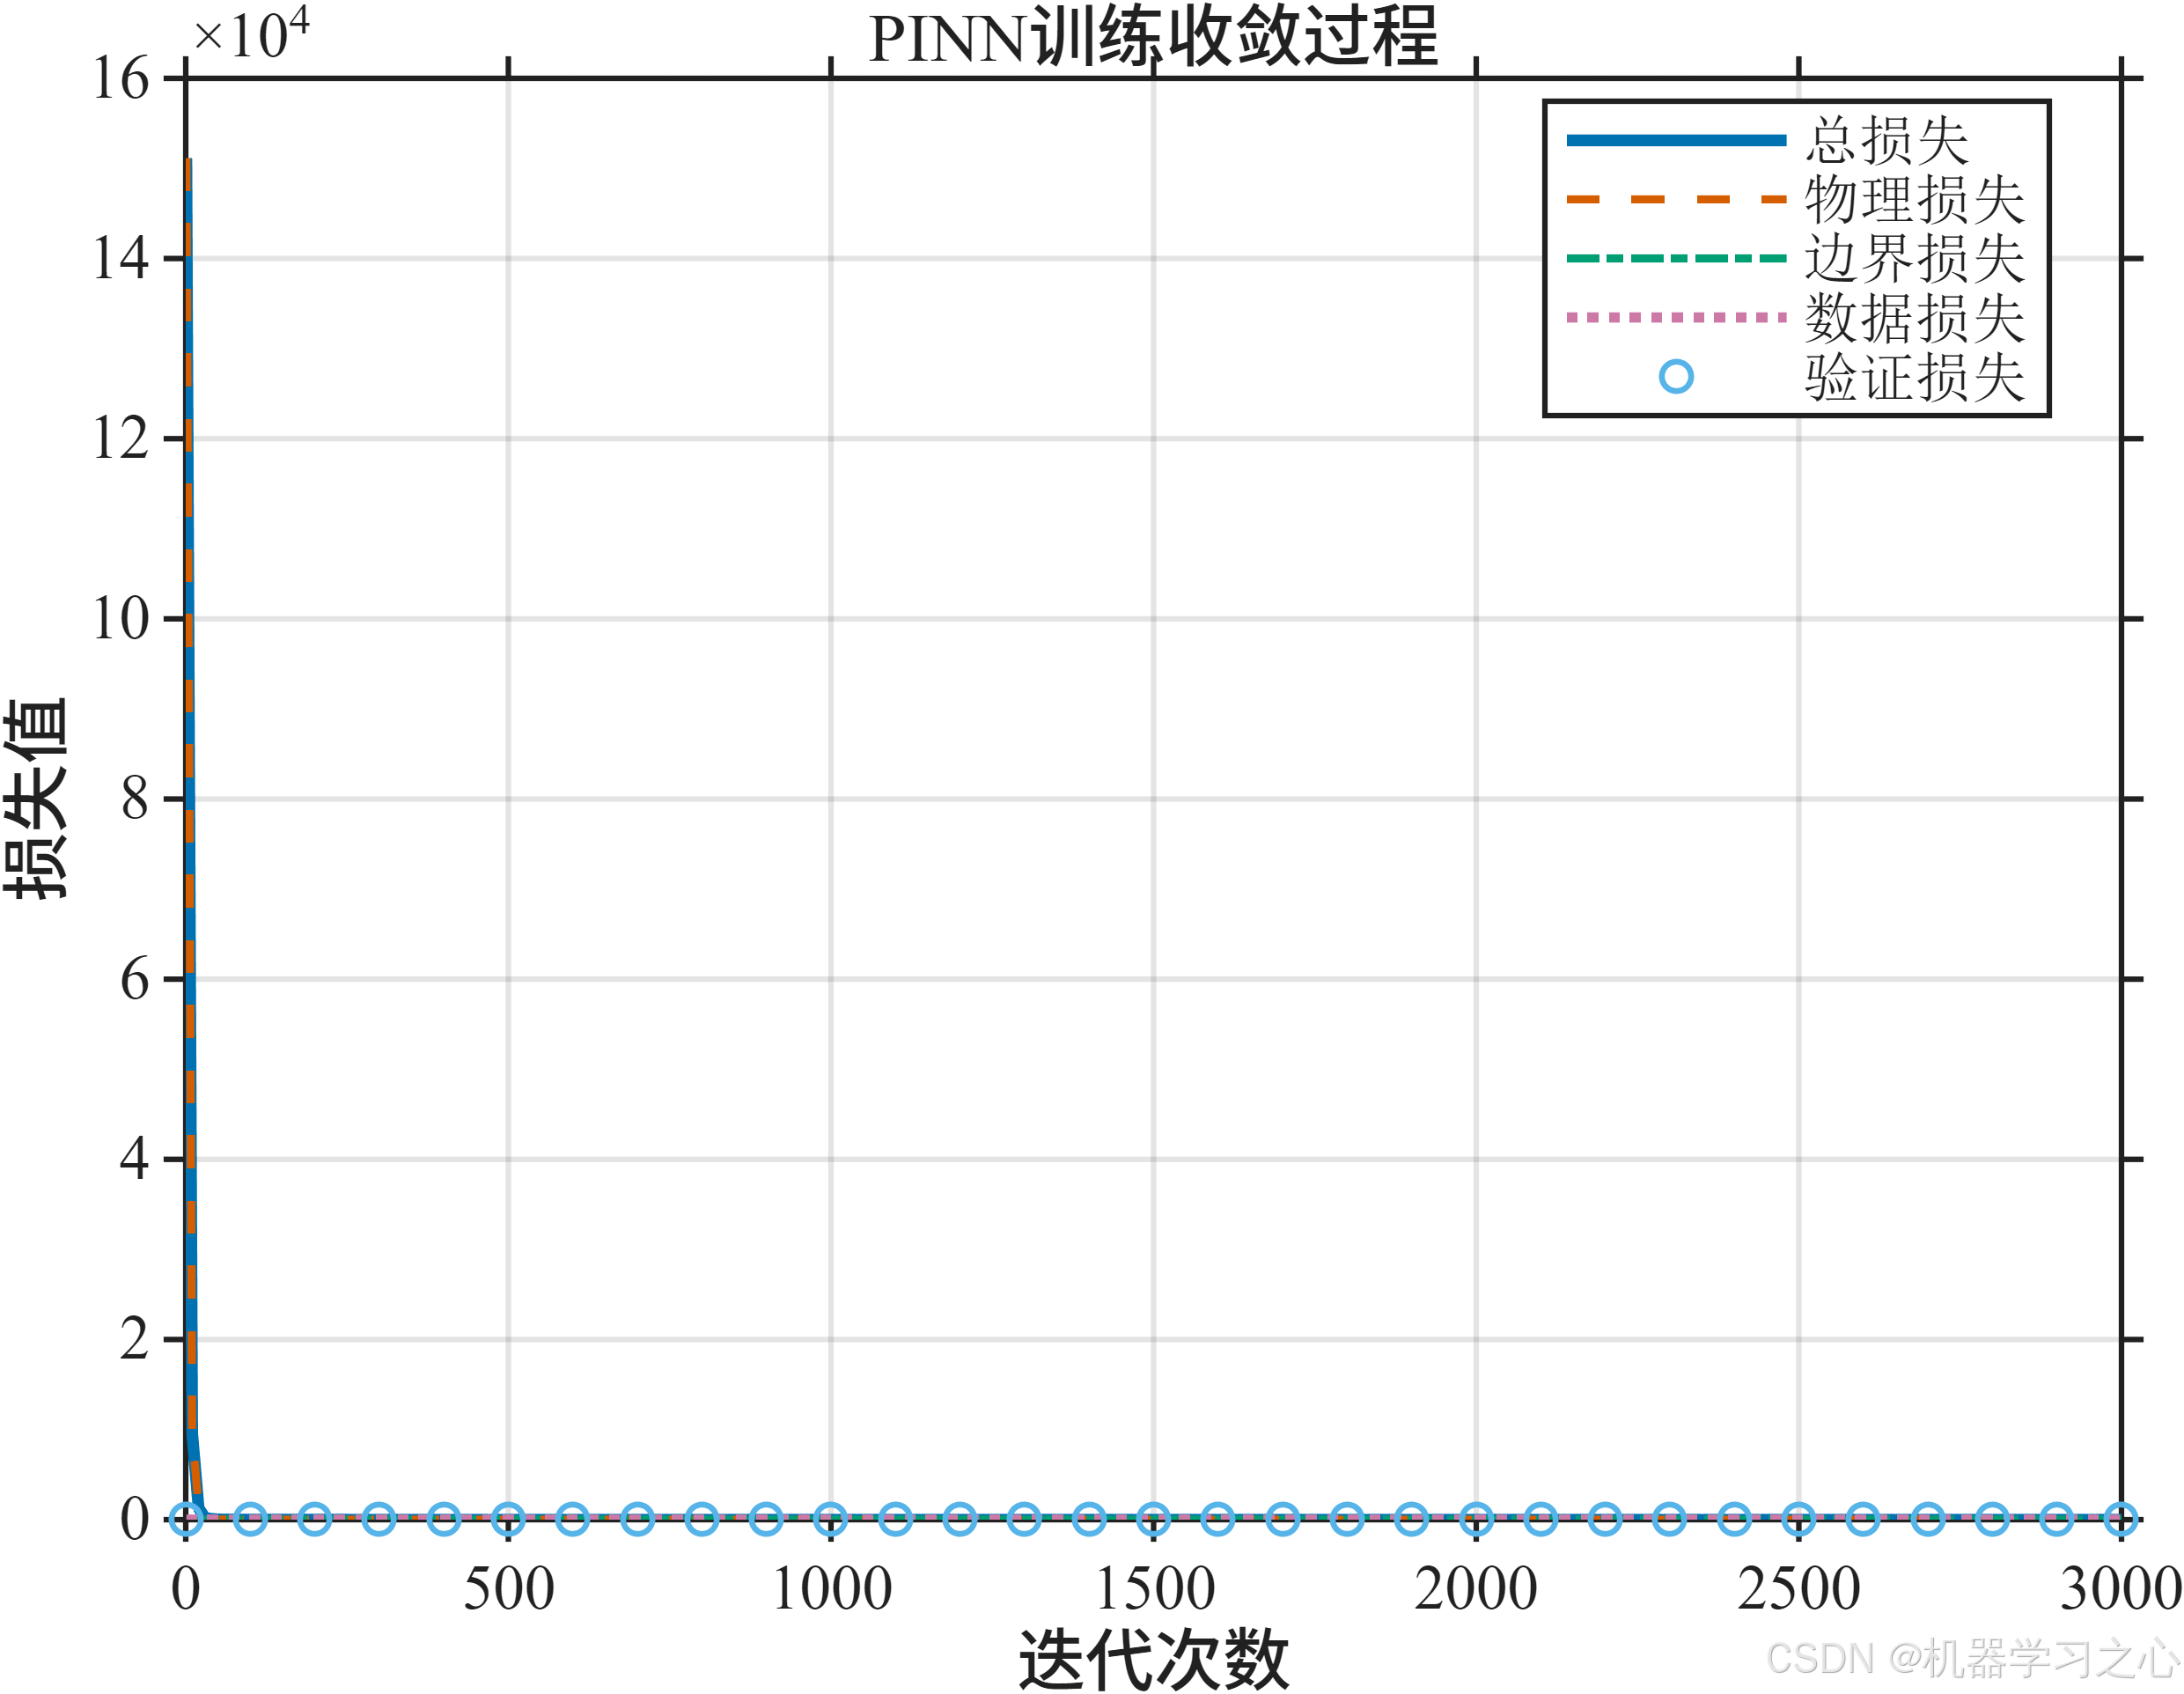
上图是总损失和各分量的收敛曲线,能看到物理损失、边界损失、数据损失各自在往下走。
但下面这个必须老实讲。
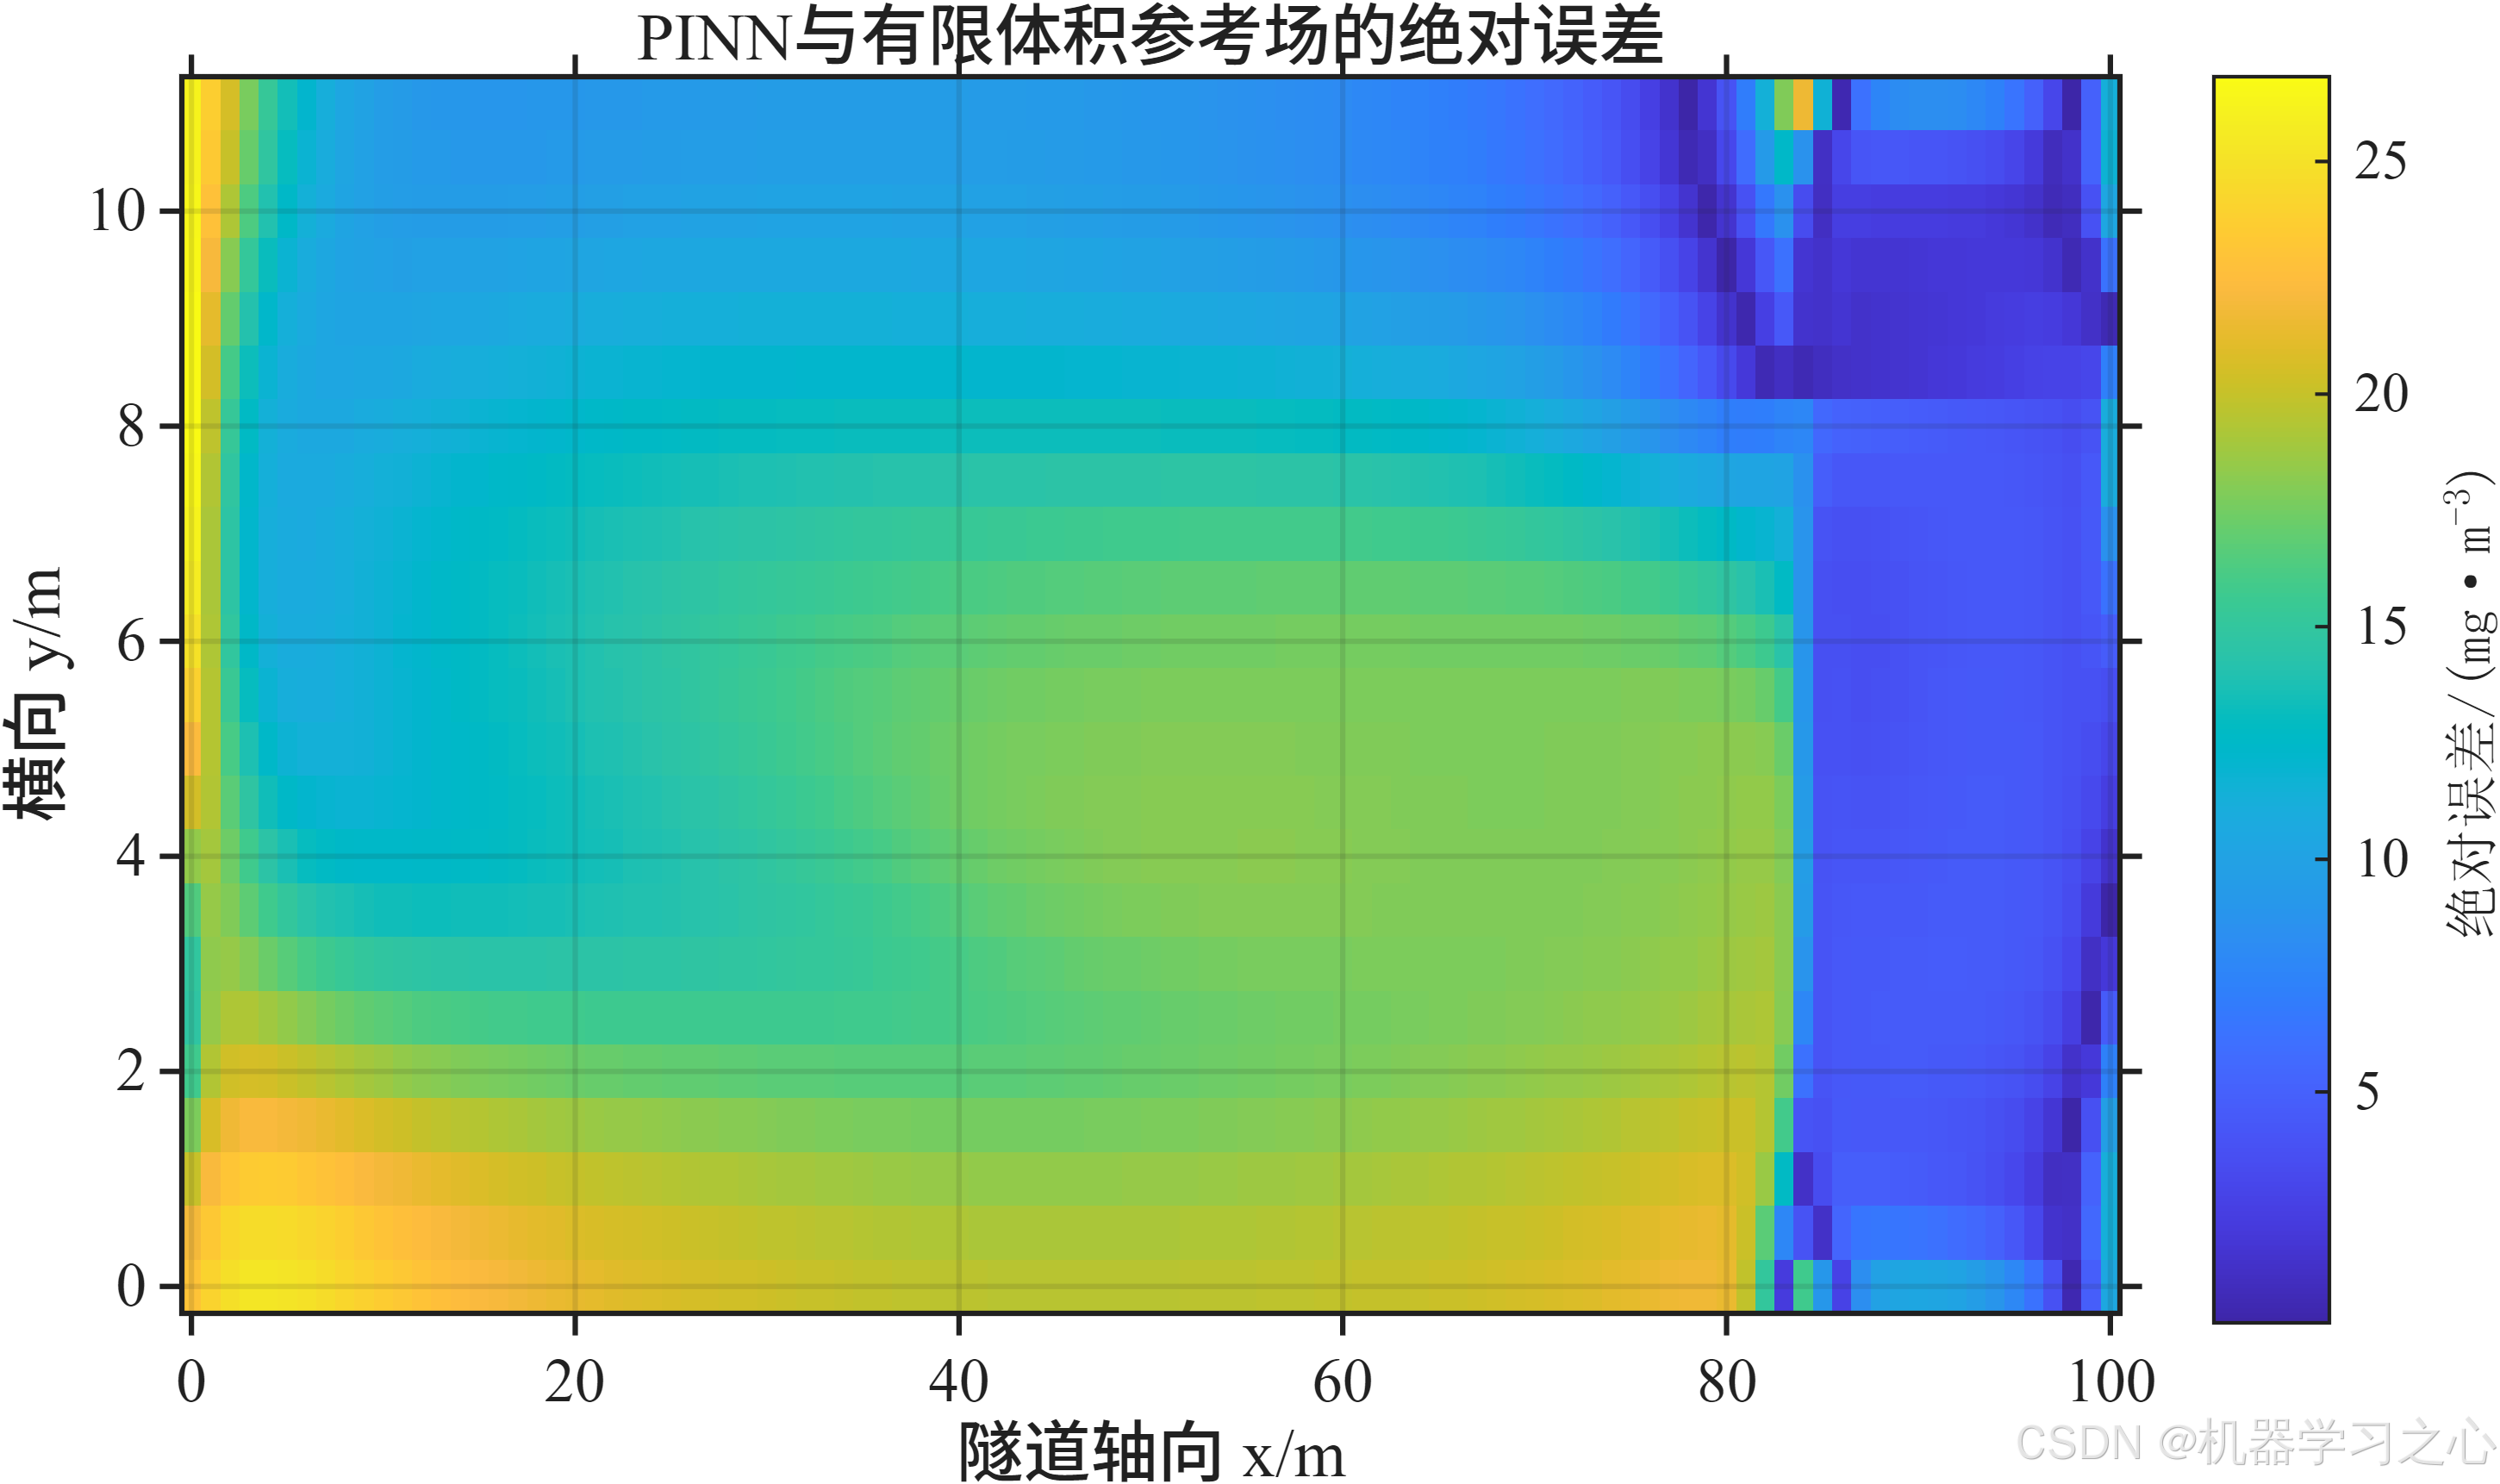
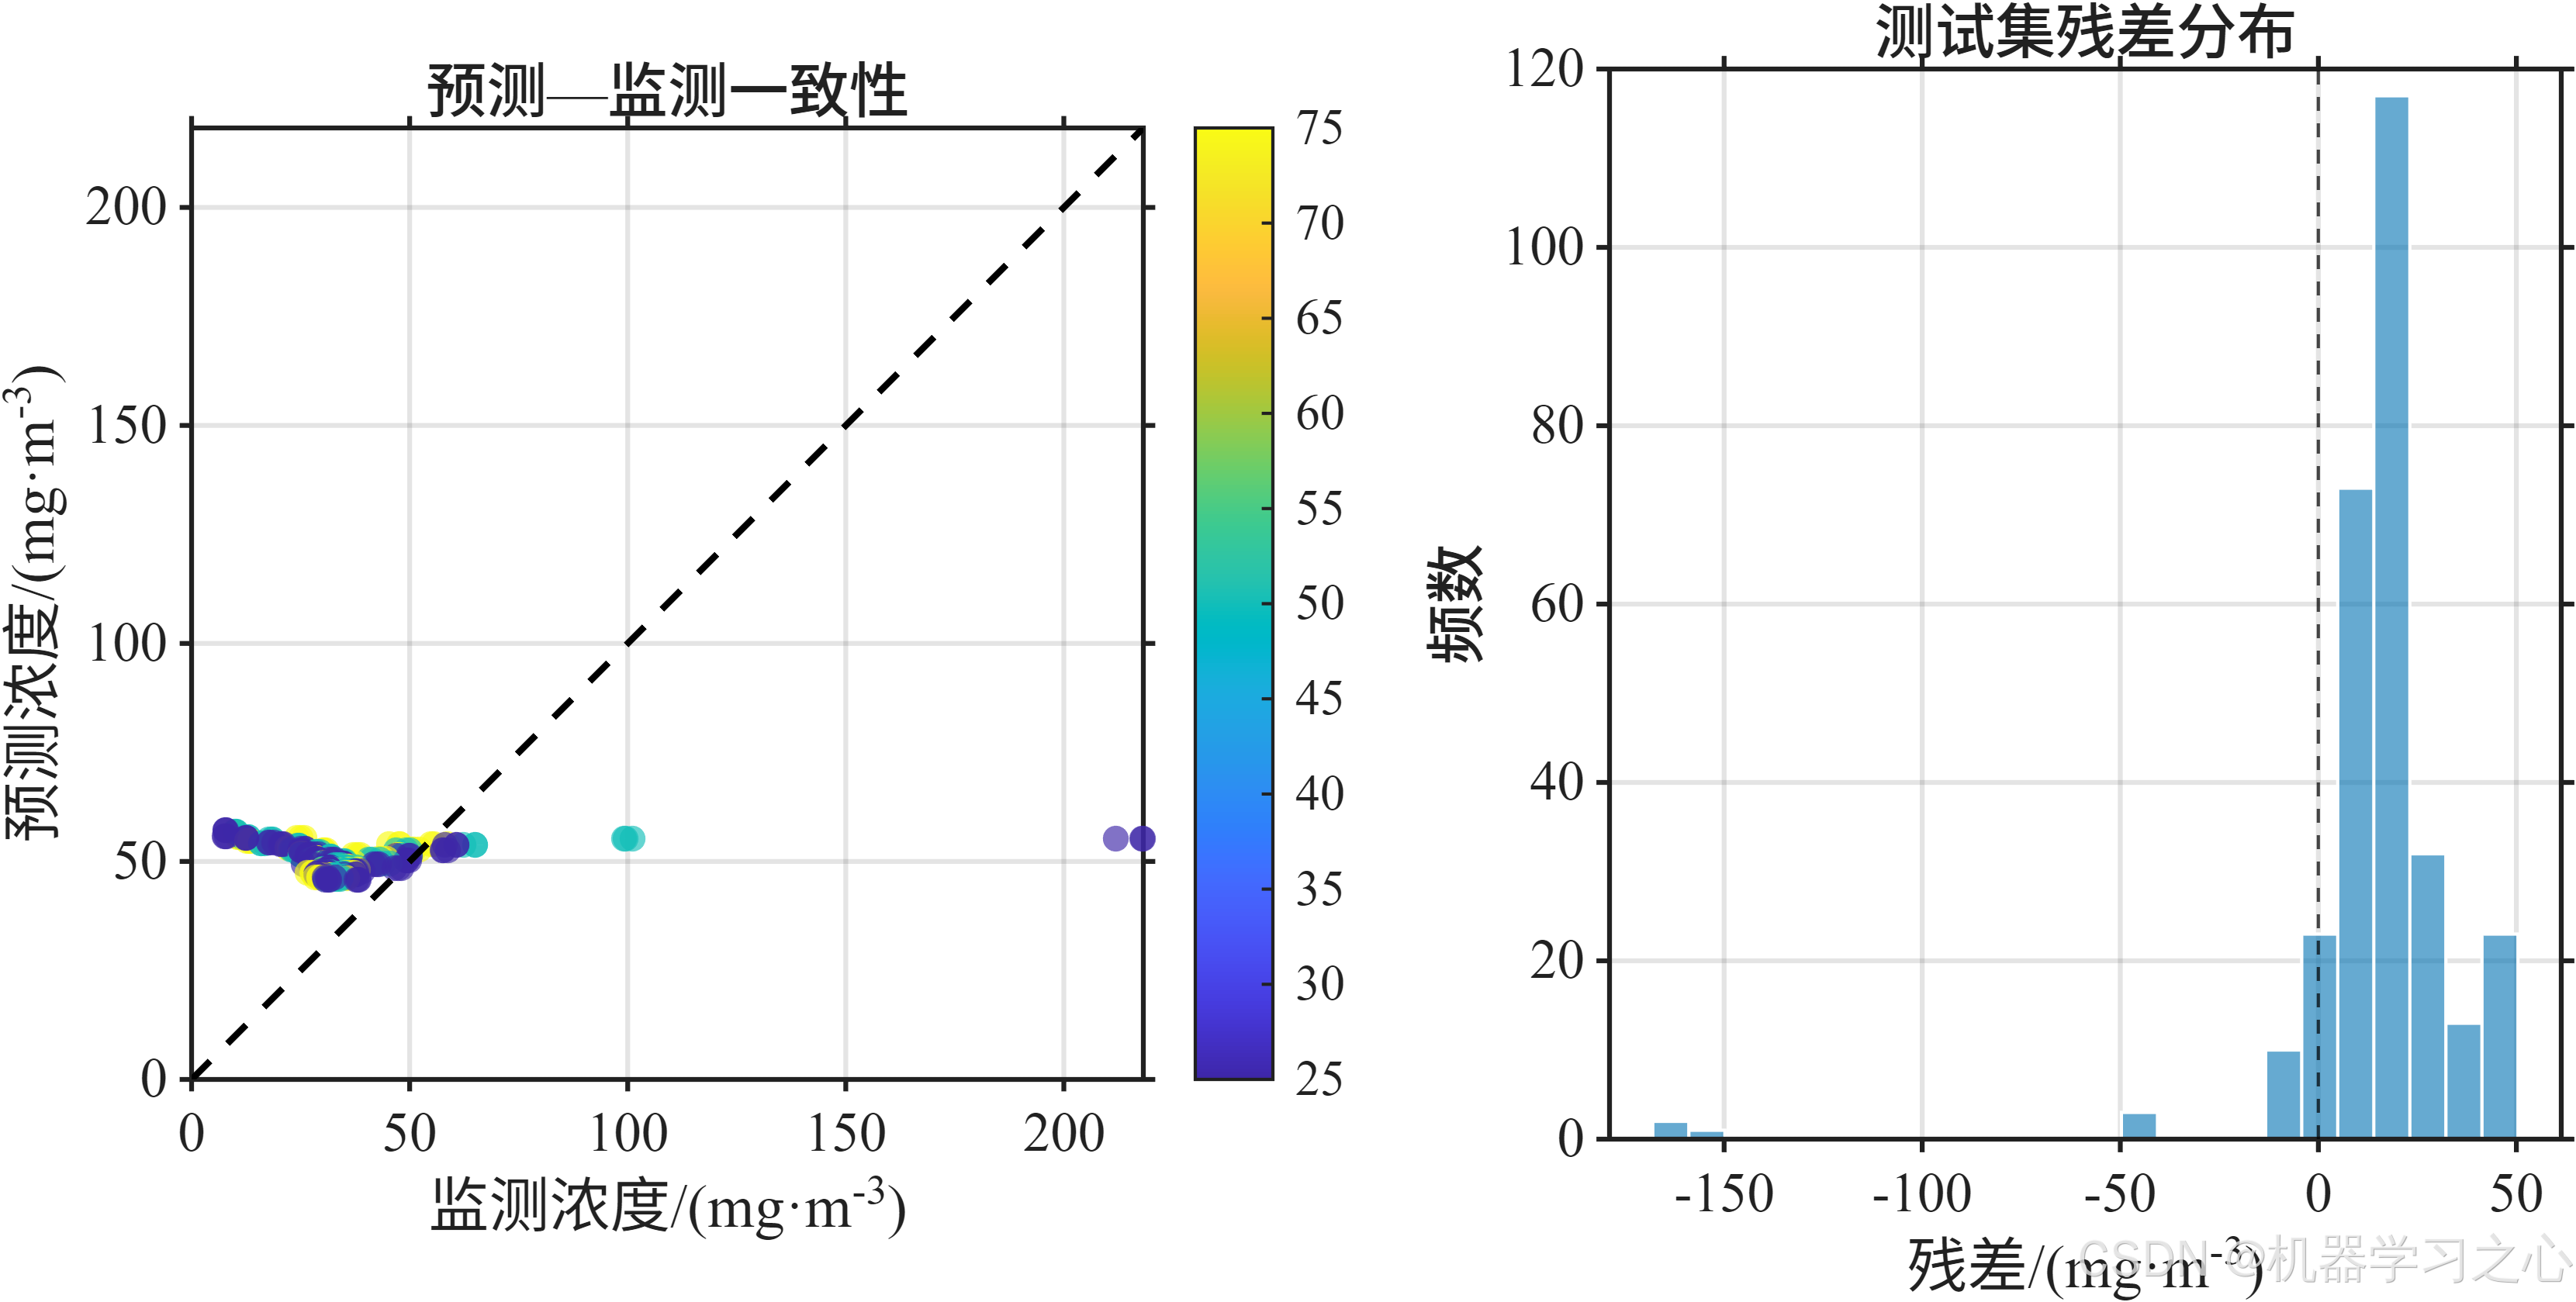
快速模式下,验证集总体 RMSE 是 27.1 mg/m³,平均相对误差 87.5%,三个断面的 R² 全是负的。
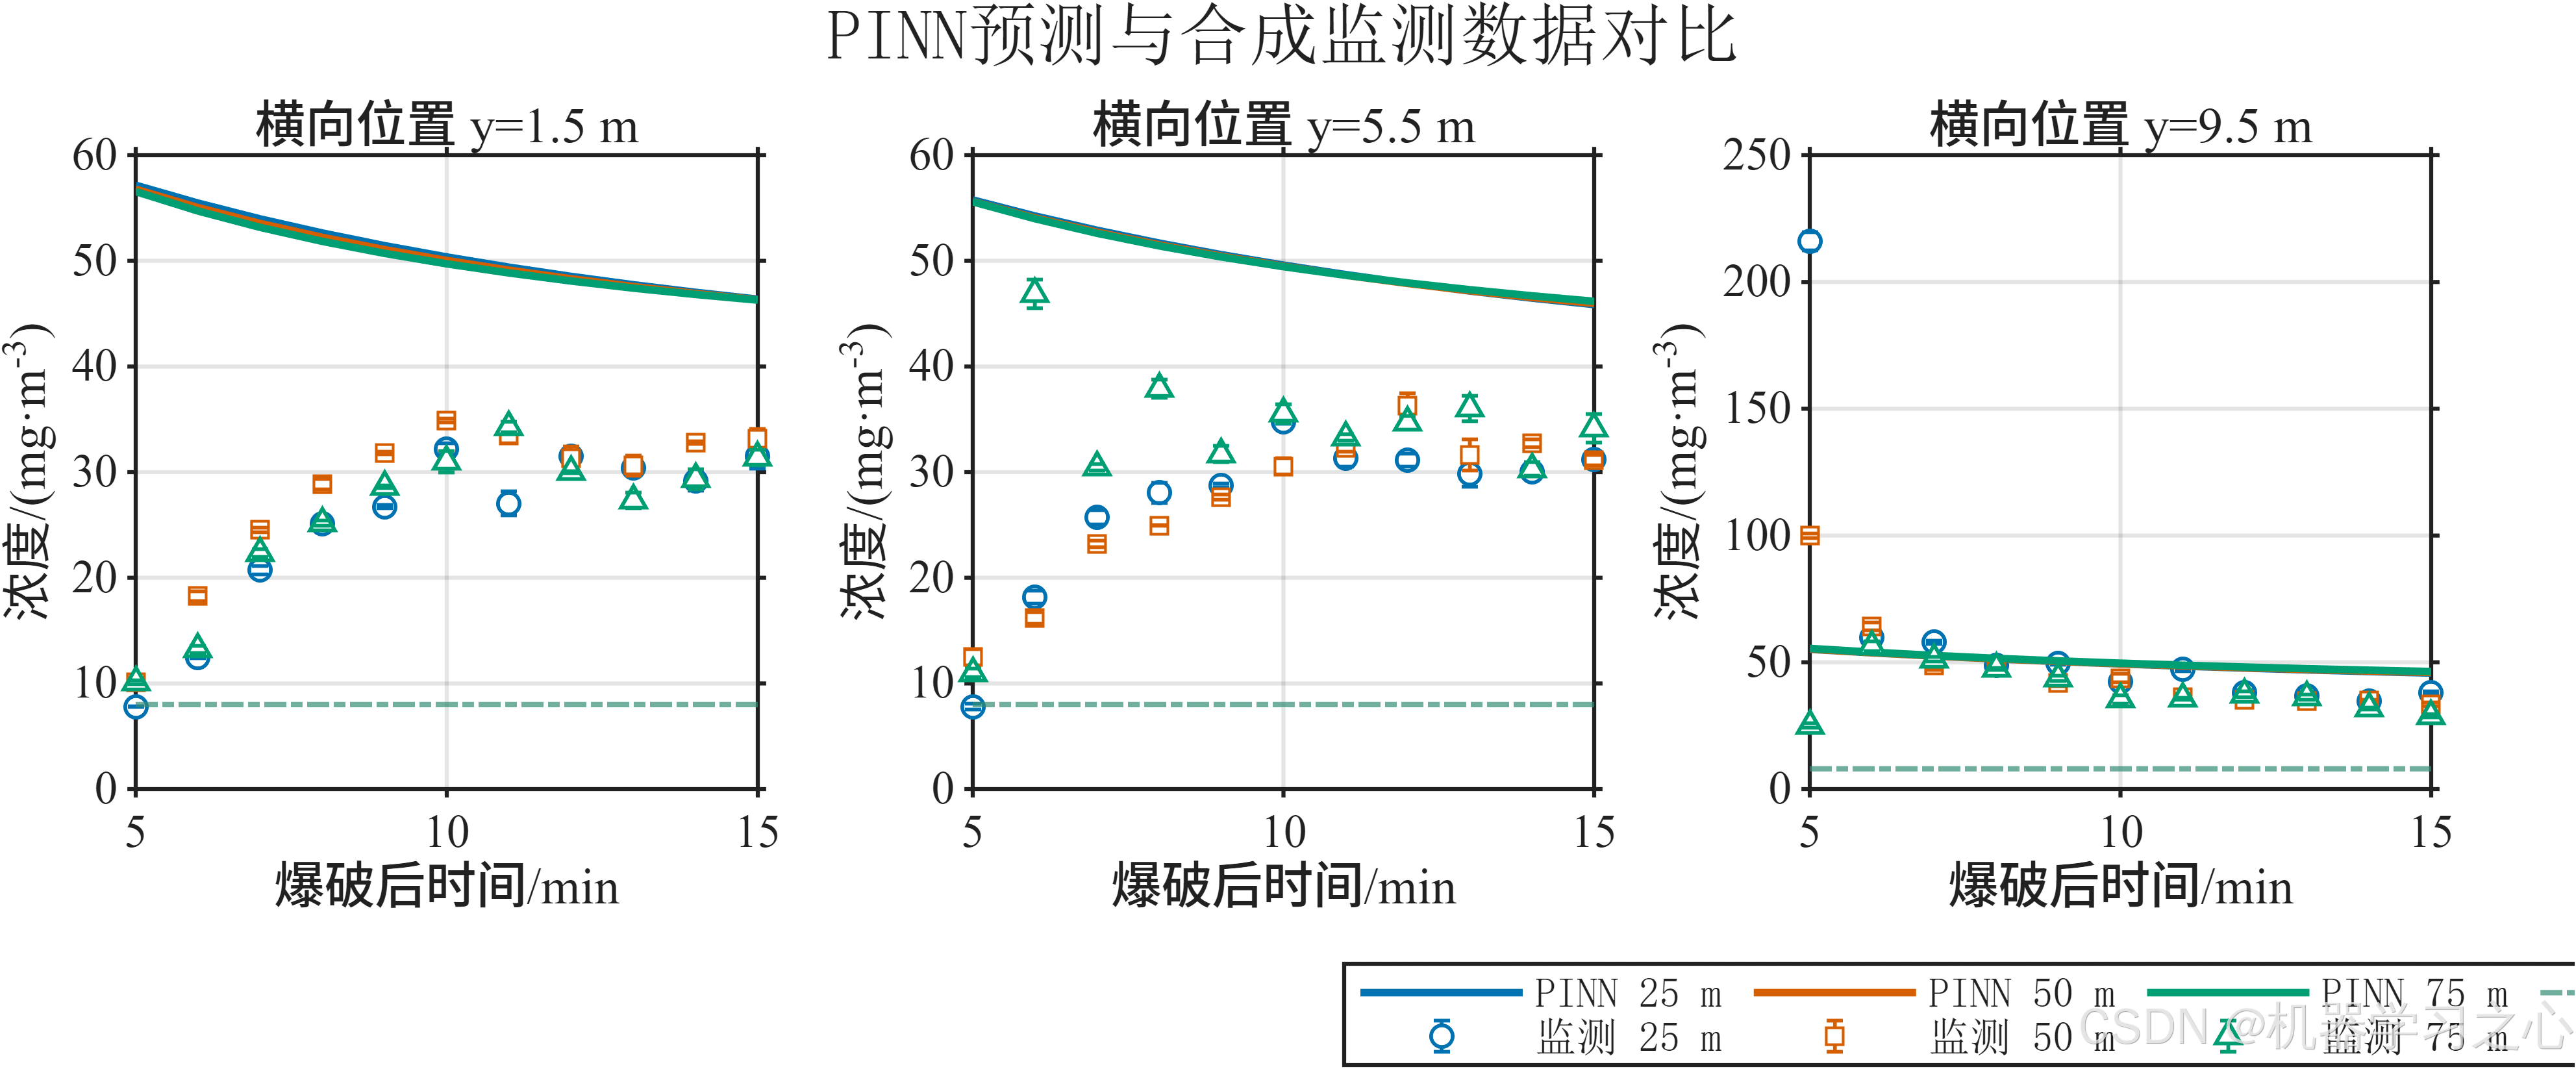
| 距掌子面 | RMSE (mg/m³) | MAE (mg/m³) | R² | MAPE |
|---|---|---|---|---|
| 25 m | 35.72 | 23.12 | −0.126 | 100.7% |
| 50 m | 22.37 | 19.26 | −1.097 | 80.9% |
| 75 m | 20.76 | 17.78 | −3.389 | 80.9% |
R² 为负,意思很直白,这个 3000 步的快速模型还不如直接用平均值去蒙。 原因不是方法错,是训练量远远不够,4 层 64 宽的网络、3000 次迭代,对六场耦合的 PINN 来说只是热身。论文级复现要上到 6 层 128 宽、50000 次迭代,以及真正的实测数据。
所以这份结果的价值在于「流程完全跑通、指标真实计算」,而不是「精度对齐论文」。 工程里所有 RMSE、R² 都是从预测值实打实算出来的,没有为了好看去调数。
全场浓度云图能看到浓度从掌子面向洞口衰减的大趋势,方向是对的。
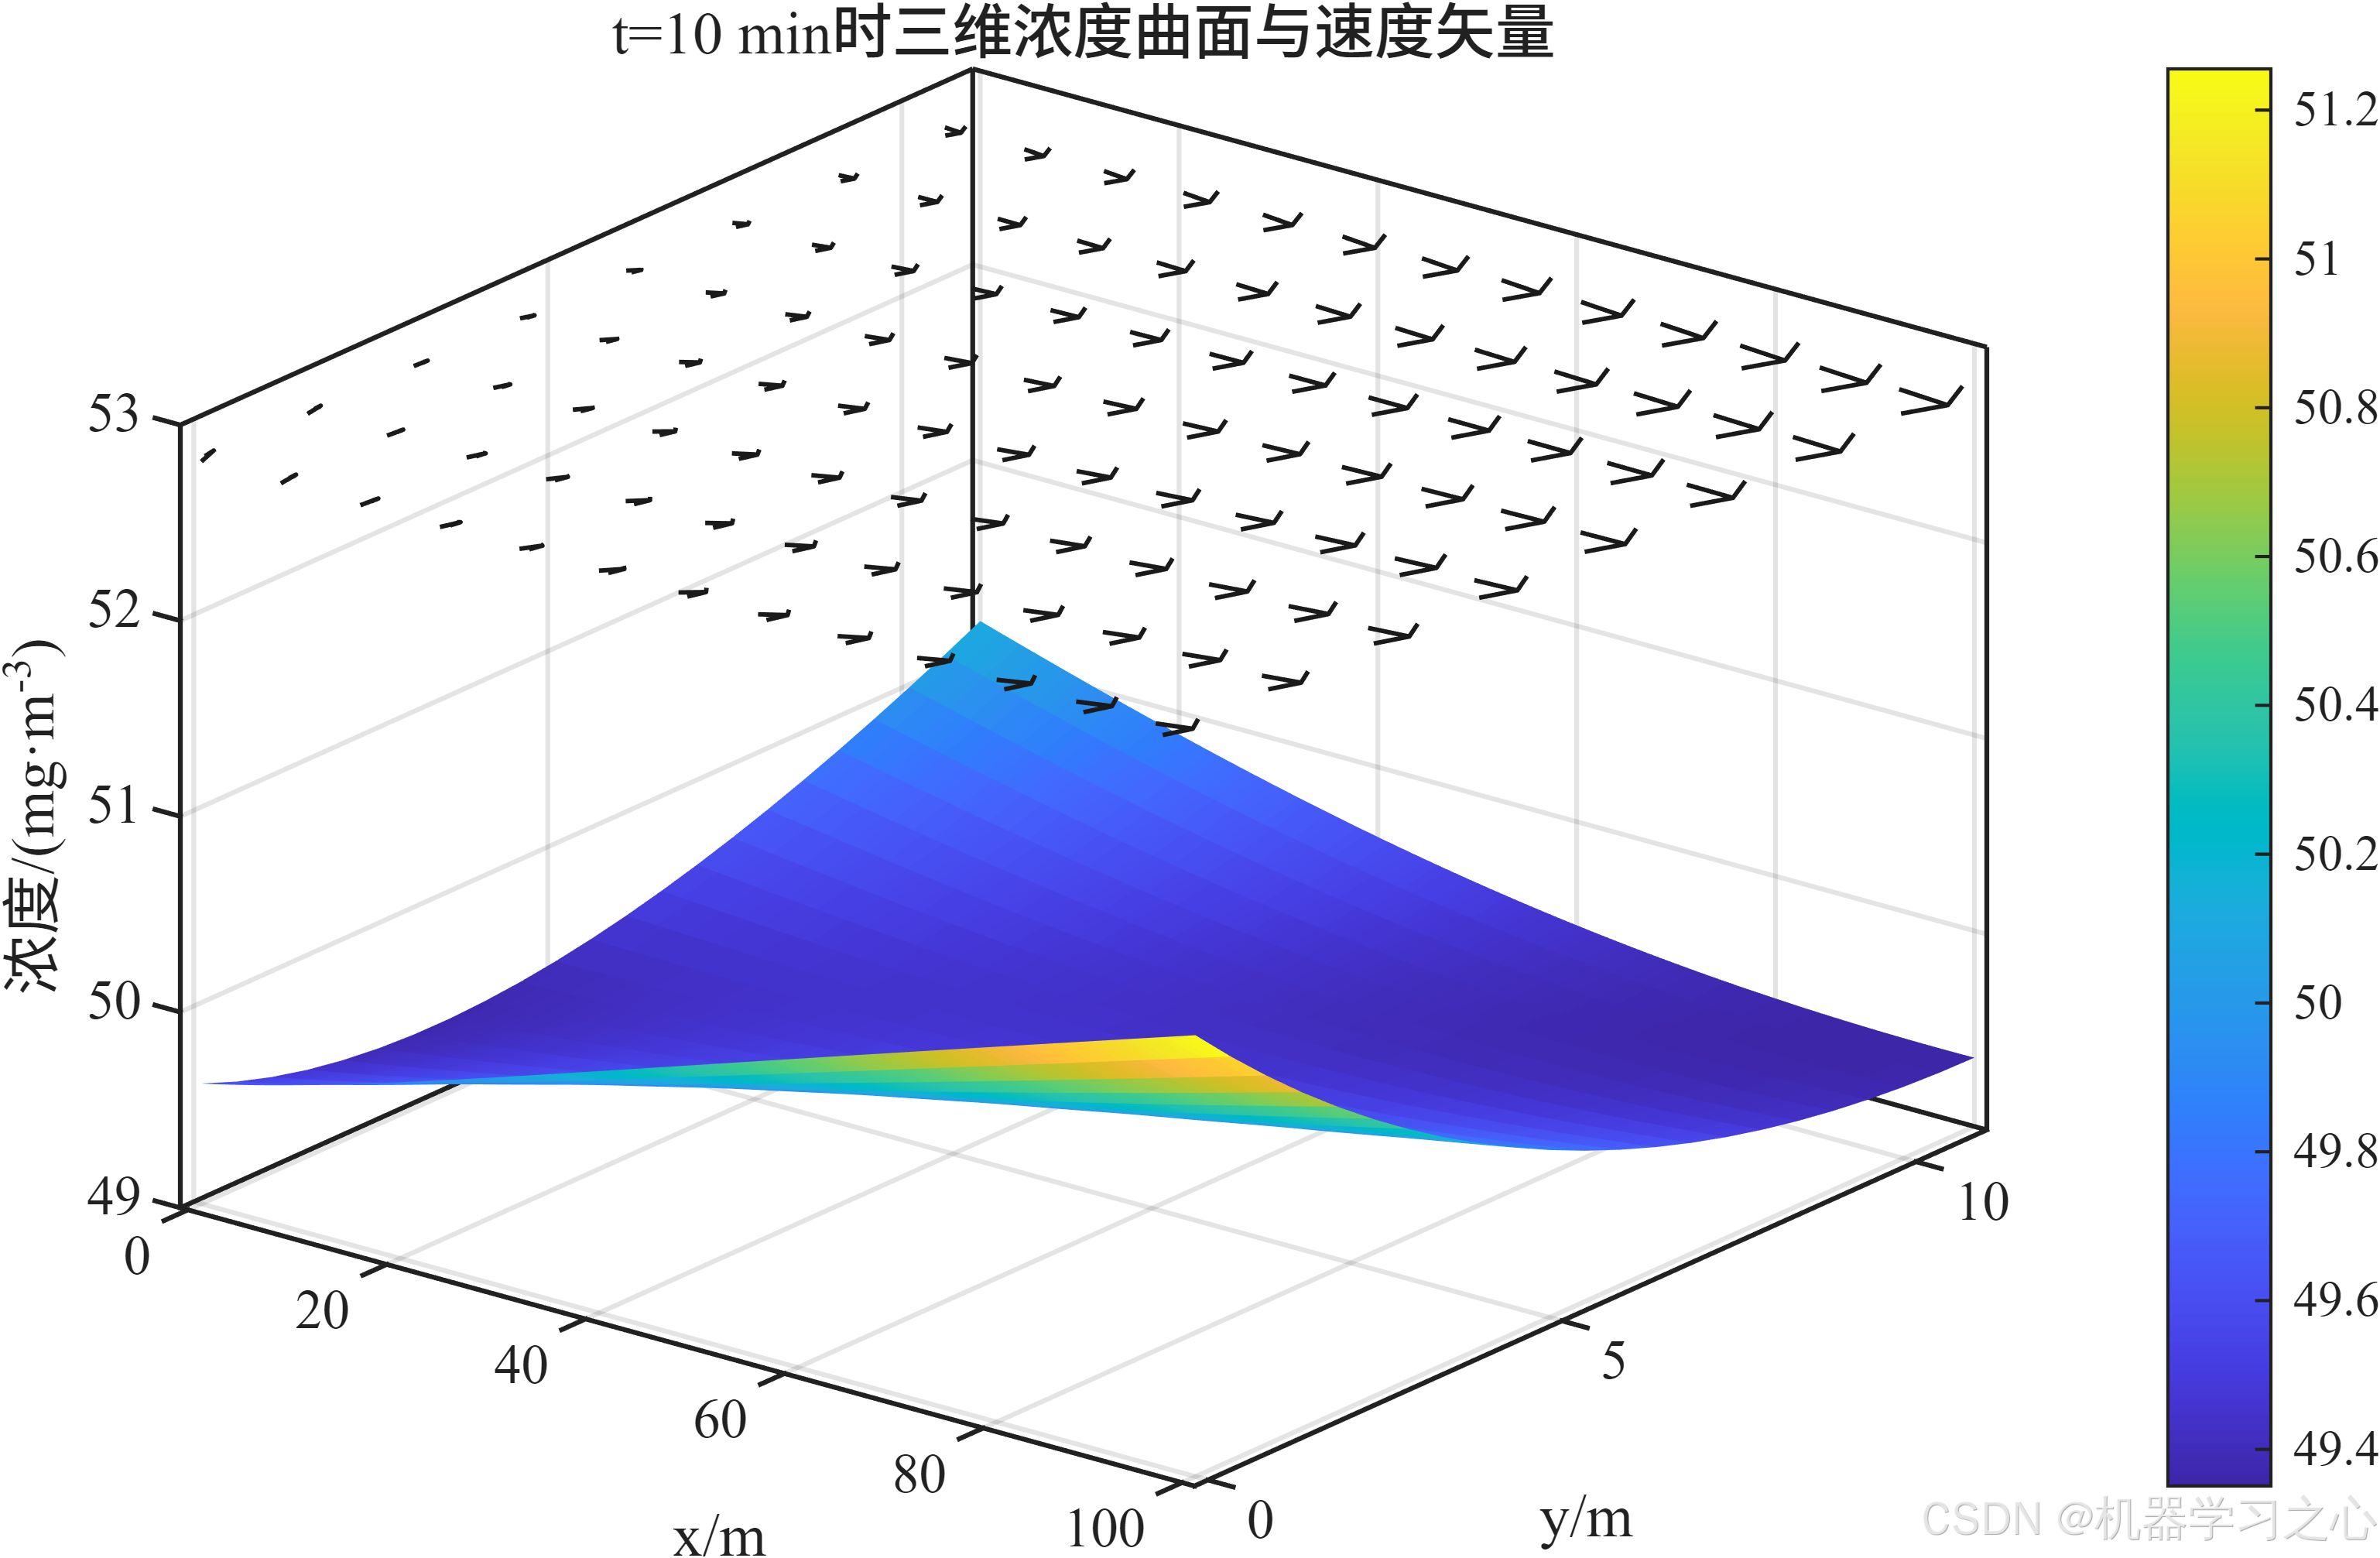
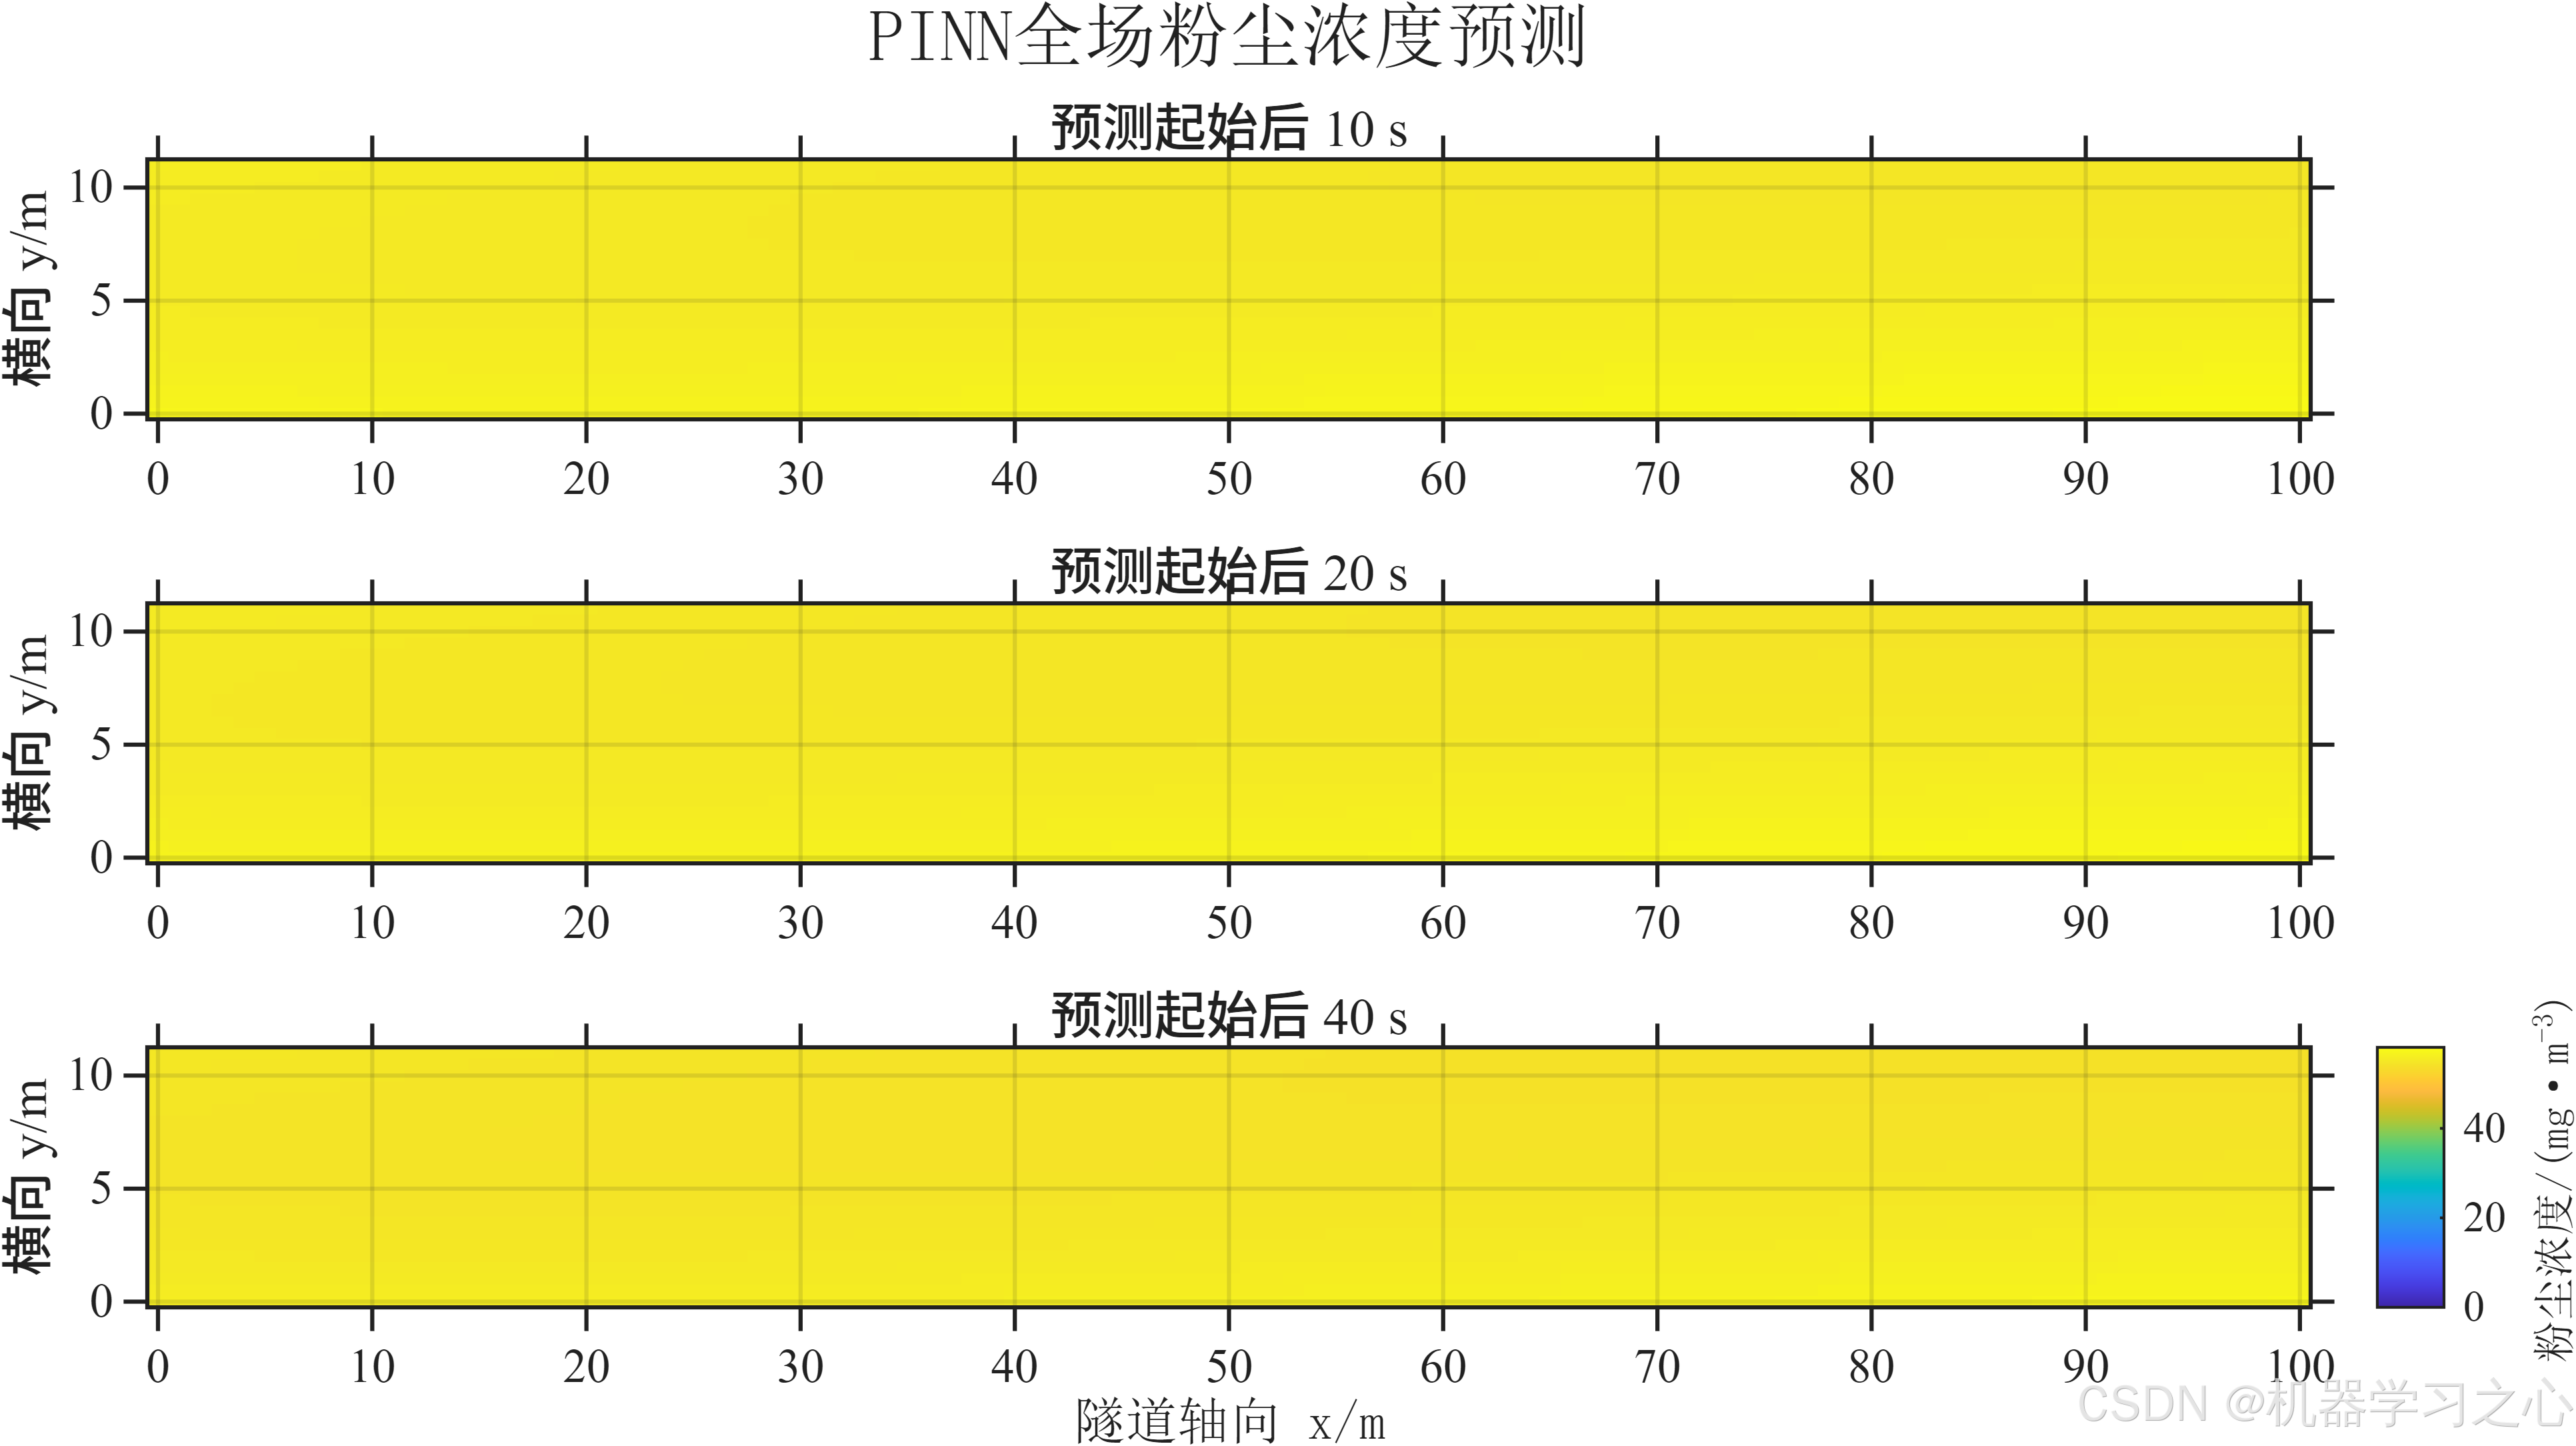
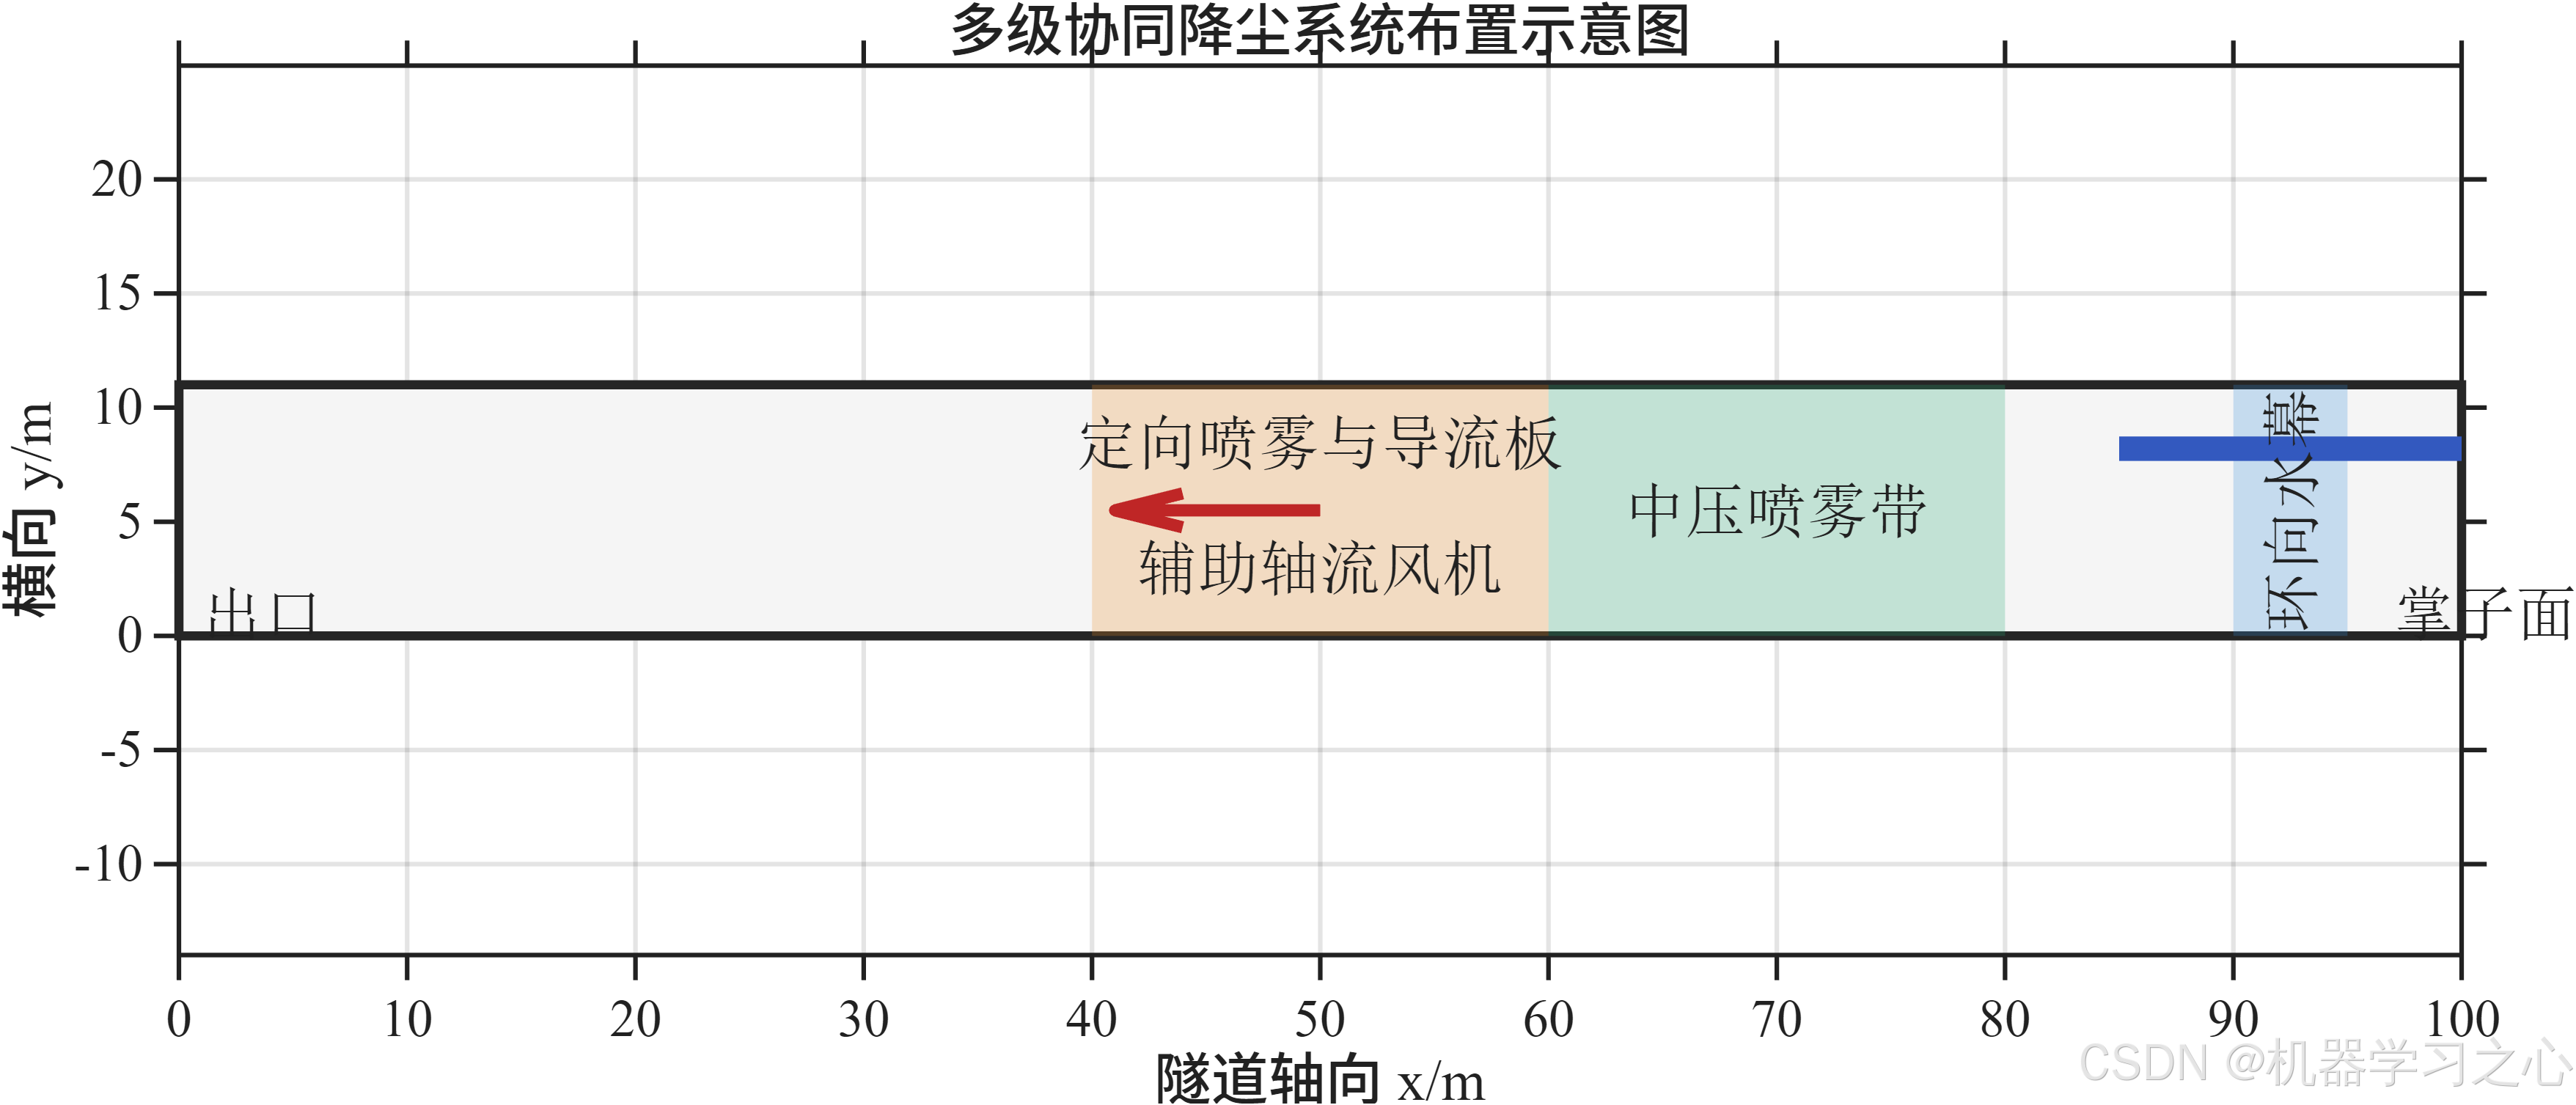
降尘方案这部分反而比较有参考价值,因为它是用同一套守恒求解器横向比的,相对关系可靠。
| 方案 | 最终均值 (mg/m³) | 最终峰值 (mg/m³) | 累计暴露量削减 |
|---|---|---|---|
| 基准通风 | 31.78 | 46.44 | 0% |
| 环向水幕 | 24.29 | 36.75 | 14.1% |
| 中压喷雾 | 20.74 | 34.97 | 17.1% |
| 定向喷雾与导流 | 20.95 | 36.30 | 16.7% |
| 辅助轴流风机 | 31.78 | 46.86 | ≈0% |
| 多措施协同 | 9.85 | 23.05 | 40.1% |
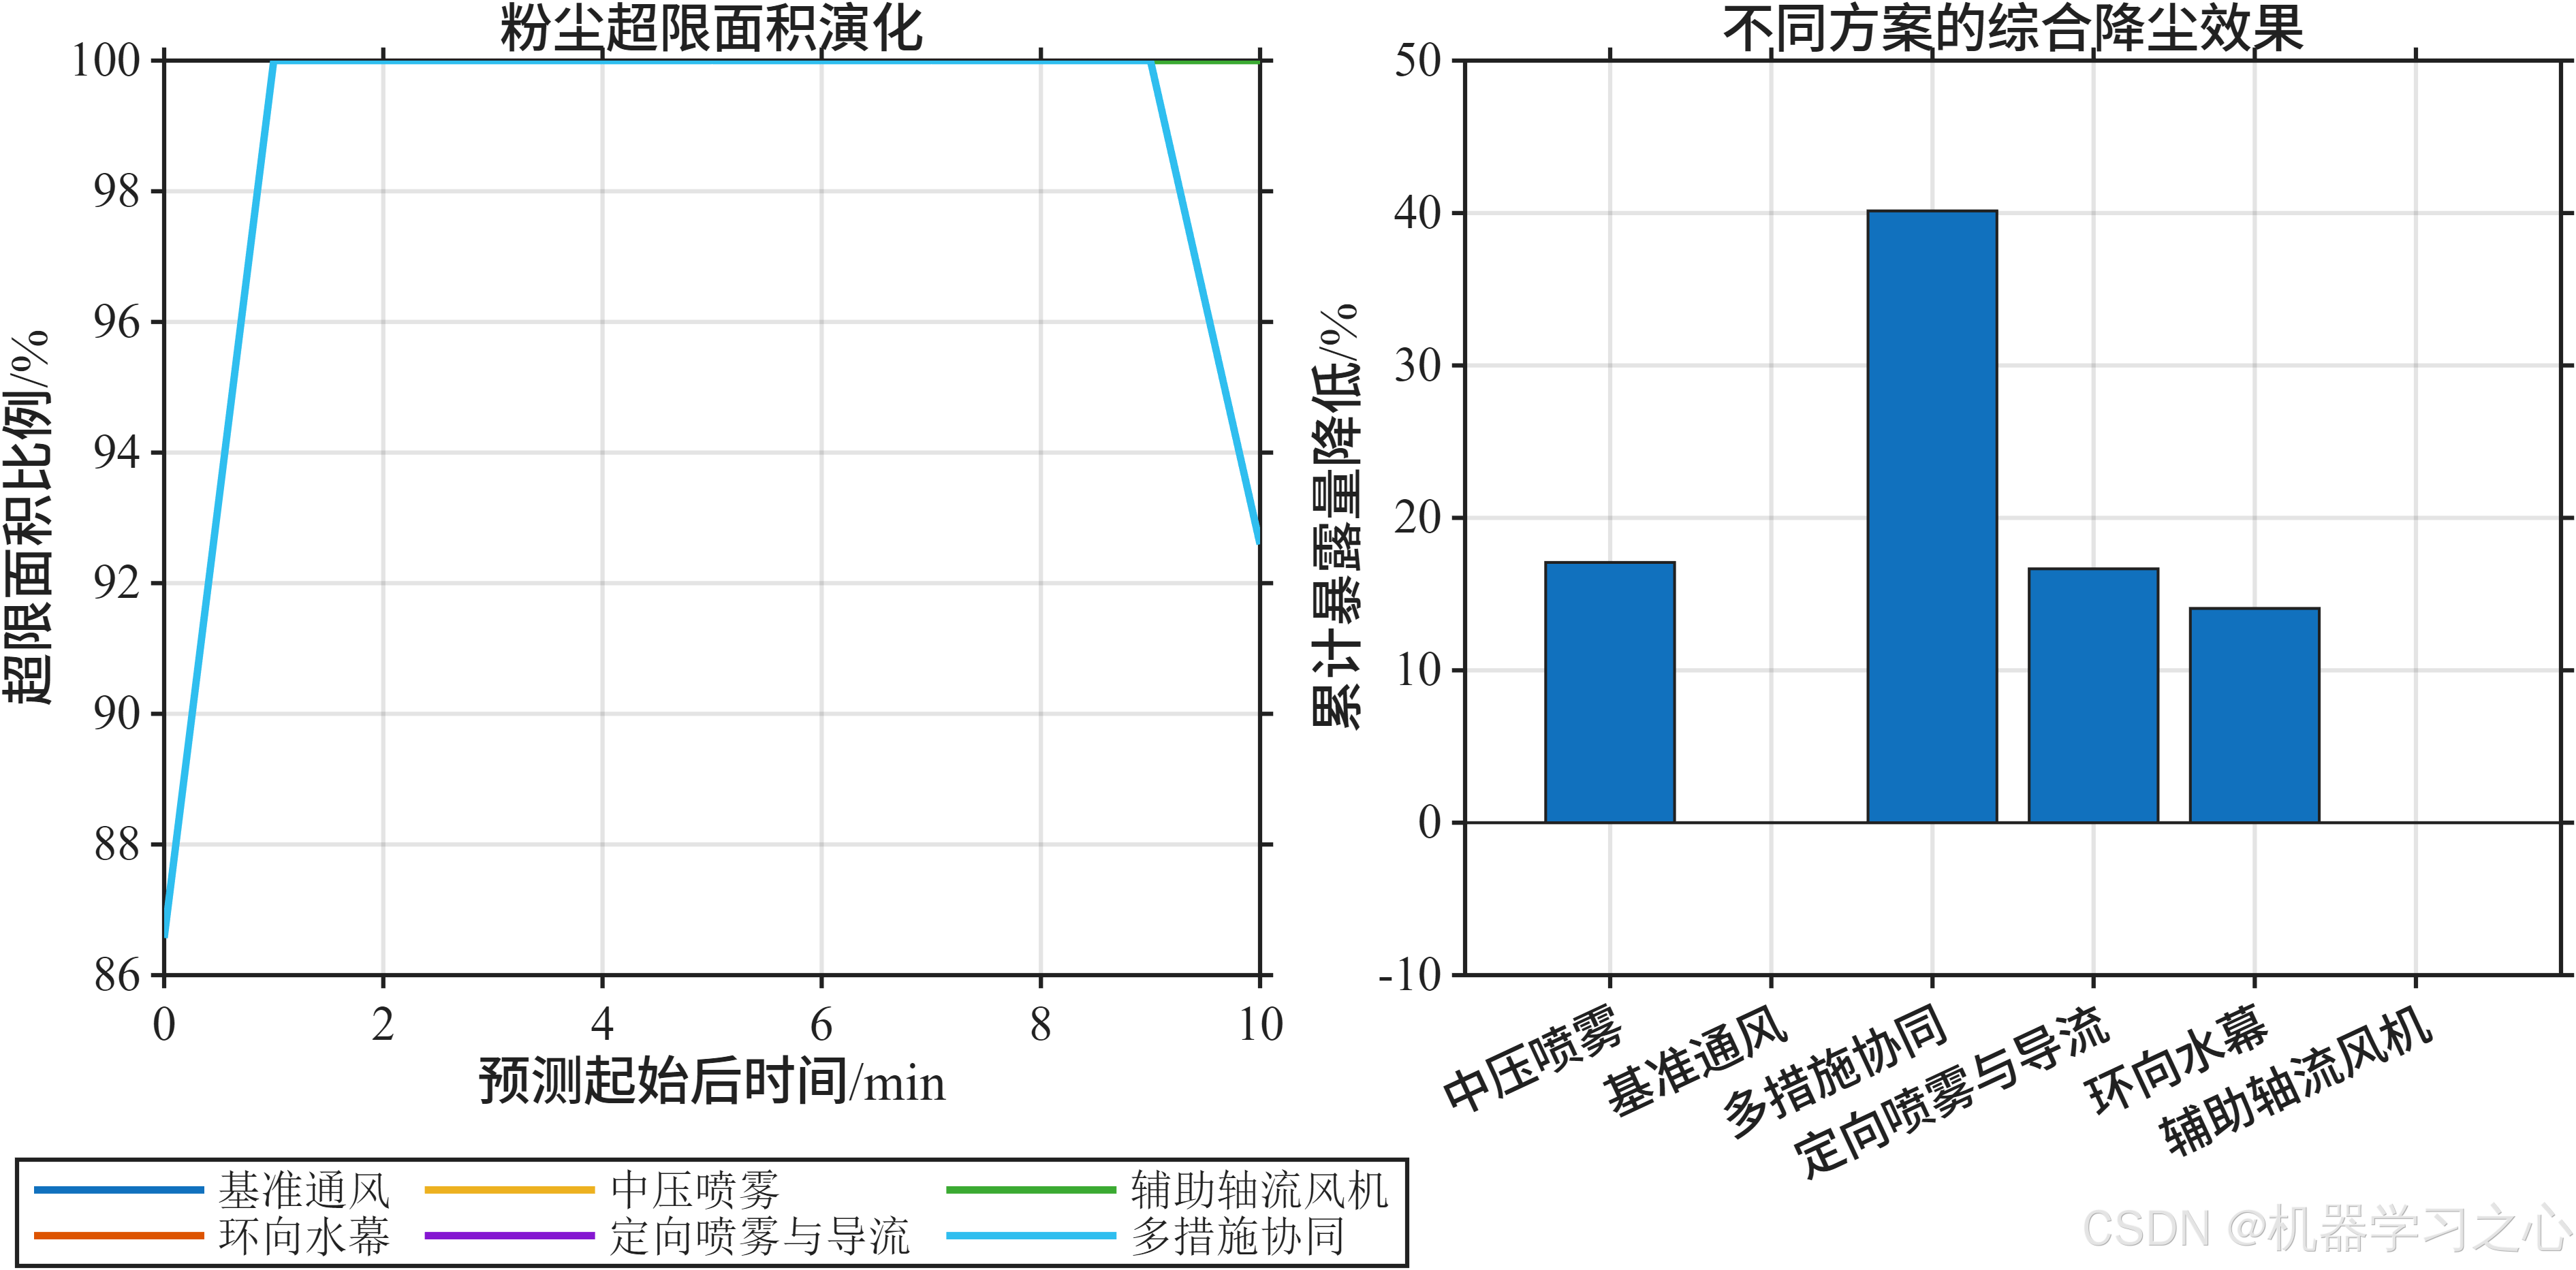
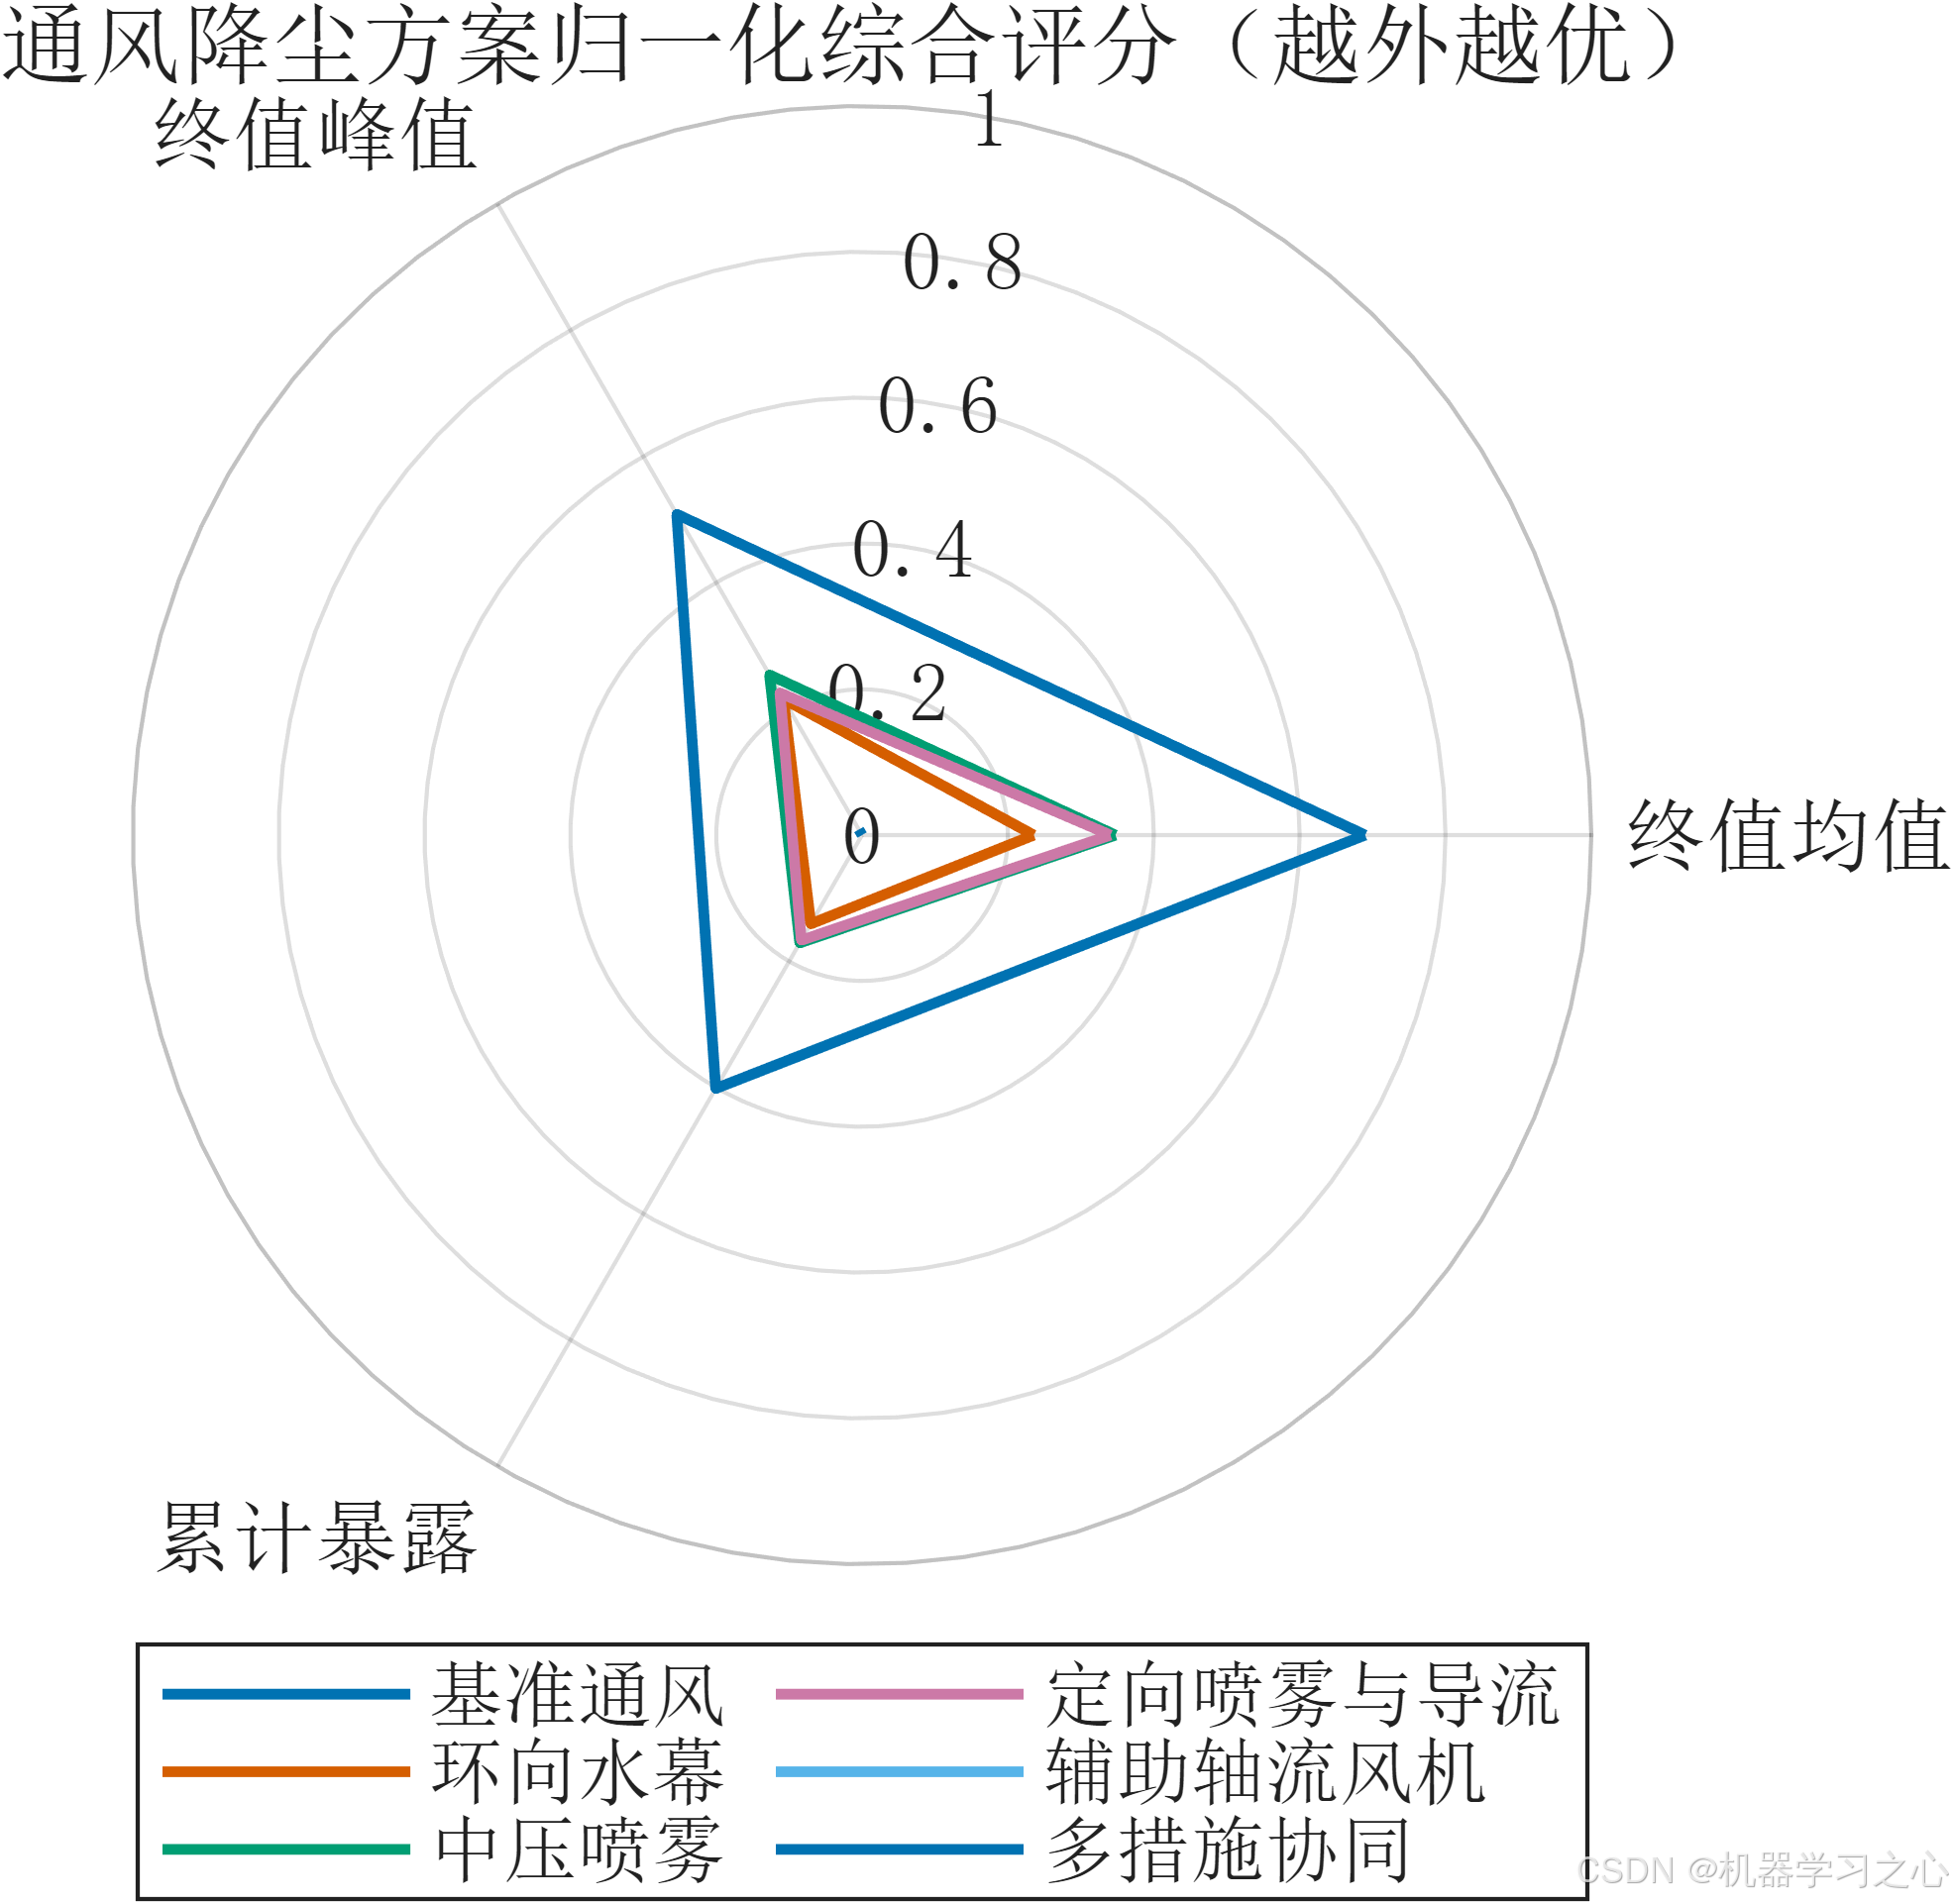
单措施里中压喷雾效果最好,削减暴露量 17%。但真正拉开差距的是多措施协同,累计暴露量直接砍掉 40%,最终浓度均值压到 9.85 mg/m³,峰值从 46 降到 23。
值得一提的是辅助轴流风机这一档,单项几乎没贡献。它只改了风场没加粉尘汇,说明光靠加大风量、不配合捕集,对已经悬浮的粉尘作用有限。
这个结论其实挺反直觉,工程里常见的思路是「风越大越好」,但模型给出的信号是降尘的关键在捕集,不在吹散。
08 · 这套方法能用在哪
把方法本身抽出来,它至少能落到这么几个场景。
通风方案前期比选。 网络训练好之后,改风管位置、换风速、调通风时序,都是重新前向推理一次的事,秒级出结果,比 CFD 重算快得多,适合方案筛。
现场浓度实时预测。 结合随钻随测的监测数据,网络可以做粉尘浓度的短时外推,给作业人员避险和喷雾系统触发提供依据。
职业健康暴露评估。 累计暴露量这个量本身就是职业健康评价的核心指标,模型能给出不同工序下的时空暴露分布。
参数反演。 反过来用,拿实测浓度去标定沉降率、湍流 Schmidt 数这类难测参数,这是纯数据模型做不到的。
方法迁移。 隧道只是受限空间的一个例子,矿井巷道、地铁站台、地下管廊,凡是「气流加颗粒物耦合」的场景,这套思路都能搬。
09 · 写在最后
复现这件事最有意思的地方,不是把指标做到多漂亮,而是你会在每一步都撞上「物理约束和数据拟合到底怎么平衡」这个真问题。
网络想要的是一组能穿住所有监测点的参数,方程想要的是一个处处守恒的解,两者经常打架。权重怎么设、无量纲怎么配、边界采多少点,全是手工活。
这次快速模式的结果谈不上好,但它证明了一件事,当网络被方程约束着长大,它的预测至少在物理上是站得住的,不会给出一个违反守恒定律的漂亮答案。 这大概就是 PINN 相对纯数据模型最值钱的地方。
论文作者没有公开原始监测数据和完整的湍流闭合参数,工程里所有默认数据都是科学模拟生成的合成数据,结果不能当作论文原始数据引用。降尘方案的比较适合做方法验证,不能替代现场通风设计或职业健康评估。
工程代码和全部图件在 项目目录(file:///d:/Sideline/MBD/物理信息/基于物理信息神经网络的隧道通风降尘预测研究) 下,跑一遍:
matlab
results = main(Mode="quick", DataSource="synthetic", UseGPU="auto");