📑 目录
- 三、少样本提示(few-shotting)
- [3.1 概念](#3.1 概念)
- [3.2 少样本聊天提示模板](#3.2 少样本聊天提示模板)
- [3.3 使用案例](#3.3 使用案例)
- [3.3.1 案例一:基于少样本提示实现分步推理引导](#3.3.1 案例一:基于少样本提示实现分步推理引导)
- [3.3.2 案例二:基于工具调用式少样本增强结构化信息提取](#3.3.2 案例二:基于工具调用式少样本增强结构化信息提取)
- [3.4 示例选择器(Example selectors)](#3.4 示例选择器(Example selectors))
- [3.4.1 概念](#3.4.1 概念)
- [3.4.2 基于长度的示例选择器](#3.4.2 基于长度的示例选择器)
- [3.4.3 基于语义相似性的示例选择器](#3.4.3 基于语义相似性的示例选择器)
- [3.4.4 基于最大边际相关性 MMR 的示例选择器](#3.4.4 基于最大边际相关性 MMR 的示例选择器)
- [3.4.5 基于 Ngram 重叠的示例选择器](#3.4.5 基于 Ngram 重叠的示例选择器)
- [四、输出解析器(Ouput parsers)](#四、输出解析器(Ouput parsers))
- [4.1 概念](#4.1 概念)
- [4.2 解析文本输出](#4.2 解析文本输出)
- [4.3 解析结构化对象输出](#4.3 解析结构化对象输出)
- [4.4 解析 Json 输出](#4.4 解析 Json 输出)
- 4.5 其他内置输出解析器概览
三、少样本提示(few-shotting)
3.1 概念
少样本提示是一种通过向 LLM 提供少量具体示例或样本,来教会它它如何执行某项特定任务的技术。提高模型性能的最有效方法之一是给出一个【模型示例】指导大模型你想做什么、怎么做。
- 参考之前学习的内容,我们可以将其想象为"零样本提示 ",直接给模型一道考题,不给任何例子。模型会凭借已有的知识直接回答。例如我们输入
"What is 2 🐦9?",答案可能是:
python
from langchain_openai import ChatOpenAI

model = ChatOpenAI(model="gpt-4o-mini")
model.invoke("What is 2 🐦9?").pretty_print()运行输出:
python
================================== Ai Message ==================================

表达式"2 🦜 9"不是⼀个标准的数学运算或⽅程。它似乎是数字2和鹦鹉🦜的组合,后⾯跟着数字9。

它没有特定的数学意义。- 少样本提示则是在给出考题前,先给它几道类似的、附有正确答案的例题。添加示例输入 和预期输出 的技术给到模型提示,让模型通过例题来理解任务应该怎么做。例如以下样例,模型通过样例后可以发现"🐦"与"+"含义相似,便可以按照此规则得出 "what is 2 🐦9? "的结果是11。
python
examples = [
	{"input":"2 🐦 2","output":"4"},
	{"input":"2 🐦 3","output":"5"}
]
这能解决什么问题?LLM 虽然知识渊博,但有时我们需要它以非常特定的格式、风格或逻辑来回答问题。提供正确的示例可以减少模型 "胡说八道" 或犯低级错误的概率,将其输出约束在你提供的范例范围内。
- 强制要求模型以特定的格式(如JSON、XML、特定的列表样式)输出结果。样例可以当作格式样板。
- 有些任务很难用文字指令清晰描述(例如:"请用莎士比亚的风格写作")。提供几个例子比写长篇大论的指令更有效。
- 对于需要多步推理的复杂任务,示例可以展示出思考链,引导模型遵循类似的推理路径。
3.2 少样本聊天提示模板
FewShotChatMessagePromptTemplate 是 LangChain 中用于构建聊天格式少样本提示 的模板类。它可以批量把一组样本对(输入 - 期望输出)转换成一组HumanMessage与AIMessage交替的聊天消息,专门适配聊天大模型,并且实现了标准 Runnable 接口,可以嵌入到主提示模板、LCEL 链路中使用。
构造方式
直接实例化构造,需要传入样本数据集,以及用于格式化单条样本的聊天模板
python
from langchain_core.prompts import ChatPromptTemplate, FewShotChatMessagePromptTemplate

# 1. 准备少样本数据集
examples = [
    {"input": "2 + 2", "output": "4"},
    {"input": "2 + 3", "output": "5"},
]

# 2. 定义单个样本的格式化模板
example_prompt = ChatPromptTemplate([
    ("human", "{input}"),
    ("ai", "{output}"),
])

# 3. 构造少样本提示模板
few_shot_prompt = FewShotChatMessagePromptTemplate(
    example_prompt=example_prompt,  # 格式化单条示例的模板
    examples=examples               # 样本示例集合
)
内置参数
examples:样本列表,列表内每一项是字典,存放单条示例的输入输出字段。example_prompt:ChatPromptTemplate对象,定义如何把单条示例字典渲染成一对人机聊天消息。
内置方法
invoke():Runnable 标准调用方法,传入变量字典,渲染全部示例,返回ChatPromptValue对象。to_messages():将渲染得到的ChatPromptValue转为模型可接收的消息实例列表list[BaseMessage]。
基础调用示例
python
# 渲染少样本模板,生成消息列表
print(few_shot_prompt.invoke({}).to_messages())运行输出:
python
[
 HumanMessage(content='2 + 2', additional_kwargs={}, response_metadata={}),
 AIMessage(content='4', additional_kwargs={}, response_metadata={}),
 HumanMessage(content='2 + 3', additional_kwargs={}, response_metadata={}),
 AIMessage(content='5', additional_kwargs={}, response_metadata={})
]
嵌入主模板,构建完整 LCEL 调用链
可以将FewShotChatMessagePromptTemplate直接嵌入到ChatPromptTemplate,和系统提示、用户当前提问组合,送入模型进行推理。
python
# 组装完整提示模板
final_prompt = ChatPromptTemplate([
    ("system", "你是一个神奇的数学天才。"),
    few_shot_prompt,
    ("human", "{input}")
])

# 构建LCEL链路
chain = final_prompt | model
chain.invoke({"input": "what is 2 + 9?"}).pretty_print()运行输出:
python
================================ Ai Message =================================
11
3.3 使用案例
3.3.1 案例一:基于少样本提示实现分步推理引导
案例目标
给定问题,让大模型先展示分步推理过程,再输出最终结论 ,而不是直接给出答案。
测试输入问题:
《教父》和《星球大战》的导演来自同一个国家吗?
本案例使用字符串版本少样本模板 FewShotPromptTemplate,构造带推理步骤的示例,引导模型模仿示例的思考格式输出。
构造思路
- 准备多组示例:每组包含【问题 + 完整分步推理过程 + 最终答案】
- 使用
PromptTemplate定义单个样本的渲染模板 - 实例化
FewShotPromptTemplate,配置前缀、后缀,组装全部示例 - 调用模板渲染提示词,送入大模型得到推理结果
内置参数(FewShotPromptTemplate)
examples:样本示例列表,列表中每一项为字典,存放单条示例的 question 与 answer。example_prompt:PromptTemplate对象,用于格式化单个样本。prefix:全部示例之前的提示文本。suffix:全部示例之后的提示文本,一般放置待预测的新问题。input_variables:模板占位变量名称列表。
内置方法
invoke():Runnable 标准调用方法,传入变量字典,渲染完整提示,返回PromptValue。.to_string():将 PromptValue 转为纯字符串。.to_messages():将 PromptValue 转为消息列表,可直接送入聊天模型。
完整代码示例:
python
from langchain_core.prompts import PromptTemplate, FewShotPromptTemplate

# 1. 定义单条样本的格式化模板
example_prompt = PromptTemplate.from_template("Question: {question}\n{answer}")

# 2. 准备少样本数据集,每组包含问题 + 完整分步推理
examples = [
    {
        "question": "李白和杜甫,谁更长寿?",
        "answer": """
		是否需要后续问题:是的。
		后续问题:李白享年多少岁?
		中间答案:李白享年61岁。
		后续问题:杜甫享年多少岁?
		中间答案:杜甫享年58岁。
		所以最终答案是:李白
		"""
    },
    {
        "question": "腾讯的创始人什么时候出生?",
        "answer": """
		是否需要后续问题:是的。
		后续问题:腾讯的创始人是谁?
		中间答案:腾讯由马化腾创立。
		后续问题:马化腾什么时候出生?
		中间答案:马化腾出生于1971年10月29日。
		所以最终答案是:1971年10月29日
		"""
    },
    {
        "question": "孙中山的外祖父是谁?",
        "answer": """
		是否需要后续问题:是的。
		后续问题:孙中山的母亲是谁?
		中间答案:孙中山的母亲是杨太夫人。
		后续问题:杨太夫人的父亲是谁?
		中间答案:杨太夫人的父亲是杨胜辉。
		所以最终答案是:杨胜辉
		"""
    },
    {
        "question": "电影《红高粱》和《霸王别姬》的导演来自同一个国家吗?",
        "answer": """
		是否需要后续问题:是的。
		后续问题:《红高粱》的导演是谁?
		中间答案:《红高粱》的导演是张艺谋。
		后续问题:张艺谋来自哪里?
		中间答案:中国。
		后续问题:《霸王别姬》的导演是谁?
		中间答案:《霸王别姬》的导演是陈凯歌。
		后续问题:陈凯歌来自哪里?
		中间答案:中国。
		所以最终答案是:是
		"""
    }
]

# 测试:渲染单条示例
print(example_prompt.invoke(examples[0]).to_string())运行输出:
python
Question: 李白和杜甫,谁更长寿?

是否需要后续问题:是的。
后续问题:李白享年多少岁?
中间答案:李白享年61岁。
后续问题:杜甫享年多少岁?
中间答案:杜甫享年58岁。
所以最终答案是:李白
python
# 3. 构建完整FewShotPromptTemplate
prompt = FewShotPromptTemplate(
    examples=examples,
    example_prompt=example_prompt,
    suffix="Question: {input}",
    input_variables=["input"],
)

# 4. 渲染模板,送入模型进行推理
prompt_messages = prompt.invoke({"input":"《教父》和《星球大战》的导演来自同一个国家吗?"}).to_messages()
model.invoke(prompt_messages).pretty_print()模型输出结果:
python
================================ Ai Message =================================
是否需要后续问题:是的。
后续问题:《教父》的导演是谁?
中间答案:《教父》的导演是弗朗西斯·福特·科波拉。
后续问题:弗朗西斯·福特·科波拉来自哪里?
中间答案:弗朗西斯·福特·科波拉来自美国。
后续问题:《星球大战》的导演是谁?
中间答案:《星球大战》的导演是乔治·卢卡斯。
后续问题:乔治·卢卡斯来自哪里?
中间答案:乔治·卢卡斯也来自美国。
所以最终答案是:是
📌 案例小结:
通过少样本提示,给模型提供带推理步骤的示范样例,模型会模仿样本的格式,对新问题一步步拆解思考,而不是直接给出简短答案。适合需要展示推理过程的问答场景。
3.3.2 案例二:基于工具调用式少样本增强结构化信息提取
案例目标
结合工具调用风格的少样本提示 与结构化输出能力,从自然语言文本中提取人物信息。输入一段描述文本,模型输出符合 Pydantic Schema 的结构化人物对象列表,未知字段返回
None。测试输入文本:
篮球场上,身高两米的中锋王伟默契地将球传给一米七的后卫挚友李明,完成一记绝杀。这对老友用十年配合弥补了身高的差距。
预期提取结果:
python
people=[
    Person(name='王伟', height_in_meters="2",skin_color=None,hair_color=None),
    Person(name='李明',height_in_meters="1.7",skin_color=None,hair_color=None),
]
构造思路
- 定义 Pydantic 模型,声明需要提取的结构化数据 Schema;
- 准备两组少样本示例:无人名场景、仅人名缺少其余属性场景;
- 构建
ChatPromptTemplate,使用MessagesPlaceholder预留少样本消息插槽; - 使用
tool_example_to_messages工具函数,把文本 + 预期结构化结果转换成工具调用格式的多消息组(HumanMessage + AIMessage(tool_call) + ToolMessage + AIMessage); - 将组装好的示例消息填入模板,搭配
with_structured_output绑定模型输出结构,构建 LCEL 链路完成信息提取。
核心工具 / 类参数说明
1. Pydantic BaseModel
用于定义输出数据结构,约束字段名称、类型与描述,供with_structured_output使用。
2. tool_example_to_messages(LangChain 内置工具函数)
专门用于工具调用类型的少样本示例 ,和普通FewShotChatMessagePromptTemplate不一样,一组样例会生成多条消息。
参数
input:str,示例里的原始用户输入文本tool_calls:list[BaseModel],期望输出的 Pydantic 模型实例tool_outputs:可选,工具返回内容;不传默认填充You have correctly called this tool.ai_response:可选,整套示例末尾追加的 AI 文本回复,部分模型需要
返回值 :list[BaseMessage],转换完成的消息列表
3. ChatPromptTemplate + MessagesPlaceholder
MessagesPlaceholder("example_messages"):作为插槽,批量放入工具调用格式的少样本消息组。("user", "{new_message}"):接收待提取信息的新文本。
内置方法
invoke():Runnable 标准调用,传入变量字典,渲染完整提示消息to_messages():将ChatPromptValue转为消息实例列表,用于预览消息结构with_structured_output():模型绑定结构化输出,强制模型返回符合 Pydantic Schema 的数据对象
完整代码示例:
python
from typing import List,Optional
from pydantic import BaseModel,Field
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder
from langchain_core.messages import HumanMessage,SystemMessage
from langchain_core.utils.function_calling import tool_example_to_messages
from langchain_openai import ChatOpenAI

# 第一步:定义结构化返回对象
class Person(BaseModel):
    """一个人的信息"""
    name : Optional[str] = Field(default=None,description="这个人的名字")
    hair_color : Optional[str] = Field(default=None,description="如果知道这个人头发的颜色")
    skin_color : Optional[str] = Field(default=None,description="如果知道这个人的肤色")
    height_in_meters : Optional[str] = Field(default=None,description="以米为单位的高度")

class Data(BaseModel):
    """提取关于人的数据"""
    people : List[Person]

# 第二步:定义两组关键示例
examples = [
    (
        "海洋是广阔而蓝色的。它有两万多英尺深。",
        Data(people=[]) # 没有人物信息的情况
    ),
    (
        "小强从中国远行到美国。",
        Data(people=[
            Person(name="小强",height_in_meters=None,skin_color=None,hair_color=None),
        ])
    )
]

# 第三步:定义提示词模板
prompt_template = ChatPromptTemplate([
    SystemMessage(content="你是一个提取信息的专家,只从文本中提取相关信息。如果您不知道要提取的属性的值,属性值返回null"),
    MessagesPlaceholder("example_messages"),
    ("user","{new_message}"),
])

# 第四步:遍历示例,构造工具调用格式的消息列表
example_messages = []
for txt,expected_result in examples:
    # 根据提取结果生成AI响应文本
    if expected_result.people:
        ai_response = "检测到人"
    else:
        ai_response = "未检测到人"
    example_messages.extend(
        tool_example_to_messages(
            input=txt,
            tool_calls=[expected_result],
            ai_response=ai_response
        )
    )

# 预览:渲染模板,查看组装后的完整消息
formatted_prompt = prompt_template.invoke({
    "example_messages":example_messages,
    "new_message":"篮球场上,身高两米的中锋王伟默契地将球传给一米七的后卫挚友李明,完成一记绝杀。"
})
for message in formatted_prompt.to_messages():
message.pretty_print()预览输出(消息预览):
python
================================ System Message ================================
你是一个提取信息的专家,只从文本中提取相关信息。如果您不知道要提取的属性的值,属性值返回null

================================ Human Message =================================
海洋是广阔而蓝色的。它有两万多英尺深。

================================== Ai Message ==================================
Tool Calls:
  Data(f81f0c81-108d-4c06-88dc-9e5f5289749e)
 Call ID: f81f0c81-108d-4c06-88dc-9e5f5289749e
  Args:
    people: []

================================= Tool Message =================================
You have correctly called this tool.

================================== Ai Message ==================================
未检测到人

================================ Human Message =================================
小强从中国远行到美国。

================================== Ai Message ==================================
Tool Calls:
  Data(ace46c82-07e0-455c-aaef-c13da7328e45)
 Call ID: ace46c82-07e0-455c-aaef-c13da7328e45
  Args:
    people: [{'name': '小强', 'hair_color': None, 'skin_color': None, 'height_in_meters': None}]

================================= Tool Message =================================
You have correctly called this tool.

================================== Ai Message ==================================
检测到人

================================ Human Message =================================
篮球场上,身高两米的中锋王伟默契地将球传给一米七的后卫挚友李明,完成一记绝杀。
python
# 第五步:初始化模型,绑定结构化输出,构建LCEL链路调用
model = ChatOpenAI(model="gpt-4o-mini")
structured_model = model.with_structured_output(schema=Data)

chain = prompt_template | structured_model
result = chain.invoke({
    "example_messages": example_messages,
    "new_message": "篮球场上,身高两米的中锋王伟默契地将球传给一米七的后卫挚友李明,完成一记绝杀。"
})
print(result)模型最终输出结果:
python
people = [
    Person(name='王伟', hair_color=None, skin_color=None, height_in_meters='2.0'),
    Person(name='李明', hair_color=None, skin_color=None, height_in_meters='1.7')
]
📌 案例小结
本案例使用工具调用格式的少样本 ,区别于普通文本型少样本提示。通过
tool_example_to_messages把样例组装成工具调用交互消息,搭配with_structured_output,可以引导模型严格按照定义的 Schema,从原文提取人物信息,未知字段填充None,适合结构化信息抽取场景。
3.4 示例选择器(Example selectors)
3.4.1 概念
准备好示例数据集后,我们需要确定提示词里放入多少个少样本示例。这里存在权衡:增加示例一般能提升模型效果,但更长的提示会带来更高的调用成本与推理延迟;当示例数量超过阈值,过多的样例反而会混淆模型。
合适的示例数量,取决于模型能力、任务类型、样例质量,以及成本、延迟约束。通常能力越强的大模型,需要的示例数量越少。最稳妥的方式是,用不同数量的示例做对比实验,找到最优值。
当示例数据集规模很大时,不需要把全部样例一次性塞进提示词。我们需要一种机制:根据当前用户输入,动态挑选匹配的示例 。
在 LangChain 中,示例选择器(Example Selector) 就是用来解决这个问题的组件:按照指定策略,从全部示例集合里挑选出合适的示例子集,用来构建少样本提示。
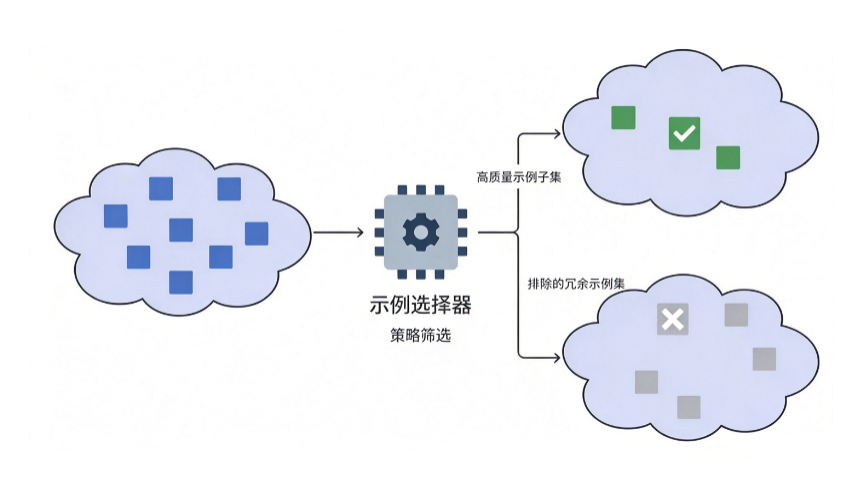
选择策略有:
Length:根据特定【长度】内可以容纳的数量选择示例。Similarity:使用输入和示例之间的【语义相似性】来决定选择哪些示例。MMR:使用输入和示例之间的【最大边际相关性】来决定要选择哪些示例。Ngram:使用输入和示例之间的【ngram 重叠】来决定要选择哪些示例。
3.4.2 基于长度的示例选择器
LengthBasedExampleSelector 是 LangChain 提供的按文本总长度筛选少样本示例的选择器。它会在拼接提示词时,自动挑选示例,保证最终提示词文本长度不超过上限,避免超出模型上下文窗口。
构造参数
example_prompt:提示模板,用来格式化每一条示例。examples:存放全部候选样例的列表。max_length:提示词允许的最大总长度,超过该值就会删减示例。get_text_length:自定义文本长度计算函数,默认按字符数量统计长度。
内置方法
add_example(example: dict[str, str]):向候选示例池新增一条样例,入参为字典,字典的键对应提示变量,值为变量内容。select_examples(input_variables: dict[str, str]) -> list[dict]:结合当前输入,从候选示例里选出合适的样例。- 输入:字典,键为输入变量,值为变量内容
- 返回:筛选后,放入提示词中的示例列表
基础调用示例:
python
from langchain_core.example_selectors import LengthBasedExampleSelector
from langchain_core.prompts import FewShotPromptTemplate,PromptTemplate

# 反义词示例集合
examples = [
    {"input": "happy","output": "sad"},
    {"input": "tall", "output": "shot"},
    {"input": "energetic", "output": "lethargic"},
    {"input": "sunny", "output": "gloomy"},
    {"input": "windy", "output": "calm"},
]

# 字符串模版
example_prompt= PromptTemplate(
    input_variables=["input","output"],
    template="Input: {input}\nOutput: {output}"
)

# 长度示例选择器
example_selector = LengthBasedExampleSelector(
    examples=examples,
    example_prompt=example_prompt,
    max_length=25,
)

# 用于实例化示例的模版
dynamic_prompt = FewShotPromptTemplate(
    # 提供一个示例选择器,动态选择示例
    example_selector=example_selector,
    example_prompt=example_prompt,
    prefix="给出每个输入的反义词",
    suffix="Input: {adjective}\nOutput:",
    input_variables=["adjective"]
)

print(dynamic_prompt.invoke({"adjective":"big"}).to_messages()[0].content)运行输出:
python
给出每个输入的反义词

Input: happy
Output: sad

Input: tall
Output: shot

Input: energetic
Output: lethargic

Input: sunny
Output: gloomy

Input: windy
Output: calm

Input: big
Output:
可以看到,示例选择器将所有的示例都选择了,因为还没有超过设置的示例最大值。接下来让我们将输入变长,验证长度示例选择器筛选示例。
python
long_str = "非常 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常大的事物"
print(dynamic_prompt.invoke({"adjective":long_str}).to_messages()[0].content)运行输出:
python
给出每个输入的反义词

Input: happy
Output: sad

Input: tall
Output: shot

Input: 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常 非常大的事物
Output:
3.4.3 基于语义相似性的示例选择器
SemanticSimilarityExampleSelector 是 LangChain 中基于文本语义相似度挑选少样本示例的选择器。它会将用户输入和全部候选示例转为向量,检索出语义最接近当前提问的样例,放到提示词中,让模型拿到和当前任务更相关的参考案例。
概念
什么是语义相似性?它是衡量两段文本含义层面的接近程度,不只看字面文字。
- 例 1:
text
text1 = "我喜欢猫"
text2 = "我讨厌狗"
两段文字用词差异大,但语义主题都是对动物的态度,语义相似度较高。
- 例 2:
text
text1 = "苹果很甜"
text2 = "苹果市值创新高"
两处 "苹果" 分别指代水果、公司,语义完全不同,因此两段文本语义不相似。
构造方式:from_examples () 类方法
用于根据示例集合快速生成语义相似示例选择器,参数如下:
examples:候选示例列表,存放所有可供挑选的样例。embeddings:嵌入模型实例,用于把文本转为向量,例如OpenAIEmbeddings()。vectorstore_cls:向量数据库接口类,用来存储所有示例的向量。k:最终要挑选的示例数量,默认值为 4。
返回值:语义相似示例选择器实例
内置方法
-
add_example(example: dict[str, str]):向候选示例池新增一条样例。- 输入:字典,字典的键对应提示变量,值为变量内容。
-
select_examples(input_variables: dict[str, str]) -> list[dict]:根据当前输入,检索语义最匹配的示例。- 输入:字典,键为输入变量,值为变量内容
- 返回:筛选后,放入提示词中的示例列表
基础调用示例:
python
from langchain_core.example_selectors import SemanticSimilarityExampleSelector
from langchain_core.prompts import FewShotPromptTemplate,PromptTemplate
from langchain_chroma import Chroma
from langchain_openai import OpenAIEmbeddings

# 反义词示例集合
examples = [
    {"input": "happy","output": "sad"},
    {"input": "tall", "output": "shot"},
    {"input": "energetic", "output": "lethargic"},
    {"input": "sunny", "output": "gloomy"},
    {"input": "windy", "output": "calm"},
]

# 字符串模版
example_prompt= PromptTemplate(
    input_variables=["input","output"],
    template="Input: {input}\nOutput: {output}"
)

# 语义相似性示例选择器
example_selector = SemanticSimilarityExampleSelector.from_examples(
    examples=examples,
    # 嵌入类用于生成用于度量语义相似度的嵌入
    embeddings=OpenAIEmbeddings(),
    # VectorStore类,用于存储嵌入并对其进行相似性搜索
    vectorstore_cls=Chroma,
    k=1,
)

# 用于实例化示例的模版
similar_prompt = FewShotPromptTemplate(
    # 提供一个示例选择器,动态选择示例
    example_selector=example_selector,
    example_prompt=example_prompt,
    prefix="给出每个输入的反义词",
    suffix="Input: {adjective}\nOutput:",
    input_variables=["adjective"]
)

print(similar_prompt.invoke({"adjective":"worried"}).to_messages()[0].content)运行输出:
python
给出每个输⼊的反义词

Input: happy
Output: sad

Input: worried
Output:
可以看到我们输入的内容和最后选择的示例都表示心情,在语义上最相似。
3.4.4 基于最大边际相关性 MMR 的示例选择器
MaxMarginalRelevanceExampleSelector 是 LangChain 中基于 最大边际相关性(MMR) 挑选少样本示例的选择器。它使用语义相似性作为基础工具,将用户输入和全部候选示例转为向量,使用 MMR 算法,挑选一组既贴合查询主题、样例之间又具备多样性的结果,放到提示词中。
概念
什么是最大边际相关性?它是一种重新排序算法,以语义相似性作为基础,从候选示例集中挑选一组既能代表查询主题,又彼此多样化的结果。
MMR 和单纯语义相似性很容易混淆,用例子区分两者:
- 语义相似性:就像面试官衡量每个应聘者与职位要求的匹配度,给每个应聘者单独打分,只看样例与查询的相似度。
- 最大边际相关性(MMR) :就像团队经理组建团队,目标选出一组优质样例,而不是单个最优结果:
- 每个成员都要满足基本职位要求(满足相关性)
- 不希望团队成员技能完全重复,需要不同专长的人(保证样例新颖性、多样性,减少冗余)
- 策略:先挑选最匹配的样例,后续挑选的样例,既要和查询相关,又要和已选中样例有差异。
📌 使用场景
- 推荐系统:推荐和用户兴趣相关但类型不同的物品,避免 "信息茧房"
- 文档摘要:从长文档挑选代表主旨、信息不重复的句子
- RAG 检索增强生成:检索到相关文档后,用 MMR 做去重与多样化筛选,减少幻觉,提升答案质量
构造方式:from_examples() 类方法
用于根据示例集合快速生成 MMR 示例选择器,参数如下:
examples:候选示例列表,存放所有可供挑选的样例。embeddings:嵌入模型实例,用于把文本转为向量,例如OpenAIEmbeddings()。vectorstore_cls:向量数据库接口类,用来存储所有示例的向量。k:最终要挑选的示例数量,默认值为 4。
返回值:MMR 示例选择器实例
内置方法
add_example(example: dict[str, str]):向候选示例池新增一条样例。- 输入:字典,字典的键对应提示变量,值为变量内容。
select_examples(input_variables: dict[str, str]) -> list[dict]:根据当前输入,使用 MMR 算法筛选示例。- 输入:字典,键为输入变量,值为变量内容。
- 返回:筛选后,放入提示词中的示例列表。
基础调用示例:
python
from langchain_core.example_selectors import MaxMarginalRelevanceExampleSelector
from langchain_core.prompts import FewShotPromptTemplate,PromptTemplate
from langchain_chroma import Chroma
from langchain_openai import OpenAIEmbeddings

# 反义词示例集合
examples = [
    {"input": "happy","output": "sad"},
    {"input": "tall", "output": "shot"},
    {"input": "energetic", "output": "lethargic"},
    {"input": "sunny", "output": "gloomy"},
    {"input": "windy", "output": "calm"},
]

# 字符串模版
example_prompt= PromptTemplate(
    input_variables=["input","output"],
    template="Input: {input}\nOutput: {output}"
)

# 语义相似性示例选择器
example_selector = MaxMarginalRelevanceExampleSelector.from_examples(
    examples=examples,
    embeddings=OpenAIEmbeddings(),
    vectorstore_cls=Chroma,
    k=2,
)

# 用于实例化示例的模版
similar_prompt = FewShotPromptTemplate(
    # 提供一个示例选择器,动态选择示例
    example_selector=example_selector,
    example_prompt=example_prompt,
    prefix="给出每个输入的反义词",
    suffix="Input: {adjective}\nOutput:",
    input_variables=["adjective"]
)

print(similar_prompt.invoke({"adjective":"worried"}).to_messages()[0].content)运行输出:
python
给出每个输⼊的反义词

Input: happy
Output: sad

Input: windy
Output: calm

Input: worried
Output:
3.4.5 基于 Ngram 重叠的示例选择器
NGramOverlapExampleSelector 是 LangChain 中基于 Ngram 重叠度 挑选少样本示例的选择器。它通过计算输入文本与候选示例之间的 ngram 重叠分数,优先选取文本片段重合度高的样例放入提示词。
概念
什么是【ngram】?ngram 指一个文本序列中连续的 n 个词(word)或字符(character)。
什么是【ngram 重叠】?通过计算两段文本之间共同拥有的 ngram 数量,用来衡量文本相似度的方法。
例如下述两段文本:
text
text1 = "苹果手机很好用" (分词后:苹果 手机 很 好用)
text2 = "这款手机很好用" (分词后:这款 手机 很 好用)
这两段文本单词重复度很高,连续三个词相同,因此 ngram 重叠高。
再看一组例子:
text
text1 = "苹果手机很好用" (分词后:苹果 手机 很 好用)
text2 = "iPhone非常不错" (分词后:iPhone 非常 不错)
两段文本含义上非常相似,但字面词汇完全不一样,它们的 ngram 重叠度为 0。
📌 因此,传统 ngram 重叠属于表面形式匹配,只看文字是否完全一致,无法识别同义词、同义改写。
什么是【语义 ngram 重叠】?不再比较词本身,而是比较词背后的语义向量(Embedding)。不再看 "苹果" 和 "iPhone" 字面是否相同,而是计算它们在语义空间向量相似度,相似度超过阈值就判定为 "重叠"。
使用场景:
- 多用于需要精准语义评估的场景,例如剽窃检测,可以识别替换词汇,但保留核心思想的 "智能剽窃"。
构造参数
example_prompt:PromptTemplate,用于格式化示例的提示模板。examples:模板所需的示例列表。threshold:算法筛选停止阈值。默认设置为 -1.0。- 负阈值:按重叠分数对示例排序,但不会排除任何示例。
- 阈值等于 0.0:按重叠分数排序,剔除与输入没有 ngram 重叠的示例。
- 阈值大于 1.0:排除全部示例,返回空列表。
内置方法
add_example(example: dict[str, str]):向候选示例池新增一条样例。- 输入:字典,字典的键对应提示变量,值为变量内容。
select_examples(input_variables: dict[str, str]) -> list[dict]:根据输入文本,按 ngram 重叠分数降序筛选示例。- 输入:字典,键为输入变量,值为变量内容。
- 返回:筛选后,放入提示词中的示例列表。
基础调用示例:
python
from langchain_community.example_selectors import NGramOverlapExampleSelector
from langchain_core.prompts import FewShotPromptTemplate,PromptTemplate

# 翻译示例
examples = [
    {"input": "See Spot run.","output": "看见Spot跑。"},
    {"input": "My dog barks.","output": "我的狗叫。"},
    {"input": "Spot can run.","output": "Spot可以跑"}
]

# 字符串模版
example_prompt = PromptTemplate(
    input_variables=["input","output"],
    template="Input: {input}\nOutput: {output}"
)

# NGram 示例选择器
example_selector = NGramOverlapExampleSelector(
    examples=examples,
    example_prompt=example_prompt,
    threshold=-1.0
)

# 用于实例化示例的模版
dynamic_prompt = FewShotPromptTemplate(
    example_selector=example_selector,
    example_prompt=example_prompt,
    prefix="给出每个输入的中文翻译",
    suffix="Input: {sentence}\nOutput:",
    input_variables=["sentence"]
)

# 按照重叠分数排序
print(dynamic_prompt.invoke({"sentence":"Spot can run fast."}).to_messages()[0].content)运行输出:
python
给出每个输入的中文翻译

Input: Spot can run.
Output: Spot可以跑

Input: See Spot run.
Output: 看见Spot跑。

Input: My dog barks.
Output: 我的狗叫。

Input: Spot can run fast.
Output:
可以看到结果集是按照 ngram 重叠分数进行了排序。可以分别设置 threshold=0.0 和 threshold=1.0进行测试,输出结果如下:
python
threshold=0.0(表示排除不相关的示例)
给出每个输入的中文翻译

Input: Spot can run.
Output: Spot可以跑。

Input: See Spot run.
Output:看见Spot跑。

Input: Spot can run fast.
Output:

threshold=1.0(排除所有示例)
给出每个输入的中文翻译

Input: Spot can run fast.
Output:
四、输出解析器(Ouput parsers)
4.1 概念
输出解析器 是 LangChain 里用于接收大模型输出、并把输出转为目标结构化格式的组件。在需要让 LLM 输出规范数据、对聊天模型返回结果做标准化处理的场景中,输出解析器是核心工具。
大语言模型(LLM)原生输出是自由、无固定格式的非结构化文本。但开发 LLM 应用时,下游代码往往无法直接读取自由文本,我们期望模型返回机器可识别的结构化数据,常见目标格式包括:
- JSON 对象
- Python 字典、列表
- 自定义 Pydantic 模型实例
- 布尔值、字符串枚举等简单类型
输出解析器就承担了转换桥梁的工作:将 LLM 返回的自然语言文本,解析、转换成程序可直接使用的结构化对象。借助输出解析器,我们和大模型的交互,从模糊的自然语言对话,转变为类似接口调用的、返回确定数据的模式,是搭建稳定、可自动化的 LLM 应用必不可少的组件。
与 with_structured_output 的区别
二者都可以实现获取结构化模型输出的能力,但本质定位、使用方式存在明显差异:
- 定位维度不同 :输出解析器是 LangChain 独立的功能性组件;
with_structured_output是聊天模型对象提供的实例方法。 - 使用方式不同 :输出解析器可直接融入 LCEL 管道,把提示模板、大模型、解析器串联成链式执行链路;
with_structured_output调用后会返回一个新增结构化输出能力的全新Runnable对象,以模型包装器的形式使用。
4.2 解析文本输出
其实对于使用 StrOutputParser 输出解析器输出文本,我们已经使用过很多次了。对于 StrOutputParser,它也实现了标准的 Runnable 接口。
python
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import StrOutputParser

model= ChatOpenAI(model="gpt-4o-mini")
chain = model | StrOutputParser()

for chunk in chain.stream("写一首夏天的歌词,50字以内。"):
print(chunk,end="|")运行输出:
python
|炎|夏|骄|阳|照|,|绿|树|映|蓝|天|。|
|蝉|鸣|声|声|烈|,|荷|塘|映|清|鲜|。|
|微|风|拂|面|过|,|凉|意|透|心|间|。|
|烦|忧|随|汗|去|,|畅|享|此|夏|欢|。||
若是不使用输出解析器,而是直接得到聊天模型返回的 AIMessage,文本内容则需要从消息中 content 字段获取。
4.3 解析结构化对象输出
PydanticOutputParser 是用于解析模型输出、生成 Pydantic 结构化对象的输出解析器。
构造参数
pydantic_object:要解析对应的 Pydantic 模型。
内置方法
invoke():将单个输入文本转换为 Pydantic 对象输出。get_format_instructions() -> str:- 作用:生成格式指令字符串,追加到送入 LLM 的 Prompt 末尾。
- 目的:向 LLM 说明输出需要遵守的格式,例如,"请将你的回复封装在XML标签中" 或 "请以JSON格式输出,包含 'name' 和 'age' 两个字段"。
📌 小说明:
get_format_instructions是 PydanticOutputParser 最关键的方法,它会自动根据你定义的 Pydantic 模型,生成对应的格式提示,不用手写 JSON 格式要求。
基础调用示例:
python
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import PydanticOutputParser
from langchain_core.prompts import PromptTemplate
from typing import Optional
from pydantic import BaseModel, Field

# 定义大模型
model = ChatOpenAI(model="gpt-4o-mini")

# 定义输出结构:Pydantic 类
class Joke(BaseModel):
    """给用户讲一个笑话。"""

    setup: str = Field(description="这个笑话的开头")
    punchline: str = Field(description="这个笑话的妙语")
    rating: Optional[int] = Field(default=None,description="从1到10分,给这个笑话评分")

# 设置解析器
parser = PydanticOutputParser(pydantic_object=Joke)

# 提示词模版
prompt = PromptTemplate(
    template="Answer the user query.\n{format_instructions}\n{query}\n",
    input_variables=["query"],
    # partial_variables:预设的固定变量字典。
    # 这类变量在模板创建阶段就提前赋值,后续调用模板时,不需要重复传入。
    # 类型:Mapping[str, Any],用于存放模板中预先固定的变量键值对。
    partial_variables={"format_instructions":parser.get_format_instructions()}
)

chain = prompt | model | parser
for chunk in chain.stream({"query": "给我讲一个关于唱歌的笑话"}):
print(chunk,end="|")运行输出:
python
setup='为什么歌手总是带着铅笔去演出?' punchline='' rating=None|
setup='为什么歌手总是带着铅笔去演出?' punchline='因为' rating=None|
setup='为什么歌手总是带着铅笔去演出?' punchline='因为他们' rating=None|
setup='为什么歌手总是带着铅笔去演出?' punchline='因为他们想' rating=None|
setup='为什么歌手总是带着铅笔去演出?' punchline='因为他们想要' rating=None|
setup='为什么歌手总是带着铅笔去演出?' punchline='因为他们想要不断' rating=None|
setup='为什么歌手总是带着铅笔去演出?' punchline='因为他们想要不断调整' rating=None
setup='为什么歌手总是带着铅笔去演出?' punchline='因为他们想要不断调整音' rating=None|
setup='为什么歌手总是带着铅笔去演出?' punchline='因为他们想要不断调整音调' rating=None|
setup='为什么歌手总是带着铅笔去演出?' punchline='因为他们想要不断调整音调!' rating=None|
4.4 解析 Json 输出
JsonOutputParser 专门用于解析大模型输出,将符合规范的 JSON 文本转为 Python 字典。
构造参数
pydantic_object:可选,用于校验 JSON 数据的 Pydantic 模型。为空时,仅校验 JSON 语法合法,不校验字段结构。
内置方法
invoke():将模型返回的文本,解析转换为 Python 字典。get_format_instructions() -> str:- 作用:生成格式指令字符串,追加到送入 LLM 的 Prompt 末尾。
- 目的:向 LLM 说明输出需要遵守的格式,例如,"请将你的回复封装在XML标签中" 或 "请以JSON格式输出,包含 'name' 和 'age' 两个字段"。
基础调用示例:
python
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import JsonOutputParser
from langchain_core.prompts import PromptTemplate

# 定义大模型
model = ChatOpenAI(model="gpt-4o-mini")

# 设置解析器
parser = JsonOutputParser()

# 提示词模版
prompt = PromptTemplate(
    template="Answer the user query.\n{format_instructions}\n{query}\n",
    input_variables=["query"],
    partial_variables={"format_instructions":parser.get_format_instructions()}
)

chain = prompt | model | parser
for chunk in chain.stream({"query": "给我讲一个关于唱歌的笑话"}):
print(chunk,end="|")运行输出:
python
{'joke': '为什么歌⼿总是带着梯⼦?\n因为他们想要在⾳乐会上达到更⾼的层次!'} 也可以使用带 Pydantic 情况下的 JsonOutputParser:
python
from langchain_openai import ChatOpenAI
from langchain_core.output_parsers import JsonOutputParser
from langchain_core.prompts import PromptTemplate
from typing import Optional
from pydantic import BaseModel, Field

# 定义大模型
model = ChatOpenAI(model="gpt-4o-mini")

# 定义输出结构:Pydantic 类
class Joke(BaseModel):
    """给用户讲一个笑话。"""

    setup: str = Field(description="这个笑话的开头")
    punchline: str = Field(description="这个笑话的妙语")
    rating: Optional[int] = Field(default=None,description="从1到10分,给这个笑话评分")

# 设置解析器
parser = JsonOutputParser(pydantic_object=Joke)

# 提示词模版
prompt = PromptTemplate(
    template="Answer the user query.\n{format_instructions}\n{query}\n",
    input_variables=["query"],
    partial_variables={"format_instructions":parser.get_format_instructions()}
)

chain = prompt | model | parser
for chunk in chain.stream({"query": "给我讲一个关于唱歌的笑话"}):
print(chunk,end="|")运行输出:
python
{'setup': '为什么歌⼿从不在森林⾥唱歌?', 'punchline': '因为他们会被树⽊的'静'⽌住!', 'rating': None}4.5 其他内置输出解析器概览
除前文介绍的文本、结构化对象、JSON 解析器外,LangChain 官方还提供了更多专用内置输出解析器:
- XML 解析器:
XMLOutputParser - Yaml 解析器:
YamlOutputParser - CSV 解析器:
CommaSeparatedListOutputParser - 枚举解析器:
EnumOutputParser - 日期解析器:
DatetimeOutputParser
LangChain 同时支持自定义输出解析器,我们可以根据业务需求,将模型输出解析为自定义格式。