一、卷积神经网络概念
卷积
卷积是一种数学运算,在深度学习(尤其是计算机视觉)中,特指二维互相关运算 (通常简称为卷积)。其基本操作是:用一个小的卷积核(filter/kernel) 在输入图像上滑动,对每个位置上的重叠区域做逐元素相乘再求和 ,得到输出特征图中的一个值。
可以把卷积核想象成一个"模式探测器"或"特征筛选器"。当卷积核滑动到某个位置时,它与图像局部区域的相似度越高,输出值就越大。例如,一个检测垂直边缘的卷积核,会在图像的垂直边缘处产生较大的响应。
数学表达式(二维离散卷积):
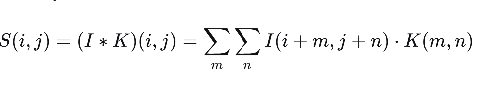
其中 I是输入图像,K是卷积核。实际在 CNN 中,通常做的是互相关(不翻转核),但本质思想一致。
为什么要用卷积?
在传统的全连接神经网络中,处理图像时会将每个像素作为独立特征输入,导致参数爆炸且无法利用图像的局部结构。卷积的引入主要解决了以下几个关键问题:
- 局部连接(Local Connectivity)
图像中,近处的像素之间关联性强,远处的像素关联性弱。卷积核只关注局部区域(例如 3×3 或 5×5),这与人类视觉系统由局部到整体的认知方式一致。
➜ 好处:显著减少连接数量,避免对远距离无关像素的冗余建模。
- 参数共享(Weight Sharing)
同一个卷积核在图像的所有位置使用相同的权重。这意味着一个边缘检测器可以同时检测图像中任何位置的边缘。
➜ 好处:参数量不随图像尺寸增大而线性增长。例如,一张 1000×1000 的图像,用全连接层需要百万级参数,而一个 3×3 卷积核仅需 9 个参数(不考虑偏置和通道数)。
- 平移不变性(Translation Invariance)
由于参数共享,卷积对图像中的模式具有位置无关性------无论猫的耳朵出现在左上角还是右下角,同一个卷积核都能识别出来。这大大增强了模型的泛化能力。
- 捕获层次化特征(Hierarchical Features)
浅层卷积核学习低级特征(边缘、颜色、纹理),深层卷积核将低级特征组合成复杂的高级语义(眼睛、鼻子、物体类别)。这种层次结构是深度卷积神经网络成功的关键。
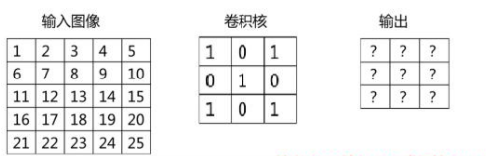
卷积------多通道
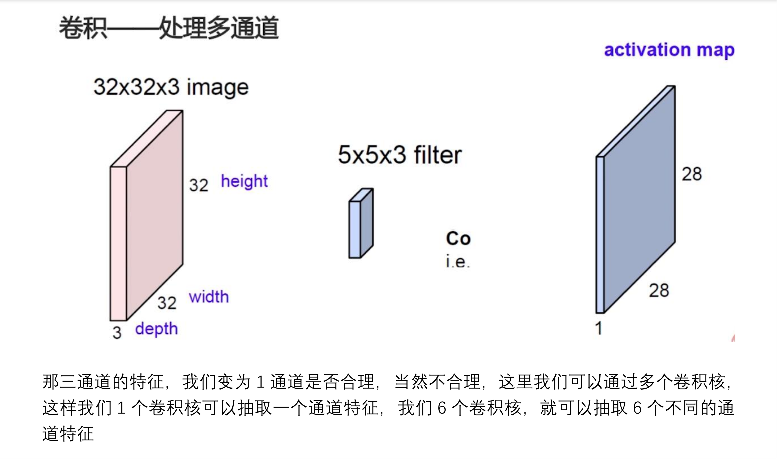
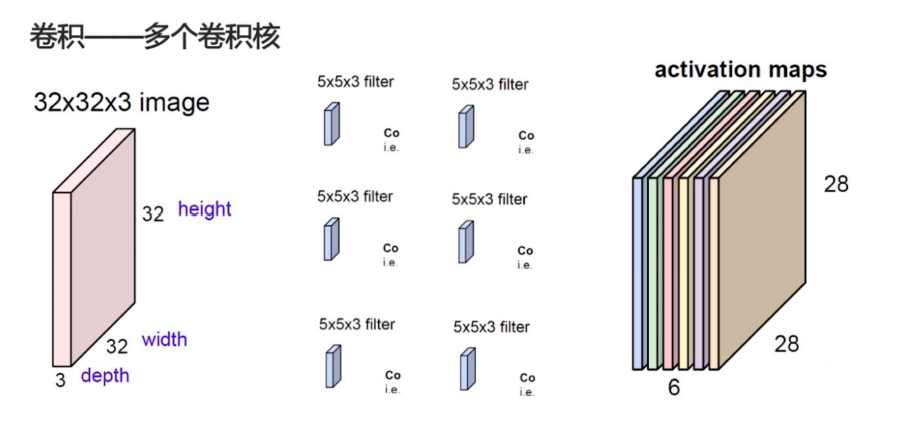
用不同的卷积核提取不同的特征这样的效果更好
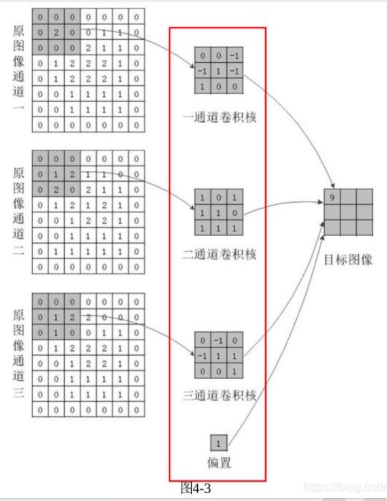
每一个卷积核都有一个偏执
池化(Pooling)
池化是一种下采样操作,通常紧跟在卷积层之后。它对特征图的每个小区域(如 2×2)进行聚合统计,常见的有:
-
最大池化(Max Pooling) :取区域内的最大值
MaxPool2d(kernel_size=2, stride=2) -
平均池化(Average Pooling):取区域内的平均值
-
全局平均池化(Global Average Pooling):对整张特征图取平均,常用于分类器前
池化没有需要学习的参数,只是固定计算。
池化的核心作用
-
降低空间尺寸
例如 2×2 池化将特征图的高和宽减半,从而大幅减少后续层的计算量和参数量。
-
增强平移不变性
即使目标在图像中轻微移动,池化后的最大值或平均值可能保持不变,使模型对微小位移更加鲁棒。
-
增大感受野
池化后每个输出点对应于输入中一个更大的区域,有助于捕获更宏观的特征。
-
抑制噪声
最大池化保留最强响应,剔除弱噪声;平均池化则平滑局部变化。
卷积与池化的典型配合使用方式
在经典 CNN 架构(如 LeNet、AlexNet、VGG)中,通常的范式是:
输入 → [卷积层 + 激活函数] → 池化层 → [卷积层 + 激活函数] → 池化层 → ... → 全连接层具体设计规律
| 阶段 | 层组合 | 作用 |
|---|---|---|
| 特征提取阶段 | 卷积 → 激活 (ReLU) → 池化 | 逐级提取局部到全局特征,同时逐步降维 |
| 分类阶段 | 全局平均池化 或 展平 + 全连接层 | 将空间特征聚合为类别分数 |
几个关键点
-
池化通常不跨通道:每个通道独立做池化,通道数不变。
-
池化 stride 一般等于 kernel_size:例如 2×2 池化步长=2,避免重叠。
-
现代趋势:一些网络(如 ResNet、DenseNet)使用步长为 2 的卷积替代池化来降采样,既能降维又可学习下采样模式。但池化依然因为简单有效而广泛使用。
实战1卷积神经网络
1.数据准备
python
import matplotlib as mpl
import matplotlib.pyplot as plt
%matplotlib inline
import numpy as np
import sklearn
import pandas as pd
import os
import sys
import time
from tqdm.auto import tqdm
import torch
import torch.nn as nn
import torch.nn.functional as F

print(sys.version_info)
for module in mpl, np, pd, sklearn, torch:
    print(module.__name__, module.__version__)

device = torch.device("cuda:0") if torch.cuda.is_available() else torch.device("cpu")
print(device)

seed = 42

#%% md
## 数据准备
#%%
from torchvision import datasets
from torchvision.transforms import ToTensor
from torch.utils.data import random_split

# fashion_mnist图像分类数据集
train_ds = datasets.FashionMNIST(
    root="data",
    train=True,
    download=True,
    transform=ToTensor()
)

test_ds = datasets.FashionMNIST(
    root="data",
    train=False,
    download=True,
    transform=ToTensor()
)

# torchvision 数据集里没有提供训练集和验证集的划分
# 这里用 random_split 按照 11 : 1 的比例来划分数据集
train_ds, val_ds = random_split(train_ds, [55000, 5000], torch.Generator().manual_seed(seed))

from torchvision.transforms import Normalize

# 遍历train_ds得到每张图片,计算每个通道的均值和方差
def cal_mean_std(ds):
    mean = 0.
    std = 0.
    for img, _ in ds:
        mean += img.mean(dim=(1, 2))
        std += img.std(dim=(1, 2))
    mean /= len(ds)
    std /= len(ds)
    return mean, std


# print(cal_mean_std(train_ds))
# 0.2860, 0.3205
transforms = nn.Sequential(
    Normalize([0.2856], [0.3202])
) # 对每个通道进行标准化


from torch.utils.data.dataloader import DataLoader

batch_size = 32
# 从数据集到dataloader
train_loader = DataLoader(train_ds, batch_size=batch_size, shuffle=True, num_workers=4)
val_loader = DataLoader(val_ds, batch_size=batch_size, shuffle=False, num_workers=4)
test_loader = DataLoader(test_ds, batch_size=batch_size, shuffle=False, num_workers=4)
2.模型构建
python
class CNN(nn.Module):
    def __init__(self, activation="relu"):
        super(CNN, self).__init__()
        self.activation = F.relu if activation == "relu" else F.selu
        #输入通道数,图片是灰度图,所以是1,图片是彩色图,就是3,输出通道数,就是卷积核的个数(32,1,28,28)
        self.conv1 = nn.Conv2d(in_channels=1, out_channels=32, kernel_size=3, padding=1)
        #输入x(32,32,28,28) 输出x(32,32,28,28)
        self.conv2 = nn.Conv2d(in_channels=32, out_channels=32, kernel_size=3, padding=1)
        self.pool = nn.MaxPool2d(2, 2) #池化核大小为2(2*2),步长为2
        self.conv3 = nn.Conv2d(in_channels=32, out_channels=64, kernel_size=3, padding=1)
        self.conv4 = nn.Conv2d(in_channels=64, out_channels=64, kernel_size=3, padding=1)
        self.conv5 = nn.Conv2d(in_channels=64, out_channels=128, kernel_size=3, padding=1)
        self.conv6 = nn.Conv2d(in_channels=128, out_channels=128, kernel_size=3, padding=1)
        self.flatten = nn.Flatten()
        # input shape is (28, 28, 1) so the fc1 layer in_features is 128 * 3 * 3
        self.fc1 = nn.Linear(128 * 3 * 3, 128)
        self.fc2 = nn.Linear(128, 10) #输出尺寸(32,10)

        self.init_weights()

    def init_weights(self):
        """使用 xavier 均匀分布来初始化全连接层、卷积层的权重 W"""
        for m in self.modules():
            if isinstance(m, (nn.Linear, nn.Conv2d)):
                nn.init.xavier_uniform_(m.weight)
                nn.init.zeros_(m.bias)

    def forward(self, x):
        act = self.activation
        x = self.pool(act(self.conv2(act(self.conv1(x))))) # 1 * 28 * 28 -> 32 * 14 * 14
        print(x.shape)
        x = self.pool(act(self.conv4(act(self.conv3(x))))) # 32 * 14 * 14 -> 64 * 7 * 7
        print(x.shape)
        x = self.pool(act(self.conv6(act(self.conv5(x))))) # 64 * 7 * 7 -> 128 * 3 * 3
        print(x.shape)
        x = self.flatten(x) # 128 * 3 * 3 ->1152
        x = act(self.fc1(x)) # 1152 -> 128
        x = self.fc2(x) # 128 -> 10
        return x


for idx, (key, value) in enumerate(CNN().named_parameters()):
    print(f"{key}\tparamerters num: {np.prod(value.shape)}") # 打印模型的参数信息
pythonsuper(CNN, self).__init__()继承
nn.Module,确保模型能正常注册参数。
pythonself.activation = F.relu if activation == "relu" else F.selu
提供两种非线性激活函数:ReLU(默认)或 SELU。
注意
F.selu是 Scaled Expontial Linear Unitne,自带自归一化性质,与AlphaDropout搭配效果更好。在
self.activation = F.relu中,我们把函数对象赋值给self.activation,这样在forward中可以通过self.activation(x)来调用。如果写成
F.selu(),那就变成了立即调用该函数,返回的是调用结果(通常是一个张量),而不是函数对象,后续无法再作为激活函数使用。
F.reluvsnn.ReLU的区别
特性 torch.nn.ReLUtorch.nn.functional.relu类型 模块(类) 函数 使用方式 实例化后调用: self.relu = nn.ReLU()然后x = self.relu(x)直接调用: x = F.relu(x)是否需要存储状态 是(无参数但需要占位) 否 在 nn.Sequential中可以直接添加 需要包装成 lambda 或使用 torch.nn.F不便适用场景 需要作为网络层,便于 nn.Sequential和nn.ModuleList管理简单的函数调用,更轻量 卷积层
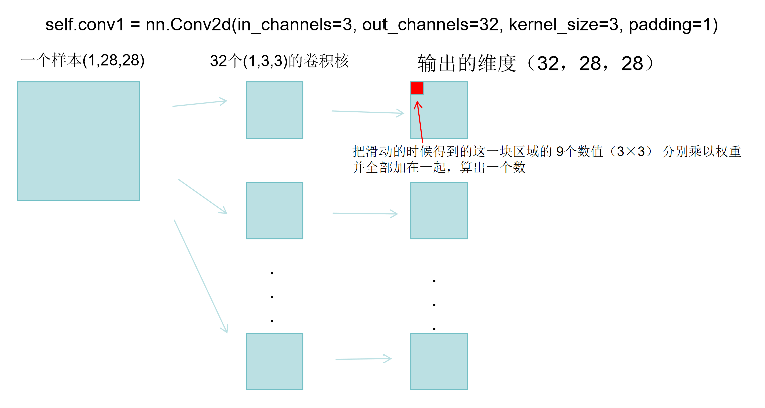
pythonself.conv1 = nn.Conv2d(in_channels=1, out_channels=32, kernel_size=3, padding=1) #输入x(32,32,28,28) 输出x(32,32,28,28)
in_channels=1,输入的通道数为1
out_channels=32,卷积核的个数,同时也是输出的通道数为32
kernel_size=3,卷积核大小为3
padding=1 在输入特征的四周补一圈0
这一层参数的个数:32(卷积核的个数)*3*3(卷积核的大小)
卷积核张量形状:
(32, 1, 3, 3)32个卷积核,每个核的深度是1(因为输入只有1个通道)
得到1个(32,28,28)。
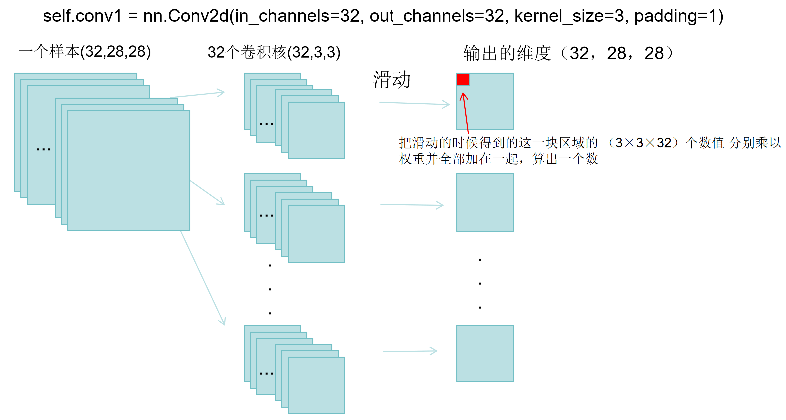
2. 第二个卷积层(
in=32, out=32)self.conv2 = nn.Conv2d(in_channels=32, out_channels=32, kernel_size=3, padding=1)
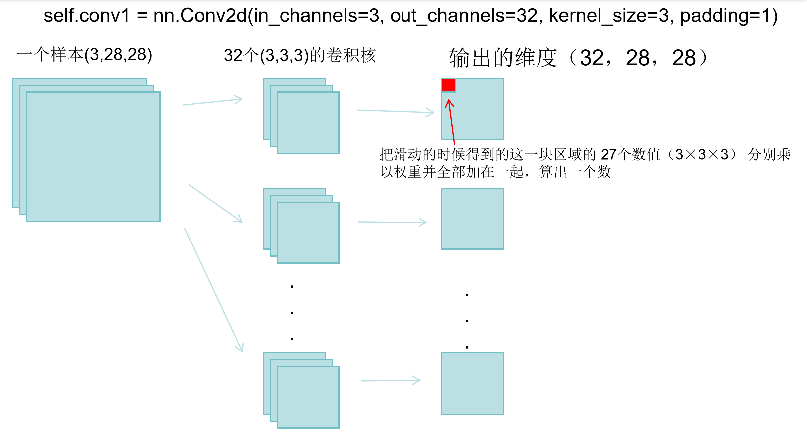
如果输入是RGB彩色图(
in_channels=3),而你希望输出32个通道:
pythonself.conv1 = nn.Conv2d(in_channels=3, out_channels=32, kernel_size=3, padding=1)
卷积核张量形状:
(32, 3, 3, 3)32个卷积核,每个卷积核都是3通道的(分别处理R、G、B三个通道),然后将结果相加得到该输出通道的一个值。
pythondef __init__(self, activation="relu"): super(CNN, self).__init__() self.activation = F.relu if activation == "relu" else F.selu #输入通道数,图片是灰度图,所以是1,图片是彩色图,就是3,输出通道数,就是卷积核的个数(32,1,28,28) self.conv1 = nn.Conv2d(in_channels=1, out_channels=32, kernel_size=3, padding=1) #输入x(32,32,28,28) 输出x(32,32,28,28) self.conv2 = nn.Conv2d(in_channels=32, out_channels=32, kernel_size=3, padding=1) self.pool = nn.MaxPool2d(2, 2) #池化核大小为2(2*2),步长为2 self.conv3 = nn.Conv2d(in_channels= 32, out_channels=64, kernel_size=3, padding=1) self.conv4 = nn.Conv2d(in_channels=64, out_channels=64, kernel_size=3, padding=1) self.conv5 = nn.Conv2d(in_channels=64, out_channels=128, kernel_size=3, padding=1) self.conv6 = nn.Conv2d(in_channels=128, out_channels=128, kernel_size=3, padding=1) self.flatten = nn.Flatten() # input shape is (28, 28, 1) so the fc1 layer in_features is 128 * 3 * 3 self.fc1 = nn.Linear(128 * 3 * 3, 128) self.fc2 = nn.Linear(128, 10) #输出尺寸(32,10) self.init_weights()
- 所有卷积层都使用
kernel_size=3, padding=1,这样卷积前后尺寸不变(输入 H,W 输出 H,W)。
- 通道数逐步增加:1 → 32 → 32 → 64 → 64 → 128 → 128,符合"浅层少通道、深层多通道"的设计模式。
池化层
pythonself.pool = nn.MaxPool2d(2, 2) #池化核大小为2(2*2),步长为2
最大池化,核大小 2×2,步长 2。
将特征图的高和宽减半(例如 28→14, 14→7, 7→3(向下取整))。
展平层和全连接层
pythonself.flatten = nn.Flatten() self.fc1 = nn.Linear(128 * 3 * 3, 128) # 输入 1152,输出 128 self.fc2 = nn.Linear(128, 10) # 输出10个类别初始化方法
pythondef init_weights(self): for m in self.modules(): if isinstance(m, (nn.Linear, nn.Conv2d)): nn.init.xavier_uniform_(m.weight) nn.init.zeros_(m.bias)
遍历模型所有模块,对
Linear和Conv2d层:
使用 Xavier 均匀分布 初始化权重(
xavier_uniform_)。偏置初始化为 0。
注意:Xavier 初始化更适合饱和激活函数(如 tanh),这里使用了 ReLU/SELU,严格来说 He 初始化可能更优,但这属于实验调优范畴。
3. 前向传播方法
forward(self, x)
pythondef forward(self, x): act = self.activation x = self.pool(act(self.conv2(act(self.conv1(x))))) # 1×28×28 → 32×14×14 x = self.pool(act(self.conv4(act(self.conv3(x))))) # 32×14×14 → 64×7×7 x = self.pool(act(self.conv6(act(self.conv5(x))))) # 64×7×7 → 128×3×3 x = self.flatten(x) # 128×3×3 → 1152 x = act(self.fc1(x)) # 1152 → 128 x = self.fc2(x) # 128 → 10 return x形状变化详解(以单样本为例,忽略 batch 维度)
实际输入: (batch, 1, 28, 28)
实际输出: (batch, 32, 28, 28)因为我们关注的是一个样本的形状的变化,batch指的是样本个数
操作 输入形状 输出形状 备注 输入 (1, 28, 28) 灰度图 conv1(1,28,28) (32,28,28) padding=1 保持尺寸 act(ReLU)(32,28,28) (32,28,28) 非线性 conv2(32,28,28) (32,28,28) 保持尺寸 act(32,28,28) (32,28,28) pool(2,2)(32,28,28) (32,14,14) 尺寸减半 conv3(32,14,14) (64,14,14) 通道数增加 act(64,14,14) (64,14,14) conv4(64,14,14) (64,14,14) act(64,14,14) (64,14,14) pool(64,14,14) (64,7,7) 尺寸减半 conv5(64,7,7) (128,7,7) act(128,7,7) (128,7,7) conv6(128,7,7) (128,7,7) act(128,7,7) (128,7,7) pool(128,7,7) (128,3,3) 7/2=3.5 向下取整 → 3 flatten(128,3,3) (1152,) fc1+ act(1152,) (128,) fc2(128,) (10,)
特别注意:第三次池化后尺寸从 7×7 变为 3×3,是因为
MaxPool2d(2,2)对奇数尺寸的向下取整效果:(7 - 2)/2 + 1 = 3.5 → 3。因此展平长度 = 128 × 3 × 3 = 1152,与
fc1的定义一致。PyTorch 的
nn.Flatten()默认从第1维 (通道维)开始展平,而第0维(batch 维)保持不变。
二、深度可分离卷积
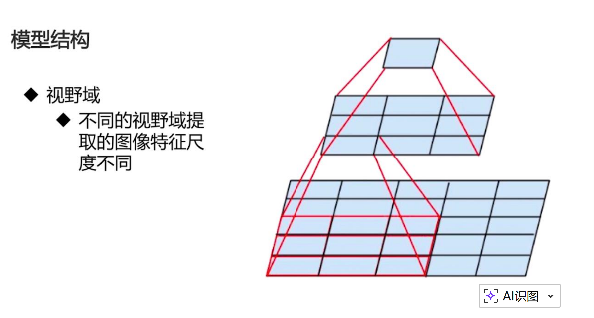
第一层:5*5(被3*3的卷积核提取之后变成第二层)
第二层:3*3(被3*3的卷积核提取之后变成第一层)
第三层(最上面):1*1
什么是深度可分离卷积?
深度可分离卷积(Depthwise Separable Convolution)是一种分解式的卷积操作,它将标准卷积拆分为两个独立的步骤:
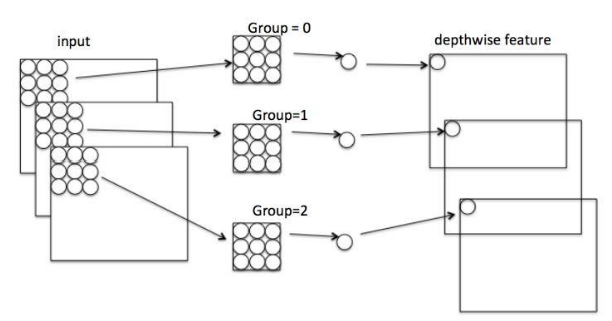
- 深度卷积 (Depthwise Convolution)------ 每个输入通道 单独做空间卷积
每个通道单独用一个卷积核,卷积之后不改变通道数
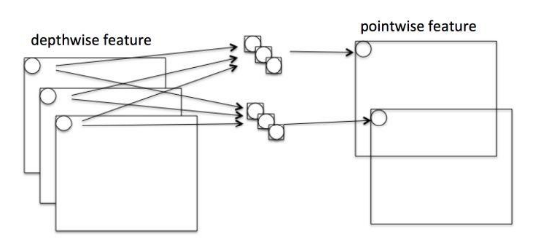
- 逐点卷积(Pointwise Convolution)------ 用 1×1 卷积混合通道
有多个卷积核,但每个通道共用一个卷积核,卷积之后改变通道数
这种分解可以在保持相近精度的前提下,大幅减少模型的参数量 和计算量,是轻量级神经网络(如 MobileNet、Xception)的基石。
为什么要用深度可分离卷积?
标准卷积在提取特征时,既做空间聚合 (通过 3×3、5×5 等卷积核)又做通道融合 (不同通道的输出相加)。这两件事其实可以解耦。深度可分离卷积的核心思想就是:先单独处理每个空间位置(深度卷积),再通过 1×1 卷积融合通道信息。
这样做的好处:
-
参数量减少约 8~9 倍(对于 3×3 卷积)
-
计算量同样大幅下降
-
适合移动端、嵌入式等资源受限场景
实战2深度可分离卷积
1.数据准备
python
import matplotlib as mpl
import matplotlib.pyplot as plt
%matplotlib inline
import numpy as np
import sklearn
import pandas as pd
import os
import sys
import time
from tqdm.auto import tqdm
import torch
import torch.nn as nn
import torch.nn.functional as F

print(sys.version_info)
for module in mpl, np, pd, sklearn, torch:
    print(module.__name__, module.__version__)

device = torch.device("cuda:0") if torch.cuda.is_available() else torch.device("cpu")
print(device)

seed = 42

## 数据准备
from torchvision import datasets
from torchvision.transforms import ToTensor
from torch.utils.data import random_split

# fashion_mnist图像分类数据集
train_ds = datasets.FashionMNIST(
    root="data",
    train=True,
    download=True,
    transform=ToTensor()
)

test_ds = datasets.FashionMNIST(
    root="data",
    train=False,
    download=True,
    transform=ToTensor()
)

# torchvision 数据集里没有提供训练集和验证集的划分
# 这里用 random_split 按照 11 : 1 的比例来划分数据集
train_ds, val_ds = random_split(train_ds, [55000, 5000], torch.Generator().manual_seed(seed))
from torchvision.transforms import Normalize

# 遍历train_ds得到每张图片,计算每个通道的均值和方差
def cal_mean_std(ds):
    mean = 0.
    std = 0.
    for img, _ in ds:
        mean += img.mean(dim=(1, 2))
        std += img.std(dim=(1, 2))
    mean /= len(ds)
    std /= len(ds)
    return mean, std


# print(cal_mean_std(train_ds))
# 0.2860, 0.3205
transforms = nn.Sequential(
    Normalize([0.2856], [0.3202])
)
from torch.utils.data.dataloader import DataLoader

batch_size = 32
# 从数据集到dataloader
train_loader = DataLoader(train_ds, batch_size=batch_size, shuffle=True, num_workers=4)
val_loader = DataLoader(val_ds, batch_size=batch_size, shuffle=False, num_workers=4)
test_loader = DataLoader(test_ds, batch_size=batch_size, shuffle=False, num_workers=4)
2.模型构建
python
# 定义深度可分离卷积层,torch没有实现,tf有实现
class DepthWiseConv2d(nn.Module):
    def __init__(self, in_channels, out_channels, kernel_size, stride=1, padding=0, bias=True):
        super(DepthWiseConv2d, self).__init__()  #这里写为super().__init__(),等价的
        self.depthwise_conv = nn.Conv2d(in_channels, in_channels, kernel_size, stride, padding, groups=in_channels,
                                        bias=False)  #groups参数表示一个卷积核的每个通道分别进行运算
        self.pointwise_conv = nn.Conv2d(in_channels, out_channels, 1, 1, 0, bias=bias)

    def forward(self, x):
        x = self.depthwise_conv(x)
        x = self.pointwise_conv(x)
        return x


class CNN(nn.Module):
    def __init__(self, activation="relu"):
        super(CNN, self).__init__()
        self.activation = F.relu if activation == "relu" else F.selu
        self.conv1 = nn.Conv2d(in_channels=1, out_channels=32, kernel_size=3, padding="same")
        self.conv2 = DepthWiseConv2d(in_channels=32, out_channels=32, kernel_size=3, padding="same")
        self.pool = nn.MaxPool2d(2, 2)
        self.conv3 = DepthWiseConv2d(in_channels=32, out_channels=64, kernel_size=3, padding="same")
        self.conv4 = DepthWiseConv2d(in_channels=64, out_channels=64, kernel_size=3, padding="same")
        self.conv5 = DepthWiseConv2d(in_channels=64, out_channels=128, kernel_size=3, padding="same")
        self.conv6 = DepthWiseConv2d(in_channels=128, out_channels=128, kernel_size=3, padding="same")
        self.flatten = nn.Flatten()
        # input shape is (28, 28, 1) so the fc1 layer in_features is 128 * 3 * 3
        self.fc1 = nn.Linear(128 * 3 * 3, 128)
        self.fc2 = nn.Linear(128, 10)

        self.init_weights()

    def init_weights(self):
        """使用 xavier 均匀分布来初始化全连接层、卷积层的权重 W"""
        for m in self.modules():
            if isinstance(m, (nn.Linear, nn.Conv2d)):
                nn.init.xavier_uniform_(m.weight)
                if m.bias is not None:
                    nn.init.zeros_(m.bias)

    def forward(self, x):
        act = self.activation
        #x -->(batch_size, 1, 28, 28)
        x = self.pool(act(self.conv2(act(self.conv1(x)))))  # (batch_size, 32, 14, 14)
        x = self.pool(act(self.conv4(act(self.conv3(x)))))  # (batch_size, 64, 7, 7)
        x = self.pool(act(self.conv6(act(self.conv5(x)))))  # (batch_size, 128, 3, 3)
        x = self.flatten(x)  # (batch_size, 128 * 3 * 3)
        x = act(self.fc1(x))  # (batch_size, 128)
        x = self.fc2(x)  # (batch_size, 10)
        return x


for idx, (key, value) in enumerate(CNN().named_parameters()):
    print(f"{key}\tparamerters num: {np.prod(value.shape)}")
pythondef __init__(self, in_channels, out_channels, kernel_size, stride=1, padding=0, bias=True): super(DepthWiseConv2d, self).__init__() # 第一步:深度卷积(Depthwise Convolution) self.depthwise_conv = nn.Conv2d( in_channels, in_channels, kernel_size, stride, padding, groups=in_channels, # <-- 这是关键参数! bias=False ) # 第二步:逐点卷积(Pointwise Convolution) self.pointwise_conv = nn.Conv2d( in_channels, out_channels, 1, 1, 0, bias=bias )第一步:深度卷积(Depthwise Convolution)
关键参数
groups=in_channels的含义:在普通卷积中,
groups=1(默认),意味着输入的所有通道被一个卷积核求出的值被加权求和。当groups=in_channels时,输入通道被完全分组,每个通道独立享有自己的卷积核。即"每个通道单独做卷积,互不干扰"。第二步:逐点卷积(Pointwise Convolution)